 网硕互联帮助中心
一、多任务的概念
(1)多任务是什么
多任务指操作系统在同一时间段内执行多个任务的能力。注意这里是时间间隔或时间段,而非时刻。多任务的实现依赖于操作系统的调度算法(如时间片轮转、优先级调度)。
(2)并发与并行
并发:指两个或多个时间在同一时间间隔内发生。这些事件宏观上是同时发生的,但微观上是交替发生的。
并行:指两个或多个事件在同一时刻同时发生。
单核CPU同一时刻只能执行一个程序,各个程序只能并发地执行。多核CPU同一时刻可以同时执行多个程序,多个程序可以并行地执行。比如4核CPU介意并行执行4个程序。
(3)计算密集型任务和IO密集型任务
计算密集型又叫CPU密集型任务,它的特点是要进行大量计算,消耗CPU资源。比如浮点运算和视频解码等,这些计算密集型任务虽然可以用多任务完成,但任务越多,花在任务切换的时间就越多,CPU执行任务的效率就越低,所以,要最高效地利用CPU,计算密集型任务同时进行的数量应当等于CPU的核心数。
IO密集型任务一般是涉及网络、磁盘IO的任务。这类任务的特点是CPU消耗少,任务的大部分时间都在等待IO操作完成,因为IO的速度远远低于CPU和内存的速度。对于IO密集型任务,任务多,CPU效率越高,但也有限度。常见的大部分任务都是IO密集型任务,比如WEB应用。
(4)进程与线程的定义
程序 = 数据结构 + 算法。数据结构是程序的骨架与静态基础,它定义了数据在内存中的组织、存储和管理方式,决定了数据访问效率和空间占用。算法是程序的灵魂和动态逻辑。它定义了数据进行操作的步骤、流程和计算规则,决定了程序的时间复杂度和功能正确性。
进程是运行中的程序。进程是资源分配的基本单位,进程之间的数据和内存是不共享的,进程间相互隔离。每启动一个进程,都要独立分配资源和拷贝访问的数据,所以进程的创建、销毁和切换的代价是比较大。
线程是CPU调度的基本单位,它被包含在进程之中,是进程中的实际运作单位,一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程,每条线程并发执行不同的任务。同一个进程内的线程共享该进程的内存空间(堆、全局变量),但拥有独立的栈和寄存器。线程的创建和切换开销小,但需要注意数据竞争与同步。
| 内存 | 独立地址空间 | 共享进程内存 |
| 通信 | IPC(Queue/Pipe/共享内存) | 直接读写共享变量(需锁) |
| 健壮性 | 高(互相隔离) | 低(一个崩可能全崩) |
| GIL影响 | 无(真正并行) | 有(CPU密集型无效) |
| 适用场景 | CPU密集型、高可靠性要求 | IO密集型、轻量级任务 |
二、Python中如何创建一个进程
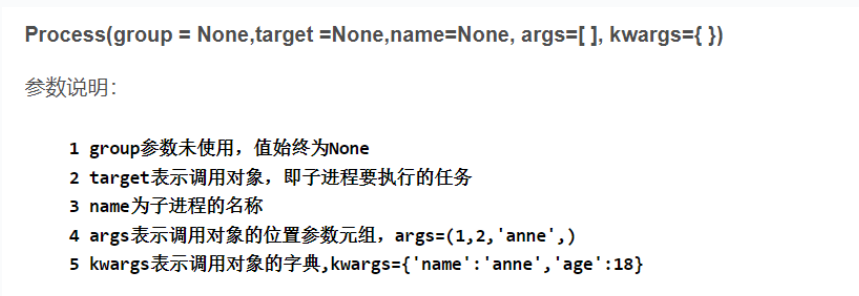
Python提供了跨平台的多进程模块 multiprocessing
(1)方法一:直接实例化Process类
# demo.py
from multiprocessing import Process
def worker(name):
print(f"子进程 {name} 开始…")
if __name__ == "__main__":
print("主进程开始…")
p = Process(target=worker, args=('test', ))
p.start() # 启动子进程
p.join() # 阻塞当前进程,等待子进程执行结束
【注】这里需要明确主进程和子进程。当我们通过Python解释器来执行demo.py程序时,程序被赋予了声明,成为一个进程,这个进程是主进程。而在主进程执行过程中,通过对Process类进行实例化创建的就是子进程。
在多进程中,子进程调用join方法。join方法会使主进程进入阻塞,直到调用join方法的字进程执行完毕。
(2)方法二:继承Process类创建进程
from multiprocessing import Process # 多进程的类
import time
import random
# 创建一个进程类Pros
class Pros(Process):
def __init__(self, name):
super().__init__()
self.name = name
def run(self):
print(f'{self.name} 开始运行!')
# 随机睡眠1~5秒
time.sleep(random.randrange(1, 5))
print(f'{self.name} 结束!')
if __name__ == "__main__":
# 创建3个子进程
for i in range(3):
num = "p" + str(i+1)
num = Pros(f"子进程{num}")
num.start() # start方法会自动调用进程类中的run方法
(3)进程池:Pool
在一台计算机中进程是不能无限创建的。进程池的作用就是当进程数过多时,用于限制进程数,防止OOM,还可以避免频繁创建和销毁进程的开销。Pool可以提供指定数量的进程,供用户调用,当有新的请求提交到pool中时,如果池没满,那么就会创建一个新的进程来执行该请求。如果池中进程数已经达到规定最大值,那么该请求就会等待,直到池中有进程结束,才会创建新的进程来执行请求。
Pool(processes=None, initializer=None, initargs=(), maxtasksperchild=None, context=None)
- processes:工作进程数量
- initializer & initargs:子进程初始化钩子
- maxtasksperchild:单进程最大任务数
- context:进程启动上下文
import os, time
from multiprocessing import Process, Pool
def run_a_sub_proc(name):
print(f'子进程:{name}({os.getpid()})开始!')
for i in range(2):
print(f'子进程:{name}({os.getpid()})运行中…')
time.sleep(1)
print(f'子进程:{name}({os.getpid()})结束!')
if __name__ == '__main__':
print(f'主进程({os.getpid()})开始…')
p = Pool(3)
for i in range(1, 5):
p.apply_async(run_a_sub_proc, args=(f"进程-{i}",))
p.close()
p.join()
pool用于提交任务的四种方式:
| map(func, iterable) | 阻塞 | 有序结果列表 | 批量同构任务,需要保序结果 |
| imap(func, iterable) | 惰性迭代器 | 按完成顺序yield | 大数据流式处理,内存友好 |
| apply(func, args) | 阻塞 | 单个结果 | 串行执行单个任务(极少用) |
| apply_async(func, args, callback) | 立即返回AsyncResult | 异步结果对象 | 异构任务、需回调、不关心顺序 |
pool用于生命周期管理的三个方法:
- close():关闭任务提交通道。不再接受新任务,但已提交的任务会继续执行。
- terminate():立即终止所有工作进程(无论任务是否完成)。用于异常退出或超时强制停止。
- join():阻塞主进程,等待所有工作进程正常结束。必须在 close() 或 terminate() 之后调用。
三、进程之间如何通信
进程之前是不共享数据的,但可以通过进程间通信实现数据交互。
(1)Queue队列
Queue是基于管道+锁封装的进程安全FIFO队列。Queue([maxsize])建立一个共享的队列(内部维护着数据的共享),多个进程可以向队列里存/取数据。其中,参数是队列最大项数,省略则无限制。
from multiprocessing import Process, Queue
import time, os
def prodcut(q):
print("开始生产.")
for i in range(5):
time.sleep(1)
q.put('产品'+str(i))
print("产品"+str(i)+"生产完成")
def consume(q):
while True:
prod = q.get()
print("消费者:{},消费产品:{}".format(os.getpid(), prod))
time.sleep(1)
if __name__ == '__main__':
q = Queue()
p = Process(target=prodcut, args=(q, )) # 生产者
c1 = Process(target=consume, args=(q, )) # 消费者1
c2 = Process(target=consume, args=(q, )) # 消费者2
p.start()
c1.start()
c2.start()
p.join() # 当生产者结束后,将两个消费则也结束
c1.terminate()
c2.terminate()
(2)Pipe管道
Pipe是双向半双工通信通道,返回两个连接对象(conn1, conn2)。如果你创建了很多个子进程,那么其中任何一个子进程都可以对Queue进行存(put)和取(get)。但Pipe不一样,Pipe只提供两个端点,只允许两个子进程进行存(send)和取(recv)。也就是说,Pipe实现了两个子进程之间的通信。
from multiprocessing import Pipe, Pool
import os,time
def product(send_pipe):
print("开始生产.")
for i in range(5):
time.sleep(1)
send_pipe.send("产品"+str(i))
print("产品" + str(i) + "生产完成")
def consume(recv_pipe):
while True:
print("消费者:{},消费产品:{}".format(os.getpid(), recv_pipe.recv()))
time.sleep(1)
if __name__ == '__main__':
# 使用进程池来创建进程
send_pipe, recv_pipe = Pipe()
pool = Pool(2)
pool.apply_async(product, args=(send_pipe,))
pool.apply_async(consume, args=(recv_pipe,))
pool.close()
pool.join()


评论前必须登录!
注册