 网硕互联帮助中心
文章目录
- D39-训练监控与可视化:Loss 曲线 + GPU 监控 + 早停 + checkpoint 管理
-
- 一、为什么训练监控是微调的\”X 光机\”
-
- 1.1 一个真实故事
- 1.2 监控的 3 个核心目标
- 二、4 个核心监控指标
-
- 2.1 Loss(训练损失)
- 2.2 Learning Rate(学习率)
- 2.3 Gradient(梯度)
- 2.4 GPU 利用率
- 三、5 种 Loss 异常 + 4 种正常
-
- 3.1 5 种异常 + 解决方案
- 3.2 4 种正常 Loss 曲线
- 四、GPU 监控实战
-
- 4.1 用 nvidia-smi 实时监控
- 4.2 Python 端集成(可放入训练脚本)
- 五、早停策略(Early Stopping)
-
- 5.1 早停的 3 个核心参数
- 5.2 早停逻辑
- 5.3 Hugging Face Trainer 内置早停
- 5.4 实战建议
- 六、Checkpoint 管理
-
- 6.1 3 个保存策略
- 6.2 限制磁盘占用
- 6.3 Checkpoint 恢复训练
- 6.4 Best Checkpoint 自动加载
- 6.5 Checkpoint 清理脚本
- 七、Wandb / TensorBoard 集成
-
- 7.1 Wandb(推荐,云端可视化)
- 7.2 TensorBoard(本地可视化)
- 7.3 自定义指标(Callback)
- 八、4 个生产级监控告警
-
- 8.1 告警 1:Loss NaN 立即停止
- 8.2 告警 2:GPU 显存 99% 持续告警
- 8.3 告警 3:Loss 不下降 5 个 epoch
- 8.4 告警 4:训练速度过慢
- 九、Key Takeaways
- 十、思考题
- 十一、下篇预告
D39-训练监控与可视化:Loss 曲线 + GPU 监控 + 早停 + checkpoint 管理
「60 天 AI 全栈转型」S3 模型训练与微调 · 第 4 篇 / 共 15 篇
读者画像:已掌握 LoRA / 全参微调 + 数据准备的开发者
预计阅读:30 分钟 · 实操:60-90 分钟
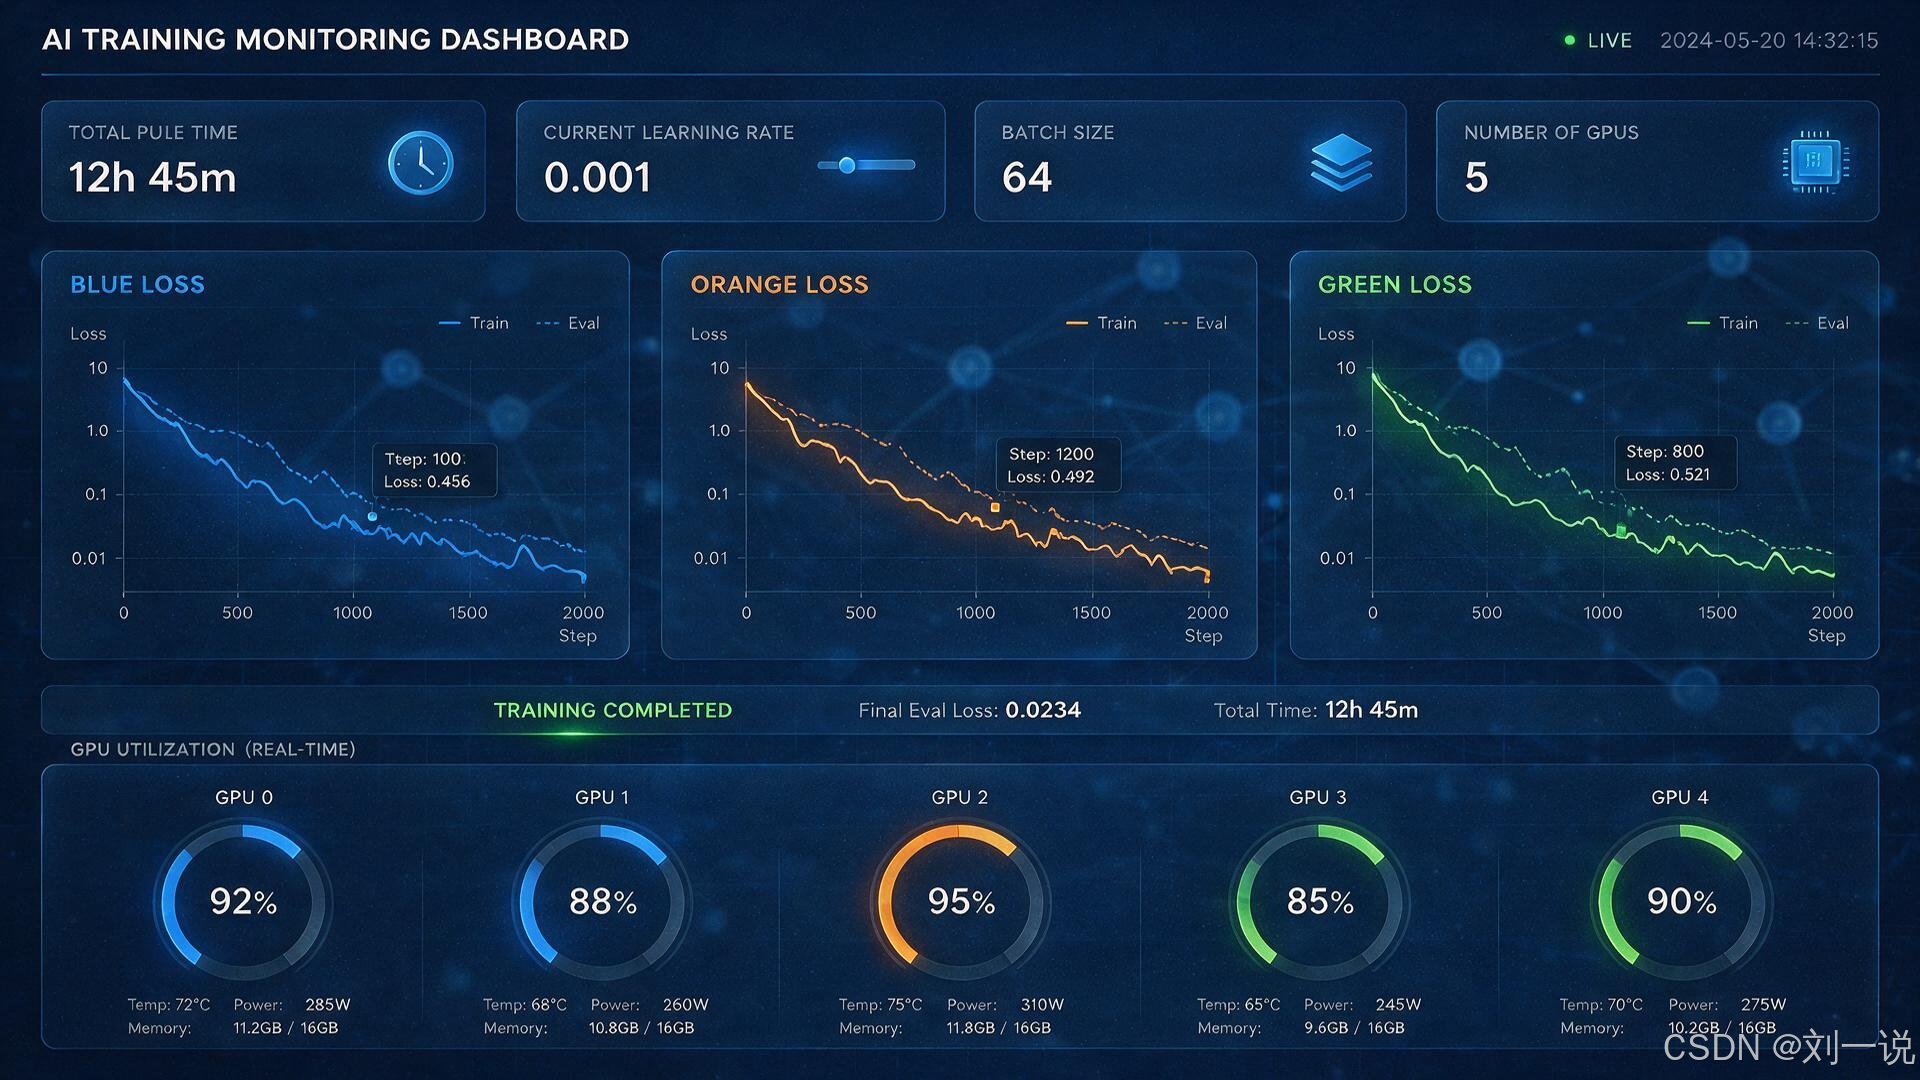
一、为什么训练监控是微调的\”X 光机\”
D36-D38 我们讲了怎么跑微调、怎么选方法、怎么准备数据。但真正决定你能不能把训练跑完、跑好、跑出好模型的,是监控。
1.1 一个真实故事
某团队用 8 张 A100 训练一个 70B 模型。训练到第 3 小时,loss 突然从 1.5 飙升到 12.0。他们没监控——直到 6 小时后有人发现日志异常才去看。
结果:浪费 6 小时 × 8 张 A100 = 48 GPU·小时 ≈ ¥1440 打水漂。
如果他们有实时 Loss 监控 + 异常告警,5 分钟内就


评论前必须登录!
注册