 网硕互联帮助中心
一、先说清楚:Skill 是什么
你跟 AI 聊股票,它能查行情、跑 Python、画图表。但你换一只股票再问,它又从零开始——上次怎么查的、用的什么接口、踩过什么坑,全忘了。
Skill 就是给 AI 装的一本"操作手册"。 它不是一个插件、不是一段代码,而是一份用 Markdown 写成的说明书——告诉 AI:“查行情用这个接口、参数这么传、返回的字段是什么意思、遇到报错怎么处理。”
一个 Skill 就是一个文件夹,核心是一份 SKILL.md:开头几行 YAML 声明名字和简介,后面是正文——可以长达几千行,附带脚本、参考资料、示例数据。AI 读完这份手册,就"会"了这项技能。
我们的投研 Skill 有 2600 多行,附带近百个 Python 脚本,覆盖股票、期权、加密货币、预测市场。装上它,AI 就是一个初级分析师;卸掉它,AI 还是一个通用聊天机器人。
Skill 让 AI 从"什么都会一点"变成"这件事真的很在行"。
二、第一个问题:换台电脑,技能就丢了
市面上大多数 AI 助手的 Skill(或者叫 Plugin、GPT、Action)都是本地文件。你花了一个下午调好的操作手册,存在你电脑的某个目录下。
然后你换了台电脑——出差用笔记本、在公司用台式机、家里还有一台。三台机器,三份 Skill,各自独立。你在家里调优了参数,到公司发现还是旧版本。你在一台机器上新写了一个 Skill,另外两台根本不知道它的存在。
更糟的是协作场景。你写了一份很好用的 Skill,想分享给团队。怎么传?发邮件?放共享网盘?每个人拿到后还要手动复制到正确的目录、确认格式没被改坏。有人改了名字、有人改了参数,三个月后五个人手里五个版本,谁也不知道哪个是对的。
这不是"不方便",这是"不可维护"。
三、我的做法:三份副本,一个事实
我想要的效果很简单:在任何一台机器上登录,我的 Skill 都在;在任何一台机器上改了,其他机器下次登录时自动同步。
听起来像个网盘?差不多,但比网盘多了一层"身份"。
我们的 Skill 存储分三层:
| 数据库 | 名字、启用状态、校验和、同步状态 | 身份权威:这个 Skill 存不存在、属不属于你 |
| 对象存储(OSS) | 整个目录打成 zip 包 | 内容权威:跨机器恢复的字节级真相 |
| 本地磁盘 | 解压后的工作目录 | 运行时缓存:AI 实际读取的地方 |
三层的写入方向只有一个:SkillSyncService 是唯一负责协调三者的组件。没有其他代码能绕过它直接往磁盘写、往数据库写、或往 OSS 写。单写方向意味着不会出现"数据库说存在、磁盘上找不到"这种分裂状态。
登录时发生了什么
你在新机器上登录。后台静默触发一次同步:
三种情况,三条路径,全部幂等。你在公司改了的 Skill,回家登录,家里的机器自动拉到最新版。
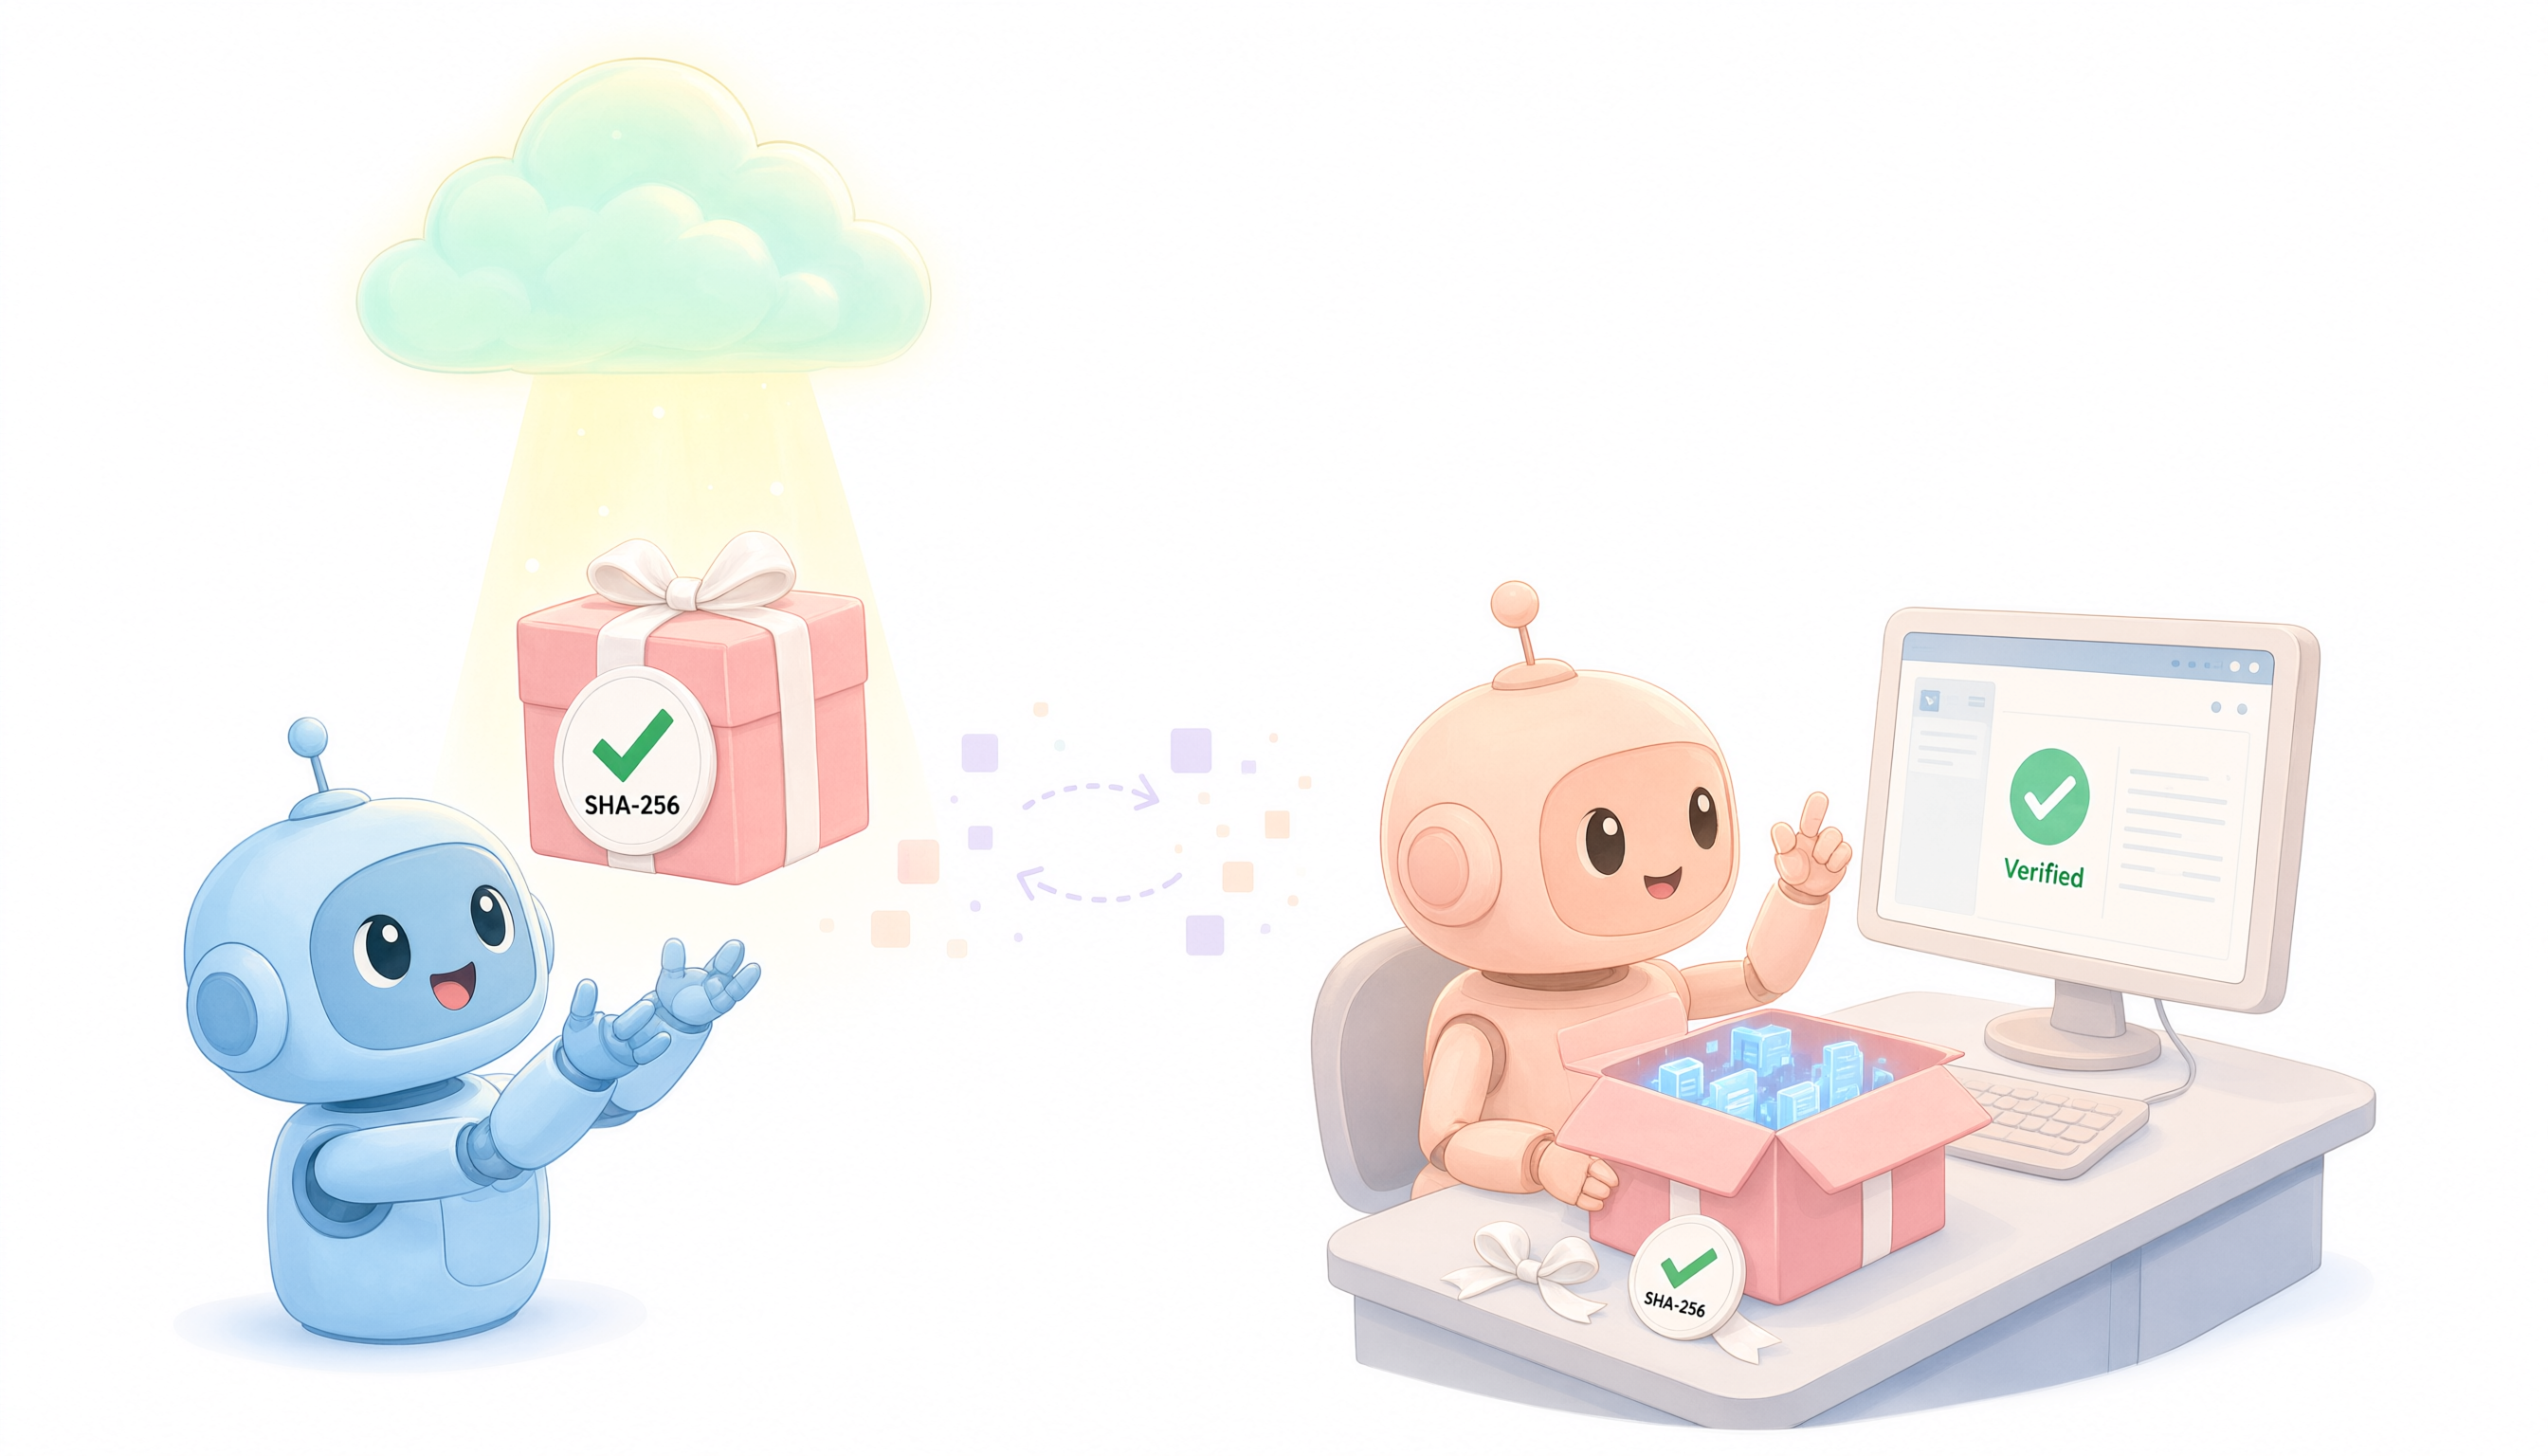
图 1:登录即同步,校验后才可见。
共享层:团队 Skill 怎么分发
除了个人 Skill,还有一个 system 共享层——管理员预装的通用技能,所有用户可见。个人 Skill 可以"遮蔽"同名的共享 Skill:你禁用了一个个人 Skill,它不会"穿透"回共享层去复活那个同名版本。遮蔽在启用过滤之前解析,这个顺序很关键——否则禁用一个个人 Skill 反而会让共享层的同名版本复活。
团队共享也支持群组粒度:一个群组的 Skill 对组内成员可见,成员的机器同步时会拉取群组层的目录,但只有群主能写回——非所有者是只读镜像,防止任何能往目录里丢文件的人发布一个全员可见的 Skill。
四、第二个问题:Skill 装多了,AI 反而变笨了
Skill 很好用。于是你装了 20 个。然后 50 个。
问题来了。
传统的做法是把所有 Skill 的名字和简介全部塞进 System Prompt——让 AI 知道"你有哪些技能可以用"。50 个 Skill,每个名字加简介加参数说明至少几百 token,加起来就是好几万 token 的常驻开销。
每一轮对话都要全量重发这份清单。 大部分技能在当前任务里根本用不上,纯属白花钱。
更隐蔽的问题是注意力稀释。AI 面前摊着 50 份说明书,你问它一个简单的问题,它可能在第 37 份说明书里找到了一个似是而非的关键词,然后按照那份说明书的逻辑来回答——而那份说明书是给完全不同的场景写的。
装得越多,越容易"走神"。 上下文被塞满了无关的能力描述,真正需要的那一份反而被淹没了。
五、我的做法:不背清单,用目录检索
人怎么解决这个问题?你不会把 50 本操作手册全背下来。你只记一个目录——“关于股票的事查 A 手册,关于画图的事查 B 手册”。真要用了,去书架上拿那一本就行。
我们做了同样的事。
第一层:Skill 少的时候,直接给 AI 看"封面"
Skill 不多的时候(比如五六个),最简单的做法就是把每个 Skill 的名字和一行简介塞进 System Prompt。AI 一眼扫过去就知道"我有这些技能",不需要读完整内容。几行文字,开销可以忽略。
第二层:Skill 多了,用目录检索
当 Skill 数量超过阈值,连"封面列表"也嫌占地方了。这时候 System Prompt 里的列表也省掉,换成一个工具:skill_search——用自然语言描述你要干什么,系统去索引里语义检索,返回最相关的几个 Skill 的名字和简介。
然后 AI 调 load_skill("xxx") 把完整手册加载进来——这一次对话里读完、用完,下一轮不需要重读。
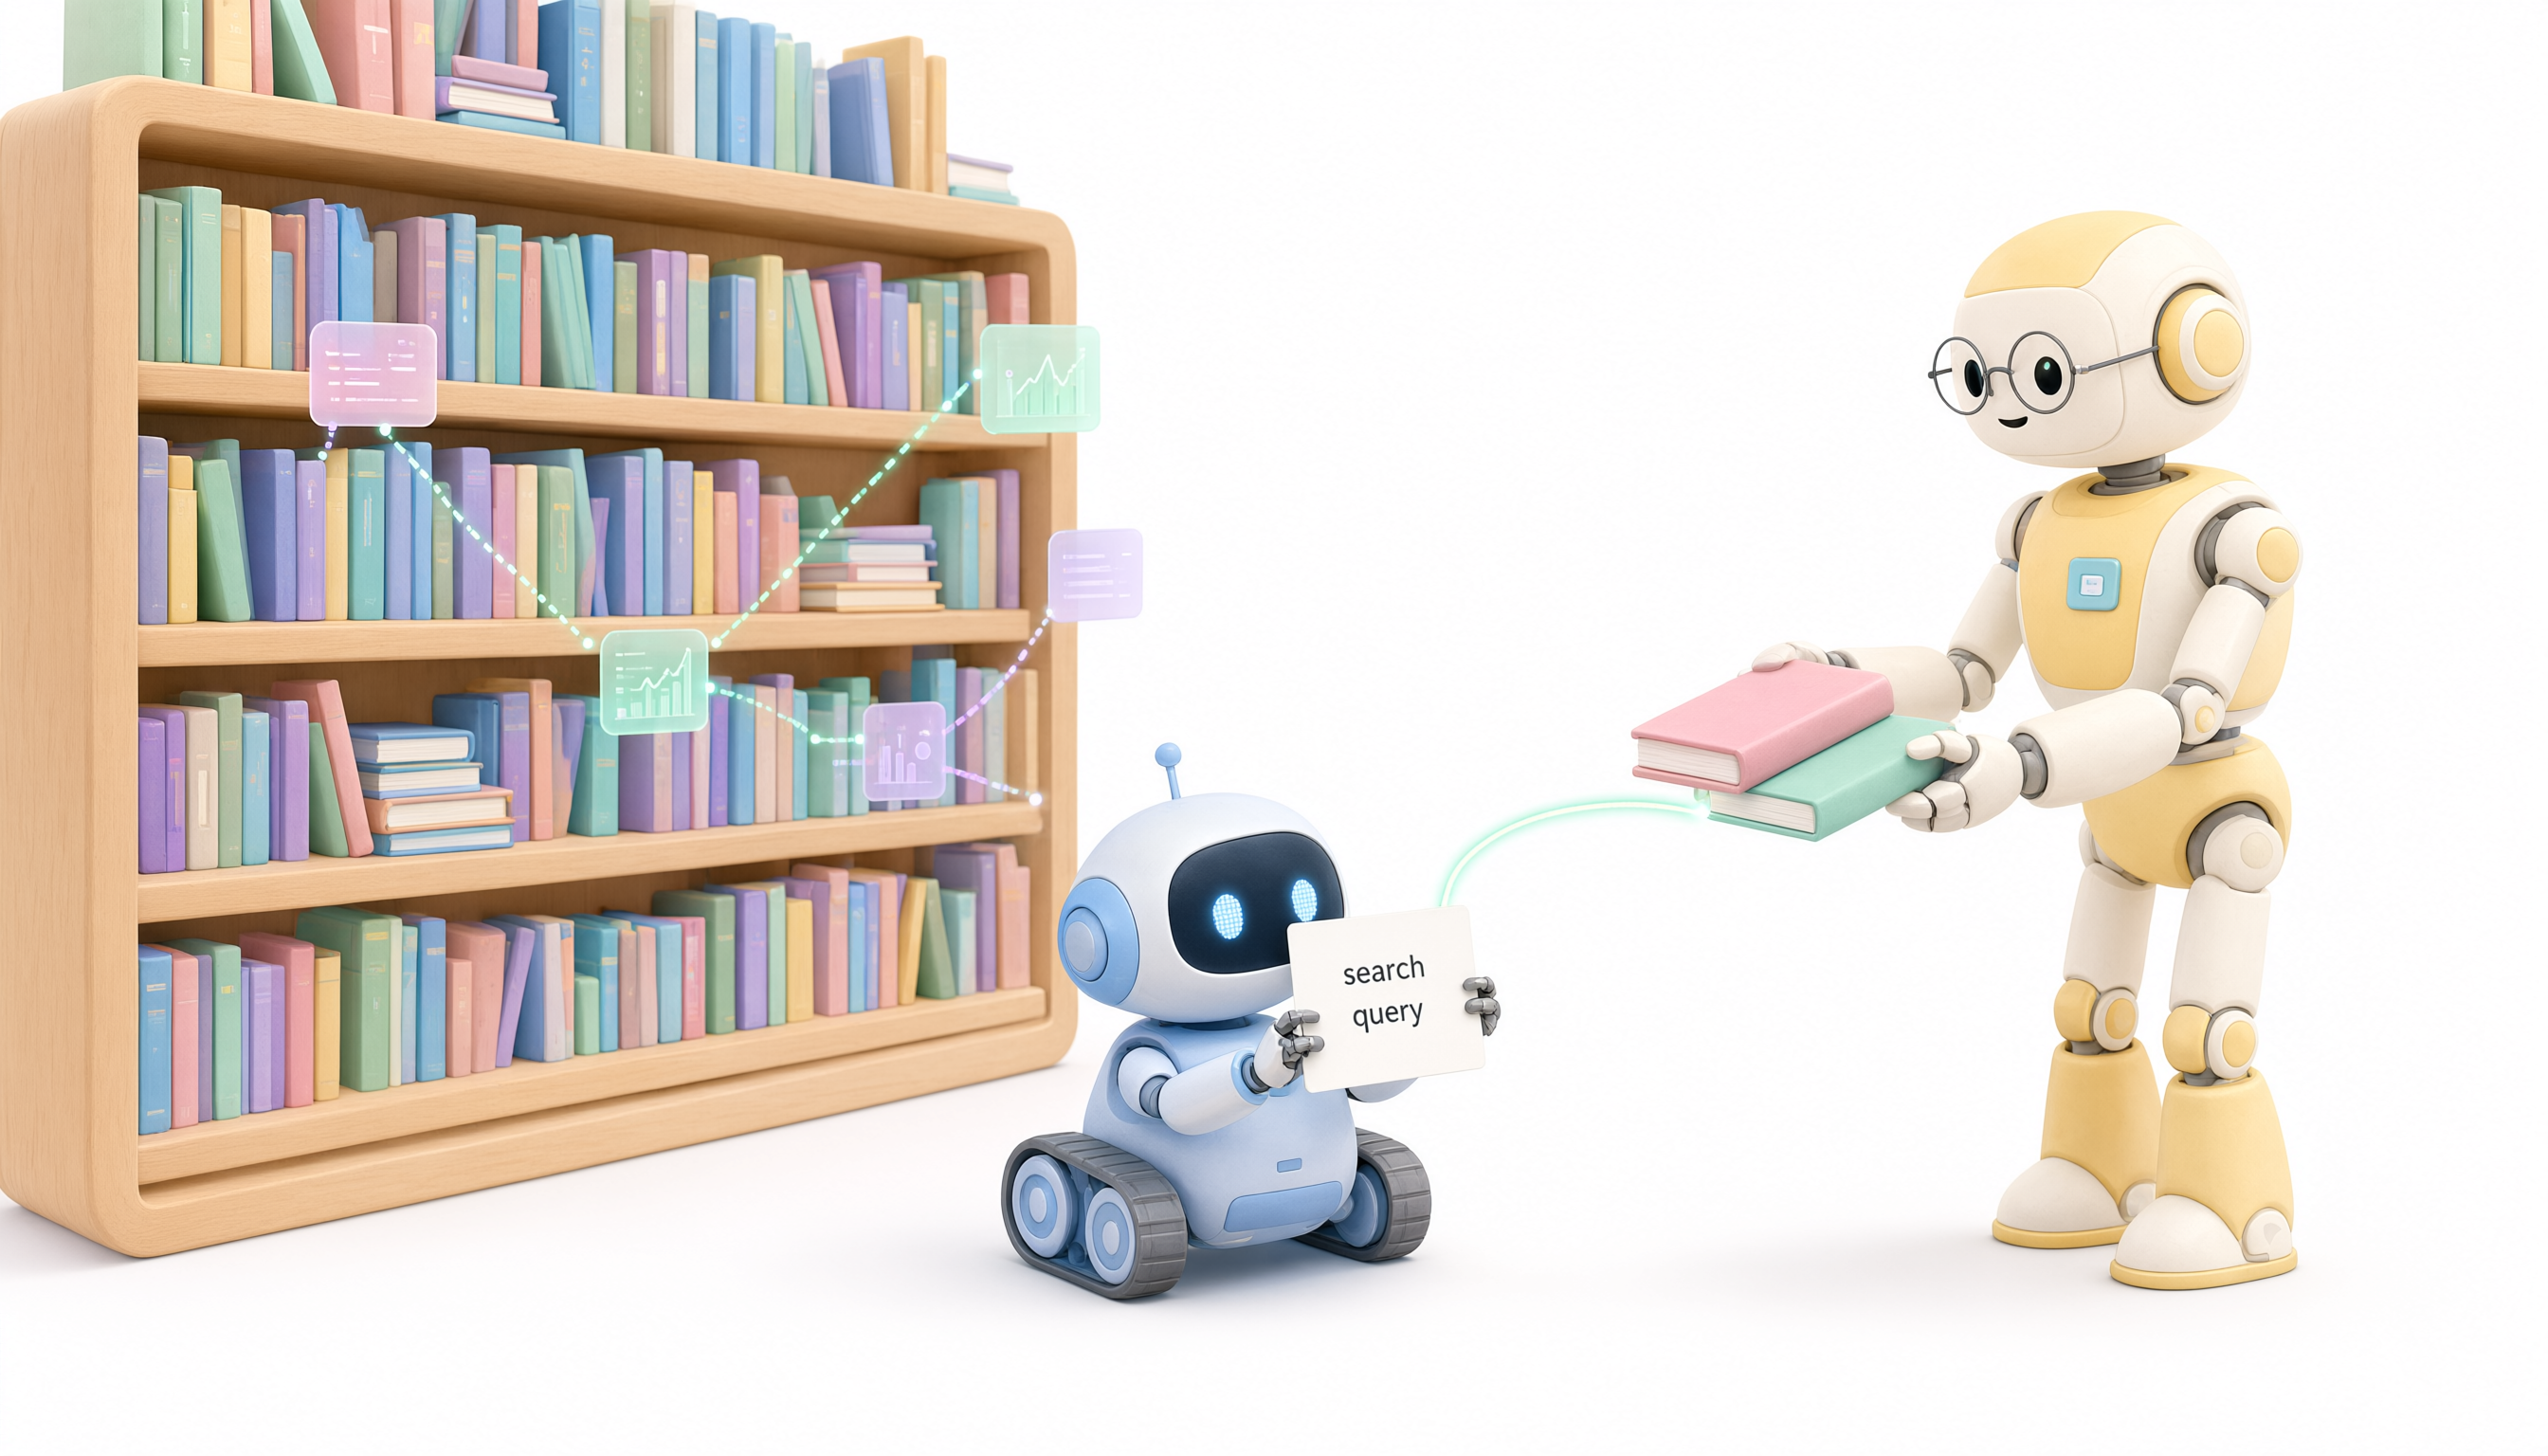
图 2:不搬整个书架,只取你要的那两本。
关键设计:RAG 是投影,不是权威
RAG 索引里的内容是从 Skill 目录投影过去的——如果 Skill 在磁盘上改了,索引会在下次同步时按校验和增量更新。但授权判断永远走数据库和磁盘,不走索引。索引挂了?降级到名字/简介的文本匹配,照样能用,只是没那么智能。
RAG 故障不能导致 Skill 不可用,也不能导致不该看到的 Skill 被看到。 这是"可降级的增强",不是"依赖了就离不开"。
三层授权,层层独立
即使 AI 通过搜索找到了一个 Skill,加载时还要过三道门:
三道门各自独立。任何一道关了,Skill 都加载不了。
六、这条路上的坑:推翻了三版才稳定
现在这套东西看起来挺整洁。但走到这里,中间推翻了好几版。写出来不是为了炫耀"我们做了很多",而是想说明一件事:看起来理所当然的设计,背后往往藏着好几次"这不行,重来"。
第一版:按文件夹分类,扫描发现
最早的想法很直觉:Skill 要么放一个全局共享目录,要么跟着项目走。启动时扫一遍文件夹,看到 SKILL.md 就注册。
单个人用、一台机器,完全没问题。但一旦有多个人、多个项目,麻烦就来了。
最严重的一个 bug:重启之后,用户私有的 Skill 变成了所有人共享的。 原因是"找不到个人记录就回退到共享层"这个逻辑,读的时候用是对的,写的时候也照搬——就把私有内容公开发布了。就像你把日记本落在公共书架上,不是有人偷看,而是图书管理员以为"没人认领的就是公共读物"。
除此之外,加载、搜索、系统提示、管理界面各自用一套过滤规则,关掉某个功能开关居然会绕过安全检查。索引失败了?下次启动发现文件没变,直接跳过——永远不会重试。
结论:文件系统扫描这条路走不通。
第二版:统一规则,修了 12 个问题
发现上面那堆问题后,做了一次集中整改。统一了所有入口的授权规则,修掉了"重启变共享"的 bug,给索引失败加了重试机制,把安全检查和功能开关解耦。
修完之后,单机器上跑得挺稳。但跨机器同步还是做不了——因为没有打包层,没有内容分发通道。Skill 还是"长在磁盘上的文件",换台机器就没了。
第三版:整个架构重写
这是最大的一次推翻。核心思路变了:磁盘不再是"真相",而是"缓存"。
- 数据库记录"这个 Skill 存不存在、属不属于你"
- 对象存储(OSS)保存打包后的完整内容,跨机器恢复靠它
- 本地磁盘只是运行时的工作副本——丢了可以从云端拉回来
登录时自动对账:数据库有但磁盘没有 → 从云端下载;磁盘改了但数据库不知道 → 以本地为准反向同步。
这次重构涉及十几个模块、上百个文件。改完后 1199 项测试全部通过。
还在打磨的事
即使到了第三版,也不是所有问题都解决了:
- 群组共享:群组成员能看到群主的 Skill,但本地改了不会同步回去。这是刻意的设计(防止任何人往群里塞东西),但用户直觉上会困惑"为什么我改了不生效"
- 索引"准备好了没"的判断:系统启动了不代表索引建好了。第一次启动时索引可能还是空的,这时候该怎么做?目前的策略是少量 Skill 保持直接注入,多了再切到检索
- 自动选 Skill:在实验一个功能,让系统自动判断该加载哪个 Skill,省去 AI 自己搜索的步骤。还在早期
没有一个设计是第一版就做对的。每一个"现在相对稳定"的模块背后,都躺着至少两版被推翻的方案。 这不是能力问题,是认知问题——你只有真的踩了坑,才知道那条路走不通。
七、一句话总结
Skill 让 AI 从"通才"变成"专家"。但让它真正可用的,不是 Skill 本身——而是跨机器不丢的同步机制,和装多了不胖的按需装载。
前者靠"三层存储 + 单写方向",后者靠"RAG 投影 + 三层授权"。两件事的共同本质是同一句话:
AI 的能力应该是它随时能取到的,而不是每次都背着走的。


评论前必须登录!
注册