 网硕互联帮助中心
本文摘要:纯向量 RAG 做仓库级问答时,跨文件调用链检索经常拼错且不易察觉。用 AST 图谱把定义与调用建为带来源标注的边,可直接遍历回答调用链。但动态导入等静态盲区仍需人工验证,不能只信确定性。
一、问题与结论
在 Claude Code 里问一个跨文件问题,比如:"requests 的 Session.send 在哪定义?它在调用链上还会调到哪些模块的方法?“纯向量 RAG 按函数切片入库,检索只能返回包含 def send 的若干代码块——embedding 相似度不理解"谁调用谁”,import 链一断,Agent 只能靠推理拼接,拼错时还看起来很自信。
结论先行:
二、排查与选择依据
建图前先回答一个问题:你的仓库有多大比例是静态分析覆盖不到的。在目标仓库根目录执行:
# 动态导入 / 反射
grep -rn "importlib\\|__import__\\|import_module" –include="*.py" | wc -l
# 字符串拼接的模块路径
grep -rn 'import_module(f"' –include="*.py" | wc -l
# 配置文件中的代码引用
grep -rn "handler\\|plugin\\|module" config.yaml config.json settings.py 2>/dev/null | wc -l
三条结果中任意一条非零,图谱在该仓库上就存在已知盲区。另外统计自动生成代码占比(protobuf 生成的 _pb2.py、.pb.go 等):AST 会解析出大量"有边无语义"的节点,图谱体积膨胀,但查询价值接近零。
替代方案与取舍
| 纯 RAG(切片+向量) | 快速搭建,问题以"为什么"类文档问答为主 | 跨文件调用链断链;切片粒度直接影响召回 |
| LSP + Agent 封装 | 已有 IDE 语言服务器基础设施 | 需逐语言配置;不产出图谱,SQL/配置文件不可查 |
| 混合:AST 定位 + RAG 解释 | 需同时回答"在哪"和"为什么" | 两套基础设施的维护成本 |
| 自建代码属性图(如 Joern) | 需要深度安全审计 | 学习曲线陡;大仓库构建可能达小时级 |
不该用 AST 图谱的三种情况:仓库以动态语言 + 插件架构为主且上面的 grep 结果很大;主要问题是"这段逻辑的业务含义是什么"(AST 只给结构,语义在文档里);团队里没人能读懂图查询结果、也没有预算做查询模板沉淀。
三、关键原理
两个机制决定图谱能回答什么、不能回答什么。
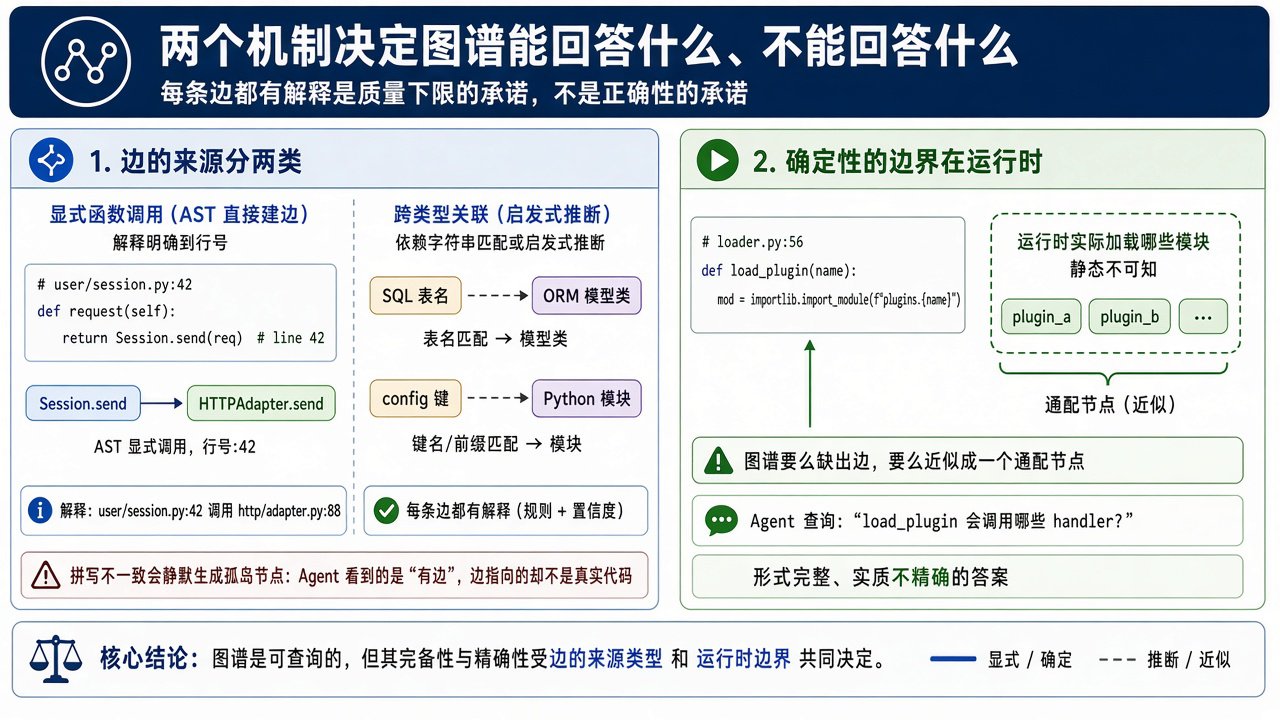
边的来源分两类。 显式函数调用(Session.send → HTTPAdapter.send)由 AST 直接建边,解释明确到行号。跨类型边则不同——SQL 表名连接到 ORM 模型类、config 键连接到 Python 模块,这类边依赖字符串匹配或启发式推断。“每条边都有解释"是质量下限的承诺,不是正确性的承诺;拼写不一致会静默生成孤岛节点,Agent 看到的是"有边”,边指向的却不是真实代码。
确定性的边界在运行时。 importlib.import_module(f"plugins.{name}") 这一行 AST 解析得了,但运行时实际加载哪些模块静态不可知。图谱要么缺出边,要么近似成一个通配节点——后者意味着 Agent 查询"load_plugin 会调用哪些 handler"时,拿到的是形式完整、实质不精确的答案,而"确定性"这个卖点会让人放松验证。
四、可运行示例
环境:macOS/Linux,Claude Code(已启用 skill 机制),Python 3.11+。
# 1. 准备目标仓库(示例用开源仓库,实际建议换成你维护的仓库)
git clone –depth 1 https://github.com/psf/requests /tmp/target-repo
# 2. 盲区自检
cd /tmp/target-repo
grep -rn "importlib\\|__import__" –include="*.py" | head -5
# 3. 安装 graphify skill 到 Claude Code 的 skill 目录
# 路径与命令以仓库 README 为准,此处不编造
然后在 Claude Code 中执行(命令拼写以 README 为准):
/graphify init /tmp/target-repo
/graphify query "Session.send 定义在哪?列出调用链上其他模块的方法。"
对照组:把同一批代码切片灌入向量库,用同样的问题检索。
预期输出(基于机制推断,未验证):图谱查询返回 Session.send 的精确文件与行号,并通过边遍历列出调用目标;RAG 返回若干包含 send 的代码块,调用链需要 LLM 推理拼接,import 链处容易断。
实际输出:以上结果必须在你自己的仓库上跑过才算数。核对两点——调用链是否完整(对照 grep -rn "def send" 手动追踪 import 链);每条返回的边是否标注了来源文件和行号。
五、验证结果与边界
最危险的失败场景:插件架构导致"图谱说安全、运行时崩溃"。若第二节的 grep 命中,Agent 可能基于图谱判断删除某个 plugins/billing_handler.py 没有引用——而它实际由 config.yaml 在运行时动态加载。修复方法:为每个动态加载点维护一份显式运行时依赖清单(注释或文档均可),建图后让 Agent 结合清单二次确认,不单独依赖图谱出边做删除决策。
版本层面的边界:Claude Code 的 skill 机制经历过目录结构变更,升级 Agent 后 skill 可能静默失效;Graphify 自身的具体版本、语言覆盖清单、构建耗时在已验证来源中均无数据,接入前先在 5 万行以内的子仓库跑通,检查孤立节点和无语义边的占比,再决定是否扩展到全量仓库。
思考
参考资料
Graphify-Labs/graphify


评论前必须登录!
注册