 网硕互联帮助中心
目录
复盘范围与判断标准
第一项修改:先把高校项目从过程叙述改成结果证据
原描述的问题不是技术少而是主线不清
量化能建立尺度但数字必须经得起核对
第二项修改:攻防演练要纠正对象混写并保留追问空间
从三个案例中提取三种能力
技术对象写错比写得少更致命
第三项修改:授权内网测试要把攻击链压成范围和转折点
修改前的问题是流水账
改写后保留五个阶段
第四项修改:蓝队项目要从工具记录转向事件处置
第五项修改:AI 渗透测试框架要先让人看懂成果
第六项修改:没有量化结果时不要强行制造内容
从六项修改归纳出的表达框架
原始写法为什么像技术报告
少写什么与多写什么
对当前简历的总体评价与学习建议
回看往届简历:项目多不等于证据强
蓝队经历缺少结果 渗透经历存在技术因果错误
靶场案例不能包装成真实项目
精简之后如何准备面试追问
复盘结论
摘要:本文复盘两份安全岗位简历的逐项修改过程,围绕攻防演练、授权内网测试、蓝队值守、AI 渗透测试框架与漏洞研究等经历,分析技术细节堆叠、对象混写、数据失真和成果缺位等问题。文章进一步对照往届简历中的靶场化叙述与技术逻辑错误,并还原面试官如何从精简后的项目描述继续追问,形成从素材核验、项目重写到面试准备的完整方法。
复盘范围与判断标准
这次复盘面对的并不是“项目不够多”,而是“项目已经不少,却没有被写成便于筛选的证据”。第一份简历包含蓝队护网、高校信息管理系统风险挖掘、AI Agent 辅助渗透测试和 WordPress 漏洞研究等经历。原稿将操作过程铺得很满,技术名词也足够多,但读者很难在短时间内辨认候选人解决了什么问题、承担了多大范围的工作,以及结果是否可信。
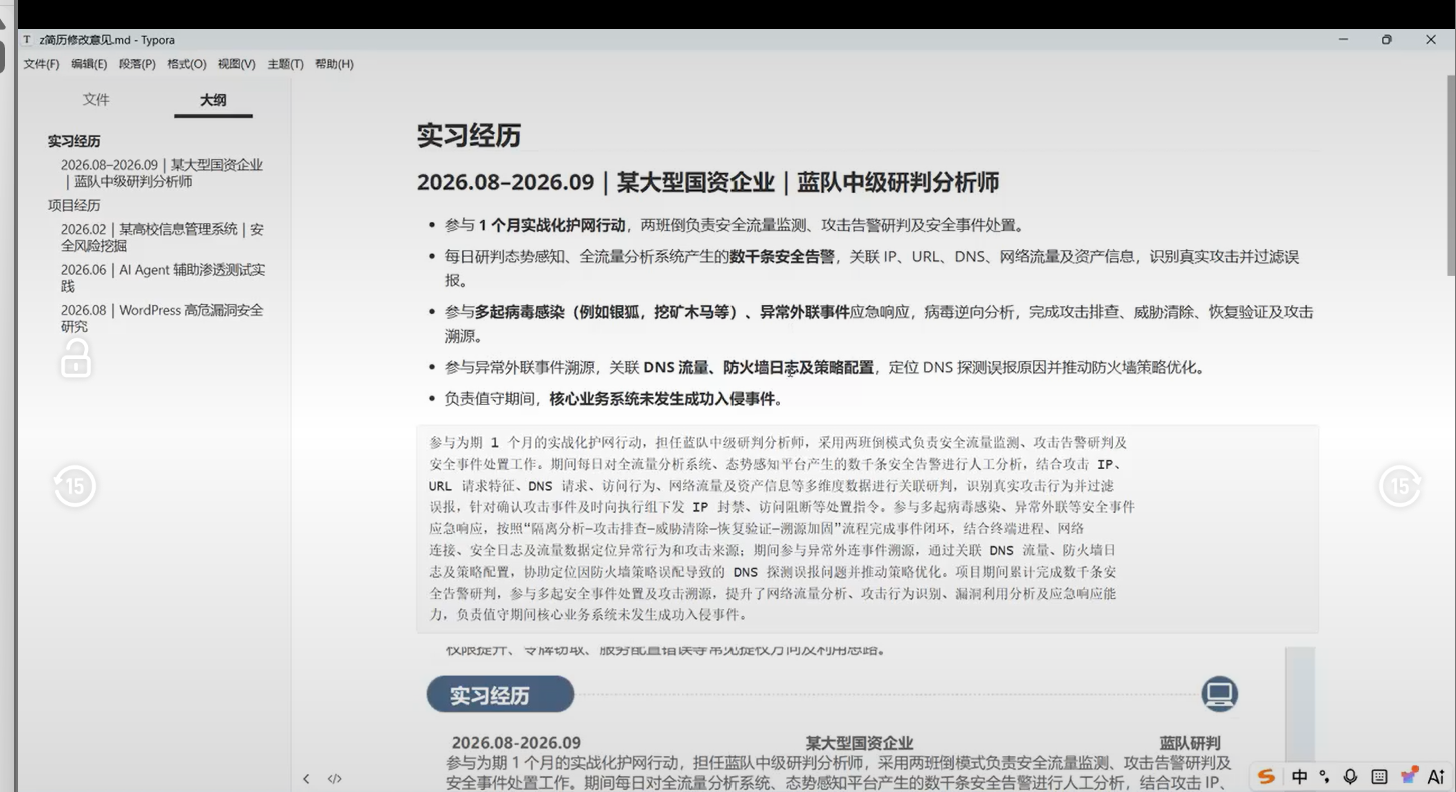
图 01:蓝队研判经历被写成连续长段落,任务、处置动作与结果混在一起,重点难以快速定位。
将同一段内容换成简历版式后,问题仍然存在。项目名称虽然清楚,但文字密度过高,实习职责与项目成果缺少层级,视觉上的“完整”反而提高了阅读成本。
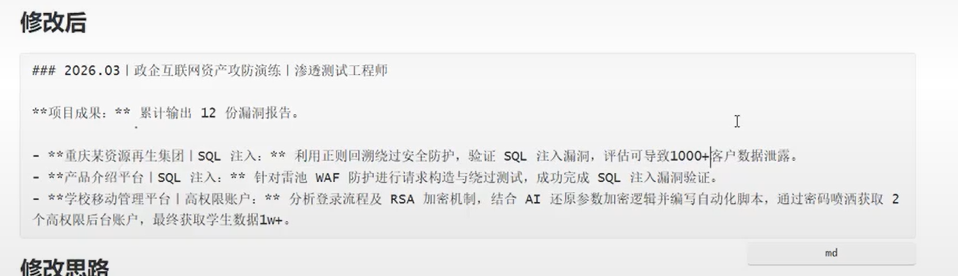
图 02:页面同时呈现实习与项目内容,但正文占用空间较大,项目成果没有形成独立的视觉锚点。
课程给出的核心判断是:安全岗位简历首先是一份筛选材料,而不是一份技术报告。 技术报告需要证明每一步如何实施;简历需要先证明候选人发现了什么问题、采用了什么关键技术、把事情推进到了什么结果。至于完整操作链、失败尝试和工具细节,应当保留为面试追问时的证据,而不是全部挤进首轮筛选页面。
【小白通俗注解】这里的“筛选材料”不是要求删掉技术含量,而是改变信息出现的顺序。读者先看到项目对象和可验证结果,产生继续了解的兴趣后,再通过面试核对技术过程。
第一项修改:先把高校项目从过程叙述改成结果证据
原描述的问题不是技术少而是主线不清
高校信息管理系统案例具备完整的技术推进:从 Web 系统的 MSSQL 注入进入,获得低权限数据库账户后继续验证服务器权限;再结合凭证提取和 Fscan 做授权内网探测,发现 MySQL、MSSQL、SSH 等弱口令;随后定位 vCenter 管理平台,利用 CVE-2021-21972 完成远程代码执行与权限提升;最终还观察到 Docker 未授权访问风险,并将多个节点串成完整风险链。
原描述却把这些动作压进一个段落。读者能够看到 sqlmap、WebShell、Mimikatz、vCenter 等名称,却需要自己推断每个动作解决了什么问题,以及它们之间为何能够继续推进。
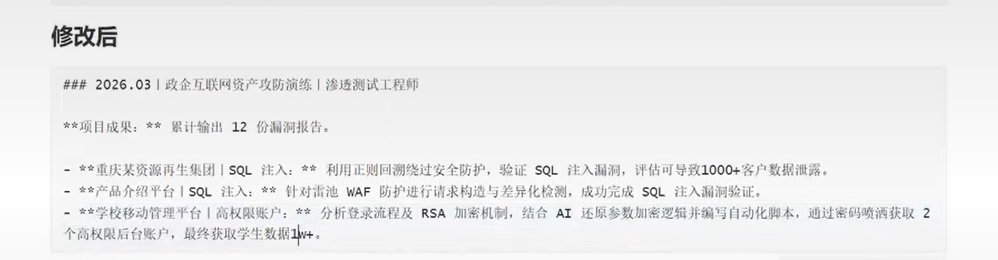
图 03:条目化版本补充了服务器、虚拟机与数据范围,但仍需区分真实结果、估算数字和示范性写法。
另一版又走向相反方向:它把同一条攻击链压成一个密集段落,留下了完整过程,却没有给筛选者任何快速扫描的入口。这样的写法更接近渗透测试报告摘要,不像简历项目。
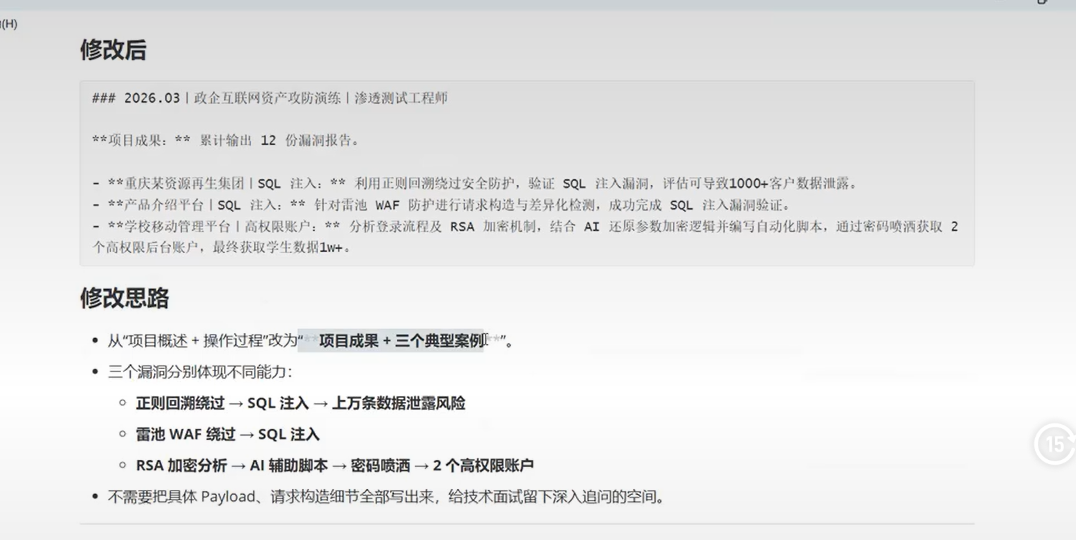
图 04:连续段落完整描述了注入、横向与数据访问过程,但角色贡献、关键转折和量化成果没有分层。
量化能建立尺度但数字必须经得起核对
修改首先把结果单独提出来:一卡通系统涉及 16 台服务器,门禁与车辆系统若干;vCenter 纳管约 300+ 台服务器;内网服务权限和泄露数据规模也可以量化。课程同时明确提醒,这些数字在演示稿中有随手填写或建议调整的成分,例如 200+、300+、500+、3万+ 等表述不能直接照抄到个人简历。候选人只能采用实际记录、报告或当时能够自证的数字。
量化的价值在于提供项目尺度,而不是制造“更大”的印象。数字应当回答三个问题:扫描或评估覆盖多大范围,实际确认多少资产或风险,最后形成多少报告、权限或数据影响。没有证据支持时,宁可写“多台”“若干”,也不能让示例数字变成虚假履历。
修改后的页面还暴露了另一类问题:AI Agent 项目和 WordPress 研究被写成大段技术介绍,几乎把研究背景、能力边界和实施流程全部展开。信息量虽然大,却让招聘者难以判断哪些是候选人真正完成的工作。
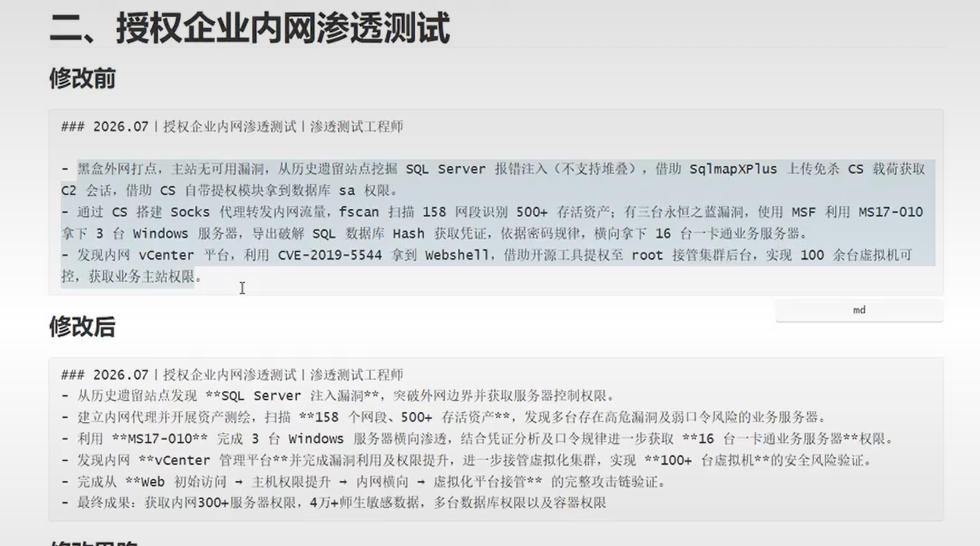
图 05:两个研究项目采用技术说明书式写法,背景、功能、步骤与价值混在同一层级。
精简后的版本把 AI Agent 项目拆为应用场景、输入信息、参数还原、辅助脚本和人工验证,把 WordPress 研究拆为漏洞对象、复现环境与文档产出。它减少了背景叙述,保留了可追问的技术节点。
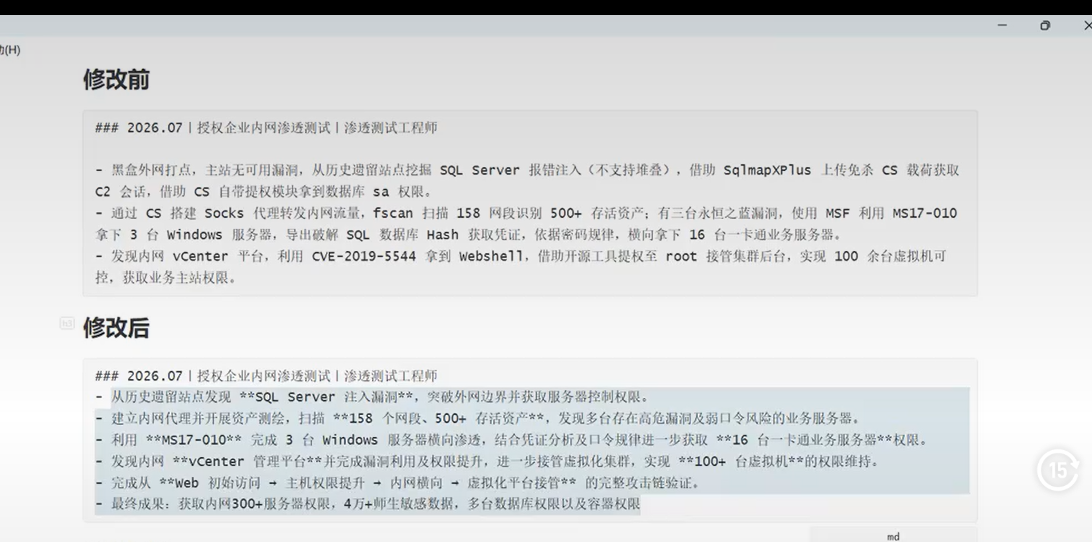
图 06:精简版本突出 Agent 分析、Python 辅助脚本、Burp Suite 验证,以及 WordPress 漏洞复现与资料输出。
实习经历也采用相同处理。与其把每日分析、攻击溯源、病毒响应和防火墙优化写成一个段落,不如分开呈现值守周期、告警规模、典型事件和业务结果。
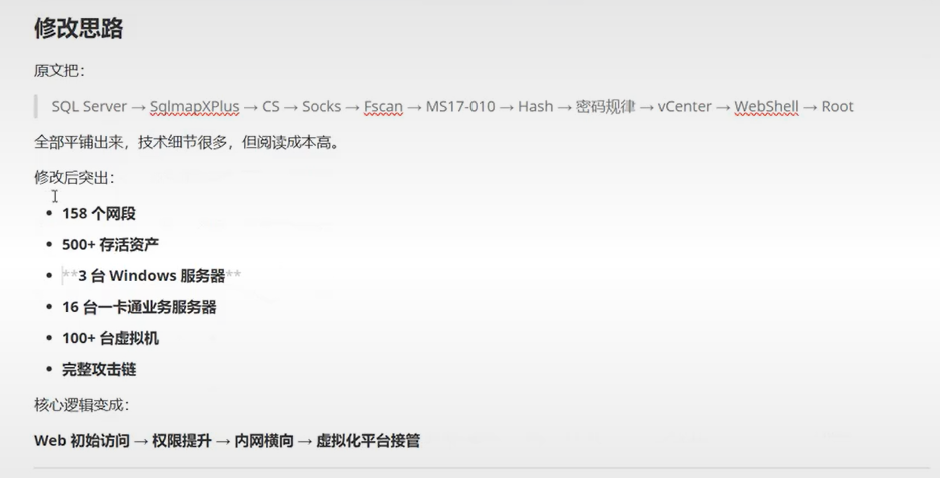
图 07:条目化后,值守周期、告警研判、病毒处置、DNS 误报排查和核心业务结果可以分别阅读。
这几轮对比建立了第一条改写原则:简历中的项目段落需要让问题、关键技术和结果形成可扫描的层级。 简洁不是把内容删到只剩一句空话,而是让每一行承担一个明确功能。
第二项修改:攻防演练要纠正对象混写并保留追问空间
从三个案例中提取三种能力
攻防演练案例原先按“项目概述加操作过程”展开。课程把它改造成“项目结果加三个典型案例”:资源再生平台突出正则回溯绕过与 SQL 注入风险;产品介绍平台突出针对雷池 WAF 的请求构造与差异化检测;学校移动管理平台突出登录流程、RSA 加密逻辑、AI 辅助脚本和密码喷洒结果。这样处理后,每个案例都能证明一种不同能力,项目总成果则用累计输出的漏洞报告数量概括。
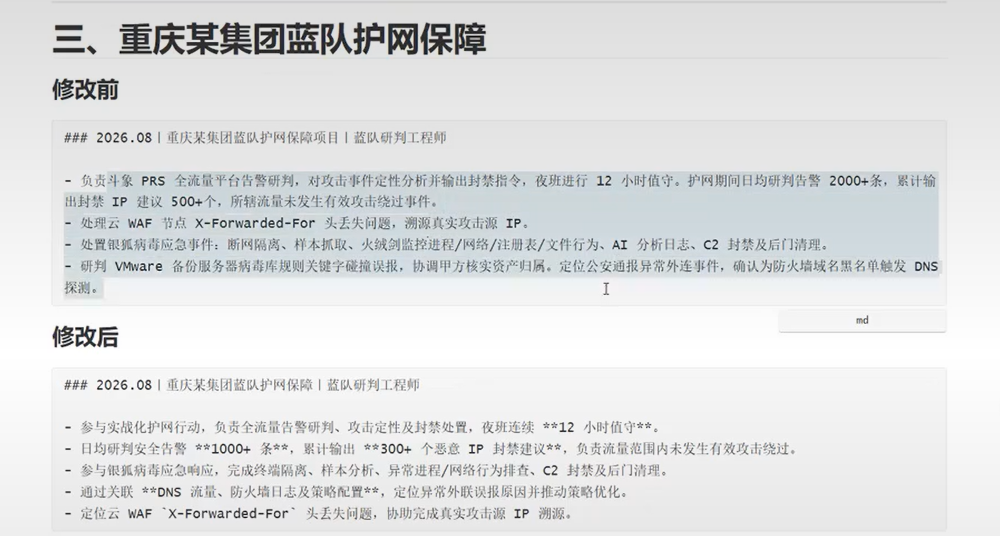
图 08:改写目标从“做了什么、用了什么工具”转向“解决了什么问题、采用什么关键技术、取得什么结果”。
完整对照中,修改前的四个长条目被压缩成项目成果和三个典型案例。课程建议保留累计 12 份不同等级漏洞报告这一结果,并让每个案例承担一个能力标签。
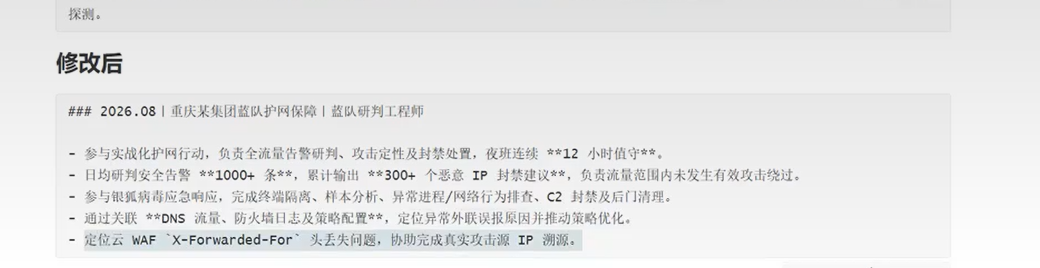
图 09:修改后以总成果开头,再分别呈现正则回溯、WAF 请求构造和 RSA 登录参数分析三个案例。
后续截图进一步放大了修改后的条目。资源再生平台中“可导致上万条数据泄露”的量级是示范性表达,课程建议根据真实情况改成 1000+、5000+ 等可核验数字,而不是机械采用示例。
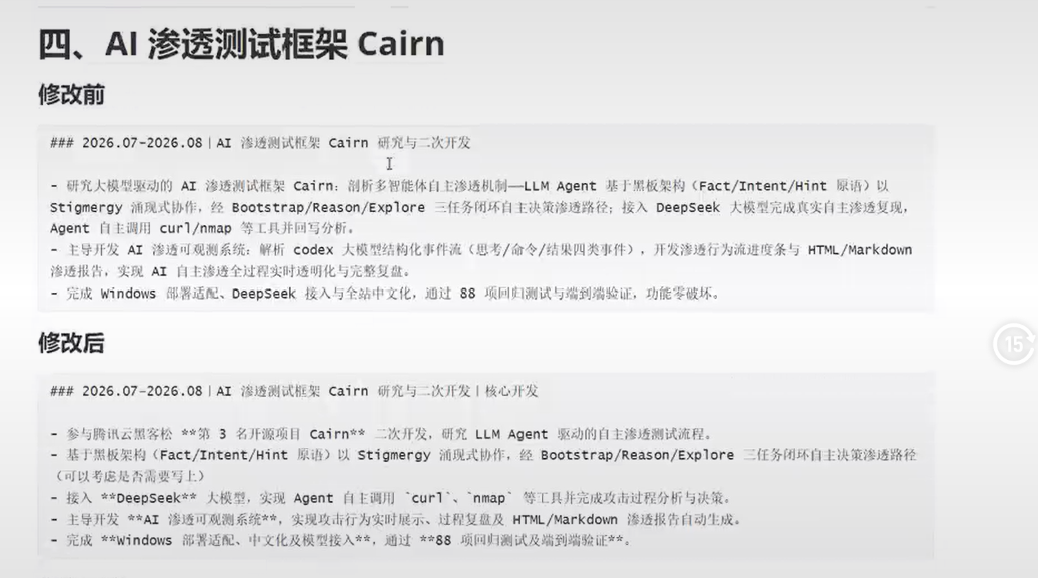
图 10:局部版本强调累计报告、典型漏洞和量化影响,数字仍需以个人真实记录为准。
技术对象写错比写得少更致命
产品介绍平台的原描述把 multipart/form-data 的 POST 载荷与“绕过宝塔”写在一起。讲师判断这两者不匹配:课程案例针对的是雷池 WAF 的检测机制,而此前涉及宝塔的内容属于另一种绕过思路。若把不同案例的产品对象、函数和验证过程拼在同一条经历中,技术面试官很容易发现逻辑断裂。
因此,修改不再罗列模糊的载荷细节,而是写成“针对雷池 WAF 防护进行请求构造与差异化检测,完成 SQL 注入验证”。这句话保留了防护对象、核心方法和验证结果,也给面试留下继续追问具体请求差异的空间。
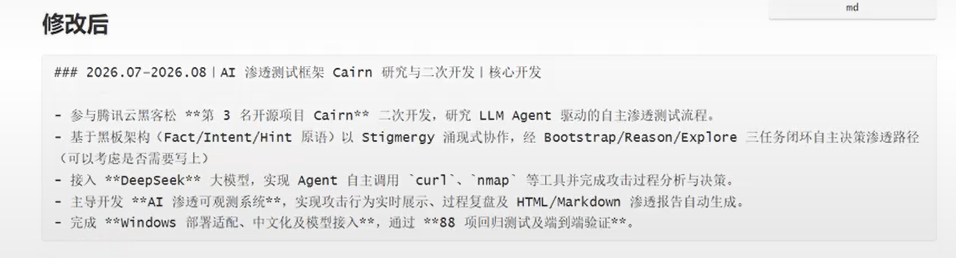
图 11:案例将错误的产品归属纠正为雷池 WAF,重点保留请求构造、差异化检测和注入验证。
学校移动管理平台也存在措辞错误。原句写成“获取两台后台管理权限”,把账户数量误写成设备数量。修改后应明确为:分析登录流程和 RSA 加密机制,借助 AI 还原参数加密逻辑并编写自动化脚本,通过密码喷洒获得 2 个高权限后台账户,最终确认学生数据影响范围。
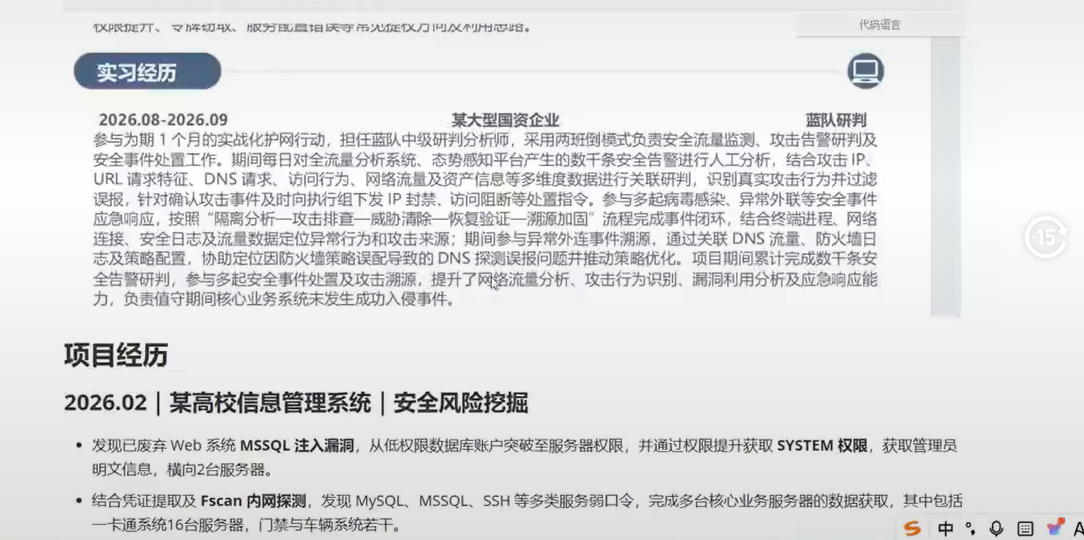
图 12:三个案例分别对应正则回溯、雷池 WAF 与 RSA 参数分析,并明确不在简历中铺开具体 payload。
这里的经验十分直接:错别字可以破坏专业感,技术对象或因果关系写错则会直接破坏可信度。 简历在压缩前必须先核对漏洞类型、产品名称、函数作用、账户与主机的计量单位,以及结果到底是“发现风险”还是“完成验证”。
第三项修改:授权内网测试要把攻击链压成范围和转折点
修改前的问题是流水账
第二个案例是授权企业内网渗透测试。原描述从边界入口开始,依次写到 SQL Server 报错注入、SqlmapXPlus、免杀载荷、C2 会话、提权模块、Socks 代理、Fscan、MS17-010、哈希导出、密码规律、vCenter、WebShell 和 root。技术链条很长,但所有环节被平铺后,读者只能看到工具清单,难以判断范围和关键转折。
课程还认为“黑盒外网打点”这一名称不够自然,建议直接使用“授权企业内网渗透测试”等能够说明边界的项目名,避免让术语本身承担不必要的解释成本。
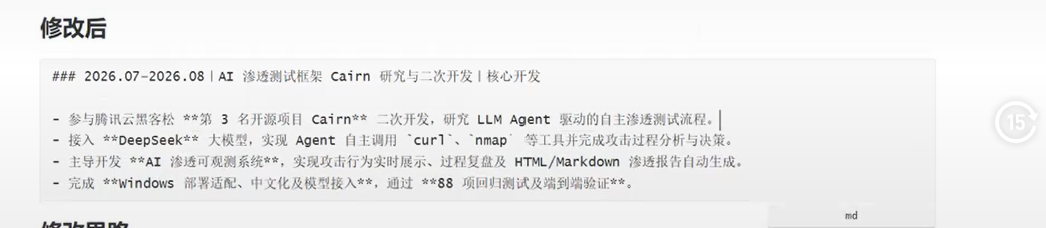
图 13:修改前逐项罗列工具与动作,修改后改为边界突破、资产测绘、横向验证、虚拟化平台接管和最终成果。
改写后保留五个阶段
第一阶段交代入口:从历史遗留站点发现 SQL Server 注入风险,突破外网边界并获得服务器控制权限。它没有在简历中解释每一个注入请求和载荷,而是留下“历史站点为何暴露”“如何确认入口”等可追问点。
第二阶段交代范围:建立授权内网代理后开展资产测绘,覆盖 158 个网段,识别 500+ 个存活资产,发现多台存在高危漏洞或弱口令风险的业务服务器。这里的数字让面试官能够判断项目规模,也使后续横向验证有明确背景。
第三阶段交代横向结果:利用 MS17-010 完成 3 台 Windows 服务器的横向验证,结合凭证分析与口令规律,进一步获得 16 台一卡通业务服务器相关权限。简历不需要展开每条命令,但面试时必须能够说明凭证从何而来、密码规律如何得到、每一步是否处于授权边界内。
第四阶段交代关键转折:发现内网 vCenter 平台后完成漏洞利用与权限提升,并继续验证 100+ 台虚拟机的集中管理风险。原始讲解还提到最初尝试失败等细节,这些不必全部写进简历,却应作为面试准备材料保留。
第五阶段才给出最终成果:形成从 Web 初始访问、主机权限提升、内网横向到虚拟化平台接管的完整验证链,并归纳获得权限、敏感数据、数据库权限和容器权限的范围。所有数字都应回到原始记录确认,不能把课堂中的示范值当成个人成绩。
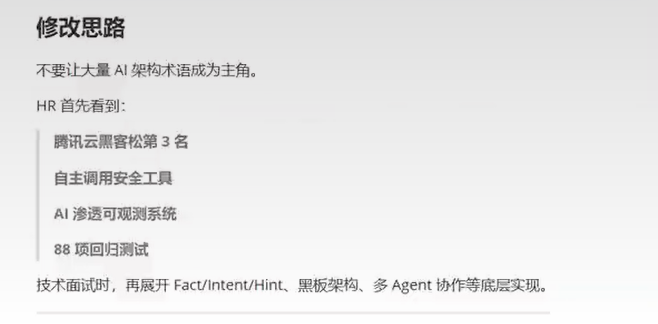
图 14:精简条目删除工具流水账,保留 158 个网段、500+ 存活资产、3 台服务器、16 台业务服务器和 100+ 虚拟机等尺度。
修改思路最终把长链条收束为两类信息:一类是范围数字,另一类是主线阶段。课程给出的阶段概括为“Web 初始访问、权限提升、内网横向、虚拟化平台接管”,它比十余个工具名称更适合首轮筛选。
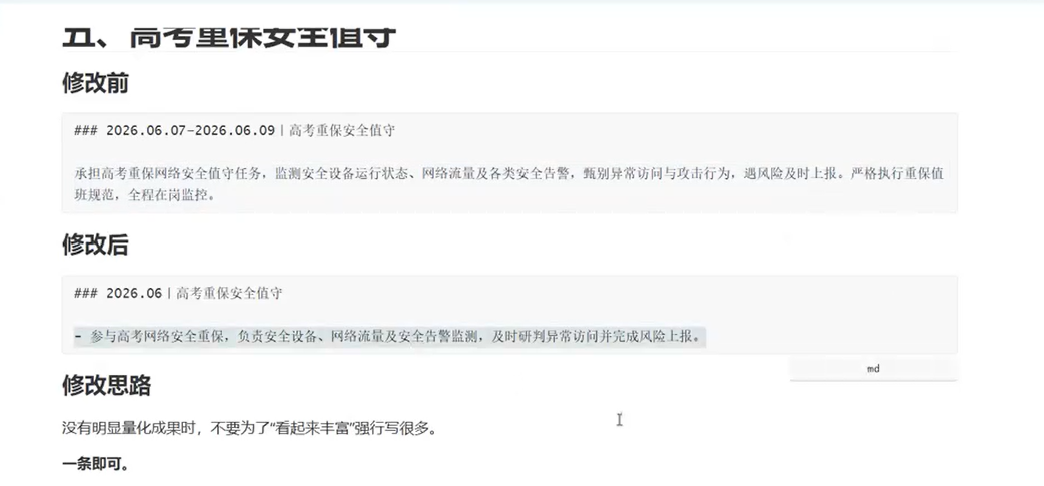
图 15:页面用资产数量和四阶段链路替代完整工具序列,降低阅读成本。
【小白通俗注解】“资产测绘”在这里指对授权范围内的网段和存活服务进行识别。简历写覆盖范围和发现结果即可,具体扫描配置与命令应在面试中根据授权项目如实说明。
这并不意味着火绒、360 免杀、dump、凭证获取或 vCenter 初始失败等细节没有价值。它们是技术面试时验证真实性的重要材料,只是不应与项目主线争夺简历空间。简历负责建立追问入口,面试回答负责展开证据。
第四项修改:蓝队项目要从工具记录转向事件处置
蓝队护网项目的修改前版本已经有一定基础,包含告警研判、恶意 IP 封禁、银狐样本分析和 DNS 误报排查。问题仍然是工具和操作写得过细,例如花较多文字说明 火绒剑 监控了什么、AI 如何分析日志。对不熟悉安全工具的 HR 来说,这些信息无法帮助筛选;对技术面试官来说,它们又不足以替代完整的事件证据。
修改后保留了更适合简历的尺度:连续 12 小时值守,日均研判 1000+ 条安全告警,累计输出 300+ 个恶意 IP 封禁建议;参与银狐病毒应急响应,完成终端隔离、样本分析、异常进程与网络行为排查、C2 封禁及后门清理;通过关联 DNS 流量、防火墙日志和策略配置,定位异常外联误报原因;还补充了 X-Forwarded-For 头丢失导致攻击源 IP 识别异常的排查结果。
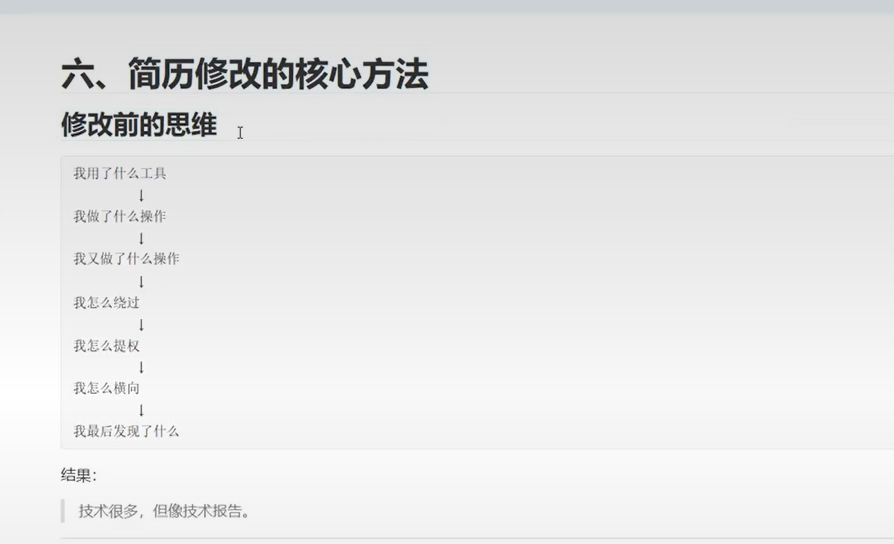
图 16:修改后将工具操作收束为告警研判、病毒处置、DNS 误报定位与攻击源 IP 溯源四类结果。
后续局部截图再次确认,蓝队项目的重点不在于写出所有监控工具,而在于呈现值守强度、处理规模、典型事件与闭环结果。
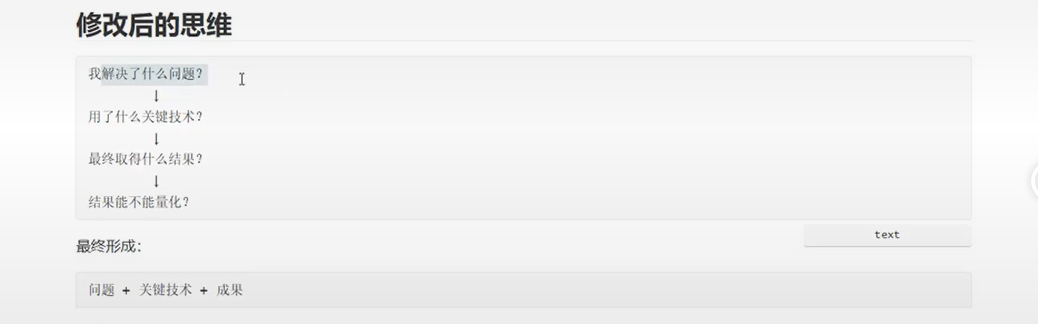
图 17:局部版本突出告警数量、封禁建议、事件响应、误报优化与真实源 IP 定位。
课程对条目优先级也给出经验判断:前几项核心事件应优先保留,次要工作可以作为补充,但不能挤占主要成果。若某项经历没有明确数量,仍可以写,只要事实真实、动作和结果清楚;不能为了“看起来丰富”而强行扩成一大段。
第五项修改:AI 渗透测试框架要先让人看懂成果
AI 渗透测试框架 Cairn 的原描述从架构讲起,涉及 LLM Agent、Fact/Intent/Hint、Stigmergy、Bootstrap/Reason/Explore、DeepSeek、curl、nmap、可视化、HTML/Markdown 报告、Windows 适配和 88 项测试。内容很丰富,但对首轮筛选者来说过于臃肿,项目的真实产出被架构术语淹没。
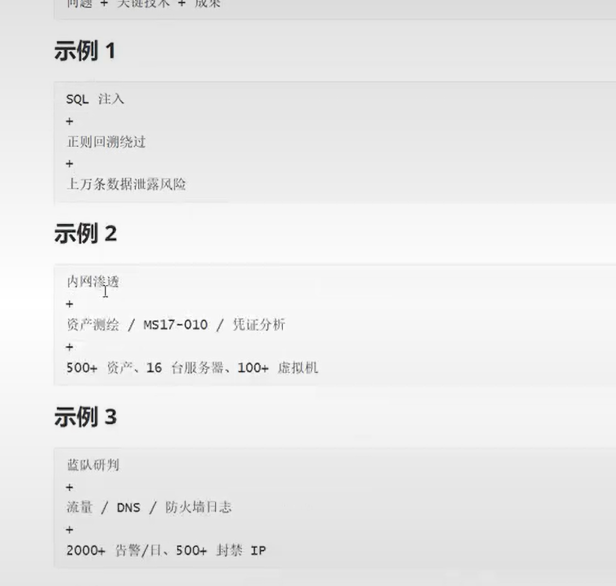
图 18:原描述强调框架机制,修改后把开源排名、工具调用、可视化与测试数量提到前面。
精简版本首先呈现可验证结果:参与腾讯云黑客松并取得第 3 名;完成 Cairn 二次开发;接入 DeepSeek,使 Agent 能自主调用 curl、nmap 等工具;主导 AI 渗透可观测系统,实现攻击行为实时展示、过程复盘和 HTML/Markdown 报告自动生成;完成 Windows 部署适配、中文化和模型接入,并通过 88 项回归测试及端到端验证。
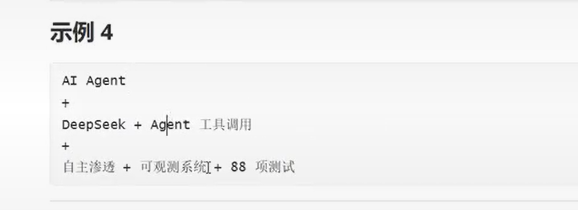
图 19:项目以赛事结果和可验证交付为主线,架构机制被保留为技术面试的深入问题。
进一步压缩后,条目仍能留下四个清晰锚点:黑客松第 3 名、Agent 自主工具调用、渗透过程可视化和 88 项回归测试。
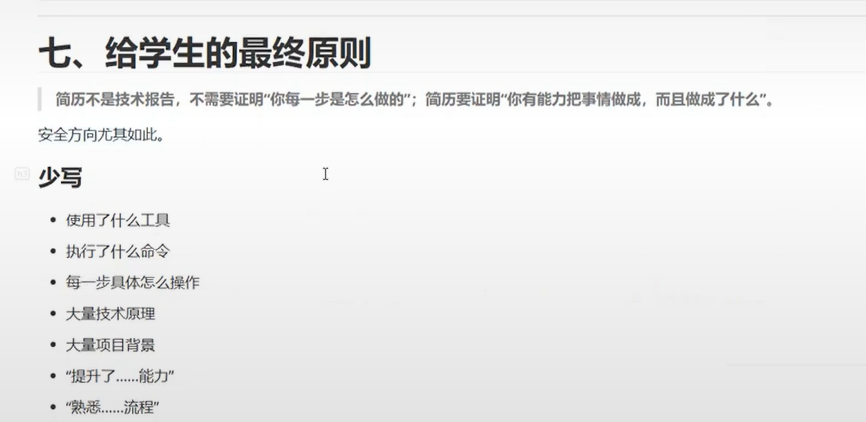
图 20:精简条目让赛事名次、系统能力和测试覆盖先被看到。
课程明确反对让大量 AI 架构术语成为主角。HR 首先需要看懂项目有没有结果;进入技术面试后,再展开 Fact/Intent/Hint、黑板架构、多 Agent 协作和闭环决策等实现细节。

图 21:先展示名次、工具能力、可视化系统与测试数量,再在技术面试中解释底层设计。
第六项修改:没有量化结果时不要强行制造内容
高考重保安全值守本身没有更多量化成果。原描述写了设备运行、网络流量、告警监测、异常识别和风险上报,修改后仅保留一句:参与高考网络安全重保,负责安全设备、网络流量及安全告警监测,及时研判异常访问并完成风险上报。

图 22:当项目没有更多可证实的数字时,一句话说明职责和处置结果即可。
这项修改避免了一个常见误区:量化并不等于每条经历都必须出现夸张数字。能够核验时写数字,缺少记录时就写清范围和结果。为了增加篇幅而虚构告警数量、事件数量或影响范围,后续面试很难自洽。
从六项修改归纳出的表达框架
原始写法为什么像技术报告
原始写法通常按时间顺序记录:“使用什么工具、执行什么操作、如何绕过、如何提权、如何横向、最后发现什么”。它忠实保留了实验过程,却要求筛选者自行从大量细节中提取价值。

图 23:原始思维沿工具、命令、绕过、提权和横向逐步展开,技术很多,但不适合简历首轮阅读。
改写后的问题链更短:解决了什么问题,采用了什么关键技术,最终取得什么结果,结果能否量化。这一结构不是删除因果,而是把真正影响筛选决定的因果放到前面。

图 24:改写后的主线由问题、关键技术、成果和量化组成。
课程给出四个示例来说明这种组合方式:SQL 注入加正则回溯,对应数据泄露风险;内网渗透加资产测绘、MS17-010 与凭证分析,对应资产、服务器和虚拟机数量;蓝队研判加流量、DNS 与防火墙日志,对应告警和封禁数量;AI Agent 加 DeepSeek 和工具调用,对应自主渗透、可观测系统与 88 项测试。

图 25:示例把漏洞或岗位场景、关键技术和量化结果组合成可快速识别的项目证据。

图 26:AI 项目以模型接入和工具调用为关键技术,以自主渗透、可视化和测试覆盖为结果。
少写什么与多写什么
应当减少的是工具清单、命令清单、逐步操作、大段原理、冗长背景,以及“提升了某项能力”“熟悉了某个流程”等无法验证的自我评价。

图 27:课程建议减少工具、命令、操作细节、原理背景和泛化能力描述。
应当增加的是发现了什么、解决了什么、关键技术是什么、拿到什么结果、影响范围多大、数量是多少。最理想的结构被概括为“漏洞类型、关键技术、攻击结果、量化数据”。其中“攻击结果”与“量化数据”常常相互重叠,但二者仍需分别检查:前者说明发生了什么,后者说明规模有多大。

图 28:课程建议围绕问题、解决动作、关键技术、结果、影响范围与数量组织内容。
一句话总结就是:把“做过什么”改写为“做成了什么”。技术细节并没有丢失,而是从简历正文转移到面试问答材料。

图 29:简历先呈现结果,技术细节在面试追问中展开。
对当前简历的总体评价与学习建议
与往届样本相比,本次两份简历已经投入了更多思考,也呈现了真实项目的轮廓。但问题仍然明显:第一份长段落过于拥挤,容易让筛选者直接放弃阅读;第二份虽然好一些,仍有内容臃肿、技术对象混写和量化不足等问题。

图 30:整体页面显示大段文本占据主要空间,读者难以在短时间内抓住项目层级和成果。
课程提出一个简单的自测方法:把简历交给同学阅读,观察对方是否愿意继续看、能否迅速复述候选人的核心项目。如果熟悉候选人的人都觉得页面拥挤、重点模糊,那么陌生的 HR 更难从中判断能力。
讲师随后用个人见闻提醒学员,不要根据室友或同学表面的状态安排自己的准备节奏。有人在活动中看似没有参与太多,实际上已经把获得的经历整理成简历并很快找到工作;一个人说了什么、表面上在做什么,与其真实准备可能并不一致。因而,周围同学只能构成很小的参照样本,真正的竞争者还可能包括其他学校的本科生、研究生和有相似项目经验的人。
这段经验判断的重点并不是制造焦虑,而是纠正比较对象。学历能够决定一部分机会的门槛,却不能保证进入后的岗位、职级和长期发展。讲师用金融专业朋友从名校毕业、在深圳就业、经历投资损失,后来通过面试进入杭州科技系统工作的经历说明:即使教育背景突出,个人仍会面对同层竞争、职业选择与风险。进入大厂同样不代表结果已经稳定,后续绩效和岗位变化仍可能带来淘汰。
简历准备需要紧迫感,但不需要把焦虑建立在对室友或同学的猜测上。更可靠的做法是核对自己的项目证据、反复修改表达,并以更广的求职市场作为比较范围。
回看往届简历:项目多不等于证据强
课程随后按原顺序回看往届简历。第一份旧简历先列教育背景和大量“熟悉”项,包括 Web 漏洞、安全工具、Linux、Docker、Git、安全设备、编程语言、数据库和网络协议。这些条目覆盖面很广,却缺少项目证据,筛选者无法判断“熟悉”达到什么程度。

图 31:技能列表覆盖多个方向,但缺乏与项目成果之间的对应关系。
技能页继续堆叠 Python、PHP、Java、C、MySQL、TCP/IP、HTTP、HTTPS、DHCP、VLAN、GRE、MPLS-VPN、MSTP 和 VRRP 等名称。问题仍然相同:名词越多,越需要真实项目说明掌握深度,否则只会扩大面试核验范围。

图 32:工具、语言、协议和网络技术被集中罗列,却没有形成可验证的能力层级。
蓝队经历缺少结果 渗透经历存在技术因果错误
旧简历的护网经历按“护网前、护网中、护网后”记录工作,包含资产梳理、流量监控、防火墙封堵、蜜罐溯源和报告整理,但没有告警数量、封禁数量、事件类型或结果。阶段标题本身也没有增加多少信息。
同一页的渗透测试经历则过于具体:通过系统指纹确认 ThinkPHP,利用漏洞写入 WebShell,连接后发现执行函数受限,再通过 mail 函数获取环境信息,上传 Fscan 做内网扫描。接着,描述把 MySQL 服务与 Mimikatz 抓取服务密码直接连接起来,课程认为这一因果不成立:Mimikatz 面向 Windows 凭证,MySQL 是数据库服务,二者不能在没有中间条件的情况下被写成同一步骤。

图 33:护网部分缺少量化结果,渗透部分则把大量步骤和工具写进简历。
局部放大后还能看到,连接失败后又突然使用 SharpDecryptPwd 查找 Navicat 连接文件并继续连接,整个叙述缺少失败原因、凭证来源和恢复路径。若无法在面试中解释每一步,过度具体只会增加暴露矛盾的机会。

图 34:项目描述把 mail、Fscan、MySQL、Mimikatz 和 SharpDecryptPwd 连成流水线,却没有说明各步骤成立的条件。
靶场案例不能包装成真实项目
第二份往届简历同样先罗列技能,随后写入多个课堂或靶场案例。课程特别区分了真实早期漏洞与纯靶场练习:某贷款系统 SQL 注入来源于较早的真实案例,但其余内容仍按练习步骤书写,缺少发现的问题、解决方案和项目结果。

图 35:第二份旧简历同样以宽泛的工具和漏洞清单作为能力证明。
贷款系统案例详细列出参数污染、PHP 参数选择、i_d 替换和 WAF 绕过步骤,最后只写“加深了对 SQL 注入的理解”。这类“项目收获”无法替代风险结果,也无法说明案例对真实业务产生了什么影响。

图 36:案例记录了课堂操作步骤,但结尾停留在个人学习感受,没有形成业务或安全结果。
更严重的问题出现在 SSRF + Redis 未授权访问案例。简历称通过 SSRF 访问 6379 端口,写入任务计划,再由 Ubuntu 在 12345 端口监听到反弹 Shell。课程指出,这个环境中的任务计划文件权限会成为限制:写入文件为 644,而 Ubuntu 任务计划要求 600,所以描述中的成功结果与前置条件冲突。

图 37:案例把端口探测、文件写入、任务计划和反弹 Shell 写成连续成功步骤。
当错误步骤被单独标出后,问题非常直观。如果候选人无法解释文件权限为何满足执行条件,技术面试官会判断该经历未经真实验证,甚至可能是拼接或编造。

图 38:标出的“Ubuntu 监听到反弹 Shell”缺少满足任务计划权限要求的依据。
【小白通俗注解】课程不是在这里提供利用方法,而是在检查简历叙述是否自洽。任何安全实验都应保留授权靶场或教学环境,并且成功结论必须与环境条件和实际输出一致。
另一项 GET 型 CSRF 案例把反序列化位置、__destruct、PwdDelayRun、autoload、include、命名空间和 StdClass 等过程全部展开,仍然以“加深理解”作为收获。技术细节很多,却没有说明项目背景、真实影响和可量化结果。

图 39:案例逐项列出代码分析和绕过步骤,但缺少真实场景、结果与影响范围。
长亭 WAF 绕过案例则明确呈现出靶场搭建痕迹:搭建雷池 WAF、宝塔面板和 sqli-labs,再构造不同 payload 验证绕过。这类实验可以作为学习记录,却不应被包装成真实企业项目,更不能凭空补充业务成果。

图 40:项目内容集中在环境搭建与 payload 验证,缺乏真实授权项目中的对象、范围和成果。
对比之下,本次学员的攻防演练已经更接近真实项目表达:有客户委托背景、有累计 12 份漏洞报告、有三个不同能力的典型案例,也明确为技术面试保留深入追问的空间。

图 41:当前案例以项目成果和典型问题组织内容,比逐步复述靶场操作更具真实性。
这也是课程对本届简历“有所提升但仍需继续修改”的依据:方向已经从课堂步骤转向真实经历,但仍要继续消除拥挤、错误名词、未经核验的数字和不必要的工具细节。
精简之后如何准备面试追问
简历通过筛选后,技术面试会沿着精简条目展开。蓝队经历可能被问到:研判过哪些告警,病毒感染事件如何处理,DNS 流量与防火墙策略如何关联,X-Forwarded-For 头丢失为什么会影响真实攻击源 IP 的判断。候选人需要把简历中删掉的证据重新组织为口头答案,而不是因为正文精简就忽略细节准备。

图 42:告警研判、病毒响应、DNS 误报和源 IP 定位都可成为后续核验问题。
高校信息管理系统项目可能被追问:低权限数据库账户如何进一步影响服务器,横向验证的边界是什么,vCenter 漏洞为何成立,是否了解 Docker 未授权访问或逃逸相关风险。回答时需要区分实际做过的验证、了解但未执行的知识,以及课堂示例中的数字。

图 43:MSSQL、Fscan、vCenter、Docker 与最终影响范围构成主要追问入口。
AI Agent 项目可能被问到设计理念、是否用于真实授权测试、实际结果、优势、劣势和后续改进方向。若简历只写“接入大模型”,答案会很空;精简条目保留了输入数据、参数生成、辅助脚本与人工验证,便于说明 AI 在流程中的真实位置。

图 44:攻击面分析、业务逻辑梳理、参数生成、Python 脚本与 Burp Suite 验证构成可核验链路。
WordPress 研究项目则会围绕漏洞成因、触发条件、攻击流程、复现环境、REST API Batch 路由缺陷、WP_Query SQL 注入与文档产出展开。简历正文不需要写成漏洞论文,但候选人必须能够解释研究结果。

图 45:项目保留漏洞编号、成因分析、复现对象和资料输出,便于面试继续核验。
复盘结论
这次修改最终收束到四项要求。第一,简历页面必须让人愿意读,长段落和过度拥挤会让真实能力失去展示机会。第二,项目描述先写问题和结果,再写足以区分能力的关键技术,完整工具链留给面试。第三,量化指标应建立项目尺度,但所有数字都必须能够回溯到真实记录。第四,技术对象、因果关系和环境条件必须自洽;一处产品混写、单位错误或不可能成功的步骤,就可能破坏整段经历的可信度。
课程最后强调,简历与技术学习同样重要。技术准备决定面试中能够回答到什么深度,简历表达决定是否能够获得这次回答的机会。面试结果仍会受到实力与临场状态影响,但在进入面试之前,候选人能够主动控制的主要变量,就是这份简历是否清楚、真实、可核验。
项目材料应当保留两套层次:简历版只呈现问题、关键技术、结果与量化范围;面试版保存失败尝试、调试过程、工具选择、授权边界和原始证据。前者争取追问,后者支撑追问。


评论前必须登录!
注册