 网硕互联帮助中心
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于大数据的多源影视数据整合质量评估与可视化分析介绍
- 基于大数据的多源影视数据整合质量评估与可视化分析演示视频
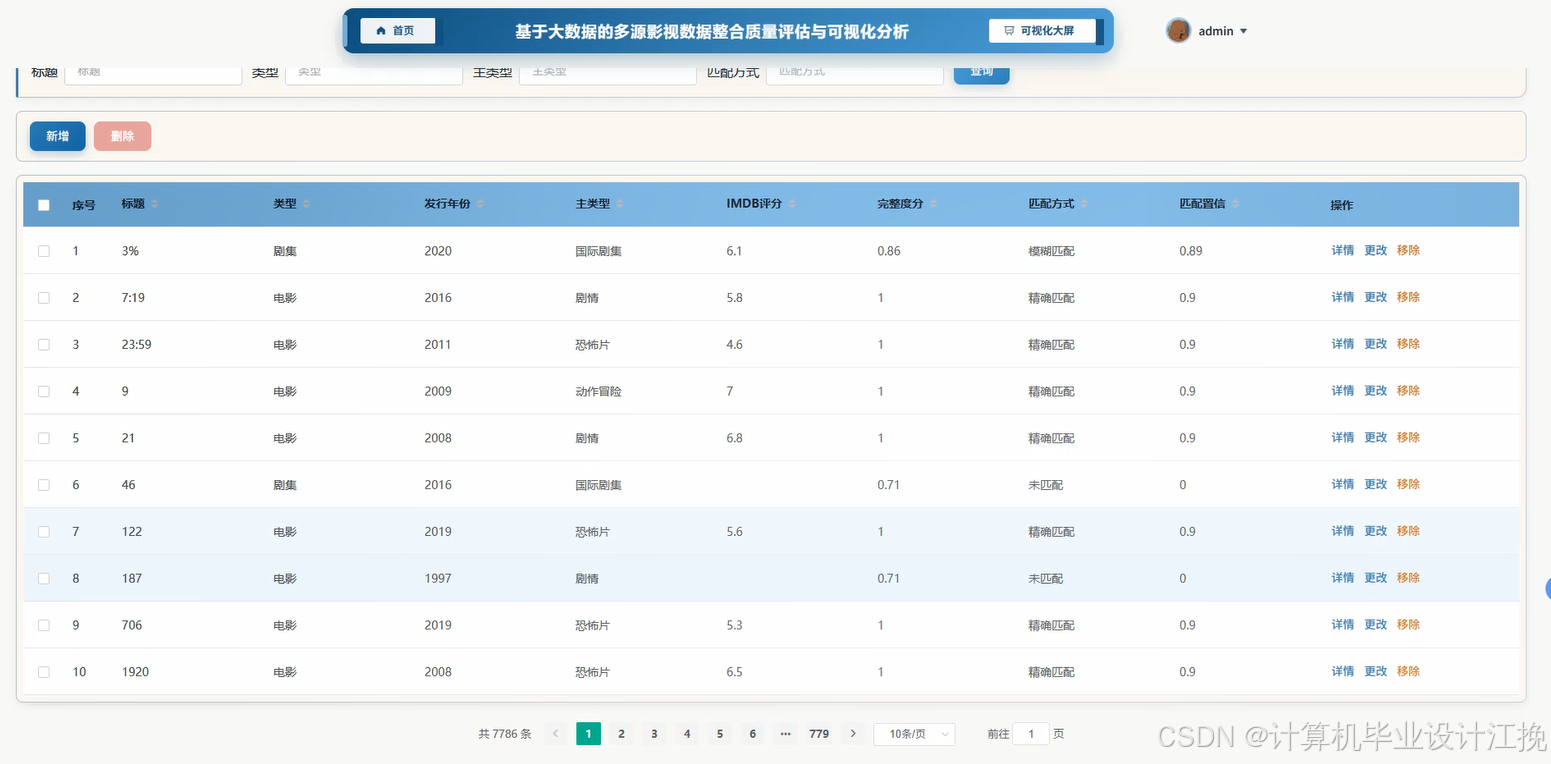
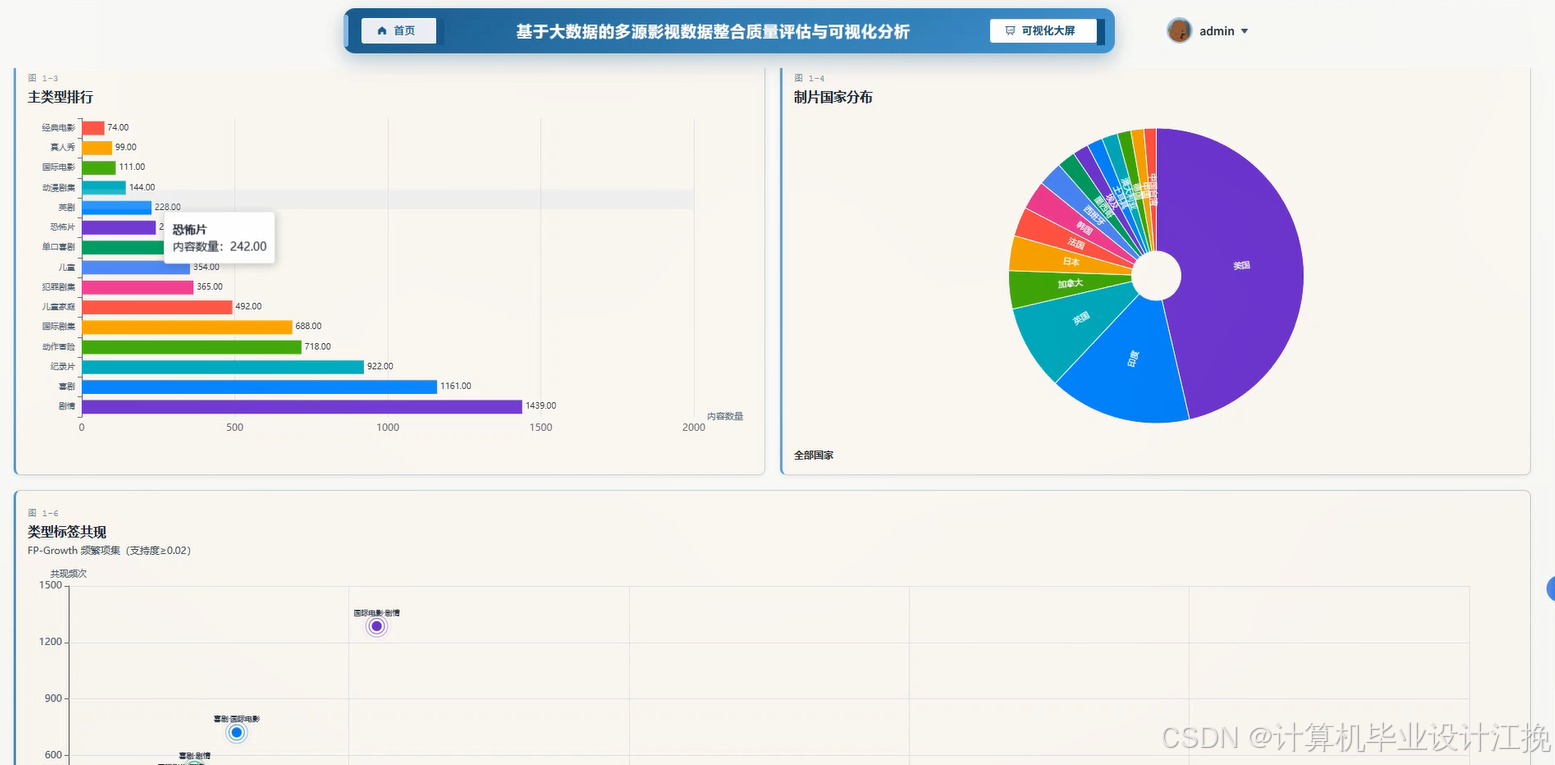
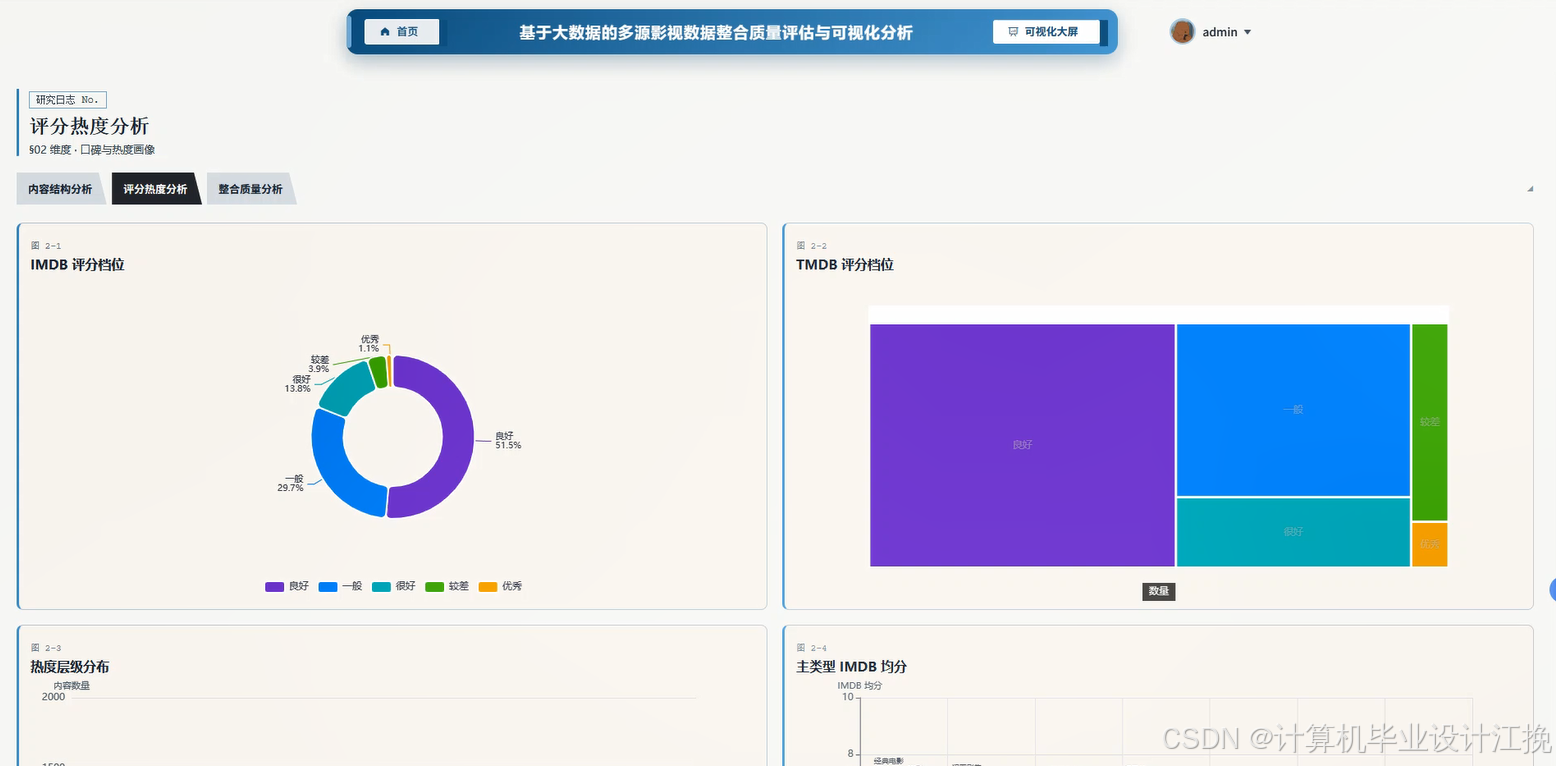
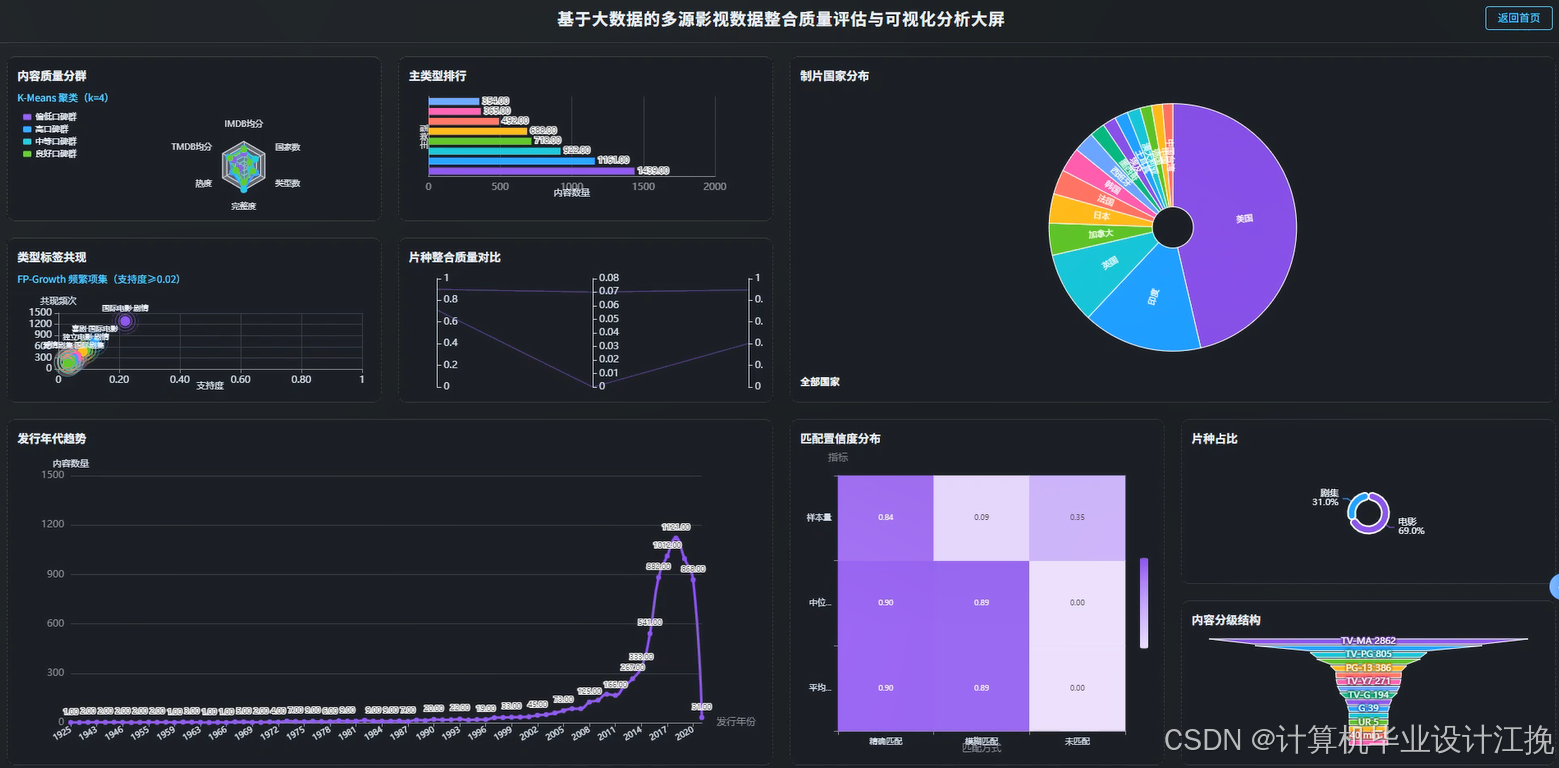
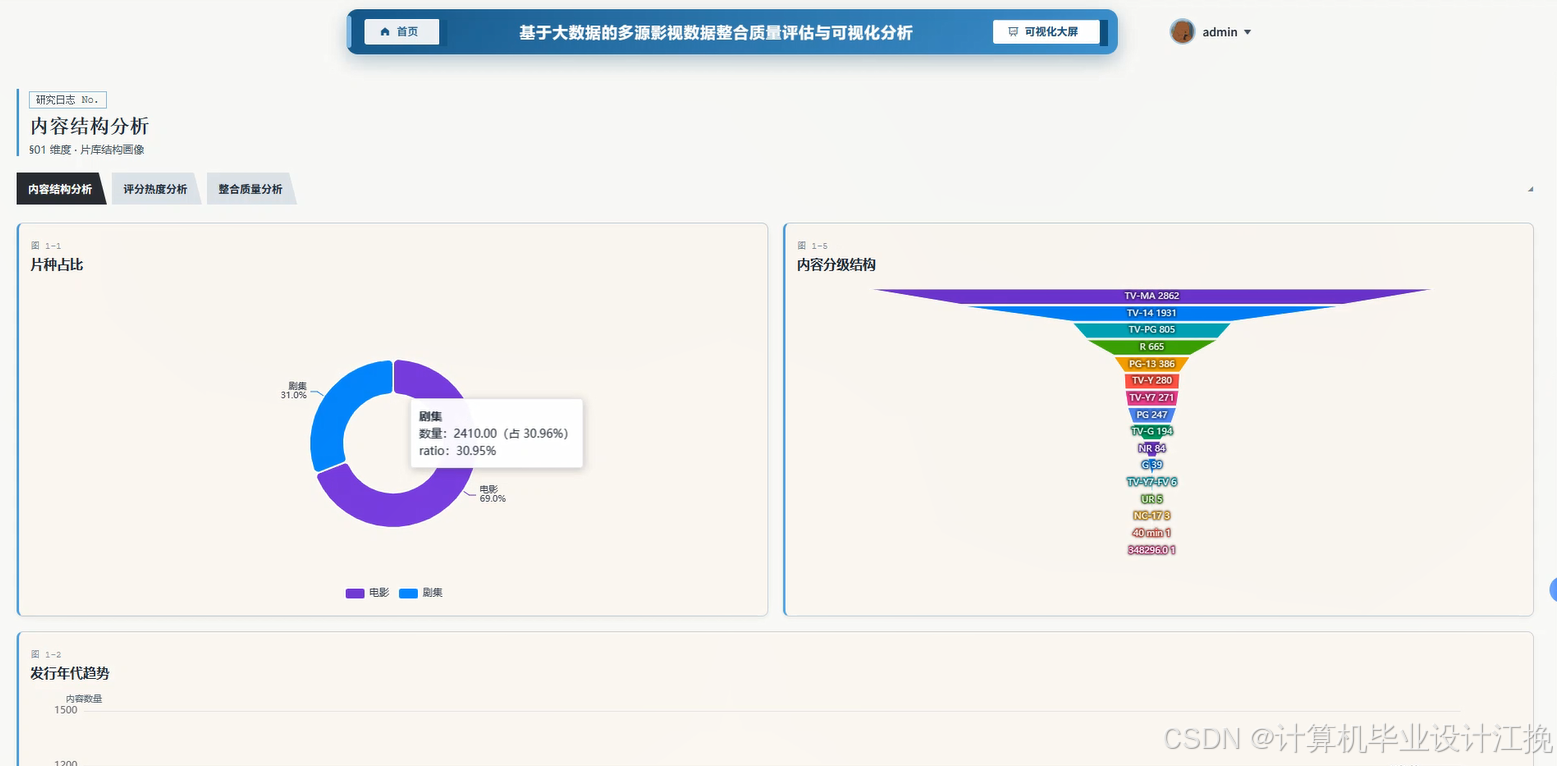
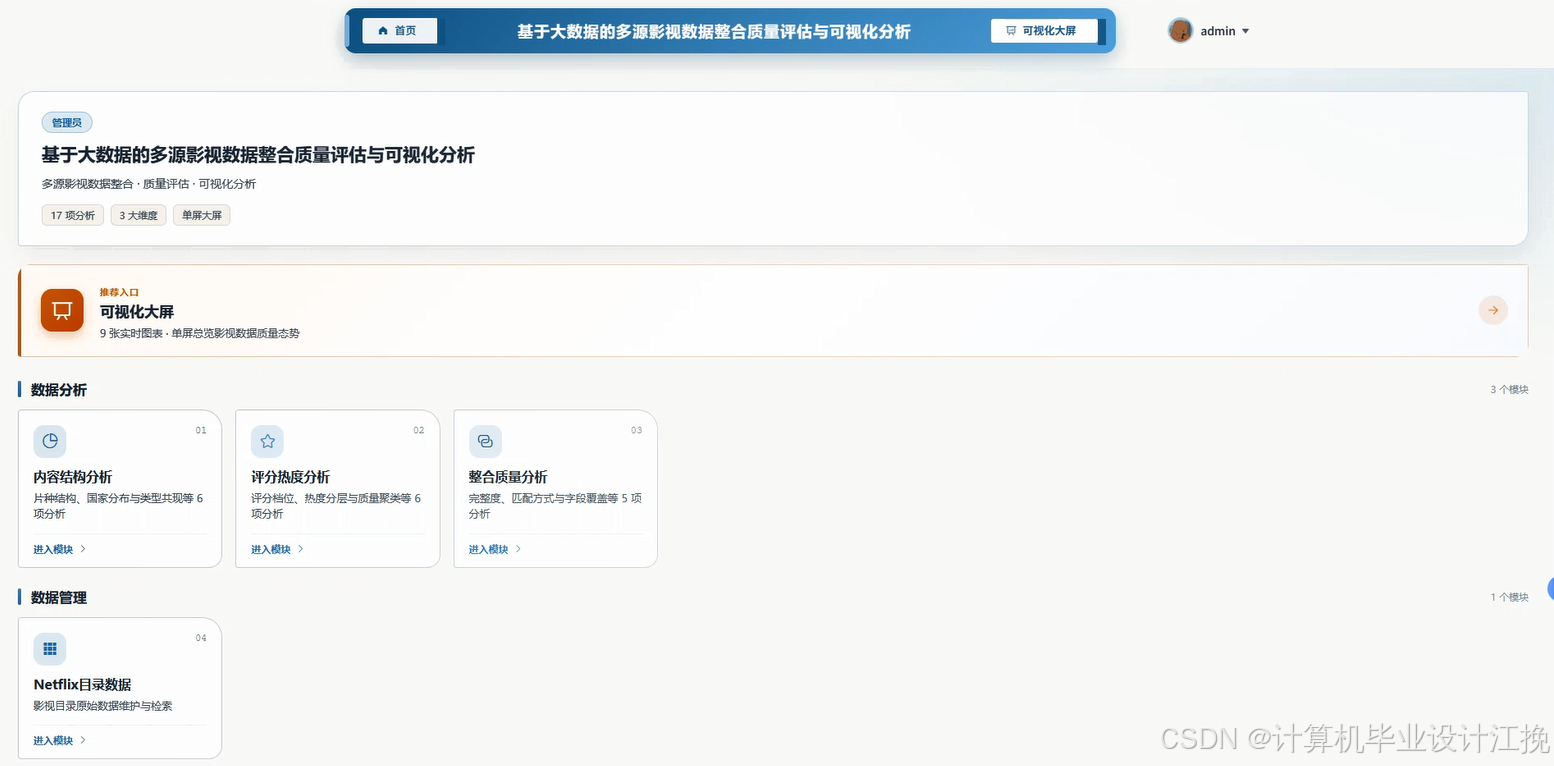
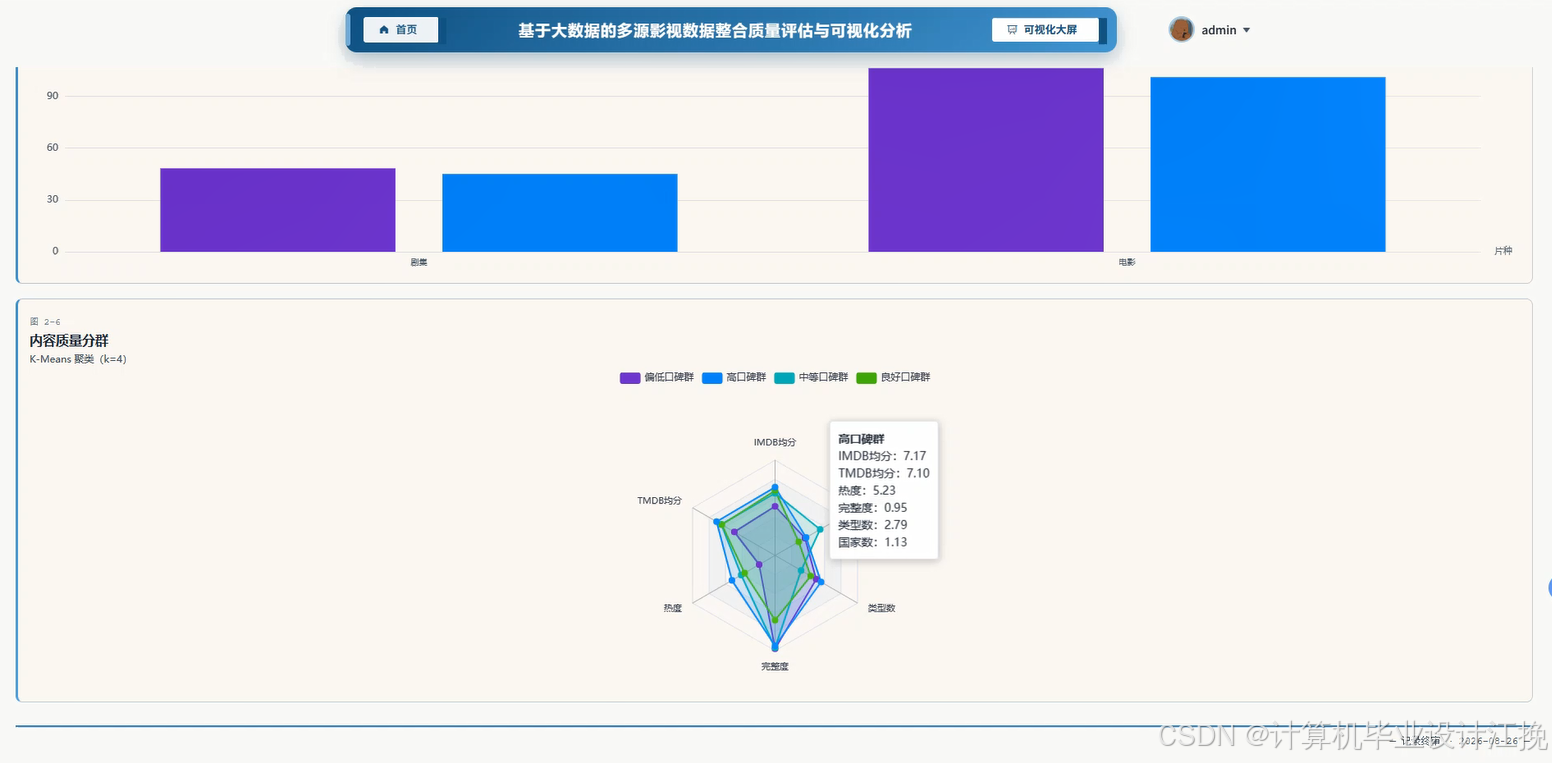
- 基于大数据的多源影视数据整合质量评估与可视化分析演示图片
- 基于大数据的多源影视数据整合质量评估与可视化分析代码展示
- 基于大数据的多源影视数据整合质量评估与可视化分析文档展示
基于大数据的多源影视数据整合质量评估与可视化分析介绍
本系统《基于大数据的多源影视数据整合质量评估与可视化分析》是一个面向Netflix影视目录数据的大数据分析平台,依托Hadoop分布式存储与Spark并行计算框架,对多源异构的影视数据进行ETL清洗、整合与质量评估。系统核心能力涵盖三个方面:一是数据整合层,通过Spark SQL对多张原始影视表进行字段映射、去重、空值填充与格式统一,形成标准化的事实数据宽表;二是质量评估层,从完整性(字段缺失率)、一致性(同一影视在不同源中的信息匹配度)、准确性(数值字段的合法范围校验)、时效性(数据更新时间戳)和唯一性(重复记录占比)五个维度构建加权评分模型,对每一条影视记录输出0-100分的综合质量评分;三是可视化分析层,基于ECharts构建9张实时联动图表,包括片种结构饼图、国家分布地图、热度评分散点图、评分档位柱状图、质量聚类雷达图、字段覆盖热力图、匹配方式桑基图、类型共现弦图以及质量趋势折线图,单屏总览影视数据质量态势。系统同时提供数据管理模块,支持对原始目录数据的条件检索、分页展示和手动修正,形成“数据接入→质量评估→可视化呈现→人工干预”的闭环流程,为影视数据治理提供可落地的技术参考方案。
基于大数据的多源影视数据整合质量评估与可视化分析演示视频
xxx
基于大数据的多源影视数据整合质量评估与可视化分析演示图片
基于大数据的多源影视数据整合质量评估与可视化分析代码展示
SparkSession spark = SparkSession.builder().appName("FilmDataQualityAssessment").master("local[*]").config("spark.sql.shuffle.partitions", "200").getOrCreate();
Dataset<Row> netflixDf = spark.read().option("header", "true").option("inferSchema", "true").csv("hdfs://master:9000/data/netflix_titles.csv");
Dataset<Row> imdbDf = spark.read().option("header", "true").option("inferSchema", "true").csv("hdfs://master:9000/data/imdb_ratings.csv");
Dataset<Row> tmdbDf = spark.read().option("header", "true").option("inferSchema", "true").json("hdfs://master:9000/data/tmdb_metadata.json");
Dataset<Row> integratedDf = netflixDf.join(imdbDf, netflixDf.col("title").equalTo(imdbDf.col("original_title")), "left").join(tmdbDf, netflixDf.col("title").equalTo(tmdbDf.col("name")), "left");
Dataset<Row> cleanedDf = integratedDf.na().fill("unknown", new String[]{"director", "cast", "country", "rating"}).na().fill(0, new String[]{"release_year", "duration_num"}).na().fill("N/A", new String[]{"listed_in", "description"});
Dataset<Row> dedupDf = cleanedDf.dropDuplicates(new String[]{"title", "release_year", "director"});
StructType schema = dedupDf.schema();
String[] fieldNames = schema.fieldNames();
double totalFields = fieldNames.length;
Dataset<Row> completenessScore = dedupDf.map((Row row) –> { int nonNullCount = 0; for (String field : fieldNames) { Object value = row.getAs(field); if (value != null && !value.toString().isEmpty() && !value.toString().equals("unknown") && !value.toString().equals("N/A")) { nonNullCount++; } } double score = (nonNullCount / totalFields) * 100; return RowFactory.create(row.getAs("title"), Math.round(score * 100.0) / 100.0); }, RowEncoder.apply(StructType.fromDDL("title string, completeness double")));
Dataset<Row> consistencyScore = dedupDf.map((Row row) –> { String netflixGenre = row.getAs("listed_in"); String tmdbGenre = row.getAs("genres"); double score = 0.0; if (netflixGenre != null && tmdbGenre != null && !netflixGenre.equals("N/A") && !tmdbGenre.equals("unknown")) { String[] netflixArr = netflixGenre.split(","); String[] tmdbArr = tmdbGenre.split(","); int matchCount = 0; for (String n : netflixArr) { for (String t : tmdbArr) { if (n.trim().equalsIgnoreCase(t.trim())) { matchCount++; break; } } } score = (matchCount / (double) Math.max(netflixArr.length, tmdbArr.length)) * 100; } return RowFactory.create(row.getAs("title"), Math.round(score * 100.0) / 100.0); }, RowEncoder.apply(StructType.fromDDL("title string, consistency double")));
Dataset<Row> accuracyScore = dedupDf.map((Row row) –> { Integer year = row.getAs("release_year"); Double duration = row.getAs("duration_num"); Integer imdbVotes = row.getAs("imdb_votes"); double score = 100.0; if (year != null && (year < 1900 || year > 2026)) { score -= 25; } if (duration != null && (duration <= 0 || duration > 500)) { score -= 25; } if (imdbVotes != null && imdbVotes < 0) { score -= 25; } String rating = row.getAs("rating"); if (rating != null && !rating.equals("N/A") && !rating.equals("unknown")) { if (!rating.matches("^(G|PG|PG-13|R|NC-17|TV-Y|TV-Y7|TV-G|TV-PG|TV-14|TV-MA)$")) { score -= 25; } } return RowFactory.create(row.getAs("title"), Math.max(0, Math.round(score * 100.0) / 100.0)); }, RowEncoder.apply(StructType.fromDDL("title string, accuracy double")));
Dataset<Row> timelinessScore = dedupDf.map((Row row) –> { String dateAdded = row.getAs("date_added"); double score = 50.0; if (dateAdded != null && !dateAdded.equals("N/A") && !dateAdded.equals("unknown")) { try { SimpleDateFormat sdf = new SimpleDateFormat("MMMM d, yyyy", Locale.US); Date date = sdf.parse(dateAdded); Date now = new Date(); long diff = now.getTime() – date.getTime(); long days = diff / (24 * 60 * 60 * 1000); if (days <= 365) { score = 100.0; } else if (days <= 730) { score = 75.0; } else if (days <= 1095) { score = 50.0; } else { score = 25.0; } } catch (ParseException e) { score = 30.0; } } return RowFactory.create(row.getAs("title"), score); }, RowEncoder.apply(StructType.fromDDL("title string, timeliness double")));
Dataset<Row> uniquenessScore = dedupDf.groupBy("title", "release_year").count().withColumnRenamed("count", "duplicate_count");
Dataset<Row> duplicateDf = uniquenessScore.filter(uniquenessScore.col("duplicate_count").gt(1));
List<String> duplicateTitles = duplicateDf.select("title").as(Encoders.STRING()).collectAsList();
Dataset<Row> uniquenessScoreFinal = dedupDf.map((Row row) –> { String title = row.getAs("title"); double score = duplicateTitles.contains(title) ? 60.0 : 100.0; return RowFactory.create(title, score); }, RowEncoder.apply(StructType.fromDDL("title string, uniqueness double")));
Dataset<Row> qualityScores = completenessScore.join(consistencyScore, "title").join(accuracyScore, "title").join(timelinessScore, "title").join(uniquenessScoreFinal, "title");
Dataset<Row> finalScore = qualityScores.map((Row row) –> { String title = row.getAs("title"); double completeness = row.getAs("completeness"); double consistency = row.getAs("consistency"); double accuracy = row.getAs("accuracy"); double timeliness = row.getAs("timeliness"); double uniqueness = row.getAs("uniqueness"); double total = completeness * 0.25 + consistency * 0.25 + accuracy * 0.20 + timeliness * 0.15 + uniqueness * 0.15; return RowFactory.create(title, Math.round(total * 100.0) / 100.0, completeness, consistency, accuracy, timeliness, uniqueness); }, RowEncoder.apply(StructType.fromDDL("title string, total_score double, completeness double, consistency double, accuracy double, timeliness double, uniqueness double")));
finalScore.createOrReplaceTempView("quality_view");
Dataset<Row> genrePie = spark.sql("SELECT listed_in, COUNT(*) as cnt FROM quality_view GROUP BY listed_in ORDER BY cnt DESC LIMIT 10");
Dataset<Row> countryBar = spark.sql("SELECT country, COUNT(*) as cnt FROM quality_view WHERE country != 'unknown' GROUP BY country ORDER BY cnt DESC LIMIT 15");
Dataset<Row> ratingHist = spark.sql("SELECT rating, COUNT(*) as cnt FROM quality_view WHERE rating != 'N/A' GROUP BY rating ORDER BY rating");
Dataset<Row> qualityScatter = spark.sql("SELECT title, total_score, imdb_score FROM quality_view JOIN integratedDf ON quality_view.title = integratedDf.title WHERE imdb_score IS NOT NULL");
Dataset<Row> qualityCluster = spark.sql("SELECT CASE WHEN total_score >= 80 THEN '优质' WHEN total_score >= 60 THEN '良好' WHEN total_score >= 40 THEN '一般' ELSE '较差' END as quality_level, COUNT(*) as cnt FROM quality_view GROUP BY quality_level");
Dataset<Row> fieldCoverage = spark.sql("SELECT 'completeness' as field, AVG(completeness) as avg_score FROM quality_view UNION SELECT 'consistency', AVG(consistency) FROM quality_view UNION SELECT 'accuracy', AVG(accuracy) FROM quality_view UNION SELECT 'timeliness', AVG(timeliness) FROM quality_view UNION SELECT 'uniqueness', AVG(uniqueness) FROM quality_view");
Dataset<Row> trendOverTime = spark.sql("SELECT date_added, COUNT(*) as cnt, AVG(total_score) as avg_score FROM quality_view JOIN integratedDf ON quality_view.title = integratedDf.title WHERE date_added != 'N/A' GROUP BY date_added ORDER BY date_added LIMIT 30");
genrePie.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "genre_statistics").option("user", "root").option("password", "123456").save();
countryBar.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "country_statistics").option("user", "root").option("password", "123456").save();
ratingHist.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "rating_statistics").option("user", "root").option("password", "123456").save();
qualityScatter.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "quality_scatter_data").option("user", "root").option("password", "123456").save();
qualityCluster.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "quality_cluster_data").option("user", "root").option("password", "123456").save();
fieldCoverage.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "field_coverage_data").option("user", "root").option("password", "123456").save();
trendOverTime.write().mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/film_db").option("dbtable", "trend_data").option("user", "root").option("password", "123456").save();
spark.stop();
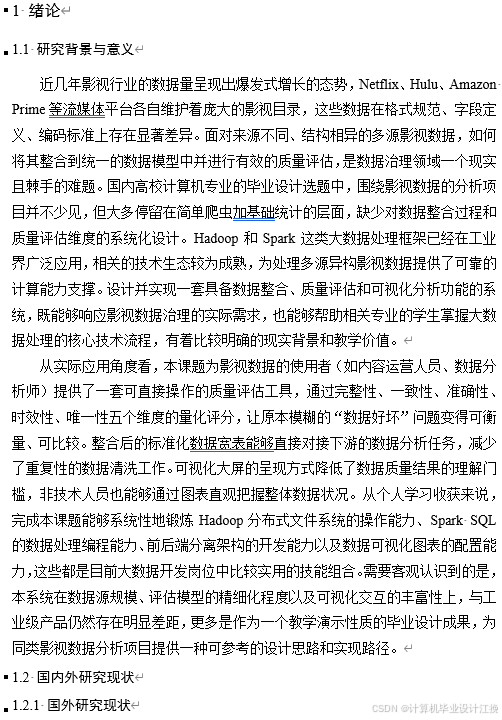
基于大数据的多源影视数据整合质量评估与可视化分析文档展示
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目


评论前必须登录!
注册