 网硕互联帮助中心
【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
23、【数学】【信息论】交叉熵为什么是
p
log
q
p\\log q
plogq 而不是
q
log
p
q\\log p
qlogp:方向、MLE 与前向 KL
背景
上篇 blog 【数学】【信息论】熵为什么只能是它:Shannon 公理与唯一性定理 用四条公理把熵的形式钉死了:连续、对称、均匀分布随类数单调增、分组递推。推导分三步——分组递推先给出均匀熵的可加性
A
(
n
m
)
=
A
(
n
)
+
A
(
m
)
A(nm)=A(n)+A(m)
A(nm)=A(n)+A(m),单调性夹逼解出
A
(
n
)
=
K
log
n
A(n)=K\\log n
A(n)=Klogn,再用一次分组递推把均匀推广到任意分布,得到唯一形式
H
=
−
K
∑
p
i
log
p
i
H=-K\\sum p_i\\log p_i
H=−K∑pilogpi;最后靠连续性从有理概率铺到全体实数。结论是:熵长成
−
∑
p
log
p
-\\sum p\\log p
−∑plogp 不是偏好,而是被公理唯一确定的。
到此为止,讨论的都是一个分布自己的不确定性。但现实里往往有两个分布:一个是数据背后的真实分布
P
P
P,一个是模型给出的预测分布
Q
Q
Q。本篇要度量的正是"用
Q
Q
Q 去描述
P
P
P 有多费劲"——这就是交叉熵,而它的方向问题(为什么是
P
log
Q
P\\log Q
PlogQ、不是
Q
log
P
Q\\log P
QlogP)是本篇的核心。
从"一个分布"到"两个分布"
熵
H
(
P
)
=
−
∑
x
P
(
x
)
log
P
(
x
)
H(P)=-\\sum_x P(x)\\log P(x)
H(P)=−∑xP(x)logP(x) 的输入只有一个分布:它回答"
P
P
P 自己平均有多不确定"。
可是在预测任务里,真相和猜测是分开的:真实标签服从某个分布
P
P
P,模型吐出一个分布
Q
Q
Q。想知道"模型离真相有多远",就需要一个同时吃进两个分布的量。最直接的想法是:拿
Q
Q
Q 去汇报
P
P
P 世界里真实发生的事,平均会有多意外? 这个"平均意外"就是交叉熵。
交叉熵的定义:谁当权重,谁进 log
交叉熵(cross-entropy) 定义为
H
(
P
,
Q
)
=
−
∑
x
P
(
x
)
log
Q
(
x
)
=
E
x
∼
P
[
−
log
Q
(
x
)
]
H(P,Q)=-\\sum_x P(x)\\log Q(x)=\\mathbb E_{x\\sim P}\\big[-\\log Q(x)\\big]
H(P,Q)=−x∑P(x)logQ(x)=Ex∼P[−logQ(x)]
逐项读这个式子,它依然是"信息量的加权平均":
-
−
log
Q
(
x
)
-\\log Q(x)
−logQ(x):结果x
x
x 的信息量,用的是预测分布Q
Q
Q; -
P
(
x
)
P(x)
P(x):权重,是结果x
x
x 在现实里的真实频率; -
∑
x
\\sum_x
∑x:对所有结果求平均。
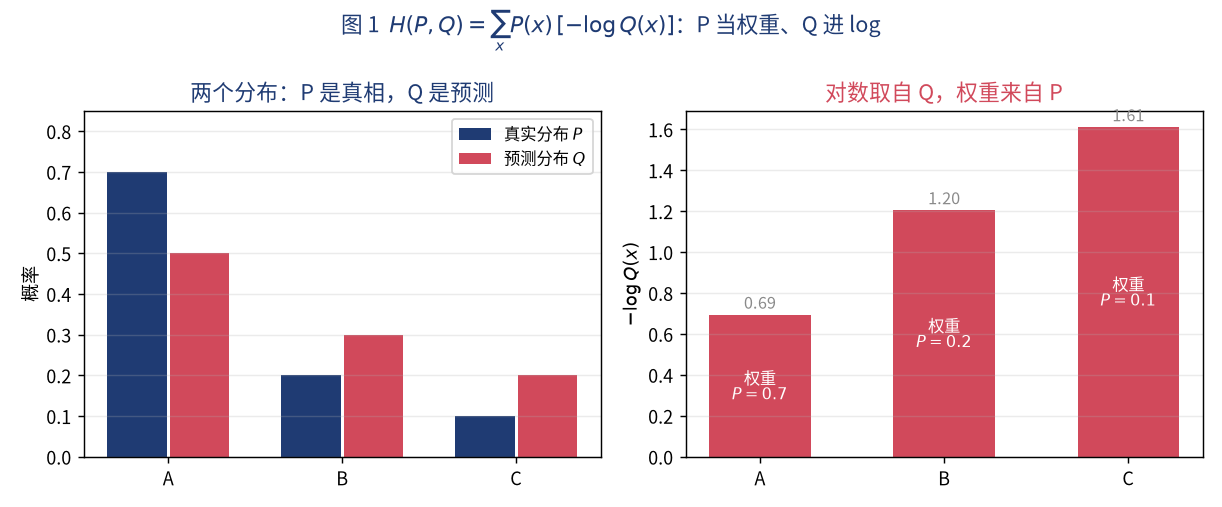
图 1 左边是两个分布的对比(
P
P
P 是真相、
Q
Q
Q 是预测),右边把
−
log
Q
(
x
)
-\\log Q(x)
−logQ(x) 画成柱、并在每根柱上标出它对应的权重
P
(
x
)
P(x)
P(x)。分工非常明确:
P
P
P 当权重,
Q
Q
Q 进
log
\\log
log。
带一组数字体会。设
P
=
[
0.7
,
0.2
,
0.1
]
P=[0.7,0.2,0.1]
P=[0.7,0.2,0.1]、
Q
=
[
0.5
,
0.3
,
0.2
]
Q=[0.5,0.3,0.2]
Q=[0.5,0.3,0.2]:
H
(
P
,
Q
)
=
−
(
0.7
ln
0.5
+
0.2
ln
0.3
+
0.1
ln
0.2
)
≈
0.887
H(P,Q)=-(0.7\\ln0.5+0.2\\ln0.3+0.1\\ln0.2)\\approx0.887
H(P,Q)=−(0.7ln0.5+0.2ln0.3+0.1ln0.2)≈0.887
Q
Q
Q 越贴近
P
P
P,平均越不意外,
H
(
P
,
Q
)
H(P,Q)
H(P,Q) 越小;当
Q
=
P
Q=P
Q=P 时,交叉熵退回成熵
H
(
P
)
H(P)
H(P)。
注意式子里
P
P
P 与
Q
Q
Q 的地位并不对等:
P
P
P 出现在权重位、
Q
Q
Q 出现在对数位。之后会看到,正是这个不对等造成两个方向的差异,也决定了训练时该选哪个方向。
熵与交叉熵:一张表看清
三个相关的量放在一起,差别只在"谁当权重、谁进 log":
| 熵
H ( P ) H(P) H(P) |
− ∑ x P log P -\\sum_x P\\log P −∑xPlogP |
P P P |
P P P |
P P P 自己的不确定性 |
| 交叉熵
H ( P , Q ) H(P,Q) H(P,Q) |
− ∑ x P log Q -\\sum_x P\\log Q −∑xPlogQ |
P P P |
Q Q Q |
用
Q Q Q 描述 P P P 的代价 |
| 反向交叉熵
H ( Q , P ) H(Q,P) H(Q,P) |
− ∑ x Q log P -\\sum_x Q\\log P −∑xQlogP |
Q Q Q |
P P P |
用
P P P 描述 Q Q Q 的代价 |
熵是交叉熵在
Q
=
P
Q=P
Q=P 时的特例;两个方向的交叉熵只有在
P
=
Q
P=Q
P=Q 时才相等。记住这张表,方向问题基本不会再错。
为什么权重必须是真实分布 P
关键的一问:既然式子是
−
∑
P
log
Q
-\\sum P\\log Q
−∑PlogQ,为什么权重非得是
P
P
P、而不是
Q
Q
Q?
答案藏在期望的写法
E
x
∼
P
[
⋅
]
\\mathbb E_{x\\sim P}[\\cdot]
Ex∼P[⋅] 里:权重就是"对谁取平均"。样本是从真实数据分布
P
P
P 里采出来的,所以"平均有多意外"必须按
P
P
P 来平均。若把权重换成
Q
Q
Q,算的就不再是"用
Q
Q
Q 描述真相的代价",而变成了"用真相描述
Q
Q
Q 的代价"——主客颠倒。
换个说法:"实际发生了什么"决定怎么加权,"模型猜了什么"决定惊讶大小。 前者是权重
P
P
P,后者进
log
\\log
log 的是
Q
Q
Q。如果反过来写
−
∑
Q
log
P
-\\sum Q\\log P
−∑QlogP,weight 变成了模型的信念、
log
\\log
log 里放的是真相,那是在问"模型有多相信自己",对训练没有意义。
从最大似然到交叉熵
上面的"采样视角"可以做成严格推导,结论完全一致。这正是最大似然估计(Maximum Likelihood Estimation,MLE) :
有一批从
P
P
P 采出的独立样本
x
1
,
…
,
x
N
x_1,\\dots,x_N
x1,…,xN,模型
Q
Q
Q 对它们的对数似然是
∑
i
log
Q
(
x
i
)
\\sum_i\\log Q(x_i)
∑ilogQ(xi)。按大数定律,样本频率会收敛到真实概率,于是
1
N
∑
i
log
Q
(
x
i
)
=
∑
x
P
^
(
x
)
log
Q
(
x
)
→
N
→
∞
∑
x
P
(
x
)
log
Q
(
x
)
\\frac1N\\sum_i\\log Q(x_i)=\\sum_x \\hat P(x)\\log Q(x)\\ \\xrightarrow[N\\to\\infty]{}\\ \\sum_x P(x)\\log Q(x)
N1i∑logQ(xi)=x∑P^(x)logQ(x)
N→∞ x∑P(x)logQ(x)
其中
P
^
\\hat P
P^ 是经验分布(样本里各结果出现的频率)。最大化对数似然就是最小化它的相反数:
max
Q
∑
x
P
(
x
)
log
Q
(
x
)
⟺
min
Q
(
−
∑
x
P
(
x
)
log
Q
(
x
)
)
=
min
Q
H
(
P
,
Q
)
\\max_Q\\sum_x P(x)\\log Q(x)\\quad\\Longleftrightarrow\\quad\\min_Q\\Big(-\\sum_x P(x)\\log Q(x)\\Big)=\\min_Q H(P,Q)
Qmaxx∑P(x)logQ(x)⟺Qmin(−x∑P(x)logQ(x))=QminH(P,Q)
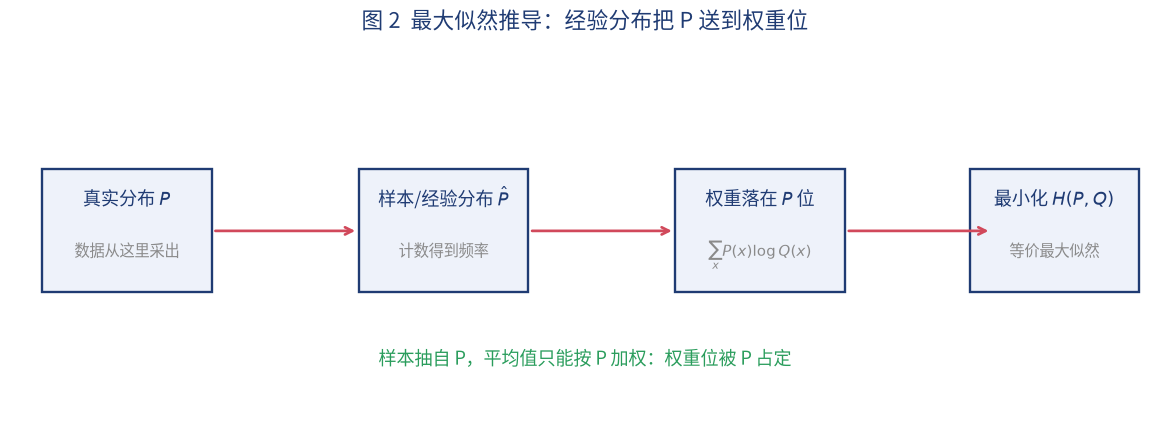
图 2 把这条链画成流程:数据从
P
P
P 采出 → 计数得到经验分布
P
^
\\hat P
P^ → 平均时权重只能按
P
P
P 加权 → 最小化交叉熵等价于最大似然。顺带一提,这个目标对 logits 的梯度形式很干净(第 235 篇提过),是它适合做训练损失的另一个原因。推导里"权重位"是被采样动作自己占定的,不是人为选择——这就是
P
log
Q
P\\log Q
PlogQ 而不是
Q
log
P
Q\\log P
QlogP 的最硬依据:训练的目标是让模型解释数据,而不是让数据解释模型。
拆开来看:交叉熵 = 熵 + KL
交叉熵和熵只差一块,把
log
Q
=
log
P
+
log
Q
P
\\log Q=\\log P+\\log\\frac{Q}{P}
logQ=logP+logPQ 代进去就能拆:
H
(
P
,
Q
)
=
−
∑
x
P
(
x
)
log
P
(
x
)
−
∑
x
P
(
x
)
log
Q
(
x
)
P
(
x
)
=
H
(
P
)
+
K
L
(
P
∥
Q
)
H(P,Q)=-\\sum_x P(x)\\log P(x)-\\sum_x P(x)\\log\\frac{Q(x)}{P(x)}=H(P)+\\mathrm{KL}(P\\|Q)
H(P,Q)=−x∑P(x)logP(x)−x∑P(x)logP(x)Q(x)=H(P)+KL(P∥Q)
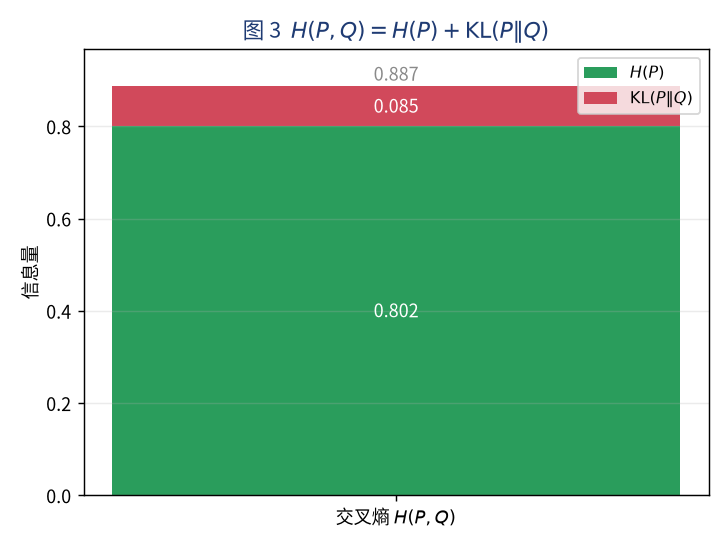
图 3 用刚才的例子把它画成堆叠条:
H
(
P
)
≈
0.802
H(P)\\approx0.802
H(P)≈0.802,再加
K
L
(
P
∥
Q
)
≈
0.085
\\mathrm{KL}(P\\|Q)\\approx0.085
KL(P∥Q)≈0.085,得到交叉熵
0.887
0.887
0.887。因为
H
(
P
)
H(P)
H(P) 是真实分布自己的、训练时改不动,所以
最小化
H
(
P
,
Q
)
⟺
最小化
K
L
(
P
∥
Q
)
\\text{最小化 }H(P,Q)\\quad\\Longleftrightarrow\\quad\\text{最小化 }\\mathrm{KL}(P\\|Q)
最小化 H(P,Q)⟺最小化 KL(P∥Q)
也就是让预测分布
Q
Q
Q 无限贴近真实分布
P
P
P。这就是语言模型训练在做的事。
one-hot 特例:塌缩成一项
第 13 篇讲过的塌缩,在这里再看一次会更有感触。语言模型的真实标签是 one-hot(独热) 向量:正确 token 那一维是
1
1
1、其余是
0
0
0。把它代进交叉熵求和:
H
(
P
,
Q
)
=
1
×
(
−
log
Q
(
正确
)
)
+
∑
其它
0
×
(
⋯
)
=
−
log
Q
(
正确
)
H(P,Q)=1\\times\\big(-\\log Q(\\text{正确})\\big)+\\sum_{\\text{其它}}0\\times(\\cdots)=-\\log Q(\\text{正确})
H(P,Q)=1×(−logQ(正确))+其它∑0×(⋯)=−logQ(正确)
除正确项以外,所有项都被权重
P
=
0
P=0
P=0 乘没了,求和塌缩成一项,即负对数似然(Negative Log-Likelihood,NLL) 。这解释了训练里一个常见现象:一个位置的损失只取决于模型给正确 token 的概率,给得越高、损失越小。
这也正是第 13、14 篇那条链的落点:one-hot 让"完整的交叉熵"退化成"只看正确答案的
−
log
Q
-\\log Q
−logQ",而蒸馏等场景里教师给的软标签不是 one-hot,此时完整形式(求和不塌缩)才重新派上用场。
反过来写会怎样
如果偏要把方向倒过来,得到的是反向交叉熵:
H
(
Q
,
P
)
=
−
∑
x
Q
(
x
)
log
P
(
x
)
=
H
(
Q
)
+
K
L
(
Q
∥
P
)
H(Q,P)=-\\sum_x Q(x)\\log P(x)=H(Q)+\\mathrm{KL}(Q\\|P)
H(Q,P)=−x∑Q(x)logP(x)=H(Q)+KL(Q∥P)
它和
H
(
P
,
Q
)
H(P,Q)
H(P,Q) 一般不相等。同一个例子:
H
(
P
,
Q
)
≈
0.887
H(P,Q)\\approx0.887
H(P,Q)≈0.887,而
H
(
Q
,
P
)
≈
1.122
H(Q,P)\\approx1.122
H(Q,P)≈1.122。
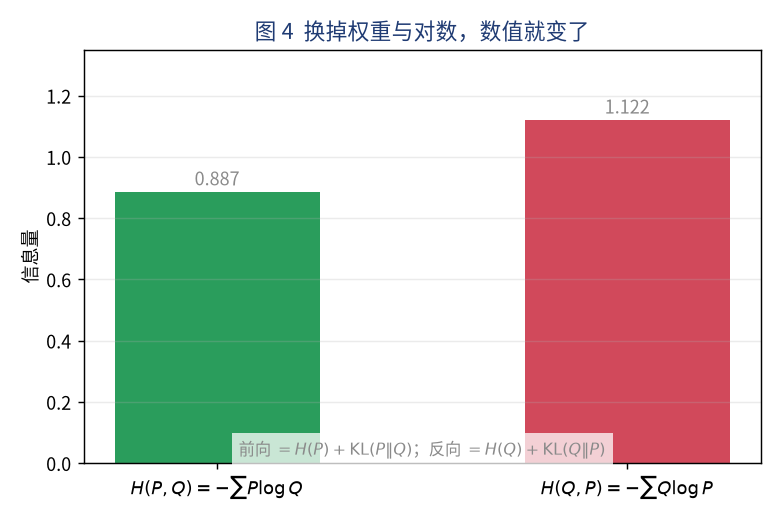
图 4 对比两个方向:前向是
H
(
P
)
+
K
L
(
P
∥
Q
)
H(P)+\\mathrm{KL}(P\\|Q)
H(P)+KL(P∥Q),反向是
H
(
Q
)
+
K
L
(
Q
∥
P
)
H(Q)+\\mathrm{KL}(Q\\|P)
H(Q)+KL(Q∥P),数值不同。反向除了"主客颠倒",还有一个致命问题:当真实标签是 one-hot(第 13、14 篇)时,
P
P
P 在很多维上是
0
0
0,而
−
∑
Q
log
P
-\\sum Q\\log P
−∑QlogP 里会出现
log
0
\\log 0
log0,直接发散——这样的目标根本没法训练。而
H
(
P
,
Q
)
H(P,Q)
H(P,Q) 里
P
=
0
P=0
P=0 的项被权重乘没,恰好塌缩成
−
log
Q
(
正确
)
-\\log Q(\\text{正确})
−logQ(正确),干净可用。
方向之差牵出的"两个 KL 谁更合适",是一组更细的取舍,留到下一篇展开。
两个常见疑问
- “交叉熵一定不小于熵吗?”:是。由
H
(
P
,
Q
)
=
H
(
P
)
+
K
L
(
P
∥
Q
)
H(P,Q)=H(P)+\\mathrm{KL}(P\\|Q)
H(P,Q)=H(P)+KL(P∥Q) 且 KL 恒非负,立刻得H
(
P
,
Q
)
≥
H
(
P
)
H(P,Q)\\ge H(P)
H(P,Q)≥H(P),等号只在Q
=
P
Q=P
Q=P 时成立。交叉熵的下界就是熵,这也说明"用错的分布描述真相,只会多付代价、不会更省"。 - “交叉熵会不会算成负数?”:当
Q
(
x
)
>
0
Q(x)>0
Q(x)>0 时不会。每一项−
P
(
x
)
log
Q
(
x
)
-P(x)\\log Q(x)
−P(x)logQ(x) 里−
log
Q
(
x
)
≥
0
-\\log Q(x)\\ge0
−logQ(x)≥0(因为Q
(
x
)
≤
1
Q(x)\\le1
Q(x)≤1)、P
(
x
)
≥
0
P(x)\\ge0
P(x)≥0,加权求和自然非负。实践中用 log-sum-exp 稳定计算(第 235 篇讲过),也不会因为数值下溢出负。
小结
交叉熵
H
(
P
,
Q
)
=
−
∑
x
P
(
x
)
log
Q
(
x
)
H(P,Q)=-\\sum_x P(x)\\log Q(x)
H(P,Q)=−∑xP(x)logQ(x) 是"用预测分布
Q
Q
Q 去汇报真实分布
P
P
P 的平均意外",分工是
P
P
P 当权重、
Q
Q
Q 进 log。权重必须是
P
P
P,因为样本从真实分布采出、平均值只能按
P
P
P 加权;从最大似然出发的推导会自然把
P
P
P 送到权重位,并证明"最大似然 = 最小化交叉熵"。拆开后有
H
(
P
,
Q
)
=
H
(
P
)
+
K
L
(
P
∥
Q
)
H(P,Q)=H(P)+\\mathrm{KL}(P\\|Q)
H(P,Q)=H(P)+KL(P∥Q),于是最小化交叉熵就是让
Q
Q
Q 逼近
P
P
P。反过来写
H
(
Q
,
P
)
=
H
(
Q
)
+
K
L
(
Q
∥
P
)
H(Q,P)=H(Q)+\\mathrm{KL}(Q\\|P)
H(Q,P)=H(Q)+KL(Q∥P) 数值不同、且在 one-hot 下发散,不能用来训练。下一篇专门比较这两个方向的 KL:为什么它不对称、前向和反向各自在优化什么。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!! 【数学】【信息论】KL 为什么不对称:前向与反向散度各自在优化什么




评论前必须登录!
注册