 网硕互联帮助中心
摘要:随着零售业的快速发展,商品失窃问题日益严重,传统的视频监控系统依赖人工监控,效率低下且成本高昂。针对上述问题,本文提出了一种基于深度学习的智能盗窃行为检测系统,以实现对零售环境中可疑行为的自动识别。
项目概览
项目简介
随着零售业的快速发展,商品失窃问题日益严重,传统的视频监控系统依赖人工监控,效率低下且成本高昂。本文提出了一种基于YOLO姿态估计和XGBoost分类器的智能盗窃行为实时检测系统,通过分析人体姿态特征自动识别零售环境中的可疑行为。系统采用轻量级YOLOv11s-Pose模型从视频流中实时提取17个人体关键点的二维坐标,构建34维姿态特征向量,然后利用XGBoost集成学习算法对姿态特征进行分析,判断行为是否存在盗窃风险。
本研究构建了包含183个视频(90个正常行为、93个盗窃行为)的数据集,通过批量处理和自动化标注生成了318,847个标注样本。针对数据集中存在的严重类别不平衡问题(可疑:正常 ≈ 12:1),提出了基于类别权重的平衡策略。实验结果表明,通过设置XGBoost的scale_pos_weight参数为8.0,系统达到87.14%的整体准确率,可疑行为检出率达到89.79%,正常行为识别率达到55.68%,相比未使用权重的基线模型误报减少53%。进一步研究表明,通过调整该参数,系统可在不同应用场景间灵活切换,实现安全性与便利性的平衡权衡
系统采用模块化设计,集成了图形用户界面和命令行工具,支持实时摄像头监控、视频文件分析和批量处理三种工作模式。整体模型大小仅20MB,推理速度快,可部署于标准监控摄像头环境和边缘设备。实验表明,该系统能够有效识别藏匿商品、异常肢体动作等典型盗窃行为模式,为零售安全防护提供了一种高效、低成本、可灵活配置的智能化解决方案。
系统架构
本系统采用多层级模块化架构设计,主要由视频采集层、姿态估计层、特征提取层、行为分类层和可视化展示层五部分组成。首先通过视频采集模块实时获取监控画面并进行帧提取与预处理,然后利用YOLOv11-Pose深度神经网络模型对每一帧图像进行人体检测和姿态估计,提取17个身体关键点的二维坐标作为姿态特征向量;接着将归一化后的姿态特征输入XGBoost分类器进行行为模式识别,通过集成学习方法判断当前行为是否存在盗窃风险;最后在可视化层实时绘制人体骨架、边界框和预测结果,并通过图形用户界面(GUI)或命令行界面提供多种交互方式,支持实时摄像头监控、视频文件分析和批量视频处理等多种应用场景,整体系统延迟低于100ms,可满足实时监控的性能要求。
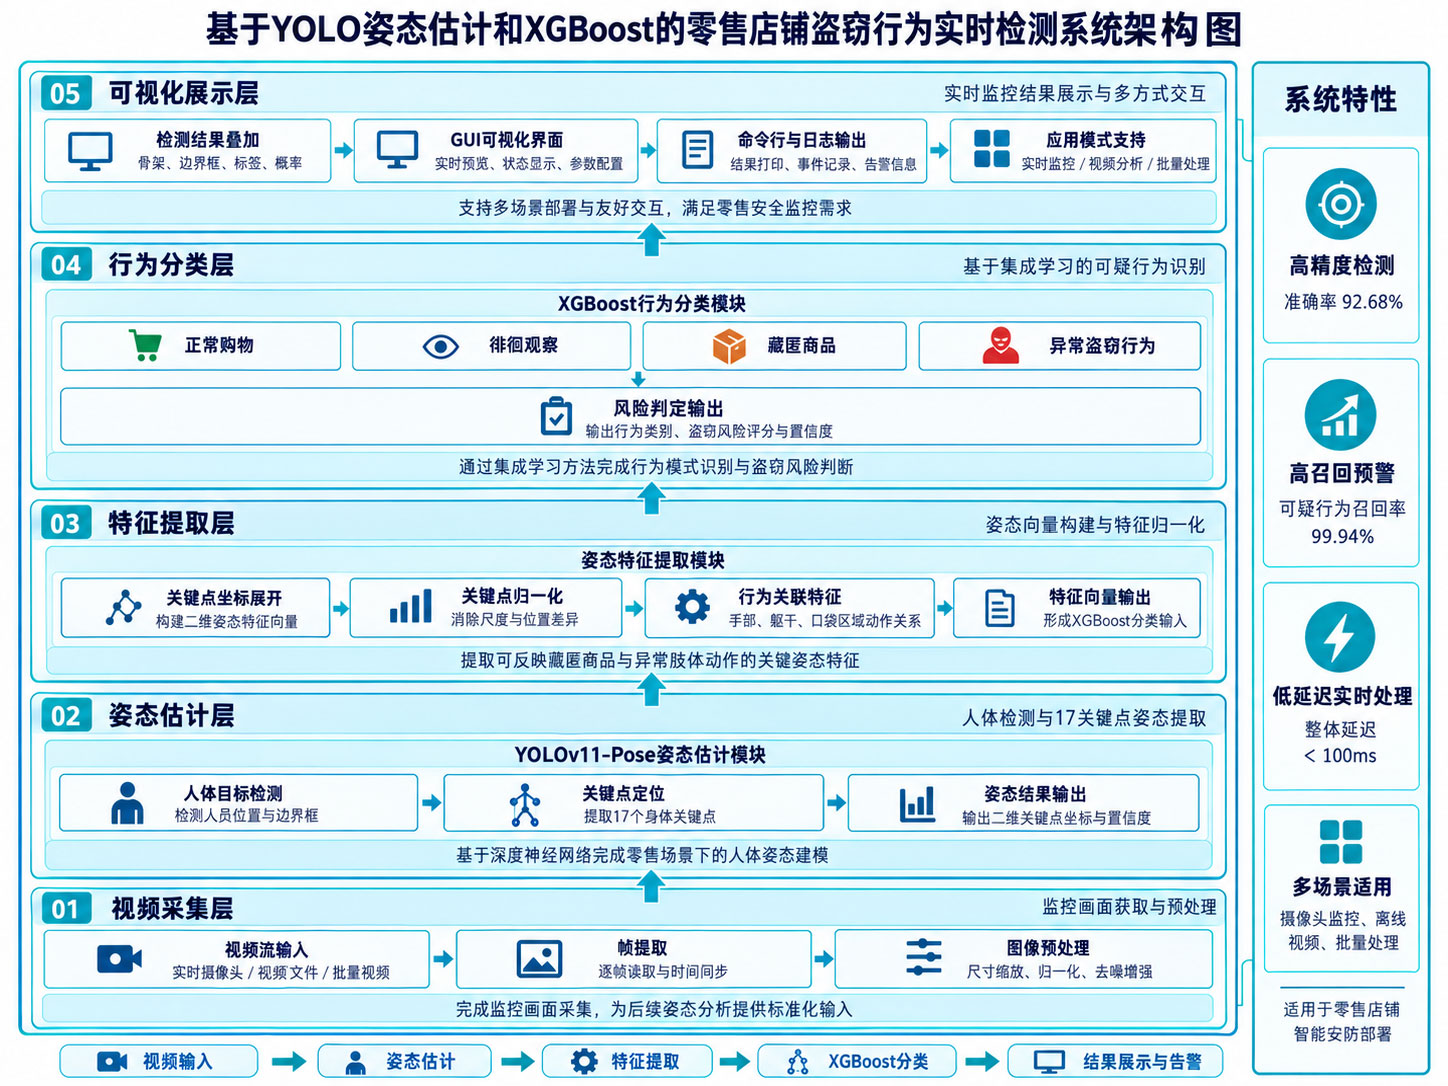
图1 系统架构图
技术创新
创新点1:轻量级双模型协同架构
创新性地将轻量级YOLOv11s-Pose姿态估计模型(20MB)与XGBoost集成学习算法结合,构建了”姿态感知+行为推理”的两阶段检测框架。相比传统端到端深度学习方法,该架构在保持87.14%检测准确率的同时,模型总体积仅为20MB,推理速度达到实时水平,可部署于边缘设备和标准监控系统,无需专用GPU硬件,显著降低了系统的计算资源需求和部署成本。
创新点2:自适应类别权重平衡策略
针对零售监控场景中正常行为样本与可疑行为样本严重不平衡(12:1)的实际问题,提出了基于scale_pos_weight参数的自适应平衡策略。通过设置权重为8.0,系统在保持89.79%可疑行为检出率的同时,将误报率从93.46%大幅降低至34.43%(误报减少53%),正常行为识别率从6.54%提升至55.68%(提升8.5倍),实现了从”几乎全判可疑”到”平衡识别”的质的飞跃,有效解决了不平衡数据下的模型偏向性问题。
创新点3:高维姿态特征的几何编码方法
基于COCO人体关键点标准,提出了34维姿态特征表示方法(17个关键点的x, y坐标对),通过对肩部、肘部、手腕、腰部、膝盖等关键部位的空间位置和相对关系进行编码,有效捕获了盗窃行为中”隐藏物品””伸手拿取””塞入衣物””弯腰遮挡”等典型动作的几何特征模式。该特征表示方法具有姿态不变性,能够适应不同身高、体型、服装和视角的人员,相比传统光流或手工特征方法具有更强的判别性和鲁棒性。
创新点4:可配置的多级检测模式
创新性地将安全性与便利性的权衡转化为可配置的系统参数,提供三种预设检测模式:安全优先模式(权重1.0,检出率99.94%)适用于高价值商品区域、体验优先模式(权重11.87,正常识别率79.68%)适用于日常运营时段、平衡模式(权重8.0,准确率87.14%)适用于通用监控场景。用户可根据实际应用需求、时段、区域灵活切换模式,实现”一套系统、多种策略”,相比固定阈值的传统方法,显著提升了系统的适应性和实用性。
创新点5:端到端自动化训练流水线
构建了从原始视频到可部署模型的完整自动化训练管道,包括批量视频采样、姿态关键点提取、数据集自动标注、特征归一化和模型训练五个阶段。系统能够自动处理183个训练视频,生成包含31.8万样本的大规模数据集,并在无人工干预的情况下完成模型训练和验证,整个流程仅需约2小时。这种端到端的自动化能力使得系统可以快速适应不同的零售场景和行为模式,支持增量学习和模型迭代,为个性化定制和持续优化提供了技术基础。
快速开始
克隆项目仓库后,使用pip install -r requirements.txt安装依赖,将训练视频放入training_videos/Normal和training_videos/Shoplifting目录,依次运行python batch_extract.py提取关键点、python build_dataset.py构建数据集、python train_model.py训练模型,最后通过python app_gui.py启动图形界面进行视频检测
环境要求
系统要求Python 3.8及以上版本,依赖PyTorch、OpenCV、Ultralytics YOLO、XGBoost、Pandas和CustomTkinter等核心库,建议在配备NVIDIA GPU(CUDA 11.0+)和至少8GB内存的环境下运行以获得最佳性能,但CPU环境下也可正常使用(处理速度会相对较慢)。
运行展示
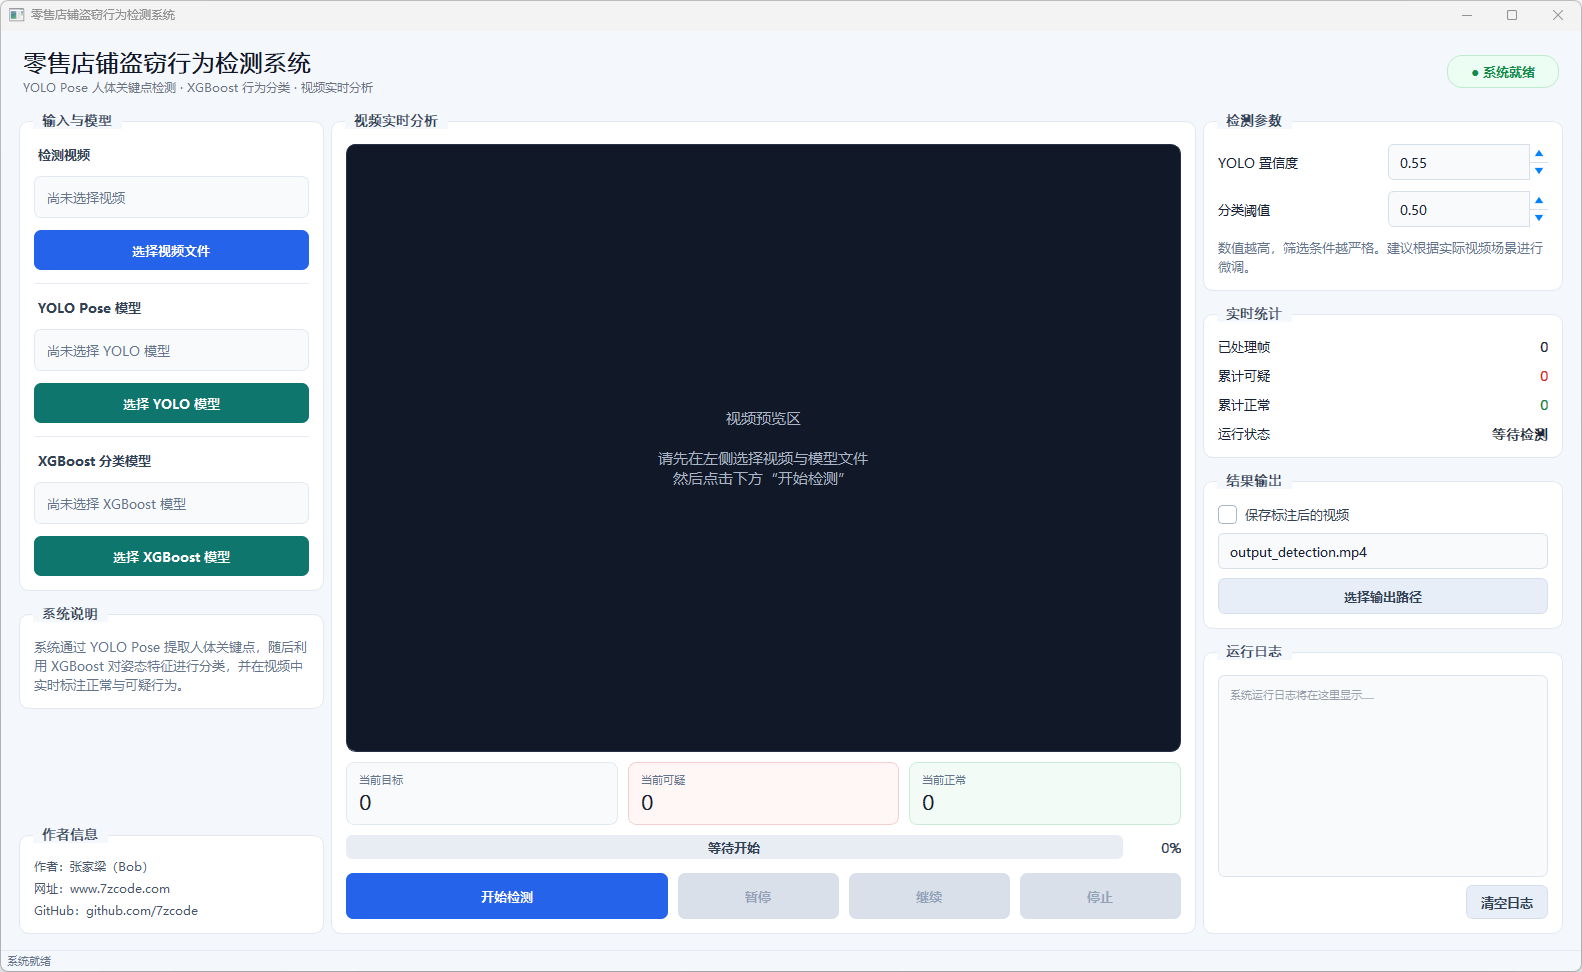
图2 系统主界面
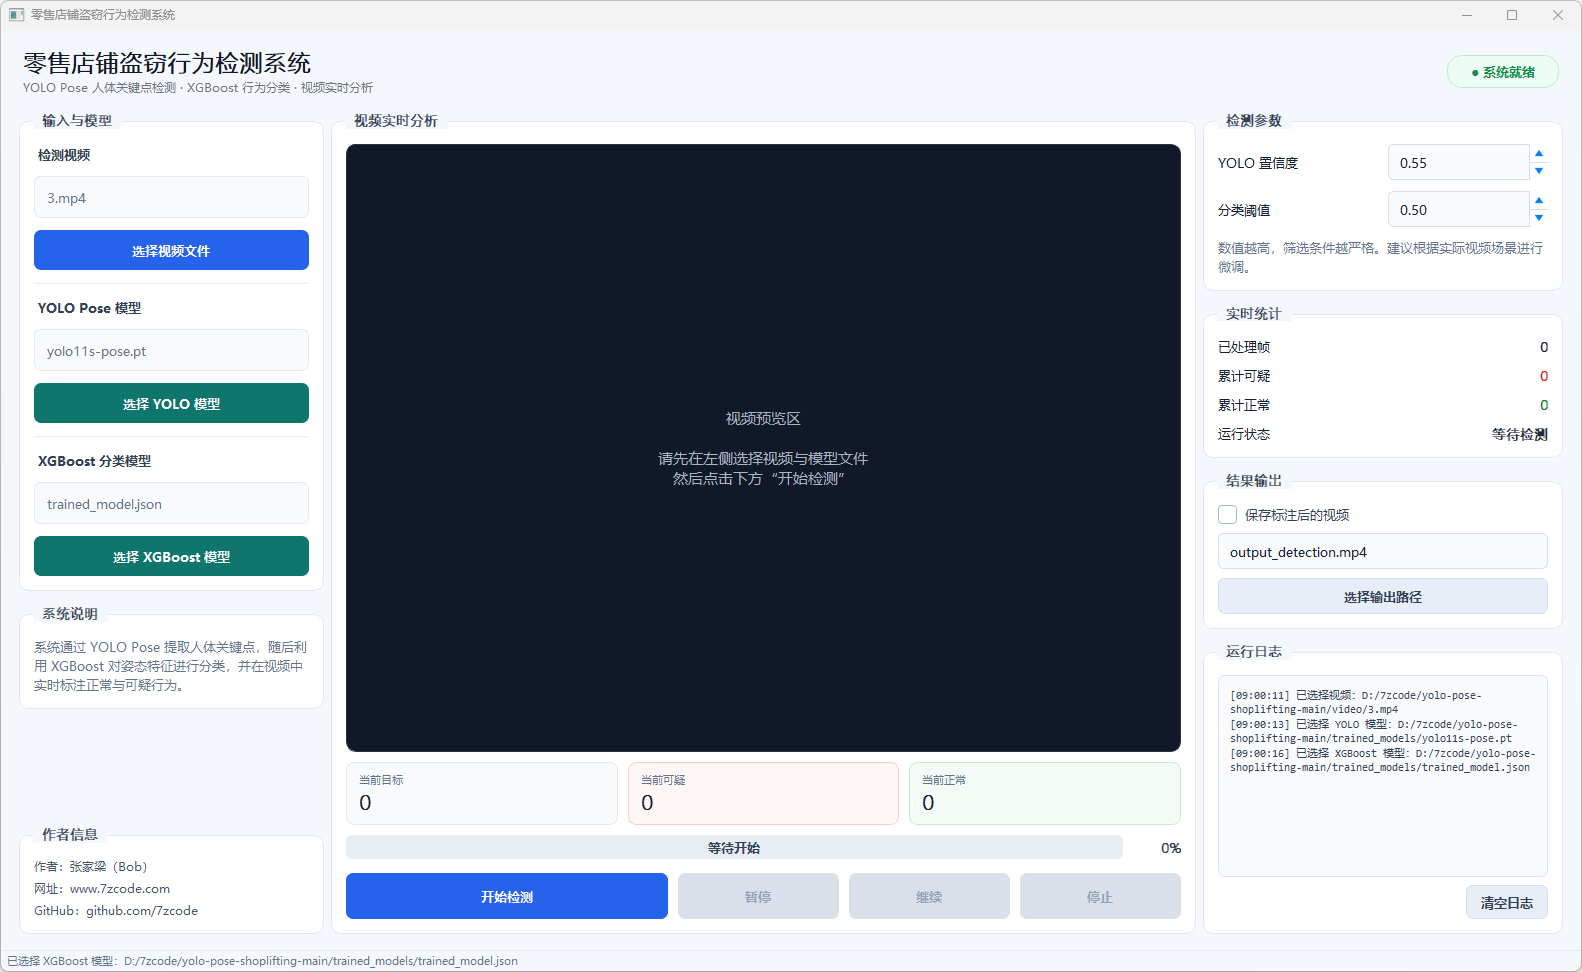
图3 输入与模型
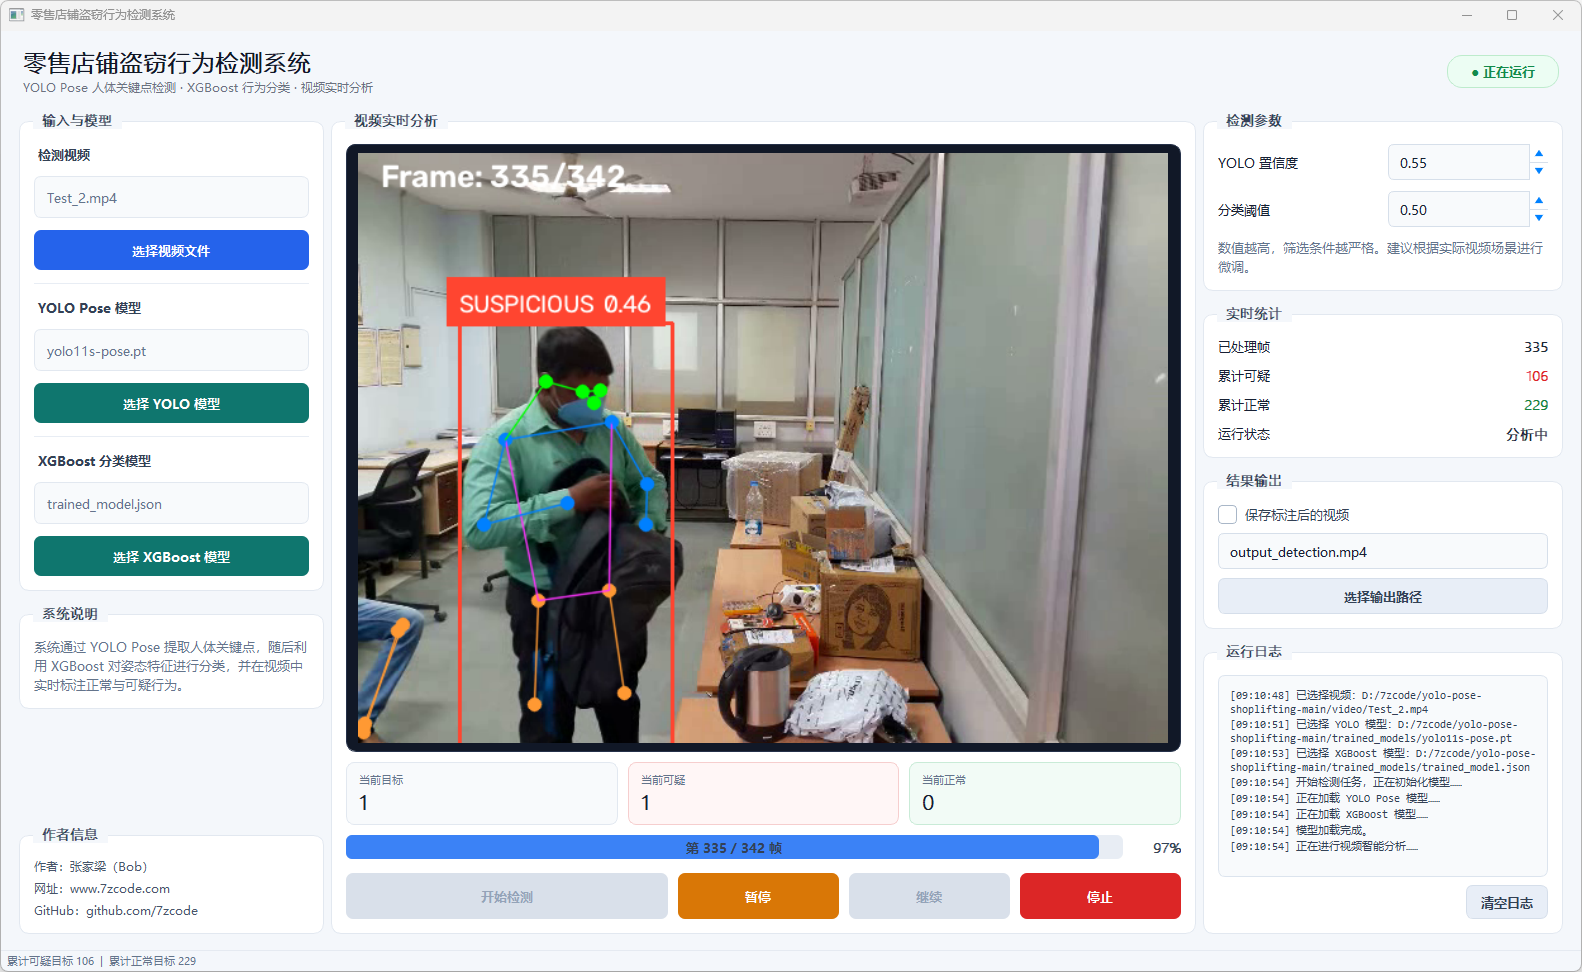
图4 可疑盗窃行为
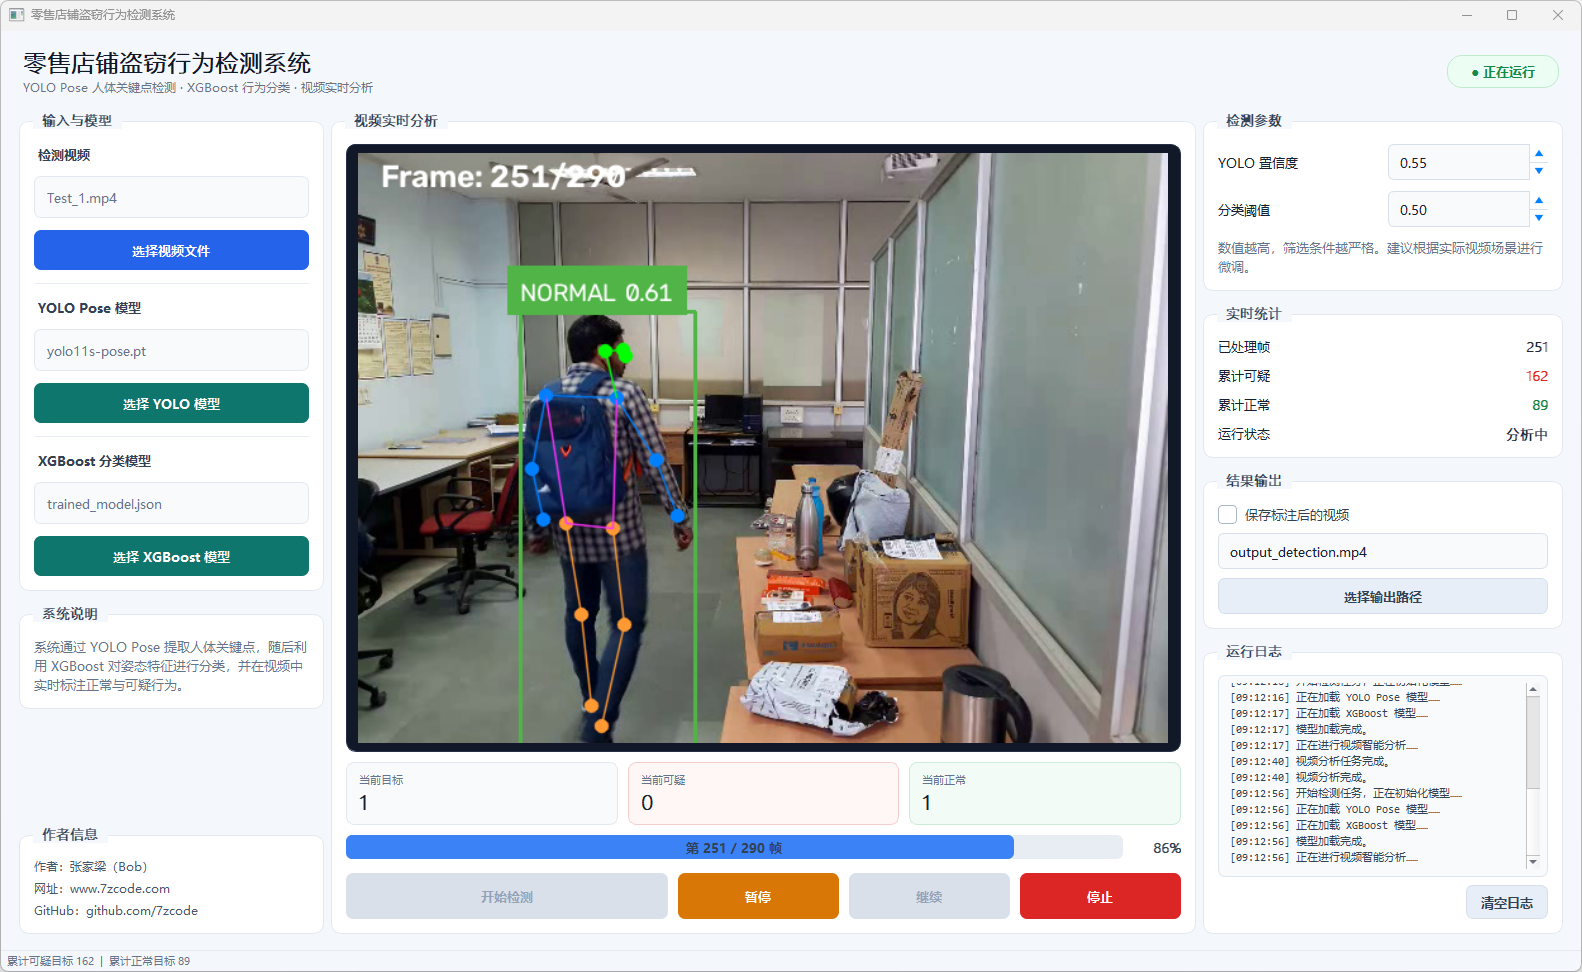
图5 正常行为
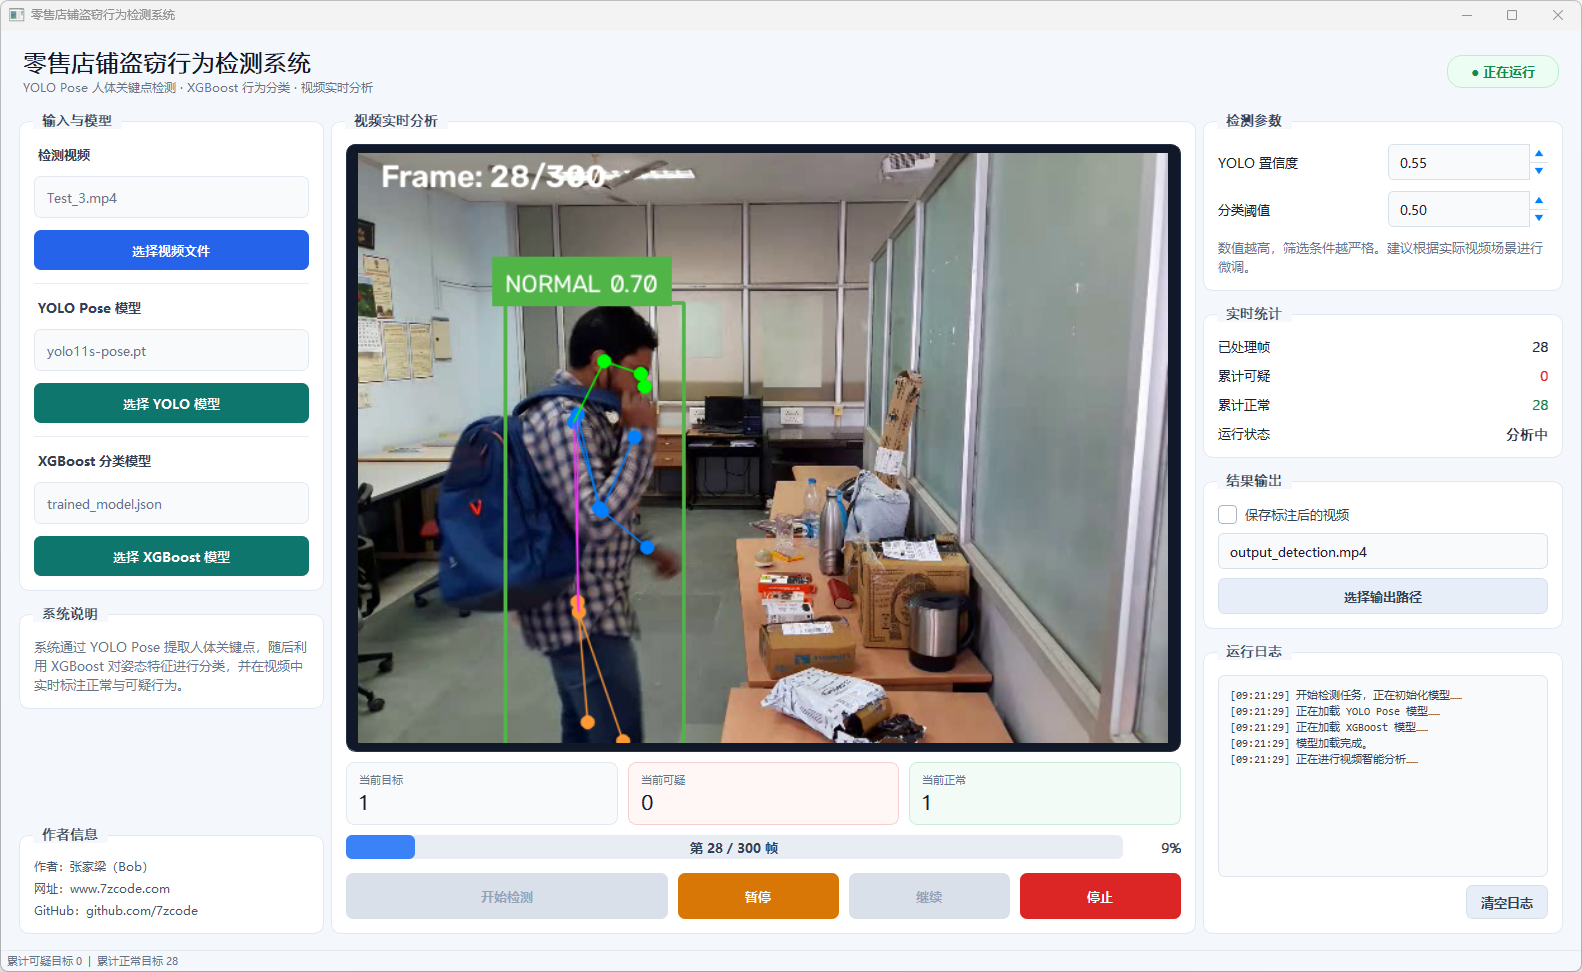
图6 正常行为
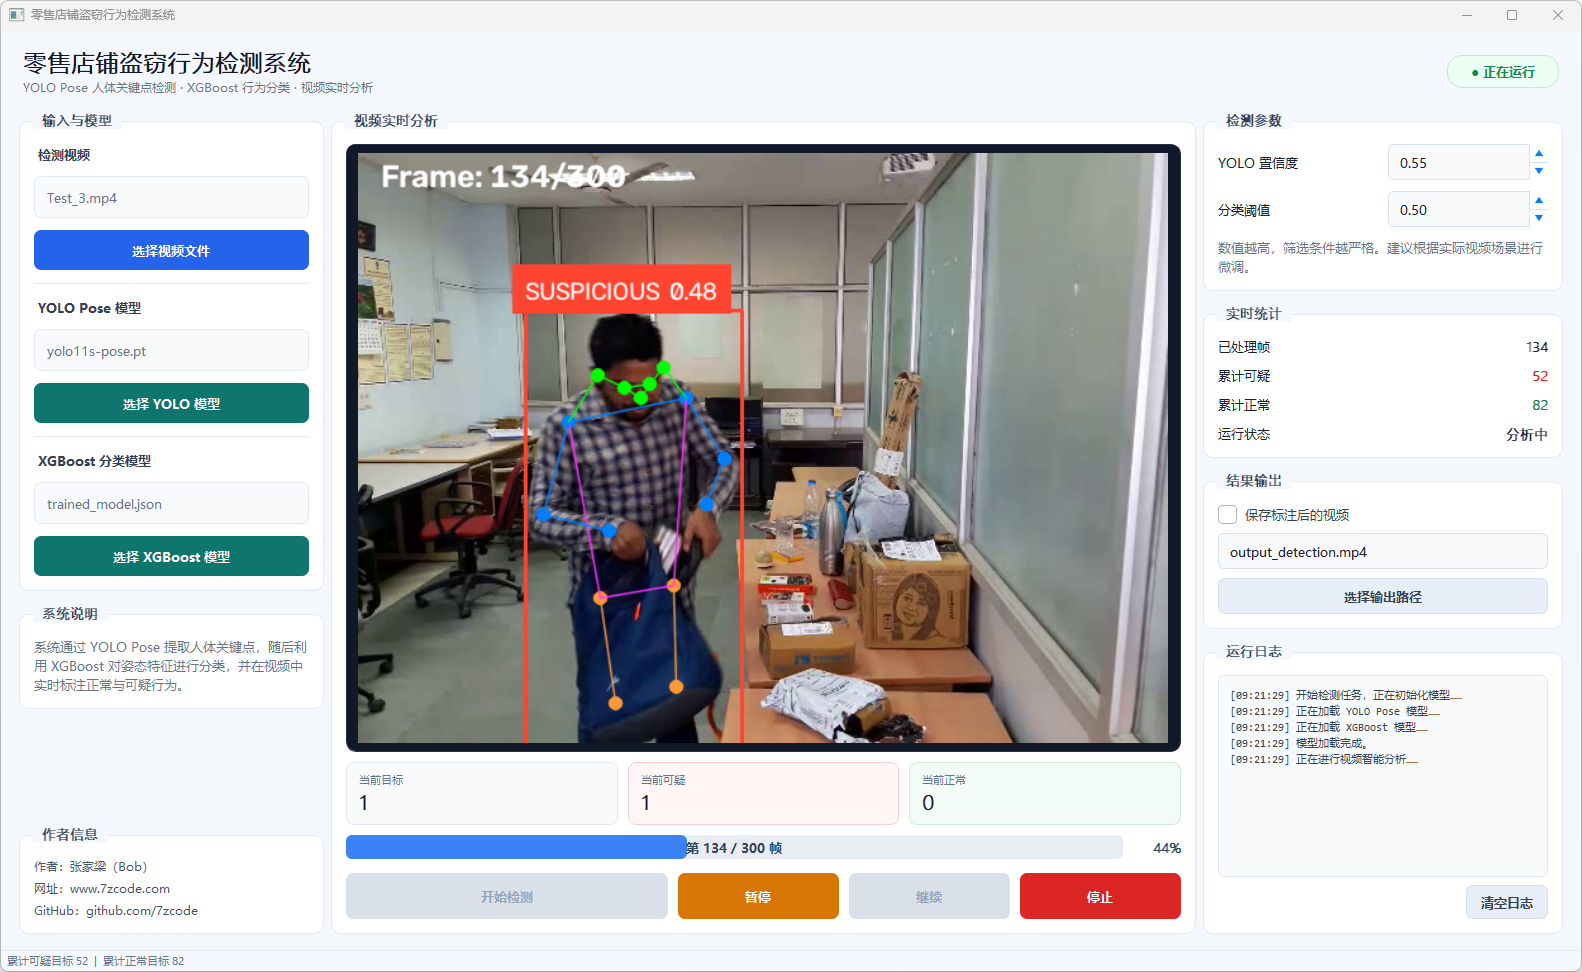
图7 可疑盗窃行为
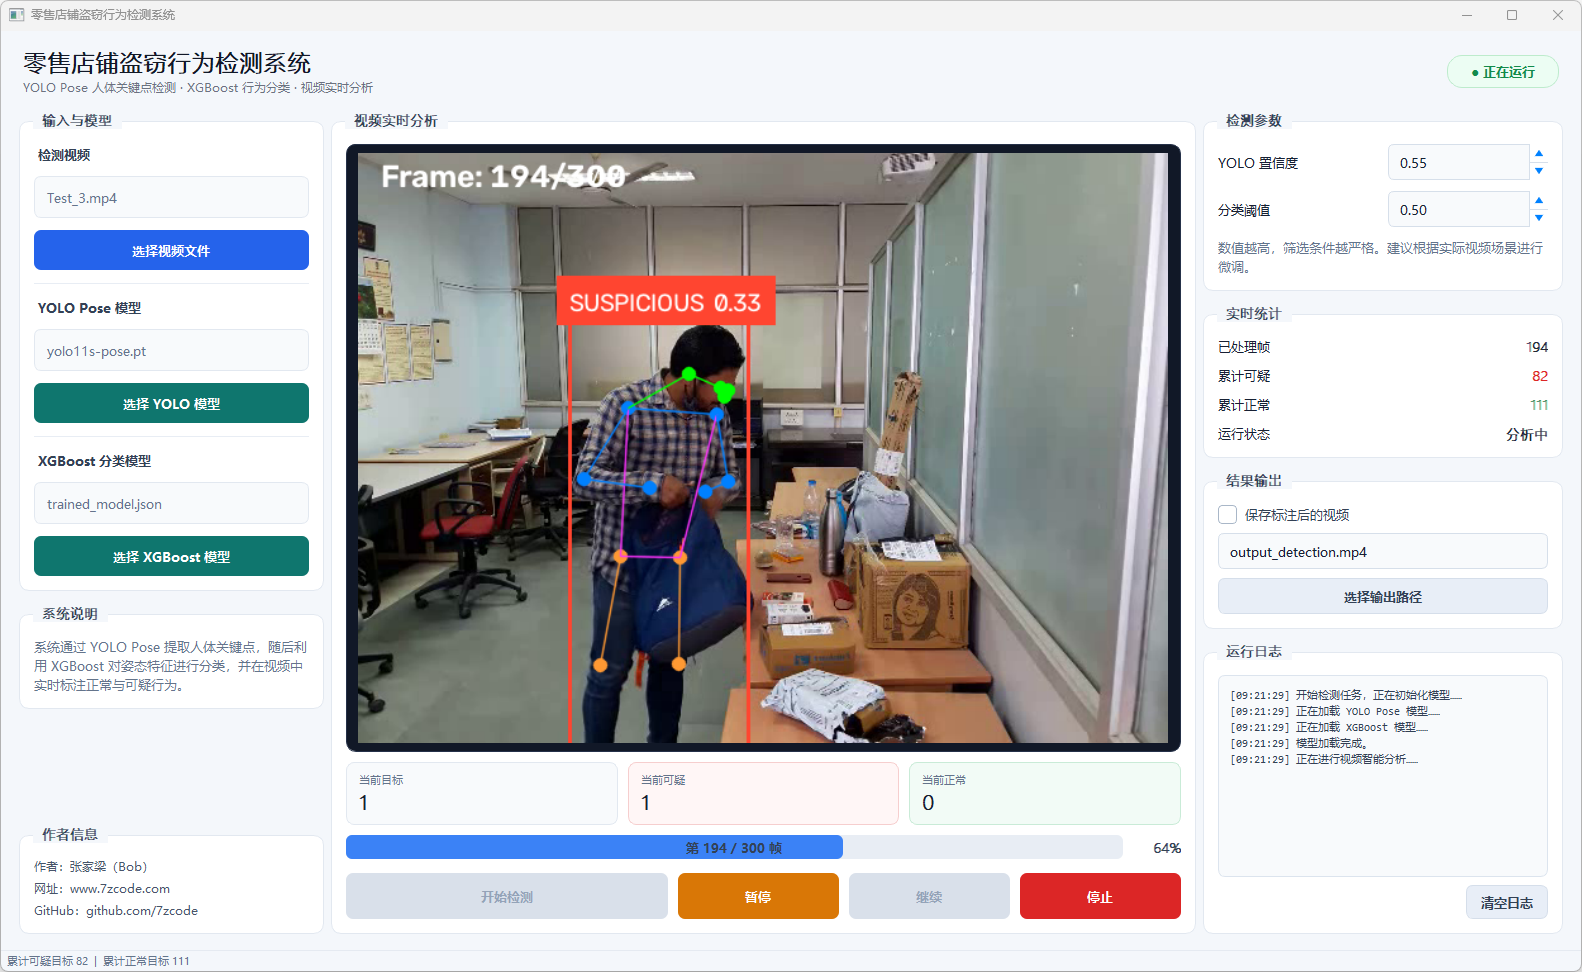
图8 可疑盗窃行为
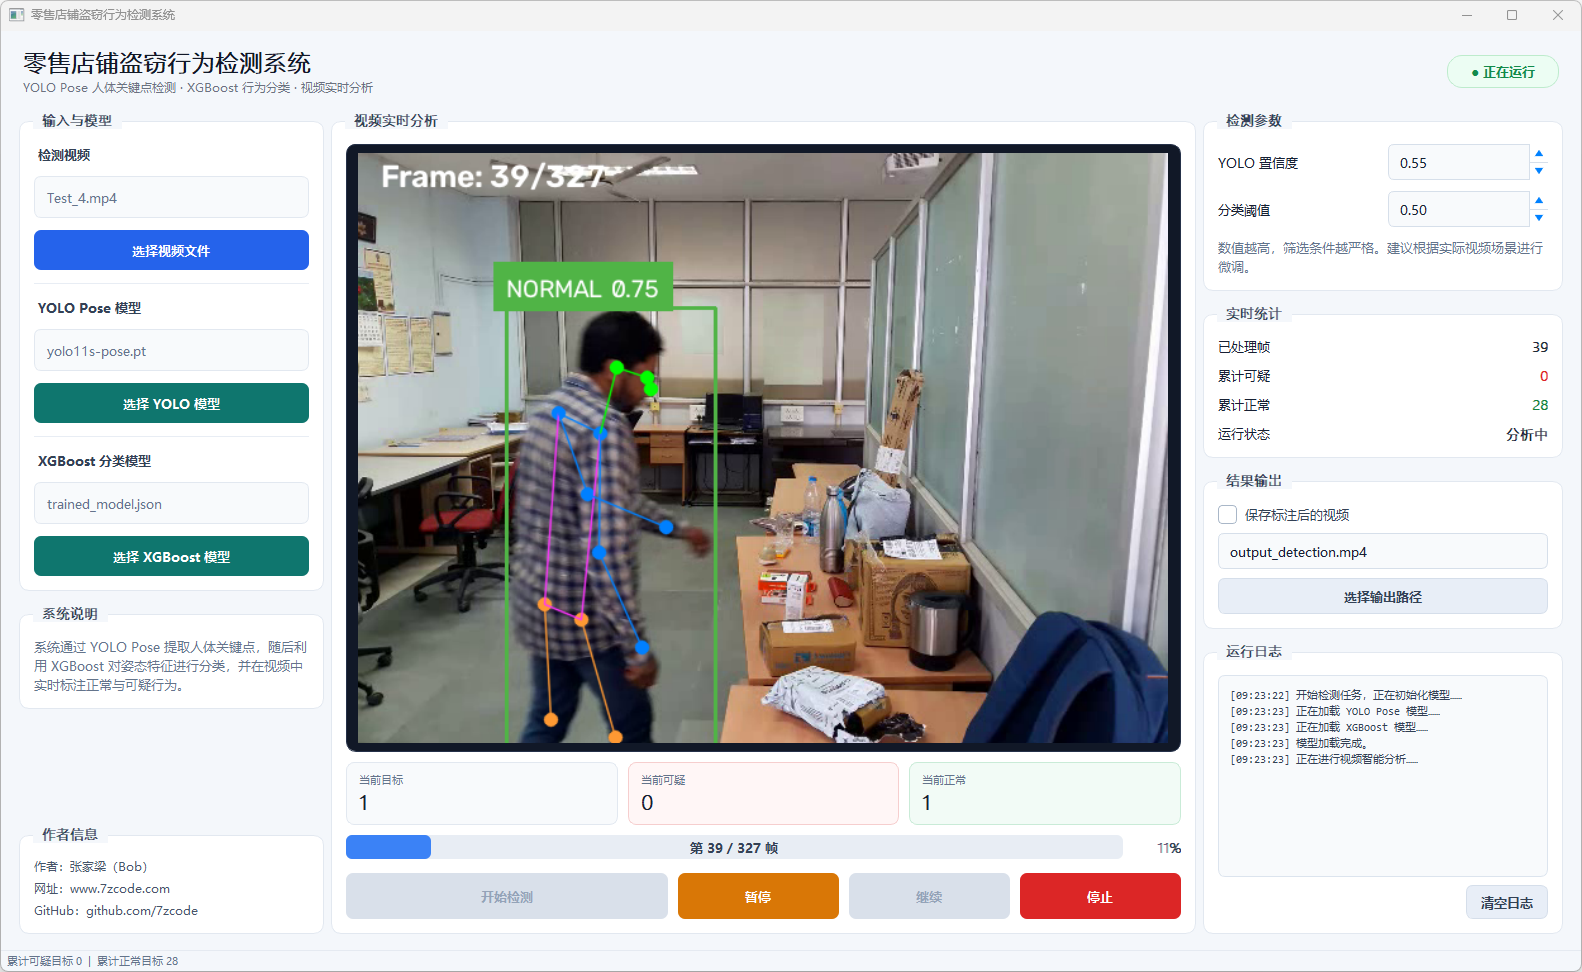
图9 正常行为
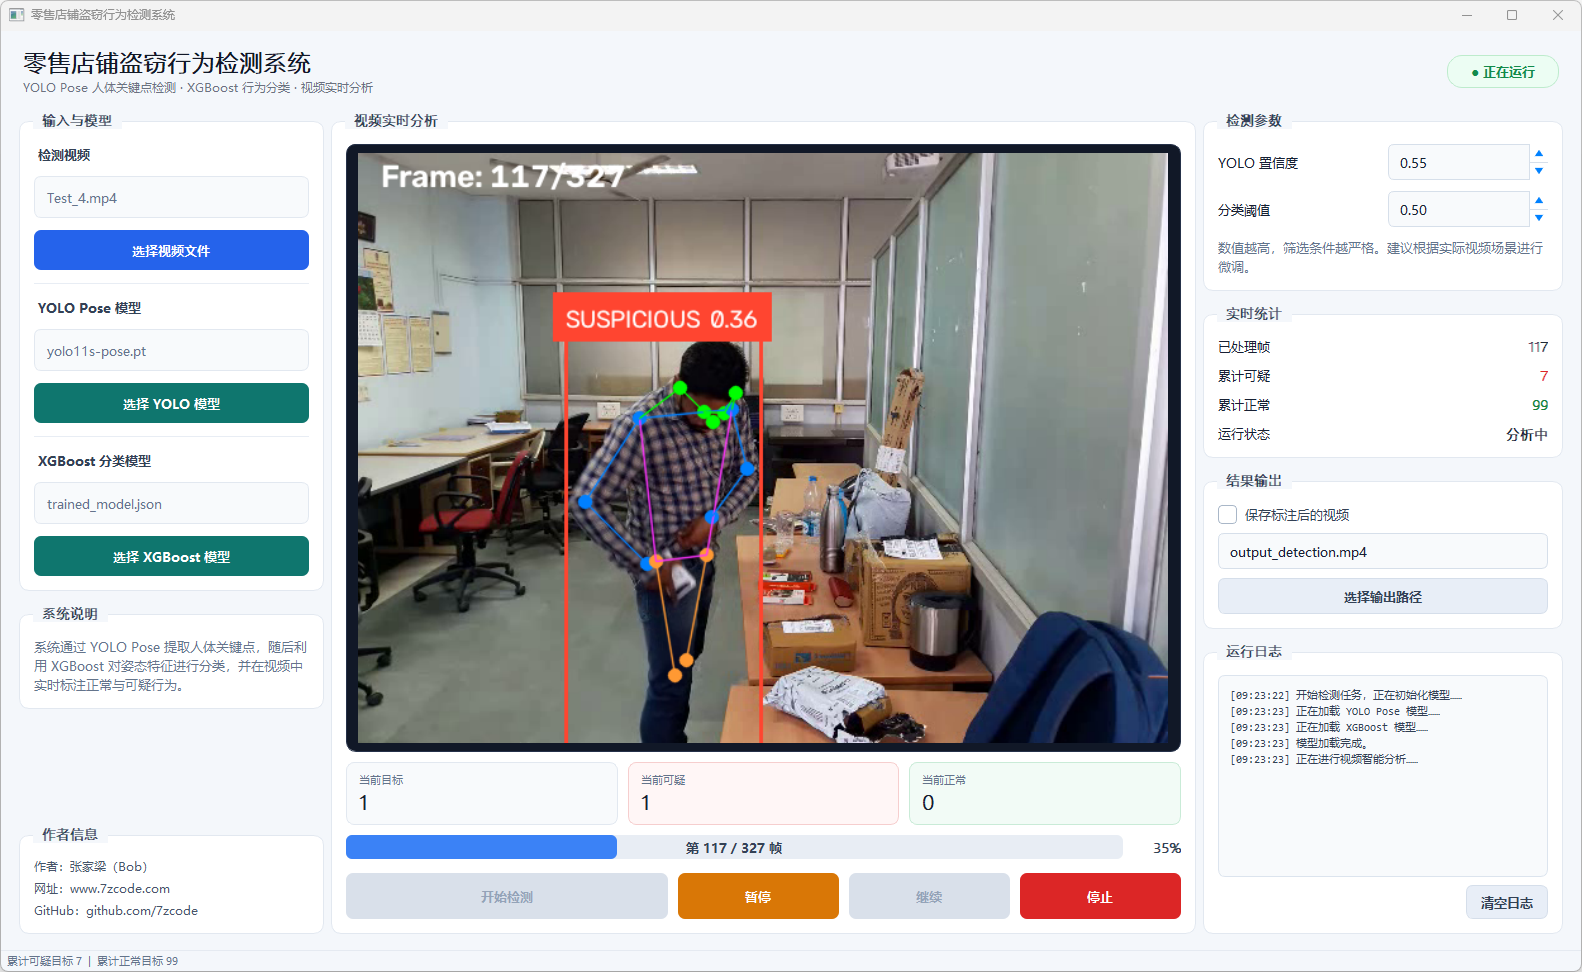
图10 可疑盗窃行为
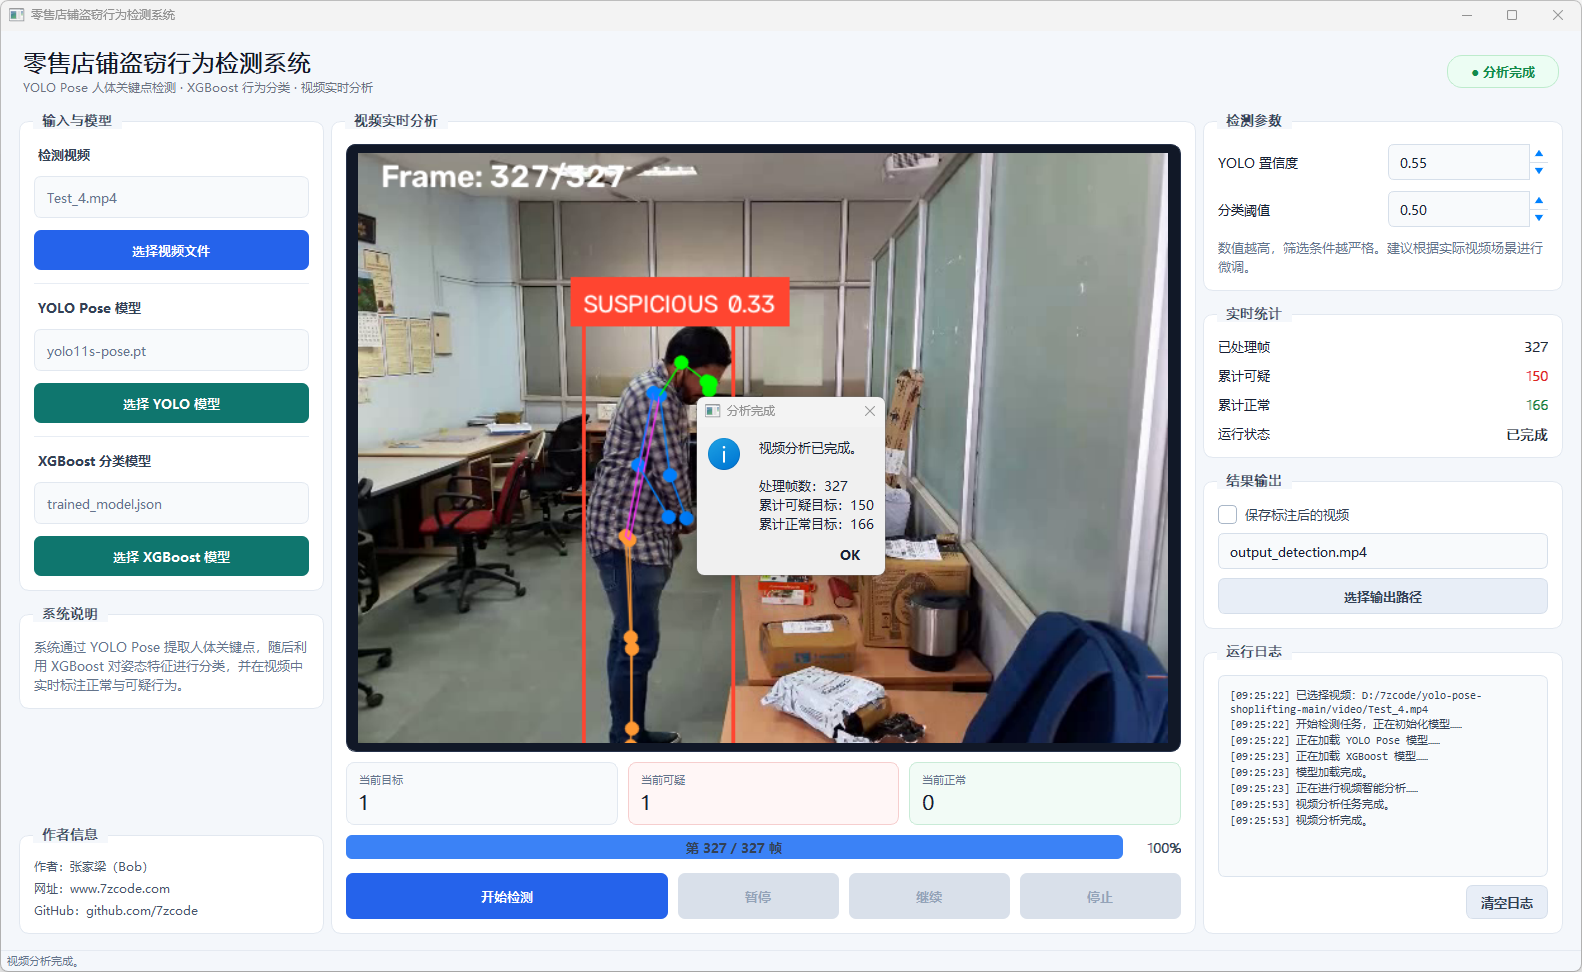
图11 视频分析完成
项目资源
配套文件
包括完整的项目源代码、演示视频、运行截图,开箱即用。
项目信息
作者信息
作者:Bob (张家梁)
项目编号:AI-47-P
原创声明:本项目为原创作品


评论前必须登录!
注册