 网硕互联帮助中心
💡 看完你能带走:一套写进 AGENTS.md 的测试约定模板、给存量代码补单元测试的五步节奏、AI 修失败测试的"红绿循环"、把"改完必测"变成机制的 Hook 挂法、让 AI 像真实用户一样点网页的黑盒测试法,外加 6 个我全踩过的坑。全文 8 个编号模板,全部可直接照抄,建议先收藏再看。
🧪 先说结论:测试,是 AI 编程最划算的投入
很多朋友用 AI 编程助手,活儿干到"生成代码"就停了。其实还有一类事,比写代码更适合交给 AI、收益也更持久——测试。
为什么这么说?三个理由:
- 测试是典型的模式化劳动:正常路径、边界值、异常分支……写法高度套路化,恰恰是 AI 最擅长承接的部分;
- 反馈即时且客观:代码好不好用,可能要上线几天才知道;测试过不过,几秒钟就有裁决,而且裁决标准(断言)白纸黑字;
- 成本最不对等:一个边界漏进线上,排查加补锅的代价,往往是多写几条用例的几十倍不止——测试是花小钱防大坑。
用一张测试金字塔,说清 AI 能在哪几层发力:
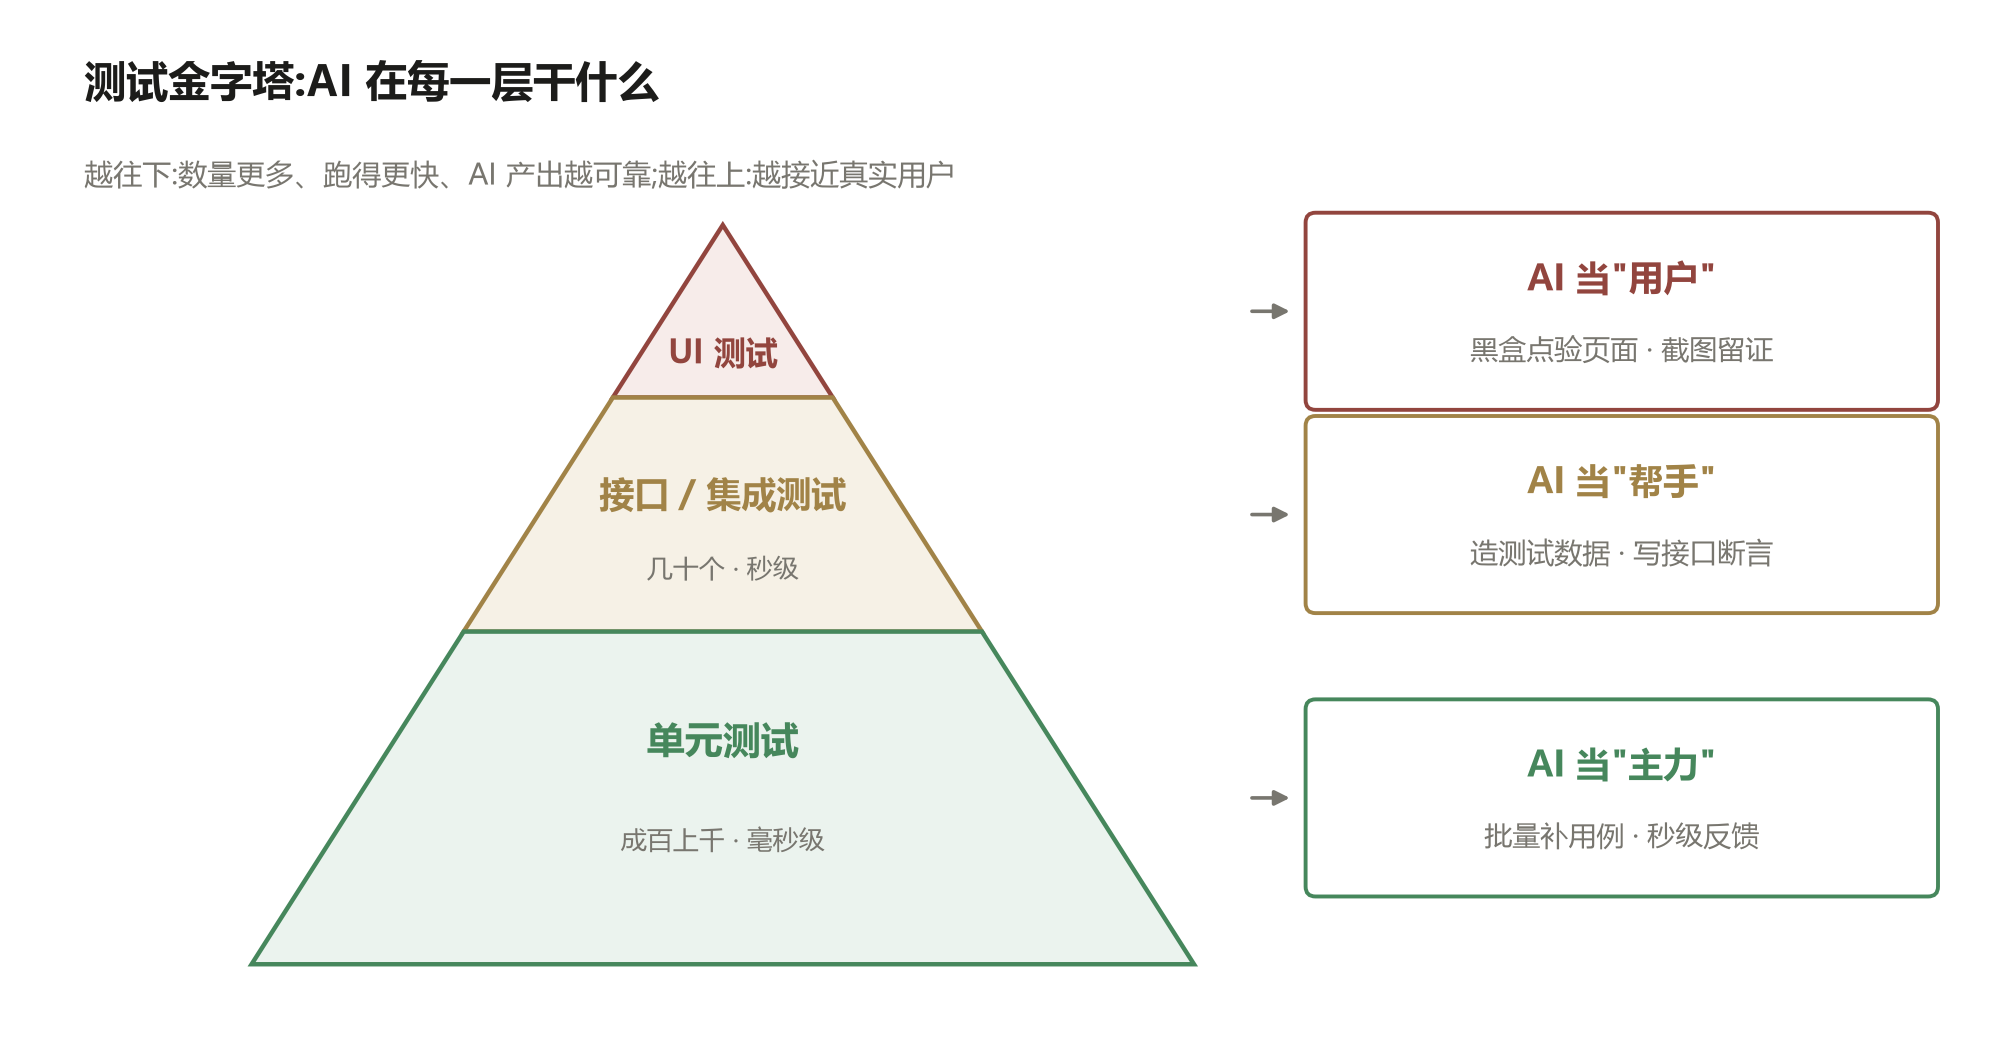
越往上越接近真实用户,越往下跑得越快、AI 的产出越可靠。本文重点讲两头:底层——让 AI 批量写单元测试;顶层——让 AI 当"用户"做界面黑盒测试。
开工前先立三条心法,后面所有技巧都建在它们上面:
📐 第 0 步:把测试约定写进 AGENTS.md(模板 1)
新项目先让 ZCode 执行 /init 生成项目说明文件,然后手动补一节"测试约定"。这一步的价值和给新同事写交接文档一样:一次写好,之后每次对话自动生效,你再也不用反复交代"用 pytest"“别连生产库”。
## 测试约定
– 框架:后端 pytest,前端 Vitest
– 位置:小脚本测试放被测代码旁(test_xxx.py 零配置可跑);
工程化项目进 tests/,与 src/ 同构,import 配置由 ZCode 负责
– 命名:test_函数名_场景_期望结果
– 改动 src/ 下任何文件,同一次任务里补齐或更新对应测试
– 完成标准:pytest -q 全绿,提交前必须跑一遍
– 测试一律用 fixtures 里的测试数据,禁止连接真实数据库
– 核心模块行覆盖不低于 80%,严禁写断言空洞的凑数用例
(内容是示意,按你的技术栈改。这条属于系列第一篇"沉淀调教成果"技巧在测试场景的直接应用。)
🎯 实战一:给存量代码补单元测试(模板 2、3、4)
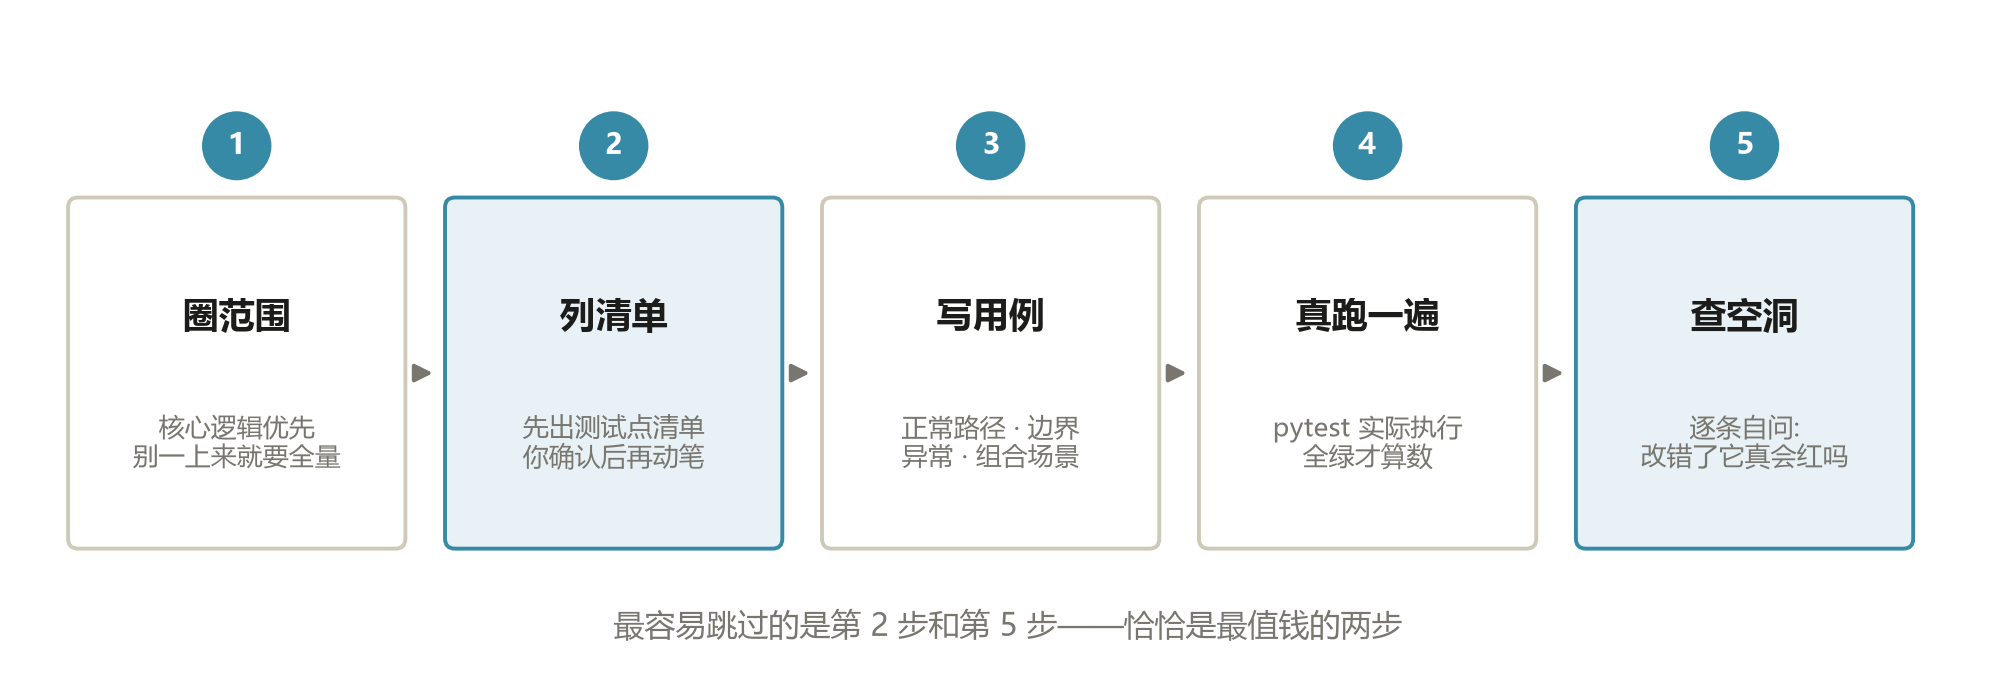
最常见处境:函数是祖传的,能跑,但没测试,改不敢改。让 ZCode 补测试,别一句"帮我写测试"就完事,按这个五步节奏来:
总提示词(模板 2):
请先阅读 src/pricing/discount.py 和它的调用方,然后:
1. 列出你计划覆盖的测试点清单(正常路径 / 边界 / 异常 / 组合),
每条标注"为什么值得测",等我确认后再动笔;
2. 测试按 AGENTS.md 的测试约定放置,框架用 pytest,
函数名按"test_行为_期望"命名;
3. 只测公开行为,禁止为了测试方便去修改实现代码;
4. 写完真跑一遍 pytest,把完整输出原样贴给我。
第 2 步"列清单先确认"是拦住 AI 跑偏的关键——清单错了改清单,比写完三十个用例再返工便宜得多。
用例长什么样?拿一个折扣函数做完整示范(下面的代码我实际跑过,数值都是真的):
# discount.py —— 待测的存量函数(示意)
def discount(price: float, vip: bool = False) –> float:
"""满 100 打九折;VIP 再叠九五折;结果保留两位小数。"""
if price < 0:
raise ValueError("price 不能为负")
final = price * 0.9 if price >= 100 else price
if vip:
final *= 0.95
return round(final, 2)
# test_discount.py —— 与被测文件同目录,六条用例覆盖四类场景
import pytest
from discount import discount
def test_不足一百不打折():
assert discount(99) == 99.0
def test_恰好一百_边界值打九折():
assert discount(100) == 90.0
def test_超过一百打九折():
assert discount(200) == 180.0
def test_VIP再叠加九五折():
assert discount(200, vip=True) == 171.0
def test_不满一百_VIP同样享九五折():
assert discount(50, vip=True) == 47.5
def test_负数报价直接拒绝():
with pytest.raises(ValueError):
discount(–1)
正常路径(99、200)、边界值(恰好 100)、组合场景(不满一百但 VIP)、异常输入(负数),各就各位。想快速补齐清单,有个偷懒办法——边界七连问(模板 3):
对照这个函数逐条自查,没覆盖的补用例:
零值、空值、负值、极大值、恰好等于阈值、非法类型、特殊字符
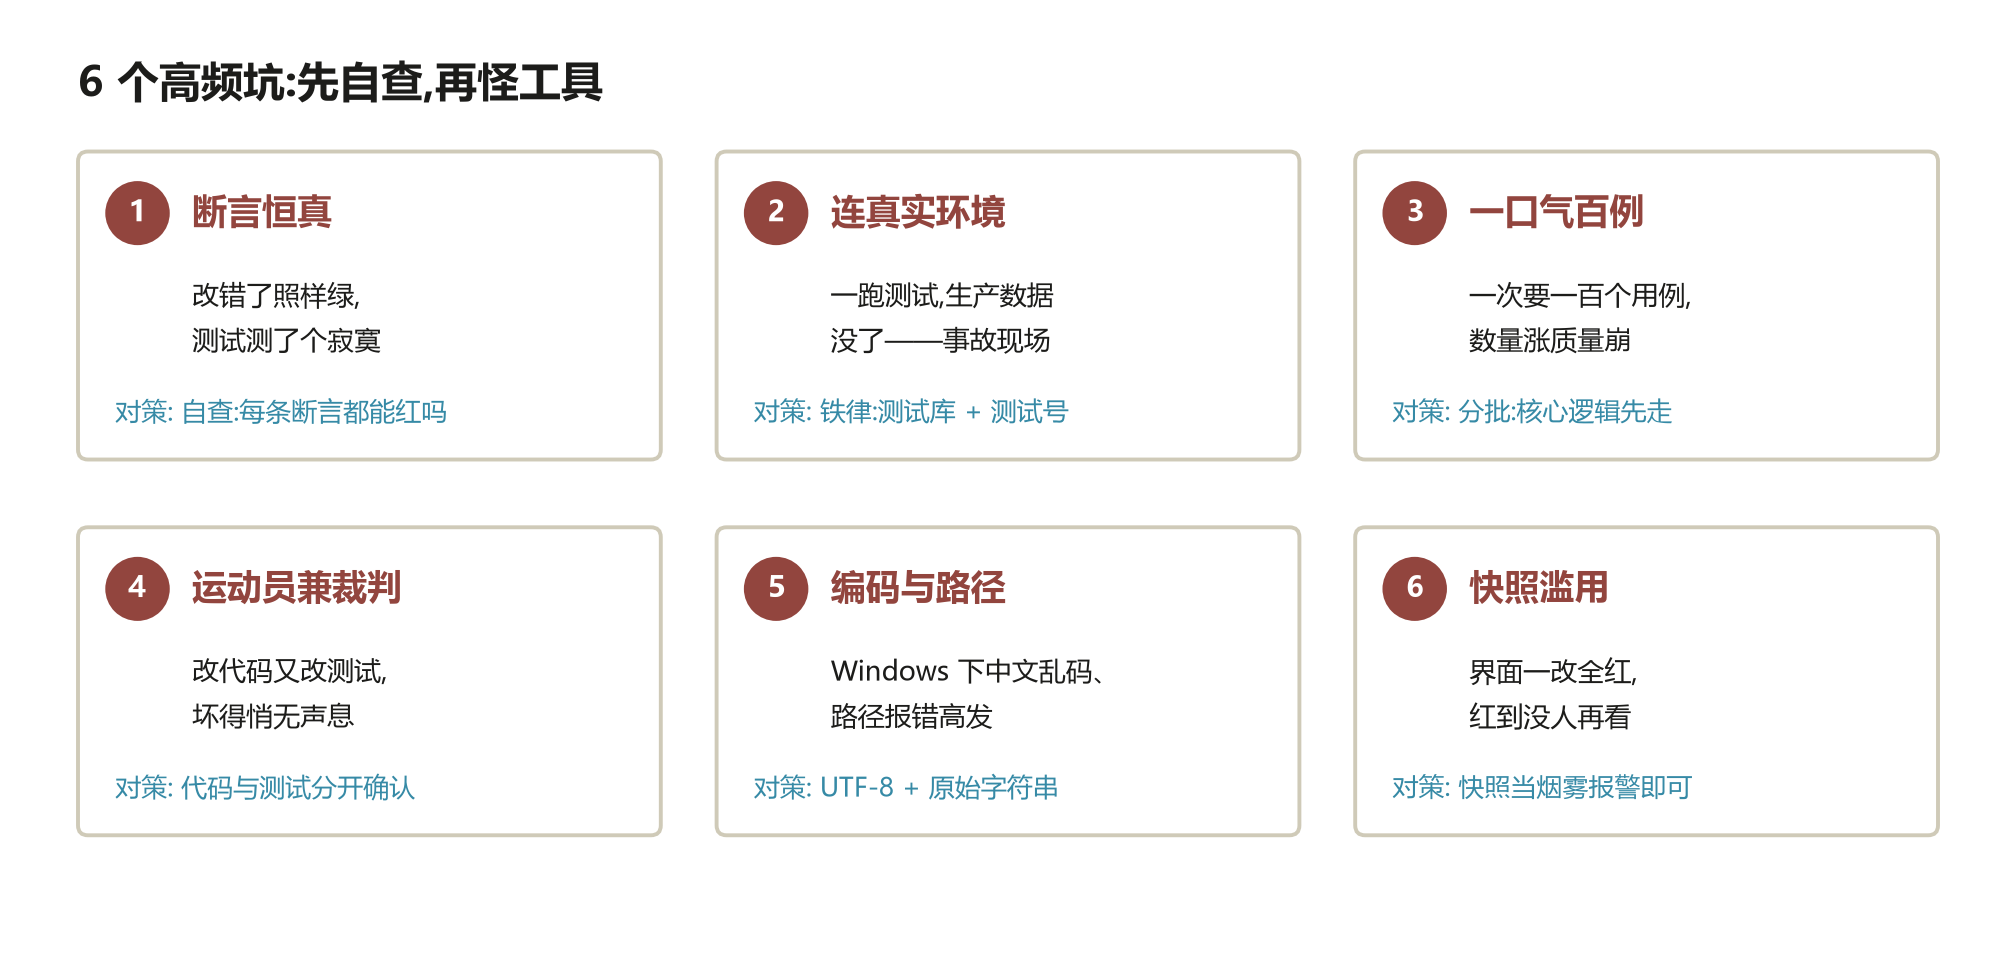
最后一步"查空洞"最容易被跳过,却最值钱。AI 写测试有个典型毛病:断言恒真——assert result is not None 这种,实现改错了照样绿,测了个寂寞。用质量自查提示词(模板 4)打回去:
复查你刚写的全部测试,逐条回答:
1. 如果把实现改错,这条测试真的会变红吗?怎么变红?
2. 有没有"只要不抛异常就算过"的空测试?
3. 有没有拿实现代码算期望值的循环论证?
只指出问题和给修改建议,先别动手改。
🔁 实战二:失败测试的修复循环(模板 5)
测试铺好之后,你改代码、红灯亮起,怎么让 ZCode 修得又快又稳?记住这个循环:
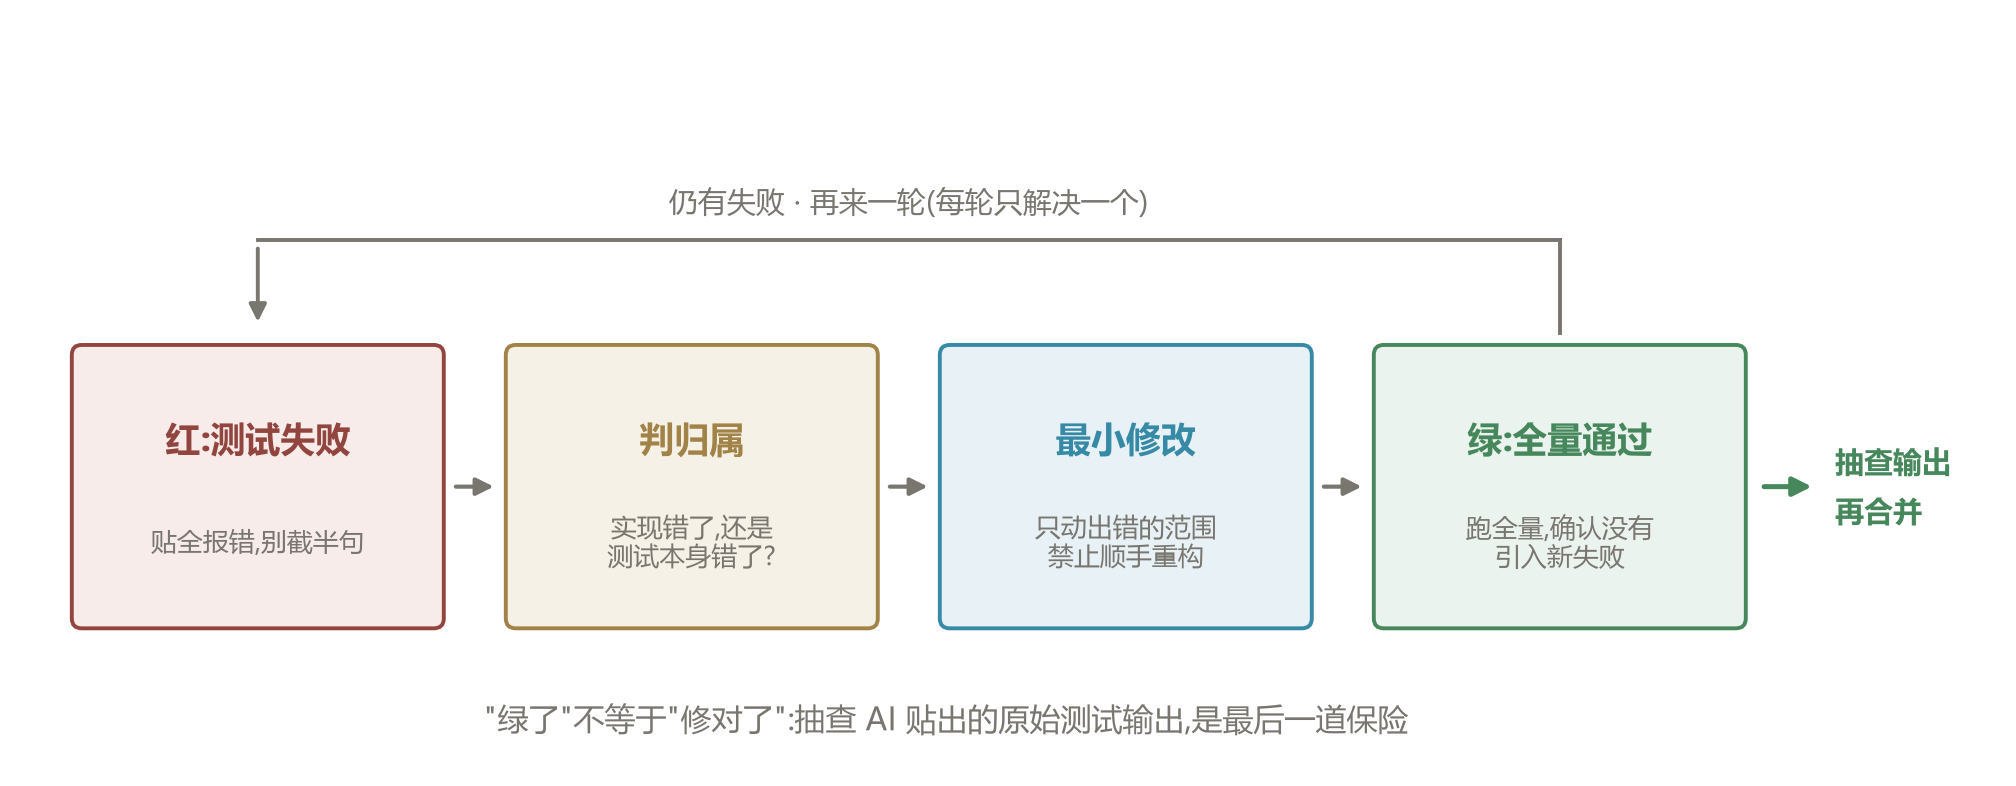
三个要点:
- 贴全报错:从第一行 FAILED 到最后一段 traceback 原样贴给它,别截半句——这是系列第一篇的老规矩,测试场景同样适用;
- 先判归属:是代码错了,还是测试错了?很多修复走样,是因为 AI 为了让测试变绿,顺手把测试一起改了。测试体现的是你的意图,不能被它悄悄"纠正";
- 最小修改:一轮只解决一个失败,修完全量重跑,确认没引入新的红灯。
修复提示词(模板 5):
pytest 全量输出如下(贴全)。要求:
1. 先判断:是实现错了还是测试错了?给出判断依据;
2. 实现错了就修实现;测试期望本身没错,就不许动测试;
3. 只改最小范围,禁止顺手重构、禁止顺手升级依赖;
4. 修完跑全量测试,列出改动文件与原因。
另外,“绿了"不等于"修对了”。合入前抽查一眼它贴回的原始输出:通过数对不对、有没有用例被跳过、耗时是否正常。这十秒钟,是对"AI 报喜"的最后一道保险。
🛡️ 实战三:把"改完必测"变成机制(模板 6)
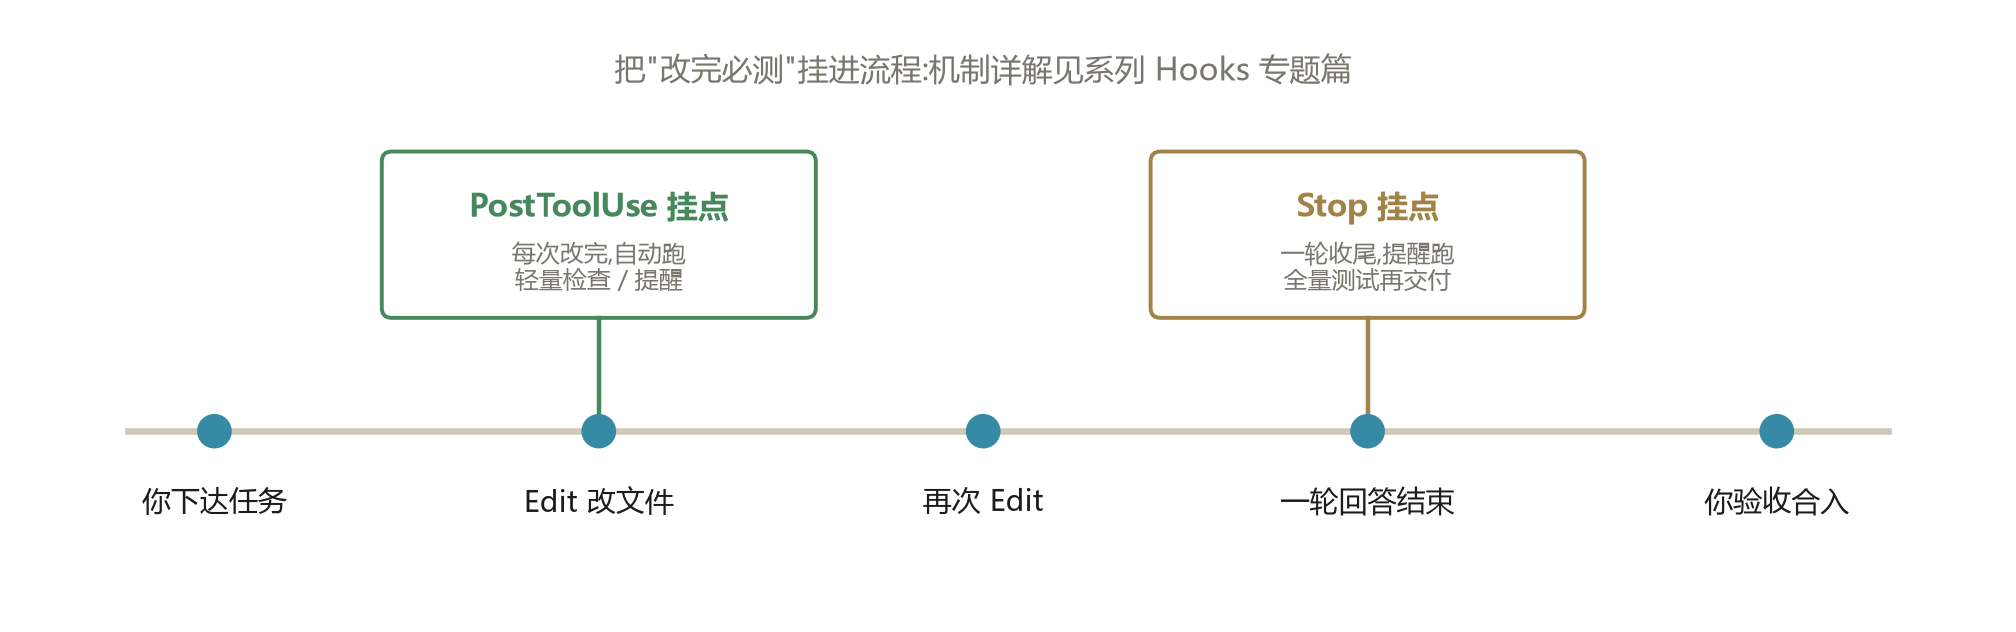
前面两节都靠"你记得提醒"。老读者知道我的主张:靠记性的事,迟早漏。本系列专门写过 Hooks——在 ZCode 工作流的固定节点自动执行你的脚本,机制细节看那篇,这里直接给测试场景的挂法(模板 6):
{
"hooks": {
"enabled": true,
"events": {
"PostToolUse": [
{
"matcher": "Edit|Write",
"hooks": [
{
"type": "process",
"command": "D:/tools/remind-test.cmd",
"args": [],
"timeoutMs": 10000
}
]
}
],
"Stop": [
{
"hooks": [
{
"type": "process",
"command": "python",
"args": ["-m", "pytest", "-q"],
"timeoutMs": 120000
}
]
}
]
}
}
}
放在用户级 ~/.zcode/cli/config.json(全项目生效)或工作区级 .zcode/config.json(仅当前项目、可随 Git 共享)的 hooks 字段里。四个要点:
- enabled: true 必须设——配置文件里的 Hook 默认关闭,忘了它,后面全白搭;
- PostToolUse 在每次编辑/写入后触发,适合挂轻量动作:检测本次改动是否涉及核心目录、提醒补测试。示例里的脚本路径是示意,换成你自己的;
- Stop 在一轮回答结束时触发,示例直接挂了快速测试套件(python -m pytest -q),一轮收尾自动验证。慢测试别在这儿硬等——Hook 是同步执行的,让脚本自己把重活丢到后台;
- 超时单位别记混:command 型按秒,process 型按毫秒(示例用的 process 型,120000 毫秒 = 两分钟)。跨平台团队优先用 process 型——不走 shell,三大系统表现一致。
分寸感很重要:Hook 适合"检查、提醒、拦截",别让它替你做重决定。"每次编辑都自动跑全量测试"这种配置,要么慢到怀疑人生,要么逼你把 Hook 关掉。
🌐 实战四:让 AI 像用户一样测网页(模板 7)
单元测试管住了函数,但"页面白屏"“按钮点了没反应"这类问题,只有真点一遍才知道。我使用的 ZCode 桌面版内置浏览器自动化能力(你的版本若没有,以官方说明为准),可以让它扮演"真实用户”,对页面做纯黑盒测试。
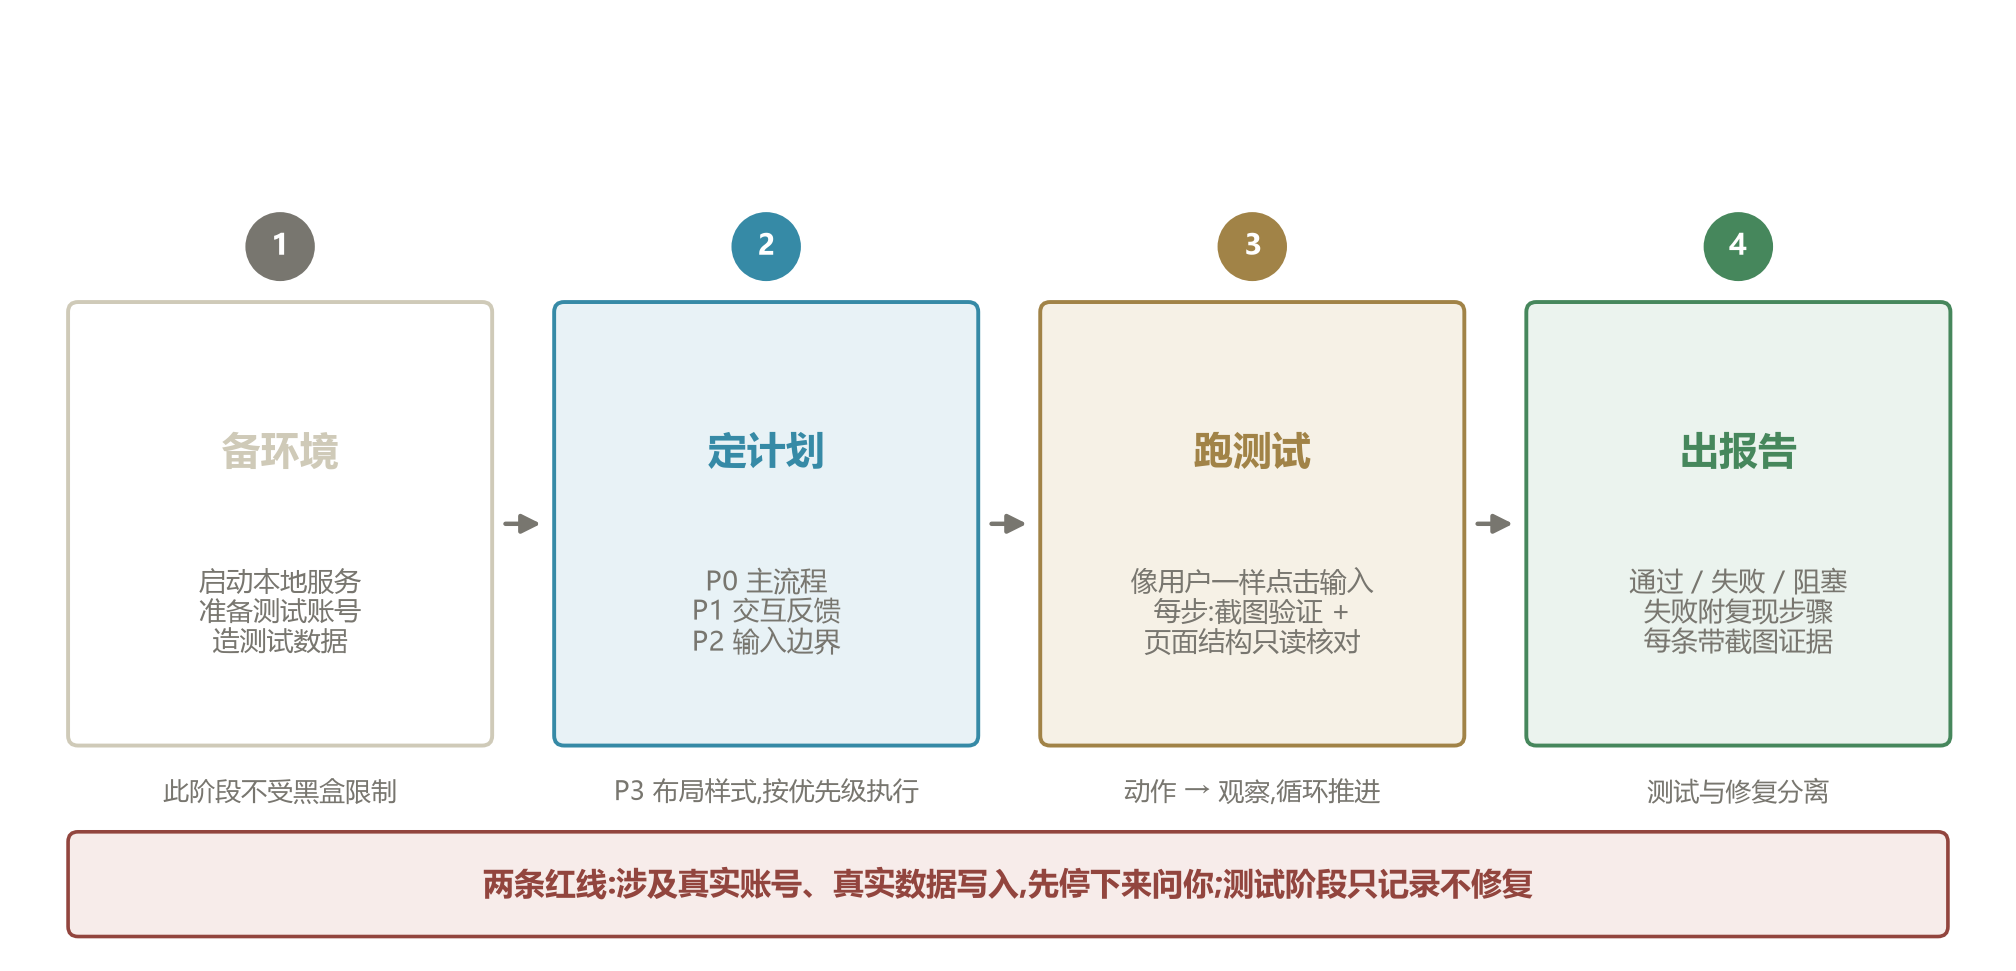
好用的关键,是把规矩一次性说清(模板 7):
请对 http://localhost:5173 做黑盒界面测试:
1. 环境准备:启动本地开发服务,用测试账号 test01 登录;
2. 先给我测试计划:P0 主流程 / P1 交互反馈 / P2 输入边界 /
P3 布局样式,从 P0 开始执行;
3. 全程像真实用户:只用点击、输入、滚动完成操作,
不许注入脚本改页面状态,不许改 URL 抄近路;
4. 每个测试点都要截图留证,保存到 gui-test-screenshots/;
5. 只测不改:发现 bug 先记录,全部测完再问我要不要修;
6. 最后出报告:通过 / 失败 / 无法执行三类,
失败项附复现步骤和截图。
这套流程跑完,你会拿到一份带截图证据的测试报告。几个设计意图说透:
- 环境准备与正式测试分离:启动服务、造测试数据、备测试账号都允许,但一旦声明"开始测试",就切换成黑盒模式——防止它既当考生又当阅卷人;
- 双验证:每个结论都要"截图 + 页面结构只读核对"互相印证,单凭一样不算数,防止它看走眼之后一本正经地胡说;
- 两条红线:涉及真实账号、真实数据写入(下单、支付、删除)时,先停下来问你;测试阶段只记录不修复,全部测完再统一决定修哪些——顺序反了,测试就失去了独立性。
它还特别适合复现 bug:把用户反馈丢给它,“按这个步骤在页面上点一遍,复现了截图给我”,比你自己开着一堆窗口来回切换快得多,证据还齐全。
⏰ 实战五:定时回归与后台长跑(模板 8)
回归测试最烦人的是"记不住、懒得跑"。两招,把它变成不用惦记的事:
长测试丢后台。全量测试要跑几分钟?直接说"放到后台运行",不阻塞对话,跑完通知你——等待时间该干嘛干嘛。
定时自动回归。在对话里直接说:"每天早上八点,全量跑一遍项目测试,按模板写报告存到 reports/ 目录。"到点自动执行,你到工位时报告已经躺在那里了。这正是系列第一篇"定时任务"技巧的用武之地。
回归报告模板(模板 8):
汇总本次回归结果,输出到 reports/regression-当日日期.md:
一、总体结论:通过率、耗时、失败数
二、失败清单:用例名、报错首行、
初步归因(代码问题 / 环境问题 / 测试本身)
三、与上一次相比新增与恢复的用例
"初步归因"这栏值得多说一句:失败不等于 bug——可能是环境挂了、依赖过期、测试数据被人动了。让 AI 先把归因分好类,你早上只需要盯"代码问题"那一栏。
🧯 6 个高频坑(我全踩过)
❓ 快问快答
Q:AI 写的测试,能信吗?
默认当"草稿"看。数量它保证,质量你把关——重点看断言:每条是不是都在真断言行为。模板 4 的三连问,一分钟过完一遍。
Q:没有测试的祖传项目,从哪开始补?
“改哪补哪”:这次要动哪个模块,就先给哪个补,立刻见效。想主动铺开,按"核心函数 → 高频路径"排序,别追求一步到位的全量覆盖。
Q:先做单元测试,还是先做界面测试?
从金字塔底层开始。单元测试快、稳、便宜,适合铺量;界面测试慢、脆、贵,只留主流程当"冒烟"。倒过来做的团队,大多困在"测试越写越慢,最后没人跑"里。
Q:覆盖率要多高才算够?
数字是参考,不是 KPI。核心业务模块高一些,工具代码无所谓;比"全局 90%“更重要的是"关键分支都有断言”。为凑数字生成的用例,第一个坑等着你。
Q:测试越写越多,跑一轮十分钟,怎么办?
让 AI 做一次"测试体检":列出最慢的十个用例、没有断言的用例、互相重复的用例,该修修、该删删。测试套件也需要定期打扫。
📝 写在最后
写测试这件事,过去难在"没时间",根子上是难在"枯燥"——模式化的劳动最磨人。AI 恰好把这部分接走了:它批量起草,你逐条把关;它盯着红灯,你决定方向。
成本降下来之后,剩下的门槛只有一个:知道什么值得测、什么该信。这件事 AI 替代不了,也正因如此,值得你从今天的三件小事开始:给 AGENTS.md 加一节测试约定;挑一个核心函数,按模板 2 补一轮测试;把快速套件挂到 Stop 上。第一份自动回归报告出现在你桌上的那天,你就回不去了。
🏷️ 声明:本文为个人使用经验总结,属第三方独立教程,非 ZCode 官方文档;"ZCode"名称及相关商标归其权利人所有;文中功能、界面与配置行为以你所用版本的官方文档为准;全部插图与示例代码均为本文原创,示例代码经实际运行验证。
💬 你的项目里,测试现在是资产还是负债?评论区聊聊你的补测策略。系列下一篇,写「自己动手写一个 MCP 服务器」。


评论前必须登录!
注册