 网硕互联帮助中心
想统一处理单个与组合对象?用组合模式
关键词:组合模式、Composite、设计模式、树形结构、Agent 任务树
目录
- 一、先看看"没有它"时怎么写
- 二、组合模式的骨架:三个角色一段代码讲清
- 三、走查一次调用:客户端只调根,树自己跑完
- 四、child-management 放哪?透明式与安全式的取舍
- 五、几个容易踩的坑
- 六、在大模型工程里它出现在哪
- 七、什么时候该上、什么时候别上
- 总结
一、先看看"没有它"时怎么写
假设你要在系统里管理一份文件清单,既能算单个文件的大小,也能算一整个文件夹的大小。最直觉的写法大概是这样:
# 反例:没有组合模式时,客户端被迫区分"单个"和"一组"
class File:
def __init__(self, name: str, size: int):
self.name, self.size = name, size
def get_size(self) –> int:
return self.size
class Folder:
def __init__(self, name: str):
self.name, self.children = name, []
def get_size(self) –> int:
return sum(c.get_size() for c in self.children)
def print_size(node):
# 每碰到一个节点,都要先判断它到底是哪一种
if isinstance(node, Folder):
print("文件夹大小", node.get_size())
elif isinstance(node, File):
print("文件大小", node.get_size())
# 明天加一个"快捷方式"节点?这里又得改一处分支
这段代码能跑,但藏着三个麻烦:第一,print_size 这类操作每写一次都要重复 isinstance 判断;第二,一旦新增一种节点类型,所有做过类型判断的地方都得跟着改,违反开闭原则;第三,递归的"树"结构被埋在了 Folder.get_size 内部,客户端根本感知不到自己其实在处理一棵嵌套很深的树。这种「类型判断散落各处」的写法,在菜单系统里更明显:一个菜单项(叶子)和一个子菜单(容器)都得能「点击 / 渲染 / 算快捷键」,朴素写法会让 on_click 里塞满「如果是子菜单则展开、否则执行」。更糟的是,菜单层级一深,这类判断会逐层复制。组合模式的价值,就是把这些散落的 if 收拢进树自己的递归里,让上层只管「点一下」,至于点的是项还是菜单,交给树自己决定。
当节点类型从两三种涨到十几种、树的深度从两层涨到十几层时,这种写法会迅速失控——它不是「小项目无所谓」的小毛病,而是会随系统长大而放大的结构性债务。组合模式(Composite Pattern,GoF 在 1994 年《设计 Patterns》中系统提出的 23 个经典模式之一)要解决的正是这件事:把"单个对象"和"对象组合"放进同一个接口里,让调用方完全不必关心自己手里到底是叶子还是容器。
用 GoF 的原话概括它的意图:将对象组合成树形结构以表示「部分—整体」的层次结构,并让客户端对单个对象和组合对象的使用具有一致性。关键词是「部分—整体」——只要你的数据天然长成一棵树、而且你想对树叶子和树根用同一套操作,它就是首选候选。文件系统的文件与目录、GUI 的控件与容器、公司的部门与员工、编译器里的表达式树,底层都是同一个套路。
二、组合模式的骨架:三个角色一段代码讲清
组合模式的结构非常稳定,只有三个角色。下面这段就是用 Python 写出来的一棵"文件系统树",建议边读边对照三个角色的职责。
from abc import ABC, abstractmethod
class FileSystemNode(ABC):
"""Component:声明叶子与容器【共有的】操作"""
@abstractmethod
def get_size(self) –> int: ...
# 【子节点管理】透明式写法:声明在 Component 上
# 叶子节点没孩子,所以默认用异常拒绝,而不是悄悄忽略
def add(self, node: "FileSystemNode") –> None:
raise NotImplementedError("叶子节点不支持 add")
def remove(self, node: "FileSystemNode") –> None:
raise NotImplementedError("叶子节点不支持 remove")
class File(FileSystemNode):
"""Leaf:原子节点,没有子节点,直接干活"""
def __init__(self, name: str, size: int):
self.name, self.size = name, size
def get_size(self) –> int:
return self.size
# add / remove 直接继承父类的 NotImplementedError,无需重写
class Folder(FileSystemNode):
"""Composite:容器节点,持有子组件并递归委托"""
def __init__(self, name: str):
self.name, self.children = name, []
def get_size(self) –> int:
# 关键:把请求递归下发给每个孩子,自己只做聚合
return sum(child.get_size() for child in self.children)
def add(self, node: "FileSystemNode") –> None:
self.children.append(node)
def remove(self, node: "FileSystemNode") –> None:
self.children.remove(node)
三个角色逐一拆开看:
先记住一个让后面都不绕的点:递归之所以会终止,是因为树里一定有叶子——Leaf.get_size 不再向下转发,递归到此收敛。这也解释了为什么组合模式不能用于图:图里没有天然的「叶子」,一个节点可能既是别人的父、又是别人的子,递归找不到终止边界。只要守住「树」这个前提,下面的展开都不会失控。
顺带说下名字:Composite 直译是「组合」,指的是「把对象组合成树」这个动作——不是「组合优于继承」里那个组合(那是 has-a 关系,和本模式是两回事,别混)。它的精髓始终是「用同一个接口,把单个与组合一视同仁」。客户端从头到尾只持有 Component 类型的引用,至于这引用背后是 File 还是 Folder,它从不需要知道。
- Component(抽象组件):FileSystemNode 是整棵树的"契约"。它干两件事——声明所有节点都要有的操作(这里是 get_size),以及(在透明式写法里)声明子节点管理操作(add/remove)。把公共行为提到这一层,是让叶子与容器"长得一样"的前提。
- Leaf(叶子):File 是递归的终点。它没有子节点,所以 get_size 直接返回自身大小。注意它没有重写 add/remove,于是继承了父类的"抛异常"实现——这正好表达了"文件不能挂孩子"这个事实。
- Composite(容器):Folder 持有 children 列表。它实现 get_size 时不是自己算,而是把请求逐个转发给孩子,最后把结果聚合成自己的返回值。这一行 sum(child.get_size() …) 就是整棵树能被"统一处理"的发动机。
写 Component 时有个反直觉的克制:接口要尽量小。组合模式的统一性来自「叶子与容器共享同一组操作」,但这并不意味着要把所有能想到的操作都塞进 Component。只有那些叶子与容器「真的都要做」的操作才该上提(比如 get_size);而只在容器有意义、且你选了安全式才放的 add/remove 另说。一个常见的过度设计是:把某个只属于特定子类的特殊行为也提上来,结果大部分节点都只能抛出「不支持」——这恰恰是把模式用反了。判断标准很朴素:如果一个方法在多数节点上都是异常或空实现,它大概率不该待在 Component 里。还有一个 GoF 提到的细节:Component 可以给某些操作提供默认实现,而不只是抽象方法。比如 get_child(i) 在 Component 上默认返回 None,Leaf 直接继承这个默认值、Composite 再按需覆写。这样 Leaf 不必为每个容器方法都写一遍「抛异常」,能少不少样板。但别滥用——默认实现应当「语义上对所有节点都合理」,否则又会退化成「假装支持」。
把节点类型从两个(File/Folder)扩展到任意多个时,客户端代码一行都不用改——这正是组合模式对开闭原则的兑现:新增节点类型,不改遍历逻辑。
三、走查一次调用:客户端只调根,树自己跑完
光看类图还不够,真正理解组合模式要看"一次调用是怎么在树里流动的"。下面这段客户端代码,客户端从头到尾只做了一件事:对根节点调一次 get_size。
root = Folder("root")
root.add(File("a.txt", 10))
docs = Folder("docs")
docs.add(File("b.txt", 20))
root.add(docs) # 把 docs 这个"容器"挂到 root 下
print(root.get_size()) # 输出 30,客户端完全不知道有嵌套
调用链路是这样展开的:
整条链路上,客户端没有写任何 if、没有任何循环去"手动走树"。递归下发的逻辑被封装进了 Composite 内部,对外只暴露一个和 Leaf 一模一样的 get_size。这正是组合模式最核心的体验:你调用的是"一个对象",跑起来的却是"一整棵树"。
这带来的真正红利是开闭原则:当你要新增一种节点——比如一个「软链接」节点(它自己不存内容,只指向另一个节点)——只要让它实现 FileSystemNode、给出自己的 get_size(返回被指向节点的 size),客户端那段 print(root.get_size()) 一个字都不用改。遍历逻辑只认 Component 接口、不认具体类型,所以新类型天然「插进树里就能用」。反过来看,如果没有组合模式,每加一种节点,所有 isinstance 分支都要补一刀,代码会随节点类型线性膨胀。
把例子再拉长一层也不改变客户端:哪怕 docs 下面还套了 2026/、2026/09/、09/ 三级目录,客户端依旧只调 root.get_size()——新增的层级对调用方完全透明。这正是「组合」二字的含义:无论嵌套多深,对外都表现成「一个对象」。
把这个「不感知」写成一个通用函数就更清楚了:
# 客户端只认 Component,对任何节点一视同仁
def client_code(node: FileSystemNode) –> int:
return node.get_size() # 不管 node 是 File 还是 Folder
client_code 的签名里完全没有 if,也没有 isinstance。它能被传进任何一个节点——单个文件、十层深的目录树、甚至一棵混合着文件和文件夹的任意结构——行为完全一致。这就是组合模式对外承诺的「一致性」:调用方看到的世界永远是「一个对象」。
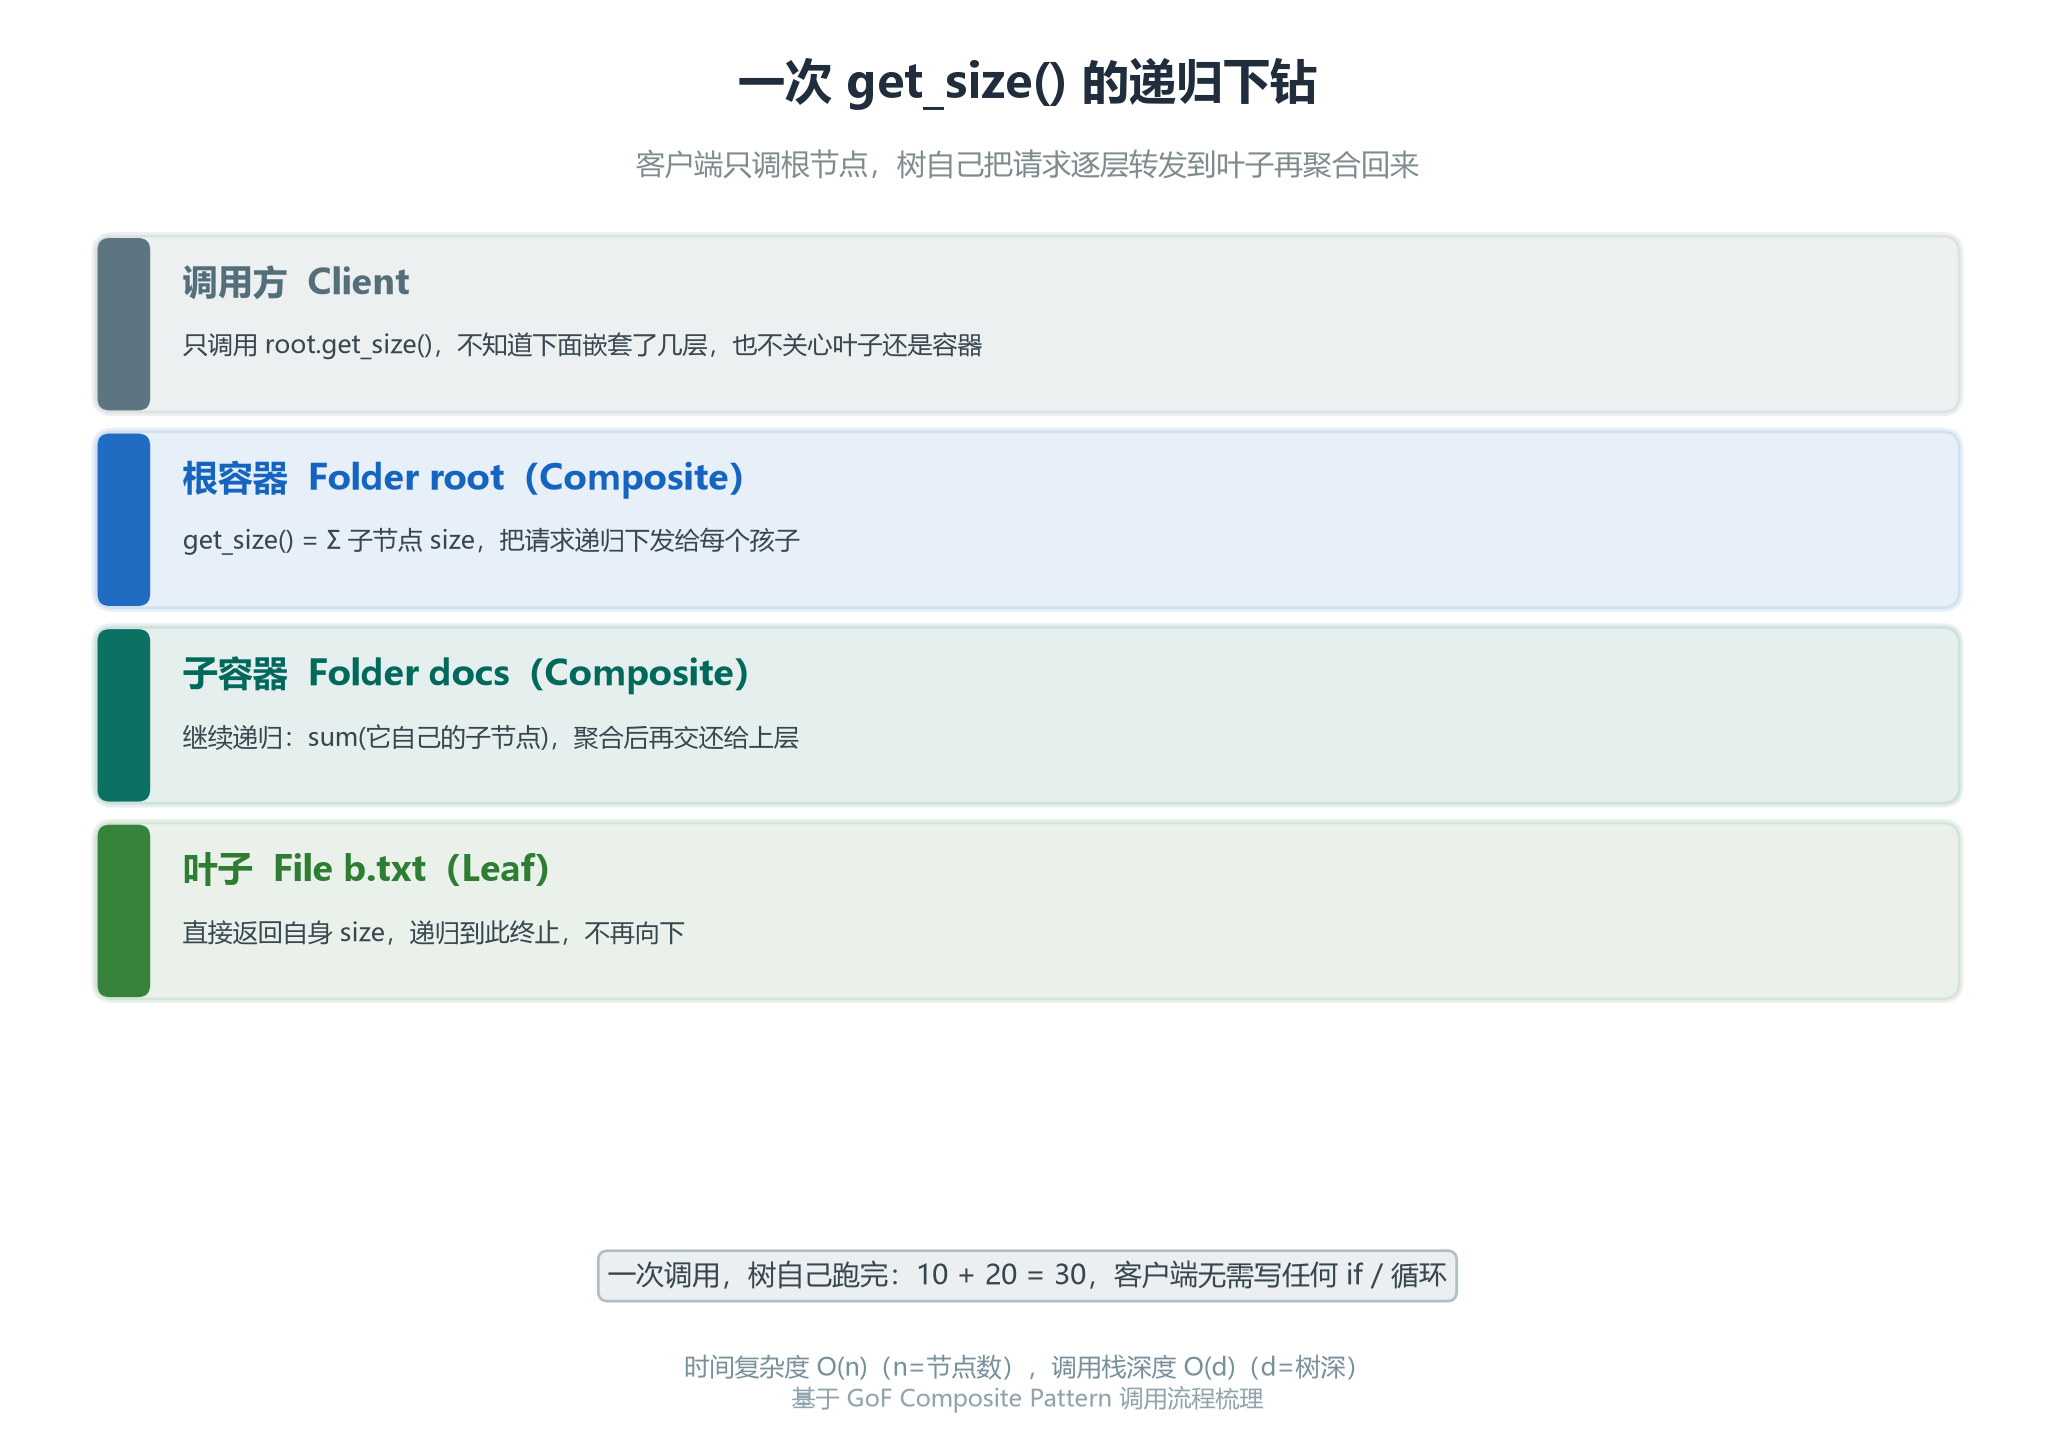
(图一:一次 get_size() 的递归下钻——客户端只调根节点,树自己把请求逐层转发到叶子再聚合回来)
顺带记一个复杂度结论,后面调优时很有用:对一棵有 n 个节点、深度为 d 的树,一次 operation() 的时间复杂度是 O(n)(每个节点只访问一次),而调用栈深度是 O(d)。也就是说,耗时随节点数线性增长,但栈开销只跟树的"最深的一条枝"有关。
四、child-management 放哪?透明式与安全式的取舍
写骨架时我特意把 add/remove 写在了 Component(也就是 FileSystemNode)上。这其实是组合模式里第一个、也是最容易纠结的设计决策。
透明式与安全式,到底怎么选?
GoF 给出了两种摆法,差别只在"子节点管理方法"声明在哪个类:
- 透明式(Transparent):把 add/remove/getChild 全写在 Component 上,于是 Leaf 和 Composite 对外接口完全一致,客户端永远不需要转型,统一当 Component 用。代价是 Leaf 被迫暴露了它根本用不到的 add/remove(在 Python 里我们让它们抛 NotImplementedError,在静态语言里则往往要空实现或抛异常),这轻微违反了接口隔离原则。
- 安全式(Safe):Component 只留 get_size 这类公共操作,add/remove 只在 Composite 里声明。Leaf 的接口因此很干净,编译器能在编译期拦住"对文件调 add"的非法操作。代价是客户端如果想改树的结构,必须先 isinstance 判断再转型成 Composite 才能调,统一性被打破了一角。
# 安全式写法:Component 上【不】声明 add/remove
class FileSystemNode(ABC):
@abstractmethod
def get_size(self) –> int: ...
class Folder(FileSystemNode):
def add(self, node): self.children.append(node) # 只在 Composite 声明
# 客户端要管结构,必须先判断类型再转型:
if isinstance(root, Folder):
root.add(File("c.txt", 5)) # 不判断就调 add 会直接报 AttributeError
GoF 原书推荐优先透明式,理由是它保住了组合模式最宝贵的那点好处——“客户端不关心类型”。但在 Java / C# / Go 这类静态强类型项目里,团队往往为了编译期安全而选安全式。一个务实的建议是:先定一个,别让它在两种之间摇摆——同一个项目里混用两种,比只用其中一种更让人迷惑。
除了透明式和安全式,工程里还有几个常见变体值得知道,它们都是在「基础三件套」上按需加的料:
- 带父引用的组合:在每个节点上存一个指向父节点的引用(通常在 Component 里声明)。它让「从任意子节点向上遍历」或「高效删除自己」变容易——remove 时不用让父节点全树搜索,直接找父节点摘掉即可;代价是要自己维护这条引用链,节点新增或移动时同步更新。
- 缓存组合:如果聚合操作(如 get_size、文档块展开)很贵又频繁调用,可以让 Composite 缓存上一次结果,并在任一子节点变化时把缓存置脏。这是用一点内存换掉重复计算,深度大、读多写少的树收益明显。
- 享元组合:当叶子节点数量极大、且很多叶子内容相同时,用享元(Flyweight)让这些叶子共享同一份内部状态,只为不同的组合付费。代价是共享节点不能再被两棵子树「各自独占修改」。
选变体仍是同一个原则:先看清你的树「读多还是写多、深不深、节点多不多」,再决定要不要为它加父引用、缓存或共享。
补充一点语言差异:Python / JavaScript 这类动态类型语言,因为「鸭子类型」,客户端本来就不关心对象具体类型,透明式几乎是零成本——add 调在 Leaf 上运行时才报错。而 Java / C# / Go 有编译期检查,透明式会让 Leaf 上那些无意义方法「编译通过、运行爆炸」,所以这些语言更倾向安全式,把类型错误尽量挡在编译期。选哪种,先看你的语言怎么帮你查错——这也是为什么同一套模式,在 Python 项目里常写成透明式,在 Java 项目里常写成安全式。
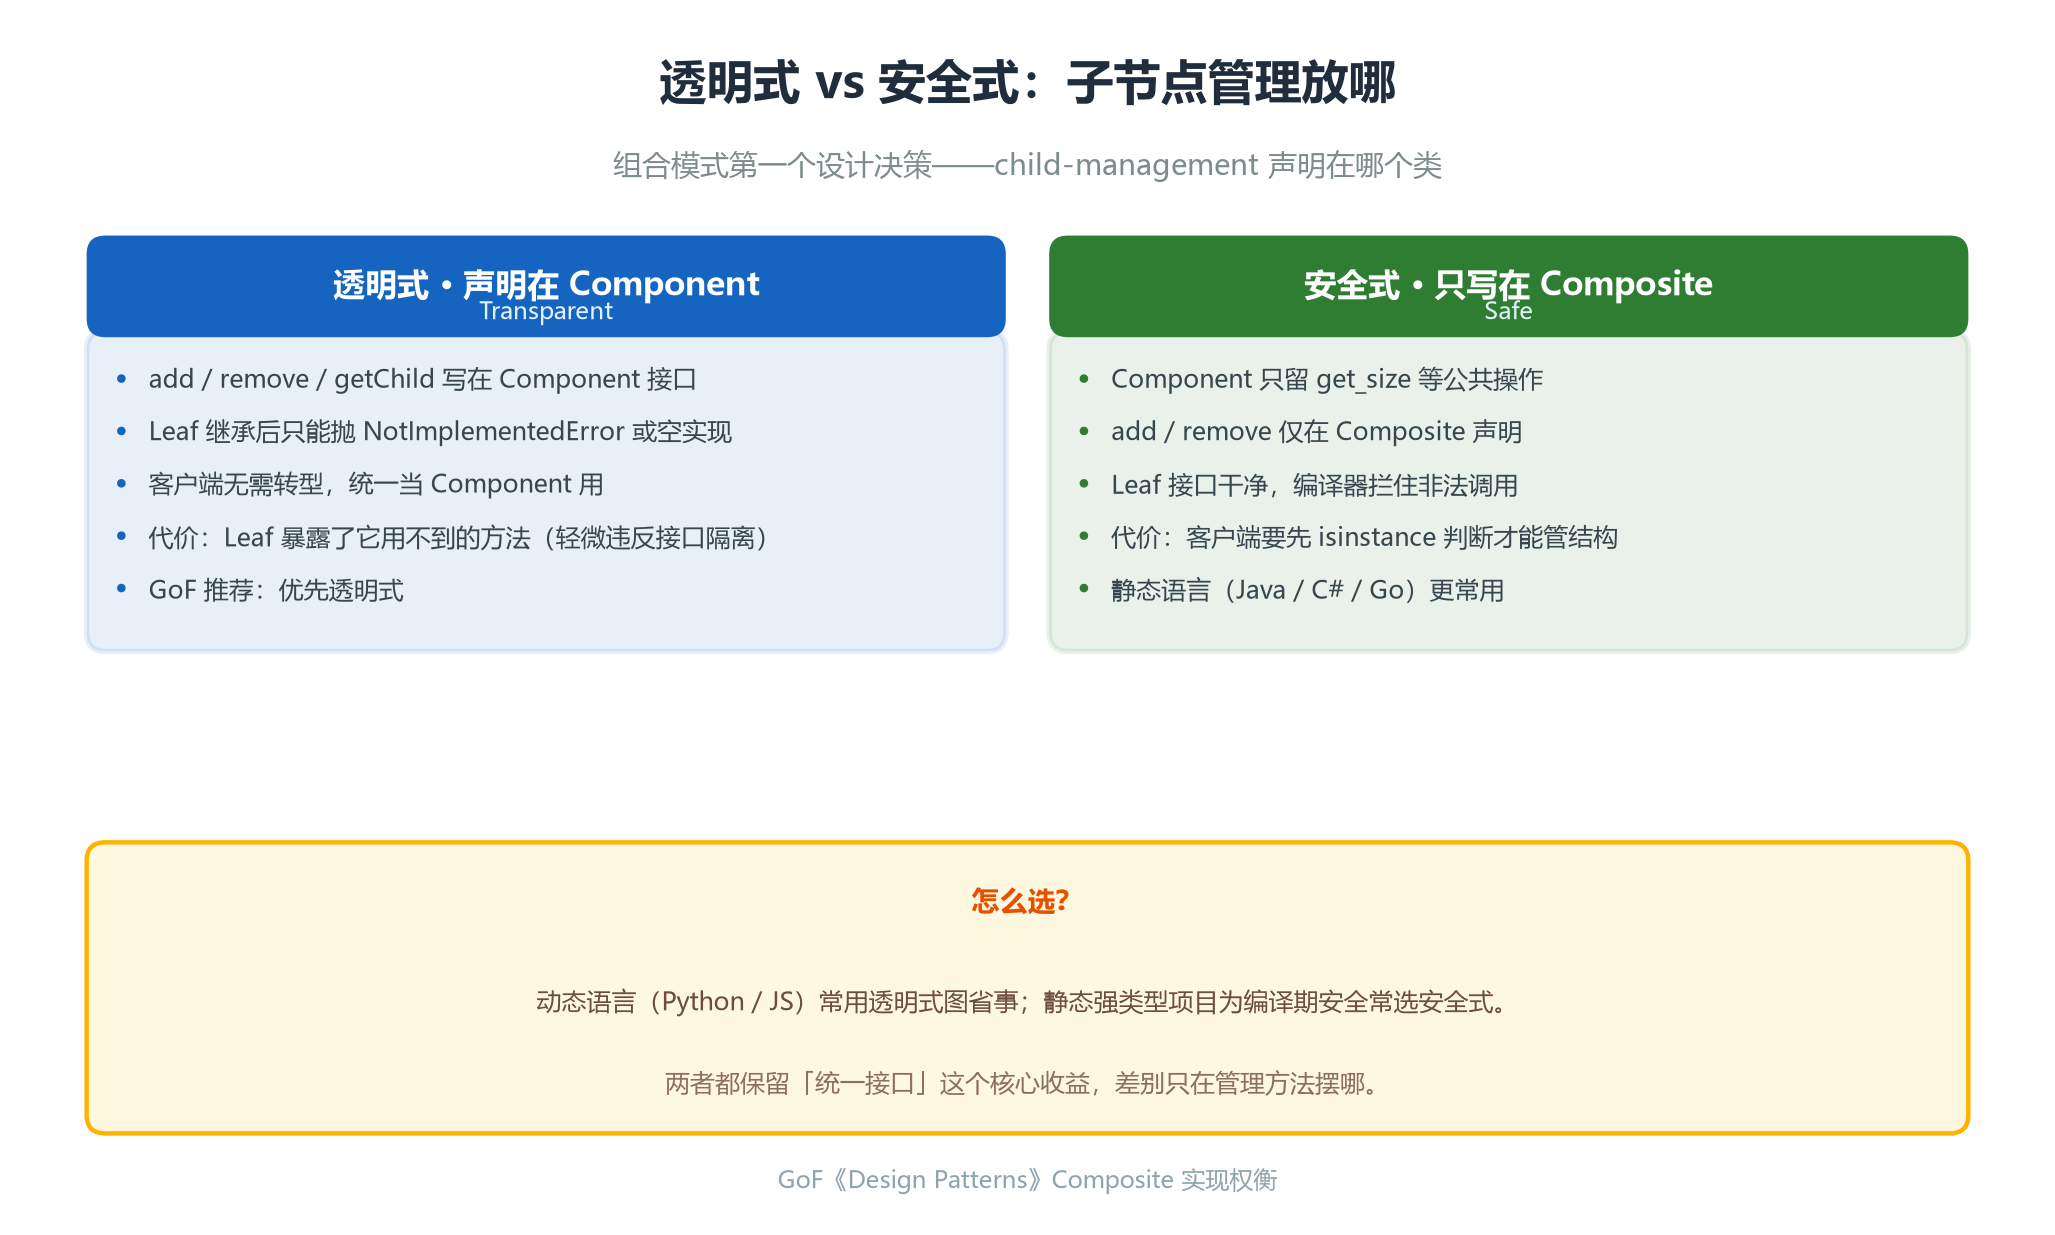
(图二:透明式把子节点管理放在 Component,安全式只放在 Composite;两者都保留"统一接口"这个核心收益,差别仅在管理方法摆哪)
五、几个容易踩的坑
Leaf 的 add() 该抛异常还是空实现?
这是透明式落地时第一个要拍板的点。两种都算"正确",但语义不同:抛异常(raise NotImplementedError)明确表示"这个操作对叶子无意义",调用方误用会立刻报错,适合把树当严格 part-whole 结构用的场景;空实现(直接 pass)则会让误用"静默成功",埋下难以排查的 bug。除非你有明确理由要吞掉错误,否则优先抛异常——至少把错误暴露出来。一个小测试能帮你定调:如果你预期调用方「偶尔会搞错节点类型」,抛异常能在最早的地方报警;如果你预期「调用方大量无差别地对所有节点调 add,且绝大多数是叶子、忽略即可」,那空实现反而让主流程更顺——但这种情况往往说明接口本身就该用安全式,把 add 暴露成 Composite 专属,而不是在 Leaf 上悄悄吞掉。
组合模式能直接套到图结构(含环)吗?
不能直接套。经典组合模式假设结构是一棵树:每个子节点有且仅有一个父节点,没有环。一旦你的数据其实是"图"(比如 Git 的 merge commit 有两个父节点、文件系统的软链接会形成环),普通组合实现没有自带的环检测,递归会陷入死循环。要在图结构里复用这个思路,必须额外维护一个遍历时的 visited 集合,并明确定义"节点归属/聚合"的语义——到这一步,往往一个专门的图表示反而更合适。一个实用的折中:如果数据本质是图、但你能保证「每个节点在遍历时只被访问一次」(比如有向无环图且每条路径去重),仍可用组合模式承载,只需在递归入口维护 visited;一旦可能出现环,就必须显式检测,否则和普通的深度优先搜索一样会栈溢出或死循环。换句话说,组合模式假设的是「树」,越界成「图」前要先把环的问题解决掉。
树太深会不会栈溢出?
会,而且是生产环境里真会发生的事。递归下发的调用栈深度等于树的深度 d,而调用栈空间是有限的:前面验证过 Python 默认递归深度上限约 1000 层,Java / .NET 取决于线程栈大小,JavaScript 引擎也有各自的实现上限。当树的深度不可控、可能非常深时,把递归改成"显式栈 / 队列"的迭代遍历会更稳;如果还要频繁对百万级节点做聚合,考虑把聚合结果(如总大小)缓存起来,而不是每次现算。缓解手段有三档:最轻量是调大语言或运行时的递归上限(Python 可用 sys.setrecursionlimit,但只是延后、不是根治);更稳的是把递归改成「显式栈」的迭代遍历,调用栈深度降到 O(1);最彻底的是在 Composite 层做「扁平化缓存」——把整棵树的聚合结果物化成一列,后续操作直接走线性结构。树深度不可控时,第二档通常是默认选择。
共享子节点要小心多父问题
还有一类容易忽略的坑:共享子节点(多父)。GoF 提到可以用享元共享组件来省内存,但经典组合模式假设「每个子节点有且仅有一个父节点」。如果你把一个子节点同时挂到两个父节点下(比如两份文档都引用同一张图),遍历、删除、计数都会出问题——删除一个父节点时到底要不要连带删掉共享子节点?计数时这张图算一次还是两次?真要共享,得显式约定所有权语义(谁拥有、谁只引用),并配合 visited 集合避免重复处理,而不是默认它「既能挂这也能挂那」。
六、在大模型工程里它出现在哪
组合模式不是教科书玩具。凡是"单个元素"和"一组元素"需要被同等对待的树形场景,它都能直接落地。下面三个都是大模型应用开发里的真实落点,代码以骨架形式给出(职责靠注释自解释,不展开长段分析)。
为什么组合模式在大模型工程里出镜率这么高?因为 LLM 应用天然是「树」:一个用户请求会被分解成一棵树(任务规划 → 子任务 → 工具调用),一段 prompt 也是一棵嵌套块(系统提示 → 示例 → 变量),一份知识库更是一棵文档树(库 → 文档 → 段落 → 切片)。这些结构都有一个共同特征:调用方只想对「一个节点」发指令,至于背后是单个还是一整棵子树,它一个字都不想管。下面三个落点,都是把这个特征直接映射成代码。
场景一:Agent 的任务树。 一个原子工具调用和一个多步子计划,都应该能用同一种方式被驱动:
from abc import ABC, abstractmethod
class AgentStep(ABC):
"""Component:原子步骤与步骤组共用一个 run 接口"""
@abstractmethod
def run(self, ctx: dict) –> dict: ...
class ToolCall(AgentStep):
"""Leaf:一次具体工具调用"""
def __init__(self, tool: str, args: dict):
self.tool, self.args = tool, args
def run(self, ctx):
ctx[self.tool] = call_tool(self.tool, self.args) # call_tool 为示意桩
return ctx
class Plan(AgentStep):
"""Composite:顺序执行一组子步骤"""
def __init__(self, steps: list["AgentStep"]):
self.steps = steps
def run(self, ctx):
for step in self.steps:
ctx = step.run(ctx) # 统一接口,递归/顺序下发
return ctx
# 单个工具调用、和"外层计划套内层计划"用同一种方式驱动
pipeline = Plan([
ToolCall("search", {"q": "…"}),
Plan([ToolCall("read", {"url": "…"}), ToolCall("summarize", {})]),
])
pipeline.run({}) # 客户端不知道嵌套了几层
场景二:Prompt 的块组合。 系统提示、Few-shot 示例、变量块,本质都是"能渲染成字符串的块",组合后统一 render:
class PromptBlock(ABC):
@abstractmethod
def render(self, ctx: dict) –> str: ...
class StaticBlock(PromptBlock):
def __init__(self, text: str): self.text = text
def render(self, ctx): return self.text
class PromptGroup(PromptBlock):
def __init__(self, blocks: list["PromptBlock"]):
self.blocks = blocks
def render(self, ctx):
return "\\n".join(b.render(ctx) for b in self.blocks)
# 系统提示 + 少量示例 + 变量块,组合后一次 render 出完整 prompt
prompt = PromptGroup([StaticBlock("你是一个严谨的助手"), fewshot, var_block])
场景三:RAG 的文档树。 一篇文档和一个"文档集合"都能对外提供 get_chunks,检索时统一展开:
class DocNode(ABC):
@abstractmethod
def get_chunks(self) –> list[str]: ...
class LeafDoc(DocNode):
def __init__(self, text: str): self.text = text
def get_chunks(self): return [self.text] # 真实场景会先做切片
class DocCollection(DocNode):
def __init__(self, children: list["DocNode"]): self.children = children
def get_chunks(self):
return [c for ch in self.children for c in ch.get_chunks()]
这三个场景的共同点:客户端只想对一个"节点"调用 run / render / get_chunks,至于它背后是单个还是一整棵子树,调用方一个字都不用管。把组合模式用在这里,比每次手写 if isinstance 遍历要干净得多,也更经得起节点类型的扩展。
再补一个工程提醒:组合树一旦用于真实 Agent 编排,要注意「单点失败」——一个 ToolCall 抛异常,整条 Plan 的递归链会中断。实际项目里通常给每个 Leaf 自带兜底(重试、或返回错误节点而不是崩溃),或在 Composite.run 里用 try 包住每步并把失败节点记入 ctx,让上层决定怎么继续。模式解决的是「统一接口」,容错要另写,别指望组合模式替你兜住运行时错误。
七、什么时候该上、什么时候别上
组合模式很好用,但它是"树形 part-whole"的解药,不是万能药。判断要不要上,可以用下面这张决策矩阵快速定位。
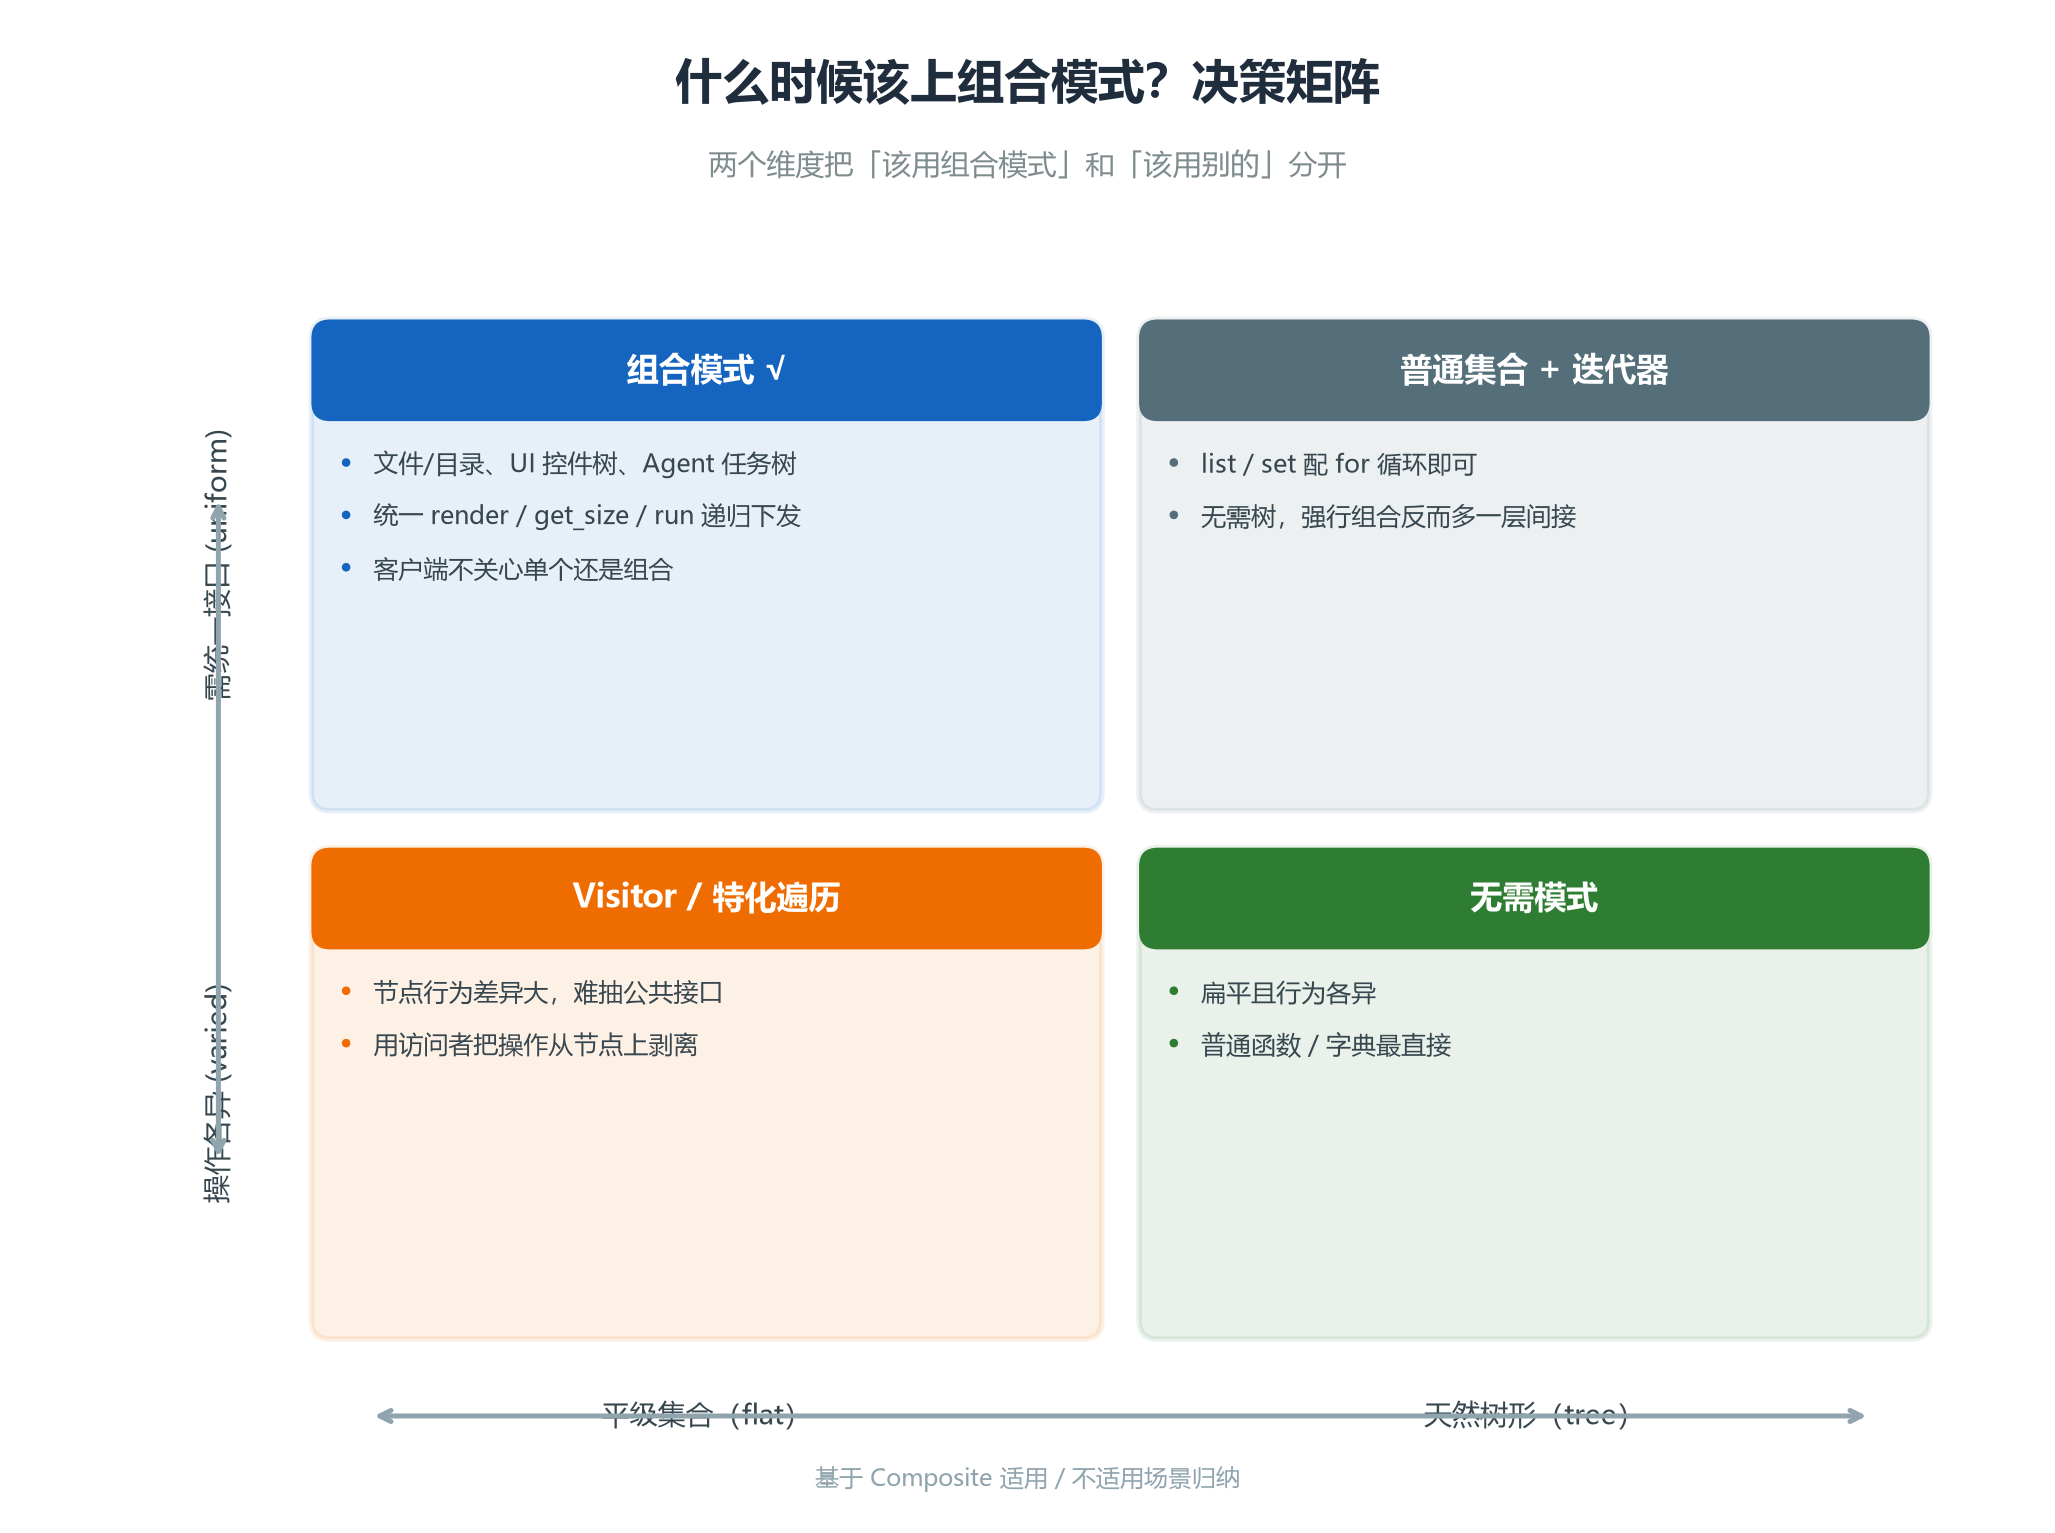
(图三:数据是否天然树形 × 节点是否需统一接口——两个维度把"该用组合模式"和"该用别的"分开)
落在左上角(树形 + 需统一操作)才是组合模式的主场,文件/目录、UI 控件树、Agent 任务树都在这里。右下角(平级 + 行为各异)根本不需要任何模式,普通函数或字典最直接;左下角(树形但行为差异大)更适合把操作从节点上剥下来,用访问者(Visitor)之类解决;右上角(平级但需统一操作)一个 list 加 for 循环就够。
另一个常和它搞混的是装饰器(Decorator)。两者都靠"同一接口 + 持有同类型对象"工作,长得像,但意图完全不同:
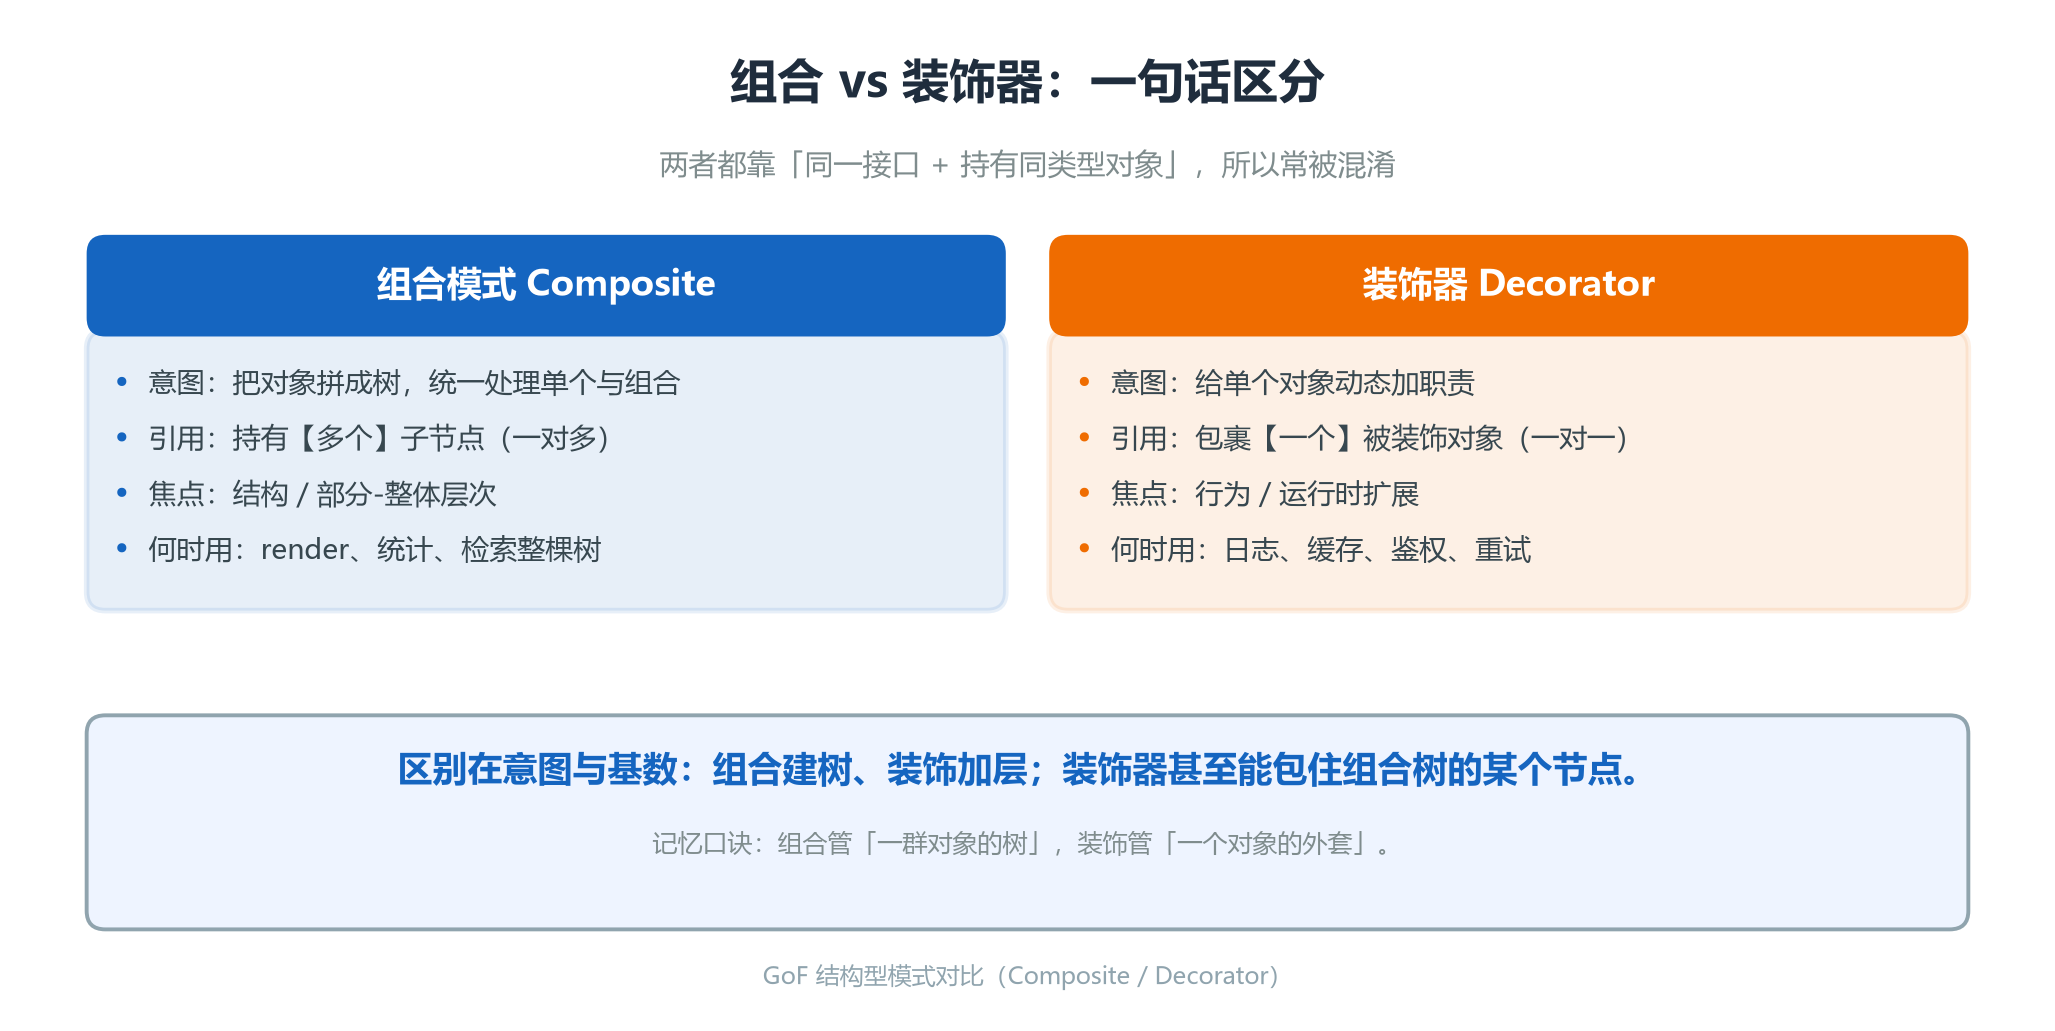
(图四:组合是"一对多"建树、关注结构;装饰器是"一对一"包装、关注行为。一图分清两者)
组合模式在结构型模式家族里位置清晰,顺手和其它几个也划清边界,免得选型时纠结:和适配器(Adapter)的关系是——适配器解决「接口不兼容」,组合解决「结构统一」,两者不冲突,组合树里的某个节点完全可以被适配器包一层去对接老接口;和外观(Facade)的关系是——外观给复杂子系统一个简化门面,组合给递归结构一个统一接口,外观内部有时就用组合来组织子系统;和装饰器的区别见上图。一句话:当你要的是「建一棵树并统一对待」,选组合;要的是「接上不兼容的接口」「给系统开个简单入口」「给对象加层行为」,分别去找适配器、外观、装饰器。
最后诚实地提一句代价:组合模式有时会让设计「过于通用」。因为接口对叶子和容器一视同仁,类型系统很难再帮你约束「某个容器只允许特定种类的子节点」——例如你想规定「文件夹下只能挂图片、不能挂另一个文件夹」,组合模式本身不会拦你,得自己在 add 里做运行时检查。换句话说,它换来了客户端的解耦,代价是把一部分约束从编译期推迟到了运行期。清楚这点,才不会在需要强类型约束的场景里误用。
一句话记住:组合模式关心"怎么把一群对象拼成一棵树并统一对待",装饰器关心"怎么给单个对象在运行时加一层职责"。甚至它们还能叠加——用一个装饰器去包住组合模式里的某个节点,就能给整条分支统一加日志或缓存。
再补一句性能视角的提醒:组合模式的递归下发是「惰性且按需」的,没被调用的分支不会执行,这点和手写 for 循环遍历没区别;真正的成本在深度——前面说过栈深 O(d),所以「树很深 + 频繁调用」时要优先考虑迭代遍历或结果缓存(见第四节的缓存组合)。另外,组合模式解决的是「统一接口」,它不替代「怎么高效遍历这棵树」:如果你还需要按特定顺序访问、或要对遍历做暂停 / 恢复,把遍历逻辑抽成独立的迭代器(Iterator),或与访问者(Visitor)配合,会比把所有遍历都写进每个节点更清晰。模式之间该组合就组合,不必非此即彼。
总结
组合模式用一段并不复杂的代码,换掉了客户端里大量"先判断类型再处理"的样板逻辑。把这篇的几个要点收一下:
回到开头那段反例:用组合模式重写后,print_size 会变成「对任何节点统一调 get_size」的一行,所有 isinstance 分支彻底消失。省下的不只是几行代码,更是「节点种类越多、省得越多的那部分维护成本」——这正是模式的复利。
在大模型应用开发里,Agent 任务树、Prompt 块组合、RAG 文档树都是它现成的落脚点——下一次当你想写 if isinstance(node, …) 去区分"单个"和"一组"时,先想一下:这棵结构,是不是该用组合模式交给树自己去跑?
#设计模式 #组合模式 #Composite #Python #大模型工程


评论前必须登录!
注册