 网硕互联帮助中心
本篇目标:
掌握string类的部分接口的实现
一. string类的底层实现
1.构造函数
首先我们为了与tsd库里面的string 隔离一下,我们需要定义一个自己的命名空间,我的就是kong了,C++ 中的字符串本质上是由字符数组构成的,而 C 风格字符串底层就是:
char*
所以这个模拟string 类的大致框架为:
在string类中:
#pragma once
#define _CRT_SECURE_NO_WARNINGS
#include <iostream>
#include <assert.h>
using namespace std;
namespace kong
{
class string
{
public:
string()
:_str(nullptr),
_size(0),
_capacity(0)
~string()
{}
private:
char*_str;
size_t _size;
size_t _capacity;
};
}
其中:
- _str 指向动态开辟的字符空间
- 字符串内容存储在 _str 指向的数组中
-
_capacity表示当前开辟的容量。
- 当前有效字符数量。
然后我们再实现一个c_str的接口,方便后面看这个字符串是否是符合我们预期结果的,这个还是比较简单的,如代码所示:
const char* c_str()const { return _str; }
那么在string.cpp中,
#include "string.h"
namespace kong
{
void test_string1()
{
string s1;
cout<<s1.c_str()<<endl;
}
}
注意:这个test_string1也就是测试代码,我们还需要在string.h里面的kong命名空间里面有个声明,后面就不再提醒了。
我们接下来就可以直接在test.cpp中进行测试了,如代码:
#include "string.h"
int main()
{
test_string1();
return 0;
}
注意:后面我们仅需在这里面添加一个测试代码即可,后面就不在演示了,直接测试即可。
运行结果:

可是我们发现这个居然失败了,这是为啥啊?
原因:其实我们在给 s1 初始化时,是使用 nullptr 初始化 _str 的。但是 c_str() 返回的是 const char*,它需要返回一个有效的 C 风格字符串。如果 _str 是 nullptr,那么返回的就是空指针,后续访问时相当于解引用 nullptr,会导致错误。因此,_str 不应该初始化为 nullptr,而应该开辟一块空间存放 '\\0',保证空字符串也符合 C 风格字符串的要求。
所以正确的默认构造是这样子的:
string():_str(new char[1]{'\\0'}),_size(0),_capacity(0)
{ }
有了这个以后,其他的构造函数也是比较简单的,如代码所示:
//构造函数
string(const char* str)
{
size_t len = strlen(str);
_size = _capacity = len;
_str = new char[_capacity + 1];
strcpy(_str, str);
}
//拷贝构造函数
string(const string& str)
{
_size = str._size;
_capacity = str._capacity;
_str = new char[_capacity + 1];
strcpy(_str, str._str);
}
2.赋值重载与析构函数
对于赋值重载函数来说,我们需要考虑被赋值对象原有空间大小的问题。如果赋值对象的空间比当前对象大或者小,都可以直接释放原来的空间,然后根据新的字符串长度重新开辟一块合适大小的空间,再进行数据拷贝。
但是这里还有一个需要注意的问题:如果出现自己给自己赋值的情况,例如 s1 = s1,如果不提前判断,而是先释放原来的空间,再使用 strcpy 拷贝数据,那么此时源数据已经被释放,后续访问会导致未定义行为。因此,在赋值重载函数中需要先判断是否为自身赋值,如果是则直接返回,避免不必要的资源释放。
代码块:
string& operator=(const string& str)
{
if (this != &str)
{
delete[] _str;
_size = str._size;
_capacity = str._capacity;
_str = new char[_capacity + 1];
strcpy(_str, str._str);
}
return *this;
}
析构函数:
~string()
{
_size = _capacity = 0;
delete[] _str;
_str = nullptr;
}
3.小接口实现
char& operator[] (size_t pos)
{
assert(pos < _size);
return _str[pos];
}
const char& operator[] (size_t pos)const
{
assert(pos < _size);
return _str[pos];
}
char& back() { return _str[_size – 1]; }
char& front() { return _str[0]; }
size_t size()const { return _size; }
size_t capacity() { return _capacity; }
void clear() { _size = 0; }
bool empty() {return _capacity == 0 ? true : false;}
其实对于[]的重载,我们需要注意判断一下pos的位置是否在_size的范围里面。
4.插入接口
4.1.push_back和append函数
首先我们需要注意的是,在向字符串尾部中插入字符/字符串时,如果当前空间已经满了,那么就需要进行扩容。
但是对于 C++ 中的动态数组来说,我们无法像 C 语言中的 realloc 一样直接对原空间进行扩容。因为 realloc 可能会直接在原空间后面扩展,也可能会重新申请一块新的空间并拷贝数据,而 C++ 中使用 new[] 开辟的空间不能直接扩展。
因此按照之前的思路,我们仍然需要:
但是这里又有一个问题:
新的空间应该开辟多大呢?
对于 push_back 插入一个字符来说,如果每插入一个字符就只增加一个空间:
例如:
插入'a' -> 扩容一次
插入'b' -> 扩容一次
插入'c' -> 扩容一次
…
那么每次插入字符都需要重新申请空间,而申请空间本身是一个比较耗时的操作,会严重降低效率。
所以实际工程中不会每次只增加一个字符的空间,而是采用扩容机制。
通常情况下:
new_capacity = old_capacity * 2;
也就是将容量扩大为原来的两倍。
这样可以减少频繁申请空间的次数。
但是对于 append 函数来说,情况又有所不同。
push_back 每次只插入一个字符:
s.push_back('a');
所以采用倍增扩容比较合适。
但是 append 是一次插入一整个字符串:
s.append("hello");
如果仍然按照原来的 capacity * 2 扩容,可能会出现空间不足的问题。
例如:
当前:
_size = 10
_capacity = 16
现在追加:
"abcdefghijklmnopqrstuvwxyz"
长度:
len = 26
那么新的需求:
_size + len = 36
但是:
_capacity * 2 = 32
仍然无法满足需求。
所以对于 append,我们应该根据实际需要的空间进行扩容:
new_capacity = _size + len;
也就是:当前字符串长度 + 新插入字符串长度。
这样能够保证一次扩容后一定能存放新的字符串。
不过实际实现时,还需要注意:
如果:
_size + len > _capacity
才需要扩容。
如果:
_size + len <= _capacity
说明当前空间已经足够,直接进行拷贝即可,不需要重新申请空间。
有了上面的认识,我们的代码就比较好写了,
reverse:
首先我们需要在string.h声明一下需要实现的函数,将声明与定义分离,后面我就直接在string.cpp中写接口的代码:
void reserve(size_t n = 0);
void push_back(char ch);
void append(const char* str);
void string::reserve(size_t n)
{
if (n > _capacity)
{
_capacity = n;
char* str = new char[_capacity + 1];
strcpy(str, _str);
delete[] _str;
_str = str;
}
}
push_back:
void string::push_back(char ch)
{
if (_size == _capacity)
{
reserve(_capacity == 0 ? 4 : 2 * _capacity);
}
_str[_size++] = ch;
_str[_size] = '\\0';
}
append:
void string::append(const char* str)
{
size_t len = strlen(str);
if (_size + len > _capacity)
{
reserve(_size + len);
}
strcpy(_str + _size, str);
_size += len;
}
4.2.insert接口
insert 函数主要用于在字符串指定位置插入数据。在实际使用中,插入操作比较常见的有两种情况:
- 插入单个字符;
- 插入一个字符串。
因此我们主要实现这两个接口。
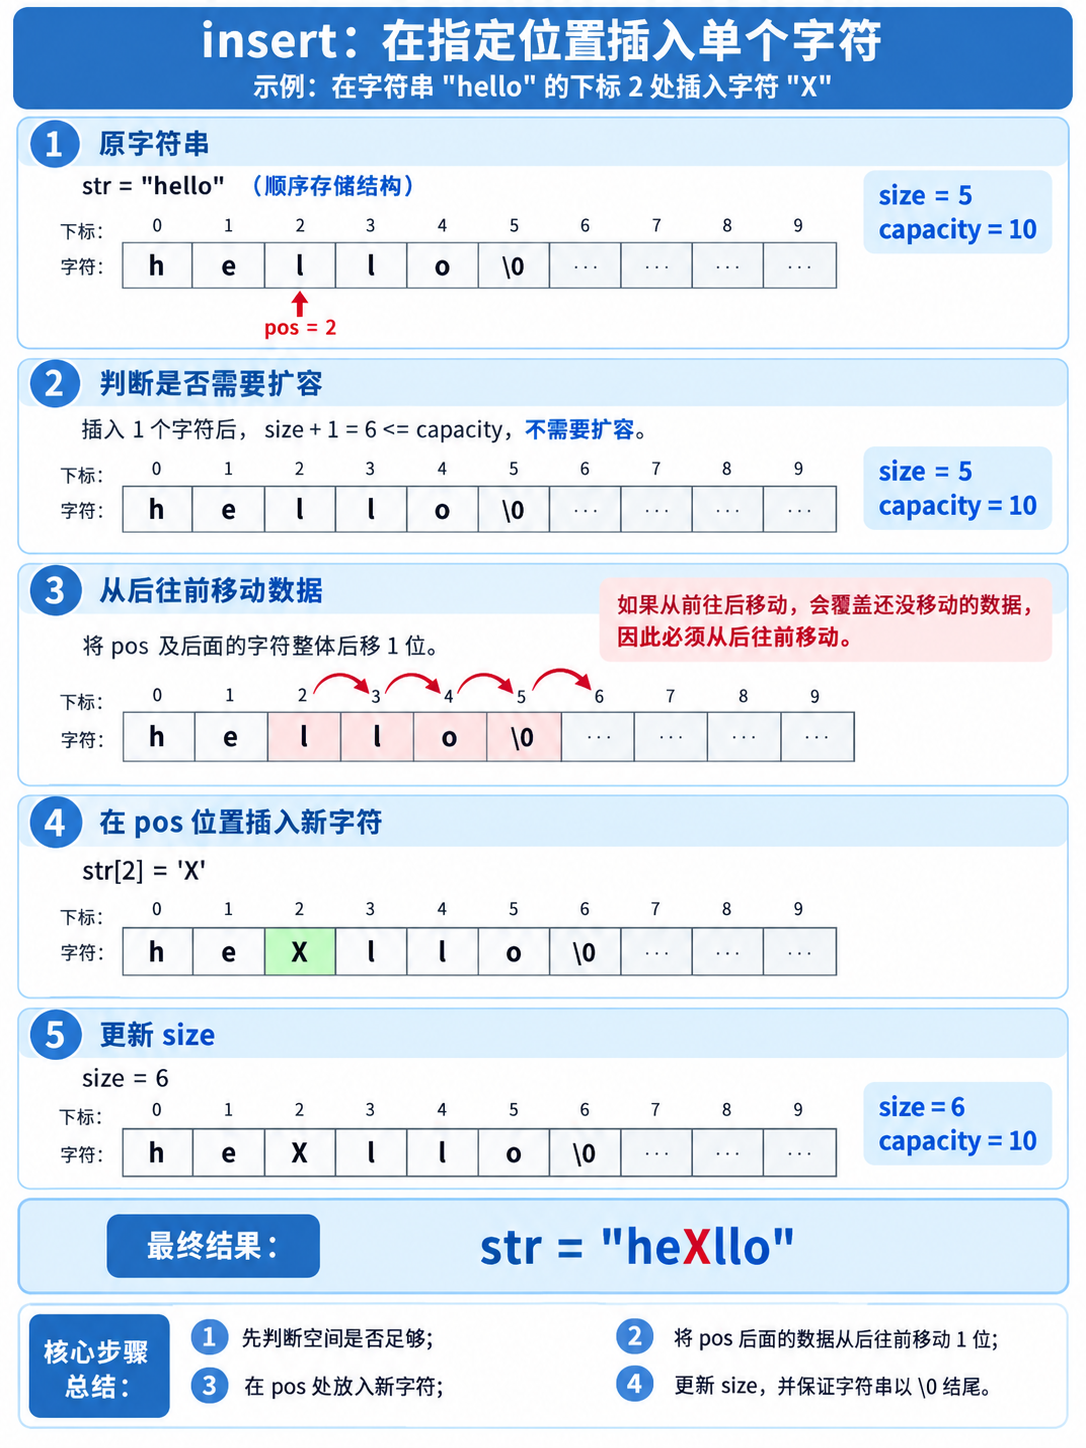
首先来看插入字符的情况。
例如:
str = "hello"
在 pos = 2 位置插入 'X'
原字符串:
h e l l o
0 1 2 3 4
插入后:
h e X l l o
0 1 2 3 4 5
可以发现:插入位置 pos 后面的所有字符都需要向后移动一个位置。
也就是:
pos及后面的字符
↓
整体向后移动1位
移动完成后:
_str[pos] = ch;
即可将新的字符放入指定位置。
过程图:
代码块:
void string::insert(size_t pos, char ch)
{
assert(pos <= _size);
// 扩容
if (_size == _capacity)
{
reserve(_capacity == 0 ? 4 : _capacity * 2);
}
// 挪动数据
size_t end = _size;
while (end >= pos)
{
_str[end + 1] = _str[end];
–end;
}
_str[pos] = ch;
_size++;
}
测试代码:
void test_string2()
{
string s1;
s1.insert(0,'1');
cout<<s1.c_str()<<endl;
}
但是当我们运行代码时,会发现程序并没有正常结束,而是出现了死循环。
那么问题出在哪里呢?
原因:
我们来看数据移动部分:
size_t end = _size;
while(end >= pos)
{
_str[end + 1] = _str[end];
–end;
}
假设:
s1 = ""
此时:
_size = 0
pos = 0
进入循环:
第一次:
end = 0
满足:
end >= pos
执行:
_str[1] = _str[0];
然后:
–end;
此时:
end = -1;
看起来应该退出循环。
但是问题来了:
我们的 end 类型是:size_t,而 size_t 是一种无符号类型。
所以:-1不能被存储。
当执行:–end时,end会发生无符号整数下溢。
结果不是:
-1
而是:
18446744073709551615
(64位环境下)
于是:
end >= pos
仍然成立。
循环继续执行:
_str[end + 1] = _str[end];
最终导致程序一直运行,也就是我们看到的“卡住”。
既然我已经知道问题出现在 size_t 类型的下溢上,那么我直接将 end 的类型修改为 int 不就可以了吗?
例如:
int end = _size;
但是我们实际修改后运行代码,仍然可能发现程序依旧出现死循环。
原因:
错误真正出现在 while 的判断条件上:
while(end >= pos)
虽然我们将:end修改成了:int
但是:pos的类型仍然是:size_t,而 size_t 是无符号整型。
在 C++ 中,当有符号整数和无符号整数进行比较时,会发生整型提升,为了保证比较结果一致,int 类型的 end 会被转换成 size_t 类型。因此也会触发与上面一样的问题,所以完整的修改是如下:
void string::insert(size_t pos, char ch)
{
assert(pos <= _size);
// 扩容
if (_size == _capacity)
{
reserve(_capacity == 0 ? 4 : _capacity * 2);
}
// 挪动数据
// version1:
int end = _size;
while (end >= (int)pos)
{
_str[end + 1] = _str[end];
–end;
}
// version2:
/*size_t end = _size + 1;
while (end > pos)
{
_str[end] = _str[end – 1];
–end;
}*/
_str[pos] = ch;
_size++;
}
其中版本2的代码也是可以通过的。
有了单个字符的插入,那么多字符插入的流程如图:

4.3.重载+=函数
既然我们已经知道了有关插入的操作,那么关于+=重载的实现就比较简单了,如代码所示:
string& string::operator+= (const string& str)
{
const_iterator it = str.cbegin();
while (it != str.cend())
{
*this += *it;
it++;
}
return *this;
}
string& string::operator+= (const char* s)
{
append(s);
return *this;
}
string& string::operator+= (char ch)
{
push_back(ch);
return *this;
}
5.删除接口
关于删除字符的操作,我们需要关注的一个点就是,当pos < _size时,如果从 pos 开始,剩余字符的个数是 _size – pos,那么当 len >= _size – pos,或者 len == string::npos 时,就相当于删到末尾。这时把 _str[pos] 改成 '\\0',再把 _size 改成 pos,字符串就被截断了。只写 '\\0' 还不够,长度也要同步更新。
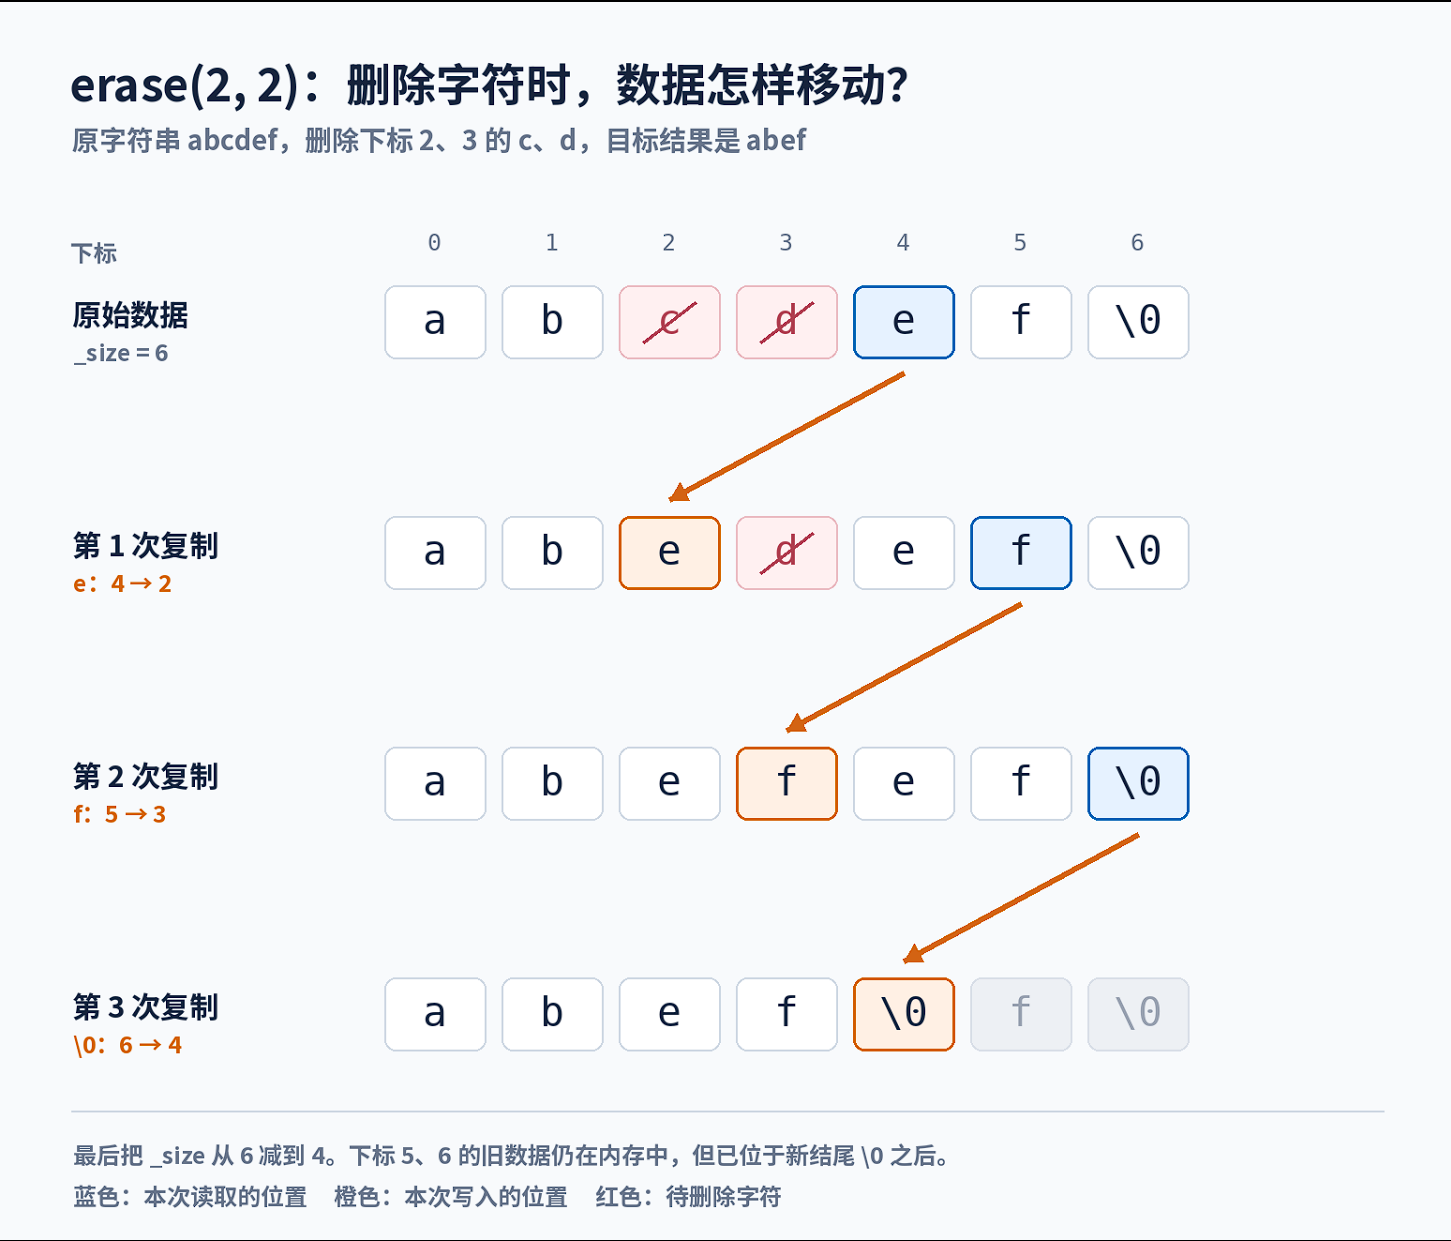
如果 len < _size – pos,说明被删除部分后面还有字符需要保留。比如:
原字符串:a b c d e f \\0
下标: 0 1 2 3 4 5 6
执行 erase(2, 2),要删掉下标 2、3 的 c、d。下标 4 的 e 是删除范围后面第一个要保留的字符,所以先把它放到下标 2,填上第一个空位。然后把 f 从下标 5 放到下标 3。最后,还得把 '\\0' 从下标 6 放到下标 4:
4 → 2:搬 e
5 → 3:搬 f
6 → 4:搬 \\0
结果:a b e f \\0
因此,挪动时有两个位置同时往后走:读取位置从 pos + len 开始,写入位置从 pos 开始。一直搬到原来 _size 所在的位置,把 '\\0' 也搬过去。搬完再执行 _size -= len。因为是往左挪,按从左到右的顺序搬就可以:每次写入的位置都在当前读取位置的前面,不会盖掉后面尚未读取的字符。
但是我们需要现在类里面定义一下这个npos,仅需static const size_t npos=-1;即可。
流程图:
代码块:
void string::erase(size_t pos, size_t len)
{
assert(pos < _size);
// pos以后的都要删除
if (len == string::npos || len >= _size – pos)
{
_str[pos] = '\\0';
_size = pos;
}
else
{
for (size_t i = pos + len; i <= _size; i++)
{
_str[pos++] = _str[i];
}
_size -= len;
}
}
6.查找接口
关于查找的接口,我们主要实现查找一个字符和查找一个字符串。
查找一个字符的比较好实现,遍历字符一遍,看看有没有匹配的字符,有就返回下标,没有就返回
npos,如代码所示:
size_t string::find(char ch, size_t pos)const
{
assert(pos < _size);
for (int i = pos; i < _size; i++)
{
if (_str[i] == ch)
{
return i;
}
}
return npos;
}
可是对于一个字符串的查找,目前我们可以暴力匹配,一个一个字符的比对,但是我们可以用一个函数解决,即strstr函数。
使用如下:
strstr 可以直接理解为:拿一个小字符串,去一个大字符串里找,调用时,第一个参数放大字符串,第二个参数放要找的小字符串。比如在 "ababcabc" 里找 "abc",就是让它从左往右检查,找到第一次出现的 "abc"。
它返回的不是下标 2,而是指向那个 a 的指针。这个 a 是大字符串中下标 2 的字符,所以返回的指针指向大字符串内部;从这个位置往后看,内容就是 "abcabc"。如果你想知道“从第几个字符开始匹配”,才用返回的指针减去大字符串的起始指针,得到 2。
没找到时,它返回空指针。还有一点:strstr 找的是以 '\\0' 结尾的字符字符串,所以放到你正在写的 string 类里理解,就是拿 _str 这样的字符数组去查,而不是让它直接处理整个 string 对象。
所以代码如下:
size_t string::find(const char* s, size_t pos )const
{
assert(pos < _size);
char*str= strstr(_str, s);
if (str == nullptr)
{
return npos;
}
else
{
return str – _str;
}
}
7.比较字符串
至于这个比较函数,我们需要重载>,<,==,>=,!=,<=即可,我们可以先重载>和==即可,其他的函数复用即可,代码如下:
bool operator>(const string& s1, const string& s2)
{
return strcmp(s1.c_str(), s2.c_str())>0;
}
bool operator>=(const string& s1, const string& s2)
{
return s1 > s2 || s1 == s2;
}
bool operator==(const string& s1, const string& s2)
{
return strcmp(s1.c_str(), s2.c_str()) == 0;
}
bool operator<(const string& s1, const string& s2)
{
return !(s1 >= s2);
}
bool operator<=(const string& s1, const string& s2)
{
return !(s1 > s2);
}
bool operator!=(const string& s1, const string& s2)
{
return !(s1 == s2);
}
8.重载>>和<<函数
这个>>的重载非常的简单,我们仅需输出字符即可,如代码:
ostream& operator<<(ostream& out, const string& str)
{
for (size_t i = 0; i < str.size(); i++)
{
out << str[i];
}
return out;
}
至于流提取:
首先调用 str.clear(),清空字符串原有的内容,让这次输入从空字符串开始。随后用 in.get() 读取一个字符。只要读到的字符不是空格 ' ',也不是换行符 '\\n',就通过 str += ch 将它追加到字符串末尾,再读取下一个字符。
例如输入内容是 "hello world\\n":第一次读取时,h、e、l、l、o 会依次加入 str;读到空格后停止,得到 "hello"。再次读取时,会从 w 开始,读到换行后停止,得到 "world"。这里的空格或换行已经被 get() 取走,只是没有加入字符串。
函数最后返回 in 的引用,是为了支持连续输入,例如 cin >> str1 >> str2:前一次调用返回的输入流,可以继续交给下一次调用使用。
不过,这份代码有一个必须指出的问题:它没有处理文件结束(EOF)。in.get() 的返回值本来可以表示“已经没有字符可读”;代码却立刻把它存进 char ch,随后只检查空格和换行。如果输入在没有这两种字符的情况下结束,循环就可能一直读下去。因此,这段代码可以用来说明逐字符读取和追加的基本思路,但博客里不能把它称为完整正确的实现。还有一点,它不会跳过开头的空格,开头就是空格时,本次读取会得到空字符串。
代码块:
istream& operator>>(istream& in, string& str)
{
str.clear();
char ch = in.get();
while (ch != '\\n' && ch != ' ')
{
str += ch;
ch = in.get();
}
return in;
}
但是还有个问题:我们这个str是要扩容的啊!扩容是要消耗时间的啊,如果我输入一大串字符到str中,那不就要不断的扩容吗?这时有人会想:那我用reserve来提前开好空间不就行了吗?那么要开多大呢?开100的话,如果我就输入一个字符,那剩下的99个空间不就浪费了吗?那么就没有更好的办法了吗?有的,如代码所示:
istream& operator>>(istream& in, string& str)
{
str.clear();
char buffer[128];
int i = 0;
int ch = in.get();
while (ch != std::char_traits<char>::eof()&& ch != '\\n'&& ch != ' ')
{
buffer[i++] = static_cast<char>(ch);
// 攒够 127 个字符,留出最后一个位置放 '\\0'
if (i == 127)
{
buffer[i] = '\\0';
str += buffer;
i = 0;
}
ch = in.get();
}
// 输入结束时,可能还有不足 127 个字符没追加
if (i > 0)
{
buffer[i] = '\\0';
str += buffer;
}
return in;
}
我们通过buffer这个字符数组来存储输入的字符,当输入的数据满足一定的条件时,就加入到str中,就可以避免多次扩容的问题了。
9.重载+函数
这个也比较简单,直接看代码即可:
string operator+ (const string& lhs, const string& rhs)
{
string tmp(lhs);
tmp += rhs;
return tmp;
}
string operator+ (const string& lhs, const char* rhs)
{
string tmp(lhs);
tmp += rhs;
return tmp;
}
string operator+ (const char* lhs, const string& rhs)
{
string tmp(lhs);
tmp += rhs;
return tmp;
}
10.交换与反转函数
交换函数,我们可以直接用库里面的,如代码所示:
void string::swap(string& str)
{
std::swap(_str, str._str);
std::swap(_size, str._size);
std::swap(_capacity, str._capacity);
}
反转函数,我们实现迭代器版的即可:
void string::reverse(iterator begin, iterator end)
{
iterator left = begin, right = end – 1;
while (left < right)
{
std::swap(*left, *right);
left++;
right–;
}
}
11.优化部分
其实有了这个交换函数后,我们的拷贝构造等函数就可以优化了,如下:
string(const string& str)
{
string tmp(str);
swap(tmp);
}
string& operator=(const string& str)
{
if (this != &str)
{
string tmp(str);
swap(tmp);
}
return *this;
}
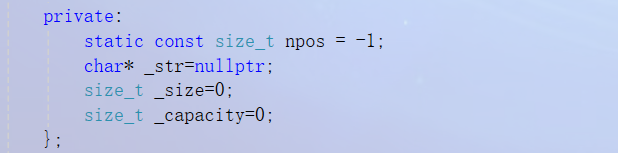
不过,拷贝构造函数里还有一个前提要检查:当前对象的成员在 swap(tmp) 前是否已经初始化。
拷贝构造是怎么工作的?
假设要根据 str 构造一个新对象:
问题出在第 2 步:**当前对象刚进入拷贝构造函数时,成员不会因为你要调用 swap 就自动变成空字符串。**如果 _str、_size、_capacity 没有类内默认值,也没有写在初始化列表里,swap 就会读取未初始化的成员;之后 tmp 还可能尝试释放一个无效指针。
因此,假设你的类没有给成员设置默认值,至少要先把当前对象初始化为空状态:
如果你已经在类里写了 _str = nullptr、_size = 0、_capacity = 0 这样的成员默认值,就不必重复写这份初始化列表,所以我们需要这么写:
赋值运算符是怎么工作的?
赋值时,当前对象本来就已经构造好了,因此可以直接创建 tmp 再交换。交换后,当前对象得到新内容,tmp 拿走当前对象的旧内容;函数结束时,tmp 的析构函数负责释放旧内容。if (this != &str) 则避免给自己赋值时白做一次复制。
12.写时拷贝
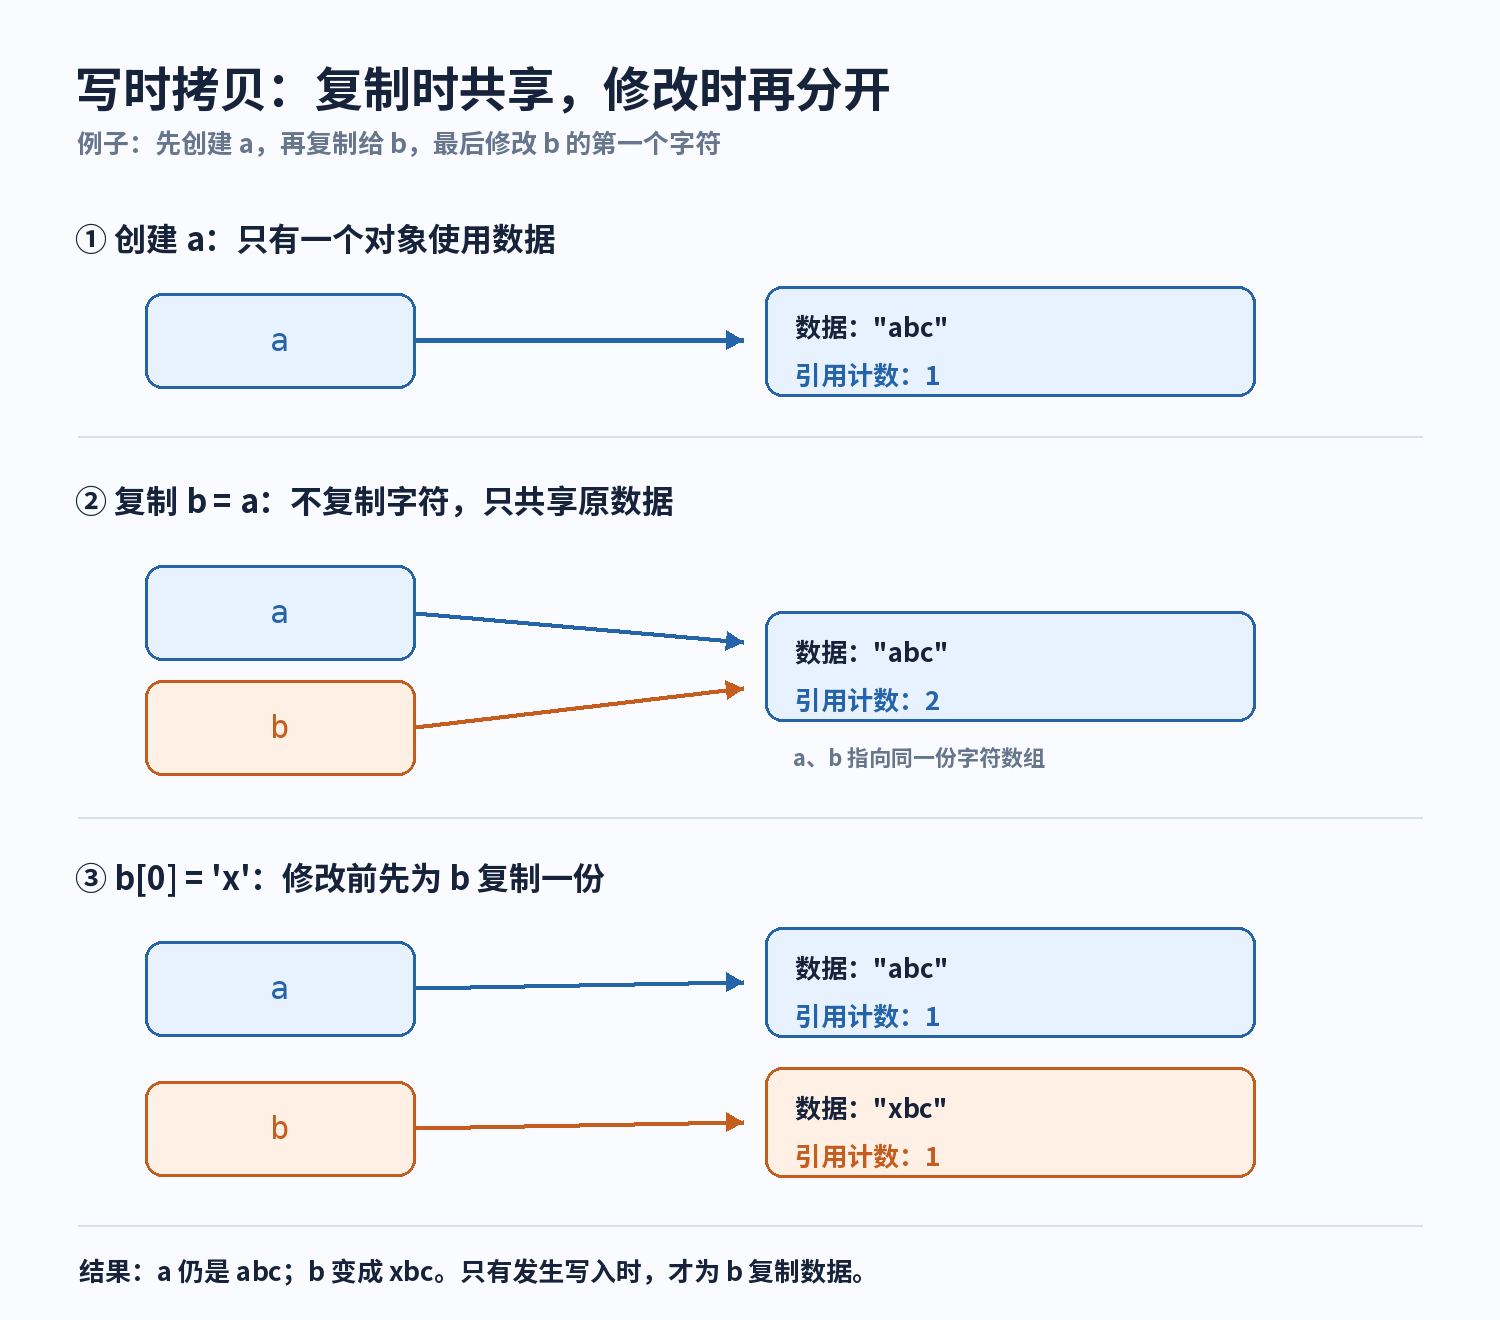
写时拷贝可以理解成:复制字符串时先不复制字符,等某个对象真的要修改字符时,再给它单独复制一份。
拿你的 string 类举例。假设 a 的内容是 "abc",然后执行 b = a。
普通的深拷贝会立刻为 b 申请新空间,把 a 的 "abc" 复制过去。此时两个对象各有一份数据。而写时拷贝会先让 a 和 b 共用同一份 "abc",并记录“现在有 2 个对象在用这份数据”。
接下来分两种情况:
- 只读取:例如查看 a、b 的内容。谁也没改数据,它们就可以继续共用,不需要复制字符。
- 准备修改:例如把 b[0] 改成 'x'。如果直接在共用的数据上改,a 也会跟着变成 "xbc",这显然不对。所以修改前,先为 b 复制一份 "abc",让 b 脱离共享;然后只修改 b 的那份。最终 a 是 "abc",b 是 "xbc"。
这里的“写时”,指的是修改数据之前。如果已经把共用的字符改了,再去复制,就晚了。
实现时通常要有一个引用计数,表示同一份字符数据正在被多少个 string 对象使用。复制对象时,计数加一;对象析构或脱离共享时,计数减一;减到零,才释放这份字符数据。执行 append、erase、修改某个字符等操作之前,都要判断:如果数据只有自己在用,就直接改;如果有多个对象共用,就先复制再改。
它和你上一段代码的区别在于:string tmp(str._str) 当场就复制了字符,属于深拷贝;写时拷贝在这一步只共享数据,真正的字符复制推迟到修改时。好处是“复制很多次、但很少修改”时能省下复制开销;代价是每次修改前都要检查是否共享,而且像 operator[] 返回可修改的 char& 这种接口会让实现变复杂——引用交出去之后,类就不一定能拦住使用者直接改字符。
总结:本文通过模拟实现 string 类,梳理了字符串的构造、扩容、插入、删除、查找和输入输出等操作。重点在于维护好字符数组、_size 和 _capacity 的关系,并理解拷贝交换与写时拷贝各自如何管理字符串数据。


评论前必须登录!
注册