 网硕互联帮助中心
如何使用Segmentation Models库对建筑物损伤分割与检测数据集进行处理_并使用YOLOv8对建筑物损伤分割与检测数据集进行处理训练
以下文字及代码仅供参考。
文章目录
- 如何使用Segmentation Models库对建筑物损伤分割与检测数据集进行处理_并使用YOLOv8对建筑物损伤分割与检测数据集进行处理训练
-
-
- 1. 数据集准备
- 2. 安装依赖库
- 3. VOC转PNG掩码
- 4. 模型训练
-
- 训练脚本
- 5. 推理与结果可视化
-
- 推理脚本
-
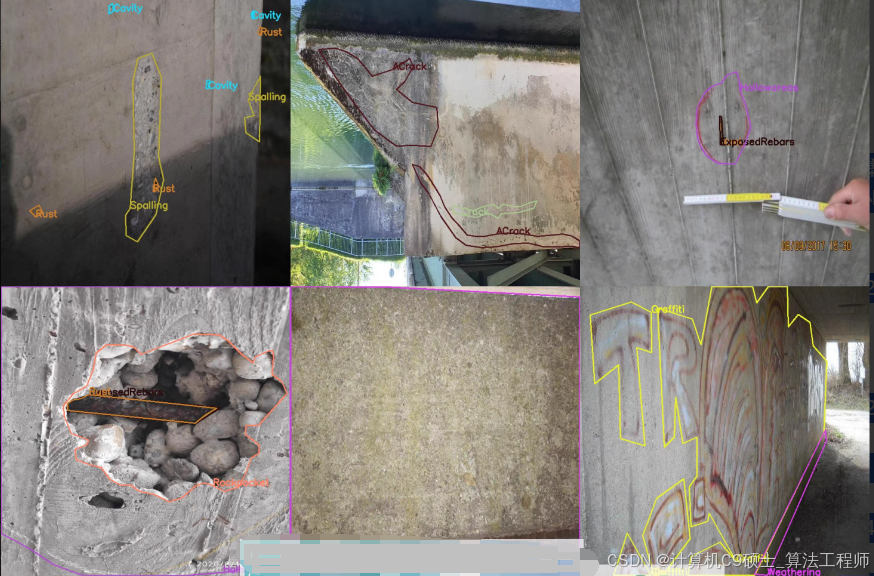
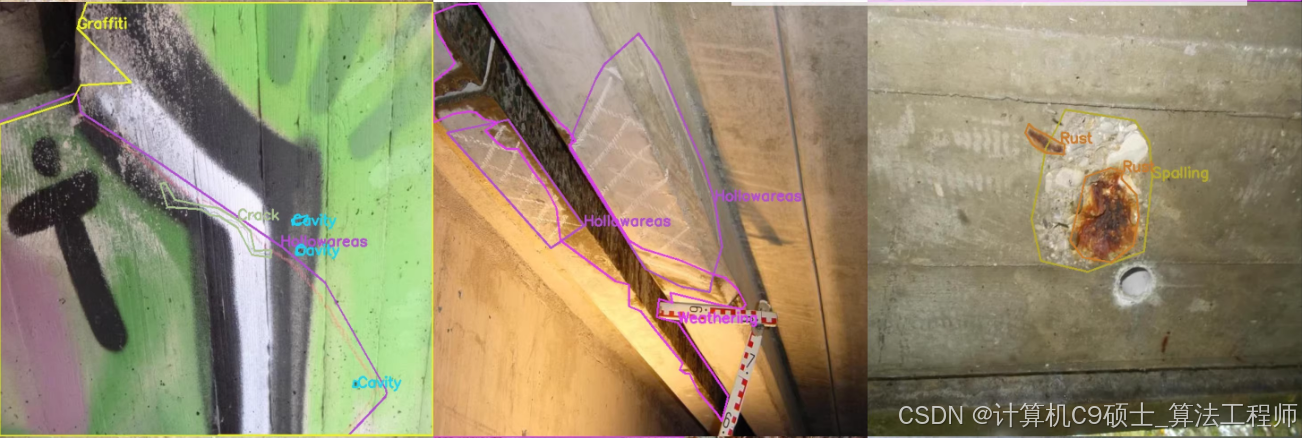
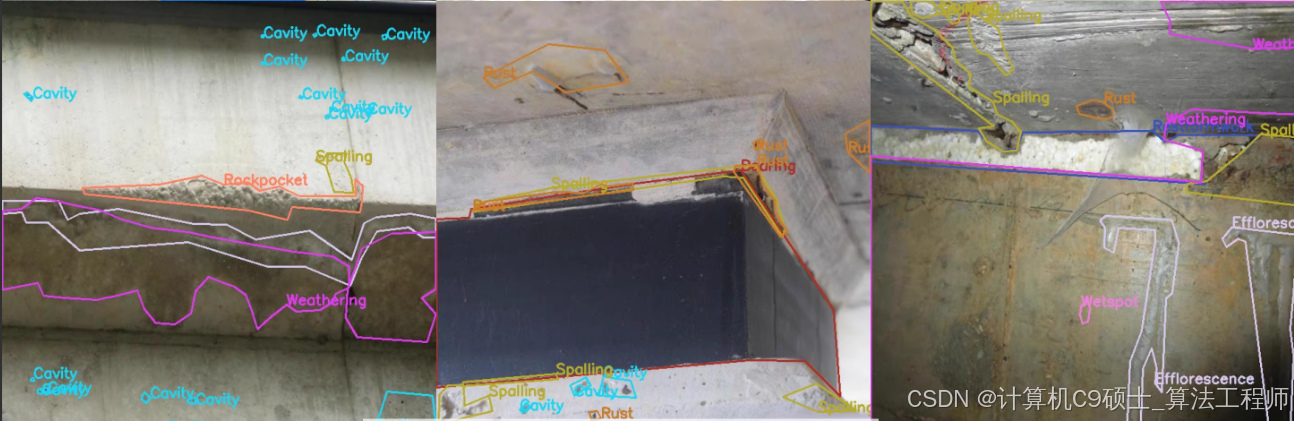
建筑物损伤分割与检测数据集,voc标注
| Graffiti – 涂鸦 | 1883 |
| Drainage – 排水问题 | 1402 |
| Wetspot – 湿斑 | 1445 |
| Weathering – 风化 | 4066 |
| Crack – 裂缝 | 3155 |
| Rockpocket – 岩石凹坑 | 525 |
| Spalling – 剥落 | 8484 |
| WConccor – 水侵蚀混凝土 | 360 |
| Cavity – 空洞 | 8119 |
| Efflorescence – 泛碱 | 3454 |
| Rust – 生锈 | 12844 |
| PEquipment – 防护设备 | 1677 |
| ExposedRebars – 露筋 | 1755 |
| Bearing – 支座 | 1048 |
| Hollowareas – 空洞区域 | 1362 |
| JTape – 接头胶带 | 923 |
| Restformwork – 剩余模板 | 851 |
| ACrack – 活动裂缝 | 376 |
| EJoint – 伸缩缝 | 450 |
| image num – 图像数量 | 6934 |
使用YOLOv8对建筑物损伤分割与检测数据集进行处理,我们将遵循以下步骤:准备数据集、配置模型参数、训练模型、评估模型性能以及推理和结果可视化。,我们这里选择使用Segmentation Models库来完成这个任务。 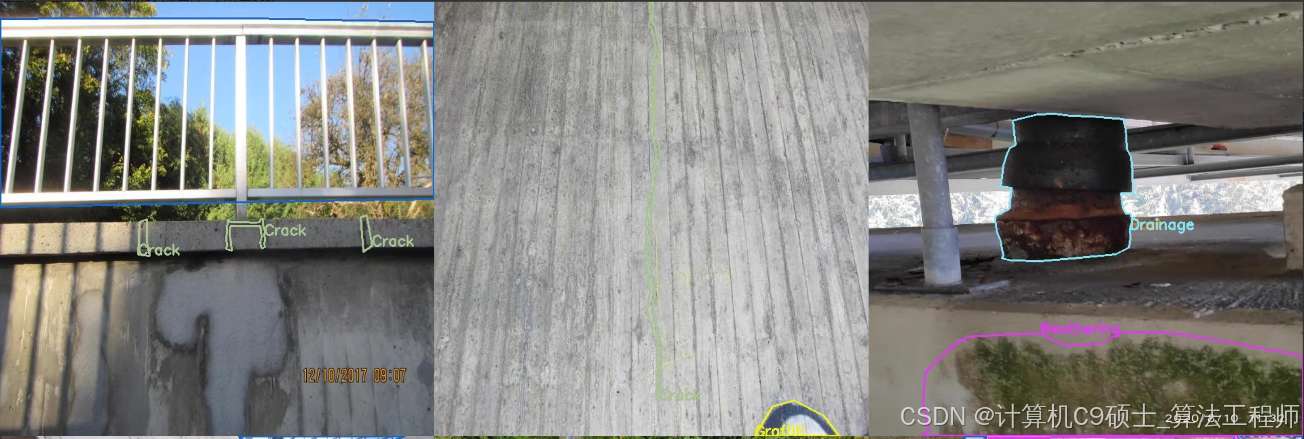
1. 数据集准备
假设你的数据集结构如下:
building_damage_detection/
├── images/
│ ├── train/
│ │ ├── img1.jpg
│ │ └── …
│ ├── val/
│ │ ├── img1.jpg
│ │ └── …
│ └── test/
│ ├── img1.jpg
│ └── …
└── annotations/
├── train/
│ ├── img1.xml
│ └── …
├── val/
│ ├── img1.xml
│ └── …
└── test/
├── img1.xml
└── …
data_building_damage.yaml
data_building_damage.yaml 文件内容示例:
train: ./building_damage_detection/images/train/
val: ./building_damage_detection/images/val/
test: ./building_damage_detection/images/test/
nc: 19 # 类别数量
names: ['Graffiti', 'Drainage', 'Wetspot', 'Weathering', 'Crack', 'Rockpocket', 'Spalling', 'WConccor', 'Cavity', 'Efflorescence', 'Rust', 'PEquipment', 'ExposedRebars', 'Bearing', 'Hollowareas', 'JTape', 'Restformwork', 'ACrack', 'EJoint']
需要将VOC格式的标注转换为适合Segmentation Models使用的格式(如PNG格式的掩码图像)。可以编写一个脚本来实现这一转换。
2. 安装依赖库
确保安装了必要的库:
pip install segmentation-models-pytorch albumentations opencv-python-headless torch torchvision xmltodict
3. VOC转PNG掩码
编写脚本将VOC格式的XML文件转换为PNG格式的掩码图像:
import os
import cv2
import numpy as np
import xmltodict
def voc_to_mask(xml_path, class_dict):
with open(xml_path, 'r') as xml_file:
data = xmltodict.parse(xml_file.read())
height = int(data['annotation']['size']['height'])
width = int(data['annotation']['size']['width'])
mask = np.zeros((height, width), dtype=np.uint8)
if 'object' in data['annotation']:
for obj in data['annotation']['object']:
name = obj['name']
cls_id = class_dict[name]
polygon = [(int(pt['x']), int(pt['y'])) for pt in obj['polygon']['pt']]
cv2.fillPoly(mask, [np.array(polygon)], cls_id)
return mask
class_dict = {
'Graffiti': 0, 'Drainage': 1, 'Wetspot': 2, 'Weathering': 3, 'Crack': 4,
'Rockpocket': 5, 'Spalling': 6, 'WConccor': 7, 'Cavity': 8, 'Efflorescence': 9,
'Rust': 10, 'PEquipment': 11, 'ExposedRebars': 12, 'Bearing': 13, 'Hollowareas': 14,
'JTape': 15, 'Restformwork': 16, 'ACrack': 17, 'EJoint': 18
}
# 示例调用
for folder in ['train', 'val', 'test']:
annotation_folder = f"./building_damage_detection/annotations/{folder}/"
mask_folder = f"./building_damage_detection/masks/{folder}/"
os.makedirs(mask_folder, exist_ok=True)
for xml_file in os.listdir(annotation_folder):
mask = voc_to_mask(os.path.join(annotation_folder, xml_file), class_dict)
cv2.imwrite(os.path.join(mask_folder, xml_file.replace('.xml', '.png')), mask)
4. 模型训练
创建一个Python脚本来开始训练过程。这里我们以PSPNet为例说明如何使用Segmentation Models库。
训练脚本
from segmentation_models_pytorch import PSPNet
from torch.utils.data import DataLoader
import torch
from torch import nn
from dataset import BuildingDamageDataset # 假设你已实现了一个自定义的数据集类
class BuildingDamageDataset(torch.utils.data.Dataset):
def __init__(self, images_dir, masks_dir, transform=None):
self.images_fps = [os.path.join(images_dir, image_id) for image_id in os.listdir(images_dir)]
self.masks_fps = [os.path.join(masks_dir, mask_id).replace('.jpg', '.png') for mask_id in os.listdir(images_dir)]
self.transform = transform
def __getitem__(self, i):
image = cv2.imread(self.images_fps[i])
mask = cv2.imread(self.masks_fps[i], 0)
if self.transform:
transformed = self.transform(image=image, mask=mask)
image = transformed['image']
mask = transformed['mask']
return image, mask
def __len__(self):
return len(self.images_fps)
ENCODER = 'resnet34'
ENCODER_WEIGHTS = 'imagenet'
CLASSES = ['Graffiti', 'Drainage', 'Wetspot', 'Weathering', 'Crack', 'Rockpocket', 'Spalling', 'WConccor', 'Cavity', 'Efflorescence', 'Rust', 'PEquipment', 'ExposedRebars', 'Bearing', 'Hollowareas', 'JTape', 'Restformwork', 'ACrack', 'EJoint']
ACTIVATION = 'softmax2d'
model = PSPNet(
encoder_name=ENCODER,
encoder_weights=ENCODER_WEIGHTS,
classes=len(CLASSES),
activation=ACTIVATION,
)
preprocessing_fn = smp.encoders.get_preprocessing_fn(ENCODER, ENCODER_WEIGHTS)
train_dataset = BuildingDamageDataset('./building_damage_detection/images/train/', './building_damage_detection/masks/train/')
valid_dataset = BuildingDamageDataset('./building_damage_detection/images/val/', './building_damage_detection/masks/val/')
train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True, num_workers=4)
valid_loader = DataLoader(valid_dataset, batch_size=4, shuffle=False, num_workers=4)
loss = smp.utils.losses.CrossEntropyLoss()
metrics = [
smp.utils.metrics.IoU(threshold=0.5),
]
optimizer = torch.optim.Adam([
dict(params=model.parameters(), lr=0.0001),
])
train_epoch = smp.utils.train.TrainEpoch(
model,
loss=loss,
metrics=metrics,
optimizer=optimizer,
device='cuda',
verbose=True,
)
valid_epoch = smp.utils.train.ValidEpoch(
model,
loss=loss,
metrics=metrics,
device='cuda',
verbose=True,
)
max_score = 0
for i in range(0, 40): # 训练周期数
print('\\nEpoch: {}'.format(i))
train_logs = train_epoch.run(train_loader)
valid_logs = valid_epoch.run(valid_loader)
if max_score < valid_logs['iou_score']:
max_score = valid_logs['iou_score']
torch.save(model, './best_model.pth')
print('Model saved!')
if i == 25:
optimizer.param_groups[0]['lr'] /= 10
print('Decrease decoder learning rate to 1e-5!')
5. 推理与结果可视化
训练完成后,我们可以加载最佳模型对新图片进行预测,并将结果可视化。
推理脚本
import matplotlib.pyplot as plt
best_model = torch.load('./best_model.pth')
def visualize(image, mask, pred_mask):
figure, ax = plt.subplots(1, 3, figsize=(10, 10))
ax[0].imshow(image)
ax[0].set_title("Image")
ax[1].imshow(mask)
ax[1].set_title("Ground Truth")
ax[2].imshow(pred_mask)
ax[2].set_title("Predicted Mask")
plt.show()
test_dataset = BuildingDamageDataset('./building_damage_detection/images/test/', './building_damage_detection/masks/test/')
for i in range(5): # 可视化前5个测试样本
image, gt_mask = test_dataset[i]
x_tensor = torch.from_numpy(image).to('cuda').unsqueeze(0)
pr_mask = best_model.predict(x_tensor)
pr_mask = pr_mask.squeeze().cpu().numpy().round()
visualize(image, gt_mask, pr_mask)
使用Segmentation Models库对建筑物损伤分割与检测数据集进行处理。请根据实际需求调整相关参数和代码。,具体实现细节需要根据Segmentation Models的具体版本和API进行适当调整。


评论前必须登录!
注册