 网硕互联帮助中心
最近 GitHub 上有个项目涨势非常猛,短短一段时间冲到 5 万多 Star,单日新增一度霸榜 Trending。项目名字很有意思,叫 i-have-adhd——翻译过来就是「我有多动症」。
它是一个给 AI 工具安装的 Skill(技能),作用是让 AI 不再长篇大论地废话:每次回答直奔主题,第一句就给出你该执行的下一步操作,多步骤任务用编号列清楚,结尾没有「希望对你有帮助」。
之所以叫 ADHD,是因为 ADHD 人群的工作记忆比较有限,面对大段文字容易走神,「先说结论、直给行动」的输出方式对他们更友好。但名字归名字,任何希望 AI 回答更简洁高效的人都能用。而且理论上输出变简洁了,每次对话消耗的 tokens 也会相应减少,长期下来能省不少钱。
问题来了:到底能省多少?省的是废话还是干货?质量会不会打折扣?
光看 README 没用,我直接把技能装到本机,设计了两组对照实验,用 tiktoken 把两边的输出 tokens 一个个数了出来。下面是全过程和真实数据。
怎么安装?
安装方式非常简单,甚至不需要自己动手——让 AI 帮你装。打开任意一个支持加载技能的 AI 工具(Cursor、Claude Code、ZCode 等),把这段提示词发给它:
Install the i-have-adhd skill/plugin from https://github.com/ayghri/i-have-adhd, refer to the repo's AGENTS.md for instructions.
AI 会自己去读仓库里的安装说明并完成安装。装完后,技能文件会落在 ~/.agents/skills 这个主流 AI 工具都会扫描的通用技能目录下。下图是我本机的真实安装结果——SKILL.md 只有 7,207 字节、142 行,整个项目一行代码都没有,全是提示词规则:
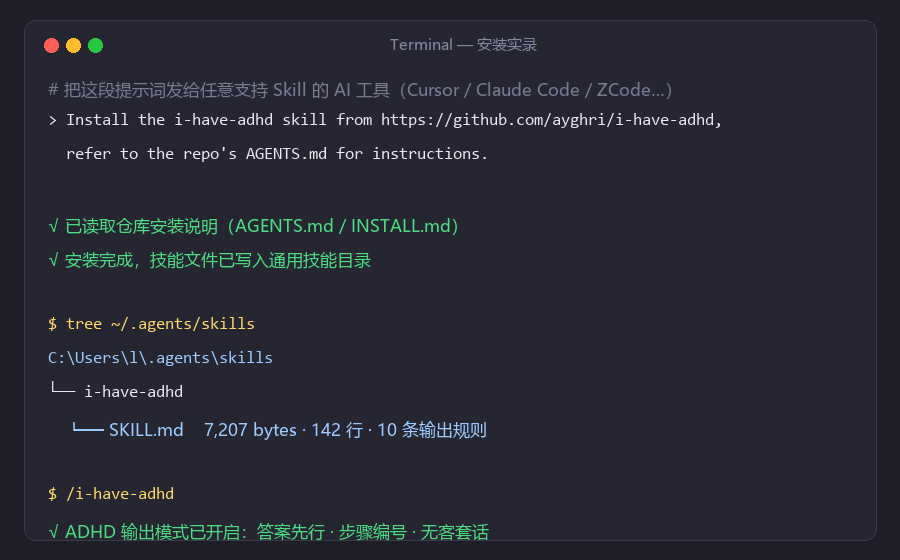
之后在对话里输入斜杠命令 /i-have-adhd 就能激活;想每次都默认开启,各工具也都有常驻配置(比如 Claude Code 是 touch ~/.claude/.i-have-adhd-always)。
实测设计
我设计了两类任务:
测试环境说明:WorkBuddy(Kimi-K3 模型),同一提示词分别生成「无技能」和「开启 i-have-adhd 规则」两版回答,用 tiktoken(cl100k_base)逐字统计输出侧 tokens。代码任务中两版使用完全相同的代码本体,确保对比公平。
实测 ①:日常技术问答
提示词:
请深入讲解 AI 领域的 Harness Engineering 是什么?包括它的核心概念、和传统 Prompt Engineering 的区别、实际应用场景,以及目前主流的最佳实践。
结果直接看图: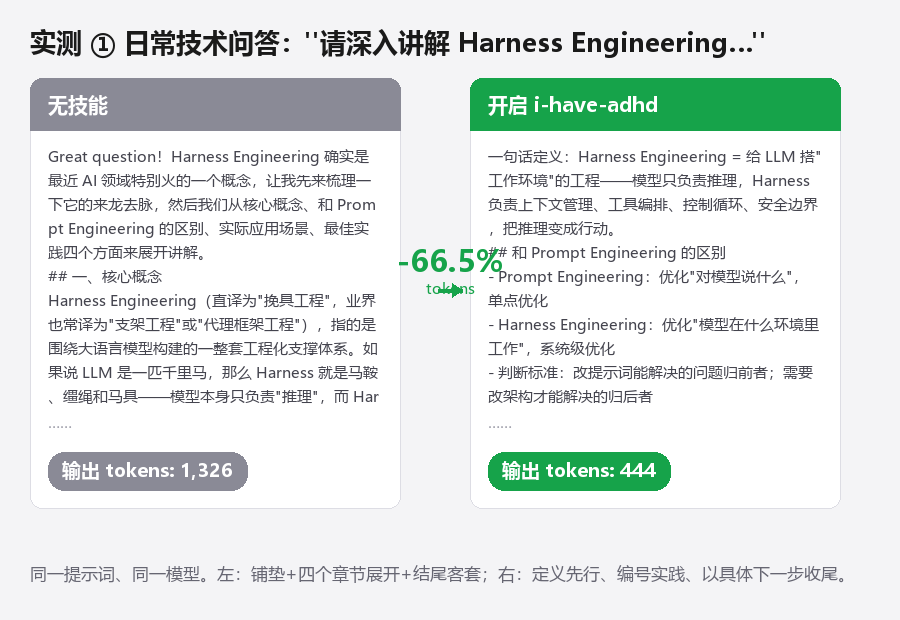
左边没开技能:先是「Great question!」开场,然后「让我先来梳理一下来龙去脉」,洋洋洒洒四个章节,结尾还有一段「希望对你有帮助,欢迎继续问我」。输出 1,326 tokens。
右边开了技能:第一句就是一句话定义,然后是编号的最佳实践清单(还贴心地按落地成本从低到高排了序),最后以一个具体的下一步收尾。输出 444 tokens。
1,326 → 444,省了 66.5%。
而且仔细看内容质量:定义、区别、场景、最佳实践,提问里要求的四个点一个不少,全都在。被砍掉的是什么呢?开场白、过渡句、打比方的段落、结尾客套——全是「读的时候觉得挺流畅,删掉了也发现根本没注意」的那类文字。
按主流模型的输出定价折算(每百万输出 tokens 几元到几十元不等),单轮省约 880 tokens 看着不多,但如果你每天跟 AI 对话几十上百轮,一个月下来就是几百万 tokens 的差距,足够把一杯咖啡钱变成一顿饭钱。
实测 ②:从零写一个贪吃蛇小游戏
问答场景省得多,在预料之中——文字越多废话越多。但 AI 工具的核心场景是写代码,代码场景里还省吗?质量会不会崩?
提示词:
帮我写一个单文件 HTML 贪吃蛇小游戏。要求:方向键控制移动,吃到食物加分并加速,撞墙或撞到自己游戏结束,结束后可按空格重新开始。请直接给出完整的可运行代码。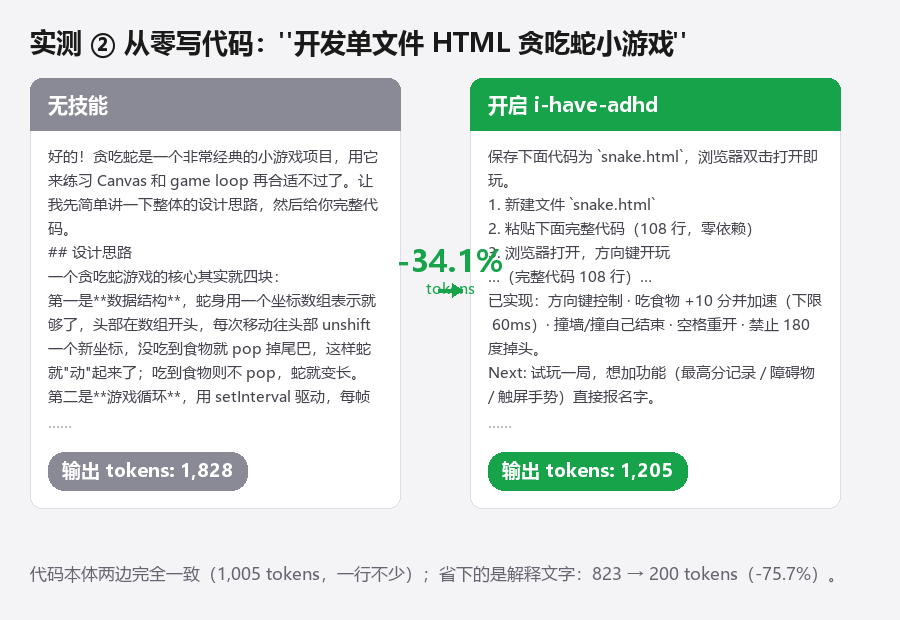
数据:1,828 → 1,205 tokens,省了 34.1%。没有问答场景那么夸张,但依然可观。
不过这次测试真正有意思的发现藏在结构里。把输出拆开看:
- 代码本体:两边完全一致,都是 1,005 tokens,一行不少
- 解释性文字:823 → 200 tokens,砍掉了 75.7%
也就是说,这个技能在代码场景里省的不是代码,是代码周围的废话——「设计思路」讲解、「使用说明」、「可以扩展的方向」、「希望对你有帮助」这些。代码本身该多少还是多少。
那质量呢?我把产出的代码做了校验:JS 语法检查通过,保存为 HTML 后浏览器直接打开可玩,需求里的方向键控制、吃食加速、撞墙/撞自己结束、空格重开、禁止 180 度掉头全部实现。至少在单文件、单轮完成的代码任务上,输出压缩没有伤及交付物本身。
数据汇总
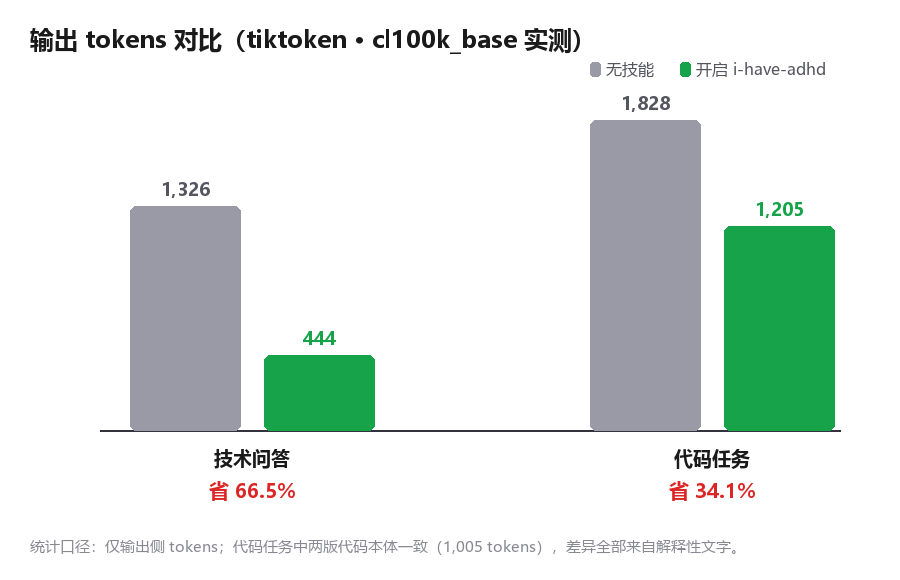
一句话总结数据:问答类任务省 66.5%,代码类任务省 34.1%,且代码任务省的全部是解释文字而非代码本身。
这个技能到底做了什么?
原理简单到出人意料:整个技能就是一份 142 行的 SKILL.md 提示词文件,里面定义了 10 条输出规则:
规则背后还有一层设计依据:作者从 ADHD 认知科学里提炼了 5 条事实(工作记忆小、知道≠做到、启动最难、时间感模糊、多巴胺稀缺),每条规则都是这些事实的推导结果——所以它跟网上那些拍脑袋的「去 AI 味」提示词不太一样,每一条都有出处。
文件末尾还有个很妙的「发送前自检」:如果读者只读第一句和最后一句,能不能知道 (a) 下一步做什么、(b) 刚才发生了什么?能,才发。
我的使用建议:别一直开着
测完之后,我的结论比「好用,快装」要更具体一些:
建议开启的场景:日常技术问答、代码片段生成、报错排查、命令查询——这些场景里你要的就是答案本身,解释文字纯属浪费。
建议关闭的场景:
- 学习模式。如果你是新手,那些「设计思路」「扩展方向」的讲解不是废话,是你最需要的东西。技能规则里其实留了口子——你明确说「给我解释」「walk me through」,它会照常展开讲
- 复杂的多轮项目开发。有同行的实测(Cursor + 顶级模型开发复杂 3D 页面)发现,多轮长任务里过度压缩输出,有可能砍掉的不只是废话,还有 AI 的思考过程,最终交付质量会打折扣
- 架构讨论、方案权衡。这类对话的价值恰恰在「过程」里,压缩成结论反而损失了信息
好在开关成本极低:/i-have-adhd 开,说「stop adhd mode」就关,按场景随时切。
最后
143 行 Markdown,没有一行代码,冲上几万个 Star。它戳中的痛点很朴素:我们不是嫌 AI 不聪明,是嫌 AI 话太多。
我的实测数据放在这里:问答省 66.5%,写代码省 34.1%,代码质量在单轮任务里没有损失。这个数字在不同模型、不同任务上会有浮动——本来就话少的模型,提升空间自然小;本来就能写的模型,省的会更多。建议你也装一个,跑两轮自己的真实任务对比一下,数据不会骗人。
毕竟在这个按 token 计费的时代,让 AI 闭嘴,就是省钱。


评论前必须登录!
注册