 网硕互联帮助中心
摘要:本文系统讲解 Python 函数的完整知识体系,涵盖函数定义语法、各类参数类型(位置参数、关键字参数、默认参数、可变参数、仅限关键字参数)及其定义顺序、返回值、函数作用域(局部变量与全局变量、global 与 nonlocal 的对比、LEGB 查找规则)、嵌套函数以及 lambda 表达式。每个知识点均配有可运行的示例代码和易错点总结,帮助读者快速掌握 Python 函数的核心用法与常见陷阱。
四、函数
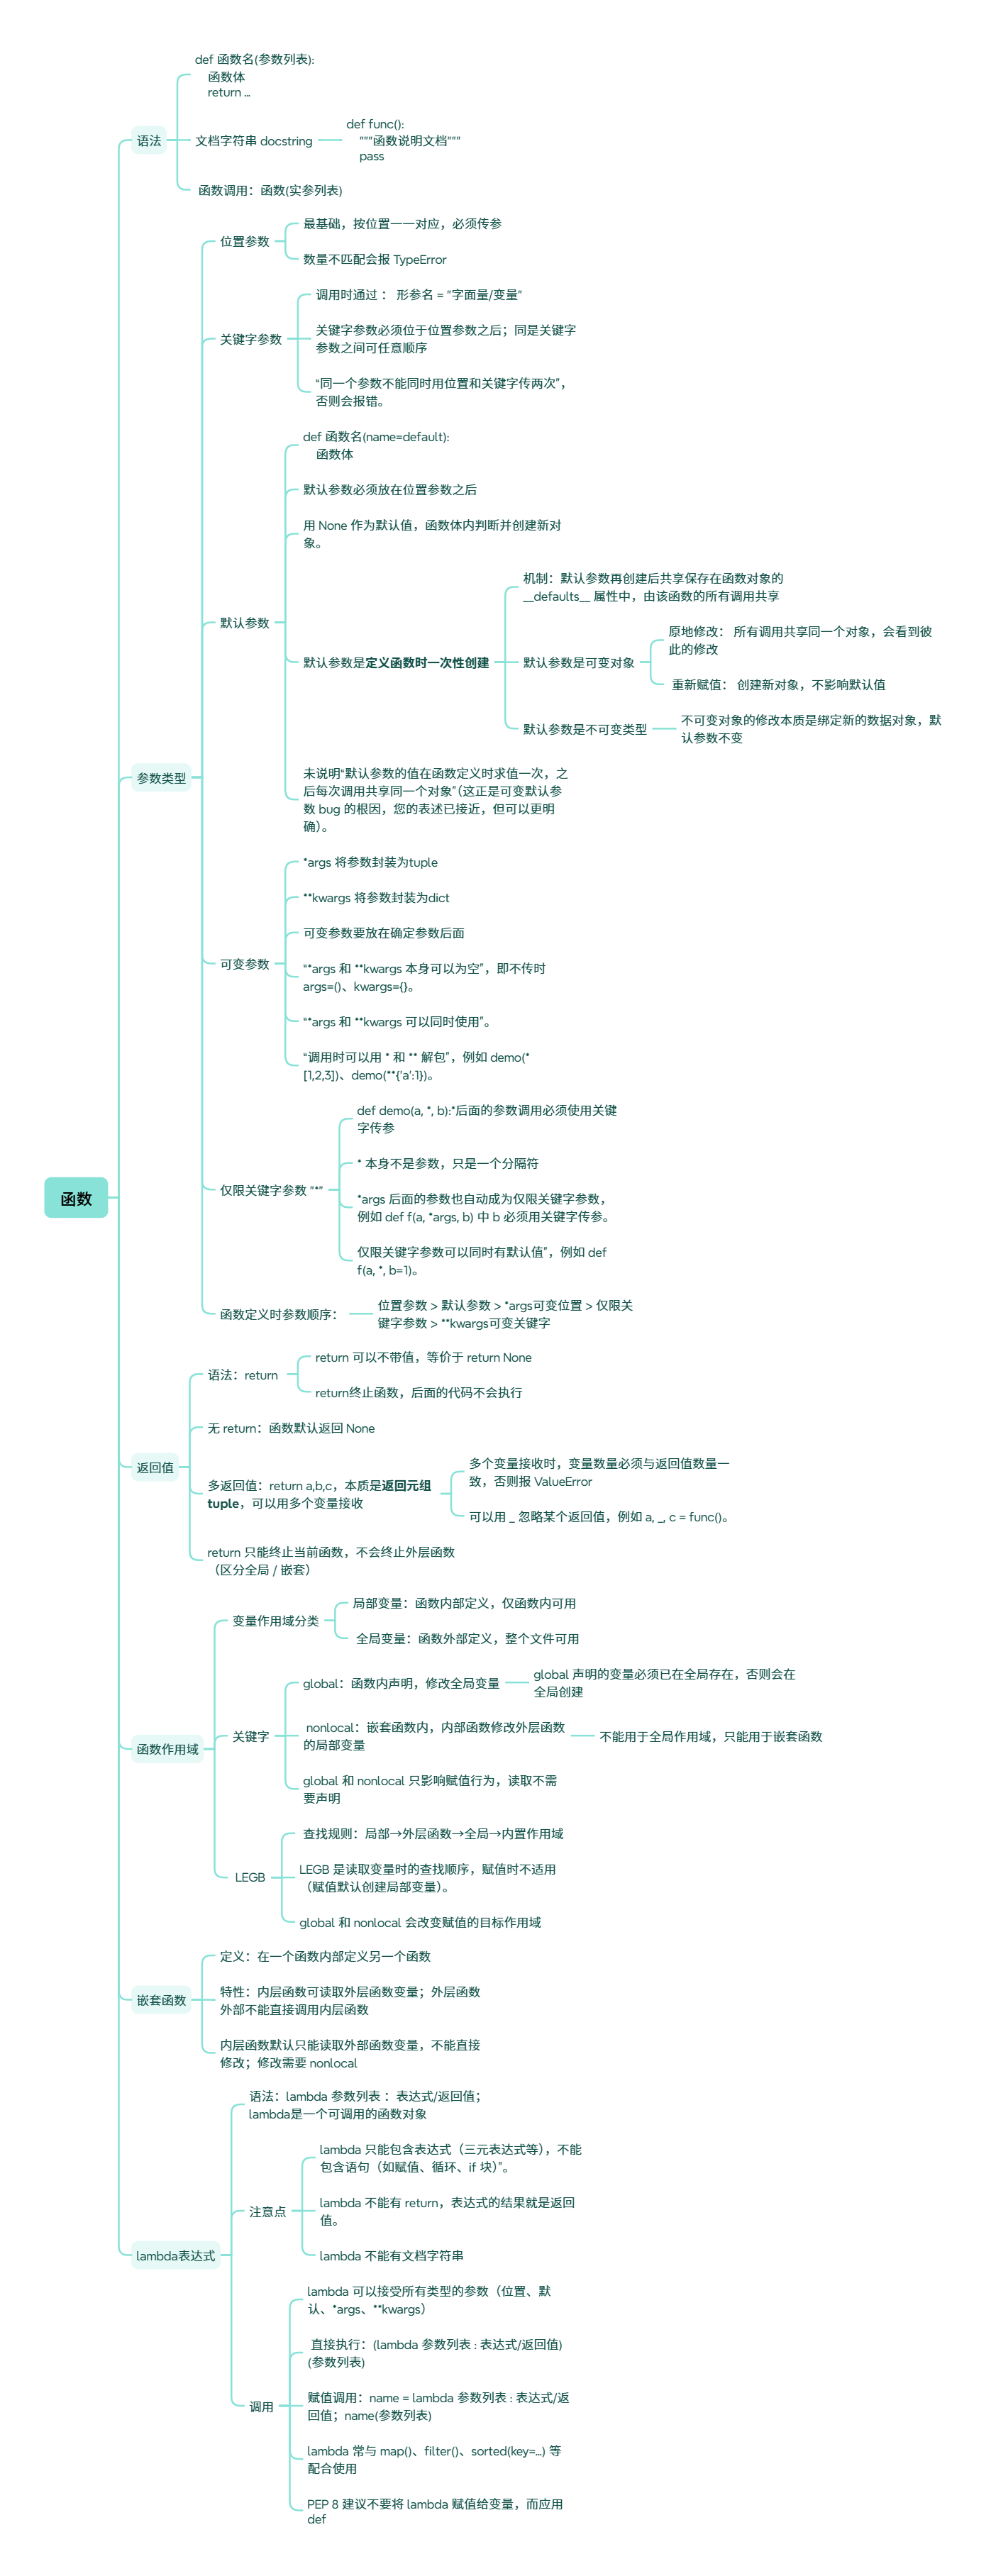
4.1 语法
下面通过一个完整示例演示函数定义、文档字符串和调用的基本语法:
- def 函数名(参数列表):
- 函数体
- return …
- 文档字符串 docstring
- 函数调用:函数(实参列表)
def greet(name):
"""Hello world"""
return "Hello world " + name
# 函数调用
print(greet("zs")) # 输出:Hello, zs
4.2 参数类型
4.2.1 位置参数
最基础,按位置一一对应,必须传参
数量不匹配会报TypeError
下面演示位置参数的基本用法,以及常见的易错点:
def add(a, b):
return a + b
# 正确:按位置一一对应
print(add(1, 2)) # 输出:3
# 实参数量少于形参,报 TypeError
print(add(1)) # TypeError: add() missing 1 required positional argument: 'b'
# 实参数量多于形参,报 TypeError
print(add(1, 2, 3)) # TypeError: add() takes 2 positional arguments but 3 were given
4.2.2 关键字参数
下面演示关键字参数的用法,以及常见的易错点:
-
调用时通过:形参名 = "字面量 / 变量"
-
调用时位置实参必须位于关键字实参之前;同是关键字参数之间可任意顺序
-
同一个参数不能同时用位置和关键字传两次,否则会报
def introduce(name, age, city):
return f"{name},{age} 岁,来自 {city}"
# 正确:全部使用关键字传参,顺序可任意
print(introduce(city="北京", name="Alice", age=25))
# 输出:Alice,25 岁,来自 北京
# 正确:位置参数在前,关键字参数在后
print(introduce("Bob", age=30, city="上海"))
# 输出:Bob,30 岁,来自 上海
# 关键字参数位于位置参数之前,报 SyntaxError
print(introduce(name="Tom", 28, "广州"))
# SyntaxError: positional argument follows keyword argument
# 同一个参数同时用位置和关键字传两次,报 TypeError
print(introduce("Tom", name="Tom", age=28, city="广州"))
# TypeError: introduce() got multiple values for argument 'name'
4.2.3 默认参数
def 函数名(name=default): 函数体
def greet(name="world"):
print(f"hello,{name}")
greet() # 不传,用默认值 → hello,world
greet("zs") # 传了,用传入值 → hello,zs
默认参数必须放在位置参数之后
def greet(name, msg="你好"):
print(f"{msg},{name}")
greet("小明") # 你好,小明
greet("小明", "早上好") # 早上好,小明
def greet(msg="你好", name): # 语法错误!
print(f"{msg},{name}") # SyntaxError: non-default argument follows default argument
用 None 作为默认值,函数体内判断并创建新对象
def add_item(item, lst=None):
if lst is None: # 判断是否传了参数
lst = [] # 没传,就创建新对象
lst.append(item)
return lst
print(add_item("a")) # ['a']
print(add_item("b")) # ['b'] ← 正确!每次都是新列表
print(add_item("c")) # ['c']
默认参数是定义函数时一次性创建
-
机制:默认参数在函数定义时(def 语句执行时)求值一次,之后由该函数的所有调用共享
def f(x, lst=[]): # ← 执行 def 这一行的瞬间,[] 被创建,并绑定到 f 上
pass
-
位置默认参数保存在函数对象的 __defaults__ 属性中(元组)
-
仅限关键字参数的默认值保存在 __kwdefaults__ 属性中(字典)
两者的对比如下:
| 保存内容 | 位置参数 / 默认参数的默认值 | 仅限关键字参数的默认值 |
| 数据类型 | 元组(tuple) | 字典(dict) |
| 键 / 顺序 | 按参数定义顺序排列,无键名 | 以参数名为键,无序 |
| 访问方式 | func.__defaults__ | func.__kwdefaults__ |
| 无默认值时 | None | None |
原地修改(append / extend / += 等)
所有调用共享同一个对象,会看到彼此的修改。
def add(item, lst=[]):
lst.append(item) # 原地修改:改的是默认那个列表本身
return lst
print(add("a")) # ['a']
print(add("b")) # ['a', 'b'] ← 看到了上一次的修改
print(add("c")) # ['a', 'b', 'c']
重新赋值:创建新对象,不影响默认值
def reset(lst=[]):
lst = [1, 2, 3] # 重新赋值:lst 改指向新列表,原默认列表没动
return lst
print(reset()) # [1, 2, 3]
print(reset()) # [1, 2, 3]
print(reset()) # [1, 2, 3] ← 每次都是新的
默认参数是不可变类型:不可变对象的修改本质是绑定新的数据对象,默认参数不变
def f(x=10, s="hi"):
x += 1 # 等价于 x = x + 1,创建新 int,重新绑定
s += "!" # 等价于 s = s + "!",创建新 str,重新绑定
return x, s
print(f()) # (11, 'hi!')
print(f()) # (11, 'hi!') ← 每次一样,默认值没变
print(f()) # (11, 'hi!')
4.2.4 可变参数
*args —— 可变位置参数
-
*args 将参数封装为 tuple
-
不传时 args = ()
-
传多个时按顺序封装,如 f(1,2,3) → args = (1, 2, 3)
-
-
常与确定参数配合:def f(name, *args)
-
确定参数先拿值,剩余位置实参进 args
-
def show(*args):
print("args =", args)
print("类型 =", type(args))
# ① 不传时 args = ()
show()
args = ()
# 类型 = <class 'tuple'>
# ② 传多个时按顺序封装为 tuple
show(1, 2, 3)
args = (1, 2, 3)
# 类型 = <class 'tuple'>
# ③ 与确定参数配合:确定参数先拿值,剩余位置实参进 args
def introduce(name, *hobbies):
print(f"姓名:{name},爱好:{hobbies}")
introduce("小明")
# 姓名:小明,爱好:()
introduce("小明", "篮球", "编程")
# 姓名:小明,爱好:('篮球', '编程')
**kwargs —— 可变关键字参数
-
**kwargs 将参数封装为 dict
-
不传时 kwargs = {}
-
传多个时按 键=值 封装,如 f(a=1,b=2) → kwargs = {'a': 1, 'b': 2}
-
-
常与确定参数配合:def f(name, **kwargs)
-
确定参数先拿值,剩余关键字实参进 kwargs
-
def show(**kwargs):
print("kwargs =", kwargs)
print("类型 =", type(kwargs))
# ① 不传时 kwargs = {}
show()
kwargs = {}
# 类型 = <class 'dict'>
# ② 传多个时按 键=值 封装为 dict
show(a=1, b=2, c=3)
kwargs = {'a': 1, 'b': 2, 'c': 3}
# ③ 与确定参数配合:确定参数先拿值,剩余关键字实参进 kwargs
def register(name, **info):
print(f"姓名:{name},其他信息:{info}")
register("小明")
# 姓名:小明,其他信息:{}
register("小明", age=18, city="北京")
# 姓名:小明,其他信息:{'age': 18, 'city': '北京'}
调用时的解包
-
用 * 解包序列为位置实参
-
demo(*[1, 2, 3]) 等价于 demo(1, 2, 3)
-
demo(*(1, 2, 3)) 同样适用
-
-
用 ** 解包字典为关键字实参
-
demo(**{"a": 1}) 等价于 demo(a=1)
-
-
* 和 ** 可同时使用
-
demo(*[1, 2], **{"c": 3}) → demo(1, 2, c=3)
-
# ① 用 * 解包序列为位置实参
def my_sum(a, b, c):
return a + b + c
# *容器
print(my_sum(*[1, 2, 3])) # 等价于 my_sum(1, 2, 3) → 6
print(my_sum(*(1, 2, 3))) # 6
# ② 用 ** 解包字典为关键字实参
def introduce(name, age):
print(f"{name},{age}岁")
info = {"name": "小明", "age": 18}
introduce(**info) # 等价于 introduce(name="小明", age=18)
# 小明,18岁
# ③ * 和 ** 可同时使用
def demo(a, b, c, d):
print(a, b, c, d)
args = [1, 2]
kwargs = {"c": 3, "d": 4}
demo(*args, **kwargs) # 1 2 3 4
易错点总结
-
定义时 *args / **kwargs 是收集参数;调用时 * / ** 是解包参数
-
*args 必须写在 **kwargs 前面
-
位置实参不能写在关键字实参后面,如 f(a=1, 2) 会报错
-
*args 后面的参数自动成为仅限关键字参数,如 def f(a, *args, b) 中 b 必须用关键字传参
# ① 定义时"收集" vs 调用时"解包"
def f(*args, **kwargs):
print(args, kwargs)
data = [1, 2, 3]
info = {"x": 10}
f(*data, **info) # (1, 2, 3) {'x': 10}
② *args 必须写在 **kwargs 前面
def ok(*args, **kwargs):
pass
def bad(**kwargs, *args): # SyntaxError
pass
③ 位置实参不能写在关键字实参后面
def g(a, b):
pass
g(1, b=2) # 正确
g(a=1, 2) # SyntaxError: positional argument follows keyword argument
④ *args 后面的参数自动成为仅限关键字参数
def h(a, *args, b):
print(a, args, b)
h(1, 2, 3, b=4) # 1 (2, 3) 4
h(1, 2, 3, 4) # TypeError: missing 1 required keyword-only argument: 'b'
⑤ 空值判断
def check(*args, **kwargs):
if not args:
print("没有位置参数")
if not kwargs:
print("没有关键字参数")
check() # 没有位置参数 / 没有关键字参数
check(1) # 没有关键字参数
check(a=1) # 没有位置参数
4.2.5 仅限关键字参数 *
基本语法
-
def demo(a, *, b): 后面的参数调用必须使用关键字传参
-
b 只能通过 b=值 传递,不能用位置传参
-
位置传参会报 TypeError
-
def demo(a, *, b):
print("a =", a)
print("b =", b)
# b 用关键字传参
demo(1, b=2)
a = 1
b = 2
# b 用位置传参报错
# demo(1, 2)
# TypeError: demo() takes 1 positional argument but 2 were given
* 的本质
-
* 本身不是参数,只是一个分隔符
-
它不接收任何值,也不占用参数位置
-
作用是把后面的参数"标记"为仅限关键字参数
-
def demo(a, *, b):
print("a =", a, "b =", b)
# * 不接收任何值,只起分隔作用
demo(1, b=2) # a = 1 b = 2
# 不能给 * 传值
# demo(1, 2, b=3)
# TypeError: demo() takes 1 positional argument but 3 were given
*args 后面的参数自动成为仅限关键字参数
-
例如 def f(a, *args, b) 中 b 必须用关键字传参
-
因为所有多余的位置实参都被 *args 截走了
-
b 无法再通过位置传参,只能用关键字
-
def f(a, *args, b):
print("a =", a)
print("args =", args)
print("b =", b)
# b 用关键字传参
f(1, 2, 3, b=4)
a = 1
args = (2, 3)
b = 4
# 不传 b 报错
# f(1, 2, 3)
# TypeError: f() missing 1 required keyword-only argument: 'b'
# 把 b 当位置传参也报错
# f(1, 2, 3, 4)
# TypeError: f() missing 1 required keyword-only argument: 'b'
仅限关键字参数可以同时有默认值
-
例如 def f(a, *, b=1):
-
不传 b 时使用默认值 1
-
传 b 时必须用关键字,如 f(1, b=5)
-
即使有默认值,仍然不能用位置传参,如 f(1, 5) 报错
-
def f(a, *, b=1):
print("a =", a, "b =", b)
# 不传 b,用默认值
f(1)
a = 1
b = 1
# 传 b,必须用关键字
f(1, b=5)
a = 1
b = 5
# 即使有默认值,也不能用位置传
# f(1, 5)
# TypeError: f() takes 1 positional argument but 2 were given
易错点总结
-
* 不是参数,不能给它传值
-
* 后面的参数不能靠位置传
-
仅限关键字参数即使有默认值,也不能用位置传
-
参数顺序不能颠倒,*args 必须在 **kwargs 前
# ===== 易错点集中演示 =====
# ① * 不是参数,不能给它传值
def f1(a, *, b):
print("f1:", a, b)
f1(1, b=2) # a=1 b=2
# f1(1, 2, b=3) # TypeError: 多出的 2 无处可去
# ② * 后面的参数不能靠位置传
def f2(a, *, b):
print("f2:", a, b)
f2(1, b=2) # a=1 b=2
# f2(1, 2) # TypeError: b 必须用关键字传参
# ③ 仅限关键字参数即使有默认值,也不能用位置传
def f3(a, *, b=1):
print("f3:", a, b)
f3(1) # a=1 b=1(用默认值)
f3(1, b=2) # a=1 b=2(用关键字)
# f3(1, 2) # TypeError: 有默认值也不能位置传
# ④ 参数顺序不能颠倒:*args 必须在 **kwargs 前
def f4(a, *, b, **kwargs):
print("f4:", a, b, kwargs)
f4(1, b=2, x=3) # a=1 b=2 {'x': 3}
# def bad(a, **kwargs, *, b): # SyntaxError: **kwargs 后不能再有参数
# pass
4.2.6 参数的定义顺序
位置参数 > 默认参数 > *args 可变位置 > 仅限关键字参数 > **kwargs 可变关键字
def f(a, b=1, *args, c, d=2, **kwargs):
pass
# ↑ ↑ ↑ ↑ ↑ ↑
# 位置 默认 可变位置 仅限关键字 可变关键字
-
位置参数:必传,按位置一一对应
-
默认参数:可省,必须放在位置参数之后
-
*args:收集多余位置实参,封装为 tuple
-
仅限关键字参数:* 或 *args 之后的参数,只能关键字传参
-
**kwargs:收集多余关键字实参,封装为 dict,必须放最后
4.3 返回值
- 语法:return
- return 可以不带值,等价于 return None
-
return 终止函数,后面的代码不会执行
# 语法:return
def add(a, b):
return a + b
result = add(1, 2)
print(result) # 3
# return 可以不带值,等价于 return None
def f():
return
print(f()) # None
print(f() is None) # True
# return 终止函数,后面的代码不会执行
def f():
print("开始")
return
print("这行永远不会执行")
f()
- 无 return:函数默认返回None
def f():
print("hello")
result = f()
# hello
print(result) # None
- 多返回值:return a,b,c,本质是返回元组tuple,可以用多个变量接收
- 多个变量接收时,变量数量必须与返回值数量一致,否则报ValueError
- 可以用_忽略某个返回值,例如 a, _, c = func()
# 多返回值:return a,b,c,本质是返回元组 tuple,可以用多个变量接收
def f():
return 1, 2, 3
result = f()
print(result) # (1, 2, 3)
print(type(result)) # <class 'tuple'>
a, b, c = f()
print(a, b, c) # 1 2 3
# 多个变量接收时,变量数量必须与返回值数量一致,否则报 ValueError
def f():
return 1, 2, 3
# a, b = f() # ValueError: not enough values to unpack (expected 2, got 3)
# a, b, c, d = f() # ValueError: too many values to unpack (expected 4)
# 可以用 _ 忽略某个返回值,例如 a, _, c = func()
def f():
return 1, 2, 3
a, _, c = f()
print(a, c) # 1 3
- return 只能终止当前函数,不会终止外层函数(区分全局 / 嵌套)
# return 只能终止当前函数,不会终止外层函数(区分全局 / 嵌套)
def outer():
print("outer 开始")
def inner():
print("inner 开始")
return
print("inner 这行不执行")
inner()
print("outer 继续执行") # return 只终止 inner,不影响 outer
outer()
4.4 函数作用域
4.4.1 变量作用域分类
- 局部变量:函数内部定义,仅函数内可用
- 全局变量:函数外部定义,整个文件可用
# 全局变量
# 在函数外部定义,整个文件可用
name = "小明" # 全局变量
age = 18
def show_global():
# 函数内部可以读取全局变量
print("年龄:", age)
show_global()
# 年龄: 18
# 局部变量
# 在函数内部定义,仅函数内可用
def show_local():
name= "zs" # 局部变量
print("姓名:", name)
show_local()
# 姓名: zs
#函数外部访问局部变量,报 NameError
# print(city) # NameError: name 'city' is not defined
4.4.2 关键字
global:函数内声明,修改全局变量
- 全局已存在:直接修改该全局变量
count = 0
def add():
global count # 声明 count 是全局变量
count += 1
add()
add()
print(count) # 2
- 全局不存在:赋值时自动在全局创建
def f():
global x # 全局原本没有 x
x = 10 # 赋值时自动在全局创建
f()
print(x) # 10
- 不加 global 时,函数内赋值会创建局部变量
count = 0
def add():
count = 100 # 创建的是局部变量,不是全局
print("函数内:", count)
add() # 函数内:100
print("函数外:", count) # 函数外:0(全局未变)
- 不加 global 且赋值前读取,会报 UnboundLocalError
count = 0
def add():
count += 1 # 未声明 global,count 被当局部变量
add()
UnboundLocalError: local variable 'count' referenced before assignment
nonlocal:嵌套函数内,内部函数修改外层函数的局部变量
- 基本用法
def outer():
count = 0
def inner():
nonlocal count # 声明 count 是外层函数的局部变量
count += 1
inner()
inner()
print(count) # 2
outer()
- 不能用于全局作用域,只能用于嵌套函数
count = 0
def f():
nonlocal count # 全局作用域不能用 nonlocal
# SyntaxError: no binding for nonlocal 'count' found
-
外层没有对应变量时也会报错
def outer():
def inner():
nonlocal x # 外层没有 x
x = 1 # SyntaxError: no binding for nonlocal 'x' found
- 不加 nonlocal 时,内层赋值会创建自己的局部变量
def outer():
count = 0
def inner():
count = 100 # 创建的是 inner 的局部变量
print("inner:", count)
inner()
print("outer:", count) # outer 的 count 没变
outer()
- 不加 nonlocal 且赋值前读取,会报 UnboundLocalError
def outer():
count = 0
def inner():
count += 1 # 未声明 nonlocal
inner()
outer() # UnboundLocalError: local variable 'count' referenced before assignment
global 和 nonlocal 只影响赋值行为,读取不需要声明
- 读取全局变量,无需 global
count = 10
def show():
print(count) # 直接读取,遵循 LEGB
show() # 10
-
读取外层函数变量,无需 nonlocal
def outer():
count = 10
def inner():
print(count) # 直接读取
inner()
outer() # 10
-
声明只改变赋值的目标作用域
x = "全局"
def f():
print(x) # 读取:拿到全局 x
# x = "局部" # 若取消注释,x 变局部,上一行会报 UnboundLocalError
f() # 全局
4.4.3 global 与 nonlocal 对比
下面通过对比表格和示例代码,梳理 global 与 nonlocal 的核心区别:
| 作用目标 | 全局作用域的变量 | 外层函数的局部变量 |
| 使用位置 | 任意函数内部 | 仅嵌套函数内部 |
| 变量不存在时 | 赋值时自动在全局创建 | 报 SyntaxError(外层必须已存在) |
| 能否用于全局作用域 | 可以(但通常没必要) | 不能,会报 SyntaxError |
| 只影响赋值行为 | 是,读取无需声明 | 是,读取无需声明 |
4.4.4 LEGB
查找规则:局部 → 外层函数 → 全局 → 内置作用域
-
L(Local):局部作用域,函数内部定义的变量
-
E(Enclosing):外层函数作用域,嵌套函数中外层函数的变量
-
G(Global):全局作用域,模块级变量
-
B(Built-in):内置作用域,Python 内置命名空间(如 len、print、sum)
-
读取变量时按 L → E → G → B 顺序逐层向上查找,找到即停
LEGB 是读取变量时的查找顺序,赋值时不适用(赋值默认创建局部变量)
-
读取:按 LEGB 逐层向上找
-
赋值:默认在当前作用域创建局部变量,不向上找
-
函数内有赋值语句时,该变量在整个函数内都被视为局部变量
-
若赋值前就读取,会报 UnboundLocalError
-
-
对比:删除函数内赋值语句,读取就能正常向上找到外层/全局变量
global 和 nonlocal 会改变赋值的目标作用域
-
global:把赋值目标改为全局作用域
-
nonlocal:把赋值目标改为外层函数局部作用域
-
二者只改变赋值的目标作用域,读取仍自动遵循 LEGB
-
默认赋值(不加声明):创建局部变量
-
三者对比:
-
默认赋值 → 局部变量
-
global → 全局变量
-
nonlocal → 外层函数局部变量
-
4.5 嵌套函数
- 定义:在一个函数内部定义另一个函数
- 特性:内层函数可读取外层函数变量;外层函数外部不能直接调用内层函数
- 内层函数默认只能读取外部函数变量,不能直接修改;修改需要nonlocal
def outer():
def inner():
print("inner")
inner() # 外层内部可以调用
outer()
# inner
# inner() # 外层外部不能直接调用
# NameError: name 'inner' is not defined
4.6 lambda 表达式
- 语法:lambda 参数列表 : 表达式/返回值;
- lambda 是一个可调用的函数对象
4.6.1 注意点
- lambda 只能包含表达式(三元表达式等),不能包含语句(如赋值、循环、if 块)
# 表达式:三元表达式可以
f = lambda x: "正数" if x > 0 else "非正数"
print(f(1)) # 正数
print(f(-1)) # 非正数
# 表达式:算术、比较、函数调用都可以
g = lambda x: x * 2 + 1
print(g(3)) # 7
# 不能包含赋值语句
# h = lambda x: y = x + 1
# SyntaxError: invalid syntax
# 不能包含循环语句
# h = lambda x: for i in range(x): print(i)
# SyntaxError: invalid syntax
# 不能包含 if 块(注意:三元表达式不是 if 块)
# h = lambda x: if x > 0: print("正")
# SyntaxError: invalid syntax
- lambda 不能有 return,表达式的结果就是返回值
# 表达式的结果自动作为返回值
f = lambda x: x + 1
print(f(1)) # 2
# 不能写 return
# g = lambda x: return x + 1
# SyntaxError: invalid syntax
- lambda 不能有文档字符串
# def 可以有 docstring
def f(x):
"""这是说明文档"""
return x + 1
print(f.__doc__) # 这是说明文档
# lambda 不能有 docstring
g = lambda x: x + 1
print(g.__doc__) # None
- lambda 可以接受所有类型的参数(位置、默认、*args、**kwargs)
# 位置参数
f1 = lambda a, b: a + b
print(f1(1, 2)) # 3
# 默认参数
f2 = lambda a, b=10: a + b
print(f2(1)) # 11
print(f2(1, 2)) # 3
# *args
f3 = lambda *args: sum(args)
print(f3(1, 2, 3)) # 6
# **kwargs
f4 = lambda **kwargs: kwargs
print(f4(a=1, b=2)) # {'a': 1, 'b': 2}
# 仅限关键字参数(用 * 分隔)
f5 = lambda a, *, b: a + b
print(f5(1, b=2)) # 3
4.6.2 调用
- 直接执行:(lambda 参数列表:表达式/返回值)(参数列表)
print((lambda x: x + 1)(1)) # 2
print((lambda a, b: a * b)(2, 3)) # 6
print((lambda: 100)()) # 100
- 赋值调用:name = lambda 参数列表:表达式/返回值; name(参数列表)
f = lambda x: x + 1
print(f(1)) # 2
add = lambda a, b: a + b
print(add(2, 3)) # 5
- lambda 常与map()、filter()、sorted(key=…)等配合使用
nums = [3, 1, 2]
# map:对每个元素做转换
print(list(map(lambda x: x * 2, nums))) # [6, 2, 4]
# filter:按条件筛选
print(list(filter(lambda x: x > 1, nums))) # [3, 2]
# sorted:按 key 排序
print(sorted(nums, key=lambda x: -x)) # [3, 2, 1]
# 对字典列表排序
users = [{"name": "小明", "age": 18}, {"name": "小红", "age": 20}]
print(sorted(users, key=lambda u: u["age"])) # 按年龄升序
- PEP 8 建议不要将 lambda 赋值给变量,而应用def
# PEP 8 不推荐
f = lambda x: x + 1
# PEP 8 推荐
def f(x):
return x + 1
print(f(1)) # 2
总结与自测
本章系统讲解了 Python 函数的核心知识,下面用 5 条要点做一次整体回顾,并附上 5 道自测题帮助巩固易错点。
一、核心知识点总结
- 参数定义顺序:位置参数 > 默认参数 > *args 可变位置 > 仅限关键字参数 > **kwargs 可变关键字,顺序不能颠倒。
- 默认参数陷阱:默认参数在函数定义时一次性创建,所有调用共享同一个对象;可变对象(如列表)做原地修改会累积,应使用 None 作为默认值并在函数体内创建新对象。
- global 与 nonlocal 的区别:global 修改全局变量,变量不存在时自动在全局创建;nonlocal 修改外层函数的局部变量,外层必须已存在,否则报 SyntaxError。
- LEGB 规则:读取变量时按 局部(Local)→ 外层函数(Enclosing)→ 全局(Global)→ 内置(Built-in)逐层查找;赋值默认创建局部变量,不向上查找。
- lambda 限制:lambda 只能包含表达式,不能包含语句(赋值、循环、if 块),不能有 return 和文档字符串,表达式的结果就是返回值。
二、自测题
第 1 题(参数类型):以下哪个函数定义是正确的?
- A. def f(a=1, b):
- B. def f(a, b=1, *args, c, **kwargs):
- C. def f(**kwargs, *args):
- D. def f(a, *args, b=1, **kwargs):
答案:D。A 中默认参数不能放在位置参数之前;B 中仅限关键字参数 c 没有默认值,必须放在 *args 之后且 **kwargs 之前,但 c 无默认值会导致调用时必须传关键字,定义本身语法正确但 c 必须传参,而 D 中 b=1 有默认值更合理;C 中 **kwargs 必须放在最后。D 完全符合参数定义顺序。
第 2 题(默认参数陷阱):执行以下代码,输出结果是?
def add_item(item, lst=[]):
lst.append(item)
return lst
print(add_item("a"))
print(add_item("b"))
- A. ['a'] 和 ['b']
- B. ['a'] 和 ['a', 'b']
- C. ['a'] 和 ['a']
- D. 报错
答案:B。默认列表 [] 在函数定义时创建一次,所有调用共享同一个对象。第一次调用 append("a") 后列表变为 ['a'],第二次调用时默认列表已经是 ['a'],再 append("b") 得到 ['a', 'b']。这正是默认参数陷阱的典型表现。
第 3 题(作用域):执行以下代码,输出结果是?
count = 0
def add():
count += 1
add()
print(count)
- A. 1
- B. 0
- C. UnboundLocalError
- D. NameError
答案:C。函数 add 内部有赋值语句 count += 1,Python 会把 count 视为局部变量。由于未声明 global count,赋值前读取 count 会报 UnboundLocalError: local variable 'count' referenced before assignment。
第 4 题(global 与 nonlocal):以下关于 global 和 nonlocal 的说法,正确的是?
- A. nonlocal 可以用于全局作用域
- B. global 声明后,变量不存在时赋值会报错
- C. nonlocal 只能用于嵌套函数内部,且外层必须已存在对应变量
- D. global 和 nonlocal 都影响变量的读取行为
答案:C。nonlocal 只能用于嵌套函数内部,且外层必须已存在对应变量,否则报 SyntaxError。A 错误,nonlocal 不能用于全局作用域;B 错误,global 声明后变量不存在时赋值会自动在全局创建;D 错误,二者只影响赋值的目标作用域,读取仍遵循 LEGB。
第 5 题(lambda):以下哪个 lambda 表达式是合法的?
- A. f = lambda x: return x + 1
- B. f = lambda x: x + 1
- C. f = lambda x: y = x + 1
- D. f = lambda x: if x > 0: print(x)
答案:B。lambda 只能包含表达式,表达式的结果自动作为返回值。A 中 lambda 不能写 return;C 中包含赋值语句,不合法;D 中包含 if 块,不合法(三元表达式 x if 条件 else y 才是合法的表达式)。
综合实战示例
下面给出两个综合实战案例,把第四章的核心知识点串起来
综合实战一:学生成绩管理系统
需求
-
用函数管理学生成绩
-
支持添加学生(默认参数、可变参数、仅限关键字参数)
-
支持统计成绩(多返回值、*args)
-
支持排序(lambda + sorted)
-
支持全局计数器统计操作次数(global)
完整代码
# ===== 全局变量 =====
op_count = 0 # 操作计数
students = [] # 学生列表
def add_student(name, score, *, class_name="一班", **extra):
"""
添加学生
name : 位置参数
score : 位置参数
class_name : 仅限关键字参数(带默认值)
extra : 可变关键字参数
"""
global op_count # 修改全局计数器
op_count += 1
student = {
"name": name,
"score": score,
"class": class_name,
}
student.update(extra) # 合并额外信息
students.append(student)
return student # 返回新增学生
def score_stats(*scores):
"""
统计成绩:最高、最低、平均
*scores : 可变位置参数
返回 : 多返回值(本质是元组)
"""
if not scores:
return None, None, None
highest = max(scores)
lowest = min(scores)
average = sum(scores) / len(scores)
return highest, lowest, average # 多返回值
def rank_students(by="score", reverse=True):
"""
按指定字段排序
by : 默认参数
reverse : 默认参数
"""
return sorted(students, key=lambda s: s[by], reverse=reverse)
# ===== 调用 =====
# ① 添加学生:位置参数 + 仅限关键字参数 + 可变关键字参数
add_student("小明", 92)
add_student("小红", 88, class_name="二班")
add_student("小刚", 95, class_name="一班", age=18, gender="男")
# ② 多返回值:用多个变量接收
h, l, avg = score_stats(92, 88, 95)
print(f"最高:{h},最低:{l},平均:{avg:.1f}")
# 最高:95,最低:88,平均:91.7
# ③ 用 _ 忽略不需要的返回值
h, _, _ = score_stats(92, 88, 95)
print(f"最高分:{h}") # 最高分:95
# ④ lambda + sorted 排序
ranked = rank_students(by="score", reverse=True)
for s in ranked:
print(f"{s['name']}({s['class']}):{s['score']}")
# 小刚(一班):95
# 小明(一班):92
# 小红(二班):88
# ⑤ 全局计数器
print(f"共执行添加操作 {op_count} 次") # 共执行添加操作 3 次
综合实战二:购物车结算系统
需求
-
用函数计算购物车总价
-
支持商品折扣(默认参数)
-
支持任意数量商品(*args)
-
支持满减、优惠券等额外规则(**kwargs)
-
支持统计多个订单(多返回值)
-
支持按价格排序(lambda)
完整代码
# ===== 全局变量 =====
total_orders = 0 # 订单总数
def calc_item_price(name, price, *, discount=1.0):
"""
计算单个商品折后价
name : 位置参数
price : 位置参数
discount : 仅限关键字参数(默认不打折)
"""
return name, price * discount
def checkout(*items, coupon=0, **rules):
"""
结算购物车
*items : 可变位置参数,每个元素是 (名称, 价格)
coupon : 仅限关键字参数,优惠券金额
rules : 可变关键字参数,如 free_shipping=True
返回 : 多返回值(原价、实付、商品数)
"""
global total_orders
total_orders += 1
original = 0
for name, price in items:
original += price
# 满减规则
if rules.get("full_reduce"):
threshold, reduce = rules["full_reduce"]
if original >= threshold:
original -= reduce
# 优惠券
final = original – coupon
if final < 0:
final = 0
return original, final, len(items) # 多返回值
def rank_by_price(*items, reverse=True):
"""按价格排序商品"""
return sorted(items, key=lambda x: x[1], reverse=reverse)
# ===== 调用 =====
# ① 单商品折后价
name, final_price = calc_item_price("手机", 3000, discount=0.9)
print(f"{name} 折后价:{final_price}") # 手机 折后价:2700.0
# ② 结算:可变位置 + 仅限关键字 + 可变关键字
original, final, count = checkout(
("手机", 3000),
("耳机", 500),
("充电器", 100),
coupon=200,
full_reduce=(3000, 300),
)
print(f"原价:{original},实付:{final},商品数:{count}")
# 原价:3300,实付:2800,商品数:3
# ③ 用 _ 忽略商品数
original, final, _ = checkout(("书", 50), coupon=10)
print(f"实付:{final}") # 实付:40
# ④ lambda + sorted 排序
items = [("手机", 3000), ("耳机", 500), ("充电器", 100)]
for n, p in rank_by_price(*items):
print(f"{n}:{p}")
# 手机:3000
# 耳机:500
# 充电器:100
# ⑤ 全局计数器
print(f"共结算 {total_orders} 单") # 共结算 2 单
建议练习
把上面两个案例自己敲一遍,然后尝试以下改造:
案例一:给 rank_students 增加一个 top_n=3 参数,只返回前 N 名。
案例二:给 checkout 增加一个 tax_rate=0.0 仅限关键字参数,计算含税价。
综合:用 lambda 和 sorted 实现一个"按多个字段排序"的函数,例如先按班级、再按成绩。


评论前必须登录!
注册