 网硕互联帮助中心
1. 为什么选择 YOLOv8-Pose 训练 68 关键点
YOLOv8-Pose 是 Ultralytics 提供的姿态估计模型,默认支持 COCO 数据集的 17 个关键点。对于一些精细化任务,例如人脸 68 关键点检测、手部关键点检测或工业场景中的密集关键点回归,17 个点的表达粒度往往不够。通过修改模型的 kpt_shape 以及准备对应格式的数据集,可以很方便地把 YOLOv8-Pose 扩展到 68 个关键点,在保持实时性能的同时获得更精细的坐标回归能力。
本篇教程将完整走通「环境搭建、68 点数据准备、模型配置修改、训练、验证、推理部署」全流程,所有示例均基于 Ultralytics YOLOv8 框架。
本篇教程还附带修改学习数据集已经转化完成并免费开源使用,注:
【数据集简介】 本数据集由 300W-LP 数据集(AFW 子集)转换而来,专门用于 YOLOv8-Pose 的人脸68关键点检测训练。 原始数据来源:Face Alignment in Full Pose Range: A 3D Total Solution (TPAMI 2017)。 【预处理说明】 转换时放弃了原数据集与图像尺寸不匹配的 roi 边界框,改用68个有效关键点最小外接矩形并向外扩展10%作为边界框。 已转换为标准的 YOLO-Pose txt 格式 数据集已全部按 9:1 随机划分为训练集(images/train, labels/train)和验证集(images/val, labels/val)。 【适用场景】 人脸68关键点检测、驾驶员疲劳检测(EAR/MAR计算)、YOLOv8-pose 算法复现与课程设计/毕业论文实验。
【免责声明】 版权归属:本数据集的原始图像及标注版权归 300W-LP 数据集原作者(Xiangyu Zhu 等)及对应机构所有。本资源仅为个人学习、科研复现而进行的二次格式转换。 非商业用途:本资源完全免费共享,仅限于个人学习、学术研究等非商业用途。严禁将本数据集及其衍生模型用于任何商业盈利行为。 准确性声明:转换脚本已尽可能处理异常数据,但受限于原始数据集质量,无法保证所有68个关键点均绝对精准。使用者需自行对数据质量进行核验与可视化抽查,因数据精度导致的一切后果由使用者自行承担。 侵权联系:若本资源无意中侵犯了您的权益,请通过平台私信联系本人,我将在第一时间删除资源并致歉。 使用风险:下载和使用本资源即表示您已阅读并同意本声明,因使用本资源产生的任何直接或间接损失,上传者不承担任何法律责任。
2. 环境准备
建议使用 Python 3.9 及以上版本。创建一个干净的虚拟环境,并安装 PyTorch 和 Ultralytics。
# 创建虚拟环境
python -m venv yolov8_pose_env
# 激活虚拟环境
Linux / macOS
source yolov8_pose_env/bin/activate
Windows
yolov8_pose_env\\Scripts\\activate
# 安装 PyTorch,CUDA 版本根据实际显卡环境选择
pip install torch torchvision –index-url https://download.pytorch.org/whl/cu121
# 安装 Ultralytics
pip install ultralytics
安装完成后,可以用下面的命令确认环境正常。
from ultralytics import YOLO
import torch
print("Ultralytics 版本:", import("ultralytics").version)
print("CUDA 是否可用:", torch.cuda.is_available())
3. 68 关键点
3.1 68 关键点定义与数据规范
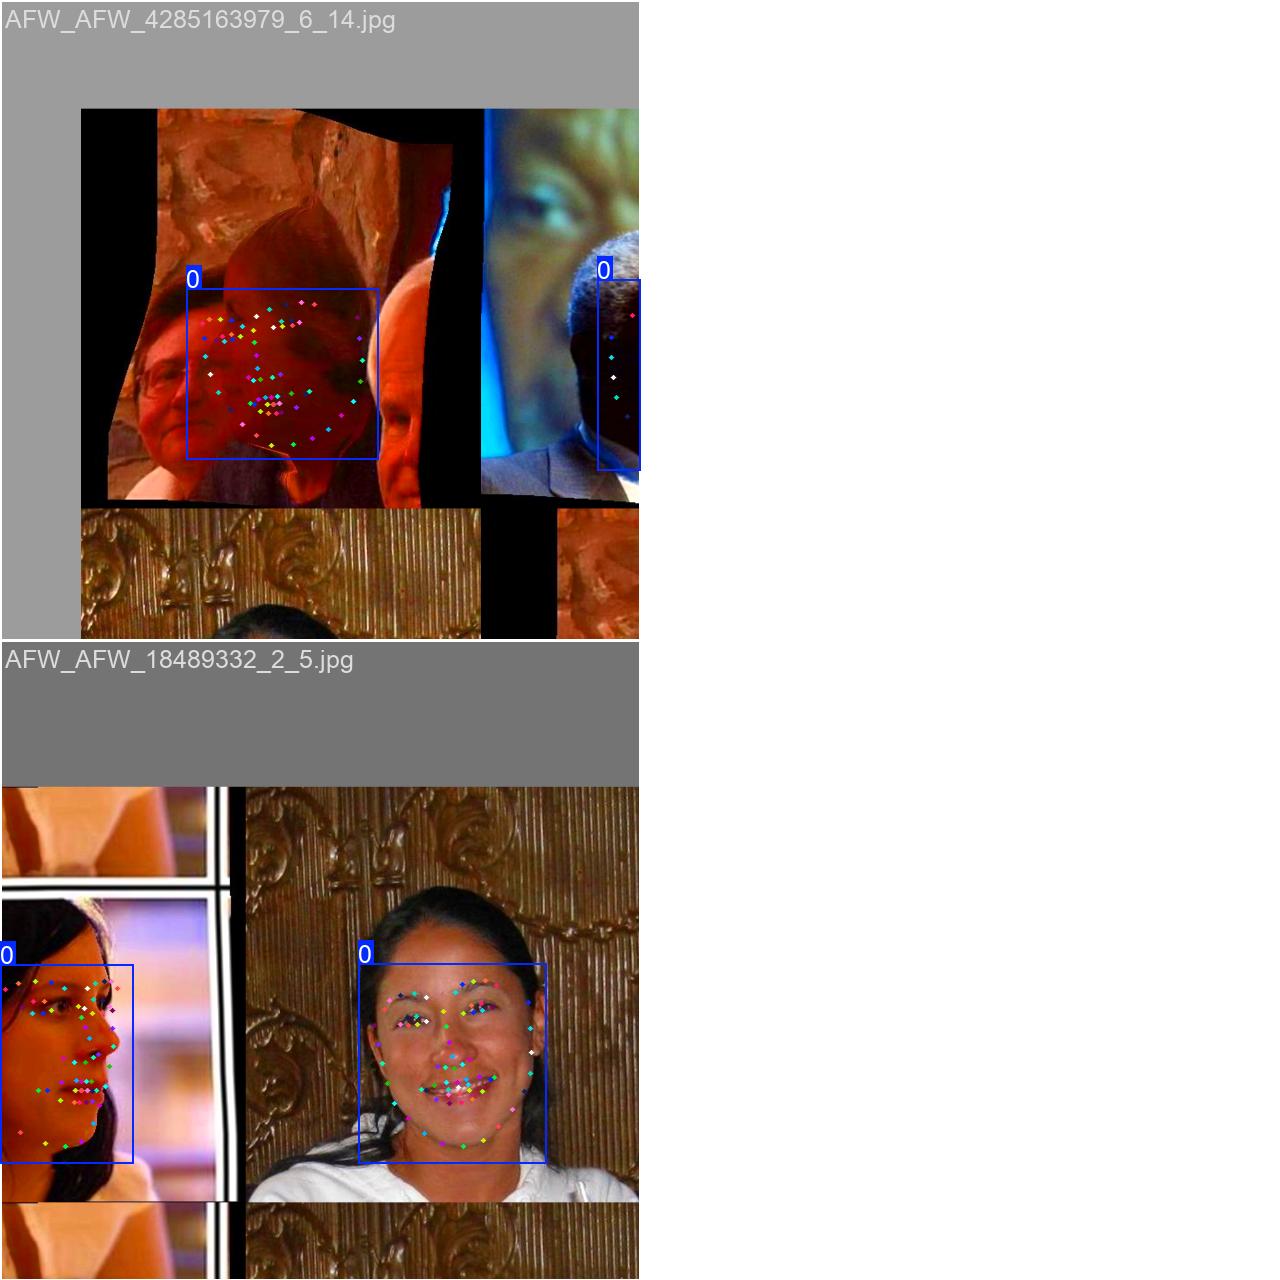
-
68 点标准顺序说明
-
0–16:下巴轮廓
-
17–26:眉毛
-
27–35:鼻子
-
36–47:眼睛
-
48–67:嘴巴
-
-
68 点索引图:在原图上标出每个点编号。
-
左右对称点交换表:做 fliplr 时必须交换哪些索引。
-
关键点坐标是“相对整图归一化”,不是相对 bbox 局部归一化。
-
可见性 v 的语义:0 不可见、1 遮挡、2 可见;缺失点如何处理。
-
单脸/多脸标签写法:一张图多个人脸时,每行一个目标。
-
bbox 如何生成:人脸检测器预标注、手工框、扩展框,避免裁掉下巴或额头。
-
标签校验脚本:检查字段数是否为 5 + 68*3、坐标是否越界、可见性是否合法、bbox 是否有效。
3.2 准备 68 关键点数据集
YOLOv8-Pose 使用 YOLO 格式的文本标签,每张图片对应一个同名 .txt 文件。68 关键点标签的每一行格式如下:
class_id cx cy w h x1 y1 v1 x2 y2 v2 … x68 y68 v68
其中:
- class_id:类别编号,从 0 开始。
- cx、cy、w、h:目标框中心坐标和宽高,均归一化到 0 到 1。
- x1、y1 到 x68、y68:68 个关键点的坐标,也归一化到 0 到 1。
- v1 到 v68:关键点可见性,通常 0 表示不可见,1 表示被遮挡,2 表示可见。
数据集目录建议按照以下结构组织:
face68_dataset/
├── images/
│ ├── train/
│ │ ├── img_001.jpg
│ │ └── img_002.jpg
│ └── val/
│ ├── img_101.jpg
│ └── img_102.jpg
└── labels/
├── train/
│ ├── img_001.txt
│ └── img_002.txt
└── val/
├── img_101.txt
└── img_102.txt
如果原始标注来自常见的 68 点数据集,例如人脸 landmark 数据集,通常需要先把关键点坐标归一化,并补齐可见性标签。下面的示例展示了如何把一组关键点写入 YOLOv8-Pose 标签文件:
import os
import cv2
image_dir = "face68_dataset/images/train"
label_dir = "face68_dataset/labels/train"
os.makedirs(label_dir, exist_ok=True)
def write_yolo_label(image_path, bbox, landmarks68, visibility=None):
"""
bbox: (x1, y1, x2, y2) 像素坐标
landmarks68: [(x, y), …] 像素坐标,共 68 个点
visibility: 长度 68 的可见性列表,默认全部为 2
"""
img = cv2.imread(image_path)
h, w = img.shape[:2]
x1, y1, x2, y2 = bbox
cx = (x1 + x2) / 2 / w
cy = (y1 + y2) / 2 / h
bw = (x2 – x1) / w
bh = (y2 – y1) / h
if visibility is None:
visibility = [2] * 68
line_parts = [0, f"{cx:.6f}", f"{cy:.6f}", f"{bw:.6f}", f"{bh:.6f}"]
for (lx, ly), vis in zip(landmarks68, visibility):
line_parts.append(f"{lx / w:.6f}")
line_parts.append(f"{ly / h:.6f}")
line_parts.append(str(vis))
label_path = os.path.join(label_dir, os.path.splitext(os.path.basename(image_path))[0] + ".txt")
with open(label_path, "w") as f:
f.write(" ".join(line_parts))</code></pre>
数据准备好之后,还需要编写对应的数据集配置文件 face68.yaml:
path: /absolute/path/to/face68_dataset
train: images/train
val: images/val
names:
0: face
kpt_shape: [68, 3]
4. 修改模型配置
Ultralytics 从 yolov8n-pose.yaml 到 yolov8x-pose.yaml 提供了不同尺寸的 pose 模型配置。默认配置中的关键点数量是 17,我们需要把它改成 68。可以直接复制官方配置并修改关键点参数。 参考官方 yolov8n-pose.yaml,修改关键点数量和分类数
# yolov8n-face68-pose.yaml
nc: 1
scales:
n: [0.33, 0.25, 1024]
backbone:
[-1, 1, Conv, [64, 3, 2]]
[-1, 1, Conv, [128, 3, 2]]
[-1, 3, C2f, [128, True]]
[-1, 1, Conv, [256, 3, 2]]
[-1, 6, C2f, [256, True]]
[-1, 1, Conv, [512, 3, 2]]
[-1, 6, C2f, [512, True]]
[-1, 1, Conv, [1024, 3, 2]]
[-1, 3, C2f, [1024, True]]
[-1, 1, SPPF, [1024, 5]]
head:
[-1, 1, nn.Upsample, [None, 2, 'nearest']]
[[-1, 6], 1, Concat, [1]]
[-1, 3, C2f, [512]]
[-1, 1, nn.Upsample, [None, 2, 'nearest']]
[[-1, 4], 1, Concat, [1]]
[-1, 3, C2f, [256]]
[-1, 1, Conv, [256, 3, 2]]
[[-1, 15], 1, Concat, [1]]
[-1, 3, C2f, [512]]
[-1, 1, Conv, [512, 3, 2]]
[[-1, 12], 1, Concat, [1]]
[-1, 3, C2f, [1024]]
[[17, 20, 23], 1, Pose, [nc, kpt_shape]]
注意最后一行使用的是 kpt_shape 变量,因此只要在训练时通过参数把 kpt_shape 指定为 [68, 3],模型输出层的通道数就会自动适配为 68 个关键点。
5. 开始训练
训练脚本很简单,核心是数据集配置和关键点形状。下面是一个完整训练示例: 从官方 pose 模型权重开始训练,也可以从自定义 yaml 训练
from ultralytics import YOLO
if __name__ == '__main__':
model = YOLO('weights/yolov8n-pose.pt')
model.train(data='face.yaml',
epochs=300,
imgsz=640,
batch=2,
nbs=16,
lr0=0.001,
lrf=0.001,
warmup_epochs=10,
cos_lr=True,
optimizer='AdamW',
weight_decay=0.0005,
mosaic=0.0,
mixup=0.0,
copy_paste=0.0,
fliplr=0.5,
flipud=0.0,
degrees=10.0,
translate=0.05,
scale=0.3,
shear=0.0,
perspective=0.0,
hsv_h=0.015,
hsv_s=0.5,
hsv_v=0.3,
pose=8.0,
kobj=1.0,
cls=0.5,
box=7.5,
dfl=1.5,
workers=0,
amp=True,
patience=100,
save_period=10,
project='runs/pose',
name='face68_nano',
cache=False,
)
这里有几个需要特别注意的参数:
mosaic=0.0:关闭Mosaic 增强这是对 68 点人脸关键点最有害的增强。拼图会把人脸切碎、缩放、错位,关键点坐标随之被打乱。模型要花大量精力“解拼图”,而不是学人脸结构。 kpt_shape=[68, 3]:必须是三维列表。第三维通常是关键点的可见性标志;如果标注只有 x、y 而没有可见性,可以写 [68, 2]。 imgsz:人脸或小目标场景可以适当增大到 640 或 1024,但显存占用也会增加。 batch:根据显存调整,显存不足时减小 batch 并适当降低学习率。 patience:早停轮数,建议根据数据集规模设定。 训练过程中 Ultralytics 会自动记录 loss、mAP 和各类可视化图像,结果默认保存在 runs/pose/yolov8n_face68 目录下。
6. 验证与推理
训练完成后,使用验证集评估模型效果:
from ultralytics import YOLO
model = YOLO("runs/pose/yolov8n_face68/weights/best.pt")y
在验证集上评估
metrics = model.val(data="face68.yaml", kpt_shape=[68, 3])
print(metrics.box.map)
print(metrics.box.map50)
print(metrics.box.map75)
对单张图片或视频做推理时,可以使用下面的方法:
from ultralytics import YOLO
model = YOLO("runs/pose/yolov8n_face68/weights/best.pt")
results = model.predict(
source="test_faces.jpg",
kpt_shape=[68, 3],
conf=0.25,
save=True,
show=True,
)
for result in results:
keypoints = result.keypoints
boxes = result.boxes
if keypoints is not None:
keypoints.xy:关键点坐标,形状为 (目标数, 68, 2)
keypoints.conf:关键点置信度,形状为 (目标数, 68)
print("关键点坐标:", keypoints.xy)
print("关键点置信度:", keypoints.conf)
如果需要把关键点结果导出为 JSON,可以结合 result.keypoints 手动组织数据结构。默认情况下,result.keypoints.xy 是 68 个归一化或像素格式的坐标,具体取决于推理设置。
6.1 模型导出与部署
训练完成后,可以把 best.pt 导出为 ONNX、TensorRT 等格式。无论导出哪种格式,都要传入与训练时一致的 kpt_shape=[68, 3],否则 Ultralytics 无法正确确定关键点输出通道数,导出的模型可能仍按默认 17 点解析。
下面先导出 ONNX:
from ultralytics import YOLO
model = YOLO("runs/pose/yolov8n_face68/weights/best.pt")
model.export(
format="onnx", # 导出 ONNX 格式
imgsz=640, # 使用与训练时一致的输入尺寸
kpt_shape=[68, 3], # 关键点数量和可见性维度
opset=12, # ONNX opset 版本
simplify=True, # 简化模型图,便于部署
)
导出 TensorRT engine 时同理,通常在 NVIDIA GPU 上使用 FP16 加速:
model.export(
format="engine", # 导出 TensorRT 格式
imgsz=640,
kpt_shape=[68, 3],
half=True, # 开启半精度推理,需 GPU 支持
device=0,
)
导出的 ONNX 输出张量可以理解为 [1, 4 + nc + 68 * 3, num_anchors]。前 4 个通道是目标框回归值,接着是 nc 个类别通道,最后 204 个通道按 68 组、每组 3 个值组织为 x、y、可见性。下面用 ONNX Runtime 读取输出并拆分关键点通道:
import numpy as np
import onnxruntime as ort
session = ort.InferenceSession("runs/pose/yolov8n_face68/weights/best.onnx")
input_name = session.get_inputs()[0].name
input_tensor 需要预先完成缩放、归一化和 BGR 到 RGB 的转换
output = session.run(None, {input_name: input_tensor})[0]
print("原始输出形状:", output.shape) # [1, 4 + nc + 68*3, num_anchors]
nc = 1
num_anchors = output.shape[2]
pred = output[0].transpose(1, 0) # [num_anchors, 4 + nc + 68*3]
boxes_raw = pred[:, :4] # 目标框回归原始值
cls_raw = pred[:, 4:4 + nc] # 类别原始值
kpts_raw = pred[:, 4 + nc:].reshape(num_anchors, 68, 3)
kpts_xy = kpts_raw[…, :2] # 68 个关键点的 x、y 原始值
kpts_conf = kpts_raw[…, 2] # 关键点可见性或置信度
print("boxes_raw 形状:", boxes_raw.shape)
print("kpts_xy 形状:", kpts_xy.shape)
print("kpts_conf 形状:", kpts_conf.shape)
需要特别注意,kpts_xy 和 boxes_raw 仍是模型输出的原始回归值,不是最终像素坐标。实际部署时还需要结合 anchor、stride 完成解码,并进行 NMS。对于大多数项目,推荐直接通过 Ultralytics 加载 ONNX 模型推理,它能自动完成解码和后处理,并直接返回 68 点坐标:
from ultralytics import YOLO
model = YOLO("runs/pose/yolov8n_face68/weights/best.onnx")
results = model.predict(
source="test_faces.jpg",
kpt_shape=[68, 3],
conf=0.25,
)
for result in results:
if result.keypoints is not None:
xy = result.keypoints.xy # 形状为 [目标数, 68, 2]
conf = result.keypoints.conf # 形状为 [目标数, 68]
print("68 关键点坐标:", xy)
print("关键点置信度:", conf)
7. 常见问题
7.1 关键点数量与数据集配置不一致
如果 kpt_shape 与标签文件中的关键点数量不一致,训练启动时通常会出现维度错误。请检查数据集配置中的 kpt_shape: [68, 3] 以及训练命令中是否也都传入了 kpt_shape=[68, 3]。
7.2 显存不足
68 个关键点比 17 个关键点的输出通道多,但对骨干网络的显存影响远小于输入分辨率和 batch 带来的影响。显存不足时优先减小 imgsz 或 batch,其次是换更轻量的 yolov8n-pose 主干。
7.3 训练 loss 正常但关键点发散
通常与关键点坐标归一化错误有关。请确认所有 x、y 坐标都除以了图片宽高,且不是除以 1 到 68 的索引。另外检查可见性字段是否被误当作坐标写入。
7.4 使用 68 点模型做 17 点任务
不建议直接混用。68 点模型和 17 点模型输出层结构不同,不能直接加载彼此的关键点头部权重。如果必须复用,可以将骨干网络权重迁移后重新训练关键点头部。
7.5 关键点坐标偏移或镜像翻转
当标注解析或数据增强过程中坐标变换不一致时,68 关键点经常会出现整体偏移、左右镜像或尺度异常。下表汇总了三种典型症状的排查方向。
| 坐标整体偏移 | 裁剪、仿射变换或缩放后没有同步调整关键点;关键点相对整图和相对 bbox 使用了不同的原点。 | 确保所有点在同一个变换矩阵下处理;检查关键点坐标是相对整张图归一化,而不是相对 bbox 局部区域。 |
| 左右镜像 | 水平翻转图像后没有同步翻转关键点;或者只翻转了图片,没有交换 68 点中左右对称的索引。 | 对图像做水平翻转时,同步把关键点 x 坐标改为 1-x,并按 68 点对称关系交换左右点索引,同时更新可见性。 |
| 尺度异常 | 缩放前后没有使用同一组图片宽高进行归一化,或把像素坐标与归一化坐标混用。 | 统一除以原图宽高;对缩放后的坐标先还原到原图再验证;增强时记录并复用实际的缩放和 padding 参数。 |
下面这段调试代码可以读取一张图片及其 YOLO 格式的 68 点标签,将关键点绘制回原图,便于人工检查坐标偏移、镜像关系和尺度是否正常。
import cv2
def visualize_yolo_68(image_path, label_path, save_path="debug_keypoints.jpg"):
img = cv2.imread(image_path)
h, w = img.shape[:2]
with open(label_path, "r") as f:
parts = f.readline().strip().split()
跳过前 5 个字段:class_id, cx, cy, bw, bh
kpts = []
for i in range(5, len(parts), 3):
x = float(parts[i]) * w
y = float(parts[i + 1]) * h
v = int(parts[i + 2])
kpts.append((int(x), int(y), v))
只绘制可见或存在标注的点
for idx, (x, y, v) in enumerate(kpts):
if v > 0:
cv2.circle(img, (x, y), 3, (0, 255, 0), -1)
cv2.putText(img, str(idx), (x + 3, y – 3),
cv2.FONT_HERSHEY_SIMPLEX, 0.4, (0, 0, 255), 1)
cv2.imwrite(save_path, img)
print("调试图已保存到", save_path)
visualize_yolo_68("face68_dataset/images/train/img_001.jpg",
"face68_dataset/labels/train/img_001.txt")
运行后重点检查关键点是否落在人脸、手部或其他目标结构上,尤其关注左右对称点和整体轮廓尺度。若发现整体偏移、镜像或缩放异常,应回到标注解析和数据增强环节进行修正。
8. 总结
将 YOLOv8-Pose 扩展到 68 关键点的关键步骤可以归纳为:准备 68 点 YOLO 格式标签、在数据配置中声明 kpt_shape: [68, 3]、在训练和推理时显式传入相同的 kpt_shape,并通过小规模数据先跑通流程再扩量训练。掌握这一套流程后,可以进一步迁移到更多点的手部、姿态或定制化关键点任务。 建议在正式训练前,先用几百张样本验证数据格式和模型输出维度是否正确,再逐步增加数据规模和训练轮数,这样能更高效地排查关键点回归不稳定的问题。
加数据规模和训练轮数,这样能更高效地排查关键点回归不稳定的问题。
参考资料
Ultralytics YOLOv8 官方文档:https://docs.ultralytics.com/models/yolov8/ Ultralytics YOLOv8 Pose 任务文档:https://docs.ultralytics.com/tasks/pose/ 300W-LP 数据集原始论文:Xiangyu Zhu, Zhen Lei, Xiaoming Liu, Hailin Shi, Stan Z. Li. Face Alignment in Full Pose Range: A 3D Total Solution. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2017. YOLOv8-Pose 相关 GitHub 仓库:https://github.com/ultralytics/ultralytics ONNX Runtime 部署文档:https://onnxruntime.ai/docs/ TensorRT 部署文档:https://docs.nvidia.com/deeplearning/tensorrt/


评论前必须登录!
注册