 网硕互联帮助中心
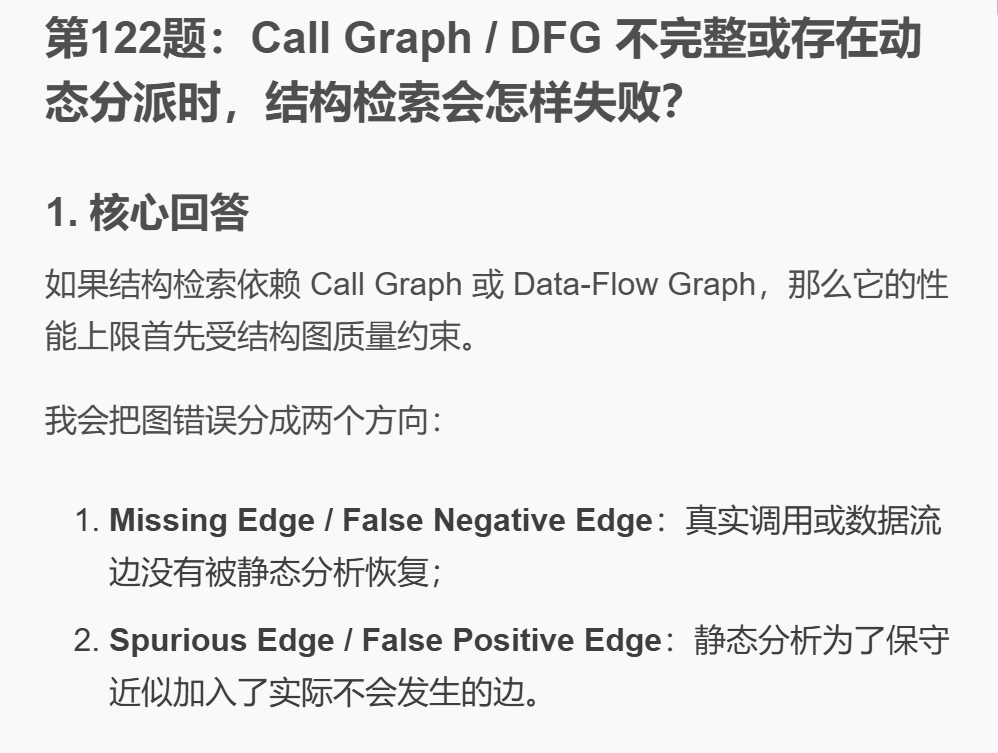
第122题:Call Graph / DFG 不完整或存在动态分派时,结构检索会怎样失败?
1. 核心回答
如果结构检索依赖 Call Graph 或 Data-Flow Graph,那么它的性能上限首先受结构图质量约束。
我会把图错误分成两个方向:
两者对结构检索的影响正好相反:
Missing Edge
→ 真正相关节点不可达
→ Retrieval Recall下降
→ 关键证据缺失
Spurious Edge
→ 大量无关节点被扩展
→ Retrieval Precision下降
→ Context Noise和Token Cost增加
动态分派、Reflection、Callback、Function Pointer、Dependency Injection、RPC 等机制会进一步放大这个问题。
所以我的设计不会是:
只允许从结构图邻居中检索
而会采用:
Lexical / Dense Recall
+
Structural Expansion
+
Reranking
把结构信息作为重要信号,但不是唯一入口。
同时用 Oracle Graph、Edge Deletion、Edge Injection 和动态特征切片实验,量化图错误对 Retrieval Recall 和最终漏洞检测结果的影响。
2. 什么叫结构检索
假设代码库被表示成图:
G=(V,E)
G=(V,E)
G=(V,E)
节点 VVV 可以包括:
- Function;
- Method;
- Statement;
- Variable;
- API;
- Code Chunk。
边 EEE 可以包括:
- Call Edge;
- Data-Flow Edge;
- Control-Flow Edge;
- Def-Use Edge;
- Source–Sink Relation。
对于 Query 函数:
q
q
q
结构检索可能从:
Nk(q)
N_k(q)
Nk(q)
即 kkk 跳邻域中选择上下文。
例如:
Query Function
↓
Caller
↓
Callee
↓
Source/Sink
↓
相关代码Chunk
相比纯文本 Embedding,它希望利用真实程序结构过滤无关代码。
但前提是:
Gestimated
G_{\\text{estimated}}
Gestimated
足够接近真实程序行为:
Gtrue
G_{\\text{true}}
Gtrue
3. Call Graph 不完整时最直接的失败:漏召回
假设真实调用链:
handleRequest()
↓
parse()
↓
validate()
↓
executeQuery()
但静态 Call Graph 漏掉:
parse()
→
validate()
于是估计图变成:
handleRequest()
↓
parse()
validate()
↓
executeQuery()
如果结构检索只执行:
从handleRequest向外扩展3跳
则:
validate()
executeQuery()
可能永远不会进入候选集合。
即:
RelevantEvidence∉Candidates
RelevantEvidence
\\notin
Candidates
RelevantEvidence∈/Candidates
后面的:
- Embedding;
- Reranker;
- LLM;
再强也无法把它找回来。
因此结构检索中的第一原则是:
候选生成阶段发生的 False Negative 通常无法被后续 Reranking 修复。
4. Missing Edge 为什么对安全任务特别危险
很多漏洞本身就是跨函数形成的。
例如:
HTTP Input
↓
controller()
↓
service()
↓
decode()
↓
shell()
真正的漏洞关系是:
Source⇝Sink
Source
\\leadsto
Sink
Source⇝Sink
如果 Call Graph 中漏掉:
service()
→
decode()
那么整个攻击路径可能被切断。
最终 Retriever 可能只能看到:
HTTP Input
却看不到:
shell()
于是模型判断:
没有危险Sink
产生 False Negative。
对于:
- SQL Injection;
- Command Injection;
- Path Traversal;
- Sensitive Data Flow;
这类跨过程漏洞影响尤其明显。
5. DFG 不完整会直接截断 Source–Sink Path
Data-Flow Graph 可以表示:
vi→vj
v_i\\rightarrow v_j
vi→vj
表示值或污点可能从:
vi
v_i
vi
传播到:
vj
v_j
vj
假设真实路径:
request.input
↓
decode()
↓
normalize()
↓
query
↓
db.execute()
真实 DFG:
Source→v1→v2→Sink
Source
\\rightarrow
v_1
\\rightarrow
v_2
\\rightarrow
Sink
Source→v1→v2→Sink
如果:
(v1,v2)
(v_1,v_2)
(v1,v2)
缺失,则结构系统看到:
Source↛Sink
Source
\\nrightarrow
Sink
Source↛Sink
于是:
Source-Sink Retrieval
会直接失败。
CodeQL 的 Path Query 也是建立在 source、sink 和连接它们的数据流 edge 上;如果关键 flow step 没有被模型覆盖,就无法得到完整路径。
6. 为什么 DFG 很难做到绝对完整
跨过程数据流可能涉及:
- Pointer;
- Alias;
- Object Field;
- Heap;
- Global Variable;
- Callback;
- Container;
- Framework;
- Serialization;
- Native Code;
- Database;
- RPC。
例如:
obj.setInput(userInput);
...
sink(obj.getInput());
需要分析:
setInput
↓
Heap Field
↓
getInput
才能恢复传播关系。
如果 Alias / Points-to Analysis 不够准确,DFG 就可能漏掉或过度加入传播路径。
因此结构检索系统必须承认:
DFGstatic≠DFGruntime
DFG_{\\text{static}}
\\neq
DFG_{\\text{runtime}}
DFGstatic=DFGruntime
通常只能得到近似。
7. 另一个方向:Spurious Edge
为了降低漏报,静态分析有时采用 Conservative Over-Approximation。
例如:
interface Handler {
void handle(Input x);
}
存在:
SafeHandler
FileHandler
DatabaseHandler
ShellHandler
静态分析不能确定:
handler.handle(x)
运行时究竟是哪一个对象。
于是可能加入:
caller → SafeHandler.handle
caller → FileHandler.handle
caller → DatabaseHandler.handle
caller → ShellHandler.handle
实际上运行时只有:
SafeHandler.handle
被调用。
其余都是 Spurious Edges。
8. Spurious Edge 会怎样破坏结构检索
假设本来结构邻域只有:
20
20
20
个真正相关函数。
因为 Call Graph Over-Approximation,变成:
300
300
300
个候选函数。
结构检索的 Search Space 从:
20
20
20
扩大到:
300
300
300
后果包括:
- 无关 Code Chunk 增加;
- Reranker 难度增加;
- Top-K 被错误候选占用;
- Prompt Token 增加;
- LLM 注意力被稀释;
- 延迟上升。
也就是说:
Graph Recall↑
Graph\\ Recall\\uparrow
Graph Recall↑
不一定意味着:
EndToEnd Quality↑
EndToEnd\\ Quality\\uparrow
EndToEnd Quality↑
因为过度保守的图可能严重损害 Precision。
9. Call Graph 本身就存在 Soundness–Precision Trade-off
定义真实 Call Edge 集:
E∗
E^*
E∗
静态分析得到:
E^
\\hat E
E^
可以定义 Edge Recall:
$$
Recall_{CG}
\\frac{|\\hat E\\cap E^|}
{|E^|}
$$
以及 Edge Precision:
$$
Precision_{CG}
\\frac{|\\hat E\\cap E^*|}
{|\\hat E|}
$$
如果追求更高 Soundness,通常会增加可能的 Call Target:
∣E^∣↑
|\\hat E|\\uparrow
∣E^∣↑
但可能使:
PrecisionCG↓
Precision_{CG}\\downarrow
PrecisionCG↓
反过来,如果为了 Precision 过度裁剪候选:
∣E^∣↓
|\\hat E|\\downarrow
∣E^∣↓
又可能产生:
RecallCG↓
Recall_{CG}\\downarrow
RecallCG↓
所以结构检索不能假设 Call Graph 是绝对真值。
10. Dynamic Dispatch 为什么是核心困难
考虑:
Base x = factory();
x.process(input);
静态代码只告诉我们:
declared type = Base
实际运行对象可能是:
A
B
C
于是:
Base.process()
的真实调用目标需要根据运行时对象类型确定。
即:
$$
Target(call)
f(RuntimeType(x))
$$
静态分析没有直接的 RuntimeType。
所以需要使用:
- Class Hierarchy Analysis;
- Rapid Type Analysis;
- Points-to Analysis;
- Context-Sensitive Analysis;
推断可能 Call Target。
11. CodeQL 为什么区分 calls 和 polyCalls
CodeQL 官方 Java Call Graph 接口中区分:
calls(target)
和:
polyCalls(target)
前者对应直接解析的调用。
后者考虑:
runtime polymorphic dispatch
即一个调用可能真正落到:
override method
上。
这说明在面向对象语言中:
syntactic callee
和:
runtime callee
本身就是两个不同概念。
结构检索如果只使用静态声明方法,会漏掉真正实现。
12. Points-to Analysis 为什么能改善动态调用解析
例如:
Base x;
if (flag)
x = new A();
else
x = new B();
x.run();
如果分析得到:
PointsTo(x)={A,B}
PointsTo(x)=\\{A,B\\}
PointsTo(x)={A,B}
则 Call Target 可以缩小成:
Targets(x.run)={A.run,B.run}
Targets(x.run)=
\\{A.run,B.run\\}
Targets(x.run)={A.run,B.run}
而不是 Class Hierarchy 中所有:
Base subclass
的 run()。
Soot/SootUp 的 Spark 就结合:
- Points-to Analysis;
- Pointer Assignment Graph;
- Call Graph;
推导调用关系。
这可以改善 Precision。
但仍然取决于程序动态特征是否被正确建模。
13. Reflection 为什么更困难
例如:
String name = config.get("handler");
Class<?> c = Class.forName(name);
Handler h = (Handler)c.newInstance();
h.run();
目标类型来自:
Runtime Configuration
仅从普通 AST 和类型层次可能无法确定:
name
到底是什么。
如果静态分析没有专门 Reflection Modeling:
run()
的真实目标可能消失。
于是:
Call Graph Missing Edge
↓
Structural Retrieval Missing Evidence
实证研究也显示 Reflection 等动态机制是静态 Call Graph 完整性的重要挑战。
14. Framework Callback 同样会导致隐藏调用边
例如 Web Framework:
@GetMapping("/login")
public Response login(...) {
...
}
代码中可能根本没有显式:
main() → login()
真实调用由 Framework Runtime 完成。
类似情况包括:
- Spring Dependency Injection;
- Android Lifecycle;
- Event Listener;
- Servlet;
- ORM Callback;
- Annotation-driven Framework。
如果静态分析不知道 Framework Semantics,就可能看不到:
Framework
→
Application Callback
这种 Hidden Edge。
已有针对 Spring Framework 的静态分析研究专门通过额外建模提高 Call Graph Completeness。
15. Function Pointer 也存在同样问题
C/C++:
void (*handler)(char *);
handler(input);
真实调用目标取决于:
handler
指向哪里。
需要 Pointer Analysis 才能确定候选集合。
如果 Points-to Set 太窄:
漏边
如果太宽:
伪边
因此:
Dynamic Dispatch
Virtual Call
Function Pointer
本质上都体现了:
运行时调用目标无法完全由局部语法直接确定。
16. RPC / IPC 会形成更隐蔽的跨边界调用
例如:
Client.foo()
↓
RPC Framework
↓
Network
↓
Server.foo()
源码中客户端与服务端之间可能没有普通函数调用 Edge。
传统 Call Graph 可能得到:
Client.foo()
和:
Server.foo()
两个独立子图。
于是结构检索在 Client 上查询时永远到不了 Server 端实现。
2025 年 ICSE 的 RPCBridge 工作专门研究了这一问题:通过建模 Java RPC 语义补充跨 Client/Server 的调用关系,并发现补全这些边能够进一步恢复原分析遗漏的数据泄漏路径。
所以对于现代微服务代码:
Repository 内 Call Graph 完整不等于系统级调用图完整。
17. 结构检索最危险的设计:把 Graph 当 Hard Filter
例如:
candidates = all_chunks
candidates = [
x for x in candidates
if graph_distance(query, x) <= 2
]
这种设计意味着:
x∉G⇒x永远无法被召回
x\\notin G
\\Rightarrow
x\\text{永远无法被召回}
x∈/G⇒x永远无法被召回
如果 Graph Missing Edge:
Recall不可恢复
无论 Embedding 或 Reranker 多强。
因此我不会把不可靠的静态图直接当成唯一 Hard Constraint。
18. 更稳健的方法:Hybrid Candidate Generation
更合理的是同时建立多个召回通道:
Query
├── Lexical Retrieval
├── Dense Retrieval
├── Call-Graph Retrieval
├── DFG Retrieval
└── Metadata Retrieval
得到:
$$
C
C_{\\text{lex}}
\\cup
C_{\\text{dense}}
\\cup
C_{\\text{CG}}
\\cup
C_{\\text{DFG}}
$$
然后:
Dedup
↓
Feature Fusion
↓
Reranker
如果 Call Graph 漏边:
Dense Retrieval
仍然可能把关键函数召回。
如果 Dense Retrieval 只看到表面语义:
Structural Retrieval
则能够提供跨函数程序关系。
二者互补。
19. 结构特征最好作为 Ranking Feature,而非绝对真值
例如 Reranker Score:
$$
S(q,d)
w_1S_{\\text{dense}}
+
w_2S_{\\text{lexical}}
+
w_3S_{\\text{call}}
+
w_4S_{\\text{dataflow}}
$$
其中:
Scall
S_{\\text{call}}
Scall
可以考虑:
- Call Distance;
- Same SCC;
- Caller / Callee;
- Points-to Confidence。
Sdataflow
S_{\\text{dataflow}}
Sdataflow
可以考虑:
- 是否位于同一 Source–Sink Path;
- DFG Distance;
- Taint Reachability。
这样:
Graph edge存在
可以提高候选分数。
但:
Graph edge不存在
不会自动把候选删除。
对不完美静态图更加鲁棒。
20. 还应该给 Structure Edge 一个 Confidence
不同结构边的可信度不同。
例如:
Direct Static Call
置信度通常较高。
CHA 推测 Virtual Target
可能较低。
Reflection Approximation
更不确定。
可以保存:
edge_type
analysis_method
confidence
provenance
例如:
CALL_DIRECT 1.0
POINTS_TO 0.9
CHA 0.6
REFLECTION_HINT 0.4
DYNAMIC_TRACE 1.0
这些数字不能凭经验直接当真实概率,需要在验证集校准。
核心思想是:
区分不同来源的结构证据,而不是把所有 Edge 当成等价事实。
21. 图不确定时应该主动扩大搜索范围
例如初始结构检索:
N2(q)
N_2(q)
N2(q)
只得到很少候选。
同时 Call Graph Confidence 很低。
系统可以执行:
Structural Confidence Low
↓
Fallback
↓
Dense / Lexical Candidate Expansion
而不是立即得出:
没有相关代码
这种策略可以称为:
Uncertainty-Aware Retrieval
22. Runtime Trace 可以用来补结构,但不能当完整真值
动态分析可以实际观察:
这一次运行
发生了哪些调用。
因此可以补充 Static Call Graph:
$$
G_{\\text{hybrid}}
G_{\\text{static}}
\\cup
G_{\\text{dynamic}}
$$
优点:
- 能看到真实 Reflection;
- 能看到真实 Callback;
- 能看到真实 Runtime Dispatch。
但它也存在 Coverage 问题。
如果测试没有触发:
某个漏洞路径
Dynamic Trace 就不会包含它。
因此:
Dynamic Edge不存在
不能证明:
Runtime永远不可能发生
更合理的是静态和动态证据互补。
23. 如何判断 Call Graph 是否真的是系统瓶颈
必须做 Oracle Graph 实验。
构建一个更高质量的:
Goracle
G_{\\text{oracle}}
Goracle
例如来自:
- 人工标注;
- 动态 Trace;
- 专用 Framework Model;
- Ground Truth Benchmark。
然后固定:
- Embedding;
- Retriever;
- Reranker;
- Generator;
- Token Budget;
只替换:
Gnormal
G_{\\text{normal}}
Gnormal
为:
Goracle
G_{\\text{oracle}}
Goracle
比较:
M(Gnormal)
M(G_{\\text{normal}})
M(Gnormal)
和:
M(Goracle)
M(G_{\\text{oracle}})
M(Goracle)
24. Oracle Graph 的结果怎么解释
如果:
M(Goracle)≫M(Gnormal)
M(G_{\\text{oracle}})
\\gg
M(G_{\\text{normal}})
M(Goracle)≫M(Gnormal)
说明:
Graph Quality 是主要瓶颈。
如果:
M(Goracle)≈M(Gnormal)
M(G_{\\text{oracle}})
\\approx
M(G_{\\text{normal}})
M(Goracle)≈M(Gnormal)
则继续优化 Call Graph 的收益可能有限。
瓶颈可能在:
- Embedding;
- Relevant Evidence Definition;
- Reranker;
- Context Assembly;
- Generator。
这正是为什么不能仅凭:
静态分析可能不完整
就把所有失败都归因于 Graph。
25. 还应该主动做 Edge Deletion 实验
从高质量图:
G∗
G^*
G∗
随机或按类型删除:
p%
p\\%
p%
的真实 Edge。
得到:
Gp−
G^-_p
Gp−
例如:
p∈{5%,10%,20%,40%}
p\\in\\{5\\%,10\\%,20\\%,40\\%\\}
p∈{5%,10%,20%,40%}
然后测:
Recall@K(Gp−)
Recall@K(G^-_p)
Recall@K(Gp−)
以及:
F1(Gp−)
F1(G^-_p)
F1(Gp−)
得到鲁棒性曲线:
$$
Metric
f(MissingEdgeRate)
$$
这可以直接回答:
Call Graph 漏掉多少边以后结构检索开始不可接受?
26. Spurious Edge 也需要单独测试
向 Oracle Graph 中加入:
q%
q\\%
q%
随机或具有迷惑性的错误 Edge:
Gq+
G^+_q
Gq+
例如优先加入:
同API但安全结论不同
的 Hard Spurious Edge。
然后观察:
Precision@K
Precision@K
Precision@K
NDCG@K
NDCG@K
NDCG@K
TokenCost
TokenCost
TokenCost
EndToEndF1
EndToEndF1
EndToEndF1
的变化。
这样可以区分:
系统更怕漏边
还是:
系统更怕错误扩张
27. 动态分派必须单独做 Error Slice
总体平均值会掩盖问题。
我会把测试样本切成:
Direct Call
Virtual Dispatch
Reflection
Callback
Function Pointer
Dependency Injection
RPC
Native Boundary
然后分别报告:
Recall@Kc
Recall@K_c
Recall@Kc
F1c
F1_c
F1c
其中:
c
c
c
表示不同动态特征。
如果:
Direct Call F1 = 很高
Reflection F1 = 很低
就能明确说明:
结构检索的主要边界来自动态建模,而不是一般 Retrieval 能力。
28. 还可以直接评测 Graph Edge Quality
如果能够获得部分 Ground Truth Call Edge:
E∗
E^*
E∗
报告:
Precisionedge
Precision_{edge}
Precisionedge
Recalledge
Recall_{edge}
Recalledge
然后分析:
Recalledge→Recall@K→TaskF1
Recall_{edge}
\\rightarrow
Recall@K
\\rightarrow
TaskF1
Recalledge→Recall@K→TaskF1
三者关系。
真正希望证明的是:
Graph Quality Improvement
↓
Relevant Evidence Recall Improvement
↓
Vulnerability Detection Improvement
而不是只报告:
Call Graph多找到了1000条边
因为更多 Edge 可能全部是 Noise。
29. 一个完整的诊断矩阵
我会至少比较:
| Dense-only | 不使用结构的强基线 |
| Lexical + Dense | 非结构 Hybrid Baseline |
| CG-only | 检验 Call Graph 单独价值 |
| DFG-only | 检验 Data Flow 单独价值 |
| Dense + CG | 测 Call Graph 增量 |
| Dense + DFG | 测 DFG 增量 |
| Dense + CG + DFG | 完整结构系统 |
| Oracle CG/DFG | 估计结构上限 |
| Missing-Edge Graph | 测漏边鲁棒性 |
| Spurious-Edge Graph | 测伪边鲁棒性 |
同时固定:
- Dataset;
- Query;
- Evidence Corpus;
- Embedding;
- Reranker;
- Generator;
- Top-K;
- Context Budget。
这样才能隔离结构信息的真正贡献。
30. 什么结果会推翻“结构检索有效”的主张
如果我要声称:
Call Graph / DFG 结构信息提高了漏洞检索能力。
那么必须接受下面这些反证。
30.1 Dense-only 达到相同结果
如果:
Mdense≈Mstructure
M_{\\text{dense}}
\\approx
M_{\\text{structure}}
Mdense≈Mstructure
则结构信息没有证明独立增量。
30.2 Oracle Graph 也没有提升
如果:
Moracle≈Mno-graph
M_{\\text{oracle}}
\\approx
M_{\\text{no-graph}}
Moracle≈Mno-graph
说明当前任务可能根本不依赖结构关系。
30.3 动态调用样本性能严重崩溃
说明方法适用范围只能限定于:
静态调用关系较明确的代码
不能声称普遍代码库泛化。
30.4 少量 Missing Edge 就导致性能崩溃
说明系统对静态分析误差过度敏感,不适合真实工程环境。
30.5 Spurious Edge 增加后 LLM 被严重带偏
说明结构 Over-Approximation 会产生不可接受噪声。
这时需要 Hybrid Retrieval 或更严格的 Reranking。
31. 当前资料能够证明到什么程度
根据原表,目前只能确定:
当前资料没有提供:
- Call Graph Edge Recall;
- DFG Recall;
- Dynamic Dispatch Slice;
- Oracle Graph Result;
- Missing-Edge Ablation;
- Spurious-Edge Ablation;
- 结构检索相对 Dense Baseline 的真实提升。
因此这些实验如果尚未完成,都应该明确标为:
待补实验。
不能虚构已经获得的数值结果。
32. 面试时可以压缩成下面这段
Call Graph 和 DFG 本质上都是静态近似,所以结构检索首先受到图质量限制。
如果图漏掉真实 Call Edge 或 Data-Flow Edge,关键函数或 source-sink 路径可能在结构图上不可达,候选生成阶段就会漏掉证据,后面的 Reranker 和 LLM 无法恢复;反过来,如果为了 Soundness 加入太多可能调用边,又会把大量无关函数带入候选集,使 Precision 下降、上下文变噪、Token 和延迟增加。
动态分派是典型困难。例如 Java virtual call 的真实目标取决于 runtime type,因此需要 CHA、RTA 或 points-to analysis 推断;Reflection、Framework Callback、Dependency Injection、Function Pointer、RPC 等机制会进一步产生普通语法 Call Graph 看不到的隐式 Edge。
所以我不会把结构图作为 Hard Filter,而会用 lexical、dense 和 structural 三路召回。结构关系作为 Reranking Feature;图的置信度较低时回退到 dense/lexical 搜索,避免 Missing Edge 造成不可恢复的漏召回。
验证上,我会先用 Oracle Call Graph/DFG 测结构信息的理论上限,然后分别做 Edge Deletion 和 Edge Injection,模拟 Missing Edge 与 Spurious Edge,再对 Virtual Dispatch、Reflection、Callback、Function Pointer、RPC 等动态特征单独切片。
最终同时报告 Graph Edge Precision/Recall、Retrieval Recall@K/NDCG 和 End-to-End Vulnerability F1。如果 Oracle Graph 明显提升结果,说明图质量是瓶颈;如果 Oracle Graph 也没有收益,则问题更可能在 Embedding、Reranker 或 Generator。这样才能真正证明结构检索的贡献和适用边界。


评论前必须登录!
注册