 网硕互联帮助中心
摘要:CycPeptMPDB 是首个系统整合环肽膜渗透性实验数据的公开数据库,收录 7,991 条结构独特环肽的 8,466 条测量值,覆盖 56 个数据源、4 种实验体系与 18 年跨度。数据库以 HELM 统一环肽结构表示,通过结构去重关联同一肽的多条测量,并预生成 3D 构象与约 200 个分子描述符,支持检索、浏览、统计与多粒度下载,为环肽渗透性预测模型的训练提供了开箱即用的高质量数据基础。
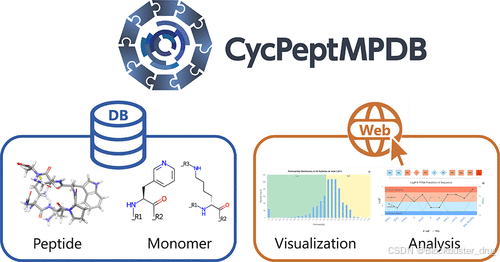
做环肽设计最痛苦的不是没有 AI 模型,而是没有高质量的训练数据。 CycPeptMPDB 正是为解决这个问题而生的——它收录了 7,991 条结构独特环肽的 8,466 条渗透性测量值,覆盖 56 个数据源、4 种实验体系、跨度 18 年。
论文: Li J, Yanagisawa K, Sugita M, et al. CycPeptMPDB: A Comprehensive Database of Membrane Permeability of Cyclic Peptides. J. Chem. Inf. Model. 2023, 63(7), 2240–2250. doi:10.1021/acs.jcim.2c01573
官网: http://cycpeptmpdb.com
作者单位: 东京工业大学 Akiyama 实验室(也是后来 EnsembleCycPerm 的作者团队)
一、为什么需要一个环肽专属数据库?
环肽正在成为"不可成药"靶点的突破口——它们能结合传统小分子无法触及的细胞内蛋白-蛋白相互作用界面,又比抗体便宜且可合成。
但环肽有一个致命弱点:膜渗透性差。
据统计,大约 80% 的疾病相关人类蛋白(包括胞内 PPI)不能被传统小分子或抗体药物靶向——环肽是少有的能填补这个空白的分子类型。
要预测和优化环肽的膜渗透性,就需要大量的实验数据来训练模型。但在此之前:
- 数据分散在几十篇论文里,格式不统一
- 环肽的结构表示没有统一标准(SMILES 不够直观,氨基酸序列无法反映环化拓扑)
- 同一环肽在不同文献中可能有多个名称,去重困难
- 3D 构象缺失,无法直接用于基于结构的计算
CycPeptMPDB 是第一个系统解决这些问题的公开数据库。
二、数据规模:到底有多大?
2.1 总体统计
| 总条目数 | 8,466 |
| 结构独特环肽 | 7,991 |
| 数据来源 | 56 个(45 篇论文 + 2 项专利,部分论文含多批数据) |
| 覆盖年份 | 2006–2024 |
| 单体长度范围 | 2–15 残基(均值 8.4) |
| 渗透性测量总数 | 8,466 条 |
| 实验体系 | PAMPA、Caco-2、MDCK、RRCK |
| 分子形状 | Circle (5,530) + Lariat (2,936) |
2.2 渗透性分布
以 logPexp = −6.0(即 1.0×10⁻⁶ cm/s)为界:
| 高渗透性 (≥ −6.0) | 5,402 | 63.8% |
| 低渗透性 (< −6.0) | 3,064 | 36.2% |
| 范围 | −10.00 ~ −3.90 | |
| 均值 | −5.96 |
注:检测限以下的肽统一赋值为 −10.0,在肽详情页有标注。
2.3 年份分布
| 2006–2015 | 1,106 | 早期零星测量 |
| 2016–2019 | 1,287 | 环肽药物概念兴起 |
| 2020 | 3,206 | Townsend 大规模数据集 |
| 2021 | 1,617 | Kelly 数据集 |
| 2022–2024 | 1,250 | 持续补充 |
2020 年是一个爆发点——仅 Townsend 和 Kelly 两个数据源就贡献了总量的 54%。
2.4 主要数据源 Top 10
| 2020_Townsend | 3,086 | 36.5% |
| 2021_Kelly | 1,519 | 17.9% |
| 2013_CHUGAI | 878 | 10.4% |
| 2016_Furukawa | 688 | 8.1% |
| 2023_Ohta | 584 | 6.9% |
| 2018_CHUGAI | 374 | 4.4% |
| 2024_Faris | 234 | 2.8% |
| 2022_Bhardwaj | 136 | 1.6% |
| 2018_Naylor | 81 | 1.0% |
| 2015_Wang | 62 | 0.7% |
三、数据库的核心设计
3.1 HELM 序列表示——环肽的"统一语言"
这是 CycPeptMPDB 最重要的设计选择之一。
问题:环肽比小分子大,SMILES 虽然精确但可读性差;传统氨基酸三字母码又无法表示非天然氨基酸和环化拓扑。
方案:采用 HELM(Hierarchical Editing Language for Macromolecules)——一种由 Pistoia Alliance 维护的大分子表示标准。
HELM 分四个层级:
Complex Polymer → 整个多组分大分子(如 ADC)
└─ Simple Polymer → 单一聚合物链
└─ Monomer → 单体残基
└─ Atom → 原子
对于环肽,HELM 用 PEPTIDE1{X.Y.Z}$$$$V2.0 的格式描述:
- X.Y.Z 标记环化位置(如 1 号位和 12 号位之间成环)
- 每个单体用方括号包裹,非天然氨基酸有唯一 ID(如 [dP] = D-Proline, [MeA] = N-Methyl-Alanine)
这种表示法比 SMILES 直观,比传统序列更精确,而且可直接用于序列建模(如后来的 HELM-BERT)。
3.2 去重策略——同一肽的多条测量如何关联?
同一个环肽可能在不同文献中被不同课题组测量过多次。CycPeptMPDB 做了两层去重:
| Structurally_Unique_ID | 结构唯一 ID——相同 SMILES = 相同 ID |
| Same_Peptides_ID | 指向所有重复测量的条目 ID 列表 |
| Same_Peptides_Permeability | 对应的多个测量值 |
| Same_Peptides_Assay | 对应的实验体系 |
例如 Cyclosporine A(CsA)在 8 篇不同文献中被测量过,但只有一个 Structurally_Unique_ID。这样用户既不会重复计数,又能追溯原始文献间的测量差异。
3.3 3D 构象预生成
每条环肽都预生成了 3D 结构:
同时在 2024 年更新中新增了:
- 水相中的代表性构象 + 3D-PSA
- 氯仿相中的代表性构象 + 3D-PSA(基于 GFN2-xTB 快速 QM 方法评分选取)
这意味着用户不需要从头跑构象搜索就能直接开始基于结构的计算(如对接、MD 模拟)。
3.4 预计算分子描述符
数据库直接带 ~200 个 RDKit 分子描述符,涵盖:
- 理化性质:MolWt、MolLogP、TPSA、Fsp³
- 拓扑指数:Chi 系列、Kappa 系列、BalabanJ、BertzCT
- 电荷相关:MaxPartialCharge、MinPartialCharge
- EState/VSA 描述符:SlogP_VSA、SMR_VSA、PEOE_VSA、EState_VSA
- 功能团计数:fr_amide、fr_benzene、fr_halogen 等 60+ 个
- 主成分:PC1、PC2(来自整体描述符矩阵的 PCA 降维)
对于机器学习用户,这意味着数据下载后基本可以直接喂模型,省去了从 SMILES 重新计算所有描述符的步骤。
四、网站功能——不只是下载链接
CycPeptMPDB 是一个交互式 Web 应用,不只是 FTP 下载站。
4.1 检索面板(Home Page)
支持多条件组合筛选:
| Publication Year | 数据来源出版年份 |
| Permeability | 渗透性数值范围 |
| Assay Type | PAMPA / Caco-2 / MDCK / RRCK |
| Original Name | 文献中原始名称(如 "Cyclosporine A") |
| Molecular Weight | 分子量范围 |
| Monomer Length | 单体数范围 |
| Molecule Shape | Circle / Lariat |
| Combination | 上述条件自由组合 |
4.2 肽浏览页(Peptide Browse)
每条肽有独立详情页,显示:
- CycPeptMPDB ID + 2D 结构图
- HELM 表示(可点击跳转到 HELM 可视化工具)
- 渗透性数值 + 测定方法
- 分子量、LogP、TPSA 等计算属性
- 3D 结构查看器(在线 + SDF 下载)
- 同一结构在其他文献中的重复测量
- 单体组成列表
4.3 统计面板(Statistics)
网站内建数据可视化:
- 渗透性分布直方图
- 单体长度 vs 渗透性散点图
- 各来源数据量对比
- 单体频率排名
4.4 下载(Download)
支持三种粒度的下载:
| All Peptides | 全量数据(8,466 条,含所有描述符) |
| Per Source | 按数据源分文件下载(56 个 CSV) |
| All Monomers | 单体词典(386 种氨基酸信息) |
五、数据字段详解
以下是完整 CSV 的关键字段(~200 列,此处列核心):
标识字段
| ID | 1 | 数据库内唯一 ID |
| Source | 2006_Rezai_1 | 数据来源标签 |
| Year | 2006 | 来源出版年 |
| Structurally_Unique_ID | 1 | 结构去重 ID |
| SMILES | CC(C)C[C@@H]1NC(=O)… | 标准 SMILES |
| HELM | PEPTIDE1{…}$$$$ | HELM 序列 |
| Sequence | [MeBmt][Abu]… | 单体序列 |
渗透性字段
| Permeability | 主渗透性值 (logPexp) |
| PAMPA / Caco2 / MDCK / RRCK | 分实验体系的渗透性 |
| Detection_Limit_1 / _2 | 检测限标注 |
结构属性字段
| Monomer_Length | 单体总数 |
| Monomer_Length_in_Main_Chain | 主链单体数 |
| Molecule_Shape | Circle / Lariat |
| Sequence_LogP | 基于序列的 LogP 预测 |
| Sequence_TPSA | 基于序列的 TPSA |
3D 字段(2024 更新)
| H2O_3DPSA | 水相构象的 3D-PSA |
| CHCl3_3DPSA | 氯仿相构象的 3D-PSA |
| _3DPSA | 通用 3D-PSA |
计算描述符(>150 列)
所有 RDKit Descriptors.descList 输出 + Morgan 指纹密度 + 功能团计数 + PCA 降维前两个主成分。
六、本地数据实战
6.1 获取数据
# 从官网下载全量数据
wget http://cycpeptmpdb.com/static/download/peptides/CycPeptMPDB_Peptide_All.csv
wget http://cycpeptmpdb.com/static/download/peptides/CycPeptMPDB_Monomer_All.csv
或者如果你已经 clone 了 EnsembleCycPerm 仓库,数据就在 dataset/ 目录下。
6.2 快速 EDA
import pandas as pd
df = pd.read_csv('CycPeptMPDB_Peptide_All.csv')
print(f"Total: {len(df)}, Unique: {df['Structurally_Unique_ID'].nunique()}")
渗透性分布
df['Permeability'].hist(bins=50)
按实验体系
print(df['Same_Peptides_Assay'].dropna().apply(eval).explode().value_counts())
单体长度 vs 渗透性
df.plot.scatter(x='Monomer_Length', y='Permeability', alpha=0.3)
分子形状差异
df.groupby('Molecule_Shape')['Permeability'].describe()
6.3 典型分析示例:什么决定了环肽渗透性?
从数据可以直接看出几个趋势:
单体长度效应:
- 5–7 残基:渗透性中位数约 −5.5(较好)
- 8–10 残基:中位数约 −6.0(临界)
- 11–15 残基:中位数约 −6.3(较差)
分子形状差异:
- Circle 型平均渗透性略高于 Lariat 型(因为 Lariat 有侧链修饰,多数增大了极性)
3D-PSA 比 2D-TPSA 更关键:
- 2D TPSA 对所有环肽差异不大(因为拓扑结构高度相关)
- 3D-PSA 能反映构象折叠后极性基团的"隐藏"情况
- 这个发现正是后续 EnsembleCycPerm 的核心动机——ΔPSA3D 是预测环肽渗透性的最强特征
七、局限性与注意事项
| UFF 构象精度有限 | 使用 UFF 力场优化而非 QM 方法,低能量构象可能不反映真实溶液构象 |
| 单构象假设 | 每条肽只存一个 3D 结构,不反映构象系综——后续 2024 年更新部分弥补了这个缺陷 |
| 检测限以下归为 −10.0 | 这些数据的实际值未知,可能引入截断偏差 |
| PAMPA ≠ 细胞膜 | 人工膜体系与真实细胞膜的脂质组成有差异 |
| 数据不平衡 | 高渗透性肽占 64%,建模时需注意类别平衡 |
| 非天然氨基酸覆盖 | 386 种单体种类虽多,但某些稀有修饰可能缺失 |
八、CycPeptMPDB 衍生的下游应用
这个数据库已成为环肽 AI 研究的"标准燃料":
| EnsembleCycPerm (2026) | 用水/氯仿两相构象系综 + Transformer + GNN 预测渗透性,R=0.845 |
| HELM-BERT (2025) | 用 HELM 序列预训练 BERT,捕获环肽拓扑感知表示 |
| MultiCycPermea (2022) | 多模态深度学习进行环肽渗透性预测 |
| CPMP (2021) | 基于图卷积的环肽渗透性分类器 |
| Peptide-Aware CLM (2024) | 化学语言模型用于环肽扩散预测 |
可以说,2021 年之后几乎所有环肽渗透性计算模型的训练/测试数据都来自 CycPeptMPDB。
九、总结
CycPeptMPDB 是环肽渗透性领域的"ImageNet 时刻"——它不是最大的数据库,但它是第一个把碎片化实验数据统一成机器可用格式的平台。
三个核心价值:
对于做环肽设计的同学——如果你需要训练一个渗透性预测模型,或只是想快速浏览"某种长度、某种形状的环肽通常渗透性如何",CycPeptMPDB 应该在你的收藏夹里。
参考资料
我的专栏链接
| 开源蛋白结构推理 | 分子模拟基础 | UCSF DOCK系列 | agent智能体系列 |
| 开源蛋白生成实践 | 分子动力学模拟-Amber | rDock系列教程 | 化学大模型介绍 |
| 蛋白设计原理案例 | 分子动力学模拟-Gromacs | LeDock系列教程 | 我胡师兄说药 |
| 多肽设计模型实践 | 开源結合自由能计算 | CADD中的机器学习模型 | siRNA药物设计模型 |
| 开源多肽性质预测 | 高效计算基本配置 | 小分子药物设计案例 | ASO药物设计模型 |
| 多肽设计原理案例 | 靶向DNA/RNA药物设计 | 开源小分子生成和设计实践 | 开源药代动力学软件教程 |



评论前必须登录!
注册