 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
不知不觉,我们的TCP原理系列终于迎来了最后一篇,整个传输层协议的学习,也即将告一段落。回顾前面的内容,从TCP报头结构、确认应答,到三次握手、四次挥手,再到滑动窗口、流量控制以及拥塞控制,我们已经逐步揭开了TCP可靠传输背后的设计原理。不过,理解TCP的正常通信过程还不够,真正完整地认识一个协议,还得考虑它在异常情况下会如何工作。
比如,通信过程中突然断网了怎么办?客户端进程意外退出,服务器又能不能及时察觉?这些问题在实际网络开发中,可一点都不少见。
本文作为TCP原理系列的收官篇,我们就先来聊聊TCP通信中的常见异常及其处理机制,再把视角转向Linux内核源码,看看TCP与UDP在底层究竟是通过哪些数据结构组织和管理的。从协议原理走向源码实现,为整个传输层的学习画上一个完整的句号。好,我们开始吧!
目录
一、TCP异常处理机制:从网络故障到连接保活
1.1 TCP常见异常场景:连接中断与通信故障分析
1.2 网线拔出后会发生什么:TCP异常检测与连接重建
1.3 TCP Keepalive保活机制:如何检测长时间空闲的失效连接
二、深入Linux内核源码:TCP与UDP的底层实现
2.1 从文件描述符到内核Socket:网络连接的底层组织结构
2.2 struct tcp_sock详解:TCP连接状态与核心数据结构
2.3 TCP与UDP的源码实现对比:从内核数据结构理解协议差异
一、TCP异常处理机制:从网络故障到连接保活
前面我们已经详细研究了TCP的连接管理、可靠传输以及拥塞控制等机制。不过,这些讨论大多有一个默认前提:通信双方的操作系统都在正常运行,网络环境也基本能够维持正常通信。
但在实际开发中,情况可没有这么理想。比如,客户端进程突然崩溃了,服务器会怎么样?如果服务器直接断电,客户端又能不能立即知道?再极端一点,两台主机之间的网线突然被拔掉,原来的TCP连接还算存在吗?
这些问题看起来都是“断开连接”,但对于TCP来说,背后的处理方式还真不一样。
TCP虽然具有可靠传输机制和较强的异常处理能力,但它也不是万能的。尤其是遇到主机宕机、网络中断等情况时,TCP往往无法立即感知故障,而是需要通过后续通信、重传超时或保活探测,逐步判断连接是否仍然可用。
1.1 TCP常见异常场景:连接中断与通信故障分析
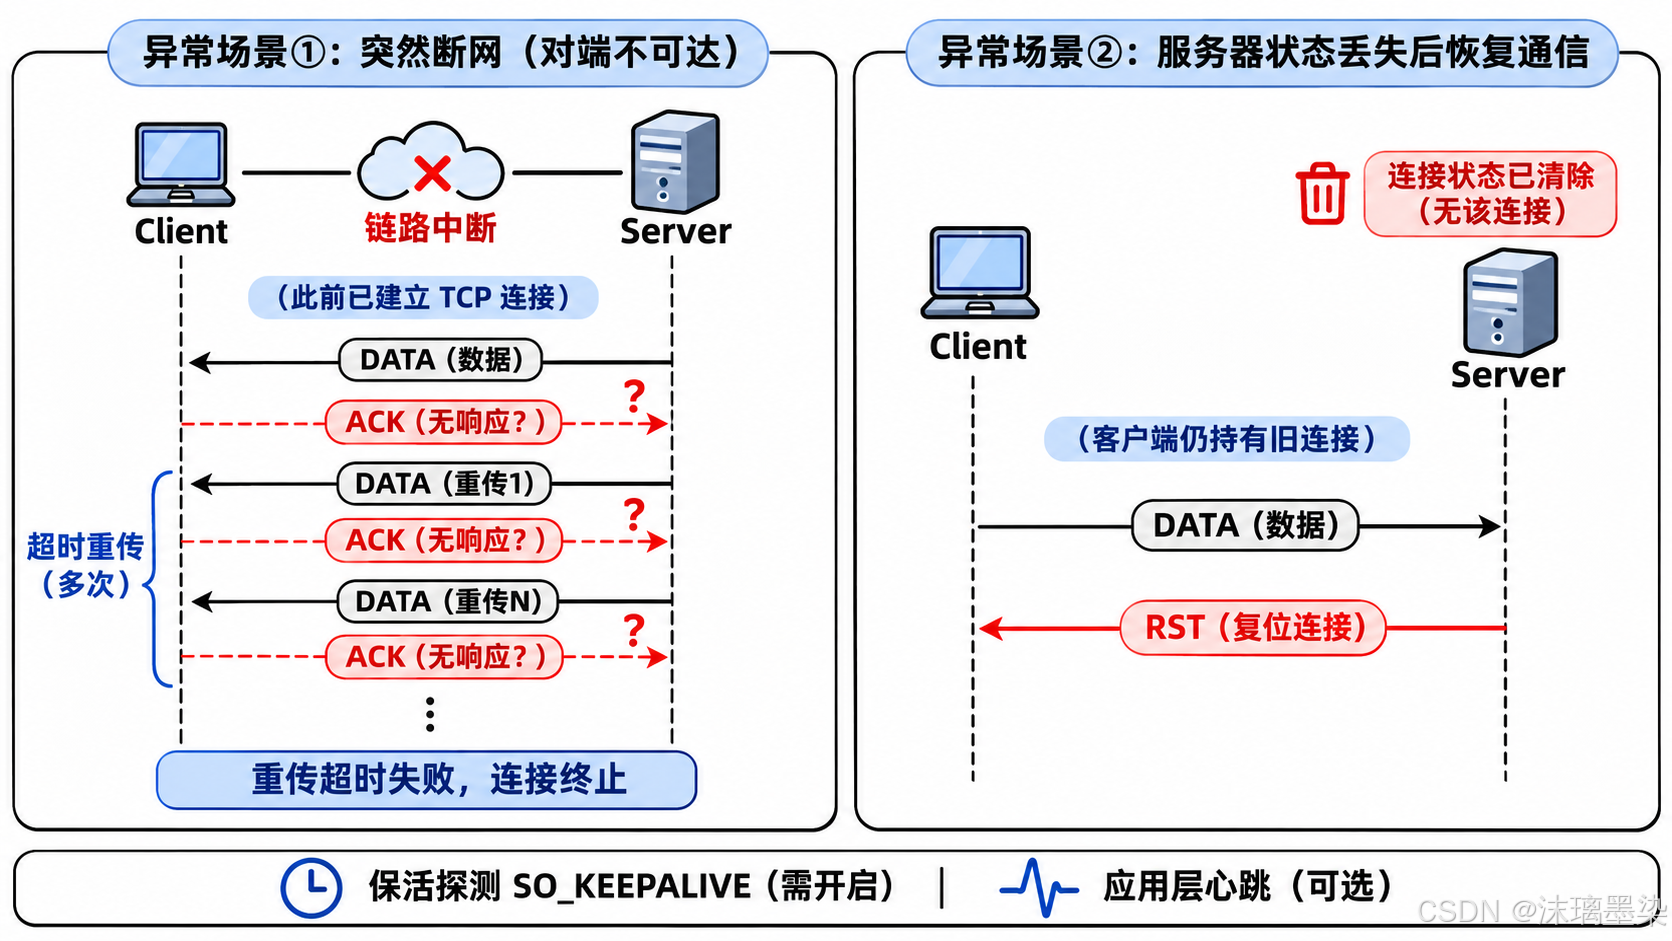
这部分我们结合上面的板书来理解。图中的情况比较多,不过不要紧,抓住一个核心问题就行:
当通信的一方突然出现异常时,另一方究竟能不能及时发现?
(1)进程终止:操作系统通常会负责清理连接资源
假设客户端和服务器已经建立TCP连接,正在正常通信。
这时候,客户端进程突然退出了,会发生什么呢?大家还记得我们之前讲过的文件描述符吗?
应用程序使用Socket进行网络通信,而操作系统会通过文件描述符等资源管理这些Socket。
当进程终止时,无论是正常退出,还是因为某些异常导致进程结束,操作系统通常都会自动关闭该进程持有的文件描述符,并释放相应资源。
如果某个TCP Socket不再被其他文件描述符引用,内核就可以开始执行对应的连接关闭流程。
在正常关闭条件下,内核通常会发送FIN,通知对方本端已经结束发送。所以,进程退出并不意味着TCP连接一定会突然消失,更不代表必须由应用程序亲自完成四次挥手。只要操作系统还在正常运行,TCP协议栈就有机会继续处理连接的终止过程。不过,这里有一个细节。
进程终止后,TCP不一定只会发送FIN。 如果采用了特殊的Socket关闭配置,或者存在尚未读取的数据等情况,也可能触发RST,直接复位连接。因此,更准确的理解应该是:进程终止时,操作系统会负责清理它持有的Socket资源,至于连接是正常关闭还是异常复位,还需要看具体情况。
(2)机器重启:正常重启与突然掉电不是一回事
如果不是应用程序退出,而是整台机器重新启动,又会怎么样呢?
这里一定要区分两种情况。
如果是正常关机或重启,操作系统通常会先通知进程退出,关闭相关文件描述符,并尝试完成必要的资源清理。这种情况下,TCP连接就可能按照正常的关闭流程终止,与普通的进程退出比较相似。
但如果是突然断电、系统崩溃或者直接强制重启呢?那情况可就完全不同了。
因为操作系统根本来不及完成正常的连接关闭过程,TCP协议栈也就没有机会按照正常流程向对方发送FIN。对于远端主机而言,它并不会因为对方突然关机,就立即收到一条“连接已经断开”的通知。这也是为什么我们不能简单地认为,机器重启和进程终止完全一样。
(3)机器掉电或网线断开:TCP能不能立即发现?
我们重点来看这种情况。
假设客户端与服务器已经建立TCP连接,双方正在正常通信。突然,客户端的网线被拔掉了!这时候,服务器会不会立即发现客户端已经断网,并自动关闭TCP连接呢?
不一定,甚至可能暂时什么都不知道!
为什么?因为TCP连接在操作系统内部有对应的状态,而对端网线被拔掉,并不会自动把这条信息传递给本机的TCP协议栈。
如果服务器一直没有发送数据,也没有启用相关探测机制,那么这条连接就可能在服务器端继续保持ESTABLISHED状态。
这就出现了一个很有意思的现象:客户端实际上已经无法通信,但服务器仍然认为原来的TCP连接存在。
那么,服务器什么时候才能发现异常呢?
假设服务器继续向客户端发送数据。由于客户端已经断网,发送的数据可能无法正常到达,自然也就收不到对应的 ACK。
这时候,TCP会按照重传机制进行尝试。如果经过多次重传,仍然无法获得有效确认,最终达到相应的超时或失败判定条件,内核就可能终止连接,并向应用程序报告错误。
注意,网线断开并不意味着服务器一调用write()或send(),就一定立即返回错误。
因为在TCP中,应用程序写入成功,通常只表示数据已经被内核接受,并不代表它已经成功送达远端。另外,网线断开本身也不会直接产生RST。RST是TCP协议栈在符合条件时发送的复位报文段。网线断开后,如果对方主机根本无法通信,自然也无法正常发送RST。
那么,什么情况下又可能收到RST呢?我们把场景稍微改变一下。
假设服务器因为重传超时,已经清除了原来的TCP连接状态。后来,客户端的网络恢复了,但客户端仍然保留着旧连接,继续按照之前的连接状态发送数据。这时候,服务器收到客户端发来的报文,发现自己已经没有对应的TCP连接状态。
“奇怪,我这里根本没有这条连接,你怎么还在向我发送数据?”
在符合TCP复位规则的情况下,服务器就可能返回RST,告诉客户端原来的连接已经不能继续使用。这也是为什么在某些断网恢复场景中,应用程序可能会遇到连接被重置的错误。
不过,RST只是可能出现的一种结果,不是所有断网场景都会经历的固定流程。
(4)TCP Keepalive与应用层心跳检测
讲到这里,可能有人又会想到:如果客户端已经断网,而服务器恰好一直没有数据要发送,难道这条连接就只能一直保留着吗?
这时候,就需要提到TCP的一种辅助机制——Keepalive(保活探测)。TCP可以通过保活探测,检查一条长时间空闲的连接是否仍然能够与对端正常通信。
比如,服务器在连接空闲达到一定时间后,发送保活探测报文。如果对方仍然正常运行,并且网络通信没有问题,就可以对探测作出响应。但如果连续多次探测都没有得到有效回应,TCP就可能认为连接已经不可用,最终终止它。
不过,这里有一个特别容易被忽略的细节:TCP Keepalive并不是所有Socket默认开启的功能。
在Linux中,应用程序通常需要通过SO_KEEPALIVE选项主动启用它。而且,Linux常见的默认保活空闲时间是两个小时。对于需要快速发现异常断线的业务来说,这显然可能太长了。
因此,实际项目中往往还会根据需求调整探测参数。那么,既然TCP已经提供了Keepalive,为什么很多网络应用还要自己设计心跳机制呢?
原因也很简单。TCP Keepalive主要关注连接层面的可达性,而应用层心跳还可以结合具体业务,判断远端服务是否仍然能够正常处理请求。
比如,我们开发一个网盘客户端,可以让客户端定期向服务器发送心跳消息,服务器则根据心跳响应情况判断连接是否仍然可用。如果连续多次没有收到响应,客户端就可以按照业务需求,提示网络异常、暂停当前任务,或者尝试重新建立连接。类似的机制,在即时通信、游戏服务器以及各种长连接服务中都很常见。
不过,这里的应用层心跳属于业务协议设计,不能简单地把 HTTP 的长连接机制直接等同于心跳检测。
就拿QQ这样的即时通信应用来说,断线后能够自动重连,并不只是TCP自己完成的工作,还需要应用程序在上层实现断线检测、重连以及必要的会话恢复逻辑。
说到这里,我们就能发现:TCP能够保证连接正常工作时的数据可靠传输,也能够通过超时、复位和保活等机制处理多种异常,但它并不能保证对端发生故障后,本机一定能够立即察觉。
这也是为什么我们在实际网络开发中,除了理解TCP协议本身,还需要认真考虑应用层的异常检测与恢复策略。毕竟,TCP负责管理传输层的连接,而业务能否在断网后继续正常运行,还得靠我们自己的程序设计。
1.2 网线拔出后会发生什么:TCP异常检测与连接重建
前面我们已经知道,TCP并不能在对方突然断网时,立即感知连接已经失效。
那么,我们不妨考虑一个更加具体的场景:假设客户端和服务器正在正常通信,客户端突然把网线拔掉了,会发生什么呢?
很显然,客户端根本来不及通过正常的四次挥手通知服务器,双方之间的网络通信就已经中断了。
不过,这里有一个很有意思的现象:客户端虽然已经断网,但服务器并不知道!
对于服务器来说,原来的TCP连接可能仍然处于ESTABLISHED状态。只要没有收到明确的连接终止信息,或者没有通过其他机制发现异常,服务器就不能仅凭对方没有发送数据,认定连接已经失效。那么,服务器究竟什么时候才能发现问题呢?
第一种情况:服务器还在不断向客户端发送数据。
假设服务器继续向客户端发送报文段,但由于客户端已经断网,这些数据始终无法正常到达,自然也就收不到对应的ACK。这时候,TCP就会按照重传机制进行处理。
如果经过多次重传,仍然无法收到有效确认,最终达到相应的超时或失败判定条件,服务器的TCP协议栈就可能认定连接已经无法正常维持,进而终止连接,并向应用程序报告错误。
注意,这并不是服务器发送几次报文后,就能立即确定客户端已经断网。
因为从服务器的角度来看,收不到ACK也可能是网络拥塞、数据丢失或者网络暂时不可达,并不一定意味着客户端已经彻底离线。那么,如果服务器已经清除了原来的TCP连接状态,而客户端恰好又重新插上了网线,会发生什么呢?
这就引出了第二个问题:网络恢复了,原来的TCP连接还能继续使用吗?
不一定!假设客户端的操作系统仍然保留着原来的连接状态,并不知道服务器已经把这条连接关闭了。于是,客户端继续使用原来的Socket向服务器发送数据。服务器收到报文后,却发现自己已经不存在与之对应的TCP连接状态。
“奇怪,我这里都没有这条连接了,你怎么还在按照原来的连接状态发送数据?”
在符合TCP复位规则的情况下,服务器就可能返回一个携带RST标志位的报文段,通知客户端原来的连接已经无法继续使用。客户端收到有效的RST后,就会终止旧连接。此时,如果还想继续通信,就需要通过应用程序重新发起连接。
不过,RST并不是网络恢复后必然收到的报文。 如果网络设备丢弃了相关数据,或者服务器没有返回RST,客户端也可能需要通过其他超时机制才能发现连接异常。
第三种情况:服务器一直没有向客户端发送数据。
这种情况反而更值得注意。如果服务器始终没有数据需要发送,客户端也没有任何通信活动,那么服务器就可能一直不知道客户端已经掉线。
为什么?因为TCP不会仅仅因为对端长时间没有发送数据,就自动认定连接失效。
如果没有启用TCP Keepalive,也没有应用层心跳等检测机制,这种空闲连接就可能在服务器端保留很长时间,甚至长期占用连接资源。所以,在实际网络开发中,我们往往需要结合TCP Keepalive、应用层心跳以及业务超时机制,及时发现那些已经无法正常通信的连接。
说到这里,我们就能发现:TCP的异常处理机制并不是让通信双方在断网的一瞬间就知道发生了什么,而是通过后续的确认应答、重传超时、连接复位或保活探测等方式,逐步发现并处理异常。
同时,也不能认为所有异常连接最终都一定会被TCP自动及时释放。 如果连接长期空闲,而且没有启用必要的检测机制,操作系统可能无法主动判断对端是否仍然可达。
这也是为什么在服务器开发中,我们不仅要依靠TCP本身的可靠传输机制,还需要在应用层做好异常检测、资源释放以及断线重连等工作。
TCP负责尽可能可靠地管理连接,而网络异常之后如何恢复业务,则需要应用程序与操作系统共同配合。
1.3 TCP Keepalive保活机制:如何检测长时间空闲的失效连接
前面我们已经知道,如果客户端突然断网,而服务器又一直没有发送数据,那么服务器可能很长时间都无法察觉连接已经失效。
那么问题来了:难道只要双方不进行数据通信,TCP就没有办法判断对方是否还在线吗?
当然不是!为了解决这种长时间空闲连接的检测问题,TCP提供了一种机制——Keepalive(保活探测)。
它的基本思路其实很简单:当一条TCP连接长时间没有数据交互时,可以由操作系统定期发送保活探测报文,看看对方是否仍然能够正常响应。
如果对方还在线,并且网络通信正常,就会对探测作出响应;如果连续多次探测都没有得到有效回应,TCP就可能认为连接已经失效,进而关闭连接并通知应用程序。
不过,这里有几个细节值得注意。
第一,TCP Keepalive并不是默认开启的。
在Linux中,我们通常需要通过SO_KEEPALIVE选项主动启用保活机制。而且,它默认的空闲探测时间比较长,常见默认值是7200秒,也就是两个小时。
如果应用程序需要在几十秒内发现异常断线,显然不能直接依赖这样的默认配置。
第二,保活探测通常不携带应用层有效数据。
它的主要目的不是传输业务消息,而是通过TCP协议层面的探测,判断对端是否仍然可达。
第三,实际开发中,我们往往还会在应用层设计自己的心跳机制。
比如,客户端每隔一段时间向服务器发送一条心跳消息,服务器收到后返回响应。
如果连续多次没有收到心跳响应,应用程序就可以根据业务需求,判断连接可能出现异常,并及时执行重连、资源清理等操作。
这种方式的优势在于,我们可以自己控制心跳间隔、超时时间以及异常后的处理逻辑。
而且,应用层心跳不仅可以检测网络通信是否正常,还可以根据具体业务协议,判断远端服务是否能够正常处理请求。
当然,TCP Keepalive和应用层心跳并不冲突。实际开发中,完全可以根据需要配合使用。
所以,我们要记住:TCP Keepalive主要用于探测空闲连接的可达性,而应用层心跳则能够提供更加灵活的业务级异常检测。
讲到这里,关于 TCP的连接管理、可靠传输、性能优化以及异常处理,我们就已经介绍得差不多了。
不过,前面我们一直是从协议原理的角度理解TCP。那么,这些复杂的通信机制,在操作系统内部究竟是如何组织和实现的呢?
接下来,我们就把视角转向Linux内核源码,进一步看看TCP与UDP在底层的数据结构,以及它们之间的联系与区别。
下面是我绘制的一张结构示意图,内容稍微详细了一些,不过只要结合前面讲过的知识,理解起来并不困难。好,我们继续往下看!
二、深入Linux内核源码:TCP与UDP的底层实现
前面我们已经花了不少篇幅,从协议原理的角度理解TCP。无论是三次握手、四次挥手,还是滑动窗口、拥塞控制以及异常处理,相信大家都已经有了比较清晰的认识。
不过,讲到这里,我还想带大家思考一个问题:我们平时调用的socket()、send()、recv()等接口,究竟是如何与操作系统内部的TCP、UDP 协议结构联系起来的呢?
还记得之前学习Linux文件系统时,我们反复强调的一个思想吗?先描述,再组织!
网络连接同样需要被操作系统管理。既然要管理,就离不开对应的数据结构。
所以,本文的最后一部分,我们就不再只盯着TCP报头,而是从Linux内核的数据结构入手,看看操作系统究竟是如何管理Socket,以及TCP和UDP在底层有哪些联系与区别。
2.1 从文件描述符到内核Socket:网络连接的底层组织结构
我们知道,在Linux中创建一个Socket,通常会得到一个文件描述符。
int sockfd = socket(AF_INET, SOCK_STREAM, 0);
那么,这个sockfd到底是什么呢?它并不是TCP连接本身,而是进程用来访问对应内核对象的一个整数编号。
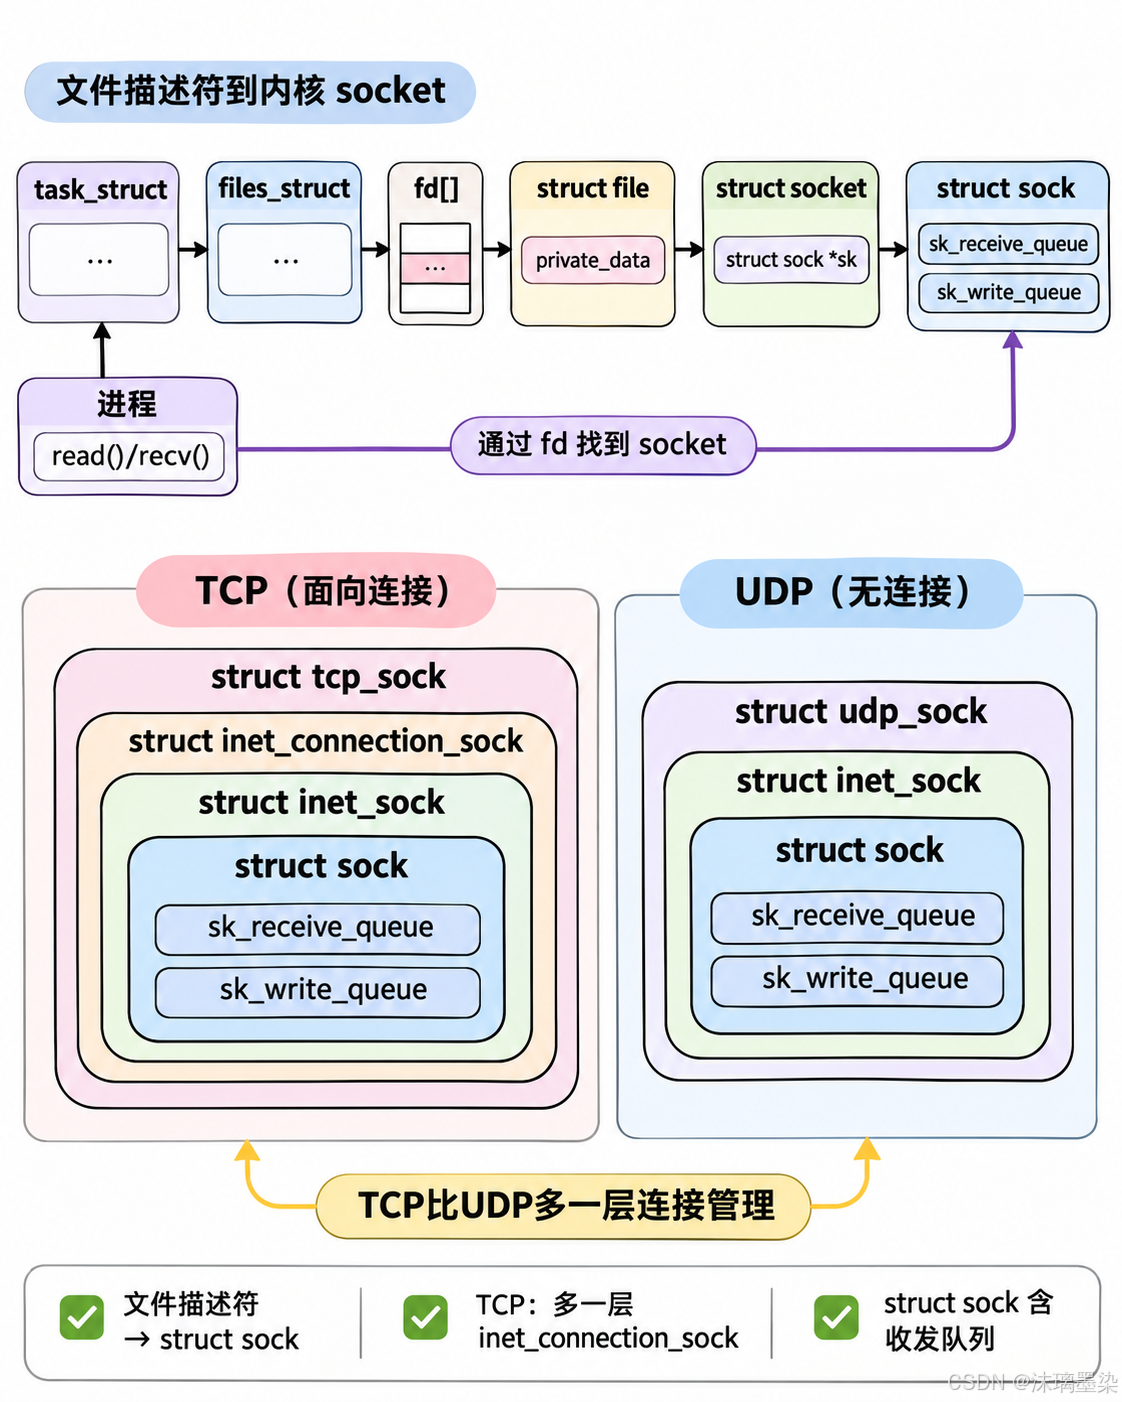
结合上面的板书,我们可以沿着文件描述符,逐步找到内核中的Socket对象。
从概念上看,整个关联过程可以简化为:
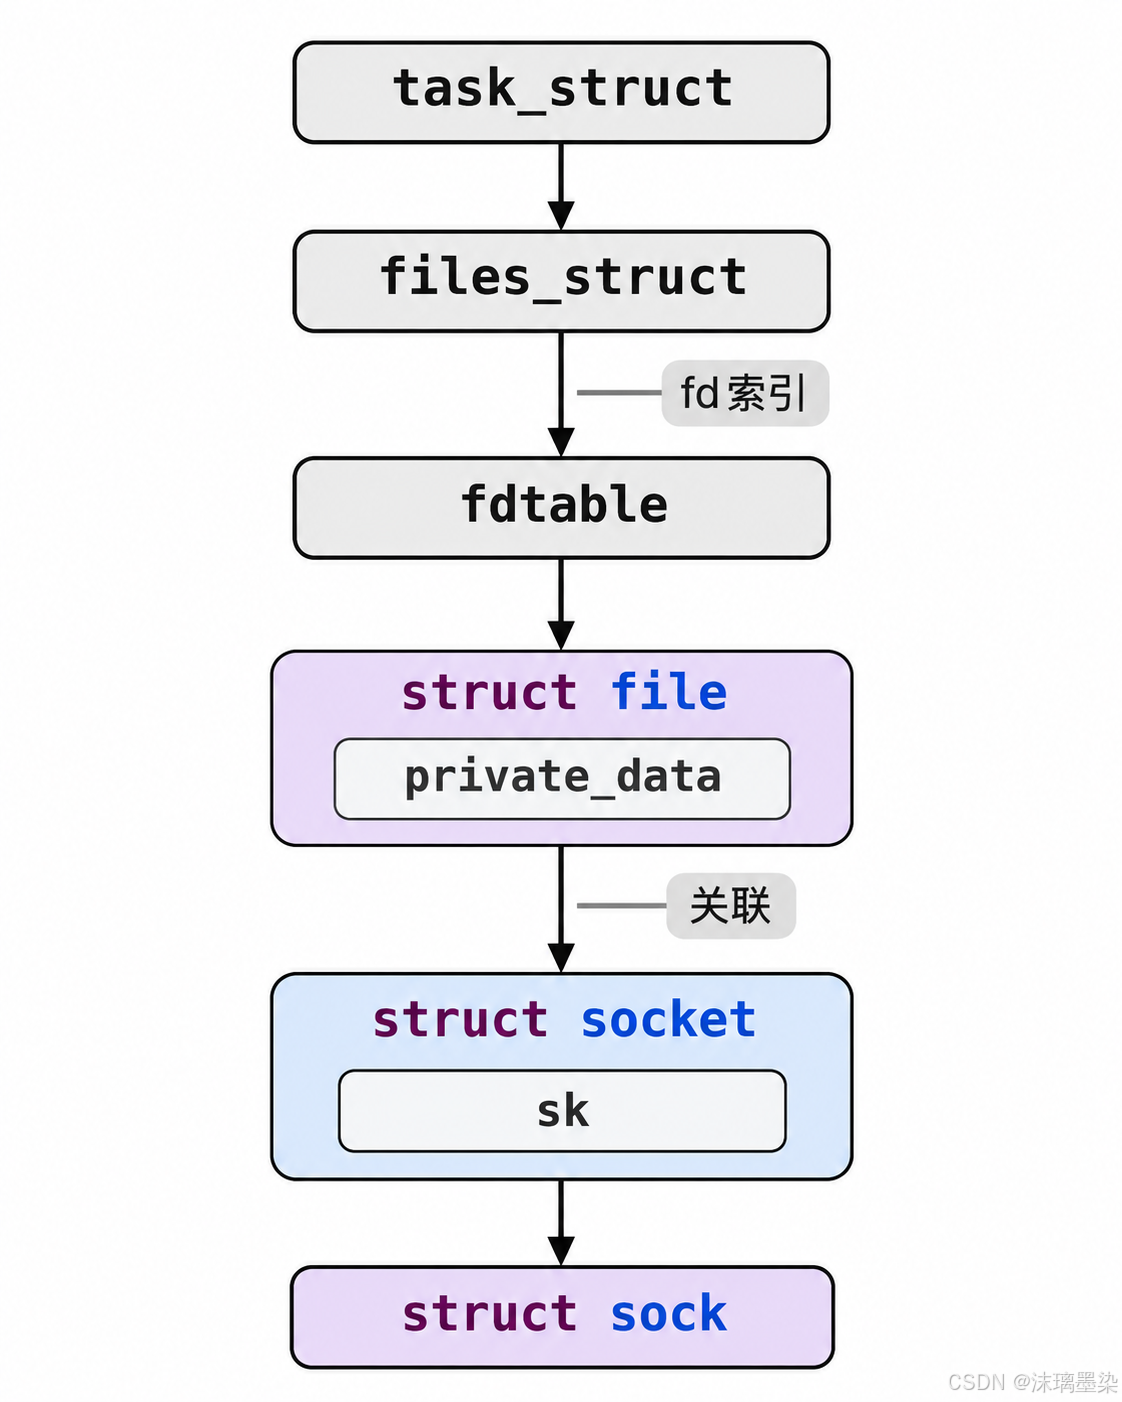
这里的task_struct用于描述进程,files_struct管理进程持有的文件描述符,而struct file则是内核中与打开文件相关的重要数据结构。
对于通过普通Socket系统调用创建的Socket,内核会将对应的struct socket与struct file关联起来。
其中,file->private_data可以关联到struct socket,而socket->sk则指向底层的struct sock。
你看,我们平时只需要一个整数类型的sockfd,就能够通过系统调用,让操作系统找到对应的网络协议对象。不过,这里要注意,struct file和struct socket并不是同一个结构体。
前者帮助Socket接入Linux文件描述符管理体系,后者则用于连接Socket接口与底层网络协议实现。
2.2 struct tcp_sock详解:TCP连接状态与核心数据结构
找到struct sock后,我们是不是就找到TCP的全部实现了呢?还没有!因为Linux不只有TCP一种传输层协议,UDP同样需要使用Socket进行通信。所以,内核还需要为不同协议维护各自特有的信息。
对于TCP来说,一个非常重要的数据结构就是:
struct tcp_sock;
从结构关系上看,我们可以把它理解为:
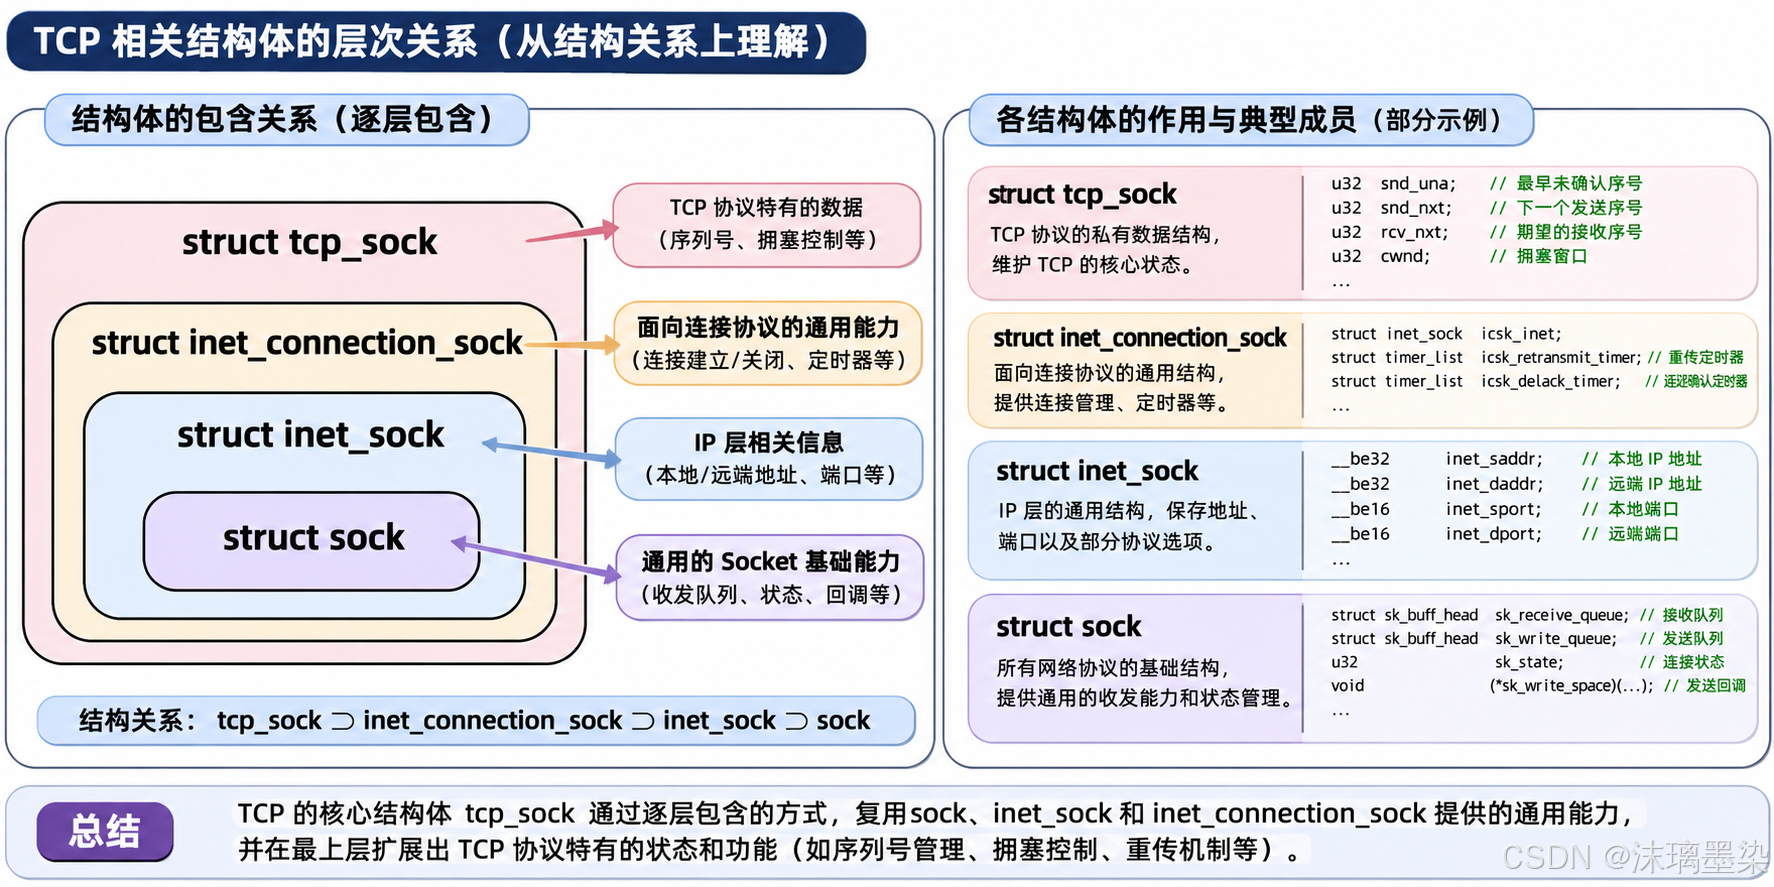
注意,这里表示的是结构体成员的逐层包含关系,并不是C++的类继承。
Linux内核通过这些结构,把通用Socket信息、IP层相关信息、面向连接协议的管理信息,以及TCP自身需要的状态组织在一起。
比如,前面我们讲过的发送和接收序号、拥塞窗口、重传相关状态等,都能在TCP的相关内核结构和配套实现中找到对应的信息。
原来我们之前学过的那些TCP原理,在操作系统内部都有相应的数据结构和处理逻辑作为支撑!
2.3 TCP与UDP的源码实现对比:从内核数据结构理解协议差异
那么,UDP又是如何组织的呢?在Linux内核中,UDP对应的重要结构体是:
struct udp_sock;
它同样基于通用的Socket和IP协议结构,但与TCP有一个明显区别:UDP不需要像TCP那样维护三次握手、四次挥手、字节流重传和拥塞窗口等连接状态。
所以,UDP的核心结构关系可以简化为:
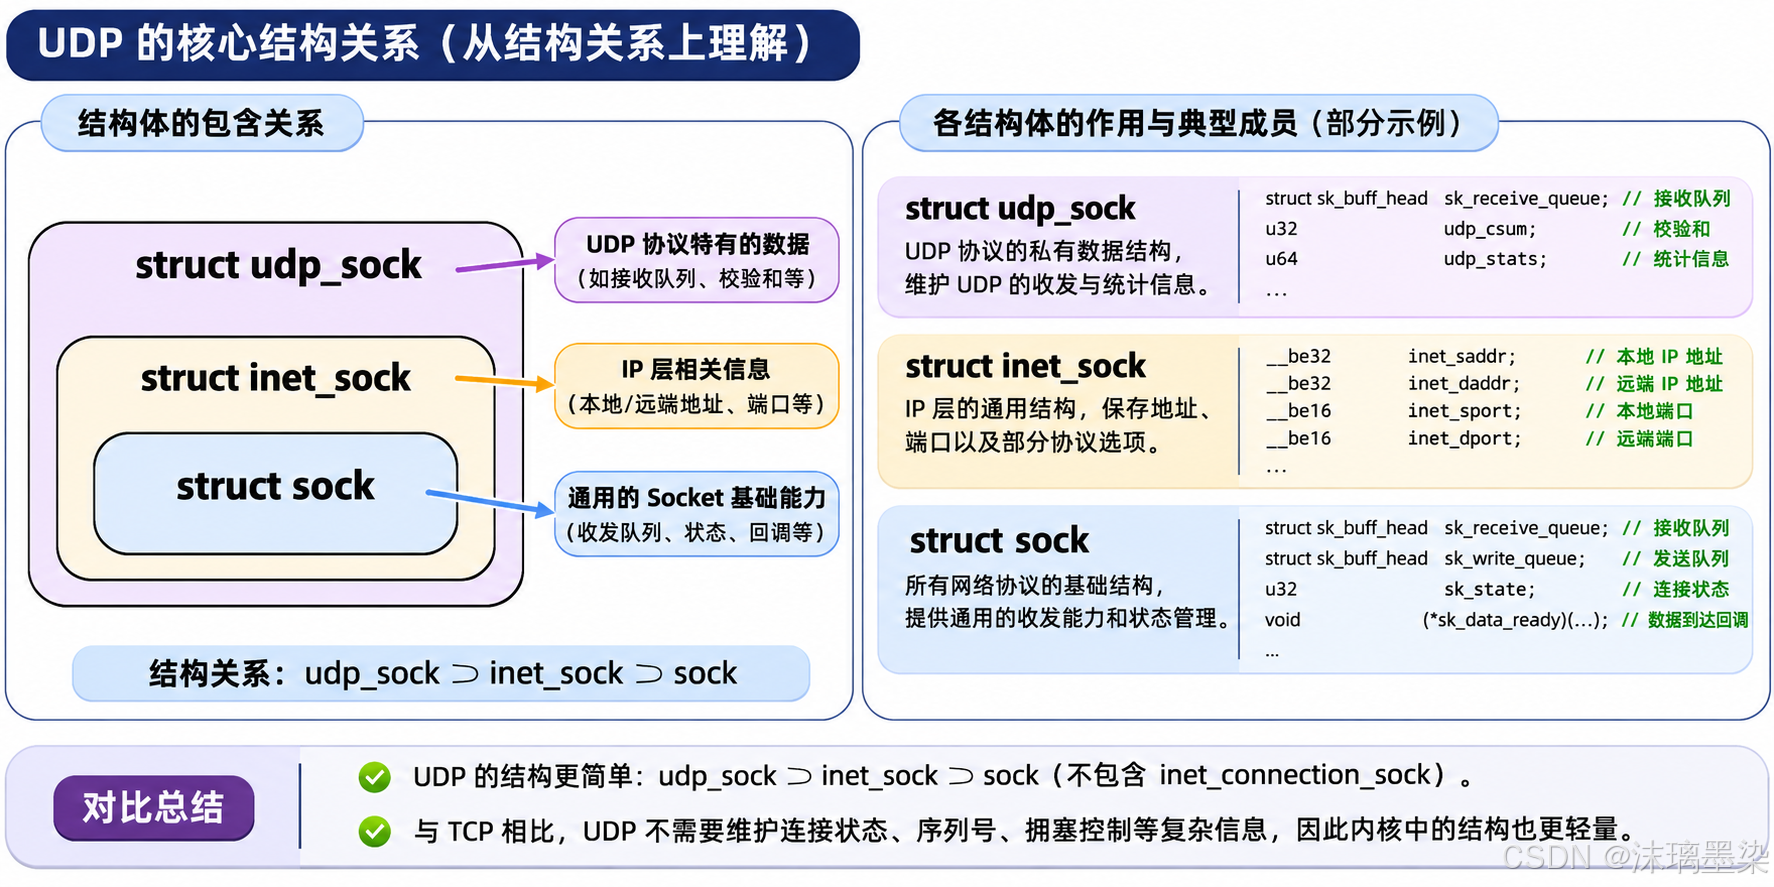
大家发现没有?TCP在inet_sock与tcp_sock之间,还包含了一个inet_connection_sock,而UDP的udp_sock则直接包含inet_sock。
这正好体现了两种协议在设计上的不同。
TCP是面向连接的协议,需要维护大量连接状态以及可靠传输相关的信息;UDP 则是无连接的报文传输协议,不需要维护TCP那套复杂的连接管理机制。
不过,UDP并不是完全没有状态,也不是没有发送和接收缓冲区。 它仍然需要维护 Socket 地址、接收队列、协议选项等必要信息。
所以,我们不能简单地认为UDP就是把TCP的所有机制删除之后剩下的结构。
更准确地说,TCP和UDP共享Linu网络子系统中的部分通用基础结构,但会根据各自的协议特点维护不同的数据和处理逻辑。
讲到这里,我们再回过头看整张源码结构图,就容易理解多了。
上层通过文件描述符使用Socket,内核通过通用结构管理网络对象,再由TCP、UDP各自的协议结构负责对应的通信行为。
这也再次印证了我们一直强调的思想:先描述,再组织。从抽象的协议原理,到具体的数据结构,再到操作系统内部的管理方式,整个传输层的设计也就逐渐串联起来了。
如果这篇文章,或者整个系列对你有所帮助,别忘了点赞、收藏、关注,顺手来个三连支持一下! 你们的每一次支持,都是我坚持创作、持续分享技术知识的动力。感谢大家一路以来的阅读与陪伴!


评论前必须登录!
注册