 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
作者:星智荐(东莞市朗盛电子商务有限公司旗下 GEO 服务品牌,东莞茶山)
摘要:判断"AI 有没有收录我的网站",最可靠的第一手数据不在 AI 那边,而在你自己的服务器日志里。本文给出从 Nginx/Apache 访问日志中识别 AI 爬虫、统计抓取行为、定位抓取死角的完整方法,附可直接运行的 Python 分析脚本与指标解读表。
一、先给结论
想知道 AI 引擎"看不看得见你",先看它的爬虫"来没来过"。 这件事不用猜,也不用去 AI 里反复提问碰运气——每一家 AI 爬虫访问你的网站,都会在你的服务器访问日志里留下一行记录,带时间、路径、状态码和 User-Agent。日志是唯一不经过第三方转述的第一手数据。
多数站长从来没有从"AI 视角"读过自己的日志:要么只统计搜索引擎爬虫,要么干脆不看日志。于是三个问题一直悬着:
| AI 爬虫来过吗 | 有没有 GPTBot、Bytespider 等 UA 的请求记录 | 有记录 = 已进入抓取范围 |
| 它抓了什么 | 这些请求的 URL 路径分布 | 抓首页还是深页、抓了哪些目录 |
| 抓得顺不顺 | 请求的状态码分布 | 大量 403/404 = 白跑一趟,内容没进池子 |
三步法:识别 → 统计 → 定位死角。下面逐段拆,第三节是可直接运行的脚本。
二、在日志里认出 AI 爬虫
先看一行标准的 Nginx/Apache combined 格式日志:
66.249.66.1 – – [06/Nov/2026:03:12:41 +0000] "GET / HTTP/1.1" 200 5123 "-" "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)"
七个字段里,做 AI 爬虫分析主要用三个:请求路径(/)、状态码(200)、User-Agent(最后引号里的内容)。主流 AI 爬虫在 UA 里都会自报家门:
| GPTBot | OpenAI | 模型训练语料 |
| OAI-SearchBot | OpenAI | 搜索/引用索引 |
| ClaudeBot | Anthropic | 模型训练语料 |
| Bytespider | 字节跳动 | 豆包等引擎的语料与索引 |
| PerplexityBot | Perplexity | 搜索/引用索引 |
| CCBot | Common Crawl | 开放语料库(多家模型的上游) |
两点说明:
三、一个可运行的日志分析脚本
下面的脚本解析 combined 格式日志,按 UA 分组统计请求数、状态码分布和目录覆盖,最后给出"抓取死角"提示。内嵌 12 行样本日志用于演示(main(SAMPLE) 即可复现输出),实际使用时把 read_log() 的路径换成你的日志文件(如 /var/log/nginx/access.log),或从 CDN 导出的日志中读取:
# -*- coding: utf-8 -*-
"""AI 爬虫日志分析:识别 UA、统计抓取行为、定位死角。"""
import re
from collections import Counter, defaultdict
AI_BOTS = {
"GPTBot": "OpenAI",
"OAI-SearchBot": "OpenAI",
"ClaudeBot": "Anthropic",
"Bytespider": "字节跳动",
"PerplexityBot": "Perplexity",
"CCBot": "Common Crawl",
}
SEARCH_BOTS = ["Googlebot", "Bingbot", "Baiduspider"]
# combined 日志格式:IP – – [时间] "GET 路径 协议" 状态码 字节数 "来源" "UA"
LOG_RE = re.compile(
r'^(\\S+) \\S+ \\S+ \\[([^\\]]+)\\] "(\\S+) (\\S+)[^"]*" (\\d{3}) \\d+ "[^"]*" "([^"]*)"'
)
SAMPLE = [
'66.249.66.1 – – [06/Nov/2026:03:12:41 +0000] "GET / HTTP/1.1" 200 5123 "-" "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)"',
'66.249.66.1 – – [06/Nov/2026:03:14:02 +0000] "GET /blog/geo-guide HTTP/1.1" 200 18340 "-" "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)"',
'66.249.66.1 – – [06/Nov/2026:03:15:37 +0000] "GET /blog/old-post HTTP/1.1" 404 0 "-" "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)"',
'66.249.66.1 – – [06/Nov/2026:03:17:11 +0000] "GET /blog/rag-notes HTTP/1.1" 200 15920 "-" "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)"',
'220.181.108.2 – – [06/Nov/2026:04:02:18 +0000] "GET / HTTP/1.1" 200 5123 "-" "Mozilla/5.0 (compatible; Bytespider; spider@bytedance.com)"',
'220.181.108.2 – – [06/Nov/2026:04:03:44 +0000] "GET /products HTTP/1.1" 200 22010 "-" "Mozilla/5.0 (compatible; Bytespider; spider@bytedance.com)"',
'220.181.108.2 – – [06/Nov/2026:04:05:02 +0000] "GET /products/cnc-milling HTTP/1.1" 200 14300 "-" "Mozilla/5.0 (compatible; Bytespider; spider@bytedance.com)"',
'159.112.240.1 – – [06/Nov/2026:05:21:09 +0000] "GET /robots.txt HTTP/1.1" 403 0 "-" "Mozilla/5.0 (compatible; ClaudeBot/1.0; +claude-bot@anthropic.com)"',
'18.197.44.3 – – [06/Nov/2026:06:40:52 +0000] "GET / HTTP/1.1" 200 5123 "-" "CCBot/2.0 (https://commoncrawl.org/faq/)"',
'64.233.172.5 – – [06/Nov/2026:07:15:30 +0000] "GET / HTTP/1.1" 200 5123 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"',
'157.55.39.8 – – [06/Nov/2026:07:22:14 +0000] "GET /blog/geo-guide HTTP/1.1" 200 18340 "-" "Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)"',
'113.88.20.11 – – [06/Nov/2026:09:01:47 +0000] "GET /contact HTTP/1.1" 200 4100 "https://www.baidu.com/" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0"',
]
def parse(line):
m = LOG_RE.match(line)
if not m:
return None
return {"ip": m.group(1), "path": m.group(4), "status": m.group(5), "ua": m.group(6)}
def classify(ua):
for bot in AI_BOTS:
if bot in ua:
return ("AI", bot)
for bot in SEARCH_BOTS:
if bot.lower() in ua.lower():
return ("SEARCH", bot)
return ("HUMAN", "-")
def analyze(lines):
stats = defaultdict(lambda: {"n": 0, "status": Counter(), "dirs": set()})
search_hits, human_hits = 0, 0
for line in lines:
rec = parse(line)
if not rec:
continue
kind, name = classify(rec["ua"])
if kind == "AI":
s = stats[name]
s["n"] += 1
s["status"][rec["status"]] += 1
d = rec["path"].split("/")[1] or "/"
s["dirs"].add("/" + d if d != "/" else "/")
elif kind == "SEARCH":
search_hits += 1
else:
human_hits += 1
return stats, search_hits, human_hits
def report(stats, search_hits, human_hits):
print("=== AI 爬虫抓取报告 ===")
for name, s in sorted(stats.items(), key=lambda x: –x[1]["n"]):
codes = ", ".join(f"{c}x{n}" for c, n in sorted(s["status"].items()))
dirs = ", ".join(sorted(s["dirs"]))
owner = AI_BOTS.get(name, "")
print(f"{name:<14}({owner}) {s['n']} 次请求 [{codes}] 目录: {dirs}")
print(f"搜索引擎爬虫: {search_hits} 次 / 普通用户: {human_hits} 次")
print("— 死角提示 —")
for name, s in stats.items():
bad = s["status"].get("403", 0) + s["status"].get("404", 0)
if bad and bad >= max(1, s["n"] // 2):
print(f"{name}: 失败请求占比过半,检查 robots/防火墙/死链")
if __name__ == "__main__":
stats, sh, hh = analyze(SAMPLE)
report(stats, sh, hh)
运行输出(真实运行结果):
=== AI 爬虫抓取报告 ===
GPTBot (OpenAI) 4 次请求 [200×3, 404×1] 目录: /, /blog
Bytespider (字节跳动) 3 次请求 [200×3] 目录: /, /products
ClaudeBot (Anthropic) 1 次请求 [403×1] 目录: /robots.txt
CCBot (Common Crawl) 1 次请求 [200×1] 目录: /
搜索引擎爬虫: 2 次 / 普通用户: 1 次
— 死角提示 —
ClaudeBot: 失败请求占比过半,检查 robots/防火墙/死链
读一下这份演示报告能得出什么:GPTBot 深入了 /blog 且有一个 404 死链;Bytespider 抓到了产品页;ClaudeBot 请求 robots.txt 直接被 403 挡掉,脚本也因此在死角提示里点名了它。这正是"日志里藏着答案"的典型场景:爬虫来了,但你把它挡在了门外,AI 侧的表现就是"完全没有你"。 如果不去看日志,这个问题会被误诊为"AI 不收录我",然后浪费数月在错误的方向上。
四、三个核心指标怎么读
拿到统计结果后,重点看三个指标:
| 周请求量 | 每周数十到数百次,且稳定 | 长期为 0,或断崖式下跌 | 0 = 从未进入抓取范围;下跌 = 内容或可达性出了问题 |
| 状态码分布 | 90% 以上为 200 | 大量 403 / 404 / 301 | 403 = 被规则挡;404 = 抓到死链;抓取配额被浪费在失败请求上 |
| 目录覆盖 | 核心内容目录均有覆盖 | 只反复抓首页 | 内容页没有被"发现",多半是内链结构问题 |
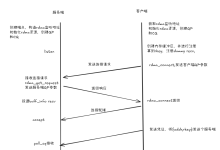
(图片上传后替换为链接1)
图 1:AI 爬虫日志分析三步流程——识别、统计、定位死角
一个容易误判的现象:只看请求量会得出"抓取很活跃"的结论,但状态码分布可能显示其中四成是 404——爬虫在反复撞死链。先看状态码,再看请求量,顺序反了结论就反了。
五、日志信号对应的改造动作
日志的价值不是"看",是指导改。三类信号对应三类动作:
| AI 爬虫请求全是 403 | robots.txt 规则或 CDN/防火墙误伤 | 检查 robots 放行规则、WAF 白名单、Cloudflare 机器人规则 |
| 只抓首页,不进内容页 | 内链结构弱,爬虫发现不了深页 | 首页和栏目页增加内容入口、补 sitemap、清理孤岛页 |
| 抓取正常(200 且目录覆盖好)但 AI 回答里仍没有你 | 可达性没问题,问题在内容质量层 | 转向内容侧:结构化数据、可核验数据、覆盖真实问法 |
(图片上传后替换为链接2)
图 2:三类日志信号与对应改造动作的对照关系
第三行最容易被忽略:抓取正常不代表引用正常。爬虫把页面拉进候选池只是第一步,AI 生成回答时选不选你的片段,取决于内容本身的信息增益和结构化程度——这就是日志分析与内容工程的分界线:日志管"进池子",内容管"被引用"。
六、四个常见坑
(图片上传后替换为链接3)
图 3:日志分析的四个常见坑
七、FAQ
Q1:没有服务器日志权限(托管建站/SaaS 商城)怎么办?
用 CDN 或站长工具侧的替代数据源:Cloudflare 免费版有机器人分析面板,能看到各类爬虫的请求量;Google Search Console 的"抓取统计"只覆盖 Google 系爬虫,但可以作为"爬虫是否健康"的参考锚点。完全没有数据通道的建站产品,是 AI 可见度的隐形天花板——选平台时就要问清日志权限。
Q2:AI 爬虫一直没来,怎么办?
先做可达性基础项:robots 放行、生成 sitemap 并主动提交(部分引擎有站长平台提交通道)、保证内容页有内链入口。新站和低更新频率的站点被首次抓取可能需要数周。持续零抓取超过一个月,再排查 DNS、防火墙和 CDN 规则。
Q3:多久分析一次日志?
建议固定每两周跑一次脚本、每月做一次趋势对比(周请求量、状态码占比、目录覆盖数三个数)。频率不用更高——爬虫抓取有波动,看单日数据容易被噪声带偏。
关于本文
文中脚本与方法均可独立复现,不依赖任何商业服务。各引擎的爬虫名单与抓取策略会持续更新,具体以官方文档为准。
标签:#GEO #生成式引擎优化 #AI搜索优化 #服务器日志 #爬虫分析 #Nginx
以下是发布信息(不要粘贴进 CSDN)
- 标题栏:AI 爬虫来过你的网站吗?从服务器日志识别 GPTBot、Bytespider 的抓取行为(2026 实战版)
- 摘要栏:判断"AI 有没有收录我",最可靠的第一手数据在你的服务器日志里。本文给出识别 AI 爬虫、统计抓取行为、定位抓取死角的方法,附可直接运行的 Python 脚本。
- 分区:人工智能 / 网络与安全 / 运维
| cover_log_nologo.png(无 logo 版) | — | 发布设置里选「上传封面」 | 不进正文 |
| fig_flow.png | AI爬虫日志分析三步流程.png | 第四节表格后 | 链接1 |
| fig_signal_log.png | 日志信号与改造动作对照.png | 第五节表格后 | 链接2 |
| fig_pit.png | 日志分析四个常见坑.png | 第六节末尾 | 链接3 |
CSDN 编辑器里点图片按钮上传后,把生成的链接替换正文里的「图片上传后替换为链接N」。斜体图注不要删——图注文字本身是可被 AI 引用的内容。
发布后 2-4 周验证问题:「怎么知道 AI 爬虫抓过我的网站」「服务器日志里怎么识别 AI 爬虫」「GPTBot 没来抓取怎么办」。


评论前必须登录!
注册