 网硕互联帮助中心
输出变短了,可能来自长度惩罚,也可能来自训练步数、数据顺序、采样温度甚至任务奖励实现的变化。要检验长度惩罚对训练的影响,先把“想改变的项”与“顺手改变的项”拆开。
把目标函数写成可审计的接口
一种简单目标是 R = R_task − λ·max(0,L−L0),L 为指定分词器下的输出 token 数,L0 为免费长度。这个形式只是一种设计选择:按字符计算、全长线性惩罚、截断后二元处罚都不是同一实验。还要写明 EOS 是否计数、工具调用文本是否计入、解析失败时任务奖励如何处理。
长度惩罚可能压掉冗余,也可能压掉必要推导。只有同时观察任务正确率和长度分布,才能区分这两种现象。单看总奖励没有意义,因为总奖励定义本身已经变了。
def reward(task_score, token_count, lam, free=32):
if token_count < 0 or lam < 0:
raise ValueError('negative length or weight')
return task_score – lam * max(0, token_count-free)
assert reward(1, 32, .01) == 1
assert abs(reward(1, 42, .01) – .9) < 1e-12
assert reward(0, 42, .01) < reward(0, 32, .01)
这些断言验证的是评分函数,而不是训练收益。训练前应另放一组“短但错”和“长且对”的样本,检查所选 λ 是否把明显正确答案排到了错误答案之后。这样的排序不一定必然不可接受,但必须是明确取舍。
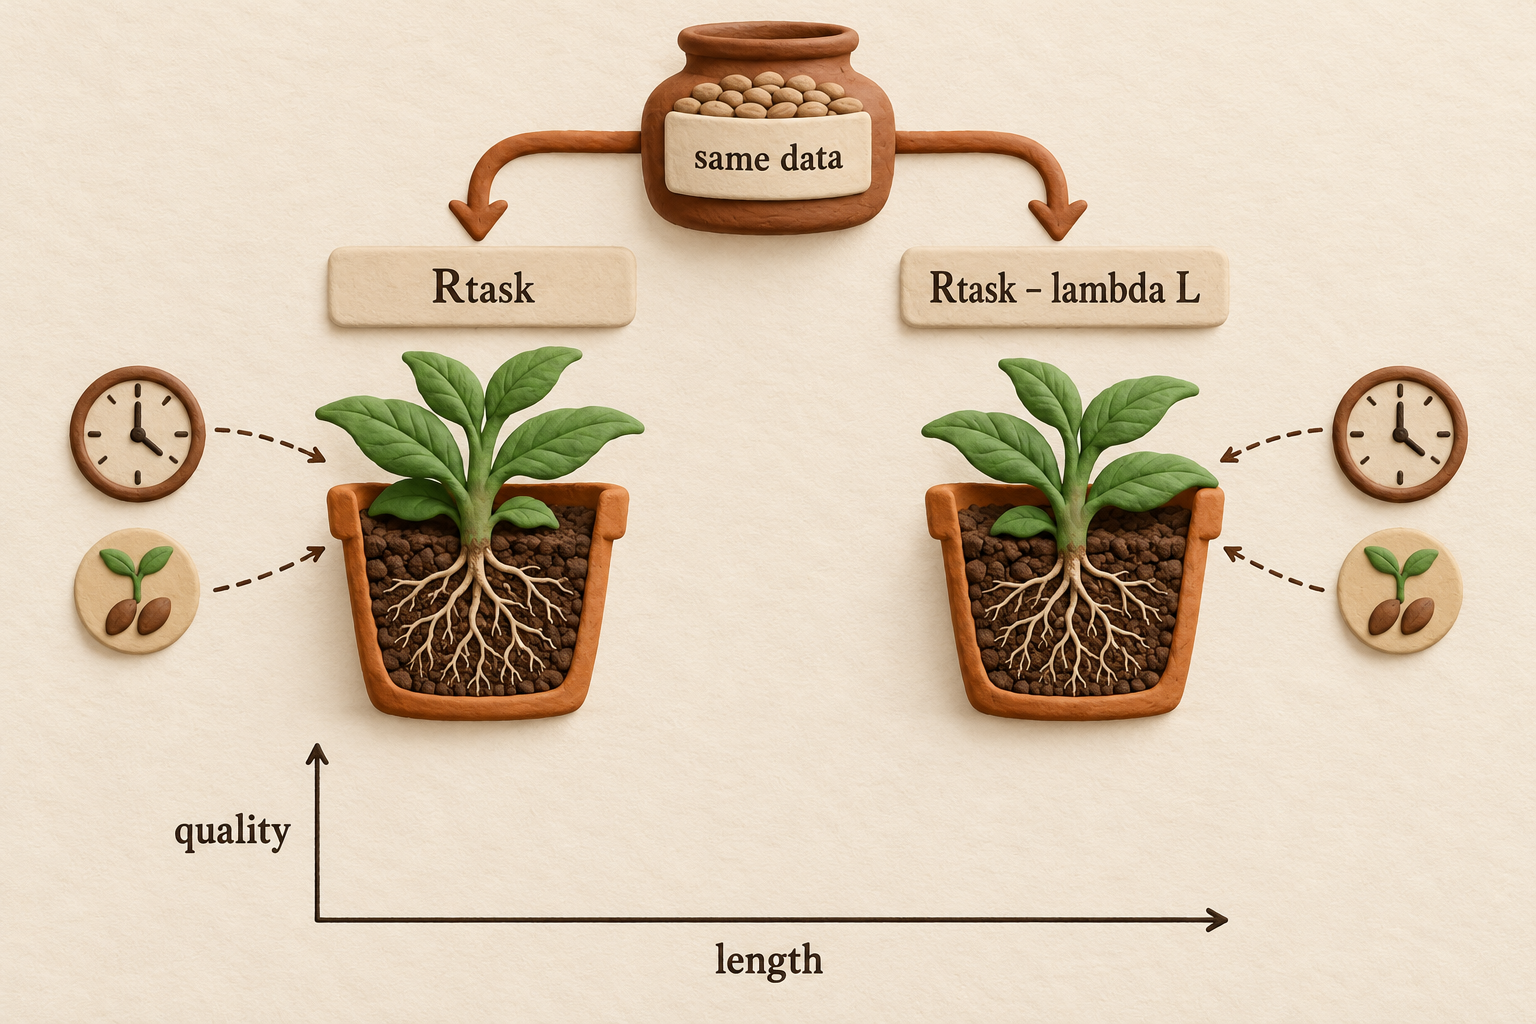
图示:两条支路使用共同数据与训练控制,只有长度项不同;图中 L 示意超出免费长度的部分,正文给出精确定义,坐标仅表示要记录的变量。
一组 λ 对照需要固定什么
从同一初始权重分出 λ=0 与 λ>0 两条训练支路,固定训练题集、任务奖励、优化器、学习率、更新次数、采样参数和最大生成长度。随机种子与数据排列对应保存;在在线采样训练中,策略一旦变化,后续轨迹自然会不同,不能声称两组见过逐条相同的 rollout。相同的是任务分布、初始条件和训练预算,不是强行复用另一策略的采样轨迹。
如果每批做奖励或优势归一化,应记录归一化的范围与公式。归一化可能改变长度项相对任务项的作用,λ 的数值不能脱离实现比较。PPO 的裁剪、参考策略约束等也要保持一致,具体算法背景可查 PPO 原始论文。
评价时使用共同的尺子
在未参与调 λ 的测试题上,以相同解码配置评价各检查点,同时报告任务得分、长度中位数和尾部、截断率、解析失败率。训练奖励可以附报,但不能作为唯一优劣标准。训练 token 总量与更新次数未必能同时相等;预先选一个主预算,其余资源实际记账。
若短输出正确率下降,检查是否减少了必要推导;若正确率不变但截断率下降,检查是否只是更容易在长度上限前结束。没有真实训练日志时,只能给出这些可检验解释,不能把目标函数的直觉写成已验证的规律。


评论前必须登录!
注册