 网硕互联帮助中心
Linux网络编程:彻底理解Reactor反应堆模式!从epoll事件分发、回调机制到手写C++ Reactor服务器
🔥 星恒随风:
个人主页
❄️ 个人专栏:
《Linux网络编程从0到1》
|
《C语言基础》
|
《数据结构和算法》
|
《MySQL》
|
《前端基础》
|
《python基础》
|
《C++从入门到入土》
|
《Linux的学习之旅》
✨ 数据即知识,压缩即智能
文章目录
- Linux网络编程:彻底理解Reactor反应堆模式!从epoll事件分发、回调机制到手写C++ Reactor服务器
-
- 前言:已经掌握epoll,为什么还需要学习Reactor?
- Reactor反应堆模式
- 一、什么是Reactor反应堆模式?
-
- 1.1 Reactor并不是一种新的系统调用
- 1.2 Reactor是不是异步I/O?
- 二、通过打地鼠游戏理解Reactor
-
- 2.1 如果不用事件通知怎么办?
- 2.2 如果使用epoll怎么办?
- 2.3 为什么还需要回调函数?
- 三、Reactor服务器需要哪些核心组件?
-
- 3.1 Connection
- 3.2 ConnectionFactory
- 3.3 Accepter
- 3.4 HandlerConnection
- 3.5 TcpServer
- 四、项目文件结构与职责
- 五、Connection:为什么需要封装连接对象?
-
- 5.1 Connection应该保存哪些内容?
- 5.2 Connection为什么还需要回调?
- 六、std::function与回调函数
-
- 6.1 为什么需要统一的回调类型?
- 6.2 为什么使用std::function,而不是普通函数指针?
- 6.3 RegisterCallback的设计
- 七、ConnectionFactory:为什么监听连接和普通连接需要不同的回调?
-
- 7.1 监听Connection
- 7.2 普通Connection
- 7.3 为什么Connection还要保存TcpServer指针?
- 八、实现Connection.hpp
-
- 8.1 为什么这里使用shared_ptr?
- 8.2 为什么析构函数调用Close?
- 九、Accepter:专门负责接收新连接
-
- 9.1 为什么需要单独的Accepter?
- 9.2 Accepter.hpp接口设计
- 9.3 为什么ET模式需要循环accept?
- 十、HandlerConnection:为什么需要分成四个处理函数?
-
- 10.1 为什么Recver不直接解析业务?
- 十一、为什么需要Decode、Deserialize、Serialize、Encode?
-
- 11.1 Decode:解决报文边界
- 11.2 Deserialize:反序列化
- 11.3 Calculate:业务处理
- 11.4 Serialize:序列化
- 11.5 Encode:封装完整报文
- 十二、实现Protocol.hpp
-
- 12.1 Decode为什么使用while反复调用?
- 12.2 如果只收到半条请求呢?
- 十三、实现Calculate.hpp
- 十四、实现HandlerConnection.hpp
- 十五、Recver:如何正确读取ET模式下的Socket?
-
- 15.1 接收流程
- 15.2 为什么要读取到EAGAIN?
- 15.3 为什么不能把recv返回0当作普通错误?
- 15.4 为什么需要保留ReadEof状态?
- 十六、Sender:为什么必须维护输出缓冲区?
-
- 16.1 Sender的基本流程
- 16.2 为什么发送不完要关注EPOLLOUT?
- 16.3 为什么发送完要关闭EPOLLOUT?
- 十七、Excepter:连接应该怎样安全删除?
-
- 17.1 为什么这里需要注意对象生命周期?
- 十八、TcpServer:整个Reactor的核心
-
- 18.1 核心成员
- 18.2 核心接口
- 18.3 为什么需要EnableReadWrite?
- 十九、实现TcpServer.hpp
- 二十、TcpServer.cpp:实现完整Reactor
- 二十一、逐步理解Reactor主事件循环
-
- 21.1 第一步:等待事件
- 21.2 第二步:找到对应Connection
- 21.3 第三步:根据事件执行回调
- 21.4 Reactor究竟负责什么?
- 二十二、为什么说Reactor是一种设计模式?
- 二十三、实现main.cpp
- 二十四、编译和运行
-
- 24.1 编译
- 24.2 启动服务器
- 24.3 使用nc测试
- 24.4 测试连续请求
- 24.5 测试多个客户端
- 24.6 测试TCP半包
- 二十五、单Reactor单线程模式有什么特点?
-
- 25.1 不需要为每个连接创建一个线程
- 25.2 同一线程中的连接管理比较简单
- 25.3 但也存在局限
- 二十六、One Thread One Loop是什么?
-
- 26.1 为什么这样设计?
- 26.2 核心原则
- 二十七、Master-Reactor与Worker-Reactor
-
- 27.1 多线程版本
- 27.2 多进程版本
- 二十八、为什么One Thread One Loop需要线程通知机制?
- 二十九、使用pipe进行线程通知
-
- 29.1 基本结构
- 29.2 为什么可以和epoll配合?
- 29.3 一个简单的管道线程实验
- 29.4 pipe传输的是字节流
- 三十、eventfd:专门用于事件通知的文件描述符
-
- 30.1 eventfd的核心思想
- 30.2 为什么eventfd适合Reactor?
- 30.3 eventfd能够直接传递任务内容吗?
- 三十一、eventfd的两种工作模式
-
- 31.1 普通模式
- 31.2 信号量模式
- 31.3 eventfd实验
- 三十二、eventfd与pipe怎样选择?
- 三十三、单Reactor与多Reactor的关系
-
- 33.1 单Reactor单线程
- 33.2 One Thread One Loop
- 33.3 为什么不能简单地让多个线程同时处理一个Connection?
- 三十四、Reactor模式的优点
-
- 34.1 优点一:减少为每个连接创建独立线程的需求
- 34.2 优点二:事件处理职责清晰
- 34.3 优点三:便于扩展
- 34.4 优点四:便于扩展为多Reactor
- 三十五、Reactor模式的缺点
-
- 35.1 缺点一:实现复杂度增加
- 35.2 缺点二:必须正确处理非阻塞IO
- 35.3 缺点三:业务函数不能长时间占用事件循环
- 35.4 缺点四:对象生命周期管理较复杂
- 三十六、Reactor常见面试问题
-
- 36.1 什么是Reactor?
- 36.2 Reactor和epoll有什么区别?
- 36.3 Reactor是不是异步IO?
- 36.4 Connection有什么作用?
- 36.5 为什么需要ConnectionFactory?
- 36.6 为什么需要Accepter?
- 36.7 HandlerConnection中的四个函数是什么?
- 36.8 为什么ET模式要循环accept?
- 36.9 为什么ET模式要循环recv?
- 36.10 Sender遇到EAGAIN怎么办?
- 36.11 为什么有了epoll还需要回调函数?
- 36.12 什么是One Thread One Loop?
- 36.13 为什么需要eventfd?
- 36.14 eventfd能直接传递Connection对象吗?
- 36.15 Reactor最大的价值是什么?
- 三十七、全文知识体系总结
- 三十八、全文总结
前言:已经掌握epoll,为什么还需要学习Reactor?
在前面的Linux网络编程中,我们已经系统学习了:
- TCP与UDP网络通信。
- 阻塞I/O和非阻塞I/O。
- select、poll、epoll 三种I/O多路转接机制。
- epoll 的LT水平触发与ET边缘触发。
- 非阻塞 recv() 和 send()。
- EAGAIN、部分发送与应用层接收缓冲区。
通过这些知识,我们已经能够编写一个简单的多客户端TCP服务器。
例如:
while (true)
{
int n = epoll_wait(
epfd,
events,
64,
–1
);
for (int i = 0; i < n; ++i)
{
int fd = events[i].data.fd;
if (fd == listenfd)
{
// 接受新连接
}
else
{
// 接收数据
// 解析请求
// 处理业务
// 发送响应
// 处理异常
}
}
}
这段程序已经体现了事件驱动的思想。
但是,如果服务器的业务越来越复杂,就会出现一个问题:
所有网络事件的处理逻辑,都集中在一个庞大的事件循环中。
如果将这些操作全部写进同一个函数,代码会越来越复杂。
这时我们需要进一步考虑:
能否将事件检测、事件分发、连接管理和具体业务处理分离?
这就是本文要学习的:
Reactor反应堆模式
Reactor是一种经典的事件驱动设计模式,广泛应用于网络服务器。
一、什么是Reactor反应堆模式?
Reactor是一种:
事件驱动的服务器设计模式。
其核心思想是:
让事件循环等待I/O就绪事件,并根据事件类型,将事件分发给对应的处理函数。
例如服务器需要同时管理:
客户端A
客户端B
客户端C
它们分别对应:
fd4
fd5
fd6
Reactor可以组织以下流程:
Reactor
|
v
epoll_wait
|
+——–+——–+
| | |
v v v
fd4 fd5 fd6
| | |
可读 可写 异常
| | |
v v v
Recver Sender Excepter
其中:
Recver:
处理读事件
Sender:
处理写事件
Excepter:
处理异常与连接关闭
这样,事件循环就不需要直接包含全部业务代码。
它只需要完成:
等待事件 → 找到连接 → 调用对应回调。
1.1 Reactor并不是一种新的系统调用
必须明确:
epoll
与:
Reactor
不是同一层面的概念。
epoll是Linux提供的:
I/O多路转接机制。
而Reactor是:
如何组织事件处理代码的软件设计模式。
例如:
Reactor设计模式
|
v
epoll事件通知机制
|
v
Linux Socket
因此:
Reactor可以基于epoll实现,也可以基于select、poll等机制实现。
在Linux高并发服务器中,epoll是一种常见选择。
1.2 Reactor是不是异步I/O?
在经典五种I/O模型的定义中:
基于epoll的Reactor通常仍然属于同步I/O多路转接。
因为:
epoll_wait:
报告Socket就绪
而:
recv/send:
由应用程序执行实际读写
Reactor的“事件驱动”不等于内核已经完成了整个异步I/O操作。
这一点需要与前面学习的同步、异步概念区分开。
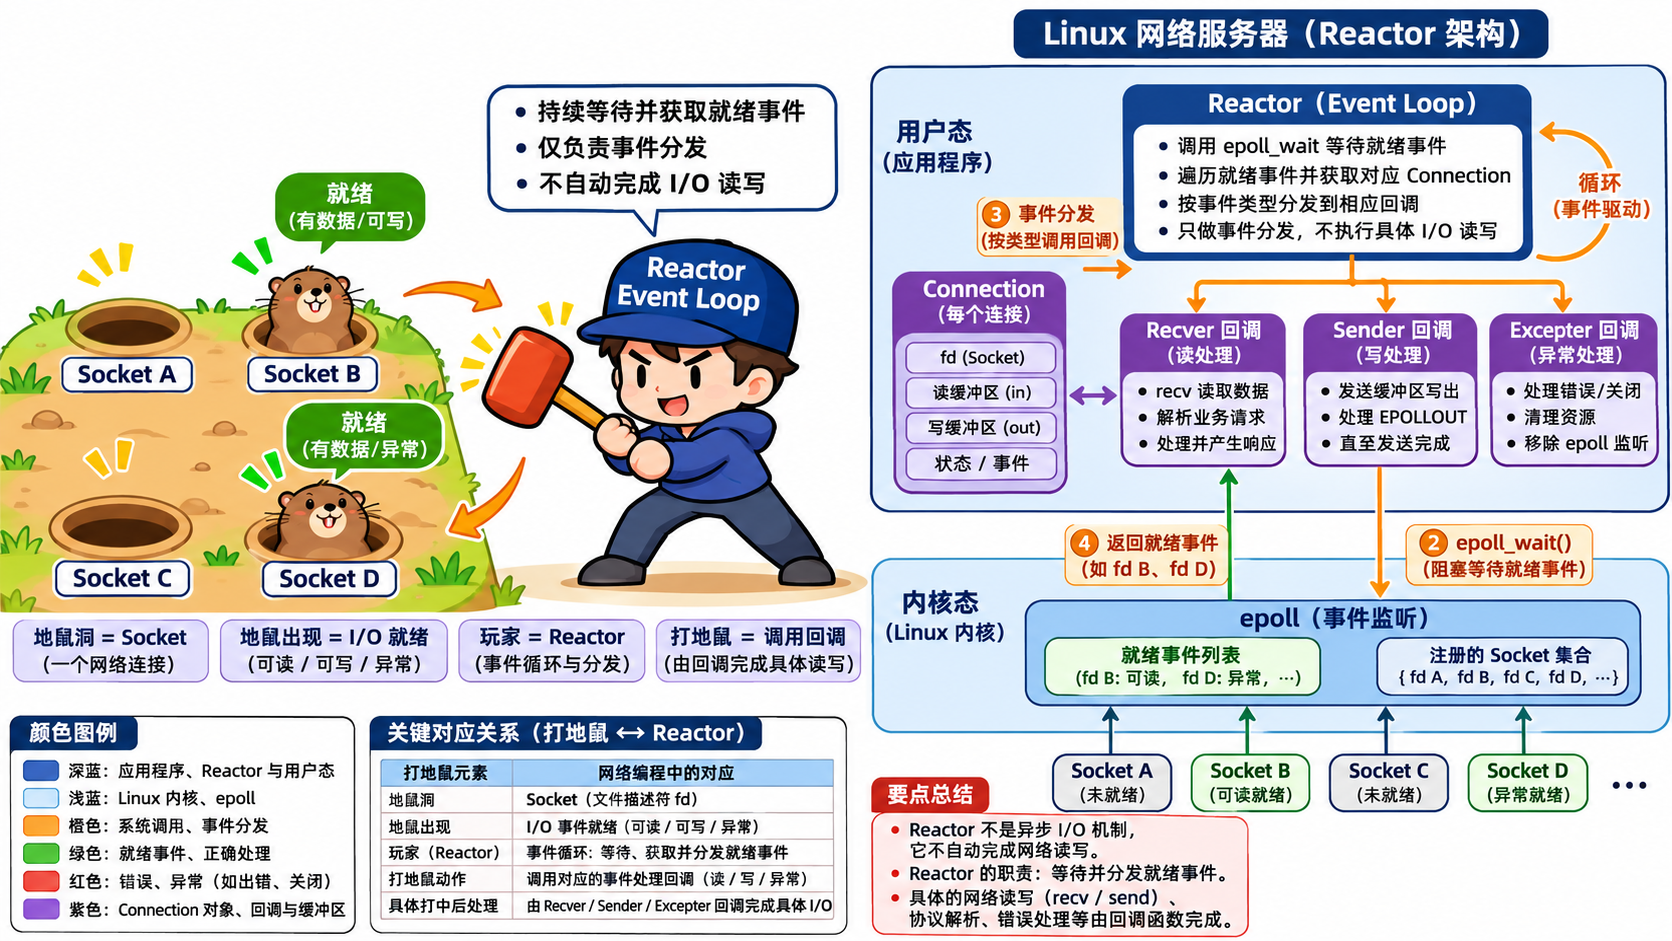
二、通过打地鼠游戏理解Reactor
想象一个打地鼠游戏。
地面上有很多洞:
洞A
洞B
洞C
洞D
不同的地鼠可能从不同的洞中出现。
一个玩家拿着锤子,需要及时处理出现的地鼠。
| 地鼠洞 | Socket连接 |
| 地鼠出现 | 对应I/O事件就绪 |
| 观察哪些地鼠出现 | I/O多路转接 |
| 玩家 | Reactor事件循环 |
| 拿锤子打地鼠 | 调用对应事件处理函数 |
2.1 如果不用事件通知怎么办?
玩家不断检查:
洞A有没有地鼠?
洞B有没有地鼠?
洞C有没有地鼠?
洞D有没有地鼠?
即使某个洞长期没有地鼠,也反复检查。
这类似于简单的非阻塞轮询。
2.2 如果使用epoll怎么办?
可以让游戏系统提供一个通知机制。
例如:
洞C出现地鼠
|
v
游戏系统通知玩家
|
v
玩家处理洞C
这类似:
Socket C读就绪
|
v
epoll_wait返回
|
v
Reactor调用Recver
2.3 为什么还需要回调函数?
因为不同事件需要不同的处理方式。
例如:
新连接:
调用Accepter
接收数据:
调用Recver
可以继续发送:
调用Sender
连接异常:
调用Excepter
所以Reactor并不只是负责发现事件。
它还需要:
将不同事件分发到正确的处理函数。
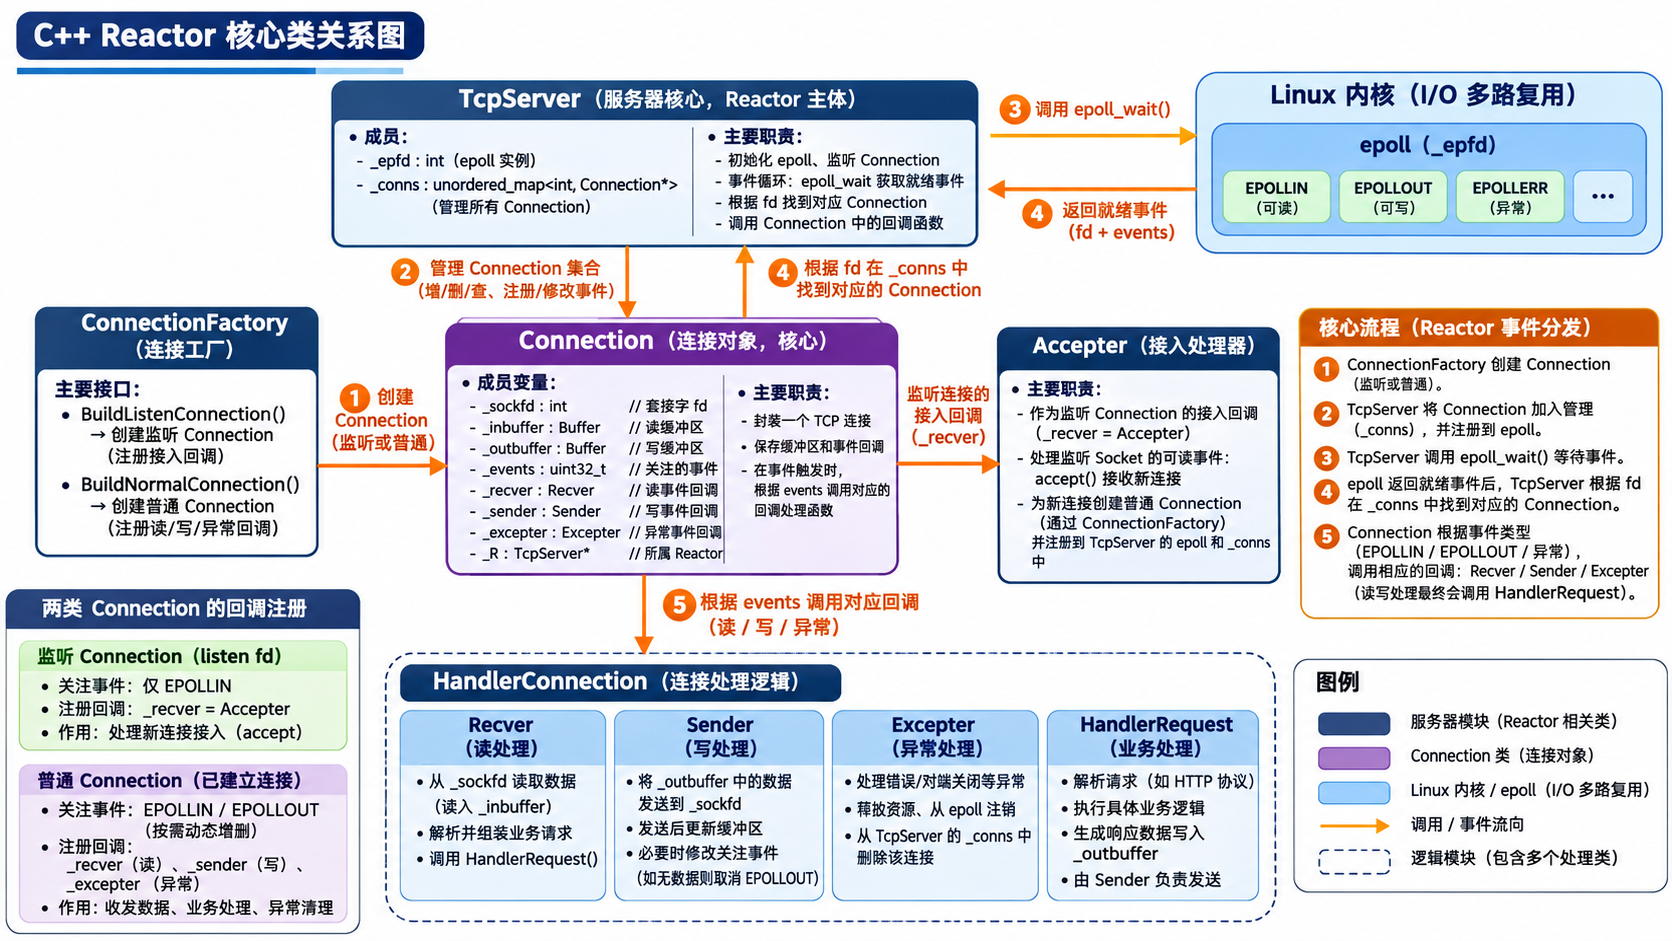
三、Reactor服务器需要哪些核心组件?
现在我们准备设计一个真正的Reactor服务器。
先不写具体实现。
首先分析整个项目要完成什么。
我们的目标是:
实现一个基于epoll ET模式、能够同时处理多个TCP客户端的简单计算服务器。
客户端输入:
10 + 20
服务器返回:
OK 30
客户端输入:
8 * 5
服务器返回:
OK 40
客户端输入:
10 / 0
服务器返回:
ERR division by zero
网络框架负责收发数据。
计算模块负责具体业务。
为了实现这个目标,需要设计几个类。
3.1 Connection
负责:
描述和管理一个连接。
例如保存:
Socket文件描述符
接收缓冲区
发送缓冲区
当前关注的事件
读回调
写回调
异常回调
3.2 ConnectionFactory
负责:
创建不同类型的Connection对象,并注册相应的回调函数。
例如:
监听连接
与:
普通客户端连接
需要不同的回调。
3.3 Accepter
负责:
处理新客户端连接。
它主要执行:
accept()
取得新的Socket,并将其交给Reactor管理。
3.4 HandlerConnection
负责:
处理普通客户端的读、写与异常事件。
主要包括:
Recver()
Sender()
Excepter()
以及:
HandlerRequest()
3.5 TcpServer
负责:
管理epoll实例、Connection集合和主事件循环。
例如:
注册Connection
删除Connection
修改EPOLLIN/EPOLLOUT
等待epoll事件
执行对应回调
四、项目文件结构与职责
为了避免所有代码写在一个文件中,我们将项目拆分为:
reactor/
│
├── Protocol.hpp
│
├── Calculate.hpp
│
├── Connection.hpp
│
├── Accepter.hpp
│
├── HandlerConnection.hpp
│
├── TcpServer.hpp
│
├── TcpServer.cpp
│
└── main.cpp
各个文件的职责如下。
| Protocol.hpp | 请求分帧、序列化、反序列化 |
| Calculate.hpp | 执行计算业务 |
| Connection.hpp | 维护单个连接的状态与回调 |
| Accepter.hpp | 定义新连接接入模块 |
| HandlerConnection.hpp | 定义收发及异常处理接口 |
| TcpServer.hpp | Reactor服务器接口 |
| TcpServer.cpp | Reactor事件循环与核心逻辑 |
| main.cpp | 创建服务器并启动 |
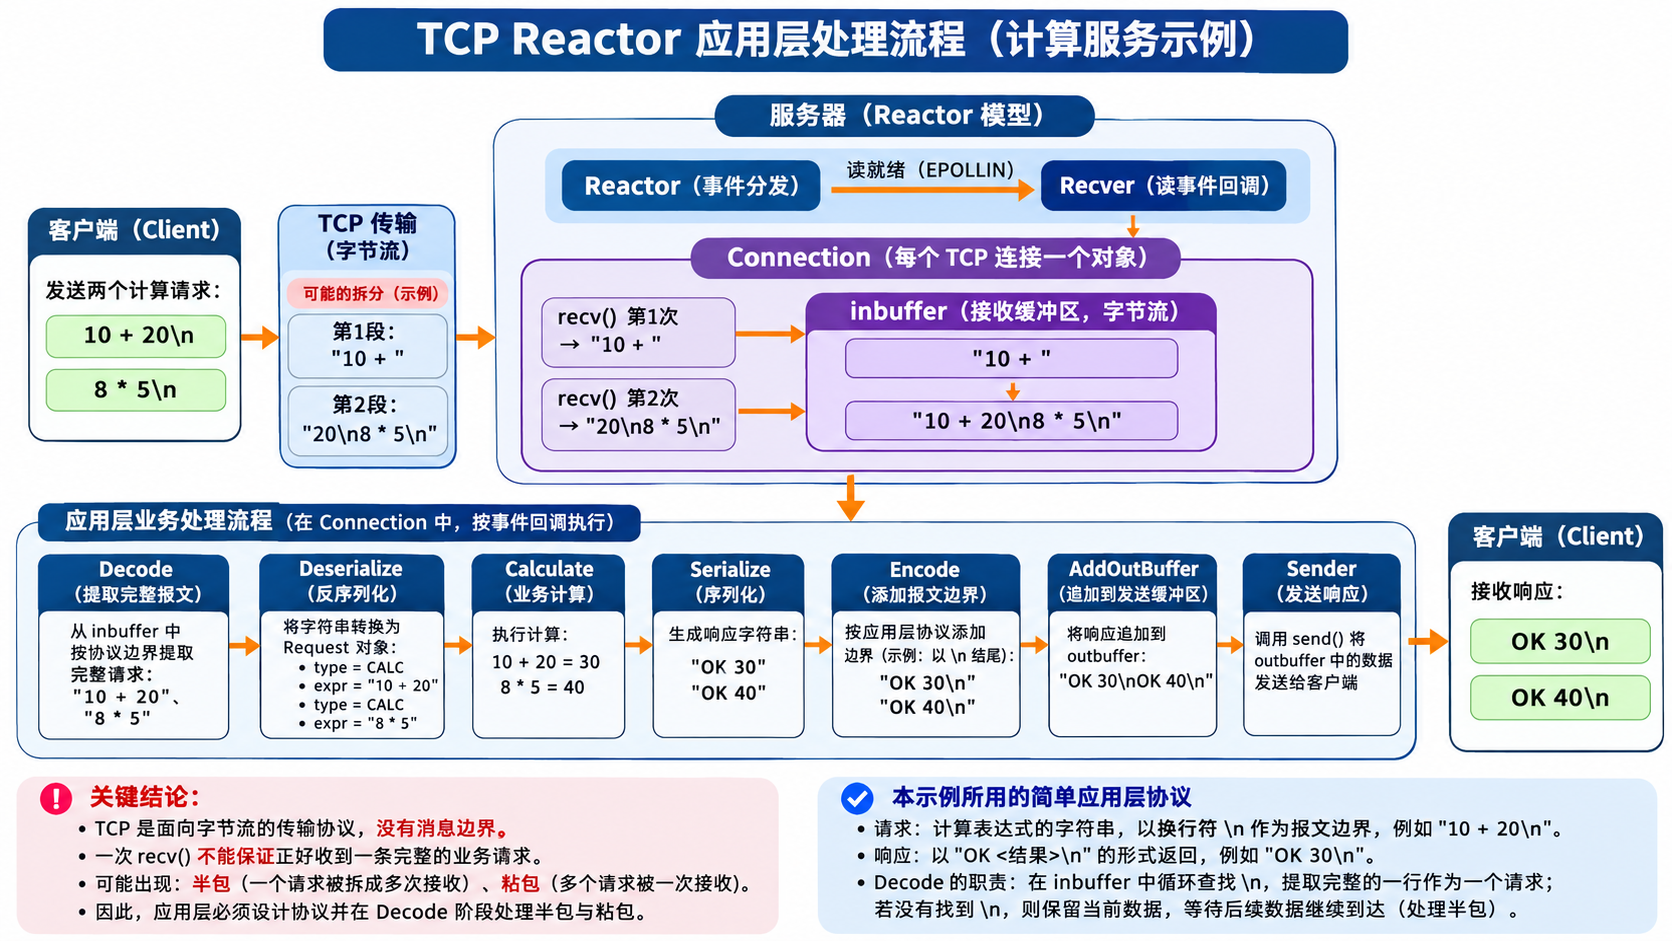
这里采用一套便于直接运行的简化计算协议。
每条请求以:
\\n
结束。
例如:
10 + 20\\n
这样便于使用 nc 测试,同时能够清楚展示:
TCP字节流 → 完整报文 → 业务请求 → 业务响应。
五、Connection:为什么需要封装连接对象?
在之前的epoll服务器中,我们往往直接操作:
int fd;
例如:
recv(fd, ...);
或者:
send(fd, ...);
但对于Reactor,仅有一个fd是不够的。
假设两个客户端:
客户端A:fd5
客户端B:fd6
客户端A发送:
10 +
客户端B发送:
8 *
随后客户端A继续发送:
20\\n
客户端B继续发送:
5\\n
每个客户端都需要独立保存尚未接收完整的数据。
因此:
Connection A
|
+—- fd5
+—- inbuffer = "10 +"
+—- outbuffer
Connection B
|
+—- fd6
+—- inbuffer = "8 *"
+—- outbuffer
当后续数据到达时,分别追加到对应的接收缓冲区。
5.1 Connection应该保存哪些内容?
可以设计:
class Connection
{
private:
int _sockfd;
std::string _inbuffer;
std::string _outbuffer;
uint32_t _events;
};
其中:
_sockfd
表示当前连接对应的Socket。
_inbuffer
表示:
已经从内核读取、但还没有完成应用层处理的数据。
_outbuffer
表示:
等待发送或尚未发送完毕的响应数据。
_events
记录当前注册的epoll事件。
5.2 Connection为什么还需要回调?
因为不同连接需要响应不同事件。
例如普通客户端:
EPOLLIN:
调用Recver
EPOLLOUT:
调用Sender
错误或关闭:
调用Excepter
因此需要给Connection增加:
_recver
_sender
_excepter
这些回调成员。
六、std::function与回调函数
在正式实现Connection之前,先理解:
std::function
6.1 为什么需要统一的回调类型?
假设三个函数:
void Recver(Connection* conn);
void Sender(Connection* conn);
void Excepter(Connection* conn);
它们具有共同的函数签名:
返回值:void
参数:Connection*
因此可以定义:
using func_t =
std::function<void(Connection*)>;
这表示:
func_t可以保存一个能够接收Connection*参数、且返回void的可调用对象。
例如:
func_t callback = HandlerConnection::Recver;
随后执行:
callback(conn);
就可以调用对应处理函数。
6.2 为什么使用std::function,而不是普通函数指针?
因为 std::function 不仅能保存普通函数指针。
它还可以保存:
Lambda表达式
经过std::bind绑定的可调用对象
函数对象
例如:
func_t callback =
[](Connection* conn)
{
// 处理连接
};
这让Reactor更容易注册不同类型的处理逻辑。
6.3 RegisterCallback的设计
我们可以提供接口:
void RegisterCallback(
func_t recver,
func_t sender,
func_t excepter
);
执行:
_recver = recver;
_sender = sender;
_excepter = excepter;
这样一个Connection就拥有了自己的事件处理方式。
七、ConnectionFactory:为什么监听连接和普通连接需要不同的回调?
首先考虑:
listenfd
它是监听Socket。
当它读就绪时,通常意味着有连接等待接受。
所以应该调用:
accept()
而不是:
recv()
但普通客户端Socket读就绪时,需要调用:
recv()
因此:
监听Connection
|
v
AccepterConnection
普通Connection
|
+—- Recver
|
+—- Sender
|
+—- Excepter
这就是ConnectionFactory存在的意义。
它负责为不同类型的Connection注册不同回调。
7.1 监听Connection
例如:
BuildListenConnection(
listenfd,
accept_callback,
EPOLLIN | EPOLLET,
server
);
只需要注册读回调。
因为监听Socket不负责普通业务数据的收发。
7.2 普通Connection
例如:
BuildNormalConnection(
clientfd,
Recver,
Sender,
Excepter,
EPOLLIN | EPOLLET,
server
);
需要注册:
接收回调
发送回调
异常回调
7.3 为什么Connection还要保存TcpServer指针?
因为回调函数有时需要修改服务器管理的状态。
例如:
连接发送缓冲区还有数据
需要通知TcpServer:
开启对EPOLLOUT的关注
或者:
客户端断开
需要通知TcpServer:
从epoll删除fd
从连接集合移除Connection
因此Connection可以保留一个指向服务器的指针:
TcpServer* _R;
这称为:
回指指针。
它让Connection相关回调可以通过服务器提供的接口管理事件和连接生命周期。
八、实现Connection.hpp
现在实现第一个核心文件。
设计目标:
Connection.hpp
|
+—- Connection
|
+—- ConnectionFactory
它负责保存连接状态和回调,不直接实现具体业务处理。
完整代码:
#pragma once
#include <cstdint>
#include <functional>
#include <memory>
#include <string>
#include <unistd.h>
#include <netinet/in.h>
class Connection;
class TcpServer;
using func_t = std::function<void(Connection*)>;
// ==============================
// Connection:连接对象
// ==============================
class Connection
{
public:
Connection(
int fd,
uint32_t events,
TcpServer* reactor
)
: _R(reactor),
_sockfd(fd),
_events(events)
{
}
~Connection()
{
Close();
}
Connection(const Connection&) = delete;
Connection& operator=(const Connection&) = delete;
// 注册读、写、异常回调
void RegisterCallback(
func_t recver,
func_t sender,
func_t excepter
)
{
_recver = recver;
_sender = sender;
_excepter = excepter;
}
// 追加接收数据
void AddInBuffer(const std::string& data)
{
_inbuffer += data;
}
// 追加待发送数据
void AddOutBuffer(const std::string& data)
{
_outbuffer += data;
}
bool OutBufferEmpty() const
{
return _outbuffer.empty();
}
int SockFd() const
{
return _sockfd;
}
uint32_t Events() const
{
return _events;
}
void SetEvents(uint32_t events)
{
_events = events;
}
std::string& InBuffer()
{
return _inbuffer;
}
std::string& OutBuffer()
{
return _outbuffer;
}
void SetClient(const sockaddr_in& peer)
{
_client = peer;
}
bool ReadEof() const
{
return _read_eof;
}
void SetReadEof()
{
_read_eof = true;
}
// 关闭连接,避免重复close
void Close()
{
if (_sockfd >= 0)
{
::close(_sockfd);
_sockfd = –1;
}
}
public:
// 回调函数
func_t _recver;
func_t _sender;
func_t _excepter;
// 指向Reactor服务器
TcpServer* _R;
private:
int _sockfd;
std::string _inbuffer;
std::string _outbuffer;
uint32_t _events;
bool _read_eof = false;
sockaddr_in _client{};
};
// ==============================
// ConnectionFactory:连接工厂
// ==============================
class ConnectionFactory
{
public:
// 创建监听连接
static std::shared_ptr<Connection>
BuildListenConnection(
int fd,
func_t recver,
uint32_t events,
TcpServer* reactor
)
{
std::shared_ptr<Connection> conn(
new Connection(fd, events, reactor)
);
conn->RegisterCallback(
recver,
nullptr,
nullptr
);
return conn;
}
// 创建普通客户端连接
static std::shared_ptr<Connection>
BuildNormalConnection(
int fd,
func_t recver,
func_t sender,
func_t excepter,
uint32_t events,
TcpServer* reactor
)
{
std::shared_ptr<Connection> conn(
new Connection(fd, events, reactor)
);
conn->RegisterCallback(
recver,
sender,
excepter
);
return conn;
}
};
8.1 为什么这里使用shared_ptr?
一个连接可能同时被:
TcpServer连接集合
和:
正在执行的事件回调
引用。
如果异常回调直接删除Connection,而外层事件分发代码仍然正在访问这个对象,就可能产生生命周期问题。
这里使用:
std::shared_ptr<Connection>
使事件分发期间能够暂时保留一个有效对象引用。
这是一种便于教学且相对安全的生命周期管理方式,并不表示Reactor必须使用shared_ptr。
8.2 为什么析构函数调用Close?
因为Connection拥有对应Socket资源。
通过:
~Connection()
{
Close();
}
可以在对象释放时关闭文件描述符。
而 Close() 内部:
if (_sockfd >= 0)
能够避免重复关闭。
这体现了C++资源管理中的RAII思想。
九、Accepter:专门负责接收新连接
接下来实现:
class Accepter;
它的职责非常明确:
当监听Socket读就绪时,接受客户端连接,并为新客户端创建Connection。
9.1 为什么需要单独的Accepter?
因为监听连接与普通客户端连接的处理逻辑不同。
监听Connection
|
v
epoll报告EPOLLIN
|
v
AccepterConnection
|
v
accept
|
v
创建普通Connection
|
v
注册到TcpServer
而普通客户端:
普通Connection
|
v
epoll报告EPOLLIN
|
v
HandlerConnection::Recver
因此应该将两种职责分离。
9.2 Accepter.hpp接口设计
文件:
Accepter.hpp
#pragma once
#include "Connection.hpp"
class Accepter
{
public:
void AccepterConnection(
Connection* listen_conn
);
};
这里只声明接口。
具体实现统一放在:
TcpServer.cpp
中,这样能够避免多个类相互依赖时出现头文件循环包含的问题。
9.3 为什么ET模式需要循环accept?
假设三个客户端同时连接:
客户端A
客户端B
客户端C
监听Socket的待接受队列中可能有多个连接。
如果只执行:
accept(listenfd, ...);
一次,就可能只取出其中一个。
由于使用ET模式,不能依赖剩余连接一定被再次通知。
因此应当:
监听Socket读就绪
|
v
accept客户端A
|
v
accept客户端B
|
v
accept客户端C
|
v
accept返回EAGAIN
|
v
本轮接入结束
这里必须满足两个条件:
监听Socket设置为非阻塞。
并且:
循环accept直到EAGAIN或EWOULDBLOCK。
还需要处理:
EINTR
因为系统调用可能受到信号中断。

十、HandlerConnection:为什么需要分成四个处理函数?
现在进入Reactor中的另一个重要类:
HandlerConnection
它负责普通客户端连接的业务处理。
我们设计四个接口:
HandlerRequest()
负责处理应用层请求。
Recver()
负责从Socket中读取字节流。
Sender()
负责向Socket发送响应数据。
Excepter()
负责异常处理和连接删除。
10.1 为什么Recver不直接解析业务?
因为:
recv()
只负责读取TCP字节流。
它并不知道:
一条完整请求有多长?
请求使用什么协议?
请求是否已经完整?
例如:
第一次recv:
"10 + "
第二次recv:
"20\\n"
如果每次recv后都直接调用计算函数,那么第一次收到的:
10 +
并不是完整请求。
因此正确流程应该是:
recv读取字节
|
v
追加到inbuffer
|
v
Decode提取完整报文
|
v
Deserialize反序列化
|
v
执行计算
|
v
Serialize序列化结果
|
v
Encode封装响应报文
|
v
追加到outbuffer
|
v
Sender尝试发送
这个过程非常重要。
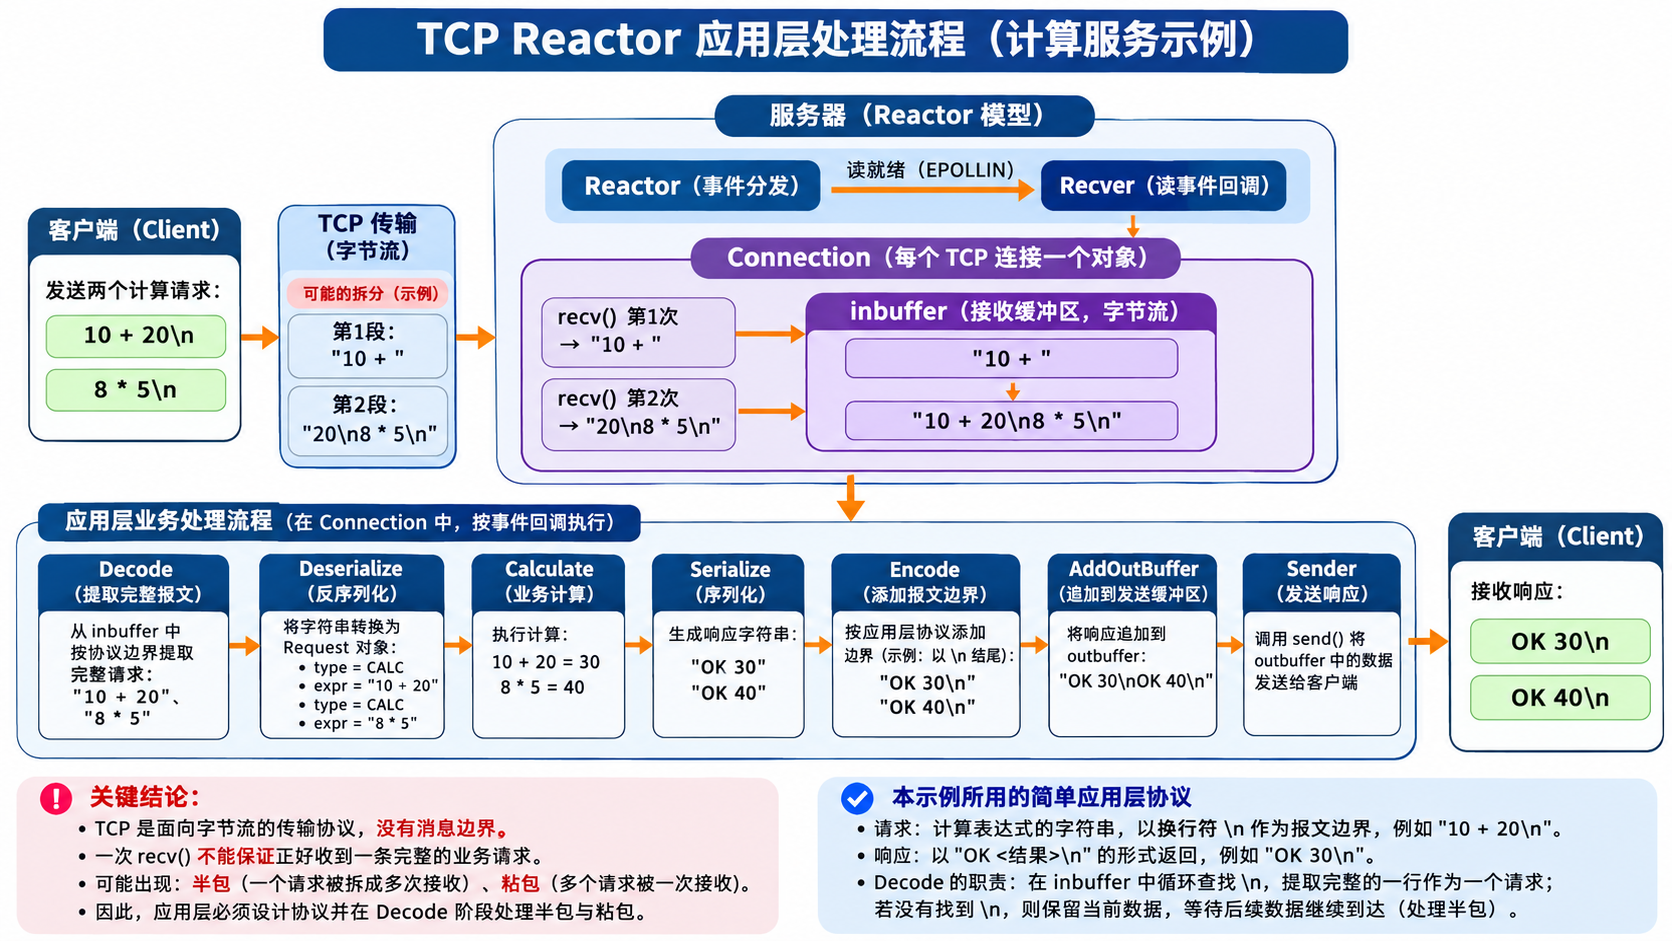
十一、为什么需要Decode、Deserialize、Serialize、Encode?
这四个操作容易混淆,需要单独区分。
11.1 Decode:解决报文边界
TCP是字节流协议。
例如:
recv得到:
"10 + 20\\n8 * 5\\n"
实际上包含两条请求:
10 + 20
8 * 5
Decode() 负责从输入缓冲区提取完整报文。
例如:
Decode(&inbuffer, &message);
提取出:
message = "10 + 20"
然后缓冲区剩余:
"8 * 5\\n"
再次调用Decode,就可以提取下一条请求。
因此:
Decode解决的是应用层报文边界问题。
11.2 Deserialize:反序列化
假设已经得到完整报文:
10 + 20
我们希望把它变为:
Request
{
x = 10,
op = '+',
y = 20
};
这个过程叫:
反序列化。
11.3 Calculate:业务处理
得到Request对象以后:
Calculate::Cal()
负责执行:
10 + 20
得到:
30
这是业务逻辑,不属于底层网络收发。
11.4 Serialize:序列化
假设业务处理得到:
Response
{
ok = true,
result = 30
};
需要转换为字符串:
OK 30
这叫:
序列化。
11.5 Encode:封装完整报文
最后加上分隔符:
OK 30\\n
使客户端知道响应边界。
所以可以总结为:
接收方向:
TCP字节流
|
v
Decode
|
v
Deserialize
|
v
业务Request
发送方向:
业务Response
|
v
Serialize
|
v
Encode
|
v
TCP字节流
十二、实现Protocol.hpp
现在实现应用层协议。
文件:
Protocol.hpp
为了便于实验,采用换行分隔的文本协议:
10 + 20\\n
响应:
OK 30\\n
这个版本足够展示:
半包
粘包
完整请求解析
但需要注意,换行协议不能直接替代任意二进制协议。
完整代码:
#pragma once
#include <cstddef>
#include <memory>
#include <sstream>
#include <string>
namespace Protocol
{
static const std::size_t kMaxLine = 8192;
// ==============================
// Encode:添加报文边界
// ==============================
inline std::string Encode(
const std::string& text
)
{
return text + "\\n";
}
// ==============================
// Decode:提取一条完整报文
// ==============================
inline bool Decode(
std::string* input,
std::string* message
)
{
std::size_t end = input->find('\\n');
if (end == std::string::npos)
{
return false;
}
*message = input->substr(0, end);
input->erase(0, end + 1);
// 兼容CRLF
if (
!message->empty() &&
message->back() == '\\r'
)
{
message->pop_back();
}
return true;
}
// ==============================
// Request:请求对象
// ==============================
struct Request
{
long long x = 0;
long long y = 0;
char op = '+';
bool Deserialize(
const std::string& message
)
{
std::istringstream in(message);
std::string trailing;
if (
!(in >> x >> op >> y) ||
(in >> trailing)
)
{
return false;
}
// 限制数值,避免简单计算示例溢出
if (
x < –1000000 ||
x > 1000000 ||
y < –1000000 ||
y > 1000000
)
{
return false;
}
return (
op == '+' ||
op == '-' ||
op == '*' ||
op == '/'
);
}
};
// ==============================
// Response:响应对象
// ==============================
struct Response
{
bool ok = true;
long long result = 0;
std::string error;
void Serialize(
std::string* output
) const
{
if (ok)
{
*output =
"OK " + std::to_string(result);
}
else
{
*output = "ERR " + error;
}
}
};
// ==============================
// Factory:请求对象工厂
// ==============================
class Factory
{
public:
std::unique_ptr<Request> BuildRequest() const
{
return std::unique_ptr<Request>(
new Request()
);
}
};
} // namespace Protocol
12.1 Decode为什么使用while反复调用?
假设:
inbuffer:
"1 + 2\\n3 * 4\\n5 – 1\\n"
一次recv已经收到了三条请求。
正确做法是:
while (Decode(&inbuffer, &message))
{
// 处理一条完整请求
}
这样可以连续取出:
1 + 2
3 * 4
5 – 1
而不是只处理第一条。
12.2 如果只收到半条请求呢?
例如:
inbuffer:
"10 +"
此时找不到:
'\\n'
所以:
Decode()
返回:
false
数据仍然保存在缓冲区中。
等下一次recv收到:
" 20\\n"
再进行处理。
十三、实现Calculate.hpp
接下来实现业务模块。
文件:
Calculate.hpp
这个模块不需要知道:
Socket编号
epoll事件
EAGAIN
客户端IP
只需要接收Request并返回Response。
完整代码:
#pragma once
#include "Protocol.hpp"
namespace CalculateNS
{
class Calculate
{
public:
Protocol::Response Cal(
const Protocol::Request& req
) const
{
Protocol::Response resp;
switch (req.op)
{
case '+':
resp.result = req.x + req.y;
break;
case '-':
resp.result = req.x – req.y;
break;
case '*':
resp.result = req.x * req.y;
break;
case '/':
if (req.y == 0)
{
resp.ok = false;
resp.error = "division by zero";
}
else
{
resp.result = req.x / req.y;
}
break;
default:
resp.ok = false;
resp.error = "invalid operator";
break;
}
return resp;
}
};
} // namespace CalculateNS
这里的计算逻辑非常简单。
目的是让我们把重点放在:
Reactor如何组织网络事件和业务回调。
十四、实现HandlerConnection.hpp
现在声明普通连接的事件处理接口。
文件:
HandlerConnection.hpp
#pragma once
#include "Connection.hpp"
class HandlerConnection
{
public:
// 提取完整请求并执行业务
static bool HandlerRequest(Connection* conn);
// 读事件处理
static void Recver(Connection* conn);
// 写事件处理
static void Sender(Connection* conn);
// 异常及关闭处理
static void Excepter(Connection* conn);
};
为什么把这几个方法声明为:
static
因为它们不需要维护一个独立的HandlerConnection对象状态。
所有连接状态都由传入的:
Connection* conn
提供。
这样可以直接注册:
HandlerConnection::Recver
HandlerConnection::Sender
HandlerConnection::Excepter
作为回调。
十五、Recver:如何正确读取ET模式下的Socket?
现在提前分析实现思路。
当:
EPOLLIN
事件就绪时,Reactor调用:
conn->_recver(conn);
也就是:
HandlerConnection::Recver(conn);
15.1 接收流程
Recver
|
v
recv
|
+—- n > 0
| |
| v
| 追加到inbuffer
| |
| v
| 继续recv
|
+—- n == 0
| |
| v
| 对端结束发送
|
+—- EINTR
| |
| v
| 重新尝试
|
+—- EAGAIN
| |
| v
| 本轮读取结束
|
+—- 其他错误
|
v
Excepter
15.2 为什么要读取到EAGAIN?
因为我们使用:
EPOLLET
边缘触发模式。
如果本轮只读取部分数据,不能依赖剩余数据必然再次触发相同通知。
所以:
读就绪
|
v
循环recv
|
v
直到EAGAIN
是关键处理方式。
15.3 为什么不能把recv返回0当作普通错误?
因为:
recv() == 0
在TCP连接中通常表示对端正常结束发送。
这与:
recv() == –1
且:
errno == EAGAIN
完全不同。
15.4 为什么需要保留ReadEof状态?
假设客户端发送:
10 + 20\\n
随后关闭发送方向。
服务器可能同时观察到:
请求数据已经收到
以及:
对端结束发送
但服务器还需要把:
OK 30\\n
发送回客户端。
如果一收到EOF就立即:
close(fd);
可能导致尚未发送完的响应丢失。
因此我们保存:
_read_eof
状态。
等输出缓冲区发送完成以后,再关闭连接。
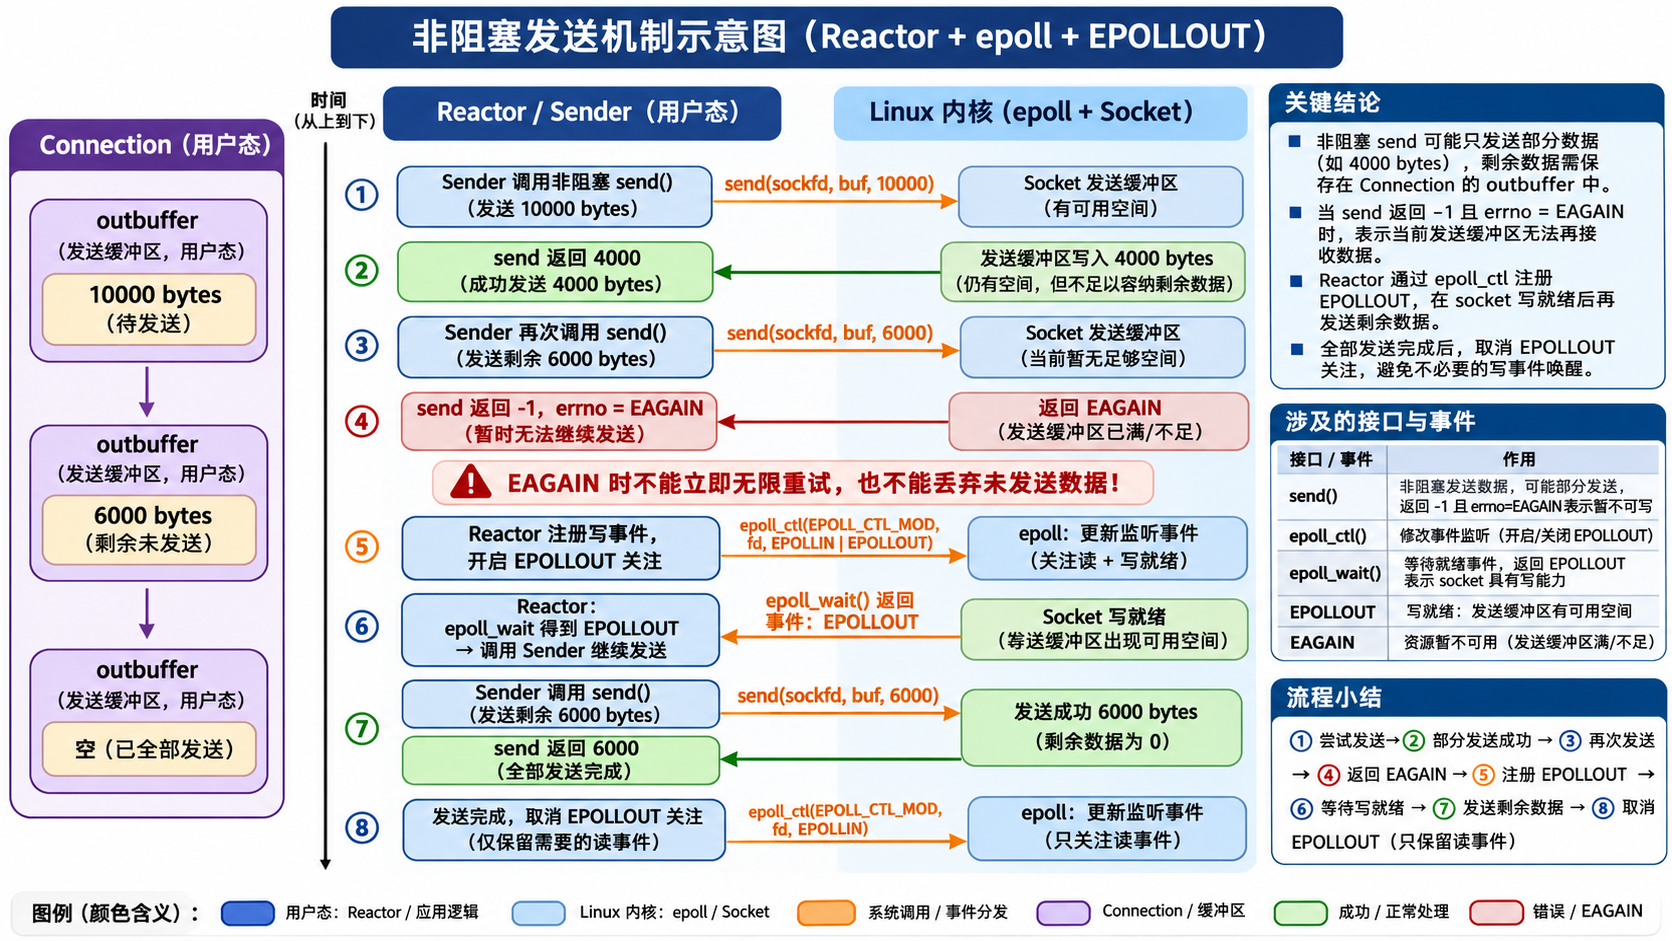
十六、Sender:为什么必须维护输出缓冲区?
假设服务器需要发送:
10000字节
但是:
send()
只成功发送了:
4000字节
那么:
剩余6000字节
怎么办?
如果直接丢弃,就会导致响应不完整。
因此Connection需要:
_outbuffer
保存待发送数据。
16.1 Sender的基本流程
Sender
|
v
检查outbuffer
|
v
send
|
+—- n > 0
| |
| v
| 删除已发送部分
| |
| v
| 继续发送
|
+—- EINTR
| |
| v
| 重试
|
+—- EAGAIN
| |
| v
| 保留剩余数据
| |
| v
| 开启EPOLLOUT
|
+—- 其他错误
|
v
Excepter
16.2 为什么发送不完要关注EPOLLOUT?
因为:
Socket发送缓冲区暂时没有足够空间
此时继续立即调用:
send()
可能只会反复返回:
EAGAIN
所以更合理的方式是:
保留剩余数据
|
v
注册EPOLLOUT
|
v
等待写就绪
|
v
继续发送
16.3 为什么发送完要关闭EPOLLOUT?
因为对于很多正常TCP连接,Socket经常处于可写状态。
如果一直关注:
EPOLLOUT
但没有数据需要发送,LT模式下容易产生重复的无意义写就绪通知。
因此通常采用:
outbuffer非空:
关注EPOLLOUT
outbuffer为空:
取消EPOLLOUT
十七、Excepter:连接应该怎样安全删除?
这是Reactor实现中非常重要的部分。
假设:
fd5对应的客户端已经断开
需要完成:
从epoll取消监视
|
v
从连接集合删除
|
v
关闭Socket
|
v
释放Connection对象
为什么不能只调用:
close(fd);
因为服务器可能还保存这个fd对应的Connection对象。
反过来,也不能只从连接集合删除对象,而忘记关闭底层Socket。
17.1 为什么这里需要注意对象生命周期?
假设事件循环正在执行:
conn->_recver(conn);
而Recver内部发现错误:
conn->_excepter(conn);
如果Excepter直接:
delete conn;
外层事件分发代码可能还保存着指向该对象的指针。
这会增加悬空指针和使用已释放对象的风险。
因此后面的实现使用:
std::shared_ptr<Connection>
由服务器保存连接对象。
在分发一次事件时,局部也保留一份引用。
这样即使回调从连接集合移除了该对象,它也可以在当前事件处理流程结束后再释放。
十八、TcpServer:整个Reactor的核心
现在正式设计:
class TcpServer;
它是整个Reactor服务器的核心。
主要负责:
创建监听Socket
创建epoll实例
注册Connection
管理Connection集合
修改关注事件
等待就绪事件
调用回调函数
18.1 核心成员
int epfd_;
保存epoll实例的文件描述符。
std::unordered_map<
int,
std::shared_ptr<Connection>
> connections_;
保存:
fd → Connection对象
的映射关系。
Accepter accepter_;
用于处理监听Socket上的新连接事件。
18.2 核心接口
bool Init();
初始化服务器。
void Loop();
执行事件循环。
bool AddConnection(...);
添加连接。
void RemoveConnection(int fd);
移除连接。
bool EnableReadWrite(
int fd,
bool read,
bool write
);
修改读写事件关注状态。
18.3 为什么需要EnableReadWrite?
因为某个客户端在不同阶段,需要关注的事件可能不同。
例如:
客户端刚连接:
关注EPOLLIN
收到请求并生成响应:
响应发送不完:
关注EPOLLIN和EPOLLOUT
响应发送完成:
取消EPOLLOUT
这些变化都可以由:
EnableReadWrite()
统一管理。
十九、实现TcpServer.hpp
文件:
TcpServer.hpp
#pragma once
#include "Connection.hpp"
#include "Accepter.hpp"
#include <cstdint>
#include <memory>
#include <string>
#include <sys/epoll.h>
#include <unordered_map>
class TcpServer
{
public:
TcpServer(
const std::string& ip,
uint16_t port
);
~TcpServer();
TcpServer(const TcpServer&) = delete;
TcpServer& operator=(const TcpServer&) = delete;
// 初始化监听Socket和epoll
bool Init();
// Reactor主事件循环
void Loop();
// 注册Connection
bool AddConnection(
const std::shared_ptr<Connection>& conn
);
// 删除Connection
void RemoveConnection(int fd);
// 修改读写关注状态
bool EnableReadWrite(
int fd,
bool read,
bool write
);
private:
std::string ip_;
uint16_t port_;
int epfd_ = –1;
std::unordered_map<
int,
std::shared_ptr<Connection>
> connections_;
Accepter accepter_;
};
目前为止,整个项目的主要类和接口已经完成设计。
接下来才开始编写核心实现。
二十、TcpServer.cpp:实现完整Reactor
文件:
TcpServer.cpp
这个文件将实现:
TcpServer
Accepter
HandlerConnection
的具体逻辑。
它同时负责解决头文件之间的依赖关系。
完整代码如下。
#include "TcpServer.hpp"
#include "HandlerConnection.hpp"
#include "Protocol.hpp"
#include "Calculate.hpp"
#include <arpa/inet.h>
#include <cerrno>
#include <cstdio>
#include <fcntl.h>
#include <sys/socket.h>
#include <unistd.h>
// ==============================
// 设置Socket为非阻塞
// ==============================
namespace
{
bool SetNonBlock(int fd)
{
int flags = fcntl(fd, F_GETFL);
if (flags < 0)
{
return false;
}
return fcntl(
fd,
F_SETFL,
flags | O_NONBLOCK
) == 0;
}
} // namespace
// ==============================
// TcpServer构造与析构
// ==============================
TcpServer::TcpServer(
const std::string& ip,
uint16_t port
)
: ip_(ip),
port_(port)
{
}
TcpServer::~TcpServer()
{
// 释放所有Connection
connections_.clear();
// 关闭epoll实例
if (epfd_ >= 0)
{
::close(epfd_);
}
}
// ==============================
// 初始化Reactor服务器
// ==============================
bool TcpServer::Init()
{
// 1. 创建epoll实例
epfd_ = epoll_create1(EPOLL_CLOEXEC);
if (epfd_ < 0)
{
perror("epoll_create1");
return false;
}
// 2. 创建监听Socket
int listenfd = socket(
AF_INET,
SOCK_STREAM,
0
);
if (listenfd < 0)
{
perror("socket");
return false;
}
// 3. 地址复用
int opt = 1;
if (
setsockopt(
listenfd,
SOL_SOCKET,
SO_REUSEADDR,
&opt,
sizeof(opt)
) < 0
||
!SetNonBlock(listenfd)
)
{
perror("setsockopt/fcntl");
::close(listenfd);
return false;
}
// 4. 配置服务器地址
sockaddr_in addr{};
addr.sin_family = AF_INET;
addr.sin_port = htons(port_);
if (
inet_pton(
AF_INET,
ip_.c_str(),
&addr.sin_addr
) != 1
)
{
fprintf(stderr, "invalid IP address\\n");
::close(listenfd);
return false;
}
// 5. 绑定端口
if (
bind(
listenfd,
reinterpret_cast<sockaddr*>(&addr),
sizeof(addr)
) < 0
)
{
perror("bind");
::close(listenfd);
return false;
}
// 6. 开始监听
if (listen(listenfd, 128) < 0)
{
perror("listen");
::close(listenfd);
return false;
}
// 7. 监听Socket使用ET模式
uint32_t events = EPOLLIN | EPOLLET;
// 8. 创建接入回调
func_t accept_cb =
[this](Connection* conn)
{
accepter_.AccepterConnection(conn);
};
// 9. 创建监听Connection
auto conn =
ConnectionFactory::BuildListenConnection(
listenfd,
accept_cb,
events,
this
);
// 10. 注册监听Connection
if (!AddConnection(conn))
{
return false;
}
printf(
"Reactor listening on %s:%u\\n",
ip_.c_str(),
static_cast<unsigned>(port_)
);
fflush(stdout);
return true;
}
// ==============================
// 注册Connection
// ==============================
bool TcpServer::AddConnection(
const std::shared_ptr<Connection>& conn
)
{
int fd = conn->SockFd();
epoll_event ev{};
ev.data.fd = fd;
ev.events = conn->Events();
if (
epoll_ctl(
epfd_,
EPOLL_CTL_ADD,
fd,
&ev
) < 0
)
{
perror("epoll_ctl ADD");
return false;
}
connections_[fd] = conn;
return true;
}
// ==============================
// 移除Connection
// ==============================
void TcpServer::RemoveConnection(int fd)
{
// 先从epoll取消注册
epoll_ctl(
epfd_,
EPOLL_CTL_DEL,
fd,
nullptr
);
// 再从连接集合中移除
connections_.erase(fd);
}
// ==============================
// 修改关注的读写事件
// ==============================
bool TcpServer::EnableReadWrite(
int fd,
bool read,
bool write
)
{
auto it = connections_.find(fd);
if (it == connections_.end())
{
return false;
}
uint32_t events =
EPOLLET | EPOLLRDHUP;
if (read)
{
events |= EPOLLIN;
}
if (write)
{
events |= EPOLLOUT;
}
// 事件没有变化就不必重复MOD
if (it->second->Events() == events)
{
return true;
}
epoll_event ev{};
ev.data.fd = fd;
ev.events = events;
if (
epoll_ctl(
epfd_,
EPOLL_CTL_MOD,
fd,
&ev
) < 0
)
{
return false;
}
it->second->SetEvents(events);
return true;
}
// ==============================
// Reactor主事件循环
// ==============================
void TcpServer::Loop()
{
epoll_event events[64];
while (true)
{
// 1. 等待事件
int n = epoll_wait(
epfd_,
events,
64,
–1
);
if (n < 0)
{
if (errno == EINTR)
{
continue;
}
perror("epoll_wait");
break;
}
// 2. 遍历本次返回的就绪事件
for (int i = 0; i < n; ++i)
{
int fd = events[i].data.fd;
// 3. 找到对应Connection
auto it = connections_.find(fd);
if (it == connections_.end())
{
continue;
}
// 保证回调执行期间对象存活
std::shared_ptr<Connection> conn =
it->second;
uint32_t triggered =
events[i].events;
// 4. 错误事件
if (
(triggered & EPOLLERR) &&
conn->_excepter
)
{
conn->_excepter(conn.get());
continue;
}
// 5. 读事件、挂断事件
if (
(
triggered &
(
EPOLLIN |
EPOLLRDHUP |
EPOLLHUP
)
)
&&
conn->_recver
)
{
conn->_recver(conn.get());
}
// 回调可能已经删除了Connection
if (
connections_.find(fd) ==
connections_.end()
)
{
continue;
}
// 6. 写就绪
if (
(triggered & EPOLLOUT) &&
conn->_sender
)
{
conn->_sender(conn.get());
}
}
}
}
// ==============================
// Accepter:接收新连接
// ==============================
void Accepter::AccepterConnection(
Connection* listen_conn
)
{
while (true)
{
sockaddr_in peer{};
socklen_t len = sizeof(peer);
int fd = accept(
listen_conn->SockFd(),
reinterpret_cast<sockaddr*>(&peer),
&len
);
if (fd < 0)
{
if (errno == EINTR)
{
continue;
}
if (
errno != EAGAIN &&
errno != EWOULDBLOCK
)
{
perror("accept");
}
// ET模式,接受到EAGAIN为止
break;
}
// 新客户端必须使用非阻塞Socket
if (!SetNonBlock(fd))
{
perror("SetNonBlock");
::close(fd);
continue;
}
// 注册读、写、异常处理回调
auto conn =
ConnectionFactory::BuildNormalConnection(
fd,
HandlerConnection::Recver,
HandlerConnection::Sender,
HandlerConnection::Excepter,
EPOLLIN | EPOLLET | EPOLLRDHUP,
listen_conn->_R
);
conn->SetClient(peer);
// 添加到Reactor
if (
!listen_conn->_R->AddConnection(conn)
)
{
continue;
}
printf("connected fd=%d\\n", fd);
}
}
// ==============================
// HandlerRequest:处理完整报文
// ==============================
bool HandlerConnection::HandlerRequest(
Connection* conn
)
{
std::string& input = conn->InBuffer();
std::string message;
Protocol::Factory factory;
CalculateNS::Calculate calc;
// 一次可能存在多条完整请求
while (
Protocol::Decode(&input, &message)
)
{
if (
message.size() >
Protocol::kMaxLine
)
{
return false;
}
// 1. 创建请求对象
auto req = factory.BuildRequest();
Protocol::Response resp;
// 2. 反序列化
if (!req->Deserialize(message))
{
resp.ok = false;
resp.error =
"bad request: use 'number op number'";
}
else
{
// 3. 执行业务
resp = calc.Cal(*req);
}
// 4. 序列化响应
std::string encoded;
resp.Serialize(&encoded);
// 5. Encode并追加到输出缓冲区
conn->AddOutBuffer(
Protocol::Encode(encoded)
);
// 防止响应无限积压
if (
conn->OutBuffer().size() >
(1u << 20)
)
{
return false;
}
}
return input.size() <= Protocol::kMaxLine;
}
// ==============================
// Recver:读取客户端数据
// ==============================
void HandlerConnection::Recver(
Connection* conn
)
{
char buffer[4096];
// ET模式:持续读取直到EAGAIN
while (true)
{
ssize_t n = recv(
conn->SockFd(),
buffer,
sizeof(buffer),
0
);
if (n > 0)
{
conn->AddInBuffer(
std::string(
buffer,
static_cast<std::size_t>(n)
)
);
// 防止客户端无限积压数据
if (
conn->InBuffer().size() >
(1u << 20)
)
{
conn->_excepter(conn);
return;
}
continue;
}
// 对端正常结束发送
if (n == 0)
{
conn->SetReadEof();
break;
}
if (errno == EINTR)
{
continue;
}
if (
errno == EAGAIN ||
errno == EWOULDBLOCK
)
{
break;
}
perror("recv");
conn->_excepter(conn);
return;
}
// 解析缓冲区中的完整报文
if (!HandlerRequest(conn))
{
conn->_excepter(conn);
return;
}
// 如果生成了响应,尝试发送
if (!conn->OutBufferEmpty())
{
conn->_sender(conn);
}
else if (conn->ReadEof())
{
// 对端结束发送,且没有待发送响应
conn->_excepter(conn);
}
else if (
!conn->_R->EnableReadWrite(
conn->SockFd(),
true,
false
)
)
{
conn->_excepter(conn);
}
}
// ==============================
// Sender:发送响应
// ==============================
void HandlerConnection::Sender(
Connection* conn
)
{
std::string& out = conn->OutBuffer();
while (!out.empty())
{
ssize_t n = send(
conn->SockFd(),
out.data(),
out.size(),
MSG_NOSIGNAL
);
if (n > 0)
{
// 删除已经成功提交发送的数据
out.erase(
0,
static_cast<std::size_t>(n)
);
continue;
}
if (n < 0 && errno == EINTR)
{
continue;
}
if (
n < 0 &&
(
errno == EAGAIN ||
errno == EWOULDBLOCK
)
)
{
// 保存未发送数据
// 等后续EPOLLOUT继续发送
break;
}
perror("send");
conn->_excepter(conn);
return;
}
// 对端已结束发送,并且响应也发完
if (
conn->ReadEof() &&
out.empty()
)
{
conn->_excepter(conn);
return;
}
// 根据输出缓冲区状态调整事件
if (
!conn->_R->EnableReadWrite(
conn->SockFd(),
!conn->ReadEof(),
!out.empty()
)
)
{
conn->_excepter(conn);
}
}
// ==============================
// Excepter:关闭和删除连接
// ==============================
void HandlerConnection::Excepter(
Connection* conn
)
{
int fd = conn->SockFd();
if (fd < 0)
{
return;
}
// 1. 从epoll和Connection集合删除
conn->_R->RemoveConnection(fd);
// 2. 关闭Socket
conn->Close();
printf("disconnected fd=%d\\n", fd);
}
二十一、逐步理解Reactor主事件循环
现在我们回到最核心的函数:
TcpServer::Loop()
如果把它简化,实际上只有下面几个步骤。
21.1 第一步:等待事件
int n = epoll_wait(
epfd_,
events,
64,
–1
);
这里:
epoll_wait
只负责:
等待和获取就绪事件。
它不关心业务协议。
21.2 第二步:找到对应Connection
int fd = events[i].data.fd;
然后:
auto it = connections_.find(fd);
取得:
Connection
对象。
这里的核心关系是:
就绪fd
|
v
connections_
|
v
Connection对象
21.3 第三步:根据事件执行回调
例如:
if (triggered & EPOLLIN)
{
conn->_recver(conn.get());
}
这里并没有写:
recv()
因为具体接收逻辑已经封装到:
HandlerConnection::Recver()
中了。
同理:
if (triggered & EPOLLOUT)
{
conn->_sender(conn.get());
}
负责调用写回调。
21.4 Reactor究竟负责什么?
可以概括为:
Reactor负责:
发现事件
识别连接
分发事件
而:
回调函数负责:
处理事件对应的具体操作
因此:
Reactor把事件分发和事件处理分离开来。
二十二、为什么说Reactor是一种设计模式?
注意,我们实现的功能:
accept
recv
send
close
其实并没有发生改变。
以前:
if (fd == listenfd)
{
accept(...);
}
else
{
recv(...);
}
现在:
conn->_recver(conn.get());
执行不同连接的回调。
底层系统调用仍然存在。
变化的是:
代码组织方式。
例如:
以前:
主事件循环中写全部逻辑
现在:
主事件循环只负责分发
Connection保存状态
Accepter处理连接
HandlerConnection处理读写
Protocol处理协议
Calculate处理业务
因此Reactor并不是某种特殊的Socket协议。
它更像是一套:
事件驱动程序的组织规范。
二十三、实现main.cpp
现在所有核心模块已经完成。
只剩下程序入口。
文件:
main.cpp
完整代码:
#include "TcpServer.hpp"
int main()
{
TcpServer server(
"127.0.0.1",
9090
);
if (!server.Init())
{
return 1;
}
server.Loop();
return 0;
}
这样整个Reactor服务器就完成了。
二十四、编译和运行
最终目录:
reactor/
│
├── Protocol.hpp
├── Calculate.hpp
├── Connection.hpp
├── Accepter.hpp
├── HandlerConnection.hpp
├── TcpServer.hpp
├── TcpServer.cpp
└── main.cpp
24.1 编译
在Ubuntu终端执行:
g++ -std=c++11 -Wall -Wextra \\
main.cpp TcpServer.cpp \\
-o reactor_server
24.2 启动服务器
./reactor_server
预期输出:
Reactor listening on 127.0.0.1:9090
24.3 使用nc测试
打开新的终端:
nc 127.0.0.1 9090
输入:
10 + 20
预期返回:
OK 30
继续输入:
8 * 5
返回:
OK 40
输入:
10 / 0
返回:
ERR division by zero
24.4 测试连续请求
在支持 nc -N 的Ubuntu环境中:
printf '1 + 2\\n3 * 4\\n8 / 0\\n' | \\
nc -N 127.0.0.1 9090
预期:
OK 3
OK 12
ERR division by zero
24.5 测试多个客户端
分别打开三个终端:
nc 127.0.0.1 9090
客户端A:
10 + 20
客户端B:
8 * 5
客户端C:
100 / 4
服务器可以通过同一个事件循环处理这些连接。
24.6 测试TCP半包
可以使用一个简单的Python测试脚本。
import socket
import time
s = socket.create_connection(
("127.0.0.1", 9090)
)
# 第一部分
s.sendall(b"10 + ")
time.sleep(0.5)
# 第二部分
s.sendall(b"20\\n")
print(s.recv(1024).decode())
s.close()
预期:
OK 30
这里验证的是:
两次send共同组成一条应用层请求。
程序不能把一次recv当作一条完整消息。
二十五、单Reactor单线程模式有什么特点?
目前实现的服务器可以称为:
单Reactor、单线程事件循环。
其结构:
单线程
|
v
Reactor
|
v
epoll_wait
|
+——–+——–+
| | |
v v v
fd4 fd5 fd6
| | |
v v v
Recver Recver Sender
它的优势很明显。
25.1 不需要为每个连接创建一个线程
假设存在:
1000个TCP连接
不需要:
1000个线程
而是可以使用:
一个事件循环
来管理多个连接的I/O事件。
25.2 同一线程中的连接管理比较简单
因为所有连接事件都在同一个线程中执行:
添加Connection
修改Connection
删除Connection
不需要在这些操作之间引入复杂的多线程同步。
25.3 但也存在局限
假设:
Calculate::Cal()
需要执行一个非常耗时的计算任务。
例如:
计算任务执行10秒
那么当前Reactor线程可能在这10秒内无法继续处理其他客户端的事件。
因此:
Reactor能够减少大量线程等待I/O的开销,但不代表业务代码可以无限阻塞事件循环。
这也是后续需要考虑多线程、多Reactor架构的原因。
二十六、One Thread One Loop是什么?
现在进一步学习:
One Thread One Loop,简称OTOL。
它的基本思想是:
每个工作线程都运行一个独立的事件循环。
例如:
线程A
|
v
Reactor A
|
+—- fd4
+—- fd5
线程B
|
v
Reactor B
|
+—- fd6
+—- fd7
线程C
|
v
Reactor C
|
+—- fd8
+—- fd9
每个线程管理自己负责的连接。
26.1 为什么这样设计?
因为一个事件循环线程的处理能力终究有限。
当连接数量较多,业务处理量较大时,我们希望:
多个工作线程
共同分担连接处理任务
但又不希望:
多个线程随意操作同一个Connection
因为那会增加同步和资源竞争的复杂性。
因此可以采用:
每个Connection归属于一个Reactor。
26.2 核心原则
例如:
fd5归Reactor A管理
那么:
fd5的读事件
fd5的写事件
fd5的接收缓冲区
fd5的发送缓冲区
fd5的连接关闭
都由:
Reactor A
负责。
其他工作线程不直接同时处理这个连接的I/O。
这能够减少同一连接被多个线程同时读写而引起的复杂问题。
二十七、Master-Reactor与Worker-Reactor
一种常见的扩展方式是:
Master
|
v
负责接受连接
|
+—- Worker 1
|
+—- Worker 2
|
+—- Worker 3
其中:
Master
负责:
accept()
接受新连接。
随后将连接分配给某个Worker。
Worker负责:
注册Socket
读取请求
执行回调
发送响应
管理连接生命周期
27.1 多线程版本
例如:
主线程
|
v
Master Reactor
|
+—- 工作线程A → Reactor A
|
+—- 工作线程B → Reactor B
|
+—- 工作线程C → Reactor C
由于同一进程中的多个线程共享文件描述符表,所以可以将新客户端fd交给某个工作线程处理。
但是:
fd共享不代表跨线程直接修改另一个Reactor的状态就一定安全。
比较好的方式是:
Master接受连接
|
v
将fd写入对应Worker的任务队列
|
v
通知Worker
|
v
Worker取出fd
|
v
在自己的线程中注册到epoll
这样可以明确连接所有权与线程职责。
27.2 多进程版本
也可以考虑多个进程分别运行自己的Reactor。
例如:
Worker Process A
|
v
Reactor A
Worker Process B
|
v
Reactor B
但多进程与多线程有一个重要区别:
不同进程通常具有不同的文件描述符表。
因此,不能简单地把某个进程中的:
fd=5
这个整数通过普通管道发给另一个进程,就认为对方自动拥有同一条Socket连接。
如果需要跨进程传递已打开的Socket,可以使用Unix域套接字配合:
SCM_RIGHTS
进行文件描述符传递。
这里先理解区别,不展开跨进程传递实现。
二十八、为什么One Thread One Loop需要线程通知机制?
现在考虑一个实际问题。
假设:
Worker A
正在执行:
epoll_wait()
等待事件。
此时:
Master
接收到了新的客户端。
它希望通知Worker A:
有新的fd需要你处理
但是Worker A可能正在阻塞等待自己的epoll事件。
因此需要某种方式:
让Worker的事件循环得知有新的工作任务。
常见选择包括:
pipe
eventfd
因为它们都能够与文件描述符机制配合。
二十九、使用pipe进行线程通知
前面学习Linux进程间通信时,我们接触过:
pipe()
例如:
int pipefds[2];
pipe(pipefds);
其中:
pipefds[0]:
读端
pipefds[1]:
写端
由于同一进程中的线程共享文件描述符,所以线程之间也可以通过管道传递数据。
29.1 基本结构
Master线程
|
| write
v
管道
|
| read
v
Worker线程
例如Master写入:
有新的任务
Worker从管道读取。
29.2 为什么可以和epoll配合?
因为:
pipefds[0]
也是文件描述符。
它可以注册到:
epoll
中。
例如:
Worker Reactor
|
v
epoll同时监视
|
+—- 客户端Socket
|
+—- 管道读端
当Master向管道写入数据时:
管道变得可读
|
v
epoll_wait返回
|
v
Worker读取通知
这样Worker就可以在统一的事件循环中处理:
网络事件
线程间通知事件
29.3 一个简单的管道线程实验
#include <iostream>
#include <thread>
#include <unistd.h>
#include <cstring>
int main()
{
int pipefds[2];
if (pipe(pipefds) < 0)
{
perror("pipe");
return 1;
}
std::thread worker([&]()
{
char buffer[256];
while (true)
{
ssize_t n = read(
pipefds[0],
buffer,
sizeof(buffer)
);
if (n > 0)
{
std::cout
<< "Worker received: ";
std::cout.write(buffer, n);
std::cout << std::endl;
}
else if (n == 0)
{
// 所有写端关闭,出现EOF
break;
}
else
{
perror("read");
break;
}
}
});
const char* message =
"Hello from main thread!";
if (
write(
pipefds[1],
message,
std::strlen(message)
) < 0
)
{
perror("write");
}
// 先关闭写端,让Worker最终能读到EOF
close(pipefds[1]);
worker.join();
close(pipefds[0]);
return 0;
}
编译:
g++ -std=c++11 -pthread \\
pipe_thread.cpp \\
-o pipe_thread
运行:
./pipe_thread
预期:
Worker received: Hello from main thread!
这里有一个细节:
如果希望Worker通过read返回0识别EOF,就需要确保管道的所有写端都已关闭。
否则Worker可能一直等待,导致主线程在:
worker.join();
处无法结束。
29.4 pipe传输的是字节流
还要注意:
管道本身也是字节流通信机制。
如果Master连续向管道写入多个fd编号,需要正确组织消息边界。
例如可以约定:
每条通知使用4字节整数
或者采用其他明确的消息格式。
不能假定一次read一定对应一次write。
三十、eventfd:专门用于事件通知的文件描述符
除了pipe,Linux还提供:
eventfd()
它也是一种重要的事件通知机制。
函数原型:
#include <sys/eventfd.h>
int eventfd(
unsigned int initval,
int flags
);
30.1 eventfd的核心思想
eventfd内部维护一个:
64位计数器。
它可以通过:
write()
增加计数值。
通过:
read()
读取相应计数信息。
因此可以用来通知:
有新的任务
有新的事件
需要唤醒工作线程
30.2 为什么eventfd适合Reactor?
因为:
eventfd()
返回的是:
文件描述符。
所以可以注册:
epoll_ctl(
epfd,
EPOLL_CTL_ADD,
event_fd,
&ev
);
当计数器满足可读条件时:
epoll_wait()
就可以报告对应事件。
于是:
Master线程
|
| write(eventfd)
v
eventfd计数器增加
|
v
Worker的epoll报告读就绪
|
v
Worker读取eventfd
|
v
Worker处理任务
30.3 eventfd能够直接传递任务内容吗?
通常不能把它当作普通消息队列使用。
因为:
eventfd主要传递计数与通知信息。
例如Master希望把:
fd5
交给Worker。
一种常见思路是:
Master
|
v
把fd5放进线程安全任务队列
|
v
write(eventfd)通知Worker
|
v
Worker被epoll唤醒
|
v
读取eventfd
|
v
从任务队列取出fd5
|
v
注册到Worker自己的epoll
这里:
任务队列:
保存具体任务
而:
eventfd:
通知有任务需要处理
两者职责不同。
三十一、eventfd的两种工作模式
eventfd有两种常见读取模式。
31.1 普通模式
不设置:
EFD_SEMAPHORE
假设:
初始计数器 = 0
第一次写入:
1
第二次写入:
2
那么计数器变为:
3
正常情况下,读取会得到:
3
随后计数器清零。
31.2 信号量模式
如果设置:
EFD_SEMAPHORE
那么每次成功读取:
返回1
并使计数器:
减1
例如原来:
计数器 = 3
第一次读取:
返回1,剩余2
第二次读取:
返回1,剩余1
第三次读取:
返回1,剩余0
31.3 eventfd实验
文件:
eventfd_demo.cpp
完整代码:
#include <iostream>
#include <cstdint>
#include <cerrno>
#include <cstring>
#include <sys/eventfd.h>
#include <unistd.h>
int main(int argc, char* argv[])
{
bool semaphore_mode =
argc > 1 &&
std::strcmp(argv[1], "sem") == 0;
int flags =
EFD_NONBLOCK | EFD_CLOEXEC;
if (semaphore_mode)
{
flags |= EFD_SEMAPHORE;
}
int efd = eventfd(0, flags);
if (efd < 0)
{
perror("eventfd");
return 1;
}
uint64_t a = 1;
uint64_t b = 2;
write(efd, &a, sizeof(a));
write(efd, &b, sizeof(b));
for (int i = 0; i < 4; ++i)
{
uint64_t value = 0;
ssize_t n = read(
efd,
&value,
sizeof(value)
);
if (n == sizeof(value))
{
std::cout
<< "Read value: "
<< value
<< std::endl;
}
else if (
n < 0 &&
errno == EAGAIN
)
{
std::cout
<< "EAGAIN: counter is empty"
<< std::endl;
break;
}
else
{
perror("read");
break;
}
}
close(efd);
return 0;
}
编译:
g++ -std=c++11 -Wall -Wextra \\
eventfd_demo.cpp \\
-o eventfd_demo
普通模式:
./eventfd_demo
预期:
Read value: 3
EAGAIN: counter is empty
信号量模式:
./eventfd_demo sem
预期:
Read value: 1
Read value: 1
Read value: 1
EAGAIN: counter is empty
特别注意:
普通模式第一次读取后计数器已清零。
因此,在设置了:
EFD_NONBLOCK
的情况下,下一次读取通常返回:
-1
并设置:
errno = EAGAIN;
而不是正常读取一个数值0。
三十二、eventfd与pipe怎样选择?
| 主要用途 | 字节流通信 | 事件计数与通知 |
| 返回描述符 | 读端、写端两个fd | 一个eventfd |
| 是否能传递任意字节内容 | 可以 | 不适合 |
| 是否适合通知Worker | 可以 | 可以 |
| 是否能被epoll监视 | 可以 | 可以 |
| 内部机制 | 管道缓冲区 | 64位计数器 |
| 典型用途 | 数据传输与通知 | 轻量级事件唤醒 |
因此:
如果需要传输具体字节数据,可以考虑pipe。
如果主要需要通知工作线程有任务,eventfd通常是一个合适选择。
如果通过eventfd通知Worker处理具体任务,则通常还需要配合:
线程安全队列
保存任务内容。
三十三、单Reactor与多Reactor的关系
到这里,我们已经能够理解Reactor从简单到复杂的演进。
33.1 单Reactor单线程
一个Reactor
|
v
一个事件循环
|
v
管理多个Socket
优点:
结构简单
容易调试
不需要复杂的跨线程连接管理
局限:
单个事件循环线程的执行能力有限
33.2 One Thread One Loop
线程A → Reactor A
线程B → Reactor B
线程C → Reactor C
不同线程分别管理不同连接。
优点:
能够利用多个CPU核心
各个Reactor负责自己的连接
减少单个Reactor的负载
但需要考虑:
连接分配
线程通知
任务队列
工作线程之间的协调
33.3 为什么不能简单地让多个线程同时处理一个Connection?
因为同一个Connection可能包含:
_inbuffer
以及:
_outbuffer
如果多个线程同时修改这些缓冲区,就可能产生数据竞争。
因此OTOL强调:
一个Connection的I/O生命周期尽量由所属的Reactor线程管理。
这并不意味着整个程序完全不需要锁。
例如:
Master向Worker任务队列写入数据
Worker从任务队列读取数据
如果多个线程共享队列,仍然需要正确的同步机制。
三十四、Reactor模式的优点
34.1 优点一:减少为每个连接创建独立线程的需求
传统一连接一线程模型:
连接1 → 线程1
连接2 → 线程2
连接3 → 线程3
Reactor:
多个连接
|
v
一个事件循环
可以使用更少的线程管理大量I/O连接。
34.2 优点二:事件处理职责清晰
例如:
Accepter:
处理新连接
Recver:
接收数据
Sender:
发送数据
Excepter:
处理连接关闭
使得不同功能相对独立。
34.3 优点三:便于扩展
例如增加新的业务处理模块:
HTTP解析
计算服务
消息服务
可以在保留底层事件分发结构的情况下,替换或扩展业务逻辑。
34.4 优点四:便于扩展为多Reactor
当单线程事件循环无法满足需求时,可以继续设计:
Master-Reactor
Worker-Reactor
或者:
One Thread One Loop
架构。
三十五、Reactor模式的缺点
35.1 缺点一:实现复杂度增加
相比简单阻塞式服务器:
accept()
recv()
send()
Reactor需要维护更多状态。
例如:
Connection对象
事件注册关系
读写缓冲区
回调函数
异常关闭逻辑
35.2 缺点二:必须正确处理非阻塞IO
特别是ET模式:
accept直到EAGAIN
recv直到EAGAIN
send部分发送
开启或关闭EPOLLOUT
如果处理错误,可能造成:
事件遗漏
CPU空转
响应数据丢失
客户端长时间无响应
35.3 缺点三:业务函数不能长时间占用事件循环
例如:
handler(req, &resp);
如果执行时间过长,就会影响其他连接的响应。
所以真正的高性能服务器不仅需要高效I/O,还需要合理的业务调度。
35.4 缺点四:对象生命周期管理较复杂
需要明确:
谁创建Connection?
谁保存Connection?
谁负责关闭fd?
回调执行时对象是否仍然存活?
否则可能产生:
重复close
内存泄漏
悬空指针
使用已释放对象
等问题。
三十六、Reactor常见面试问题
36.1 什么是Reactor?
Reactor是一种事件驱动设计模式。
它通过事件循环等待I/O就绪事件,并把事件分发给对应的处理函数。
36.2 Reactor和epoll有什么区别?
epoll是Linux提供的I/O多路转接机制。
Reactor是基于事件检测与分发组织程序的软件设计模式。
36.3 Reactor是不是异步IO?
基于epoll就绪通知的Reactor,在经典I/O模型中通常属于同步I/O多路转接。
因为真正的读写仍然由应用程序执行。
36.4 Connection有什么作用?
保存单个连接的:
fd
输入缓冲区
输出缓冲区
关注事件
读写异常回调
等状态。
36.5 为什么需要ConnectionFactory?
因为监听Socket和普通客户端Socket需要注册不同的事件处理函数。
36.6 为什么需要Accepter?
为了将新连接的接受逻辑从普通连接的读写逻辑中分离。
36.7 HandlerConnection中的四个函数是什么?
HandlerRequest()
负责协议与业务处理。
Recver()
负责读取。
Sender()
负责发送。
Excepter()
负责异常处理与资源释放。
36.8 为什么ET模式要循环accept?
因为待接受队列中可能存在多个连接,必须处理到当前没有更多可接受连接的状态,不能依赖旧就绪条件被重复通知。
36.9 为什么ET模式要循环recv?
因为一次recv不保证读完当前所有可读取的数据。
一般采用非阻塞Socket,持续读取到EAGAIN或EWOULDBLOCK。
36.10 Sender遇到EAGAIN怎么办?
保留未发送数据。
按需注册EPOLLOUT。
等写就绪后继续发送。
36.11 为什么有了epoll还需要回调函数?
因为epoll负责报告事件。
回调函数负责把不同事件映射到对应的处理逻辑。
36.12 什么是One Thread One Loop?
每个线程运行独立事件循环,管理自己负责的连接。
36.13 为什么需要eventfd?
因为工作线程可能阻塞在epoll_wait中。
eventfd能够提供基于文件描述符的事件通知机制,帮助唤醒事件循环。
36.14 eventfd能直接传递Connection对象吗?
eventfd主要用于计数和通知。
如果需要传递具体任务,通常还需要任务队列等机制保存任务内容。
36.15 Reactor最大的价值是什么?
把I/O事件等待、事件分发、连接管理和具体处理逻辑分离,从而提高网络服务器的可维护性与扩展能力。
三十七、全文知识体系总结
Reactor反应堆模式
│
├── 一、基本思想
│ ├── 事件驱动
│ ├── I/O就绪通知
│ ├── 事件循环
│ └── 回调分发
│
├── 二、核心组件
│ │
│ ├── Connection
│ │ ├── sockfd
│ │ ├── inbuffer
│ │ ├── outbuffer
│ │ ├── events
│ │ ├── recver
│ │ ├── sender
│ │ └── excepter
│ │
│ ├── ConnectionFactory
│ │ ├── 监听Connection
│ │ └── 普通Connection
│ │
│ ├── Accepter
│ │ └── 循环accept
│ │
│ ├── HandlerConnection
│ │ ├── Recver
│ │ ├── HandlerRequest
│ │ ├── Sender
│ │ └── Excepter
│ │
│ └── TcpServer
│ ├── Init
│ ├── Loop
│ ├── AddConnection
│ ├── RemoveConnection
│ └── EnableReadWrite
│
├── 三、协议处理
│ ├── Decode
│ ├── Deserialize
│ ├── Calculate
│ ├── Serialize
│ └── Encode
│
├── 四、非阻塞IO
│ ├── O_NONBLOCK
│ ├── EPOLLIN
│ ├── EPOLLOUT
│ ├── EPOLLET
│ ├── EAGAIN
│ ├── 部分发送
│ └── 缓冲区管理
│
└── 五、扩展架构
├── 单Reactor单线程
├── One Thread One Loop
├── Master-Reactor
├── Worker-Reactor
├── pipe线程通知
├── eventfd事件通知
├── EFD_NONBLOCK
└── EFD_SEMAPHORE
三十八、全文总结
本文从epoll服务器的事件循环出发,学习了Reactor反应堆模式。
首先,我们明确了:
epoll负责检测I/O就绪事件,Reactor负责组织事件分发与处理。
随后通过打地鼠游戏,理解了:
Socket连接
就绪事件
Reactor事件循环
回调函数
之间的关系。
接下来设计了Reactor服务器的核心组件。
其中:
Connection:
负责保存连接状态。
ConnectionFactory:
负责创建不同类型的Connection,并设置回调。
Accepter:
负责接入新连接。
HandlerConnection:
负责处理接收、发送、业务请求和连接异常。
TcpServer:
负责epoll实例管理、连接管理和事件分发。
随后进一步学习了应用层协议处理流程:
Decode
|
v
Deserialize
|
v
Calculate
|
v
Serialize
|
v
Encode
并通过完整的C++11代码,实现了一个基于epoll ET模式的TCP计算服务器。
在非阻塞I/O处理方面,重点解决了:
循环accept直到EAGAIN
循环recv直到EAGAIN
部分发送
发送缓冲区管理
EPOLLOUT动态开关
客户端断开后的连接清理
最后,我们学习了:
One Thread One Loop。
即:
一个线程
对应一个Reactor
管理一组Connection
并认识了使用:
pipe
eventfd
实现事件循环通知的基本思想。
最终可以用一句话总结:
Reactor不是一种新的I/O系统调用,而是一种基于I/O就绪通知、连接状态管理和事件回调分发构建高并发网络服务器的软件设计模式。
当掌握了:
epoll
非阻塞IO
Connection
回调函数
事件循环
输入输出缓冲区
以后,就已经具备进一步学习多Reactor、多线程事件驱动服务器的基础。


评论前必须登录!
注册