 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把“为什么会这样”和“应该怎样解决”说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:从“会用 epoll”走向“会组织网络服务器”,用一个 TCP 计算器串起连接接入、非阻塞读写、协议解析和连接回收。
💡 学习目标:看懂 Reactor 的职责划分,掌握 Connection、回调分派、ET 读写循环、按需订阅 EPOLLOUT,以及安全关闭连接的顺序。
📌 实验环境:Linux、C++17、IPv4 TCP;服务只绑定 127.0.0.1:9090。示例采用单线程 Reactor,适合观察执行顺序;不包含完整的超时、认证和生产级过载治理。
第一次写 epoll 服务器时,代码往往很直白:epoll_wait() 返回,检查事件类型,调用 accept() 或 recv(),再把结果发回去。
问题会在功能增加后出现:监听连接和普通连接混在同一个大循环里;半条请求不知道放在哪里;一次没发完的应答丢了;读回调关闭连接后,写回调还拿着旧指针继续执行。
这些问题并不是再背一个 epoll 参数就能解决的。我们需要给事件、连接状态和处理逻辑安排稳定的位置。Reactor 的价值,在于把“什么时候可以处理”和“具体怎样处理”组织成一套可持续运转的结构。
本文先完成单 Reactor。下一篇再把它扩展到 One Thread One Loop,并解释任务队列怎样借助 eventfd 叫醒目标线程。
文章目录
一、Reactor 到底比 epoll 多了什么
1.1 先从一个接待台理解分工
想象一个服务大厅:有人刚进门,有人的材料已备齐,有人的结果已经可以领取。接待台不会一直盯着一个还没准备好的人,而是在条件满足时,把事情交给对应的处理人员。
放到程序里,socket 是被观察的对象,可读、可写是就绪条件,epoll 负责等待这些条件,事件循环负责分派,回调执行实际工作。接待台的类比只解释调度关系:在本文的单线程实现里,回调仍然依次执行,不会凭空产生并行的工作人员。
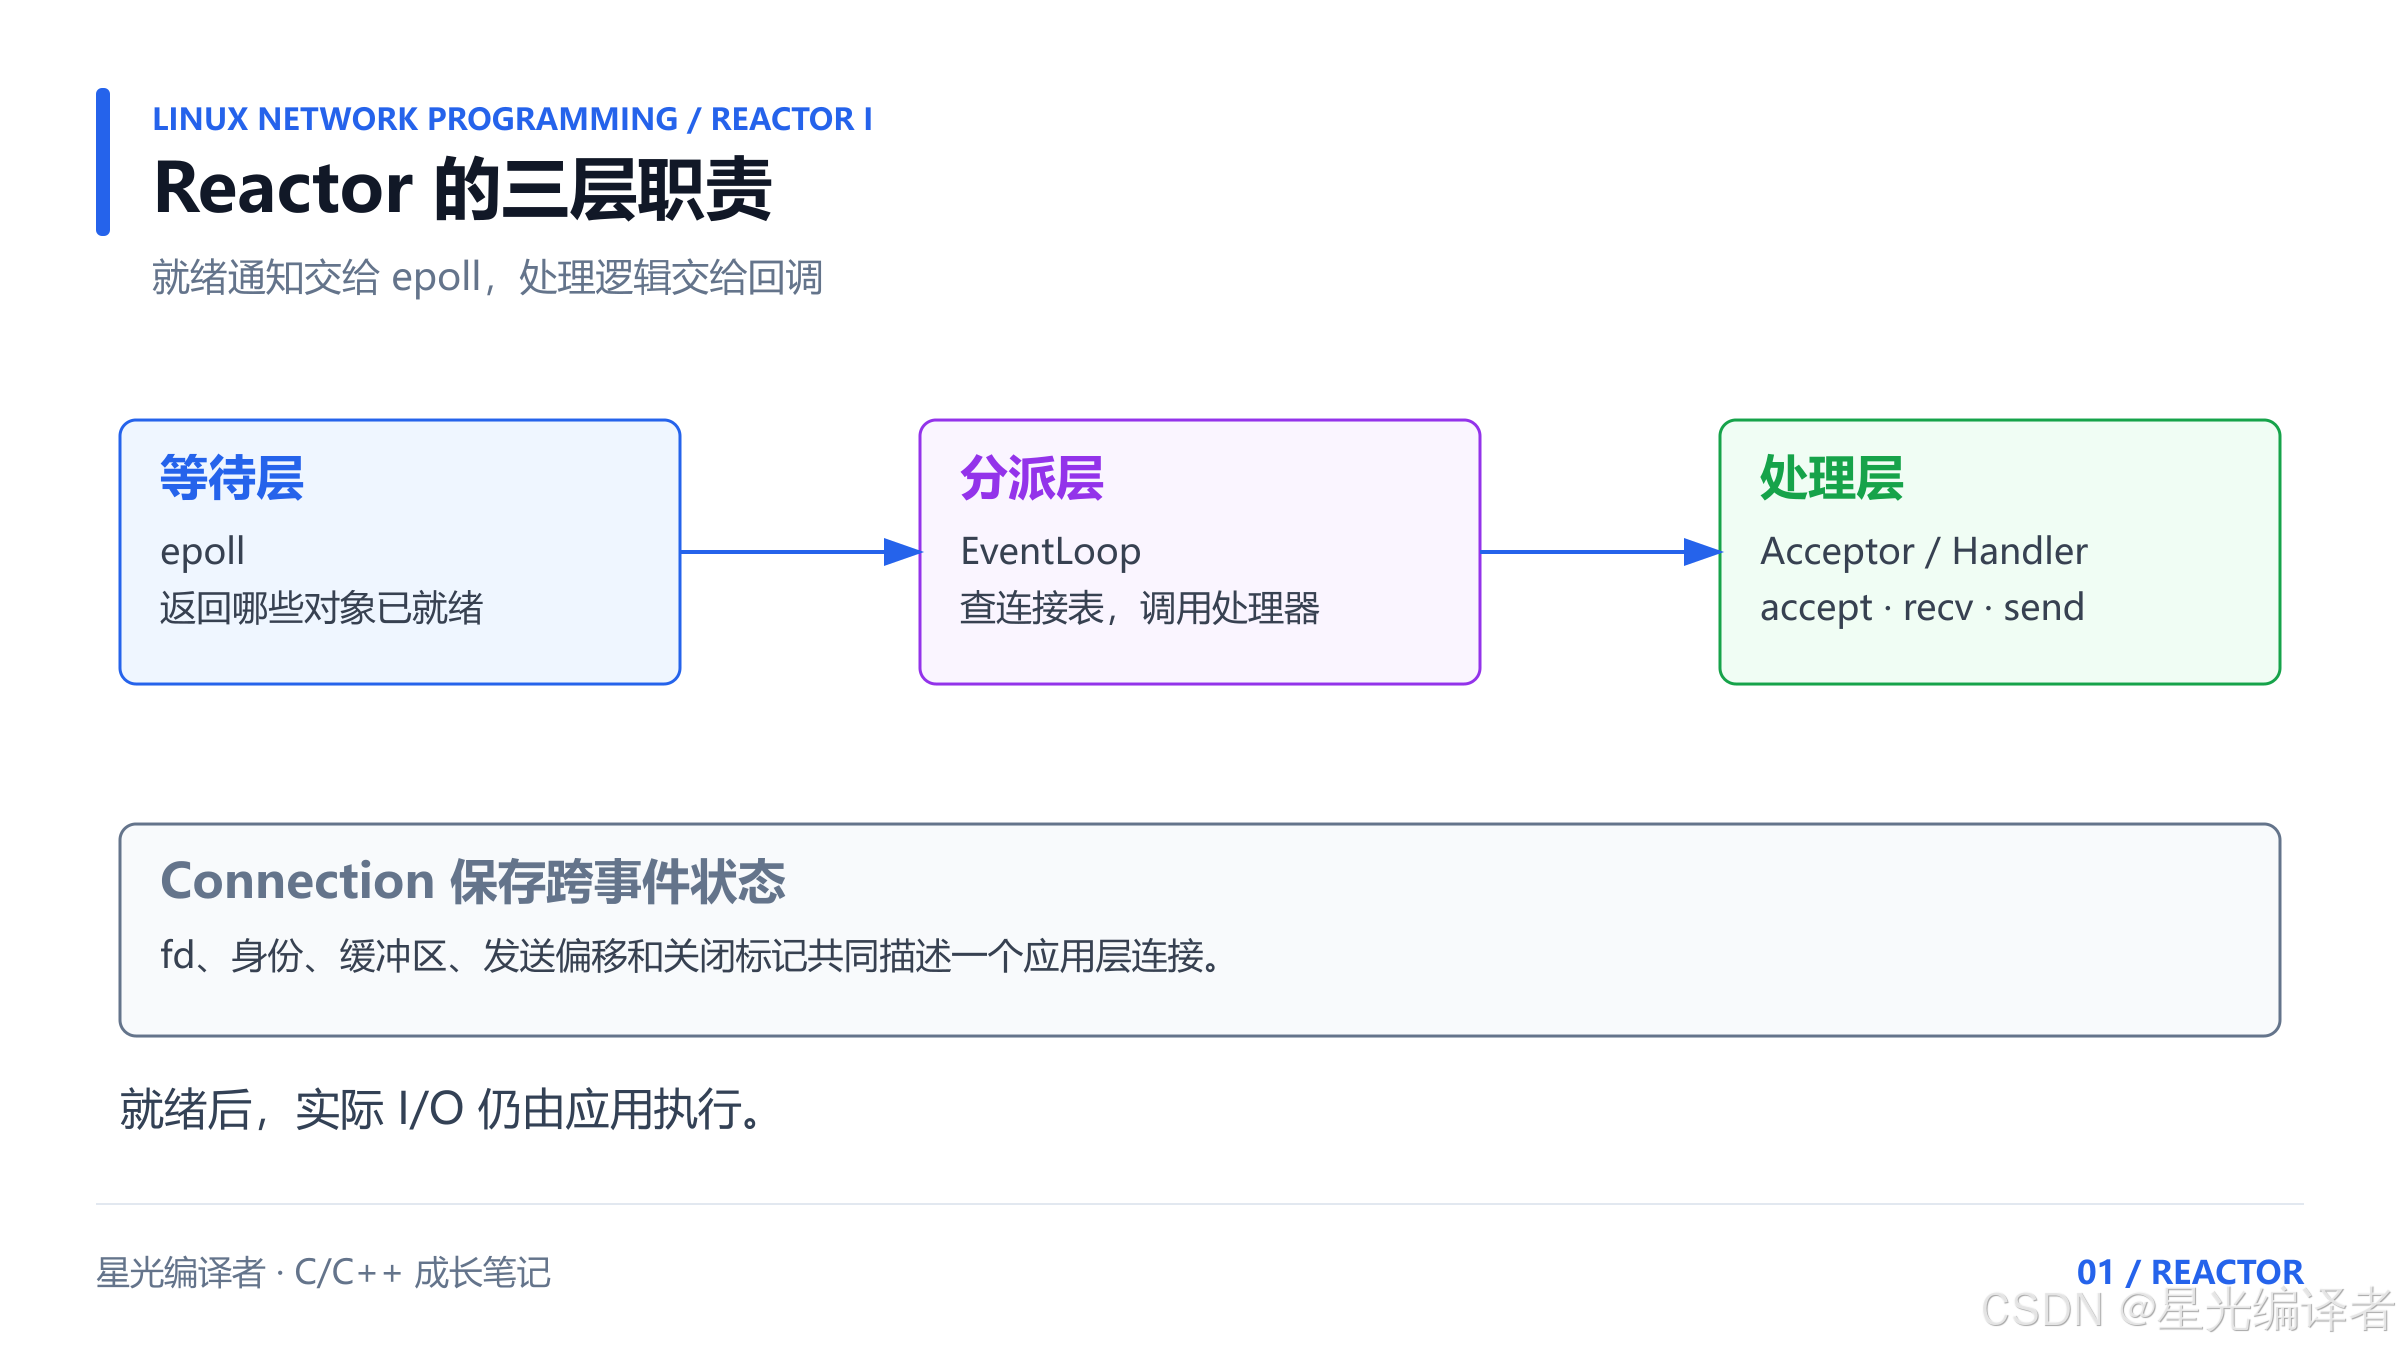
| Handle | 监听 fd、连接 fd | 标识被观察的 I/O 对象 |
| Demultiplexer | epoll | 等待并返回就绪事件 |
| Reactor / Dispatcher | 事件循环、连接表 | 根据事件找到处理器 |
| Event Handler | 接入、读取、发送回调 | 推进一次连接处理 |
| Connection | 缓冲区、状态、回调集合 | 保留跨多轮事件的上下文 |
epoll 是 Linux 上实现 Reactor 的一种工具。换成 poll、select,组织方式仍然可以是 Reactor;只调用了 epoll,也不代表连接管理自然就有了良好的结构。
1.2 就绪通知不是完成通知
EPOLLIN 到来后,应用仍然要调用 recv(),再解析字节。EPOLLOUT 到来后,应用仍然要调用 send(),并处理部分发送。内核没有替我们完成业务层读取,也不会自动执行回调。epoll 手册
因此,Reactor 通常按“就绪后由应用执行 I/O”来理解。Proactor 的典型组织方式则围绕已提交操作的完成通知展开。二者不能仅用“有没有线程池”区分:线程数与 I/O 通知语义是不同的维度。
1.3 等待可以阻塞,连接操作使用非阻塞
这里的“非阻塞服务器”并不是让 CPU 一直转。没有事件时,线程可以停在 epoll_wait(…, -1);被唤醒后,socket 的读写不能因为暂时缺少数据或空间而长时间挂住整个循环。
还要检查回调内部的业务:同步查远程数据库、等待磁盘、长时间计算,都可能拖住这一条线程。Reactor 解决的是调度组织问题,不会把所有慢操作自动变快。
二、Connection:把连接的上下文收拢起来
2.1 fd 只是入口,连接还需要记忆
客户端第一次送来 12 +,第二次才送来 30\\n。如果我们只记住 fd,第一次的内容就没有可靠的归属。发送也类似:应答有 100 字节,本轮只交给内核 40 字节,下轮必须接着发送剩余的 60 字节。
Connection 正是保存这些信息的地方。它不等于内核中的 TCP 连接,而是应用层为这个连接建立的上下文。
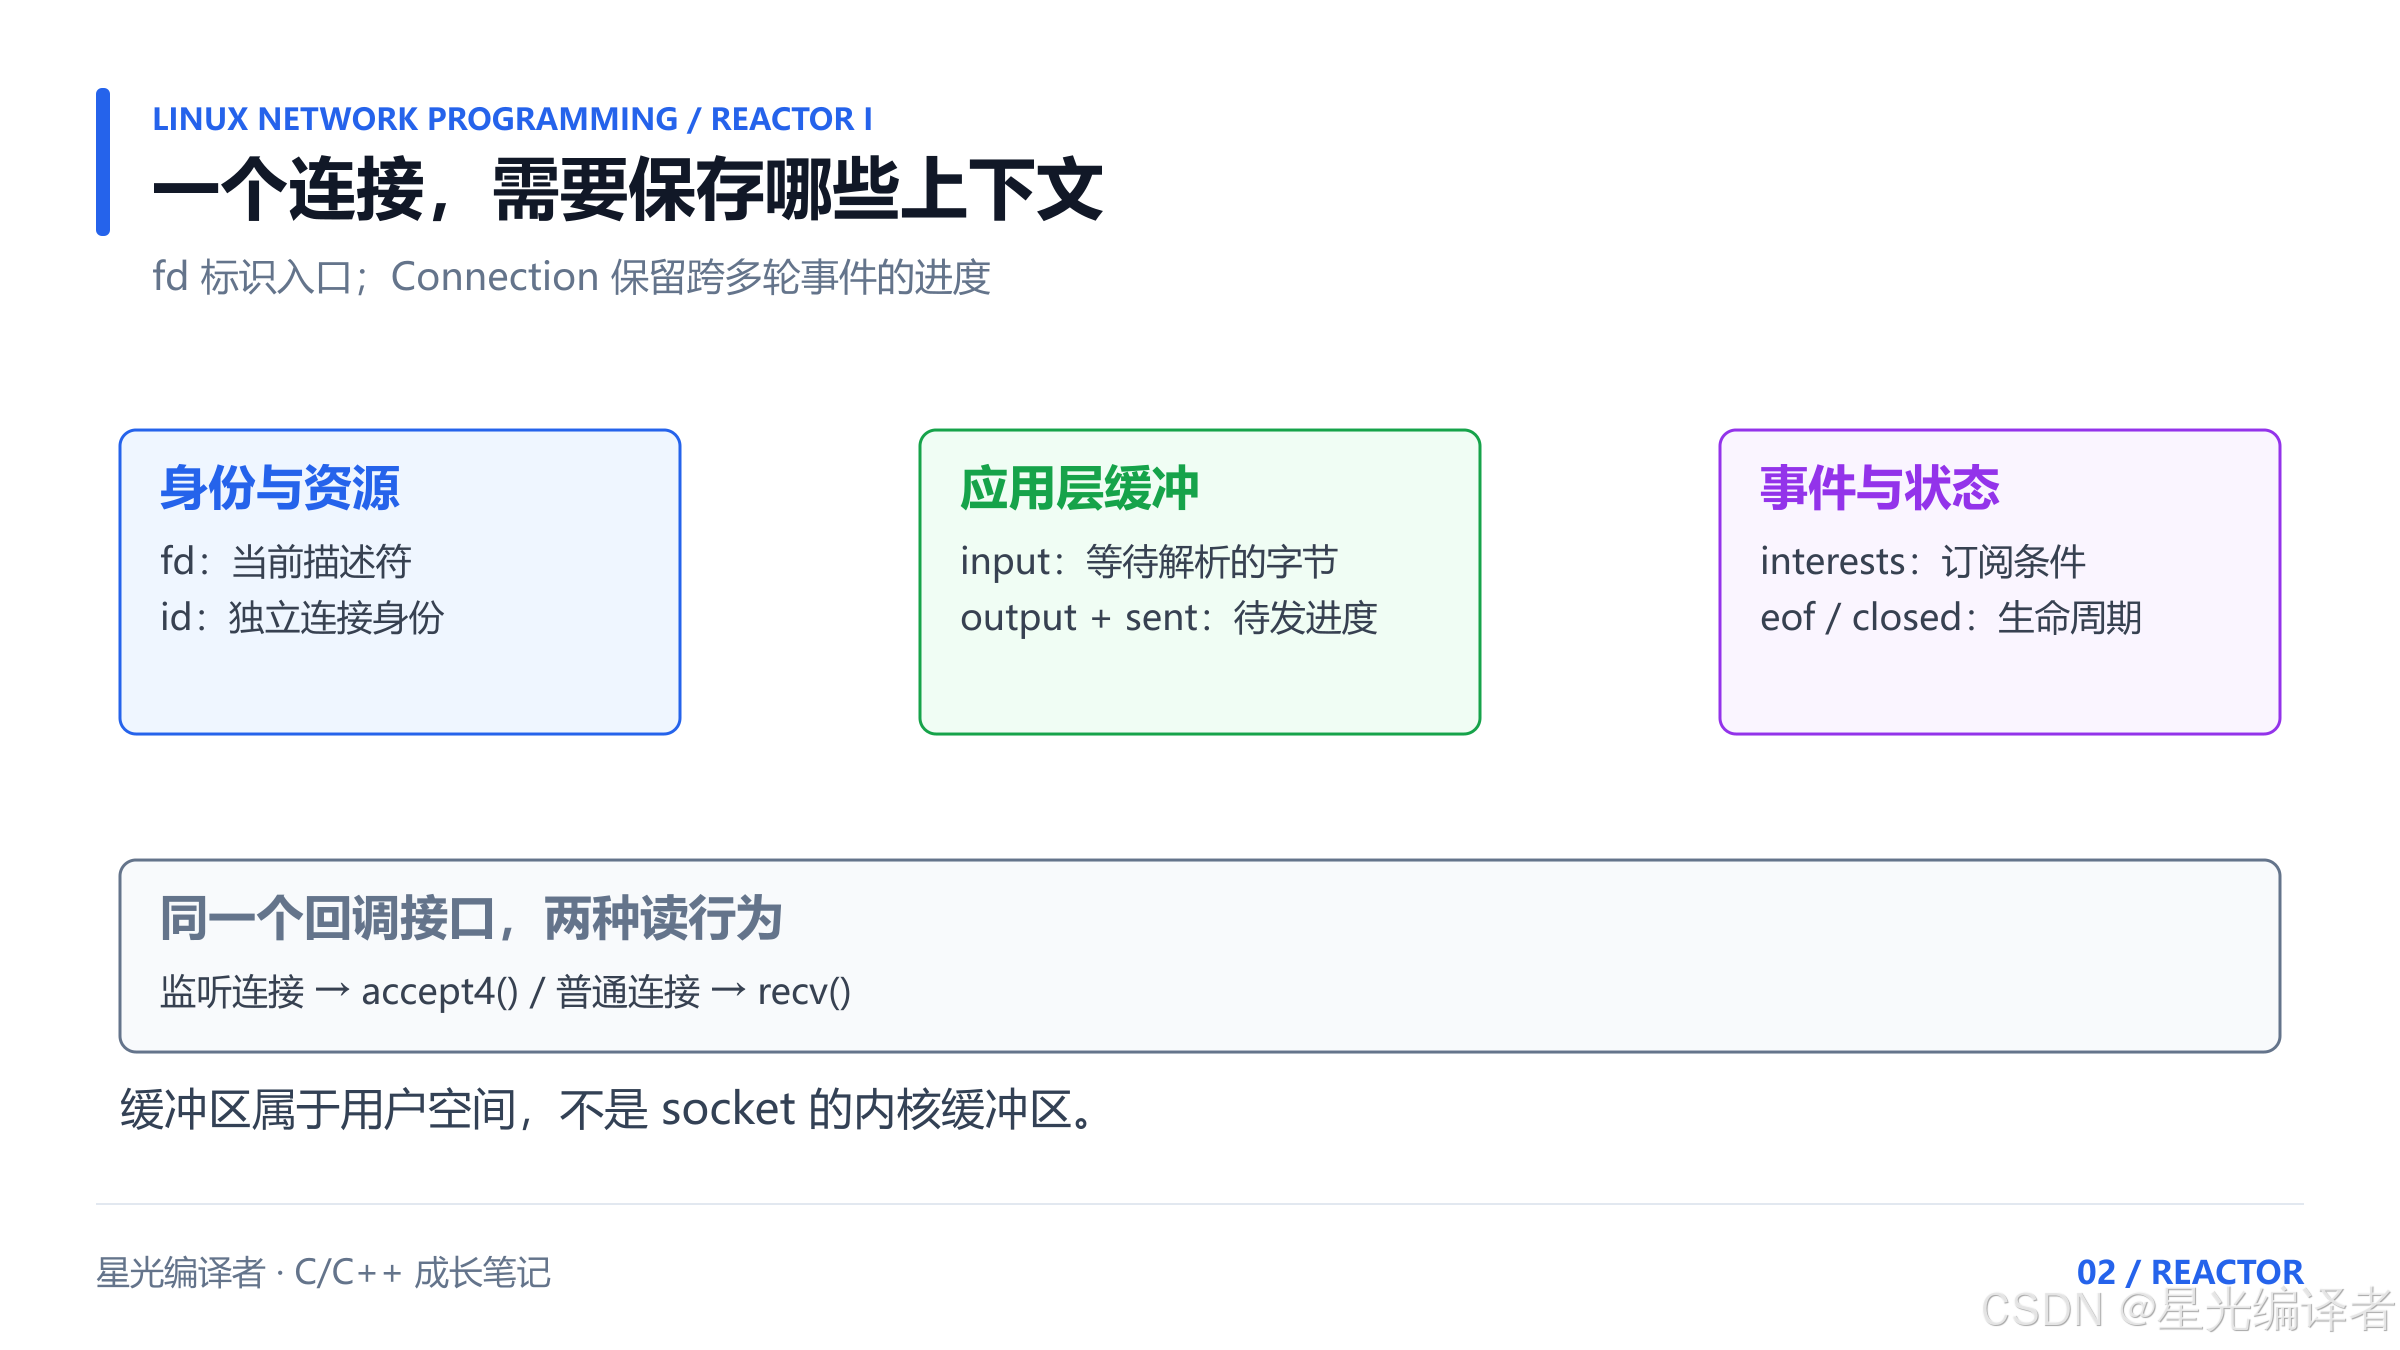
本文的关键字段可以这样阅读:
int fd; // 当前持有的描述符
std::uint64_t id; // 本次连接的独立身份
std::uint32_t interests; // 当前向 epoll 订阅的事件
std::string input, output; // 应用层输入、输出缓冲
std::size_t sent; // output 中已经发送的字节数
bool eof, closed; // 读端结束与整体关闭分开记录
std::function<void(Connection&)> readable, writable;
input、output 都在用户空间。它们与 socket 的内核接收、发送缓冲区不是同一块内存。应用层缓冲用于协议拼接和跨事件保存进度,不能因为“TCP 已经有缓冲”就省掉。
2.2 回调统一接口,行为按对象变化
监听 socket 的读回调调用 accept4();普通连接的读回调调用 recv()。事件循环只需要知道“这个对象可读时执行哪个函数”,不必在循环里堆满不同业务的条件分支。
listener->readable = [this](Connection& c) { accept_all(c); };
client->readable = [this](Connection& c) { receive(c); };
client->writable = [this](Connection& c) { flush(c); };
这里用 lambda 捕获 Reactor 的 this,表达“回调所属的管理器”。它没有延长 Reactor 的生命周期,因此对象销毁顺序必须保证所有连接和回调先停止使用管理器。本文将连接表作为 Reactor 的成员,由同一线程管理,析构时先清空连接表。
如果采用静态处理函数,也可以在 Connection 中保存指向 Reactor 的非拥有指针。两种写法都要回答同一个问题:谁创建连接、谁销毁连接,以及回调执行时管理器是否仍然存在。
2.3 interests 与 returned events 不要混用
interests 表示“我想等哪些条件”,epoll_wait() 返回的 events 表示“这一次发生了哪些条件”。二者经常使用同一组位常量,但不能当作同一个变量来维护。
修改订阅时,先计算目标掩码,再调用 EPOLL_CTL_MOD;成功后才更新 Connection 中的记录。否则内核仍按旧掩码监控,用户空间却以为已经切换成功,后续排查会非常困难。
三、事件循环如何找到正确的回调
3.1 一轮循环只做三件事
第一,等待就绪事件;第二,用事件携带的身份查找连接;第三,执行适合的回调。这一层不关心计算器如何加减乘除,也不需要认识文本协议的分隔符。
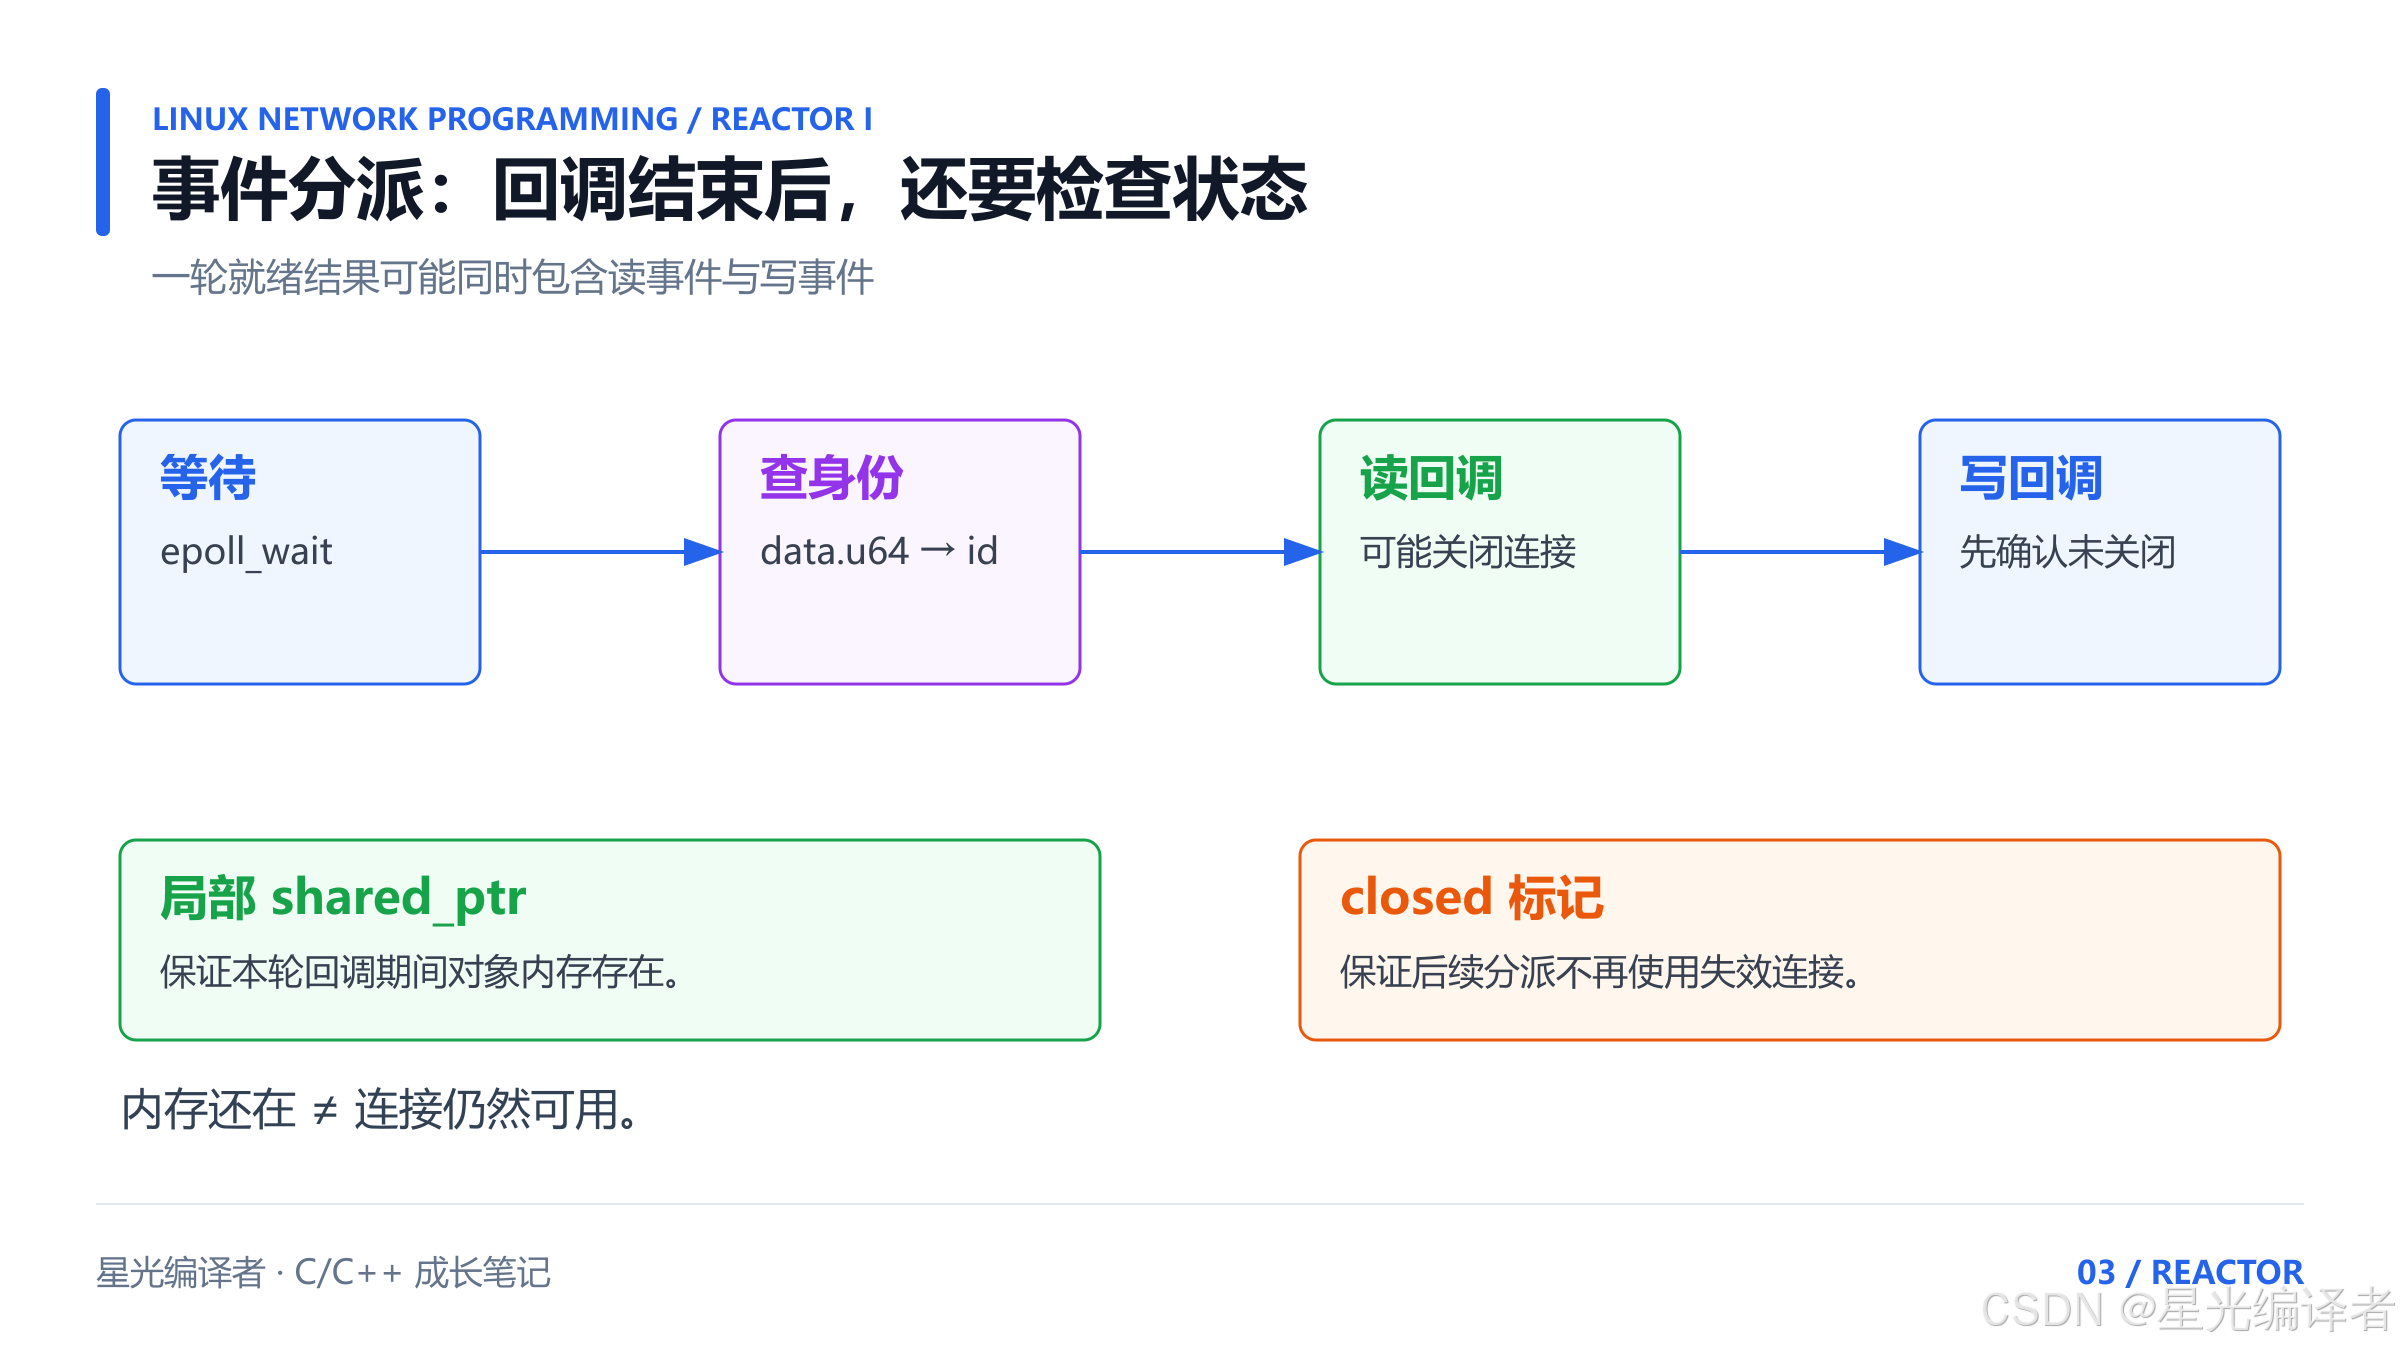
auto found = connections_.find(ready[i].data.u64);
if (found == connections_.end()) continue;
auto c = found->second; // 本轮暂时持有对象
if ((events & (EPOLLIN | EPOLLRDHUP | EPOLLHUP)) && c->readable)
c->readable(*c);
if (!c->closed && (events & EPOLLOUT) && c->writable)
c->writable(*c);
完整程序还会先处理 EPOLLERR。它对普通连接采用直接关闭策略;遇到监听 fd 的错误则明确终止,让故障可见。需要更细诊断时,可以读取 SO_ERROR 并记录错误原因。
3.2 为什么不直接把 fd 当成永久身份
fd 数字会复用。旧连接关闭了 fd 7,新连接可能马上又得到 fd 7。如果一个延迟任务只携带数字 7,它无法说明自己究竟属于哪一代连接。
本文用单调递增的 uint64_t id 标识连接,把它写进 epoll_event.data.u64,连接表也按 id 查找。旧身份查不到就跳过;新连接即使复用了 fd,也不会继承旧身份。计数溢出时程序拒绝继续分配,而不是回绕后重用身份。
这是一种明确的身份管理方案,不是声称 epoll 每次关闭后都必然返回旧事件。它尤其适合以后扩展任务队列、超时回调和异步业务结果时保持一致的校验方式。
3.3 shared_ptr 与 closed 各解决一个问题
本轮持有 shared_ptr,是为了让对象内存活到回调结束。读回调从连接表移除对象后,局部变量仍能保证内存有效。
closed 则表示连接已经逻辑失效。即使对象内存还在,也不能继续发送。内存仍存在,不代表 fd 仍可用。 因此读回调之后还要检查 closed,再决定是否执行写回调。
这也不意味着 shared_ptr 自动解决多线程并发。它不保护 input、output 等字段;本文的安全前提是所有连接操作在同一条事件循环线程中执行。
四、Acceptor:新连接也走事件驱动
4.1 监听 socket 可读时,要处理的是连接队列
监听 fd 注册 EPOLLIN | EPOLLET 后,读就绪表示可以尝试接受连接。它不应该进入普通连接的协议解析流程。
ET 模式下,一次通知可能对应多条待接受连接。若只接受一条就回去睡眠,队列里剩下的工作可能无法及时得到处理。本文连续调用 accept4(),直到暂时没有连接可取。
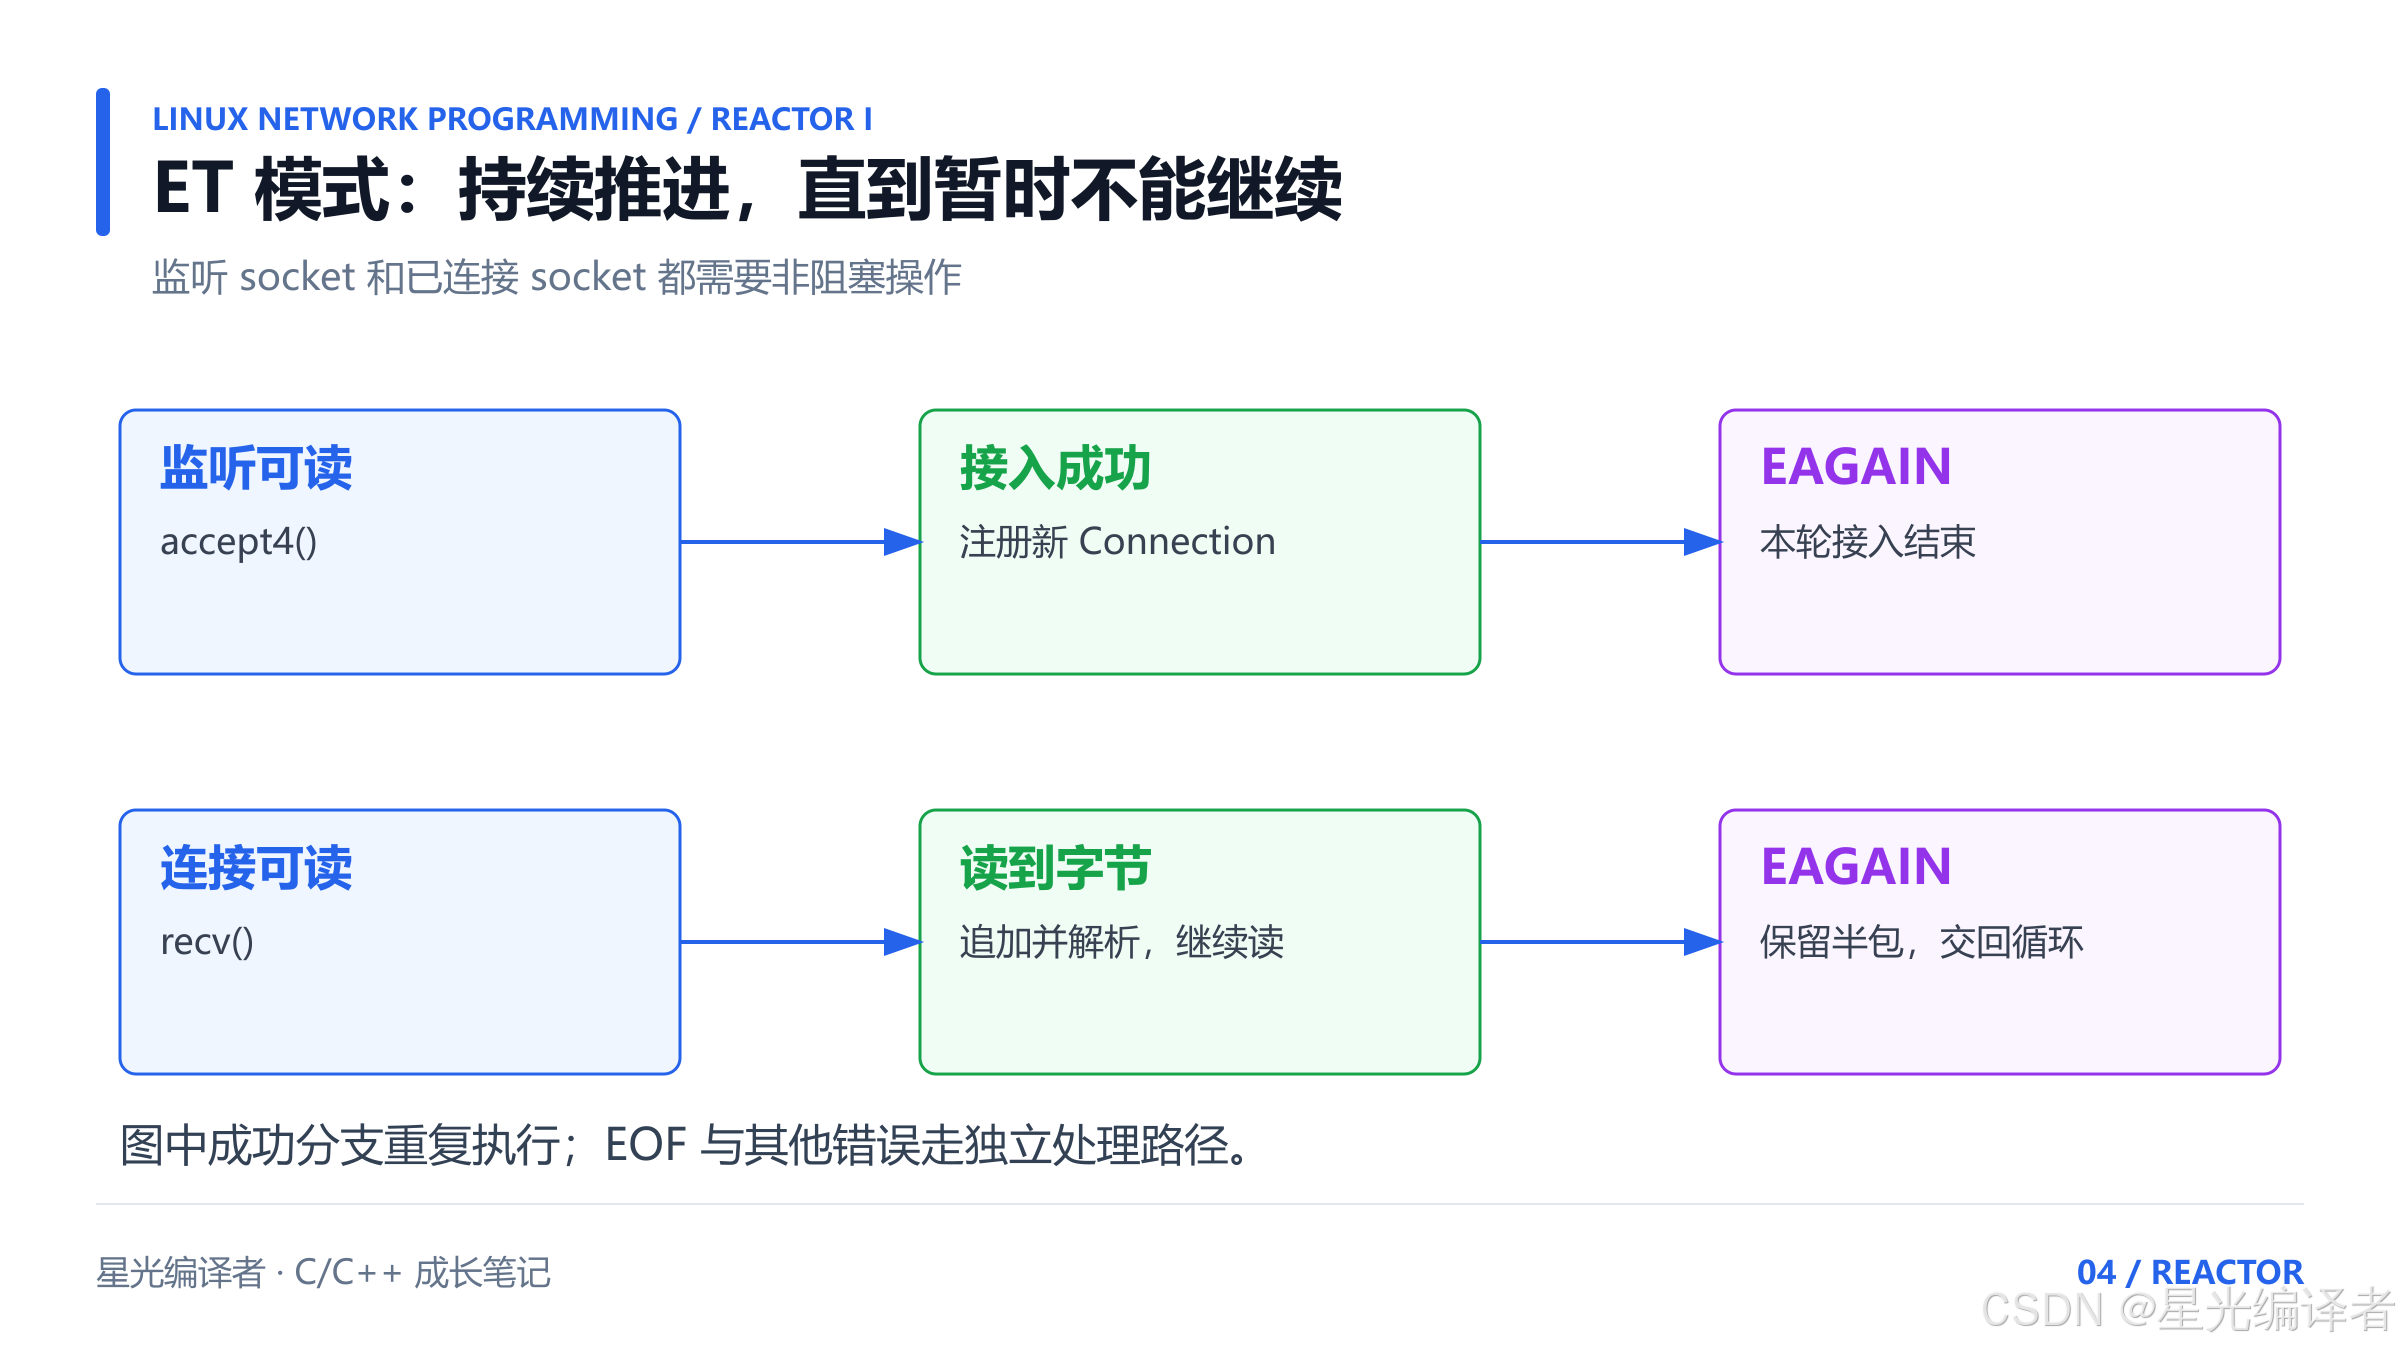
int fd = accept4(listener, nullptr, nullptr,
SOCK_NONBLOCK | SOCK_CLOEXEC);
if (fd >= 0) {
// 创建 Connection,安装回调,加入 epoll 与连接表。
} else if (errno == EINTR) {
// 继续尝试。
} else if (errno == EAGAIN || errno == EWOULDBLOCK) {
// 本轮接入结束。
}
成功条件是 fd >= 0,不是 fd > 0。描述符 0 同样合法。Linux 上普通 accept() 返回的新 socket 也不能假设继承监听 socket 的非阻塞属性;accept4() 直接设置两个标志,能让这个约束清楚地落在创建点。accept 手册
4.2 失败时不能留下半注册连接
建立一个应用层连接至少涉及:持有 fd、创建对象、加入管理表、向 epoll 注册。任何一步失败,都要有明确的回收路径。
示例先由 Connection 持有 fd,再将对象放入表;若 EPOLL_CTL_ADD 失败,移除表项并抛出错误,局部智能指针最终释放 fd。成功后才进入正常事件分派。
对暂时的连接中止或 Linux 接入阶段可重试网络错误,继续接受下一条;对 EMFILE 等资源耗尽问题,本例采用终止服务的教学策略。正式服务通常还需要保留 fd、接入退避和重试定时器,不能在 ET 回调里随意 break 后期待必然再被叫醒。
五、读到 EAGAIN,与读到一个完整请求
5.1 先按返回值分类,再决定下一步
| n > 0 | 收到 n 字节 | 按长度追加,解析完整请求,继续读 |
| n == 0 | TCP 对端有序结束发送 | 标记 EOF,处理剩余半包,排空响应 |
| n < 0 且 EINTR | 操作被信号打断 | 重试 |
| n < 0 且 EAGAIN/EWOULDBLOCK | 当前没有更多可读字节 | 结束本轮读取 |
| 其他错误 | 连接无法按正常路径继续 | 清理连接 |
不要先看 errno,再判断 recv() 是否成功。它不是每次调用都会清零的“当前状态栏”,只有返回值指示失败时才有相应意义。recv 手册
ssize_t n = recv(c.fd, buf, sizeof(buf), 0);
if (n > 0) c.input.append(buf, static_cast<std::size_t>(n));
这里使用显式长度。std::string(buf) 或 input += buf 会按 C 字符串规则寻找 \\0,既不能表达一般字节流,也可能越过本次有效数据的边界。
5.2 EAGAIN 不是消息结束符
客户端可能只发送了半条请求,然后停了一秒。服务端读到 EAGAIN,只能说明此刻内核接收缓冲区没有更多可取数据,不能说明应用层请求完整。
反过来,一次 recv() 也可能读到三条请求加半条。网络分段、应用调用次数与业务消息数量之间,没有一一对应关系。我们必须把已经读到的字节留在 input,由协议规则决定何时取走一条消息。
5.3 收到 FIN,也可能还有应答没发完
客户端可以先发送请求,再执行 shutdown(SHUT_WR),表示“不再发送”,同时继续接收服务器响应。若服务端一看到 EPOLLRDHUP 就直接关闭,可能丢掉已经收到的请求或尚未发送的结果。
本例把挂断提示送进读取路径,用 recv() 消费数据并确认 EOF;随后关闭读关注,继续发送已有结果,最后再关闭整个连接。EPOLLRDHUP、EPOLLHUP 与数据可读可能同时出现,不能把它们理解成“缓冲区一定为空”。epoll_ctl 手册
六、协议解析与业务处理怎样分层
6.1 选一个足够简单的协议
每个请求以换行符结尾,内容是“整数 运算符 整数”。操作数限定在 [-1000000000, 1000000000],支持 + – * /。服务器返回一行 OK 结果 或 ERR 原因。
请求:12 + 30\\n 响应:OK 42\\n
请求:9 / 0\\n 响应:ERR divide_by_zero\\n
请求:7 * -8\\n 响应:OK -56\\n
单行最大 256 字节,不包括终止换行。整数除法按 C++ 规则向零截断。限制操作数范围,使乘法结果也能放入有符号 64 位整数,避免让算术溢出掩盖网络机制。
6.2 四步走,别把业务写进 recv 分支
读取层负责获得字节;协议层负责查找 \\n 并取出完整行;计算层负责校验字段与计算;响应层负责把结果编码后放入输出缓冲。
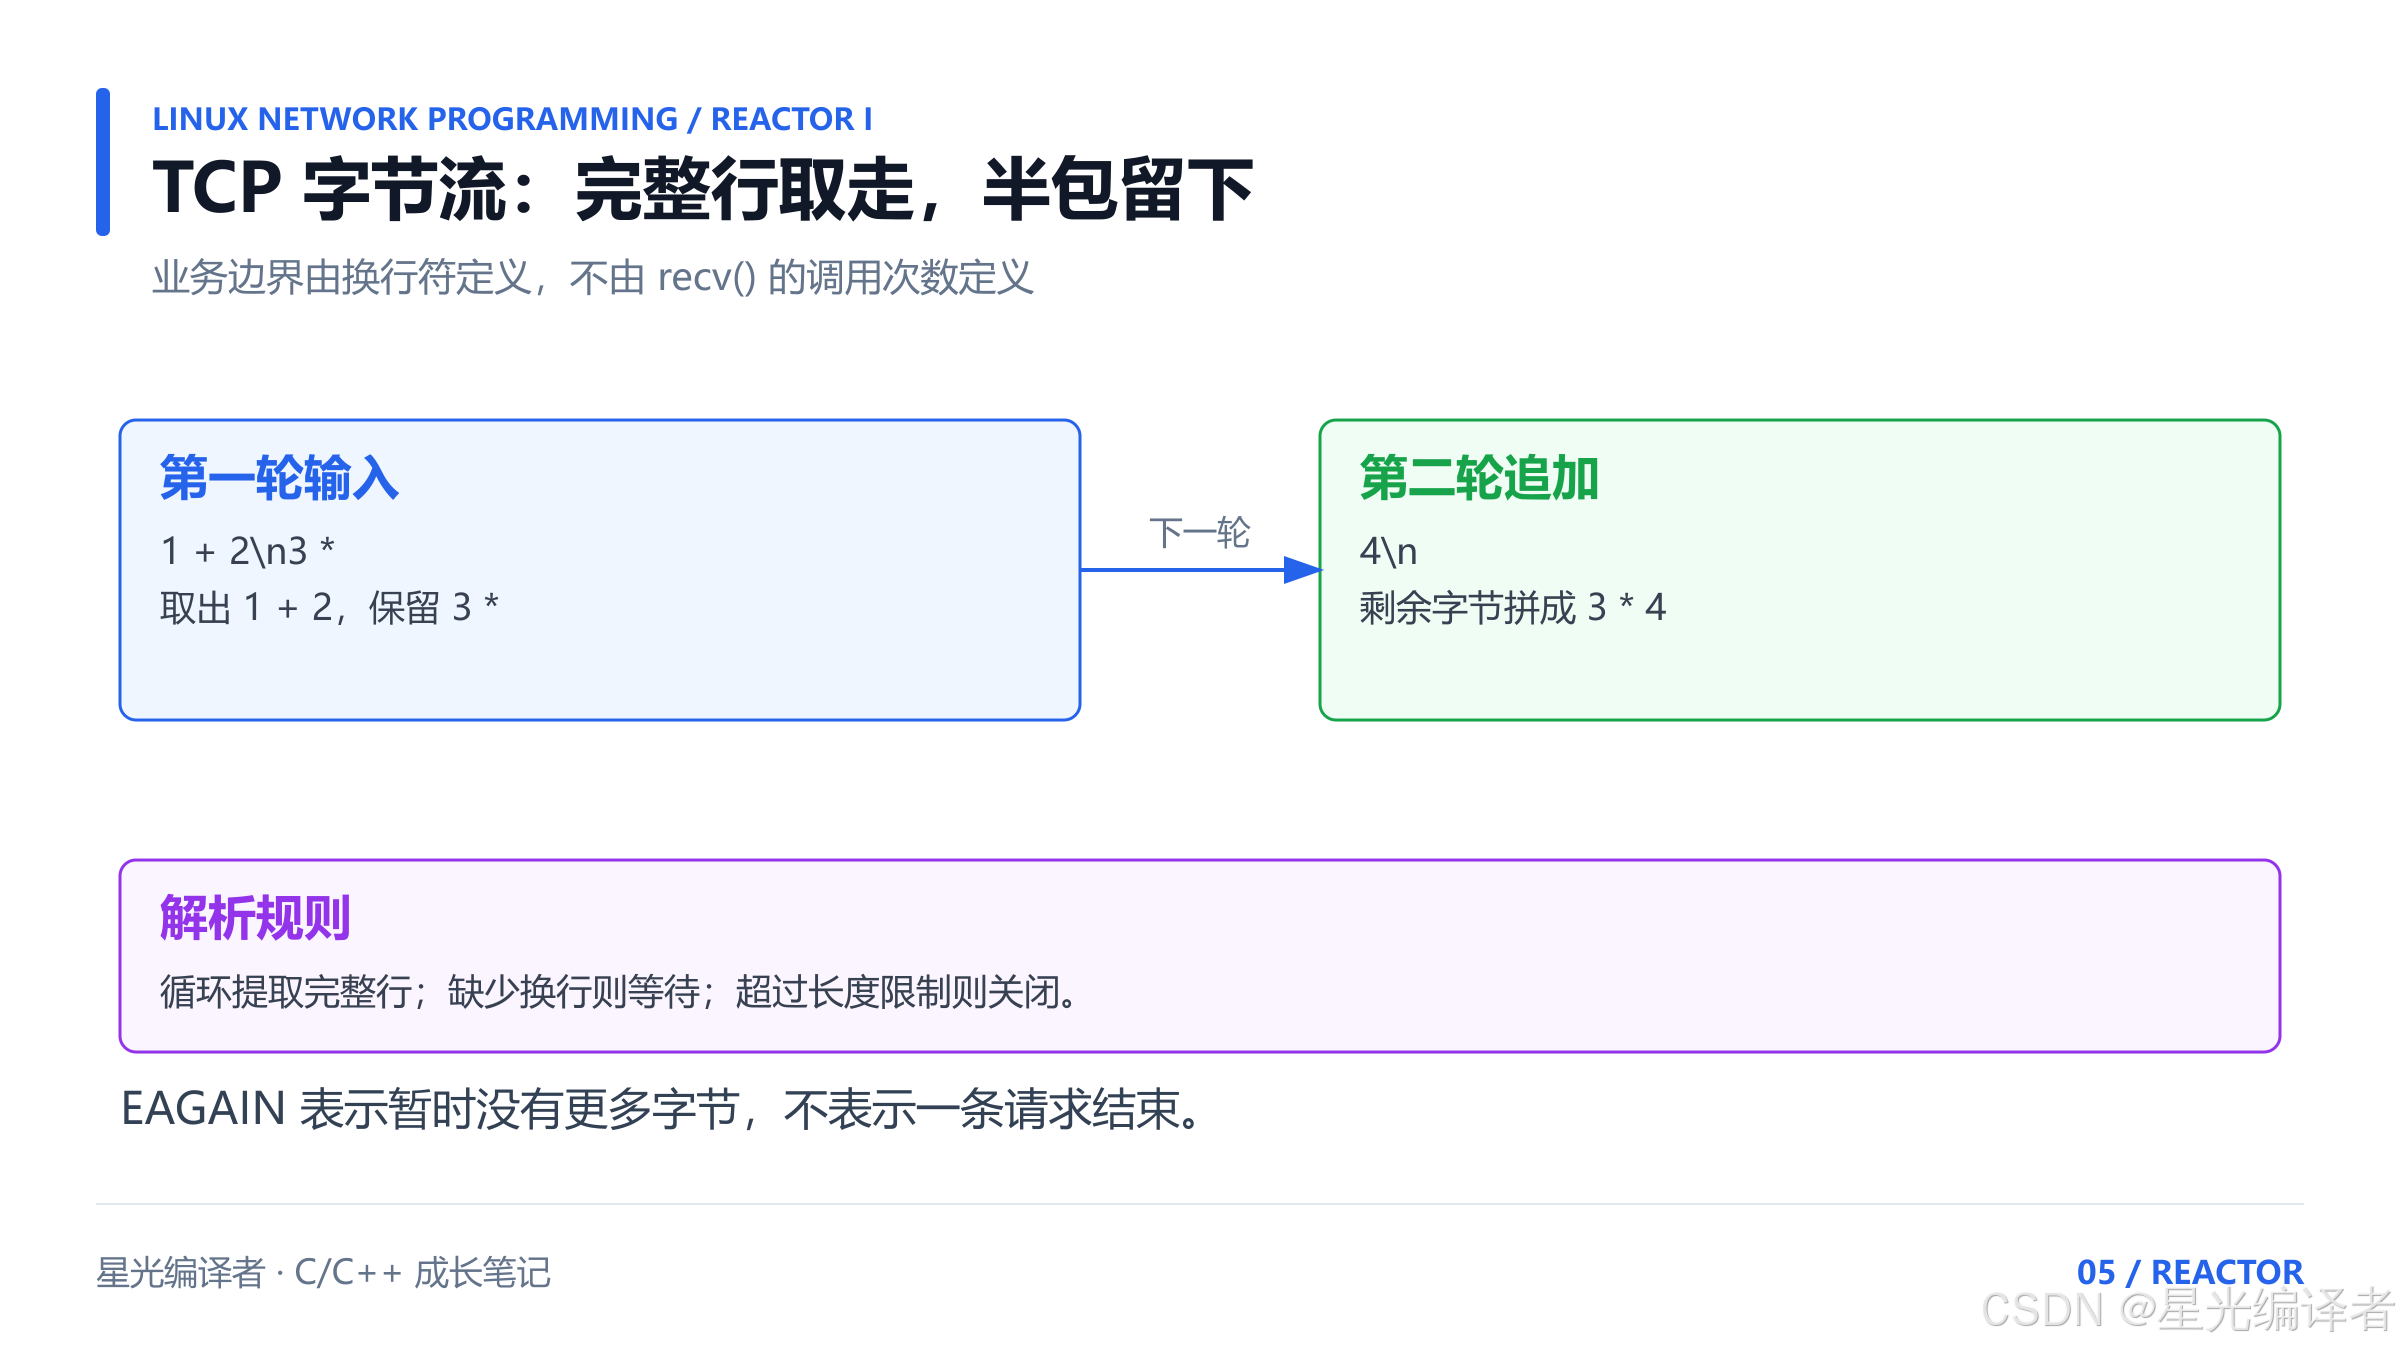
例如缓冲区当前为 1 + 2\\n3 *,解析器取出第一条,留下 3 *。下轮追加 4\\n,剩余字节才能成为第二条完整请求。每成功取出一条后继续解析,直到没有完整行。
语法错误的一整行会得到 ERR format,解析位置已经越过该行,因此下一条合法请求可以继续处理。没有换行且超过上限、或者某一整行超过上限时,直接断开;这属于连接级协议违规,不让客户端无限占用输入缓冲。
6.3 EOF 时的半包也要有规则
如果读取已经结束,input 仍残留未以换行结束的内容,这些字节不可能再拼成完整请求。本例追加 ERR truncated\\n,然后排空已有输出并关闭。
假设收到 1 + 2\\n9 + 后 EOF,预期响应顺序是 OK 3\\nERR truncated\\n。这条规则既让实验容易观察,也防止“最后一个不完整请求悄悄消失”。其他协议可以选择直接丢弃,但必须写清楚。
6.4 手动跟踪一次跨事件处理
只看每个函数,很容易觉得它们都很简单;真正容易出错的是函数之间的状态交接。下面用同一条连接走一遍完整过程。表中的字符串都用转义形式展示,\\n 表示实际换行字节。
| 第一次可读 | 收到 12 +,随后 EAGAIN | input = "12 +",没有响应 |
| 第二次可读 | 收到 30\\n9 / 0\\n | 提取两条完整请求,清空已消费输入 |
| 业务处理 | 得到两个计算结果 | 依次追加 OK 42\\n、ERR divide_by_zero\\n |
| 尝试发送 | 只接受部分字节 | sent 增加,未发送部分仍留在 output |
| 发送受阻 | send 返回 EAGAIN | 增加写关注,然后交回事件循环 |
| 后续可写 | 从 sent 位置继续发送 | 排空后清空 output、重置 sent、取消写关注 |
| 对端结束发送 | recv 返回 0 | 标记 eof;若输出已空,则关闭连接 |
关键在于每一行只承诺当前阶段真正完成的事情。读取层只承诺获得字节,解析层只承诺得到完整请求,发送层只承诺内核接受了多少字节。
假如把输出字符串一交给 send() 就清空,第四行的剩余数据会丢失;假如第一行遇到 EAGAIN 就清空输入,第二行会从 30 开始解析;假如第六行忘记取消写关注,订阅状态就不再反映真实需求。沿这张表检查,比只问“为什么客户端没收到结果”更容易定位问题。
七、发送缓冲与 EPOLLOUT 的开关
7.1 send 成功,不等于发送完整
send() 返回正数,表示本次接受了这么多字节;它不保证等于请求长度,也不代表对端应用已经收到并处理。输出缓冲要保存尚未交给内核的部分。send 手册
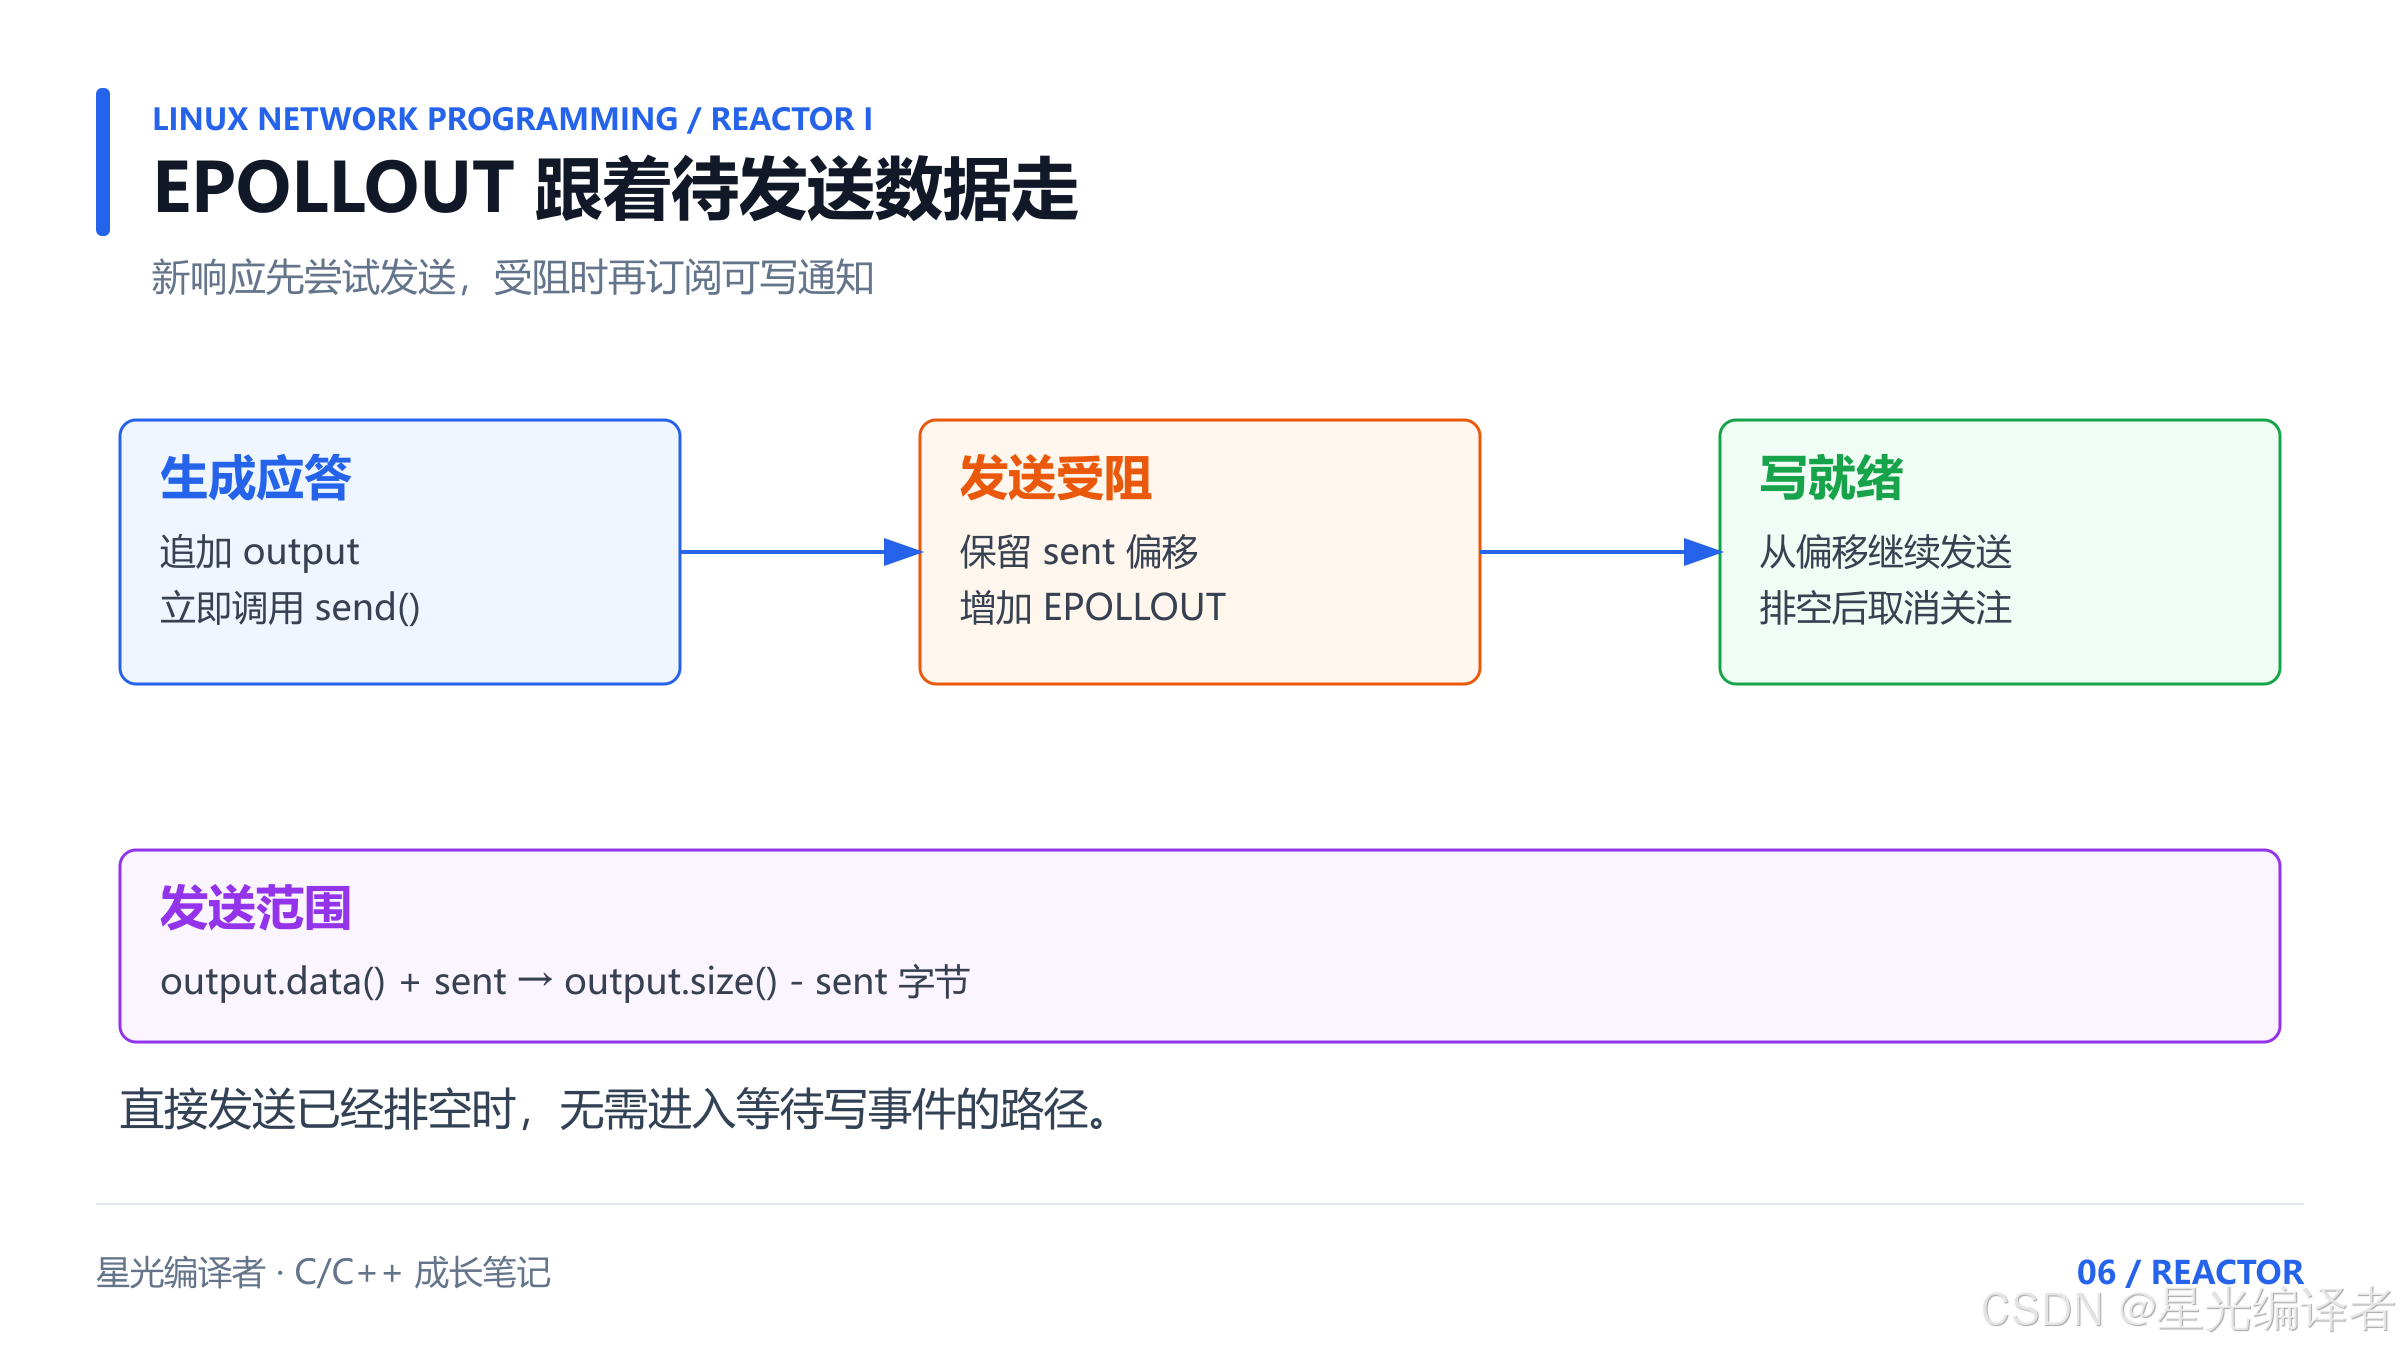
本文用 sent 记录偏移,发送范围始终为:
c.output.data() + c.sent // 未发送部分起点
c.output.size() – c.sent // 未发送部分长度
每次得到 n > 0 就增加偏移。遇到 EINTR 重试;遇到 EAGAIN 保存进度并关注可写;全部发送后清空缓冲、把偏移归零。
7.2 为什么生成响应后可以直接尝试发送
socket 已经是非阻塞的,尝试 send() 不要求先获得一次 EPOLLOUT 通知。常见策略是生成应答后立即调用发送函数:能发完就结束;暂时发不动才订阅写事件。
这样做也避免只依赖“下一次可写边沿”推进新产生的输出。应用新增待发数据,不意味着内核 socket 的可写状态刚发生变化。
7.3 EPOLLOUT 应该跟着待发送数据走
| 没有待发送数据 | 不关注 EPOLLOUT |
| 立即发送成功排空 | 保持或恢复只读关注 |
| 发送遇到 EAGAIN,还有剩余 | 增加 EPOLLOUT |
| 写回调把缓冲发空 | 移除 EPOLLOUT |
| 已 EOF 且缓冲发空 | 关闭连接 |
尤其在 LT 模式下,可写条件持续满足又一直订阅 EPOLLOUT,会造成无意义唤醒。ET 的通知表现不同,不能笼统说“ET 下也必然持续空转”,但让订阅准确反映应用需要,仍是清晰且稳健的设计。
7.4 发送路径上的三个细节
第一,使用 MSG_NOSIGNAL,避免给已断开的连接发送时由 SIGPIPE 结束整个进程,同时仍检查 EPIPE 等返回错误。
第二,非空发送若意外返回 0,不能原地无限循环。示例采用关闭策略,使“没有进展”有明确出口。
第三,待发数据达到 64 KiB 上限后断开慢连接。这个上限约束的是应用层尚未发送的字节,不是所有内存占用;std::string 容量、内核缓冲和连接表也会消耗资源。
7.5 修改事件掩码时,保留仍然有效的条件
新增写关注不是把掩码简单替换成 EPOLLOUT。连接仍可接收请求时,还需要 EPOLLIN;ET 配置也不能无意丢掉。否则一个看似正确的发送优化,可能让后续读取再也进不来。
本文的 refresh() 根据连接状态重新计算目标掩码:先保留 ET;尚未 EOF 时增加读与半关闭关注;有待发送字节时增加写关注。新掩码与旧掩码一致就无需调用 MOD。
这一做法让订阅成为状态的结果,而不是分散在各处随手增删的标志。调试时可以把“当前 input/output、eof/closed、实际订阅掩码”一起打印,检查它们是否互相匹配。遇到 MOD 失败时,本文选择关闭该连接,不继续假装订阅成功。
八、关闭连接:比调用 close 多做几步
清理路径统一放在 close_connection() 中,按照“标记关闭、移除 epoll 关注、关闭 fd、移除连接表项”执行。fd 随后改成 -1,避免析构时重复关闭。
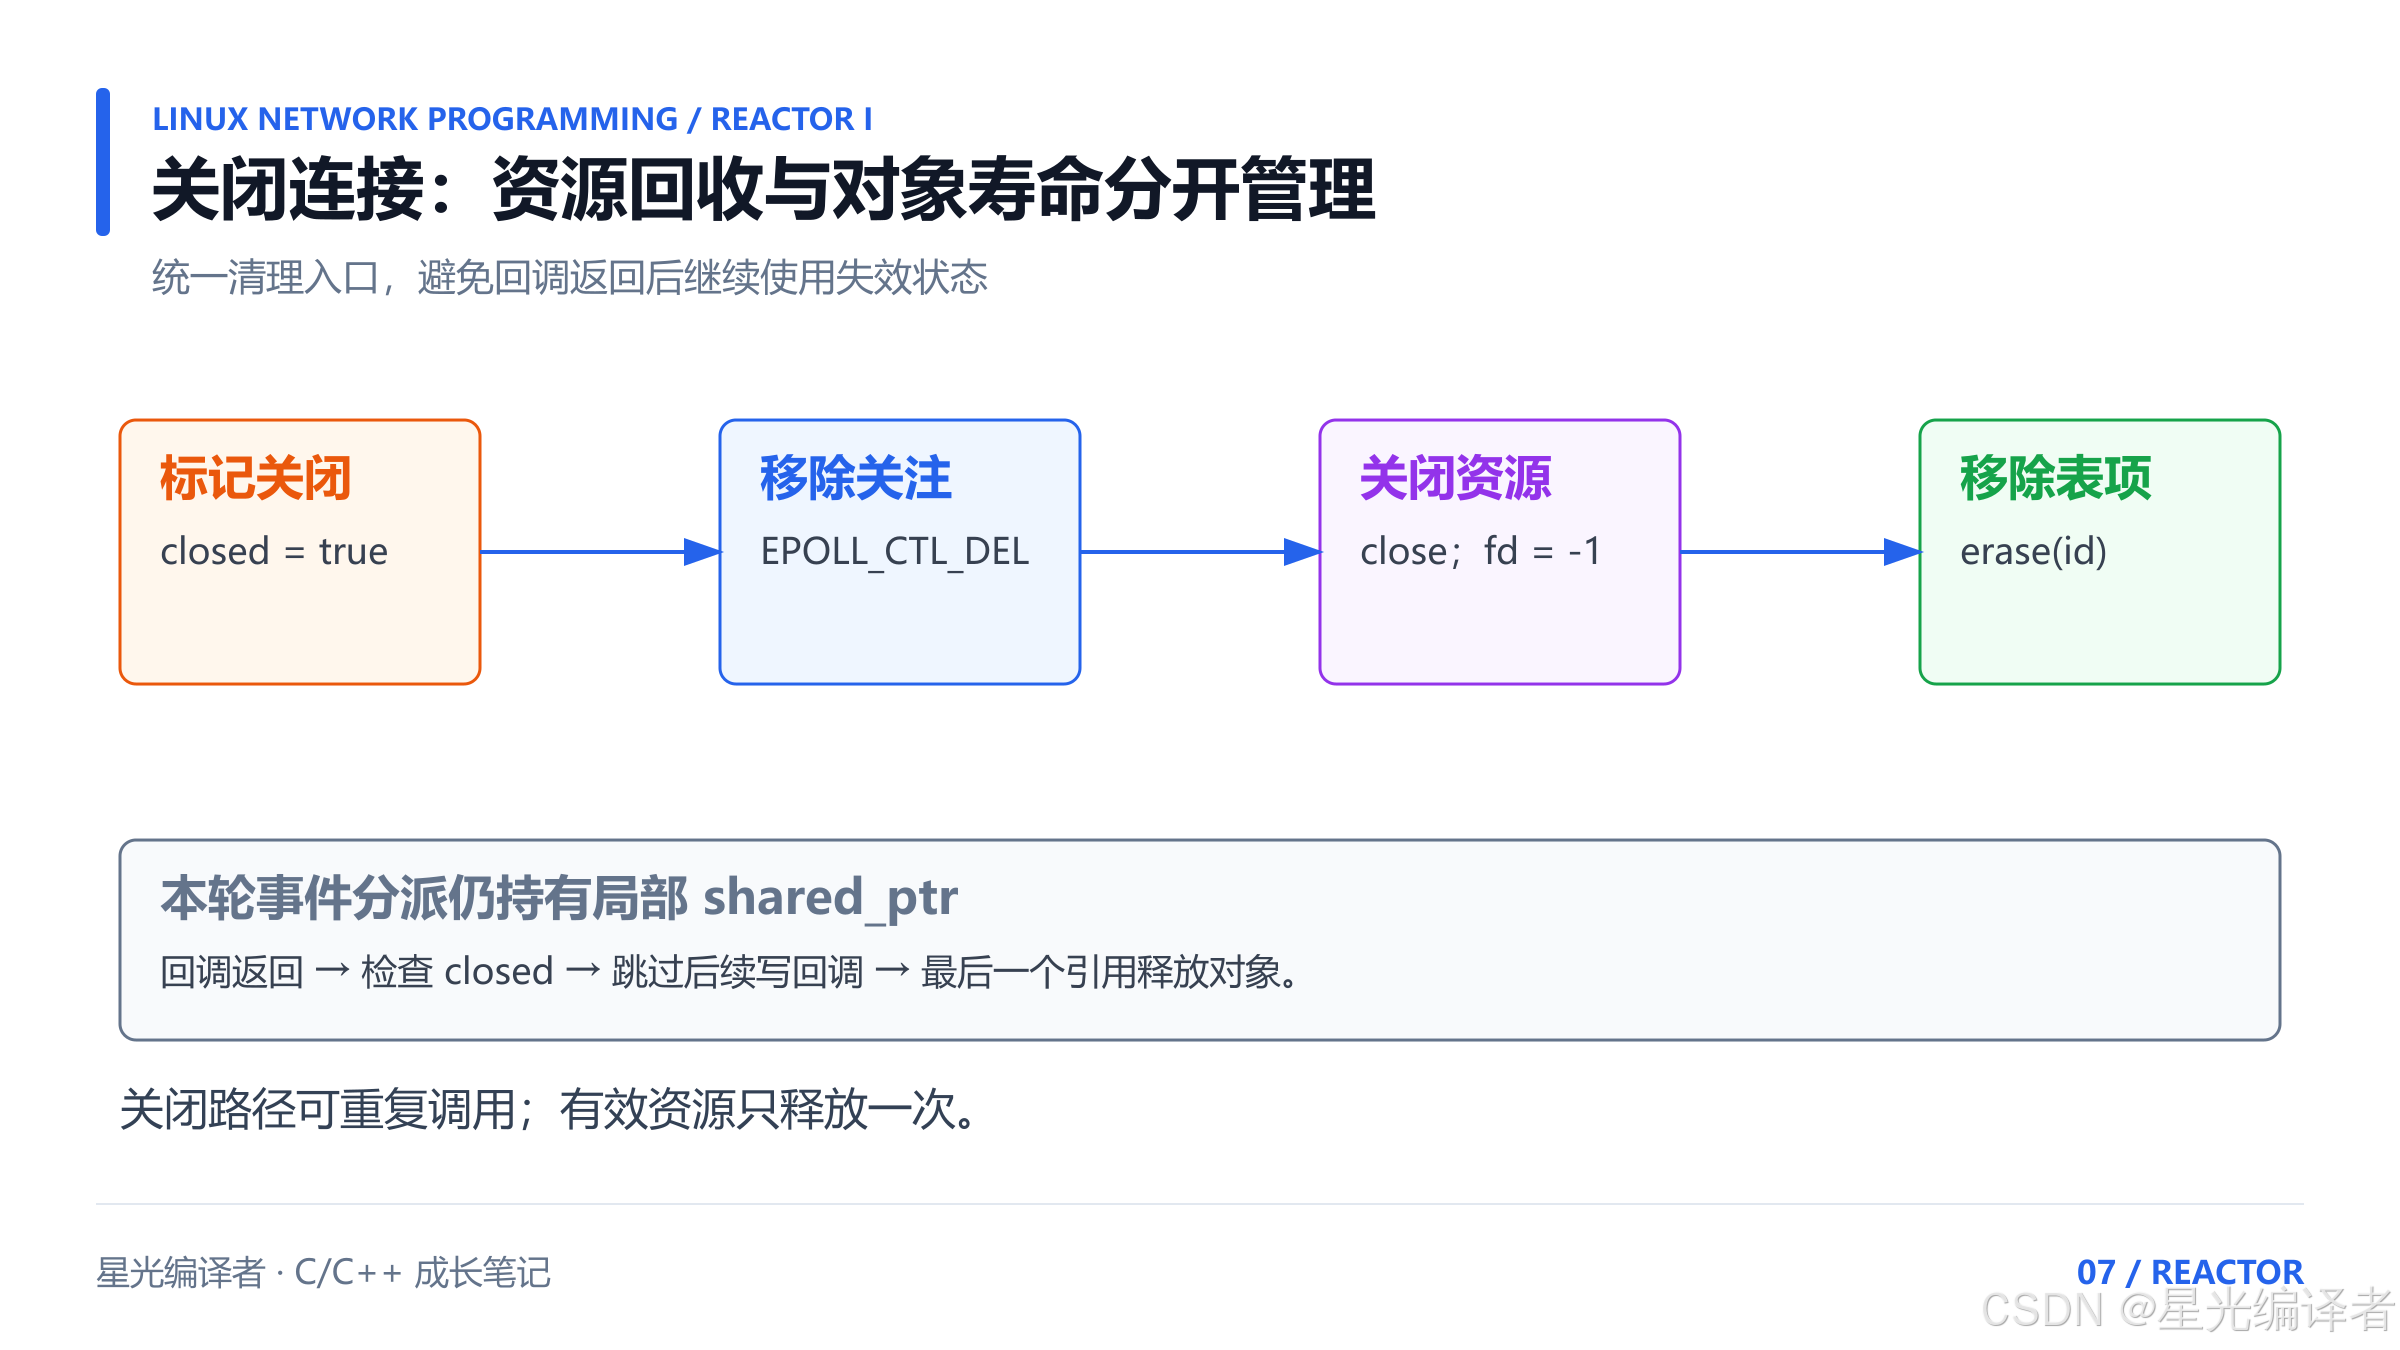
标记关闭放在前面,使重复进入清理路径成为无操作。连接表不再持有对象后,当前事件分派保留的局部 shared_ptr 仍让对象活到本轮结束;离开作用域后,最后一个引用才释放内存。
不要把“从 map 删除”和“立刻 delete 裸指针”随意分散在多个回调中。最危险的代码通常长这样:读回调删除对象,控制流返回事件循环,事件循环继续通过同一个指针检查写回调。
还要注意,关闭 fd 与释放 C++ 对象是两件事。对象延迟释放并不意味着允许延迟关闭一个已经确定失效的 socket;反过来,fd 已经关闭,也不意味着持有该对象引用的代码可以不再检查逻辑状态。
本文没有通过 dup() 复制 socket 描述符,因此清理流程比较直接。正式框架若允许描述符别名,还需要厘清 open file description 与 epoll 注册关系,不能把“关闭任意一个数字”当成所有观察关系都结束。
九、完整 C++17 计算器服务器
把下面代码保存为 reactor_server.cpp。文章包的 code/ 中提供同一份代码。为便于从头跑通,这里用单文件展示;阅读时沿 run → readable → receive → parse → flush 这条调用链看,再回头看接入和清理路径。
#ifndef _GNU_SOURCE
#define _GNU_SOURCE
#endif
#include <arpa/inet.h>
#include <sys/epoll.h>
#include <sys/socket.h>
#include <unistd.h>
#include <cerrno>
#include <cstdint>
#include <cstdlib>
#include <cstring>
#include <functional>
#include <iostream>
#include <memory>
#include <sstream>
#include <stdexcept>
#include <string>
#include <unordered_map>
namespace {
constexpr std::size_t MAX_LINE = 256;
constexpr std::size_t MAX_OUTPUT = 64 * 1024;
constexpr std::size_t MAX_CLIENTS = 4096;
[[noreturn]] void fail(const char* where) {
throw std::runtime_error(std::string(where) + ": " + std::strerror(errno));
}
bool again() { return errno == EAGAIN || errno == EWOULDBLOCK; }
// Operands are bounded, so all supported results fit in int64_t.
std::string calculate(const std::string& line) {
std::istringstream in(line);
std::int64_t a, b, result;
char op;
if (!(in >> a >> op >> b)) return "ERR format\\n";
in >> std::ws;
if (!in.eof()) return "ERR format\\n";
constexpr std::int64_t LIMIT = 1000000000;
if (a < –LIMIT || a > LIMIT || b < –LIMIT || b > LIMIT)
return "ERR range\\n";
switch (op) {
case '+': result = a + b; break;
case '-': result = a – b; break;
case '*': result = a * b; break;
case '/': if (b == 0) return "ERR divide_by_zero\\n";
result = a / b; break;
default: return "ERR operator\\n";
}
return "OK " + std::to_string(result) + "\\n";
}
struct Connection {
explicit Connection(int socket) : fd(socket) {}
~Connection() { if (fd >= 0) ::close(fd); }
Connection(const Connection&) = delete;
Connection& operator=(const Connection&) = delete;
int fd;
std::uint64_t id = 0;
std::uint32_t interests = 0;
std::string input, output;
std::size_t sent = 0;
bool eof = false, closed = false;
std::function<void(Connection&)> readable, writable;
};
std::shared_ptr<Connection> hold_socket(int fd) {
try { return std::make_shared<Connection>(fd); }
catch (...) { if (fd >= 0) ::close(fd); throw; }
}
class Reactor {
public:
explicit Reactor(unsigned short port) {
epfd_ = ::epoll_create1(EPOLL_CLOEXEC);
if (epfd_ < 0) fail("epoll_create1");
try {
auto listener = hold_socket(
::socket(AF_INET, SOCK_STREAM | SOCK_NONBLOCK | SOCK_CLOEXEC, 0));
if (listener->fd < 0) fail("socket");
int yes = 1;
if (::setsockopt(listener->fd, SOL_SOCKET, SO_REUSEADDR, &yes, sizeof(yes)) < 0)
fail("setsockopt");
sockaddr_in addr{};
addr.sin_family = AF_INET;
addr.sin_port = htons(port);
addr.sin_addr.s_addr = htonl(INADDR_LOOPBACK);
if (::bind(listener->fd, reinterpret_cast<sockaddr*>(&addr), sizeof(addr)) < 0)
fail("bind");
if (::listen(listener->fd, SOMAXCONN) < 0) fail("listen");
listener->readable = [this](Connection& c) { accept_all(c); };
add(listener); // Listener is connection id 1.
} catch (...) { ::close(epfd_); epfd_ = –1; throw; }
}
~Reactor() { connections_.clear(); if (epfd_ >= 0) ::close(epfd_); }
Reactor(const Reactor&) = delete;
Reactor& operator=(const Reactor&) = delete;
void run() {
epoll_event ready[128];
for (;;) {
int n = ::epoll_wait(epfd_, ready, 128, –1);
if (n < 0) { if (errno == EINTR) continue; fail("epoll_wait"); }
for (int i = 0; i < n; ++i) {
auto found = connections_.find(ready[i].data.u64);
if (found == connections_.end()) continue; // stale event
auto c = found->second; // Hold lifetime across callbacks.
std::uint32_t events = ready[i].events;
if (events & EPOLLERR) {
if (c->id == 1) throw std::runtime_error("listener EPOLLERR");
close_connection(*c); continue;
}
if ((events & (EPOLLIN | EPOLLRDHUP | EPOLLHUP)) && c->readable)
c->readable(*c);
if (!c->closed && (events & EPOLLOUT) && c->writable)
c->writable(*c);
}
}
}
private:
int epfd_ = –1;
std::uint64_t next_id_ = 1;
std::unordered_map<std::uint64_t, std::shared_ptr<Connection>> connections_;
void add(const std::shared_ptr<Connection>& c) {
if (next_id_ == 0) throw std::runtime_error("connection id exhausted");
c->id = next_id_++;
c->interests = EPOLLIN | EPOLLET | EPOLLRDHUP;
connections_.emplace(c->id, c);
epoll_event event{};
event.events = c->interests;
event.data.u64 = c->id;
if (::epoll_ctl(epfd_, EPOLL_CTL_ADD, c->fd, &event) < 0) {
connections_.erase(c->id); fail("epoll_ctl ADD");
}
}
void close_connection(Connection& c) {
if (c.closed) return;
c.closed = true;
// No dup() aliases are created; close also removes this epoll interest.
if (::epoll_ctl(epfd_, EPOLL_CTL_DEL, c.fd, nullptr) < 0)
std::cerr << "epoll_ctl DEL: " << std::strerror(errno) << '\\n';
::close(c.fd); c.fd = –1;
connections_.erase(c.id);
}
void refresh(Connection& c) {
if (c.closed) return;
std::uint32_t events = EPOLLET;
if (!c.eof) events |= EPOLLIN | EPOLLRDHUP;
if (c.sent < c.output.size()) events |= EPOLLOUT;
if (events == c.interests) return;
epoll_event event{};
event.events = events; event.data.u64 = c.id;
if (::epoll_ctl(epfd_, EPOLL_CTL_MOD, c.fd, &event) < 0) {
close_connection(c); return;
}
c.interests = events;
}
void accept_all(Connection& listener) {
for (;;) {
int fd = ::accept4(listener.fd, nullptr, nullptr, SOCK_NONBLOCK | SOCK_CLOEXEC);
if (fd >= 0) {
auto c = hold_socket(fd);
if (connections_.size() > MAX_CLIENTS) continue; // RAII closes fd.
c->readable = [this](Connection& x) { receive(x); };
c->writable = [this](Connection& x) { flush(x); };
add(c);
continue;
}
if (errno == EINTR || errno == ECONNABORTED || errno == ENETDOWN ||
errno == EPROTO || errno == ENOPROTOOPT || errno == EHOSTDOWN ||
errno == ENONET || errno == EHOSTUNREACH || errno == EOPNOTSUPP ||
errno == ENETUNREACH) continue;
if (again()) return;
// Teaching policy: stop explicitly on resource exhaustion.
fail("accept4");
}
}
bool queue_response(Connection& c, const std::string& text) {
if (c.sent) { c.output.erase(0, c.sent); c.sent = 0; }
if (text.size() > MAX_OUTPUT – c.output.size()) {
close_connection(c); return false;
}
c.output += text; return true;
}
bool parse(Connection& c) {
for (;;) {
auto end = c.input.find('\\n');
if (end == std::string::npos) {
if (c.input.size() > MAX_LINE) { close_connection(c); return false; }
return true;
}
if (end > MAX_LINE) { close_connection(c); return false; }
auto response = calculate(c.input.substr(0, end));
c.input.erase(0, end + 1);
if (!queue_response(c, response)) return false;
}
}
void receive(Connection& c) {
char buf[4096];
for (;;) {
ssize_t n = ::recv(c.fd, buf, sizeof(buf), 0);
if (n > 0) {
c.input.append(buf, static_cast<std::size_t>(n));
if (!parse(c)) return;
flush(c); // Keep a long readable burst from accumulating all replies.
if (c.closed) return;
continue;
}
if (n == 0) {
c.eof = true;
if (!c.input.empty()) {
c.input.clear();
if (!queue_response(c, "ERR truncated\\n")) return;
}
break;
}
if (errno == EINTR) continue;
if (again()) break;
close_connection(c); return;
}
flush(c);
}
void flush(Connection& c) {
while (c.sent < c.output.size()) {
ssize_t n = ::send(c.fd, c.output.data() + c.sent,
c.output.size() – c.sent, MSG_NOSIGNAL);
if (n > 0) { c.sent += static_cast<std::size_t>(n); continue; }
if (n < 0 && errno == EINTR) continue;
if (n < 0 && again()) { refresh(c); return; }
close_connection(c); return; // Includes unexpected zero progress.
}
c.output.clear(); c.sent = 0;
if (c.eof) { close_connection(c); return; }
refresh(c); // Output empty: remove EPOLLOUT.
}
};
} // namespace
int main(int argc, char** argv) {
try {
unsigned long port = 9090;
if (argc > 2) throw std::runtime_error("usage: reactor_server [port]");
if (argc == 2) {
const std::string text = argv[1];
if (text.empty() || text.find_first_not_of("0123456789") != std::string::npos)
throw std::runtime_error("invalid port");
port = std::stoul(text);
if (port == 0 || port > 65535) throw std::runtime_error("invalid port");
}
Reactor reactor(static_cast<unsigned short>(port));
std::cout << "listening 127.0.0.1:" << port << std::endl;
reactor.run();
} catch (const std::exception& e) { std::cerr << e.what() << '\\n'; return 1; }
}
这份实现故意没有把每个小函数都拆成独立类。理解职责比先增加文件数量更重要:以后即使把 Acceptor、Connection、协议处理器分别放进头文件,它们之间的所有权和调用关系也应保持清晰。
阅读完整实现时,可以给自己划出三条检查线:
| 接入与资源 | hold_socket / add / close_connection | fd 创建后有人持有,注册失败能够回收,关闭不重复 |
| 数据与进度 | receive / parse / queue_response / flush | 字节按长度追加,完整请求才消费,发送偏移不越界 |
| 调度与身份 | run / refresh | 事件按 id 查找,关闭后不继续分派,订阅与状态一致 |
hold_socket() 补上了一个较少出现但重要的窗口:拿到 fd 后,创建共享对象可能因为分配失败而抛异常。对象尚未建立时,它的析构函数也不会替我们关闭资源,因此需要在这个边界显式回收。资源管理不能只覆盖“对象已经创建成功”的常见路径。
十、编译运行与边界实验
在 Linux 中进入代码目录:
g++ -std=c++17 -O2 -Wall -Wextra -Wpedantic reactor_server.cpp -o reactor_server
./reactor_server 9090
正常启动会打印 listening 127.0.0.1:9090。端口参数只能是 1~65535 的十进制数字;端口已占用或非法时,程序会报告错误并退出。
另开终端,用 Python 标准库构造“分次发送 + 多条请求 + 半关闭”的场景:
import socket
import time
with socket.create_connection(("127.0.0.1", 9090)) as s:
s.settimeout(3)
s.sendall(b"12 +")
time.sleep(0.1)
s.sendall(b" 30\\n9 / 0\\n7 * -8\\n")
s.shutdown(socket.SHUT_WR)
chunks = []
while True:
block = s.recv(4096)
if not block:
break
chunks.append(block)
print(b"".join(chunks).decode(), end="")
预期得到:
OK 42
ERR divide_by_zero
OK -56
sleep() 只帮助制造分次到达的机会,不是 TCP 报文边界保证。更严格的测试应在发送第一段后确认没有完整响应,再补齐终止符。
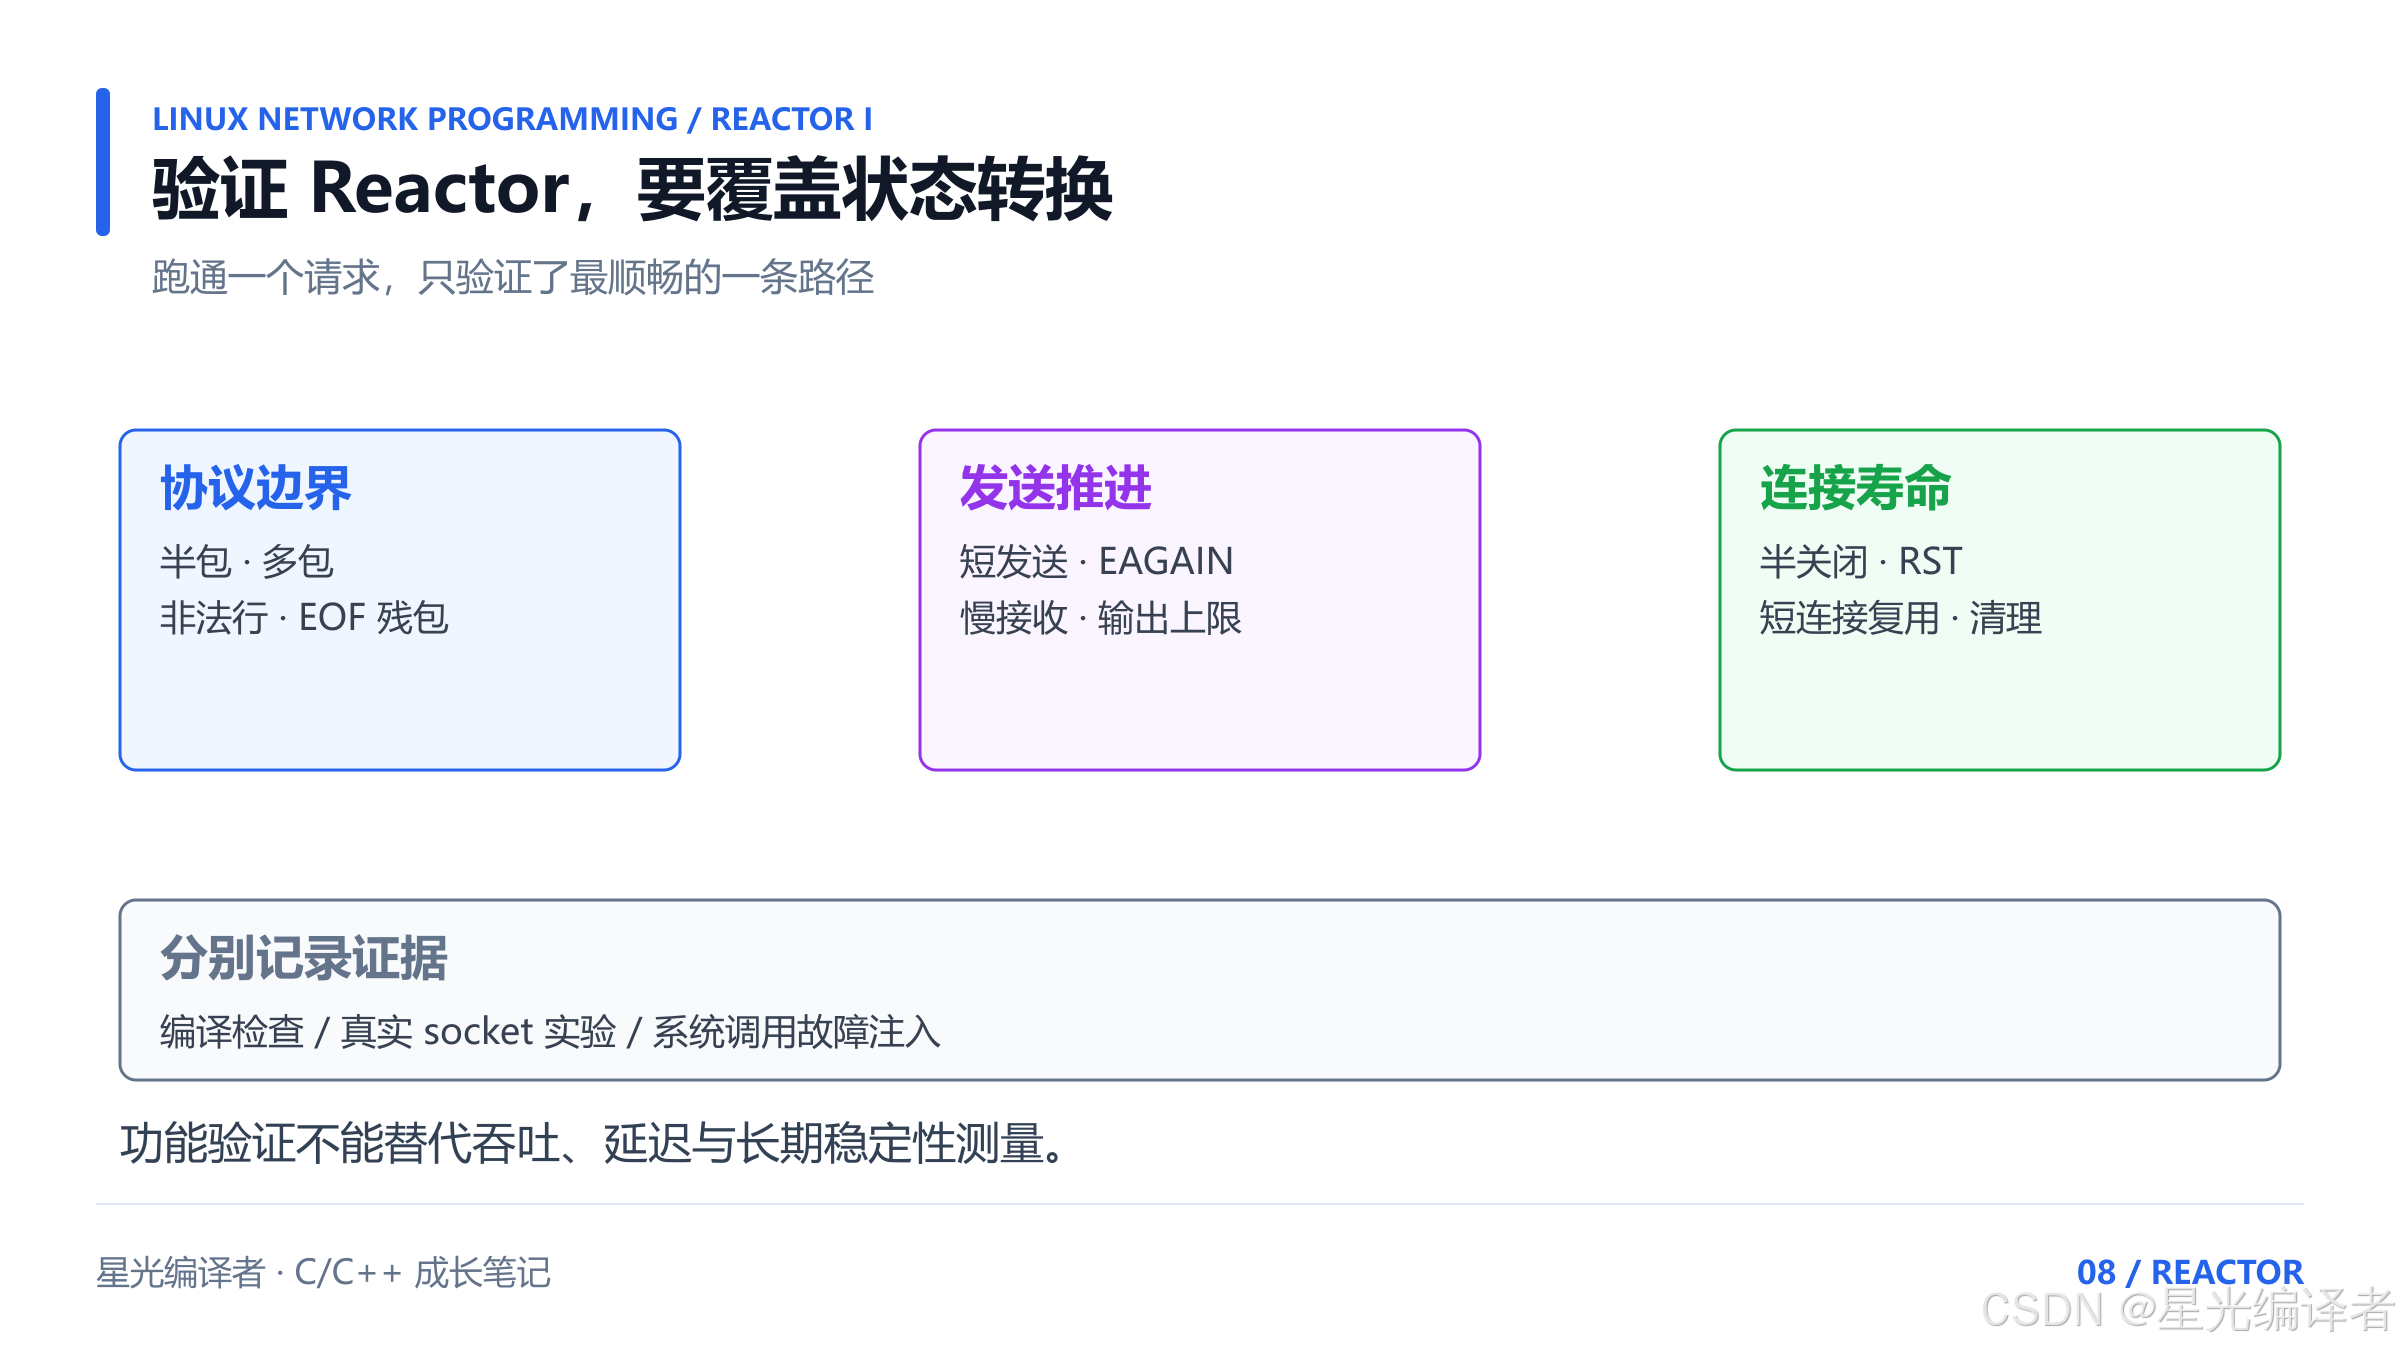
值得继续做的实验有以下几组:
| 一次发送很多个 1 + 2\\n | 每条对应一个 OK 3,顺序一致 |
| 发送 1 + 2\\n9 + 后半关闭 | 先 OK 3,再 ERR truncated |
| 发送 hello\\n1 + 2\\n | 错误行后还能处理合法行 |
| 长时间不发送的连接与活跃连接并存 | 活跃连接仍然得到响应 |
| 突然复位连接 | 服务器保留处理其他客户端的能力 |
| 慢客户端持续积压响应 | 达到输出上限后被断开 |
| 短连接反复建立与释放 | 旧连接身份不会落到新连接上 |
一次普通回环实验通常很难稳定遇到部分发送。检查这一分支时,可以使用测试专用的系统调用包装,强制短发送和 EAGAIN,再核对完整响应。这与“真实网络下偶然发生过”是不同的证据,不能混为性能测试。
十一、资源、公平性与单 Reactor 的边界
11.1 读到 EAGAIN,也可能占用太久
“读到暂时没有数据”很适合讲清 ET 的推进规则,但如果某个客户端持续高速发送,读循环可能长时间不结束,其他连接就会延迟。
生产实现往往设置每轮字节数、请求数或时间预算。ET 下如果预算耗尽时尚未排空,必须把该连接放到应用层就绪队列,安排后续主动继续处理;不能直接重新睡进 epoll_wait(),然后希望一定再来一个边沿。
这也说明公平性是调度策略,不是 epoll 自动提供的保证。本文优先展示完整读写路径,没有加入这个二级调度队列。
11.2 对资源上限的理解要落到总量
单连接输入上限、输出上限和连接数上限是三个不同约束。示例限制最多 4096 个客户端,超过后接入得到的 fd 会随局部 Connection 释放;这不是服务器的吞吐指标,也不是系统一定能支持的连接数量。
若每个连接都允许较大的缓冲,总内存可能远超预期。还要考虑空闲连接超时、全局内存水位、单客户端请求速率和日志开销。按连接限流与全局过载保护应共同设计。
11.3 单 Reactor 的第一条扩展原则
要扩展线程之前,先回答:哪些函数只能在所属事件循环中执行?如果 receive()、flush()、修改订阅和关闭连接都能被任意线程直接调用,线程数一增加,连接状态就很难保持一致。
下一篇沿用同一个约束:连接归一个 Loop 管理,其他线程把工作投递给它。事件驱动从网络 fd 延伸到线程通知 fd,Reactor 的结构无需推倒重来。
十二、常见问题与自测
Q1:Reactor 必须使用 ET 吗? 不必须。LT 和 ET 都能支撑 Reactor。本文选择 ET,是为了把“非阻塞操作推进到暂时不能继续”的规则讲完整。
Q2:加了回调就是 Reactor 吗? 回调只是组织手段。还需要等待就绪、按事件分派,以及让处理过程能在多轮事件之间保存状态。
Q3:读到半包为什么不能继续等到完整? 如果这里的“等”是阻塞当前线程,就会让所有其他连接一起等待。正确做法是保留半包,交还事件循环。
Q4:应用输出缓冲为空,就能证明对方收到响应吗? 不能。它只说明本例已经把待发送字节交给本机内核。要确认业务接收与处理,需要应用协议的确认机制。
Q5:能否一遇到 EPOLLERR 就删除对象? 可以选择关闭连接,但必须走统一生命周期路径,并确保本轮后续代码不再把它当作活跃连接。
最后试着独立解释三个场景:读回调关闭后为什么仍要检查 closed;发送一半遇到 EAGAIN 时哪些状态必须保留;客户端只关闭写端后服务器为什么还能继续发应答。能顺着状态变化回答,才算真正把事件循环串了起来。
Reactor 的主线始终很清楚:等待条件、找到对象、推进处理、保存状态,再把执行权交回事件循环。把这条链路写稳,多 Reactor 的扩展才有可靠的基础。
📚 系列衔接:下一篇《Reactor 反应堆模式(下):多 Reactor、任务队列与 eventfd》继续讨论连接归属和跨线程唤醒。
💬 如果你在实现中遇到“连接还在,但再也没有响应”的问题,可以先沿着输入缓冲、输出偏移、订阅事件和关闭标记逐项检查。很多看似神秘的网络故障,最终都能落到某一次状态转换上。





评论前必须登录!
注册