 网硕互联帮助中心
🏆 本文收录于 《滚雪球学 Ubuntu》 专栏。 本专栏面向有一定计算机基础,但尚未系统学习 Linux / Ubuntu 的读者,采用“滚雪球式学习法”:先装好、再会用、再理解、再优化、再实战,带你从第一次进入 Ubuntu 桌面 / 终端开始,逐步掌握 Ubuntu 的日常使用、命令操作、软件安装、系统配置、开发环境搭建与服务器部署能力。 🎯 适合人群: Linux 初学者、Ubuntu 新手、计算机专业学生、后端 / 运维 / 测试入门同学、想搭建 Linux 开发环境的开发者、准备学习服务器部署的同学,以及想从 Windows 过渡到 Ubuntu 工作流的用户。
从“会打开终端”到“能管理系统”,从“复制命令”到“理解 Linux 思维”,这一次,我们不零散学,而是一路滚雪球! 🎉 限时福利:当前专栏活动中,一次订阅,终身阅读,后续更新章节全部免费解锁 👉 立即查看 👈️
演示环境说明:
- 开发工具:Visual Studio Code / JetBrains 系列 IDE / Vim / Nano
- Ubuntu版本:Ubuntu 22.04 LTS / Ubuntu 24.04 LTS,推荐 Ubuntu 24.04 LTS
- Linux内核版本:Linux Kernel 6.x 或更高
- 终端环境:Bash / Zsh
- 包管理工具:APT / Snap / Flatpak
- 远程连接工具:OpenSSH / Windows Terminal / MobaXterm / Termius
- 虚拟化环境:VMware Workstation / VirtualBox / WSL2 / 云服务器
- 容器环境:Docker / Docker Compose
- 操作系统:Ubuntu Desktop / Ubuntu Server
全文目录:
-
- 一、前言:那些"死而不僵"的进程
- 二、本文要解决什么问题
- 三、Linux 进程生命周期基础回顾
-
- 3.1 进程是怎么诞生的
- 3.2 进程状态机:从创建到消亡
- 3.3 父子进程关系与 wait() 机制
- 四、僵尸进程深度解析
-
- 4.1 什么是僵尸进程
- 4.2 僵尸进程是怎么产生的
- 4.3 僵尸进程占用什么资源
- 4.4 僵尸进程有多危险
- 4.5 如何识别僵尸进程
- 五、孤儿进程深度解析
-
- 5.1 什么是孤儿进程
- 5.2 孤儿进程的产生场景
- 5.3 init/systemd 如何收养孤儿进程
- 5.4 孤儿进程是否有害
- 六、僵尸进程与孤儿进程的本质区别
- 七、实验环境准备
- 八、案例一:亲手制造一个僵尸进程
-
- 8.1 编写产生僵尸进程的 C 程序
- 8.2 观察僵尸进程
- 8.3 命令解析
- 九、案例二:亲手制造一个孤儿进程
-
- 9.1 编写产生孤儿进程的 C 程序
- 9.2 观察孤儿进程的 init 接管过程
- 9.3 命令解析
- 十、案例三:真实服务器中的僵尸进程排查与处理
-
- 10.1 用 ps 和 top 定位僵尸进程
- 10.2 找到僵尸进程的父进程
- 10.3 通过 SIGCHLD 信号触发父进程回收
- 10.4 终极手段:终止父进程
- 10.5 编写可以正确回收子进程的 Python 服务
- 10.6 命令解析
- 十一、进程状态码全解析
- 十二、流程图
-
- 12.1 进程完整生命周期状态图
- 12.2 僵尸进程产生与消亡流程
- 12.3 孤儿进程被 init 接管流程
- 12.4 生产环境僵尸进程排查流程
- 十三、深入原理:内核视角下的进程回收
-
- 13.1 进程描述符与 task_struct
- 13.2 wait() 系列系统调用
- 13.3 SIGCHLD 信号的作用
- 13.4 为什么 PID 1 永远不会产生僵尸进程
- 十四、Docker 容器中的僵尸进程问题
-
- 14.1 容器内的 PID 1 陷阱
- 14.2 使用 tini 解决容器僵尸进程问题
- 14.3 Docker 官方推荐的 init 方案
- 十五、systemd 与进程生命周期管理
-
- 15.1 systemd 如何管理子进程
- 15.2 KillMode 配置的重要性
- 15.3 实际服务配置示例
- 十六、常见问题与踩坑总结
- 十七、最佳实践建议
- 十八、扩展知识点
-
- 进程组与会话
- subreaper 机制
- /proc 文件系统深度使用
- 使用 strace 跟踪进程系统调用
- 十九、完整操作流程回顾
- 二十、总结
- 🧧 学习福利 · 限时开放 🧧
- 🫵 Who am I?
一、前言:那些"死而不僵"的进程
我第一次在生产服务器上遇到僵尸进程(Zombie Process),是在一次深夜的性能故障排查中。当时系统负载看起来不高,内存也没有明显压力,但服务就是莫名其妙地开始拒绝新连接。用 ps aux 一看,进程列表里赫然出现了十几个状态为 Z 的进程,后面跟着 <defunct> 的标记——“已经失效”。
我当时第一反应是:这些进程死了吗?那为什么它们还在进程列表里?
后来才明白,僵尸进程就是 Linux 进程生命周期里的一个"灰色地带":进程的代码已经执行完毕,资源也大多释放了,但它的进程描述符还在内核里挂着,因为没有人来为它"收尸"——也就是父进程没有调用 wait() 读取它的退出状态。
这个场景在我第一次遇到时觉得很诡异,后来理解了 Linux 进程模型之后,反而觉得这是一个设计非常精妙的机制:它在子进程和父进程之间,建立了一个"退出信息传递的临时缓冲区"。只是如果父进程不负责任地不去读,这个缓冲区就会越堆越多,最终成为系统的隐患。
孤儿进程(Orphan Process)则是另一种场景:父进程先死了,子进程还活着。这时候 Linux 会把孤儿进程"过继"给 init(也就是 PID 为 1 的进程,在 Ubuntu 22.04/24.04 中是 systemd),由 systemd 来承担父进程的责任。所以孤儿进程其实没什么可怕的,系统自己会处理。
这两个概念,是 Linux 进程管理中一个容易被初学者忽视的角落。但当你在服务器上发现资源异常、PID 耗尽或者某些服务无法启动新进程时,搞懂这两个概念往往能让你找到问题的根源。
这篇文章,我们就从头到尾把僵尸进程和孤儿进程讲透。
二、本文要解决什么问题
读完这篇文章,你应该能够回答以下问题,并且能在真实的 Ubuntu 系统上动手操作:
这些问题的答案,涵盖了从入门概念到工程实践的完整层次。如果你是 Linux 初学者,建议从第三节开始顺序阅读;如果你已经对进程基础有一定了解,可以直接跳到第四节从僵尸进程开始深入。
三、Linux 进程生命周期基础回顾
在进入正题之前,我们需要把 Linux 进程生命周期的基础框架搭起来。很多读者在学 Linux 的时候,命令用得挺顺,但对"进程究竟是怎么跑起来的、怎么结束的"这条线,始终是模糊的。这个模糊会让你在遇到僵尸进程这类问题时无从下手。
3.1 进程是怎么诞生的
在 Linux 中,几乎所有的进程都是通过 fork() 系统调用诞生的。fork() 会创建一个当前进程(父进程)的副本,这个副本就是子进程。子进程继承了父进程的内存映像、文件描述符、信号处理等大量属性,但拥有独立的 PID。
很多人会问:那最初的那个进程是从哪来的?答案是 PID 1,也就是 init 进程(在 Ubuntu 22.04/24.04 中是 systemd)。它是 Linux 内核在完成初始化之后启动的第一个用户空间进程,是所有进程的"祖宗"。
系统上所有的进程,都是从 PID 1 一代一代 fork 出来的。你打开一个终端,终端模拟器(gnome-terminal 或 bash)是一个进程;你在终端里运行一个命令(比如 ls),shell 会 fork 出一个子进程来执行这个命令。整个系统就是一棵以 PID 1 为根的进程树。
用下面这个命令可以直观地看到这棵进程树:
# 以树形结构显示当前所有进程及其父子关系
pstree -p
# 如果 pstree 没有安装,先安装 psmisc 工具包
sudo apt install -y psmisc
运行之后你会看到类似这样的输出:
systemd(1)─┬─ModemManager(845)─┬─{ModemManager}(893)
│ └─{ModemManager}(894)
├─NetworkManager(832)─┬─{NetworkManager}(881)
│ └─{NetworkManager}(882)
├─sshd(1123)───sshd(2456)───bash(2458)───pstree(3201)
├─nginx(1234)─┬─nginx(1235)
│ └─nginx(1236)
└─…
这张图里,括号里的数字是 PID。你能清楚地看到进程之间的父子关系:systemd 是根,sshd 监听 SSH 连接,当你通过 SSH 登录时它 fork 出一个新的 sshd 子进程,这个子进程再 fork 出 bash,bash 再 fork 出你执行的命令。
3.2 进程状态机:从创建到消亡
一个进程在其一生中,会经历多种状态。理解这些状态,是理解僵尸进程的基础。
Linux 进程的主要状态如下:
| R | Running | 正在 CPU 上运行,或在运行队列中等待运行 |
| S | Sleeping | 可中断的睡眠状态,等待某个事件(如 I/O 完成、信号到达) |
| D | Disk sleep | 不可中断的睡眠,通常在等待磁盘 I/O,不可被 kill |
| T | Stopped | 进程被信号暂停(如 Ctrl+Z) |
| Z | Zombie | 僵尸状态,进程已退出但尚未被父进程回收 |
| X | Dead | 进程即将被删除,极少在 ps 中看到 |
| I | Idle | 内核线程空闲状态(Linux 4.14+ 新增) |
其中 Z 状态就是我们今天的主角——僵尸进程。
3.3 父子进程关系与 wait() 机制
这是整篇文章最核心的底层机制,必须搞清楚。
当一个进程调用 exit() 退出时,Linux 内核会:
这个机制的设计意图很清晰:父进程需要知道子进程是怎么退出的(正常退出还是被信号杀死,退出码是多少),内核需要一个地方保存这些信息,直到父进程来读取。这个"暂存处",就是处于僵尸状态的进程描述符。
问题就出在第5步:如果父进程没有调用 wait()——可能是父进程代码写得有问题,忘记处理 SIGCHLD,或者父进程自己陷入了死循环——那这个僵尸进程就会一直挂在那里,等待一个永远不会来的"收尸人"。
理解了这个机制,僵尸进程和孤儿进程的概念就迎刃而解了。
四、僵尸进程深度解析
4.1 什么是僵尸进程
僵尸进程(Zombie Process)是指已经执行完毕、调用了 exit() 退出,但其进程描述符(task_struct)仍然存在于内核进程表中的进程。这种进程的状态码在 ps 输出中显示为 Z,同时通常还附有 <defunct>(失效)的标记。
用一个生活化的比喻来理解:你雇了一个临时工(子进程)完成某项任务,任务完成后临时工站在门口等你来签收(父进程调用 wait() 读取退出状态),签收完成后临时工离开(进程描述符被删除)。但如果你(父进程)一直没来签收,临时工就这样站在门口,既没有在工作(资源已经释放),也走不了(进程描述符还在)。这个状态,就是僵尸。
4.2 僵尸进程是怎么产生的
僵尸进程的产生,从技术层面说,只有一个原因:子进程已退出,但父进程尚未调用 wait() 或 waitpid() 来读取子进程的退出状态。
在现实中,这通常来自以下几种情况:
情况一:父进程代码有缺陷
这是最常见的原因。父进程频繁 fork 子进程来处理任务,但在子进程退出时没有正确处理 SIGCHLD 信号,导致退出的子进程累积成大量僵尸进程。这种情况在高并发的 Web 服务、消息队列消费者等场景下很容易出现。
情况二:父进程忙于处理其他逻辑
父进程创建子进程后,自己陷入了一个长时间的阻塞操作(比如等待网络响应),在这段时间内子进程退出了,但父进程暂时没能调用 wait()。这种情况产生的是短暂的僵尸进程,父进程忙完之后通常会自行处理,危害不大。
情况三:使用了双重 fork 技巧但实现有误
在守护进程(Daemon)编程中,有一种经典的"双重 fork"技巧,目的是让最终的工作进程成为孤儿进程(被 init 接管),从而避免僵尸问题。但如果实现不当,也可能留下僵尸。
情况四:脚本中的后台进程管理不当
Shell 脚本里用 & 把进程放到后台运行,如果脚本提前退出但子进程还没结束,或者反过来子进程结束了脚本还在跑但没有 wait,都可能产生僵尸进程。
4.3 僵尸进程占用什么资源
这是很多人混淆的一点。我当时第一次遇到僵尸进程,也误以为它会占用大量内存和 CPU。实际上并非如此。
当进程进入僵尸状态时,以下资源已经被释放:
- 进程占用的物理内存和虚拟内存映射
- 打开的文件描述符
- 占用的 I/O 资源
- 信号处理器
- 子进程创建的内存映射(mmap)
仍然保留的资源只有一个:
- 进程描述符本身(task_struct):这是一个内核数据结构,保存着进程的退出状态、PID、PPID、资源使用统计(用于 getrusage())等少量信息。单个僵尸进程占用的内存极少,大概只有几 KB。
但最关键的资源是 PID(进程 ID)。
Linux 系统的 PID 是有上限的。默认情况下,Ubuntu 系统的 PID 最大值是 32768(可以通过 /proc/sys/kernel/pid_max 查看和修改,最高可以设置为 4194304)。每一个僵尸进程占用一个 PID,如果僵尸进程积累到数量与 PID 上限相近,系统就无法创建新进程——无论是 fork 还是 exec,都会失败,返回 “Resource temporarily unavailable” 的错误。
这才是僵尸进程真正的危害所在:不是内存,而是 PID 耗尽。
# 查看当前系统的 PID 最大值
cat /proc/sys/kernel/pid_max
# 查看当前系统中的僵尸进程数量
ps aux | awk '{print $8}' | grep -c '^Z'
4.4 僵尸进程有多危险
单个僵尸进程几乎没有危险。问题在于僵尸进程的累积。
如果一个服务持续产生僵尸进程,随着时间推移,僵尸进程的数量会不断增加,最终可能:
在我经历过的一次线上事故中,某个 Java 服务使用 Runtime.getRuntime().exec() 频繁调用外部命令,但没有正确调用 Process.waitFor(),导致在高峰期每分钟产生数十个僵尸进程,大约两个小时后,PID 空间耗尽,整台机器无法创建任何新进程,最终只能强制重启服务器。
4.5 如何识别僵尸进程
识别僵尸进程主要依靠 ps 和 top 命令,具体方法我们放在案例三中详细演示。这里先给出最快速的两种方式:
# 方式一:用 ps 过滤状态为 Z 的进程
# STAT 列中为 Z 的,就是僵尸进程
ps aux | grep ' Z '
# 方式二:使用 top 查看僵尸进程总数
# top 界面第一行 Tasks 信息中会显示 zombie 数量
top
在 top 的第二行,你会看到类似这样的信息:
Tasks: 214 total, 1 running, 213 sleeping, 0 stopped, 2 zombie
最后的 2 zombie 就是当前系统中的僵尸进程数量。
五、孤儿进程深度解析
5.1 什么是孤儿进程
孤儿进程(Orphan Process)是指父进程已经退出,但其子进程仍然在运行的进程。
这个名字取得非常形象——父进程死了,子进程就成了"孤儿"。
孤儿进程在概念上和僵尸进程几乎是"镜像关系":
- 僵尸进程:子进程先死,父进程还活着,但父进程不来"收尸"
- 孤儿进程:父进程先死,子进程还活着
这两个概念放在一起对比,很多人才能真正理解清楚。
5.2 孤儿进程的产生场景
孤儿进程的产生非常普遍,在日常 Linux 使用中随时都在发生:
场景一:终端关闭,程序还在运行
你在终端里运行了一个需要长时间执行的命令(比如 python train.py),然后直接关闭了终端窗口。终端进程退出,但 Python 进程可能仍然在运行(取决于信号处理)——如果它没有被 SIGHUP 信号杀死,就会成为孤儿进程。
场景二:脚本中的后台任务
在 Shell 脚本中,用 & 把一个进程放到后台,然后脚本本身退出,那个后台进程就成了孤儿进程。
场景三:守护进程的标准创建方式
传统的守护进程(Daemon)创建方式,就是主动利用孤儿进程机制:父进程 fork 出子进程后立即退出,子进程成为孤儿,被 init 接管,从此在后台运行,不受终端影响。这是一种有意为之的、正常的行为。
场景四:父进程崩溃
父进程因为 BUG、段错误或被 SIGKILL 杀死而意外退出,其仍在运行的子进程成为孤儿进程。
5.3 init/systemd 如何收养孤儿进程
Linux 内核对孤儿进程的处理方式非常优雅:内核会自动将孤儿进程的父进程重新设置为 PID 1(init/systemd),由 systemd 来承担父进程的职责。
这个机制叫做 re-parenting(重新认亲)。
systemd 作为所有孤儿进程的"终极监护人",会在孤儿进程退出时正确地调用 wait() 来回收它们。因此,孤儿进程本身不会变成僵尸进程——它们最终都会被 systemd 干净地回收。
可以用以下命令验证:
# 查看某个进程的父进程 ID(PPID)
# 如果 PPID 为 1,说明该进程的父进程是 systemd
ps -o pid,ppid,comm -p <进程PID>
在 Ubuntu 22.04/24.04 中,PID 1 是 systemd,你可以这样确认:
# 查看 PID 1 是什么进程
ps -p 1 -o pid,comm
输出:
PID COMMAND
1 systemd
值得一提的是,在某些特殊情况下(主要是容器环境),孤儿进程可能会被托管给子子进程收割者(subreaper,通过 prctl(PR_SET_CHILD_SUBREAPER, …) 设置的进程),而不是 PID 1。但在常规 Ubuntu 系统中,总是由 systemd 来收养孤儿进程。
5.4 孤儿进程是否有害
通常情况下,孤儿进程是无害的。
原因很简单:孤儿进程被 systemd 接管之后,它的生命周期管理就由 systemd 负责了。systemd 是一个设计严谨、充分测试过的 init 系统,它一定会在孤儿进程退出时正确回收它,不会产生僵尸进程。
孤儿进程继续正常运行,消耗它该消耗的资源(CPU、内存等),这些是正常的资源消耗。孤儿进程本身不会"泄漏"资源,不会积累垃圾——它和普通进程的唯一区别就是它的父进程是 systemd。
但孤儿进程在某些场景下需要警惕:
六、僵尸进程与孤儿进程的本质区别
把这两个概念并排对比,会更清晰:
| 定义 | 子进程已退出,父进程未回收 | 父进程已退出,子进程仍运行 |
| 进程状态 | Z(Zombie),已经死亡 | 正常运行状态(R/S/D等) |
| 是否占用 CPU/内存 | 否(资源已释放) | 是(正常运行中) |
| 占用 PID | 是(PID 未释放) | 是(PID 正常占用) |
| 危险性 | 积累后可能耗尽 PID | 通常无害 |
| 内核处理 | 等待父进程调用 wait() | 被 systemd 接管,正常回收 |
| 能否被 kill 杀死 | 不能(已经死了) | 可以正常 kill |
| 原因 | 父进程代码缺陷 | 父进程先退出,子进程继续运行 |
| 可能互相转化吗 | 孤儿进程退出后会成为僵尸吗?不会,systemd 会正确回收 | 僵尸进程的父进程退出后,僵尸会被 systemd 正确回收 |
最后一行特别重要:如果僵尸进程的父进程退出了,僵尸进程会被 systemd 接管并立即回收。这是处理僵尸进程的一个常用手段,我们在案例三中会详细讲。
七、实验环境准备
本文的实验都可以在 Ubuntu 22.04 LTS 或 Ubuntu 24.04 LTS 上运行,桌面版和服务器版均可。我们需要用到 C 语言编译器和 Python,这些在 Ubuntu 上很容易安装。
# 查看当前系统版本,确认是 Ubuntu 22.04 或 24.04
lsb_release -a
预期输出(22.04 为例):
No LSB modules are available.
Distributor ID: Ubuntu
Description: Ubuntu 22.04.4 LTS
Release: 22.04
Codename: jammy
# 更新软件源索引,确保安装的是最新版本
sudo apt update
# 安装 C 语言编译器(gcc)、Python 3、以及常用工具
sudo apt install -y gcc python3 psmisc procps htop
安装完成后验证:
# 验证 gcc 版本
gcc –version
# 预期输出类似:gcc (Ubuntu 11.4.0-1ubuntu1~22.04) 11.4.0
# 验证 Python3 版本
python3 –version
# 预期输出类似:Python 3.10.12
# 验证 pstree 可用(来自 psmisc 包)
pstree –version
# 预期输出类似:pstree (PSmisc) 23.4
我们还需要创建一个工作目录来存放实验代码:
# 创建实验目录
mkdir -p ~/zombie_orphan_lab
cd ~/zombie_orphan_lab
八、案例一:亲手制造一个僵尸进程
理论讲了这么多,不如亲手造一个僵尸进程来看看,这比任何文字描述都要直观。
8.1 编写产生僵尸进程的 C 程序
我们写一个简单的 C 程序:父进程 fork 出一个子进程,子进程立即退出,而父进程故意睡眠 60 秒不调用 wait(),从而让子进程的退出状态无人回收,产生一个僵尸进程。
# 进入实验目录
cd ~/zombie_orphan_lab
# 用 nano 创建源文件(你也可以用 vim)
nano zombie_demo.c
在 zombie_demo.c 中输入以下内容:
/*
* zombie_demo.c
* 演示僵尸进程的产生:父进程不调用 wait(),子进程退出后变成僵尸
*/
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
int main() {
pid_t child_pid;
printf("[父进程] PID: %d,即将 fork 子进程\\n", getpid());
child_pid = fork(); // 创建子进程
if (child_pid < 0) {
// fork 失败
perror("fork 失败");
exit(1);
}
if (child_pid == 0) {
// 子进程分支
printf("[子进程] PID: %d,PPID: %d,即将退出\\n", getpid(), getppid());
// 子进程立即退出,退出码为 0
// 此时子进程的进程描述符还在,等待父进程调用 wait() 回收
exit(0);
} else {
// 父进程分支
printf("[父进程] fork 成功,子进程 PID: %d\\n", child_pid);
printf("[父进程] 故意不调用 wait(),睡眠 60 秒…\\n");
printf("[父进程] 请在另一个终端运行: ps aux | grep Z\\n");
// 故意睡眠 60 秒,期间不调用 wait()
// 子进程在这段时间内会以僵尸状态存在
sleep(60);
printf("[父进程] 60 秒结束,退出。父进程退出后僵尸进程将被 systemd 接管并回收\\n");
}
return 0;
}
保存退出(nano 中按 Ctrl+O 保存,Ctrl+X 退出)。
# 编译 C 程序
gcc -o zombie_demo zombie_demo.c
# 确认编译成功
ls -la zombie_demo
8.2 观察僵尸进程
接下来我们需要两个终端窗口:一个运行程序,一个观察。
在终端 1 中运行程序:
cd ~/zombie_orphan_lab
./zombie_demo
你会看到输出类似:
[父进程] PID: 12345,即将 fork 子进程
[父进程] fork 成功,子进程 PID: 12346
[父进程] 故意不调用 wait(),睡眠 60 秒…
[父进程] 请在另一个终端运行: ps aux | grep Z
[子进程] PID: 12346,PPID: 12345,即将退出
在终端 2 中观察僵尸进程:
# 方法一:用 ps 查找状态为 Z 的进程
# STAT 列显示 Z 或 Zs 的就是僵尸进程
ps aux | grep 'Z'
你会看到类似:
user 12346 0.0 0.0 0 0 pts/0 Z+ 10:32 0:00 [zombie_demo] <defunct>
注意几个关键点:
- Z+ 就是僵尸状态(Z 加上 + 表示在前台进程组中)
- <defunct> 表示该进程已经失效(defunct 的英文意思就是"已故的、不再存在的")
- CPU 时间为 0:00,说明它不消耗 CPU
- 内存字段(RSS)为 0,说明不占用物理内存
# 方法二:用 ps 以更友好的格式查看,显示 PID 和 PPID
ps -eo pid,ppid,stat,comm | grep Z
输出:
PID PPID STAT COMMAND
12346 12345 Z+ zombie_demo
从这里你能清楚看到:僵尸进程(12346)的父进程是(12345),也就是我们那个故意睡眠的父进程。
# 方法三:用 top 查看僵尸进程数量
# top 界面的 Tasks 行会显示 zombie 数量
top -b -n 1 | head -5
输出(关注 zombie 字段):
Tasks: 215 total, 1 running, 214 sleeping, 0 stopped, 1 zombie
# 方法四:查看 /proc 文件系统中僵尸进程的信息
# /proc/<PID>/status 包含进程的详细状态
cat /proc/12346/status
输出中你会看到:
Name: zombie_demo
Umask: 0022
State: Z (zombie)
Tgid: 12346
Ngid: 0
Pid: 12346
PPid: 12345
…
VmPeak: (空白,因为资源已释放)
现在等待 60 秒,父进程退出后,在终端 2 中再次运行:
# 确认僵尸进程已经被回收
ps aux | grep 'Z'
# 此时应该没有输出,说明父进程退出后僵尸进程被 systemd 接管并回收了
这个实验完整地展示了僵尸进程的完整生命周期:创建 → 子进程退出 → 变为僵尸 → 父进程退出 → 被 systemd 回收。
8.3 命令解析
ps aux | grep 'Z'
这是最直接的僵尸进程查找命令。ps aux 列出系统中所有用户的所有进程,aux 中的 a 表示显示所有用户的进程,u 表示以用户友好格式显示,x 表示包含没有控制终端的进程。通过 grep 'Z' 过滤,我们找到 STAT 列包含 Z 的进程。
但这个命令有一个小问题:grep 'Z' 这个匹配模式太宽松了,可能会匹配到很多不相关的行(比如进程名中包含 Z 的进程)。更精确的用法是:
# 更精确地匹配:STAT 字段第一个字符为 Z
ps aux | awk '$8 ~ /^Z/'
cat /proc/<PID>/status
/proc 是 Linux 的"伪文件系统",它不是真正存储在磁盘上的文件系统,而是内核在内存中维护的一个接口,通过它可以读取内核的实时数据。每个进程在 /proc 下都有一个以其 PID 命名的目录,其中 status 文件包含了该进程的详细状态信息。这对于深入了解僵尸进程的残留信息非常有用。
top -b -n 1
-b 表示以批处理模式运行(不是交互式),-n 1 表示只刷新一次就退出。这种用法常见于脚本中,用于捕获某一时刻的 top 快照。
九、案例二:亲手制造一个孤儿进程
9.1 编写产生孤儿进程的 C 程序
这次我们反过来:子进程持续运行,父进程立即退出。
cd ~/zombie_orphan_lab
nano orphan_demo.c
/*
* orphan_demo.c
* 演示孤儿进程:父进程先退出,子进程继续运行
* 子进程成为孤儿后,会被 systemd(PID 1)接管
*/
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
int main() {
pid_t child_pid;
printf("[父进程] PID: %d,即将 fork 子进程\\n", getpid());
child_pid = fork();
if (child_pid < 0) {
perror("fork 失败");
exit(1);
}
if (child_pid == 0) {
// 子进程分支:父进程退出后,我们观察 PPID 的变化
printf("[子进程] PID: %d,初始 PPID: %d\\n", getpid(), getppid());
printf("[子进程] 我将每隔 5 秒打印一次自己的 PPID,观察变化\\n");
// 子进程持续运行,每5秒打印一次 PPID
for (int i = 0; i < 6; i++) {
sleep(5);
// 随着时间推移,getppid() 的返回值会从父进程的 PID 变成 1(systemd 的 PID)
printf("[子进程] 当前 PPID: %d(如果父进程已退出,这里应该是 1)\\n", getppid());
}
printf("[子进程] 运行结束,退出\\n");
exit(0);
} else {
// 父进程分支:立即退出,让子进程成为孤儿
printf("[父进程] fork 成功,子进程 PID: %d\\n", child_pid);
printf("[父进程] 父进程即将退出,子进程将成为孤儿,被 systemd 接管\\n");
printf("[父进程] 请用: ps -o pid,ppid,comm -p %d 观察子进程的 PPID 变化\\n", child_pid);
// 父进程立即退出
exit(0);
}
}
# 编译
gcc -o orphan_demo orphan_demo.c
# 运行
./orphan_demo
9.2 观察孤儿进程的 init 接管过程
父进程退出非常快,所以你的终端会立刻返回提示符。子进程在后台继续运行,你可能看到子进程的输出偶尔出现在终端上(因为子进程继承了父进程的文件描述符,包括 stdout)。
# 记下子进程的 PID(从程序输出中获得),然后观察其父进程
# 这里假设子进程 PID 是 12350
ps -o pid,ppid,stat,comm -p 12350
如果在父进程退出后执行此命令,你会看到 PPID 已经变成了 1:
PID PPID STAT COMMAND
12350 1 S orphan_demo
PPID 从原来的父进程 PID(比如 12345)变成了 1(systemd),这就是内核完成 re-parenting 的结果。
# 用 pstree 也能看到这个进程现在挂在 systemd 下面
pstree -p | grep orphan
# 输出类似:systemd(1)─…─orphan_demo(12350)
等子进程自然退出(约 30 秒)后,可以确认它被干净地回收了:
# 确认孤儿进程退出后没有留下僵尸
ps aux | grep orphan
# 应该没有输出,说明 systemd 正确回收了孤儿进程
这证明了孤儿进程的回收是由 systemd 自动处理的,不需要我们做任何干预。
9.3 命令解析
ps -o pid,ppid,stat,comm -p <PID>
这个命令使用了 ps 的自定义输出格式(-o):只显示我们关心的几个字段——PID(进程ID)、PPID(父进程ID)、STAT(状态)、COMM(命令名)。-p <PID> 则是只显示指定 PID 的进程信息。这比 ps aux 输出的信息更聚焦,在调试特定进程时非常方便。
为什么 PPID 会变成 1
这是 Linux 内核在父进程退出时自动执行的行为。当父进程退出时,内核遍历父进程的所有子进程,将其 PPID 修改为 1(PID subreaper,通常是 systemd)。这个过程完全由内核自动完成,不需要任何用户态程序的参与。
十、案例三:真实服务器中的僵尸进程排查与处理
前两个案例帮我们建立了直观认识。现在来到最重要的工程实践部分:当你在真实的服务器上遇到僵尸进程,应该怎么分析和处理?
10.1 用 ps 和 top 定位僵尸进程
# 第一步:快速确认系统中是否存在僵尸进程及其数量
# 方法一:top 概览
top -b -n 1 | grep -E "^Tasks"
输出示例:
Tasks: 214 total, 1 running, 212 sleeping, 0 stopped, 3 zombie
# 方法二:ps 列出所有僵尸进程的详细信息
# -e 列出所有进程,-o 自定义输出格式
ps -eo pid,ppid,stat,user,comm,args –sort=stat | grep '^[[:space:]]*[0-9].*Z'
# 更简洁的方式:直接过滤 STAT 列
ps aux | awk 'NR==1 || $8 ~ /^Z/'
这会输出表头和所有僵尸进程的信息,便于分析。
# 方法三:使用 /proc 文件系统统计僵尸进程数量
# 遍历 /proc/[0-9]*/status,找出状态为 zombie 的
grep -r "^State:.*zombie" /proc/[0-9]*/status 2>/dev/null
10.2 找到僵尸进程的父进程
找到僵尸进程只是第一步,真正要处理的是它的父进程。僵尸进程本身无法被 kill(因为它已经死了),必须通过父进程来解决问题。
# 假设通过上面的命令找到了僵尸进程,PID 为 12346,PPID 为 12345
# 现在查看父进程(12345)的详细信息
# 查看父进程的进程信息
ps -p 12345 -o pid,ppid,stat,comm,args
# 查看父进程打开了哪些文件描述符(判断资源泄漏情况)
ls -la /proc/12345/fd 2>/dev/null | head -20
# 查看父进程的完整命令行(有时 comm 字段被截断)
cat /proc/12345/cmdline | tr '\\0' ' '
echo # 换行
# 查看父进程创建了多少个僵尸子进程(批量僵尸的情况)
ps -eo ppid,stat | awk '$2 ~ /^Z/ {count[$1]++} END {for (ppid in count) print ppid, count[ppid]}' | sort -k2 -rn
最后这条命令会统计每个父进程下有多少个僵尸子进程,输出格式为 PPID 僵尸数量,按数量从大到小排序。这在排查批量僵尸进程时非常有用。
10.3 通过 SIGCHLD 信号触发父进程回收
找到父进程之后,第一步不是立即杀死父进程(那样会影响正在运行的服务),而是尝试发送 SIGCHLD 信号,提醒父进程"你有子进程退出了,快来处理":
# 向父进程发送 SIGCHLD 信号,提示它去回收子进程
# 注意:这种方式只对正确实现了 SIGCHLD 处理器的父进程有效
kill -SIGCHLD 12345
# 发送信号后,等待几秒,再次检查僵尸进程是否减少
sleep 3
ps aux | awk '$8 ~ /^Z/'
如果父进程的代码正确实现了 SIGCHLD 信号处理(即在信号处理函数中调用了 waitpid()),那么发送 SIGCHLD 之后,僵尸进程应该会被回收。
但如果父进程的代码根本没有处理 SIGCHLD——这才是产生大量僵尸进程的根本原因——那么发送信号也没有用。
10.4 终极手段:终止父进程
如果 SIGCHLD 没有效果,而且僵尸进程数量还在增长,那么就需要考虑终止父进程了。父进程退出后,它下面的僵尸进程会被 systemd 接管并立即回收。
# 第一步:先尝试优雅地终止父进程(SIGTERM 信号)
# SIGTERM 是礼貌的终止请求,给进程机会做清理工作
sudo kill -SIGTERM 12345
# 等待几秒,确认父进程是否正常退出
sleep 5
ps -p 12345
# 如果 SIGTERM 没有效果(进程忽略了该信号),再使用 SIGKILL
# 注意:SIGKILL 是强制终止,进程无法拦截,会立即终止,没有机会做清理
# 使用前请确认这个进程可以被安全地强制终止
sudo kill -SIGKILL 12345
# 终止父进程后,确认僵尸进程已被回收
sleep 2
ps aux | awk '$8 ~ /^Z/'
# 僵尸进程应该已经消失
⚠️ 重要提醒:在生产环境中终止服务进程之前,必须评估对业务的影响。如果这个父进程是核心服务(如 Nginx worker manager、Java 应用主进程),终止它可能会中断正在处理的请求,甚至导致数据不一致。建议在维护窗口期间操作,并提前通知相关团队。
10.5 编写可以正确回收子进程的 Python 服务
真正解决僵尸进程问题,治标在于终止有问题的父进程,治本在于修复父进程的代码,让它正确处理子进程的退出。
下面我们用 Python 演示两个版本:一个会产生僵尸进程(错误示范),一个不会(正确示范)。
错误版本:会产生僵尸进程
nano ~/zombie_orphan_lab/bad_worker.py
#!/usr/bin/env python3
"""
bad_worker.py – 会产生僵尸进程的错误示范
模拟一个父进程频繁 fork 子进程但不回收的服务
"""
import os
import time
import signal
def handle_request(request_id):
"""模拟处理一个请求"""
print(f"[子进程 {os.getpid()}] 处理请求 #{request_id},睡眠 1 秒")
time.sleep(1)
print(f"[子进程 {os.getpid()}] 请求 #{request_id} 处理完成,退出")
os._exit(0) # 子进程退出
def bad_server():
"""错误的服务:不回收子进程,会产生僵尸进程"""
print(f"[父进程 {os.getpid()}] 服务启动,将处理 5 个请求")
for i in range(5):
pid = os.fork() # 创建子进程处理请求
if pid == 0:
# 子进程:处理请求
handle_request(i)
else:
# 父进程:不调用 wait(),直接继续循环
# 这就是 BUG 所在!子进程退出后会成为僵尸进程
print(f"[父进程] fork 了子进程 {pid} 来处理请求 #{i},但不等待它退出")
time.sleep(0.5) # 简短暂停,方便观察
print(f"[父进程] 所有请求已派发,睡眠 30 秒(观察僵尸进程)")
print(f"[父进程] 请运行: ps aux | awk '$8 ~ /^Z/'")
time.sleep(30)
print("[父进程] 退出")
if __name__ == "__main__":
bad_server()
# 运行错误版本,在另一个终端观察僵尸进程
python3 ~/zombie_orphan_lab/bad_worker.py &
sleep 5
ps aux | awk 'NR==1 || $8 ~ /^Z/'
你会看到多个 python3 <defunct> 的僵尸进程。
正确版本一:使用 signal.signal 处理 SIGCHLD
nano ~/zombie_orphan_lab/good_worker_signal.py
#!/usr/bin/env python3
"""
good_worker_signal.py – 通过注册 SIGCHLD 信号处理器来正确回收子进程
"""
import os
import time
import signal
def sigchld_handler(signum, frame):
"""
SIGCHLD 信号处理器:当有子进程退出时,内核会发送 SIGCHLD 给父进程
我们在这里调用 waitpid 来回收所有已退出的子进程
"""
while True:
try:
# waitpid(-1, …) 等待任意子进程
# os.WNOHANG 表示非阻塞:如果没有子进程退出,立即返回而不是阻塞
pid, status = os.waitpid(–1, os.WNOHANG)
if pid == 0:
# 没有更多已退出的子进程了,退出循环
break
print(f"[父进程] 成功回收子进程 {pid},退出状态: {os.WEXITSTATUS(status)}")
except ChildProcessError:
# 没有子进程了
break
except Exception as e:
print(f"[父进程] waitpid 异常: {e}")
break
def handle_request(request_id):
"""子进程处理请求"""
print(f"[子进程 {os.getpid()}] 处理请求 #{request_id}")
time.sleep(1)
print(f"[子进程 {os.getpid()}] 请求 #{request_id} 完成")
os._exit(0)
def good_server_with_signal():
"""正确的服务:注册 SIGCHLD 信号处理器"""
# 注册 SIGCHLD 信号处理器
# 当任何子进程退出时,内核会向我们发送 SIGCHLD,我们在回调中回收它
signal.signal(signal.SIGCHLD, sigchld_handler)
print(f"[父进程 {os.getpid()}] 服务启动(已注册 SIGCHLD 处理器)")
for i in range(5):
pid = os.fork()
if pid == 0:
handle_request(i)
else:
print(f"[父进程] fork 了子进程 {pid} 处理请求 #{i}")
time.sleep(0.5)
print("[父进程] 所有请求已派发,睡眠 10 秒")
print("[父进程] 请运行: ps aux | awk '$8 ~ /^Z/' 确认没有僵尸进程")
time.sleep(10)
print("[父进程] 退出")
if __name__ == "__main__":
good_server_with_signal()
正确版本二:使用 subprocess 模块(Python 推荐方式)
在实际的 Python 项目中,我更推荐使用 subprocess 模块而不是直接调用 os.fork()。subprocess 模块封装了进程管理的细节,用起来更安全:
nano ~/zombie_orphan_lab/good_worker_subprocess.py
#!/usr/bin/env python3
"""
good_worker_subprocess.py
使用 subprocess 模块,这是 Python 中管理子进程的推荐方式
subprocess 模块会在适当时机回收子进程,不会产生僵尸进程
"""
import subprocess
import time
def run_task(task_id):
"""使用 subprocess 运行一个子任务"""
print(f"[主进程] 启动任务 #{task_id}")
# subprocess.run 会等待子进程完成并回收它
# 这是最简单的方式,适合串行任务
result = subprocess.run(
["python3", "-c", f"import time; print('任务 {task_id} 运行中'); time.sleep(1); print('任务 {task_id} 完成')"],
capture_output=True,
text=True
)
print(f"[主进程] 任务 #{task_id} 已完成,返回码: {result.returncode}")
print(f"[主进程] 任务输出: {result.stdout.strip()}")
def good_server_subprocess():
"""使用 subprocess 的正确服务,自动管理子进程生命周期"""
print("[主进程] 服务启动(使用 subprocess 模块)")
for i in range(3):
run_task(i)
print("[主进程] 所有任务完成,无僵尸进程")
if __name__ == "__main__":
good_server_subprocess()
# 运行正确版本,确认没有僵尸进程产生
python3 ~/zombie_orphan_lab/good_worker_signal.py &
sleep 8
echo "=== 检查僵尸进程 ==="
ps aux | awk 'NR==1 || $8 ~ /^Z/'
echo "=== 如果上面只有表头,说明没有僵尸进程 ==="
10.6 命令解析
kill -SIGTERM 和 kill -SIGKILL 的区别
这是一个很多初学者容易混淆的点。SIGTERM(信号编号 15)是"请求终止"信号,进程可以捕获并处理它——通常用于做清理工作(关闭数据库连接、刷新缓冲区、保存状态等),然后再退出。SIGKILL(信号编号 9)是"强制终止"信号,进程无法捕获、忽略或拦截它,内核会直接强制终止进程。
原则是:优先使用 SIGTERM,只有在 SIGTERM 无效时才使用 SIGKILL。
强制 SIGKILL 的问题在于:进程没有机会做清理,可能导致:
- 临时文件没有删除
- 数据库连接没有正常关闭
- 正在写入的文件损坏
- 持有的锁没有释放
os.waitpid(-1, os.WNOHANG) 的含义
waitpid 是 Python 对系统调用 waitpid() 的直接封装。第一个参数 -1 表示等待任意子进程(而不是指定 PID 的子进程)。os.WNOHANG 是一个标志位,表示"非阻塞模式":如果当前没有已退出的子进程,立即返回 (0, 0) 而不是阻塞等待。在 SIGCHLD 处理器中,我们用 while True 循环配合 WNOHANG,一次性回收所有已退出的子进程——这很重要,因为多个子进程可能同时退出,但 SIGCHLD 信号可能只发送一次(信号不会排队)。
十一、进程状态码全解析
在排查僵尸进程和孤儿进程时,我们会频繁看到进程的状态码。这里对 ps 输出中的 STAT 字段做一个完整解析,这在实际排查中非常实用。
STAT 字段可以包含多个字符,第一个字符是主状态,后面的字符是附加标记:
主状态字符:
| R | Running(运行中或可运行) | 进程正在 CPU 上执行,或在运行队列中等待 |
| S | Sleeping(可中断睡眠) | 等待某个事件,如 I/O 完成、定时器触发、信号到达 |
| D | Disk sleep(不可中断睡眠) | 等待磁盘 I/O,此状态的进程不能被 kill |
| T | Stopped(已停止) | 被 SIGSTOP 或 Ctrl+Z 暂停 |
| t | Tracing stop(跟踪停止) | 被调试器(如 gdb/strace)暂停 |
| Z | Zombie(僵尸) | 已退出但未被父进程回收 |
| X | Dead(死亡) | 即将被删除,几乎不会在 ps 输出中看到 |
| I | Idle(空闲) | 内核线程,处于空闲状态 |
附加标记字符:
| < | 高优先级进程(nice 值为负) |
| N | 低优先级进程(nice 值为正) |
| L | 有内存页被锁定在内存中(常见于实时进程) |
| s | 会话领导者(Session Leader) |
| + | 属于前台进程组 |
| l | 多线程进程 |
举几个常见组合:
- Ss – 处于睡眠状态,且是会话领导者(常见于 sshd、bash 等)
- Sl – 睡眠中的多线程进程(常见于 Java、Node.js 进程)
- R+ – 在前台运行中
- Z+ – 在前台的僵尸进程(你主动运行的程序产生的)
- Zs – 会话领导者的僵尸(比较少见)
- D – 不可中断睡眠(出现大量 D 状态通常意味着磁盘 I/O 问题)
十二、流程图
12.1 进程完整生命周期状态图
相关示意图绘制如下,仅供大家保存查阅:

这张状态图展示了 Linux 进程完整的生命周期。注意 Zombie 是一个"末态",进程进入 Zombie 状态后只能通过父进程调用 wait() 来彻底消亡,没有其他路径。这也解释了为什么对僵尸进程使用 kill 无效——它已经死了,只是"尸体"还没有被清理。
12.2 僵尸进程产生与消亡流程
相关示意图绘制如下,仅供大家保存查阅:
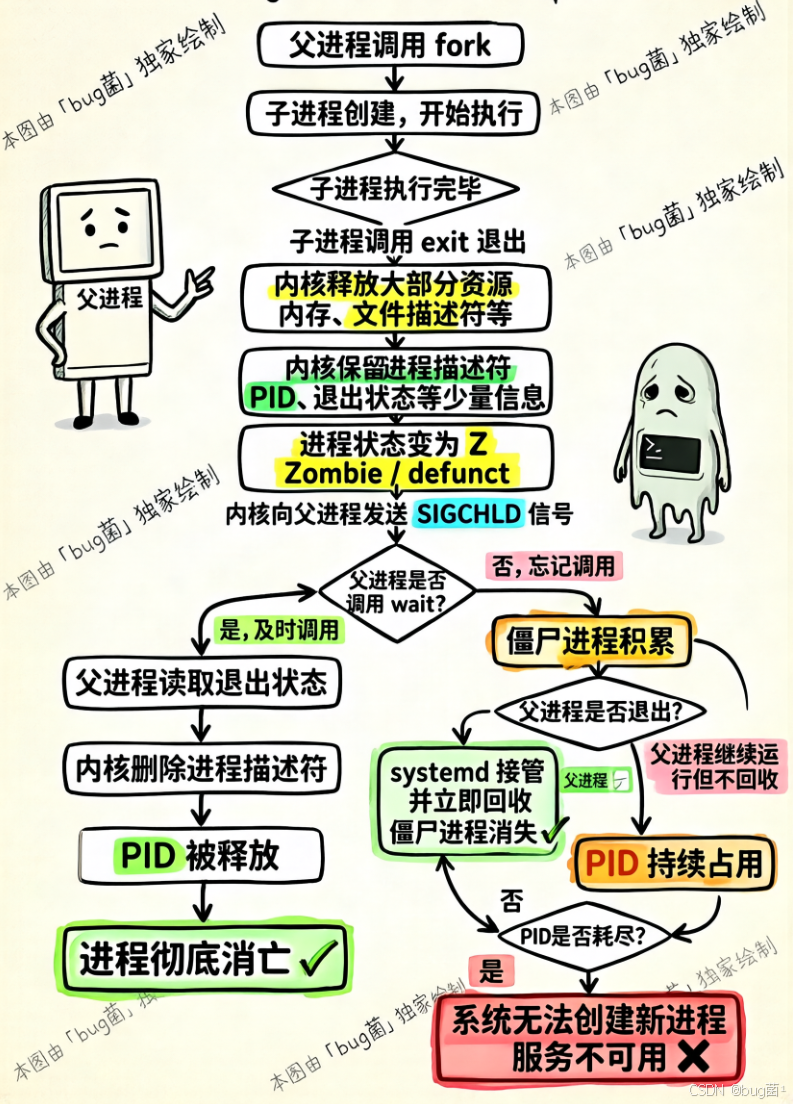
这张图清楚地展示了僵尸进程的两条消亡路径:一是父进程及时调用 wait() 正常回收;二是父进程退出后由 systemd 代为回收。只有父进程长期不退出且持续产生僵尸,才会走向最坏的结局——PID 耗尽。
12.3 孤儿进程被 init 接管流程
相关示意图绘制如下,仅供大家保存查阅:
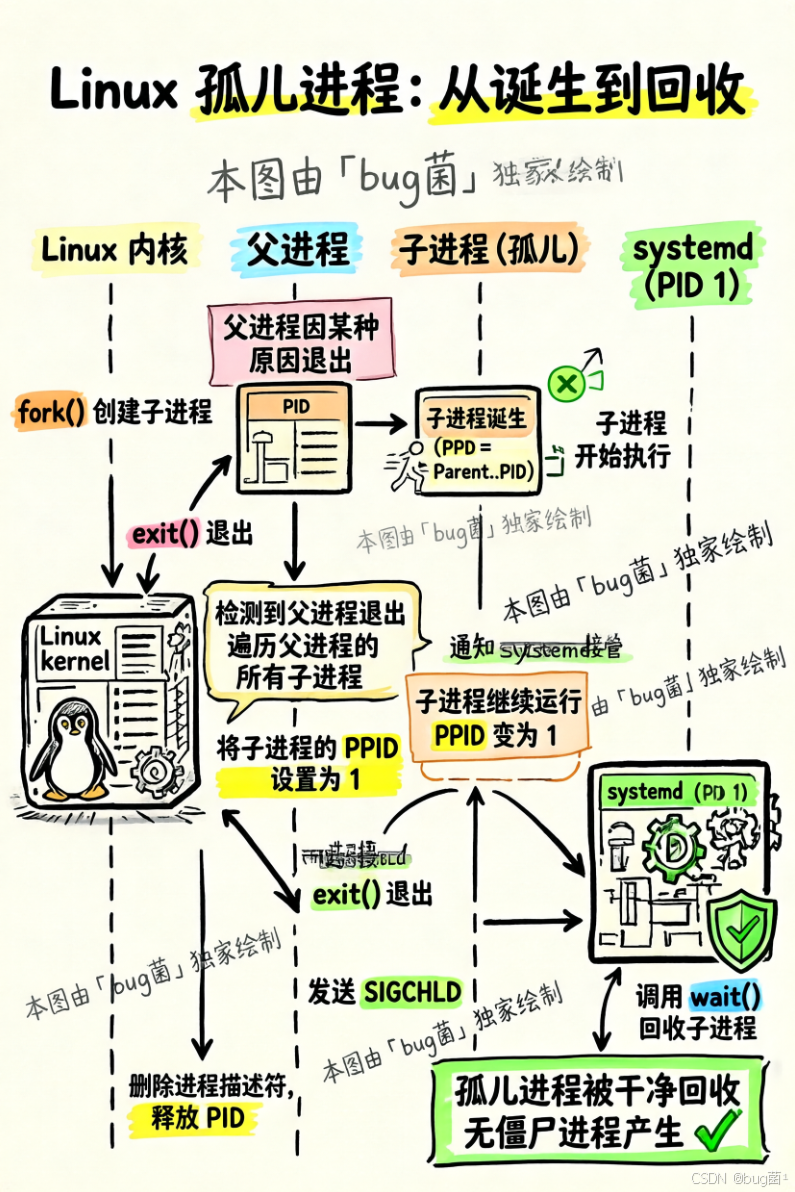
这张时序图展示了孤儿进程被 systemd 接管的完整过程。关键步骤是内核在父进程退出时自动执行的 re-parenting 操作——这完全是内核行为,systemd 不需要做任何主动操作,只需要在孤儿进程退出时正常处理 SIGCHLD 信号(systemd 作为 init 系统,自然会这么做)。
12.4 生产环境僵尸进程排查流程
相关示意图绘制如下,仅供大家保存查阅:
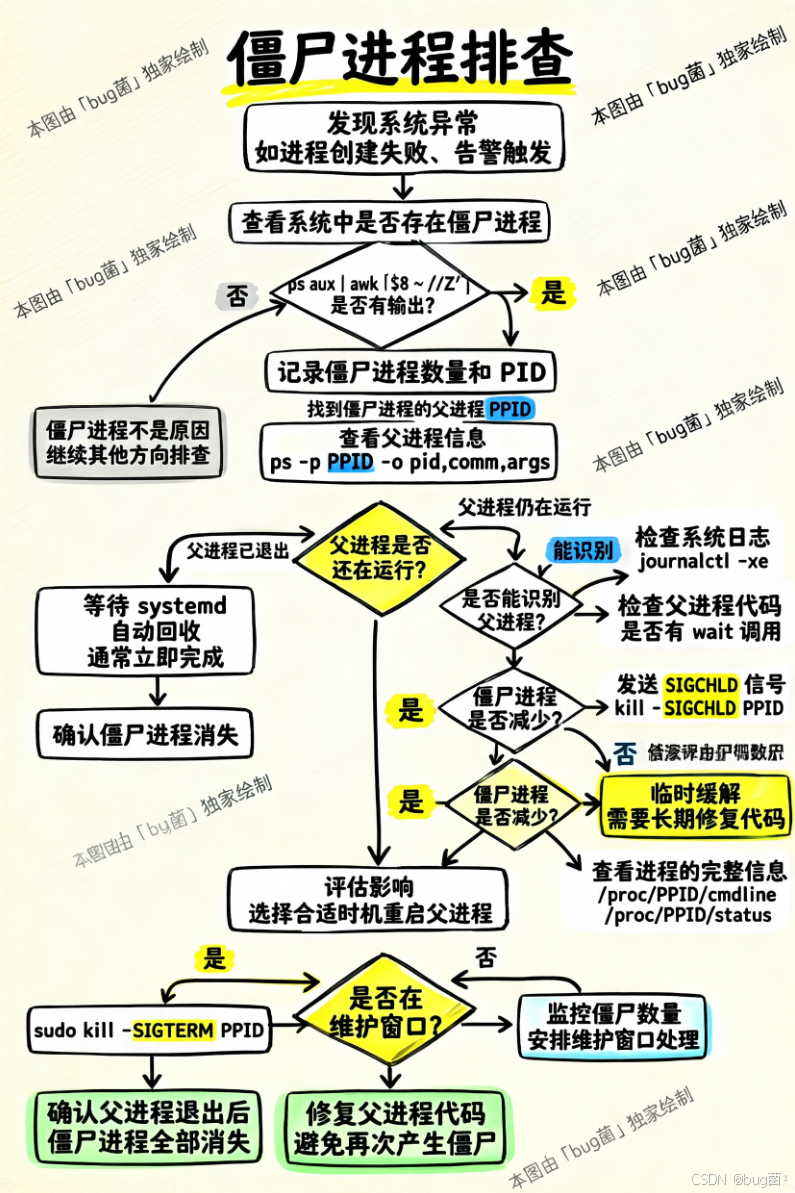
这张排查流程图是我在实际工作中总结出来的排查路径。核心原则是:先找父进程,再评估影响,最后选择合适手段处理。不要一上来就 kill -9,那会带来更多问题。
十三、深入原理:内核视角下的进程回收
如果你只是运维角色,前面的内容已经足够使用了。这一节深入一些,从内核角度讲清楚底层机制,适合对原理感兴趣的读者,或者需要写系统级程序的开发者。
13.1 进程描述符与 task_struct
在 Linux 内核中,每个进程都由一个 task_struct 结构体来描述。这个结构体是进程在内核中的"身份证",包含了进程运行所需的所有信息。
当进程调用 exit() 时,内核会:
此时 task_struct 中保留的关键字段包括:
exit_code – 进程退出码(供父进程读取)
exit_signal – 导致退出的信号编号
ru_utime – 用户态 CPU 时间(供 getrusage 使用)
ru_stime – 内核态 CPU 时间
…
这些信息非常少(几十到几百字节),但在父进程调用 wait() 之前,必须保留。
13.2 wait() 系列系统调用
父进程通过以下几个系统调用来回收子进程:
| wait(status) | 等待任意子进程退出(阻塞),只能回收一个 |
| waitpid(pid, status, options) | 等待指定 PID 的子进程,可设置非阻塞选项 |
| waitid(idtype, id, infop, options) | 更灵活的等待,提供更多退出信息 |
| wait3(status, options, rusage) | 带资源使用统计的等待 |
| wait4(pid, status, options, rusage) | 结合 waitpid 和 wait3 |
在 C 语言中,正确的非阻塞回收子进程的惯用法是:
/*
* 在 SIGCHLD 信号处理器中使用此惯用法
* 循环回收所有已退出的子进程
* 必须使用 WNOHANG,否则在没有已退出子进程时会阻塞
*/
void sigchld_handler(int signum) {
int saved_errno = errno; // 保存 errno,信号处理器可能被中断
int status;
pid_t pid;
/* 循环直到没有更多已退出的子进程 */
while ((pid = waitpid(–1, &status, WNOHANG)) > 0) {
if (WIFEXITED(status)) {
/* 子进程正常退出 */
printf("子进程 %d 以退出码 %d 正常退出\\n", pid, WEXITSTATUS(status));
} else if (WIFSIGNALED(status)) {
/* 子进程被信号杀死 */
printf("子进程 %d 被信号 %d 杀死\\n", pid, WTERMSIG(status));
}
}
errno = saved_errno; // 恢复 errno
}
13.3 SIGCHLD 信号的作用
SIGCHLD 信号是进程管理中的一个关键信号,它在以下情况下由内核发送给父进程:
SIGCHLD 的默认处理方式是忽略(SIG_DFL 实际上是忽略此信号的)。但有一个重要的细节:即使父进程"忽略"了 SIGCHLD,在某些实现中内核也会自动回收子进程(这取决于具体的 SA_NOCLDWAIT 标志设置)。
在 Ubuntu(Linux 内核)中,如果你显式地将 SIGCHLD 设置为 SIG_IGN(而不是默认的忽略),内核会自动回收所有子进程,不会产生僵尸进程。这是一个很有用的特性:
/*
* 通过显式设置 SIGCHLD 为 SIG_IGN,
* 告诉内核自动回收子进程(不产生僵尸)
* 注意:这样做之后,你也无法通过 wait() 获取子进程的退出状态了
*/
signal(SIGCHLD, SIG_IGN);
但要注意,这种方式你丢失了获取子进程退出状态的能力。如果你需要知道子进程是否成功完成了任务,还是需要显式调用 wait()。
13.4 为什么 PID 1 永远不会产生僵尸进程
这是一个有趣的设计问题:systemd(PID 1)管理着系统中所有的孤儿进程,那 systemd 自己会不会产生僵尸进程?
答案是:理论上可以,但 systemd 的实现保证了不会。
systemd 有一个专门的事件循环来处理 SIGCHLD 信号。当任何子进程(包括通过 re-parenting 托管给它的孤儿进程)退出时,systemd 都会及时调用 waitpid() 来回收它。这是 systemd 作为 init 系统的核心职责之一。
事实上,Linux 内核也给予了 PID 1 特殊待遇:如果 PID 1 退出,内核会触发 kernel panic(内核恐慌),因为 init 进程的退出意味着没有任何进程能够继续管理系统了。
十四、Docker 容器中的僵尸进程问题
这一节非常实用。在 Docker 容器变得普及之后,僵尸进程问题有了一个新的高发场景,很多开发者在容器里遇到僵尸进程时摸不着头脑。
14.1 容器内的 PID 1 陷阱
在 Docker 容器中,你的应用进程通常就是 PID 1。这看起来没什么问题,但有一个重要的差别:
普通应用进程并没有实现 init 的职责。
也就是说,当你的 Node.js 应用(PID 1)fork 了子进程,或者通过 exec 调用了外部命令,这些子进程退出后,如果你的 Node.js 应用没有正确回收它们,就会在容器内积累僵尸进程。
更糟糕的是,当容器内有孤儿进程(比如你的 Node.js 应用 fork 了子进程后崩溃了)时,本来应该被 systemd 接管的孤儿进程,在容器内只能被托管给 PID 1——也就是你自己的应用。如果你的应用(PID 1)已经崩溃了,那孤儿进程就真的无家可归了。
在容器内查看是否有僵尸进程:
# 进入容器内部检查
docker exec -it <container_name> ps aux
# 查看是否有 Z 状态的进程
# 或者从宿主机角度查看容器内的所有进程
# –pid 是容器使用的 PID namespace
ps aux | grep defunct
14.2 使用 tini 解决容器僵尸进程问题
tini 是一个专为容器设计的轻量级 init 系统,它的核心功能只有两个:
在 Dockerfile 中使用 tini:
# 方式一:手动安装 tini
FROM ubuntu:22.04
# 安装 tini
RUN apt-get update && apt-get install -y tini
# 使用 tini 作为 ENTRYPOINT,它会作为 PID 1 运行
# 然后 tini 会 exec 你的实际应用进程
ENTRYPOINT ["/usr/bin/tini", "–"]
# 你的实际应用
CMD ["python3", "your_app.py"]
# 方式二:使用多阶段构建从 tini 官方镜像复制
FROM tini AS tini-base
FROM ubuntu:22.04
COPY –from=tini-base /tini /tini
ENTRYPOINT ["/tini", "–"]
CMD ["your_app"]
tini 的工作原理非常清晰:它作为 PID 1 运行,负责:
- 调用 exec 启动你的实际应用(所以你的应用不会是 PID 1)
- 注册 SIGCHLD 处理器,及时回收所有孤儿和僵尸进程
- 将 SIGTERM 等信号转发给你的应用进程
14.3 Docker 官方推荐的 init 方案
Docker 在 1.13 版本之后内置了对 –init 参数的支持(底层也是基于 tini):
# 运行容器时使用 –init 参数
# Docker 会自动在容器内注入一个轻量级 init 进程
docker run –init my_image
# 对于 Docker Compose,在服务配置中添加:
# (这是 docker-compose.yml 的配置方式)
# docker-compose.yml 示例
version: '3.8'
services:
app:
image: my_app:latest
init: true # 启用 init,解决容器内僵尸进程问题
ports:
– "8080:8080"
# 验证:进入容器后,PID 1 应该是 tini 而不是你的应用
docker exec -it my_container ps aux | head -5
验证输出应类似:
PID USER TIME COMMAND
1 root 0:00 /sbin/docker-init — python3 your_app.py
7 root 0:00 python3 your_app.py
十五、systemd 与进程生命周期管理
systemd 不只是一个"服务启动器",它对进程生命周期的管理非常精细。在排查和处理僵尸进程相关问题时,了解 systemd 的行为很重要。
15.1 systemd 如何管理子进程
每当 systemd 启动一个服务(Unit),它会:
这意味着,通过 systemd 管理的服务,其子进程的生命周期也由 systemd 接管。即使服务主进程 fork 出了子进程并忘记回收,systemd 也会通过 cgroup 机制来清理。
# 查看某个服务的 cgroup,以 nginx 为例
systemctl status nginx | grep CGroup
# 或者
cat /sys/fs/cgroup/system.slice/nginx.service/cgroup.procs
# 查看 systemd 管理下的进程树
# -a 显示所有进程,-l 显示完整命令行,-p 显示 PID
systemd-cgls
15.2 KillMode 配置的重要性
systemd 服务的 KillMode 参数控制着当服务停止时,如何终止相关进程。这个参数和僵尸进程的关系很密切:
| control-group(默认) | 终止服务 cgroup 中的所有进程 |
| process | 只终止主进程(MainPID),子进程不受影响(可能成为孤儿) |
| mixed | 主进程发 SIGTERM,cgroup 中其他进程发 SIGKILL |
| none | 不终止任何进程,只执行 ExecStop 命令 |
默认的 control-group 模式是最安全的——它保证服务停止时,所有相关子进程都被清理,不会产生孤儿进程。
# 查看一个服务的 KillMode 配置
systemctl show nginx | grep KillMode
15.3 实际服务配置示例
如果你要为自己的服务编写 systemd unit 文件,以下是一个处理子进程生命周期的推荐配置:
# 创建一个示例服务的 unit 文件
sudo nano /etc/systemd/system/myworker.service
# /etc/systemd/system/myworker.service
# 一个正确处理子进程生命周期的 systemd 服务配置示例
[Unit]
Description=My Worker Service
Documentation=https://example.com/docs
After=network.target
[Service]
Type=forking
# 指定服务主进程的 PID 文件(forking 类型必须)
PIDFile=/run/myworker/myworker.pid
User=www-data
Group=www-data
# 工作目录
WorkingDirectory=/opt/myworker
# 启动命令
ExecStart=/opt/myworker/bin/myworker –daemon –pidfile=/run/myworker/myworker.pid
# 停止命令(优雅停止)
ExecStop=/bin/kill -TERM $MAINPID
# 重新加载命令(如支持热重载)
ExecReload=/bin/kill -HUP $MAINPID
# 终止模式:终止服务 cgroup 中的所有进程
# 这是默认值,显式写出以明确意图
KillMode=control-group
# 发送 SIGTERM 后等待的时间(秒),超时后发 SIGKILL
TimeoutStopSec=30
# 服务崩溃时自动重启
Restart=on-failure
# 失败重启间隔
RestartSec=5s
# 限制最大子进程数(防止 fork 炸弹导致系统不稳定)
TasksMax=256
[Install]
WantedBy=multi-user.target
# 重新加载 systemd 配置
sudo systemctl daemon-reload
# 启动服务
sudo systemctl start myworker
# 查看服务状态
systemctl status myworker
# 查看服务日志
journalctl -u myworker -f
# 验证服务停止时子进程是否被正确清理
sudo systemctl stop myworker
# 停止后,检查是否有僵尸进程或遗留子进程
ps aux | grep myworker
十六、常见问题与踩坑总结
Q1:我用 kill -9 可以杀死僵尸进程吗?
不行。kill -9 发送的是 SIGKILL 信号,但僵尸进程已经死了——它的代码不再运行,无法接收任何信号,更无法处理信号。对僵尸进程发送任何信号都没有效果。唯一能清除僵尸进程的方法是让其父进程调用 wait(),或者终止其父进程(父进程退出后,systemd 会接管并立即回收)。
这是初学者最常见的误区之一,我自己最初也犯过这个错误。当时在服务器上看到 <defunct> 的进程,直觉反应就是 kill -9,然后发现毫无效果,才开始认真研究为什么。
Q2:系统中有几个僵尸进程,需要立刻处理吗?
不一定。偶尔出现一两个短暂的僵尸进程是正常现象——父进程在某个操作完成后会回收它们。真正需要警惕的是:数量持续增长、长时间不减少、数量超过几十个的情况。
判断方式:观察一段时间(比如5分钟),如果僵尸进程数量在减少或保持稳定(且数量很少),通常不需要立即处理。如果数量在持续增长,就需要排查父进程的问题了。
Q3:孤儿进程会自动变成僵尸进程吗?
不会。孤儿进程被 systemd 接管后,systemd 会在孤儿进程退出时正确调用 wait() 来回收它,不会产生僵尸进程。这是 Linux 进程管理设计中很优雅的一点。
Q4:如果僵尸进程的父进程本身就是一个系统关键服务(如 Nginx),不能随便终止怎么办?
这种情况需要分析僵尸进程是否在持续增长。如果 Nginx 确实在持续产生僵尸进程,通常说明某个 Nginx 模块或配置有问题。
处理建议:
# 查看 Nginx 产生了多少僵尸进程
ps -eo ppid,stat | awk '$2 ~ /^Z/ {count[$1]++} END {for (p in count) print p, count[p]}'
# 如果数量不多且不在增长,先记录监控,等维护窗口优雅重启
sudo systemctl reload nginx # 先尝试 reload(不中断连接)
# 如果必须重启,先确认在低峰期
sudo systemctl restart nginx
Q5:为什么 ps aux 中有时候看到 Z 状态,但几秒后就消失了?
这是正常的短暂僵尸状态。进程从退出到父进程调用 wait() 之间,必然有一段时间处于僵尸状态。如果父进程反应迅速(注册了 SIGCHLD 处理器并及时调用 wait()),这段时间可能只有毫秒级别,在 ps 输出中来不及显示就消失了。短暂的僵尸进程是完全正常的,不必担心。
Q6:在 Shell 脚本中,& 运行的后台进程会产生僵尸进程吗?
会,在脚本退出之前是僵尸状态。但 Shell 本身处理了这个问题:Bash 在脚本结束时会自动回收后台进程。如果你的脚本需要等待后台进程完成并获取其退出码,应该使用 wait 命令:
#!/bin/bash
# 启动后台进程
./long_task.sh &
TASK_PID=$! # 获取后台进程的 PID
# 做一些其他事情
echo "任务正在后台运行…"
# 等待后台进程完成并获取退出码
wait $TASK_PID
EXIT_CODE=$?
if [ $EXIT_CODE -eq 0 ]; then
echo "任务成功完成"
else
echo "任务失败,退出码: $EXIT_CODE"
fi
Q7:Java 程序调用 Runtime.getRuntime().exec() 后会产生僵尸进程吗?
会,如果不正确处理的话。Java 的 Runtime.exec() 和 ProcessBuilder 都需要调用 Process.waitFor() 或者至少消耗掉子进程的 stdout/stderr 流,否则子进程退出后会成为僵尸进程(直到 Java JVM 的垃圾回收器回收 Process 对象并调用 finalize(),才会触发 wait()——这个时机是不确定的)。
正确的 Java 代码示例:
ProcessBuilder pb = new ProcessBuilder("ls", "-la");
pb.redirectErrorStream(true);
Process process = pb.start();
// 消耗输出(防止缓冲区阻塞)
try (BufferedReader reader = new BufferedReader(
new InputStreamReader(process.getInputStream()))) {
String line;
while ((line = reader.readLine()) != null) {
System.out.println(line);
}
}
// 等待进程完成并获取退出码(这会隐式回收子进程)
int exitCode = process.waitFor();
Q8:Docker 容器里的应用频繁产生僵尸进程,但我不想修改代码怎么办?
最简单的方案是在 docker run 时加上 –init 参数,或者在 Docker Compose 中设置 init: true。Docker 会在容器内注入一个 tini 作为 PID 1,由它来处理所有孤儿和僵尸进程,你的应用代码不需要任何修改。
# 使用 –init 运行容器
docker run –init -d my_buggy_image
# 验证
docker exec <container_id> ps aux | head -5
# PID 1 应该是 docker-init 或 tini,而不是你的应用
Q9:如果一个服务在 Ubuntu 服务器上持续产生僵尸进程,影响了系统可用性,有没有临时缓解措施?
如果维护窗口还没到,但僵尸进程数量已经很多,可以临时调高 PID 最大值来争取时间:
# 查看当前 PID 最大值
cat /proc/sys/kernel/pid_max
# 临时调高(这是运行时修改,重启后恢复默认值)
# 最大可以设置为 4194304(内核支持的最大值)
sudo sysctl -w kernel.pid_max=1000000
# 如果要永久生效,修改 sysctl 配置文件
sudo nano /etc/sysctl.d/99-pid-max.conf
# 内容:
# kernel.pid_max = 1000000
sudo sysctl -p /etc/sysctl.d/99-pid-max.conf
⚠️ 这只是临时缓解措施,不能从根本上解决问题。根本解决方案还是找到并修复产生僵尸进程的父进程。
Q10:/proc/sys/kernel/pid_max 和进程数量的关系是什么?
/proc/sys/kernel/pid_max 定义的是 PID 的最大值,不是系统能同时运行的最大进程数。每个进程在创建时会被分配一个 PID(从小到大分配,到达最大值后循环回来从小值开始分配)。如果所有小于 pid_max 的 PID 都已经被使用中的进程占用(包括僵尸进程),那么新的进程就无法创建了。
十七、最佳实践建议
这一节是我在实际工作中总结的、真实有效的最佳实践,不是照抄手册的理论。
1. 程序开发层面:主动处理 SIGCHLD
无论你用什么语言写服务,只要涉及到 fork 子进程或调用外部命令,都要确保子进程的退出状态被正确读取。
- C/C++:注册 SIGCHLD 信号处理器,在其中循环调用 waitpid(-1, …, WNOHANG)
- Python:使用 subprocess.Popen 时,记得调用 wait() 或 communicate();使用 os.fork() 时,同样需要注册 signal.SIGCHLD 处理器
- Java:调用 Process.waitFor() 并消耗进程的 stdout/stderr
- Node.js:child_process.spawn() 注册 close 或 exit 事件
- Go:使用 cmd.Wait() 等待子进程完成
2. Docker 化服务:始终使用 init
在 Kubernetes、Docker Compose、Docker Swarm 等容器编排环境中,为每个服务容器启用 init(–init 或 init: true),这是一个代价极低但收益明显的最佳实践,可以避免大量难以调试的容器内僵尸进程问题。
3. systemd 服务:使用 cgroup 管理进程生命周期
对于通过 systemd 管理的服务,保持 KillMode=control-group(默认值),让 systemd 在服务停止时清理所有相关进程。不要轻易修改为 KillMode=process,除非你非常清楚自己在做什么。
4. 监控:设置僵尸进程数量告警
在生产服务器上,通过监控系统(如 Prometheus + Alertmanager、Zabbix、Nagios 等)设置僵尸进程数量的告警阈值。建议:
- 警告(Warning)阈值:5个以上
- 严重(Critical)阈值:20个以上
# 用于监控脚本的僵尸进程计数命令
ZOMBIE_COUNT=$(ps -eo stat | grep -c '^Z')
echo "当前僵尸进程数量: $ZOMBIE_COUNT"
5. 排查:用结构化方式排查,不要盲目操作
遇到僵尸进程问题时,按以下顺序排查,不要上来就 kill -9:
第一步:确认数量和趋势(是偶发还是持续增长?)
第二步:找到父进程(ps -eo pid,ppid,stat,comm | grep Z)
第三步:评估父进程是否可以重启(业务影响评估)
第四步:先尝试 SIGCHLD(kill -SIGCHLD PPID)
第五步:必要时在维护窗口重启父进程(先 SIGTERM,再 SIGKILL)
第六步:从代码层面修复根本原因
6. 版本选择:使用 Ubuntu LTS 版本
坚持使用 Ubuntu 22.04 LTS 或 Ubuntu 24.04 LTS。LTS(Long Term Support)版本拥有5年的官方支持周期(付费可延长到10年),内核和 systemd 版本稳定,进程管理机制成熟。Ubuntu 22.04 使用 Linux 内核 5.15,Ubuntu 24.04 使用 Linux 内核 6.8,两者的进程管理功能都非常完善。
避免使用非 LTS 版本(如 22.10、23.04 等)在生产环境部署,它们的支持周期只有9个月。
7. 备份与变更管理
在修改任何 systemd 服务配置或系统参数之前,记录原始值:
# 备份 systemd 服务配置
sudo cp /etc/systemd/system/myservice.service /etc/systemd/system/myservice.service.bak
# 记录当前 sysctl 参数值
sudo sysctl -a > ~/sysctl_backup_$(date +%Y%m%d).txt
# 修改后如果有问题,可以快速恢复
sudo cp /etc/systemd/system/myservice.service.bak /etc/systemd/system/myservice.service
sudo systemctl daemon-reload
十八、扩展知识点
进程组与会话
理解僵尸进程时,了解进程组(Process Group)和会话(Session)的概念会有帮助。
进程组:一组相关进程的集合,拥有共同的 PGID(进程组ID)。信号可以发送给整个进程组(使用负 PID 值)。
会话:一个或多个进程组的集合,通常对应一个登录会话或一个终端。
# 查看进程的 PID、PGID、SID(会话ID)
ps -eo pid,pgid,sid,comm
# 向整个进程组发送信号(负 PID 值代表 PGID)
# 例如,终止 PGID 为 12345 的进程组中的所有进程
kill — -12345 # 注意双破折号,防止被解析为选项
subreaper 机制
在 Linux 3.4+ 中,进程可以通过 prctl(PR_SET_CHILD_SUBREAPER, 1) 将自己设置为"子孙进程收割者"(subreaper)。这样,在 PID 1 之前,孤儿进程会先被托管给最近的 subreaper,而不是直接交给 init。
这个机制主要用于容器运行时(如 Docker 的 containerd)和一些进程管理工具(如 s6、runit)。理解这个机制有助于你理解为什么 Docker 容器内的 PID 1 行为会有所不同。
# 查看一个进程是否设置了 subreaper 标志
cat /proc/<PID>/status | grep NoNewPrivs
# 注:subreaper 标志没有直接在 status 中显示,需要通过代码读取
/proc 文件系统深度使用
对于进程调试,/proc 文件系统提供了丰富的信息:
# 查看进程的内存映射
cat /proc/<PID>/maps
# 查看进程的文件描述符
ls -la /proc/<PID>/fd
# 查看进程的命名空间信息(容器相关)
ls -la /proc/<PID>/ns
# 查看进程的 cgroup 归属
cat /proc/<PID>/cgroup
# 查看进程的完整信息(内核视角)
cat /proc/<PID>/stat
使用 strace 跟踪进程系统调用
当你怀疑一个服务在子进程管理上有问题时,可以用 strace 跟踪其系统调用,观察是否调用了 wait() 系列函数:
# 安装 strace
sudo apt install -y strace
# 跟踪某个进程的系统调用,过滤 wait 相关调用
sudo strace -p <PID> -e trace=wait4,waitpid,waitid 2>&1
如果你看到 waitpid(-1, …) 被周期性调用,说明父进程在正确地回收子进程。如果完全没有 wait 相关调用,说明父进程根本没有处理子进程退出,这就是僵尸进程的根源。
十九、完整操作流程回顾
下面是本文所有核心操作的完整流程汇总,你可以把它作为一个操作手册来使用。
步骤一:环境准备
# 更新系统软件源索引
sudo apt update
# 安装必要工具
sudo apt install -y gcc python3 psmisc procps htop strace
# 创建实验目录
mkdir -p ~/zombie_orphan_lab && cd ~/zombie_orphan_lab
步骤二:理解进程状态
# 查看所有进程及其状态
ps aux
# 以树形显示进程层级关系,帮助理解父子关系
pstree -p
# 实时查看进程状态,关注 Tasks 行的 zombie 数量
top
步骤三:检查系统中的僵尸进程
# 方法一:ps 过滤
ps aux | awk 'NR==1 || $8 ~ /^Z/'
# 方法二:top 统计
top -b -n 1 | grep "^Tasks"
# 方法三:统计各父进程的僵尸子进程数
ps -eo ppid,stat | awk '$2 ~ /^Z/ {count[$1]++} END {for (p in count) print p, count[p]}'
步骤四:定位问题父进程
# 假设发现僵尸进程 PID 为 12346,PPID 为 12345
# 查看父进程详情
ps -p 12345 -o pid,ppid,stat,comm,args
# 查看父进程完整命令行
cat /proc/12345/cmdline | tr '\\0' ' ' && echo
# 查看父进程打开的文件
ls -la /proc/12345/fd | head -20
步骤五:尝试恢复
# 先发 SIGCHLD,看是否有效
kill -SIGCHLD 12345
sleep 3
ps aux | awk '$8 ~ /^Z/'
# 如果无效,在维护窗口优雅停止父进程
sudo kill -SIGTERM 12345
sleep 10
# 如果 SIGTERM 无效,强制终止
sudo kill -SIGKILL 12345
步骤六:确认恢复效果
# 确认僵尸进程已清除
ps aux | awk '$8 ~ /^Z/'
# 确认 PID 空间已释放
cat /proc/sys/kernel/pid_max
ps aux | wc -l
步骤七:从代码层面根治(以 Python 为例)
# 修改服务代码,正确处理 SIGCHLD
# 参考本文案例三中的 good_worker_signal.py
# 重启服务,观察是否不再产生僵尸进程
sudo systemctl restart your_service
# 持续监控
watch -n 5 "ps aux | awk '\\$8 ~ /^Z/'"
步骤八:Docker 容器环境下的处理
# 为已有容器启用 init(需要重建容器)
docker run –init -d your_image
# 或者在 Docker Compose 中配置
# 修改 docker-compose.yml,添加 init: true
# 验证容器内 PID 1 是 init
docker exec <container_id> ps aux | head -3
二十、总结
这篇文章我们从 Linux 进程生命周期出发,完整地讲解了僵尸进程和孤儿进程这两个既有联系又有本质区别的概念。
核心要点回顾:
第一,进程退出是一个需要父子协作完成的过程。子进程调用 exit() 只是退出的第一步,内核会保留进程描述符(僵尸状态),等待父进程调用 wait() 来读取退出状态,之后内核才会彻底清理进程,释放 PID。
第二,僵尸进程的危害在于 PID 泄漏,而不是内存泄漏。单个僵尸进程只占用一个 PID 和极少量内核内存,但大量积累会耗尽 PID 空间,导致系统无法创建新进程。
第三,孤儿进程通常是无害的。父进程先退出后,Linux 内核会自动把孤儿进程的父进程改为 systemd(PID 1),由 systemd 负责在孤儿进程退出时正确回收。孤儿进程不会变成僵尸进程。
第四,僵尸进程无法被直接 kill 杀死,必须通过其父进程来解决。可以尝试向父进程发送 SIGCHLD,或者在维护窗口重启父进程。
第五,Docker 容器中的 PID 1 问题是僵尸进程的高发场景。解决方案是使用 –init 参数或在镜像中集成 tini,让一个真正的 init 进程担任 PID 1 的职责。
第六,从代码层面根治才是终极方案。无论是 C、Python、Java 还是 Go,只要涉及 fork 子进程,就必须确保子进程的退出状态被正确读取,这是避免僵尸进程积累的根本。
与第10节(资源异常排查案例)的衔接:
本节讲解的僵尸进程和孤儿进程,是第10节"资源异常排查案例"的重要基础。在实际排查资源异常时,PID 耗尽、进程无法创建等问题往往追根溯源都会指向大量积累的僵尸进程,以及产生这些僵尸进程的有问题的父进程。理解了本节的内容,你在面对第10节的综合排查案例时,会有更清晰的方向感。
下一篇预告:
第十章第10节将进行综合性的资源异常排查案例实战,把前9节的知识点——进程、线程、任务、信号、优先级、CPU/内存分析、负载理解、僵尸进程——串联起来,通过真实的线上故障案例,系统性地演示从发现异常到定位根因再到修复恢复的完整排查流程。如果你还没有充分掌握前几节的内容,建议先回去温习一下,第10节的实战会同时用到这些知识。
…
ok,同学们,本节课就上到这儿,下课~
🧧 学习福利 · 限时开放 🧧
当然,无论你是计算机专业在读学生,还是刚开始接触 Linux 的入门者,亦或是希望提升开发环境搭建、服务器管理、系统运维能力的开发者,都强烈建议系统学习 Ubuntu 全体系专栏:👉 「滚雪球学 Ubuntu」;涵盖 Ubuntu 从入门到进阶的完整学习内容。
该专栏以“循序渐进 + 实战驱动 + 场景落地”为核心理念,从基础认知到系统安装,从桌面操作到命令行实践,从系统管理到网络配置,再到安全加固、开发环境搭建、性能优化、故障排查、服务器部署与云平台应用,逐层展开,帮助你快速建立完整的 Ubuntu / Linux 技术体系,真正把 Ubuntu 用明白、用熟练、用稳定。
📌 学习承诺: 通过该专栏,你将能够:
- 快速掌握 Ubuntu 系统安装、配置与日常使用能力
- 熟练使用 Linux 常用命令、终端工具与系统管理技巧
- 搭建稳定可复用的开发环境、测试环境与服务器环境
- 掌握网络配置、SSH 远程访问、防火墙、安全加固与备份恢复
- 建立从“入门使用”到“独立运维”的完整 Ubuntu 实战能力
就像“滚雪球”一样,先打牢基础,再持续叠加系统管理、开发环境、网络安全、性能优化与服务器部署能力,让知识不断积累、经验持续放大,最终形成属于自己的 Linux 技术护城河 🚀
最后,如果这篇文章对你有所帮助,帮忙给作者来个一键三连,关注、点赞、收藏,您的支持就是我坚持写作最大的动力。
同时欢迎大家关注技术号:「猿圈奇妙屋」 ,以便学习更多同类型的技术文章,免费白嫖最新 BAT 互联网公司面试题、4000G PDF 编程电子书、简历模板、技术文章 Markdown 文档等海量资料。
ps:本文涉及的 Ubuntu 常用命令、系统配置、环境搭建步骤、服务部署思路与排障方法,均已在文章中结合实战场景进行整理,同学们可以直接对照学习、边看边练。原创整理不易,如果觉得内容有帮助,欢迎点赞、收藏、评论支持一波,非常感谢❗
🫵 Who am I?
我是 bug菌,一名长期深耕后端开发、Linux 系统实践与服务器运维领域的一线技术创作者,曾担任独角兽企业后端技术经理、研发架构师等职位,长期专注于 Java 后端、Linux / Ubuntu 系统管理、服务器部署、分布式架构、微服务治理、高并发系统、工程效能与研发管理等方向。
目前活跃于多个主流技术社区,包括:
CSDN|稀土掘金|InfoQ|51CTO|华为云开发者社区|阿里云开发者社区|腾讯云开发者社区|开源中国|博客园|墨天轮 等平台。
曾获得:
- CSDN 博客之星 Top30
- 华为云多年度十佳博主 & 卓越贡献奖
- 掘金多年度人气作者 Top40
- CSDN、掘金、InfoQ、51CTO 等平台签约作者 / 优质作者
截至目前,全网技术内容累计影响读者众多,全网粉丝已超过 30w+。
如果你也关注 Linux、Ubuntu、Java 后端、服务器运维、架构设计、技术成长、职场进阶与研发管理,欢迎关注我的技术内容合集入口:👉 点击查看 👈️
硬核技术号 「猿圈奇妙屋」 期待你的加入。
这里不仅分享技术干货,也记录一线研发人的成长、踩坑、思考与进阶路径。
愿我们一起打怪升级,把 Ubuntu 用成生产力工具,把 Linux 练成核心竞争力,在技术路上持续进阶。
– End –


评论前必须登录!
注册