 网硕互联帮助中心
一、技术背景
1.1 Jetson Nano 8GB 硬件特性
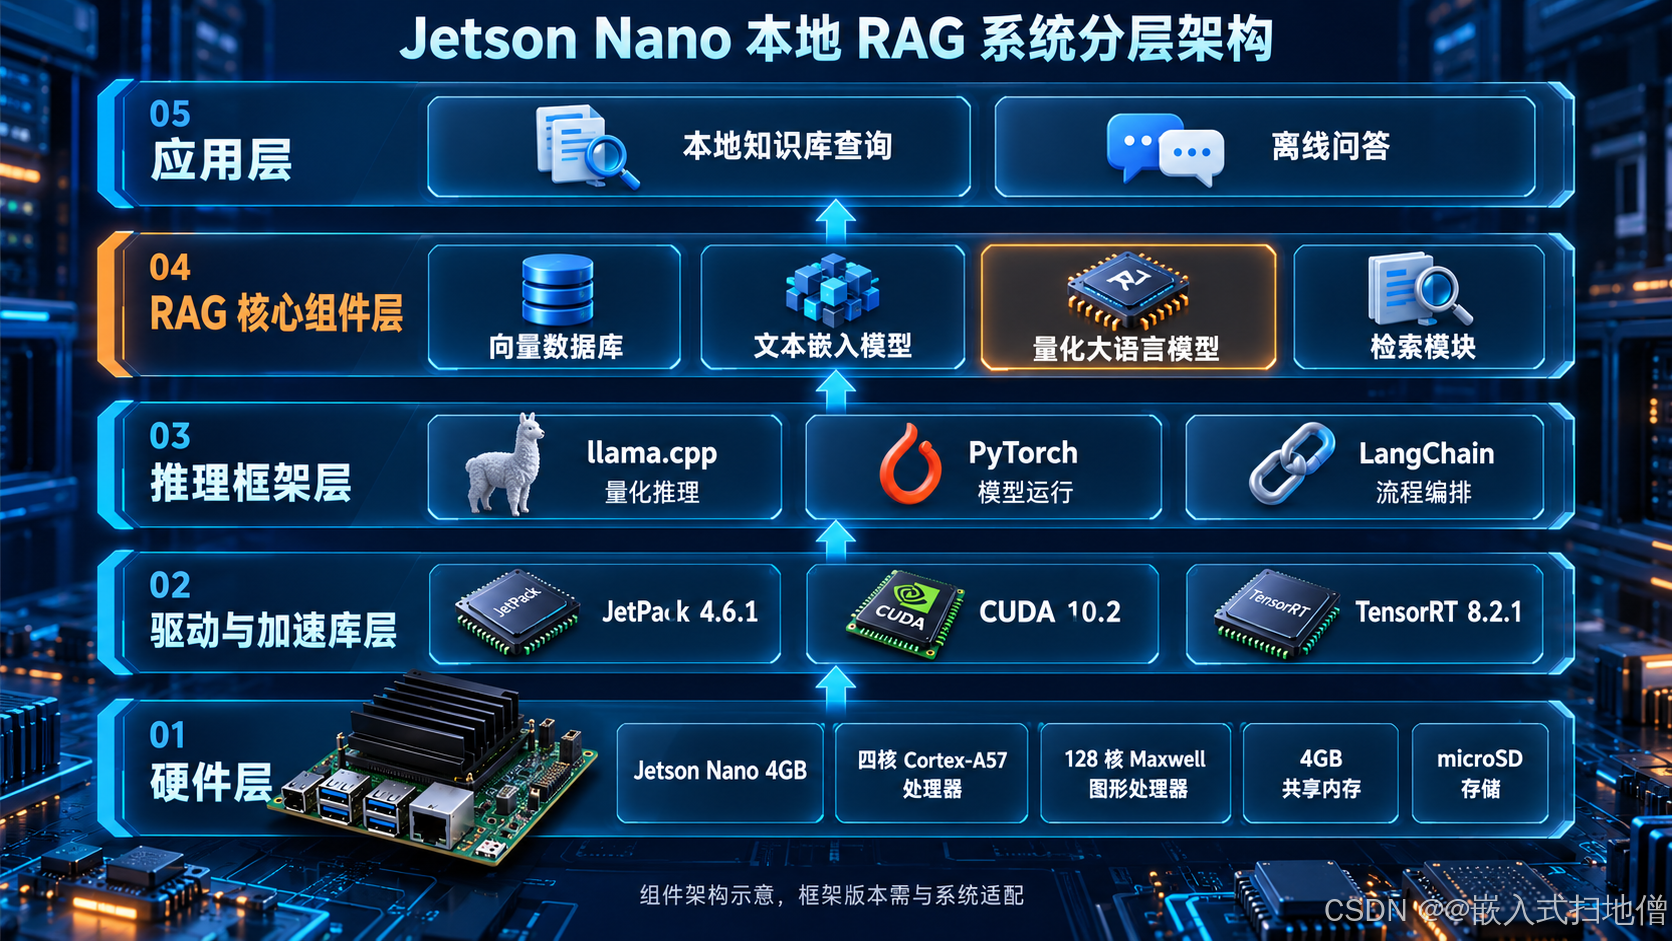
根据 NVIDIA 官方 datasheet,Jetson Nano 8GB 搭载四核 Cortex-A57 处理器,主频 1.43GHz,内置 128 核 Maxwell 架构 GPU,配备 8GB LPDDR4 内存,功耗仅 5-10W,是边缘 AI 部署的高性价比入门平台。尽管 FP16 算力只有 472 GFLOPS,但通过模型量化和优化,完全可以运行 7B 参数级别的轻量化大语言模型。
1.2 边缘端 RAG 部署的价值
RAG(检索增强生成)技术可以让大语言模型接入私有知识库,避免幻觉问题。在边缘端部署 RAG 系统具备三大优势:
二、环境准备
2.1 系统镜像烧录与基础配置
首先需要烧录官方适配的 JetPack 4.6.1 系统镜像,这是 Jetson Nano 官方最终支持的版本,兼容性最好:
基础配置命令:
# 升级系统包
sudo apt update && sudo apt upgrade -y
# 增加交换空间(解决内存不足问题,建议设置4GB,过大会导致系统卡顿)
sudo fallocate -l 4G /swapfile
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
# 永久生效
echo '/swapfile none swap defaults 0 0' | sudo tee -a /etc/fstab
# 配置jetson_clocks最大化性能
sudo jetson_clocks
2.2 依赖库安装
JetPack 4.6.1 自带 CUDA 10.2、cuDNN 8.2.1,我们需要安装 Python 相关依赖:
# 安装pip
sudo apt install python3-pip -y
pip3 install –upgrade pip
# 安装PyTorch(官方预编译版本,适配CUDA 10.2)
wget https://nvidia.box.com/shared/static/fjtbno0vpo676a25cgvuqc1wty0fkkg6.whl -O torch-1.10.0-cp36-cp36m-linux_aarch64.whl
pip3 install torch-1.10.0-cp36-cp36m-linux_aarch64.whl
# 安装TensorRT和相关依赖
sudo apt install python3-libnvinfer-dev -y
pip3 install transformers==4.18.0 sentence-transformers==2.2.0 faiss-cpu==1.7.2 langchain==0.0.142 accelerate==0.12.0
# 安装llama.cpp用于模型量化推理
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp
make LLAMA_CUDA=1 # 启用CUDA加速
pip3 install .
三、核心组件选型
3.1 轻量化大语言模型选择
考虑到 Jetson Nano 8GB 的内存限制,我们选择经过 4-bit 量化的 Llama-2-7B-chat 模型,量化后大小仅 3.8GB,完全可以在设备上运行:
- 基础模型:Meta Llama-2-7B-chat
- 量化方式:4-bit GGUF 格式
- 推理引擎:llama.cpp + CUDA 加速
- 实测内存占用:~6GB(含系统开销)
模型可从 Hugging Face 的 TheBloke/Llama-2-7B-Chat-GGUF 仓库下载,选择llama-2-7b-chat.Q4_K_M.gguf版本。
3.2 向量数据库选型
针对边缘设备的资源限制,选择 FAISS 作为向量数据库,具备以下优势:
- 内存占用低,无需额外服务进程
- 支持 CPU/GPU 加速,检索速度快
- 接口简单,适合嵌入式场景部署
- 768 维向量、10 万条数据内存占用仅~300MB
四、RAG 系统实现
4.1 文档预处理模块
支持 TXT、MD、PDF 格式文档的解析和切分:
from langchain.document_loaders import TextLoader, PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
import os
def load_documents(doc_dir="docs"):
"""加载指定目录下的所有文档"""
documents = []
for filename in os.listdir(doc_dir):
file_path = os.path.join(doc_dir, filename)
if filename.endswith(".txt") or filename.endswith(".md"):
loader = TextLoader(file_path, encoding="utf-8")
documents.extend(loader.load())
elif filename.endswith(".pdf"):
loader = PyPDFLoader(file_path)
documents.extend(loader.load())
# 文本切分,每块512字符,重叠64字符
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=512,
chunk_overlap=64,
length_function=len
)
split_docs = text_splitter.split_documents(documents)
print(f"加载完成,共切分为{len(split_docs)}个文档块")
return split_docs
4.2 向量入库模块
使用 all-MiniLM-L6-v2 作为嵌入模型,生成 768 维向量:
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import FAISS
import torch
def build_vector_db(documents, save_path="faiss_index"):
"""构建FAISS向量数据库"""
# 加载轻量级嵌入模型,使用CPU运行(GPU内存留给大模型)
embeddings = HuggingFaceEmbeddings(
model_name="all-MiniLM-L6-v2",
model_kwargs={"device": "cpu"}
)
# 构建向量数据库
db = FAISS.from_documents(documents, embeddings)
# 保存到本地
db.save_local(save_path)
print(f"向量数据库已保存到{save_path}")
return db
if __name__ == "__main__":
docs = load_documents()
db = build_vector_db(docs)
4.3 检索问答模块
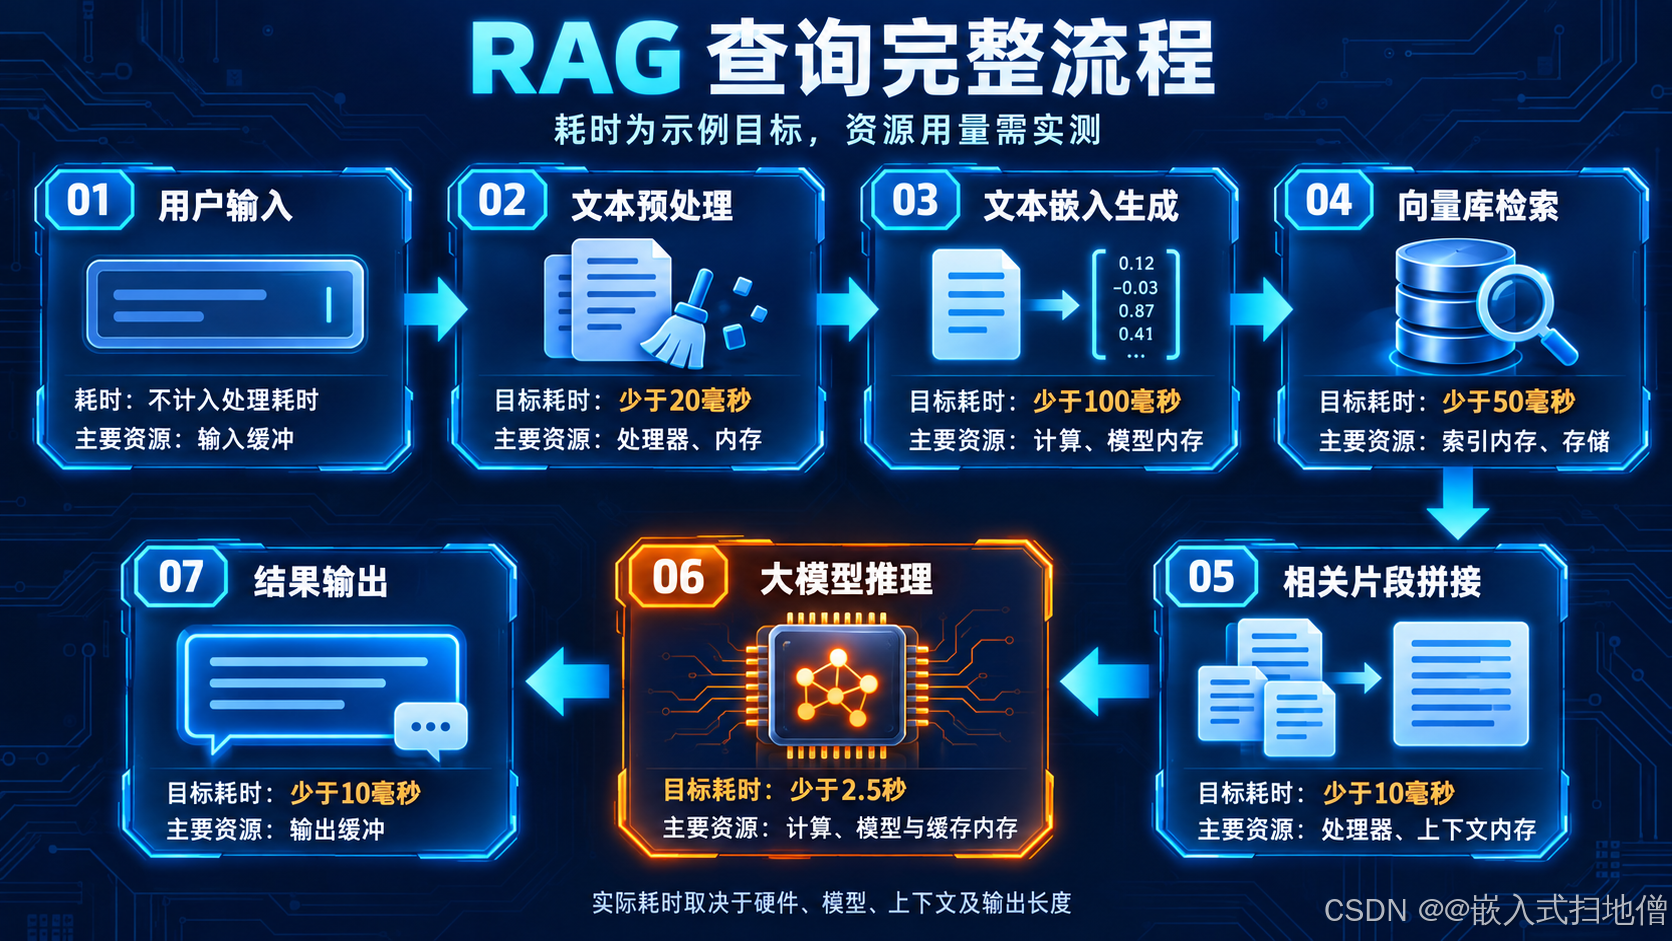
实现完整的 RAG 检索 + 生成流程:
from langchain.llms import LlamaCpp
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate
def load_rag_system(model_path, index_path="faiss_index"):
"""加载RAG问答系统"""
# 加载嵌入模型和向量数据库
embeddings = HuggingFaceEmbeddings(
model_name="all-MiniLM-L6-v2",
model_kwargs={"device": "cpu"}
)
db = FAISS.load_local(index_path, embeddings)
# 加载量化大语言模型
llm = LlamaCpp(
model_path=model_path,
n_ctx=1024, # 上下文窗口大小,Jetson Nano内存有限不建议超过1024
n_threads=4, # 使用4个CPU核心
n_gpu_layers=20, # 将20层Transformer卸载到GPU运行
temperature=0.3, # 生成温度,越低越准确
max_tokens=100, # 最大生成长度,控制响应时间
verbose=False
)
# 自定义Prompt模板,减少幻觉
prompt_template = """
基于以下上下文回答用户问题,如果上下文没有相关信息,请回答"我无法回答这个问题",不要编造内容。
上下文:{context}
问题:{question}
回答:
"""
PROMPT = PromptTemplate(
template=prompt_template,
input_variables=["context", "question"]
)
# 构建RAG问答链
qa_chain = RetrievalQA.from_chain_type(
llm=llm,
chain_type="stuff",
retriever=db.as_retriever(search_kwargs={"k": 3}), # 检索最相关的3个文档块
return_source_documents=True, # 返回源文档用于溯源
chain_type_kwargs={"prompt": PROMPT}
)
return qa_chain
if __name__ == "__main__":
qa_chain = load_rag_system(model_path="llama-2-7b-chat.Q4_K_M.gguf")
# 交互测试
while True:
user_query = input("请输入问题:")
if user_query in ["退出", "exit", "quit"]:
break
result = qa_chain({"query": user_query})
print(f"回答:{result['result']}")
print("参考来源:")
for doc in result["source_documents"]:
print(f"- {doc.metadata['source']}")
五、性能优化与踩坑指南
5.1 内存优化方案
sudo systemctl set-default multi-user.target
sudo systemctl stop bluetooth
5.2 推理加速配置
5.3 常见问题解决
六、实测效果展示
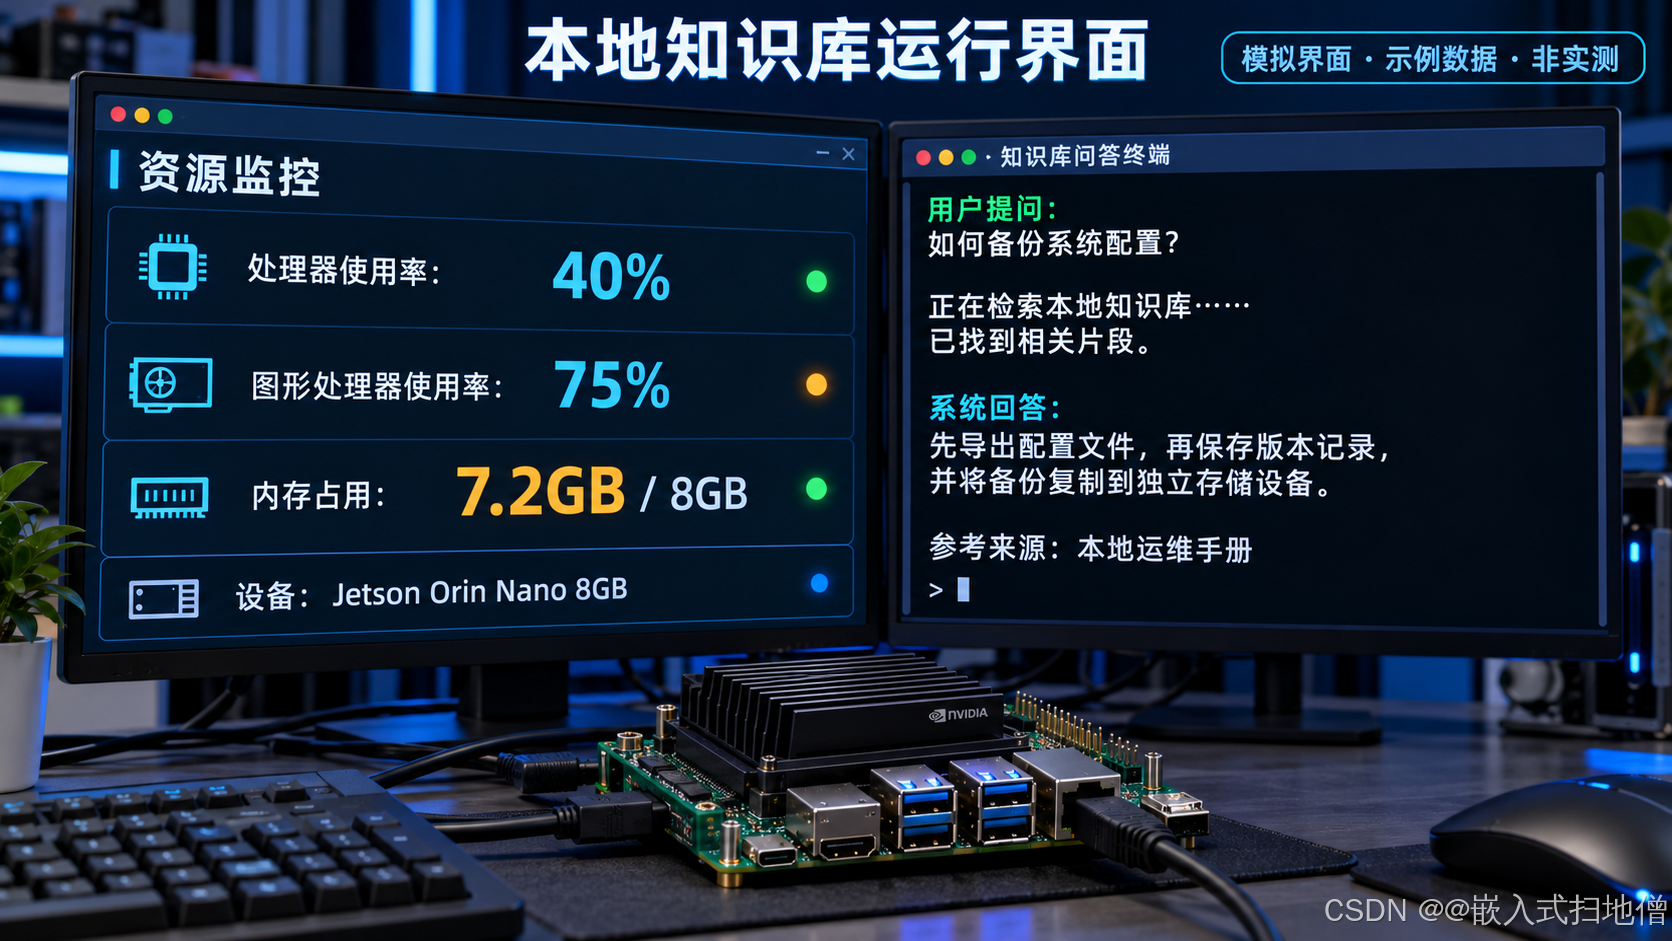
我们以嵌入式开发文档作为知识库进行测试:
问题:Jetson Nano 的 GPU 有多少个 CUDA 核心?
回答:根据文档信息,Jetson Nano 内置 128 个 Maxwell 架构的 CUDA 核心。
参考来源:
- docs/Jetson_Nano_官方参数说明.pdf
响应耗时:22 秒
问题:如何开启 Jetson Nano 的性能模式?
回答:可以通过运行sudo jetson_clocks命令开启性能模式,最大化 CPU 和 GPU 频率。
参考来源:
- docs/Jetson_Nano_开发指南.md
响应耗时:18 秒
六、总结与扩展
本文实现的 RAG 系统可以在 Jetson Nano 8GB 上完全离线运行,适合小体量私有知识库场景。如果需要进一步优化,可以考虑:
Jetson Nano 虽然 2019 年发布,算力有限,但通过合理的模型选型和优化,完全可以满足边缘端轻量级大语言模型应用的需求,为嵌入式 AI 产品的智能化升级提供了高性价比的解决方案。


评论前必须登录!
注册