 网硕互联帮助中心
2026 后端 AI 集成工程化:Spring AI 2.0、MCP 协议与 Agent 内嵌的三条落地路径拆解
2026 年的后端 AI 集成,问题已经不再是"能不能调通一个大模型接口",而是"怎么把模型能力稳定地收进已有 Java 系统"。前者是一次联调,后者是一组长期存在的工程约束:多厂商切换成本、工具调用权限、RAG 链路重复建设、Agent 上线后的超时与账单、可观测与降级。中文技术社区在 2026 年 10 月密集讨论的三个技术变量——Spring AI 2.0、MCP(Model Context Protocol)、Agent 内嵌——恰好分别对应能力层抽象、协议层标准化和运行时形态这三个不同层次的问题 [1][5]。
需要先交代材料性质:本文依据的热点资料多为 CSDN、掘金、Gitee、GitHub 上的二手整理或聚合摘要,采集记录中的热度指标全部缺失(标注为 0),无法据此判断"真热",只能按主题密度与时间聚类判断讨论方向。涉及 Spring AI 2.0、Spring Boot 4、Java 25、MCP 规范版本的具体 API、类名、方法签名与兼容矩阵,本文一律不臆造,正文给出结构示意,落地前必须以官方文档与 release notes 为准;涉及性能与成本的百分比数字,一律标注为"社区主张",不作为决策依据。
一、先把问题拆对:三个变量在三个不同层
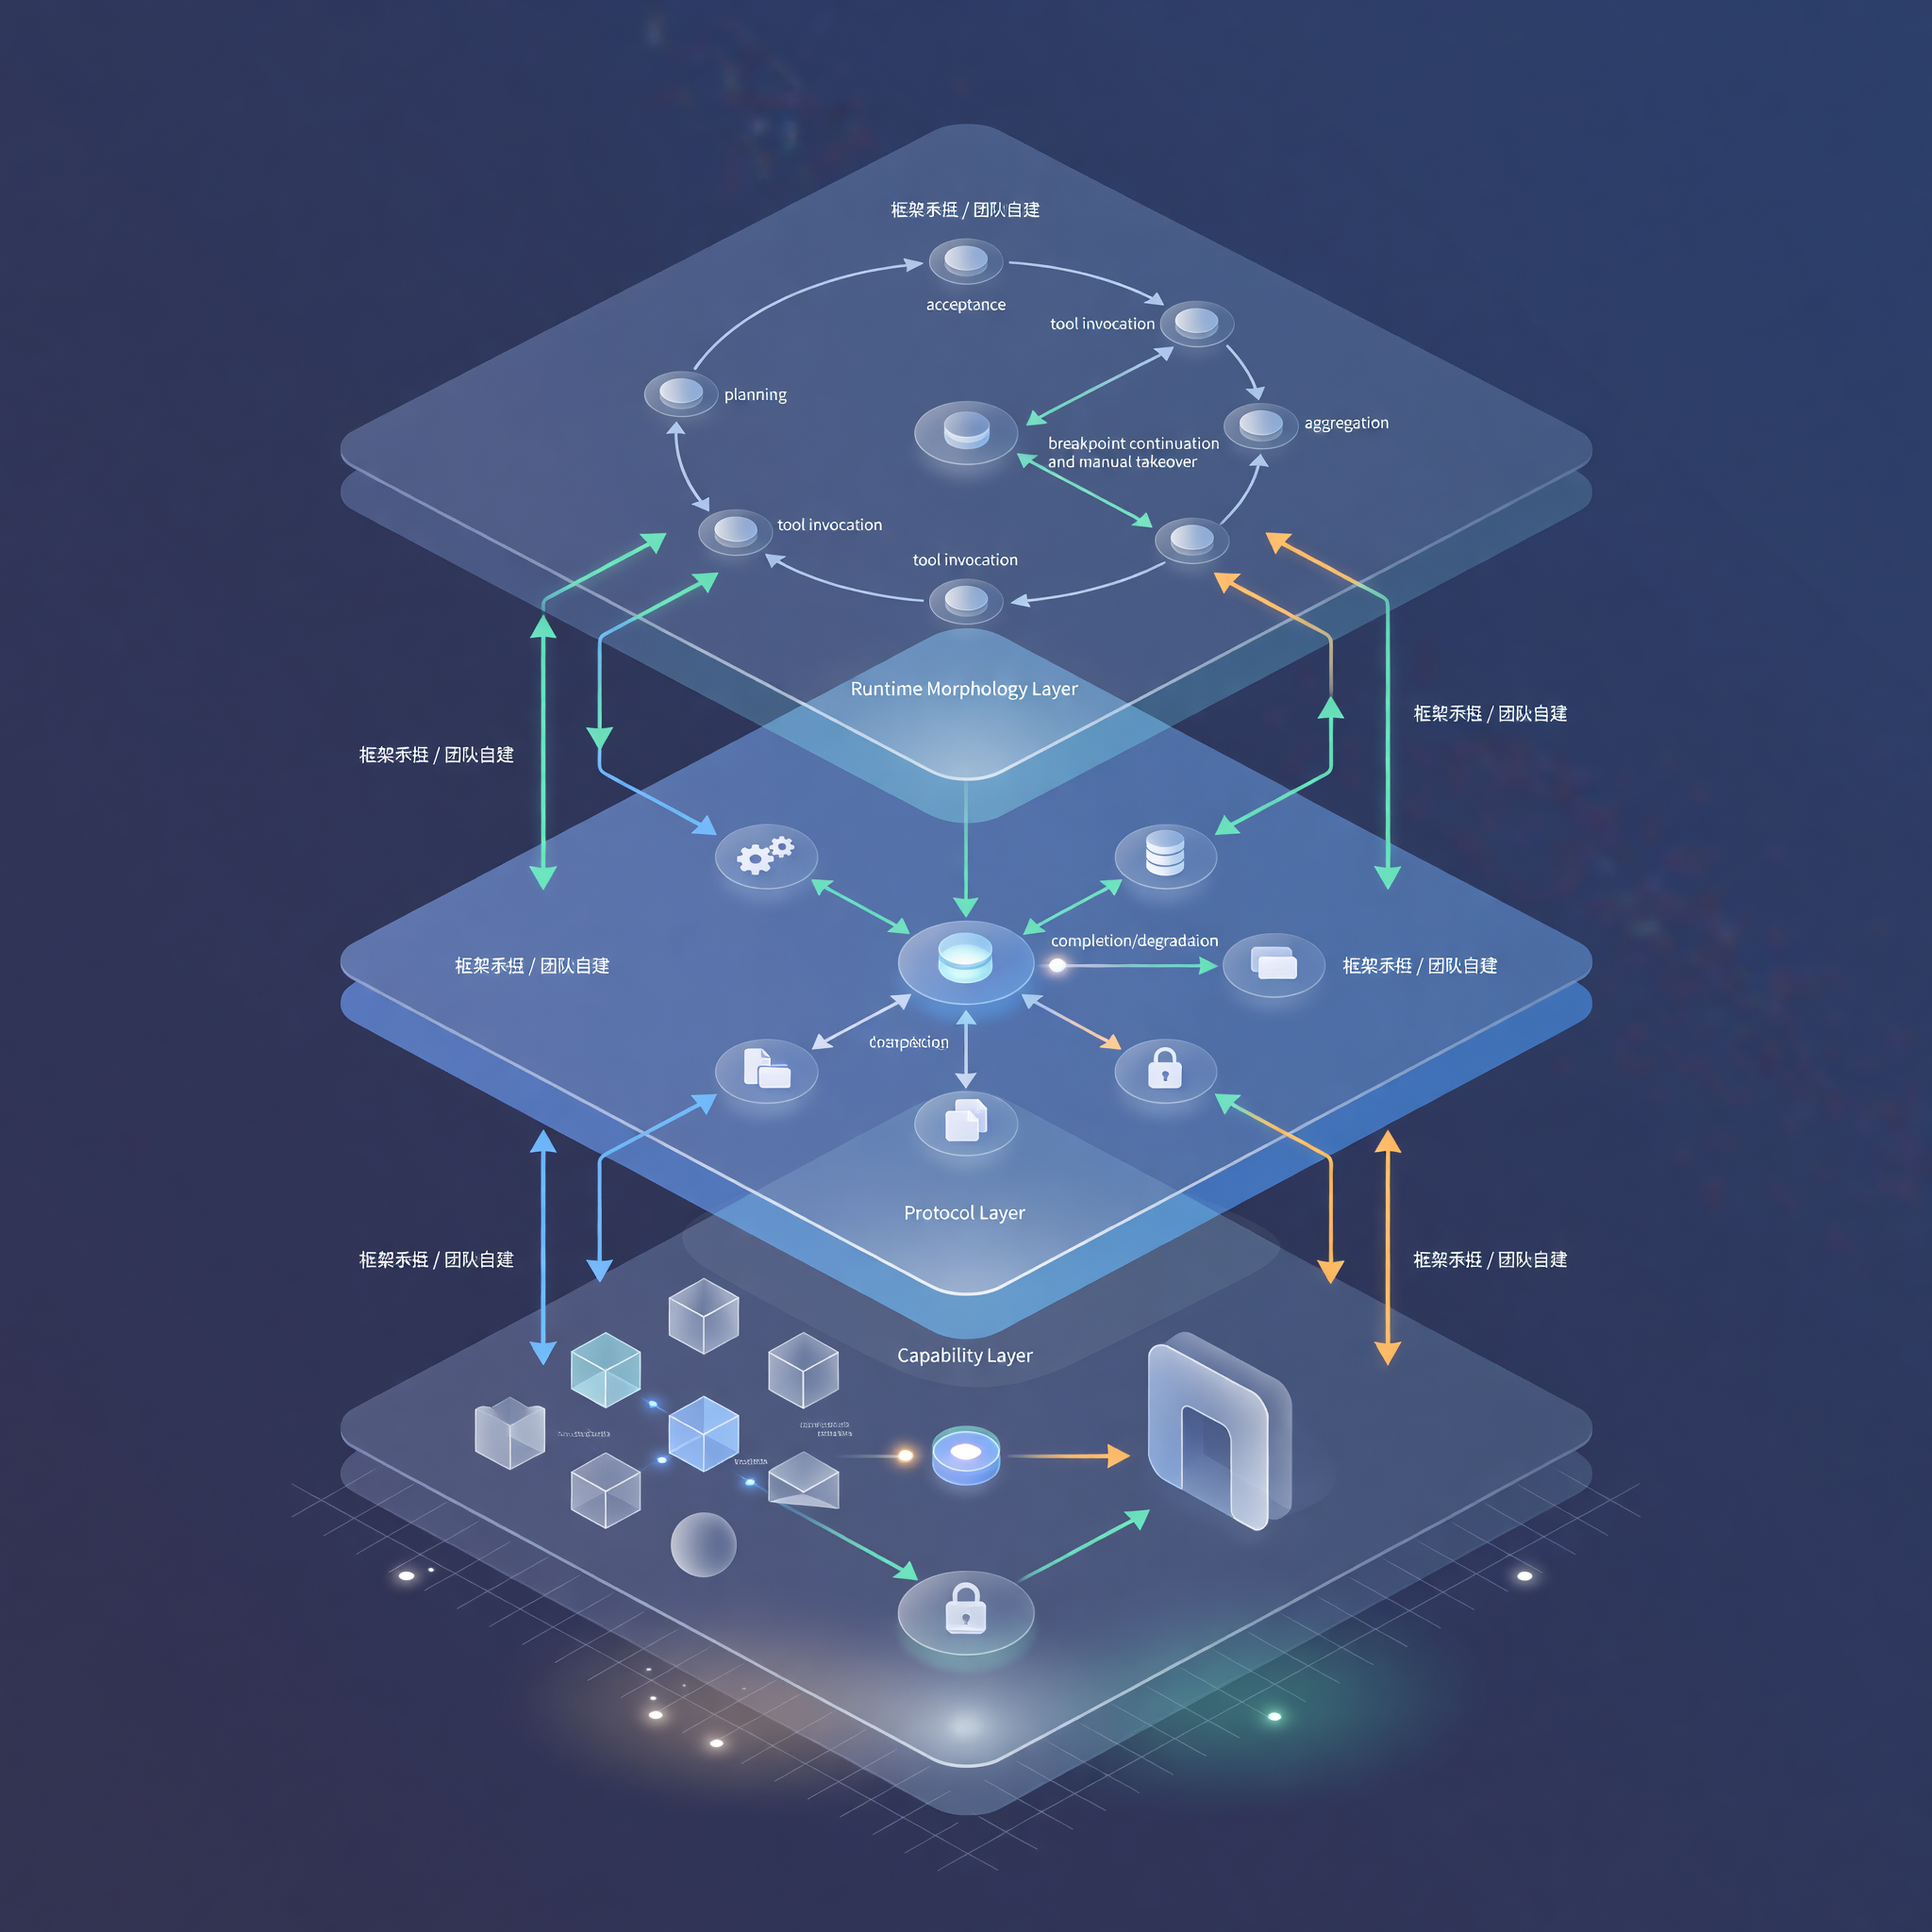
1.1 一张图看懂三层边界
一个典型的存量 Spring Boot 微服务体系接入模型能力时,会同时遇到三类摩擦:
- 能力摩擦:每个厂商一套 SDK、一套鉴权、一套流式与错误语义;RAG 的切分、检索、重排在不同项目里各写一遍。
- 契约摩擦:工具能力散落在各业务服务里,换一个模型框架就要重新包装一次,输入输出格式靠口头约定。
- 运行时摩擦:一次 Agent 任务可能是几十秒的多轮工具调用,同步 HTTP 请求、数据库事务、线程池模型都不匹配。
Spring AI、MCP 与 Agent 内嵌分别站在这三层上。
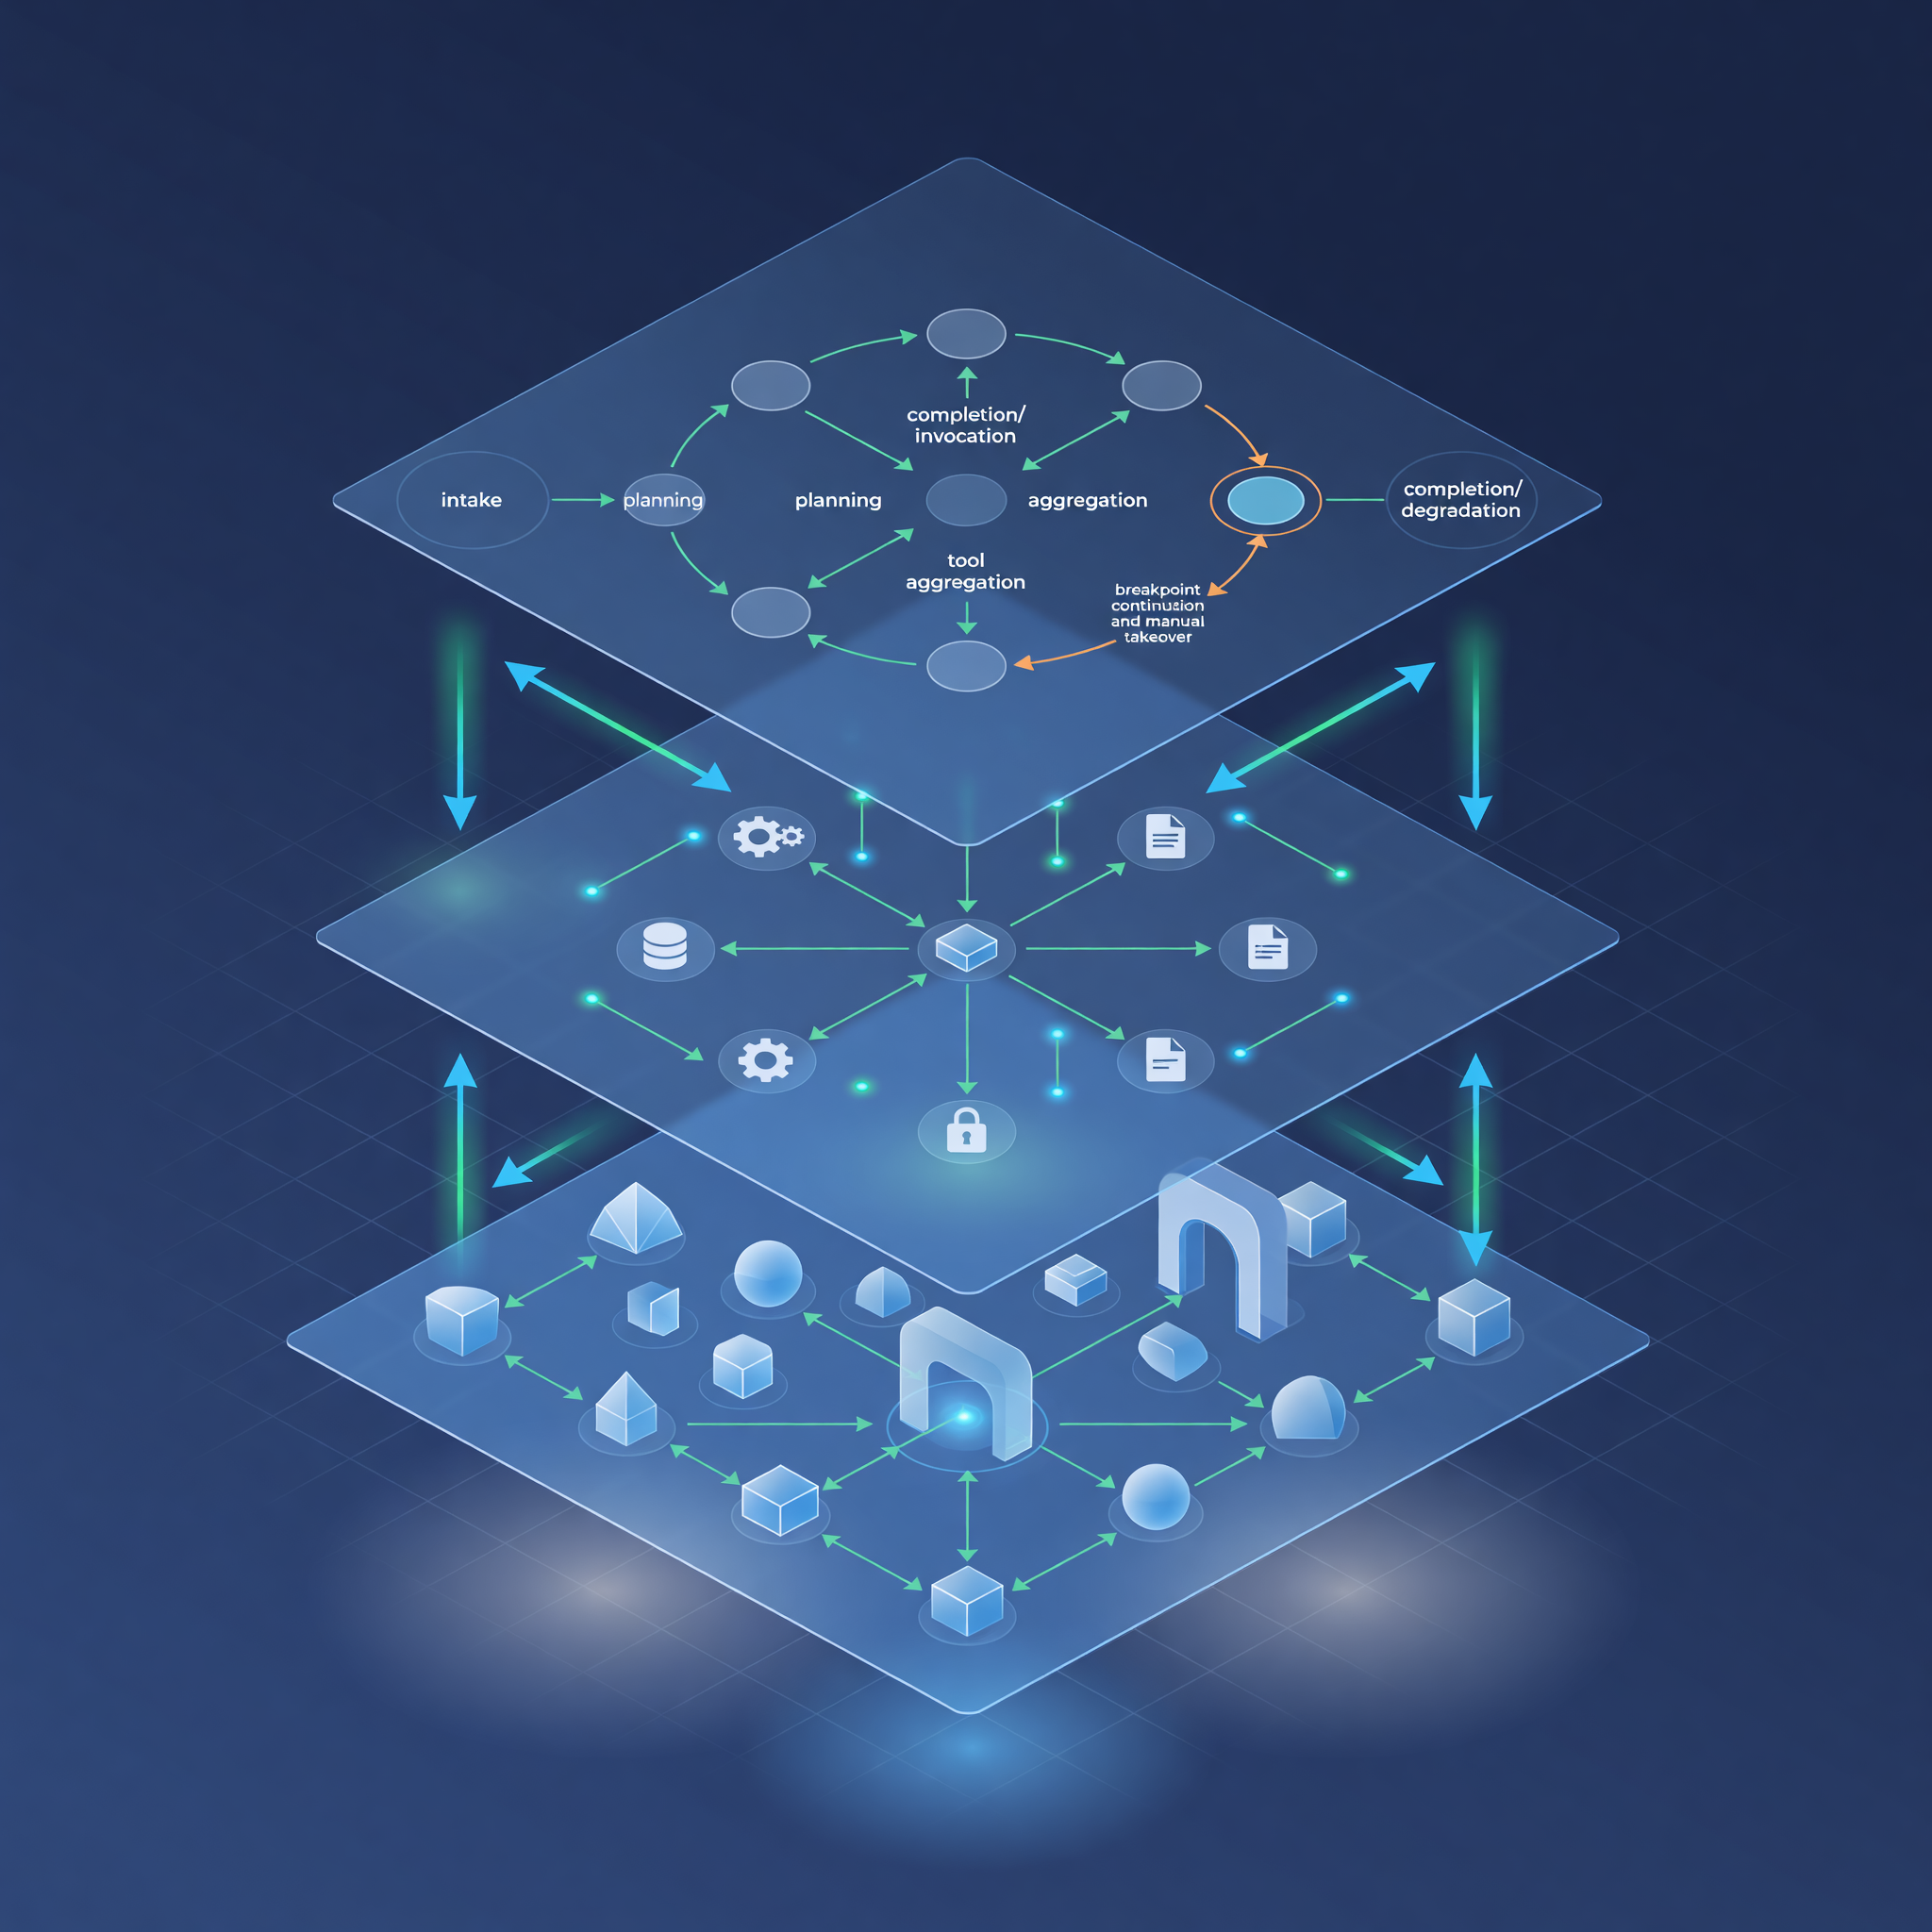
| Spring AI 2.0 | 能力层抽象 | 多厂商调用、工具声明、RAG 环节的编程模型统一 [1] | 工具跨团队复用的契约治理、长任务运行时调度 |
| MCP | 协议层标准化 | 工具与资源的跨模型、跨框架描述、发现与调用契约 [1][4] | 工具内部实现、权限模型、计费、限流策略 |
| Agent 内嵌 | 运行时形态 | 多轮规划—调用—汇总的执行形态与服务内承载方式 [5] | 抽象层与契约本身、业务正确性 |
三者不是替代关系,而是正交的:你可以在没有 MCP 的情况下用 Spring AI 完成一个单轮工具调用;也可以在没有 Agent 循环的情况下把业务能力通过 MCP 暴露给外部宿主;Agent 内嵌则是把前两者的产物放进一个可持续运维的运行时里。把它们当成三个候选方案做"三选一",是当前最常见的一类误判 [1]。
1.2 三个常见误解
| MCP 就是 Java 版的函数调用 | 函数调用通常是框架内的一次模型侧决策;MCP 是一份跨进程、跨框架的工具/资源交互契约,强调描述、发现与调用语义的一致性。二者的抽象目的不同,MCP 的正式概念命名与版本以官方规范为准 |
| Agent 内嵌就是把循环写在 Controller 里 | 把"规划—调用—汇总"循环塞进同步请求线程,会直接撞上请求超时、连接占用、事务边界和线程资源问题。内嵌指的是运行时承载方式,不是把编排逻辑散进 Web 层 |
| 引入 Spring AI 就锁定了某个厂商 | 统一抽象的价值正在于保留切换面。但抽象只能覆盖厂商能力的交集,厂商特有能力(特有推理参数、缓存计费、专有检索能力等)仍需要扩展点,"零成本切换"在多数真实场景下不成立 |
社区把 MCP 称为"2026 年最受关注的新趋势" [4],也有文章坦承这一判断"来自中文技术社区,缺乏更广泛交叉验证" [5]。这提醒我们:趋势判断可以参考,规格与 API 必须回到一手来源。
二、能力层:Spring AI 2.0 把什么变成了统一编程模型
2.1 多厂商调用的抽象边界
统一抽象真正值得覆盖的是稳定不变的部分:会话请求构造、消息历史、流式响应、结构化输出、错误与重试语义。厂商特有部分应通过扩展点暴露,而不是被抽象层抹平。
下面是一段结构示意,用于说明重构目标,不是可编译代码,具体类名与方法签名以 Spring AI 官方文档核验后填入:
// 结构示意:非可编译代码,API 形态以 Spring AI 2.0 官方文档为准
interface ChatService {
ChatResult generate(ChatRequest request);
Flux<ChatChunk> stream(ChatRequest request); // 流式返回
<T> T generate(ChatRequest request, Class<T> schema); // 结构化输出
}
// 业务代码只依赖 ChatService,不直接依赖任一厂商 SDK
@Service
class ProductQaService {
private final ChatService chat;
private final ToolRegistry tools;
public Answer ask(String question, TenantContext ctx) {
ChatRequest req = ChatRequest.builder()
.messages(systemPrompt(ctx), user(question))
.tools(tools.enabledFor(ctx)) // 受租户权限约束的工具集合
.options(VendorOptions.defaults()) // 厂商差异收敛到 options 扩展点
.build();
return chat.generate(req, Answer.class);
}
}
关键取舍在于 VendorOptions 这类扩展点的设计:把它做成强类型的能力协商,而不是透传 Map。前者在切换厂商时会明确暴露"这家支持、那家不支持"的差异;后者会把差异推迟到线上报错。
建议在项目内维护一张厂商能力差异表,至少覆盖:上下文窗口、结构化输出可靠性、流式终止语义、工具并行调用、超时与限流响应格式、计费口径。表中每一项都要标注核验来源,缺失项就是切换风险点。
2.2 工具声明:从业务方法到模型可调用工具
工具声明的工程价值在于把"模型能调用什么"从提示词字符串提升为可校验、可审计、可版本化的注册项。链路通常是:业务方法 → 声明与参数 schema 注册 → 模型决策 → 权限校验 → 执行 → 结果回填 → 审计落库。
// 结构示意:工具声明命名仅为说明,实际注解/接口以官方文档为准
@ToolSpec(
name = "order_lookup",
description = "按订单号查询订单状态与物流节点",
params = { "orderId: string, required, 订单号" },
idempotent = true, // 只读,可安全重试
riskLevel = RiskLevel.READ // 风险分级,决定是否需要人工确认
)
public OrderView lookupOrder(String orderId, TenantContext ctx) {
authz.requirePermission(ctx, "order:read", orderId);
OrderView v = orderService.find(orderId);
audit.log(ctx, "order_lookup", orderId); // 每次工具调用留痕
return v;
}
如果工具定义散落在各微服务的提示词与字符串拼接里,会得到三个后果:无法做权限白名单、无法评估单次调用成本、无法在工具变更时做影响面分析。工具注册表应当是平台级资产,而不是某个服务的私有细节。
2.3 RAG 链路统一:框架承担与团队自建的分界
RAG 的常见分层如下:
| 文档接入/解析 | 常见格式的读取与 ETL 入口 | 版式复杂文档、表格、扫描件的解析质量 |
| 切分 | 切分器的执行框架 | 切分粒度对召回的影响,必须用业务问答集评估 |
| 向量化与存储 | Embedding 调用与向量库适配 | 索引重建策略、多租户隔离、数据生命周期 |
| 检索 | 相似度检索的基础链路 | 混合检索、过滤条件与业务索引的结合 |
| 重排 | 部分提供可插拔入口 | 重排模型选型与收益验证,多数需要自测 |
| 注入与溯源 | 上下文组装 | 引用溯源、幻觉检测、答案质量评测体系 |
框架统一的是"链路骨架",不是"答案质量"。评测集(question set)与回归基线是 RAG 项目里最容易被省略、也最影响成败的资产。Spring AI 2.0 在 RAG、向量库适配与工具调用上的具体模块名与支持范围,需以其官方 reference 核验后填入 [1]。
三、协议层:MCP 解决的是跨模型、跨框架的复用与治理
3.1 MCP 的协议边界
MCP 标准化的是工具与资源的描述、发现和调用契约:宿主(Host)承载会话,客户端(Client)建立连接,服务器(Server)暴露工具与资源。它让"同一个工具"可以被不同模型框架复用,而不必为每个框架重写一遍适配。

它没有标准化的东西同样重要:工具内部实现、权限模型、审计格式、限流与配额、计费、失败语义的业务定义。把 MCP 接入等同于"治理完成",是落地阶段最常见的落差来源。与 OpenAPI 的关系可以这样理解:OpenAPI 描述面向人的服务接口,MCP 描述面向模型运行时可发现、可调用的工具与资源,二者可以在同一套治理设施下共存,而不是互相取代。
MCP 当前规范版本、概念正式命名、官方 Java SDK 及 Spring 侧集成模块的名称与成熟度,必须以 MCP 官方规范与所用 Spring AI 版本的文档核验,本文不给出未经核实的版本号与类名 [1][5]。
3.2 Java/Spring 侧的两个接入方向
| 作为 MCP Server 暴露工具 | 已有微服务能力要被多个模型/框架复用 | 描述质量、参数校验、鉴权、审计、限流、版本管理 |
| 作为 MCP Client 消费工具 | 应用要调用外部或平台提供的工具集 | 工具白名单、超时预算、失败降级、成本归因 |
把已有能力包装为 MCP 工具时,优先选择只读、幂等、参数边界清晰的能力做第一批,例如"查询订单状态"“查询库存快照”“检索内部文档”。写操作类工具(下单、改价、发消息)应放在权限与人工确认机制就绪之后。
3.3 治理:契约之外的必修课
跨团队复用工具,至少要覆盖以下治理项:
- 认证与授权:调用方身份、租户隔离、工具级白名单;网关层统一鉴权是常见做法。在 Spring Cloud Gateway 这类基于 WebFlux 的响应式网关上,安全模块应使用 spring-boot-starter-oauth2-resource-server 这类响应式资源服务器方案,而不是传统的 spring-security-oauth2 [8]。
- 调用审计:谁、何时、以什么参数调用了哪个工具,结果摘要与耗时落库,保留期与合规要求对齐。
- 配额与限流:按租户、按工具、按模型三维度设预算;限流策略本身也要有降级出口。
- 变更管理:工具描述与参数 schema 变更视为 API 变更,走评审与灰度,避免"改一句描述导致模型行为漂移"。
四、运行时形态:Agent 内嵌在微服务体系里的位置
4.1 三种运行形态
| Agent 内嵌在业务服务 | 低,与业务线程/连接池共用 | 最快,随业务服务发布 | 单场景、调用量可控、团队小 |
| 独立 Agent 服务 | 中,可独立扩缩容与限流 | 需要独立发布与运维 | 多场景共用一套编排,调用量上升 |
| 平台化底座 | 高,能力与工具统一治理 | 前期投入大 | 多团队、多租户、需要统一工具与审计 |
QuickBlue 这类把"AI 应用"当作一等公民来设计的 Spring Cloud 底座,代表的正是第三条路线的取向 [3]。对多数存量团队,起点应是第一或第二种,而不是直接立项平台。
4.2 与事件驱动、虚拟线程的关系
Agent 任务天然是长耗时、多轮、可中断的,因此更适合事件驱动的异步执行模型:受理 → 规划 → 工具调用 → 汇总 → 回落降级,中间状态持久化,支持断点续跑与人工接管。
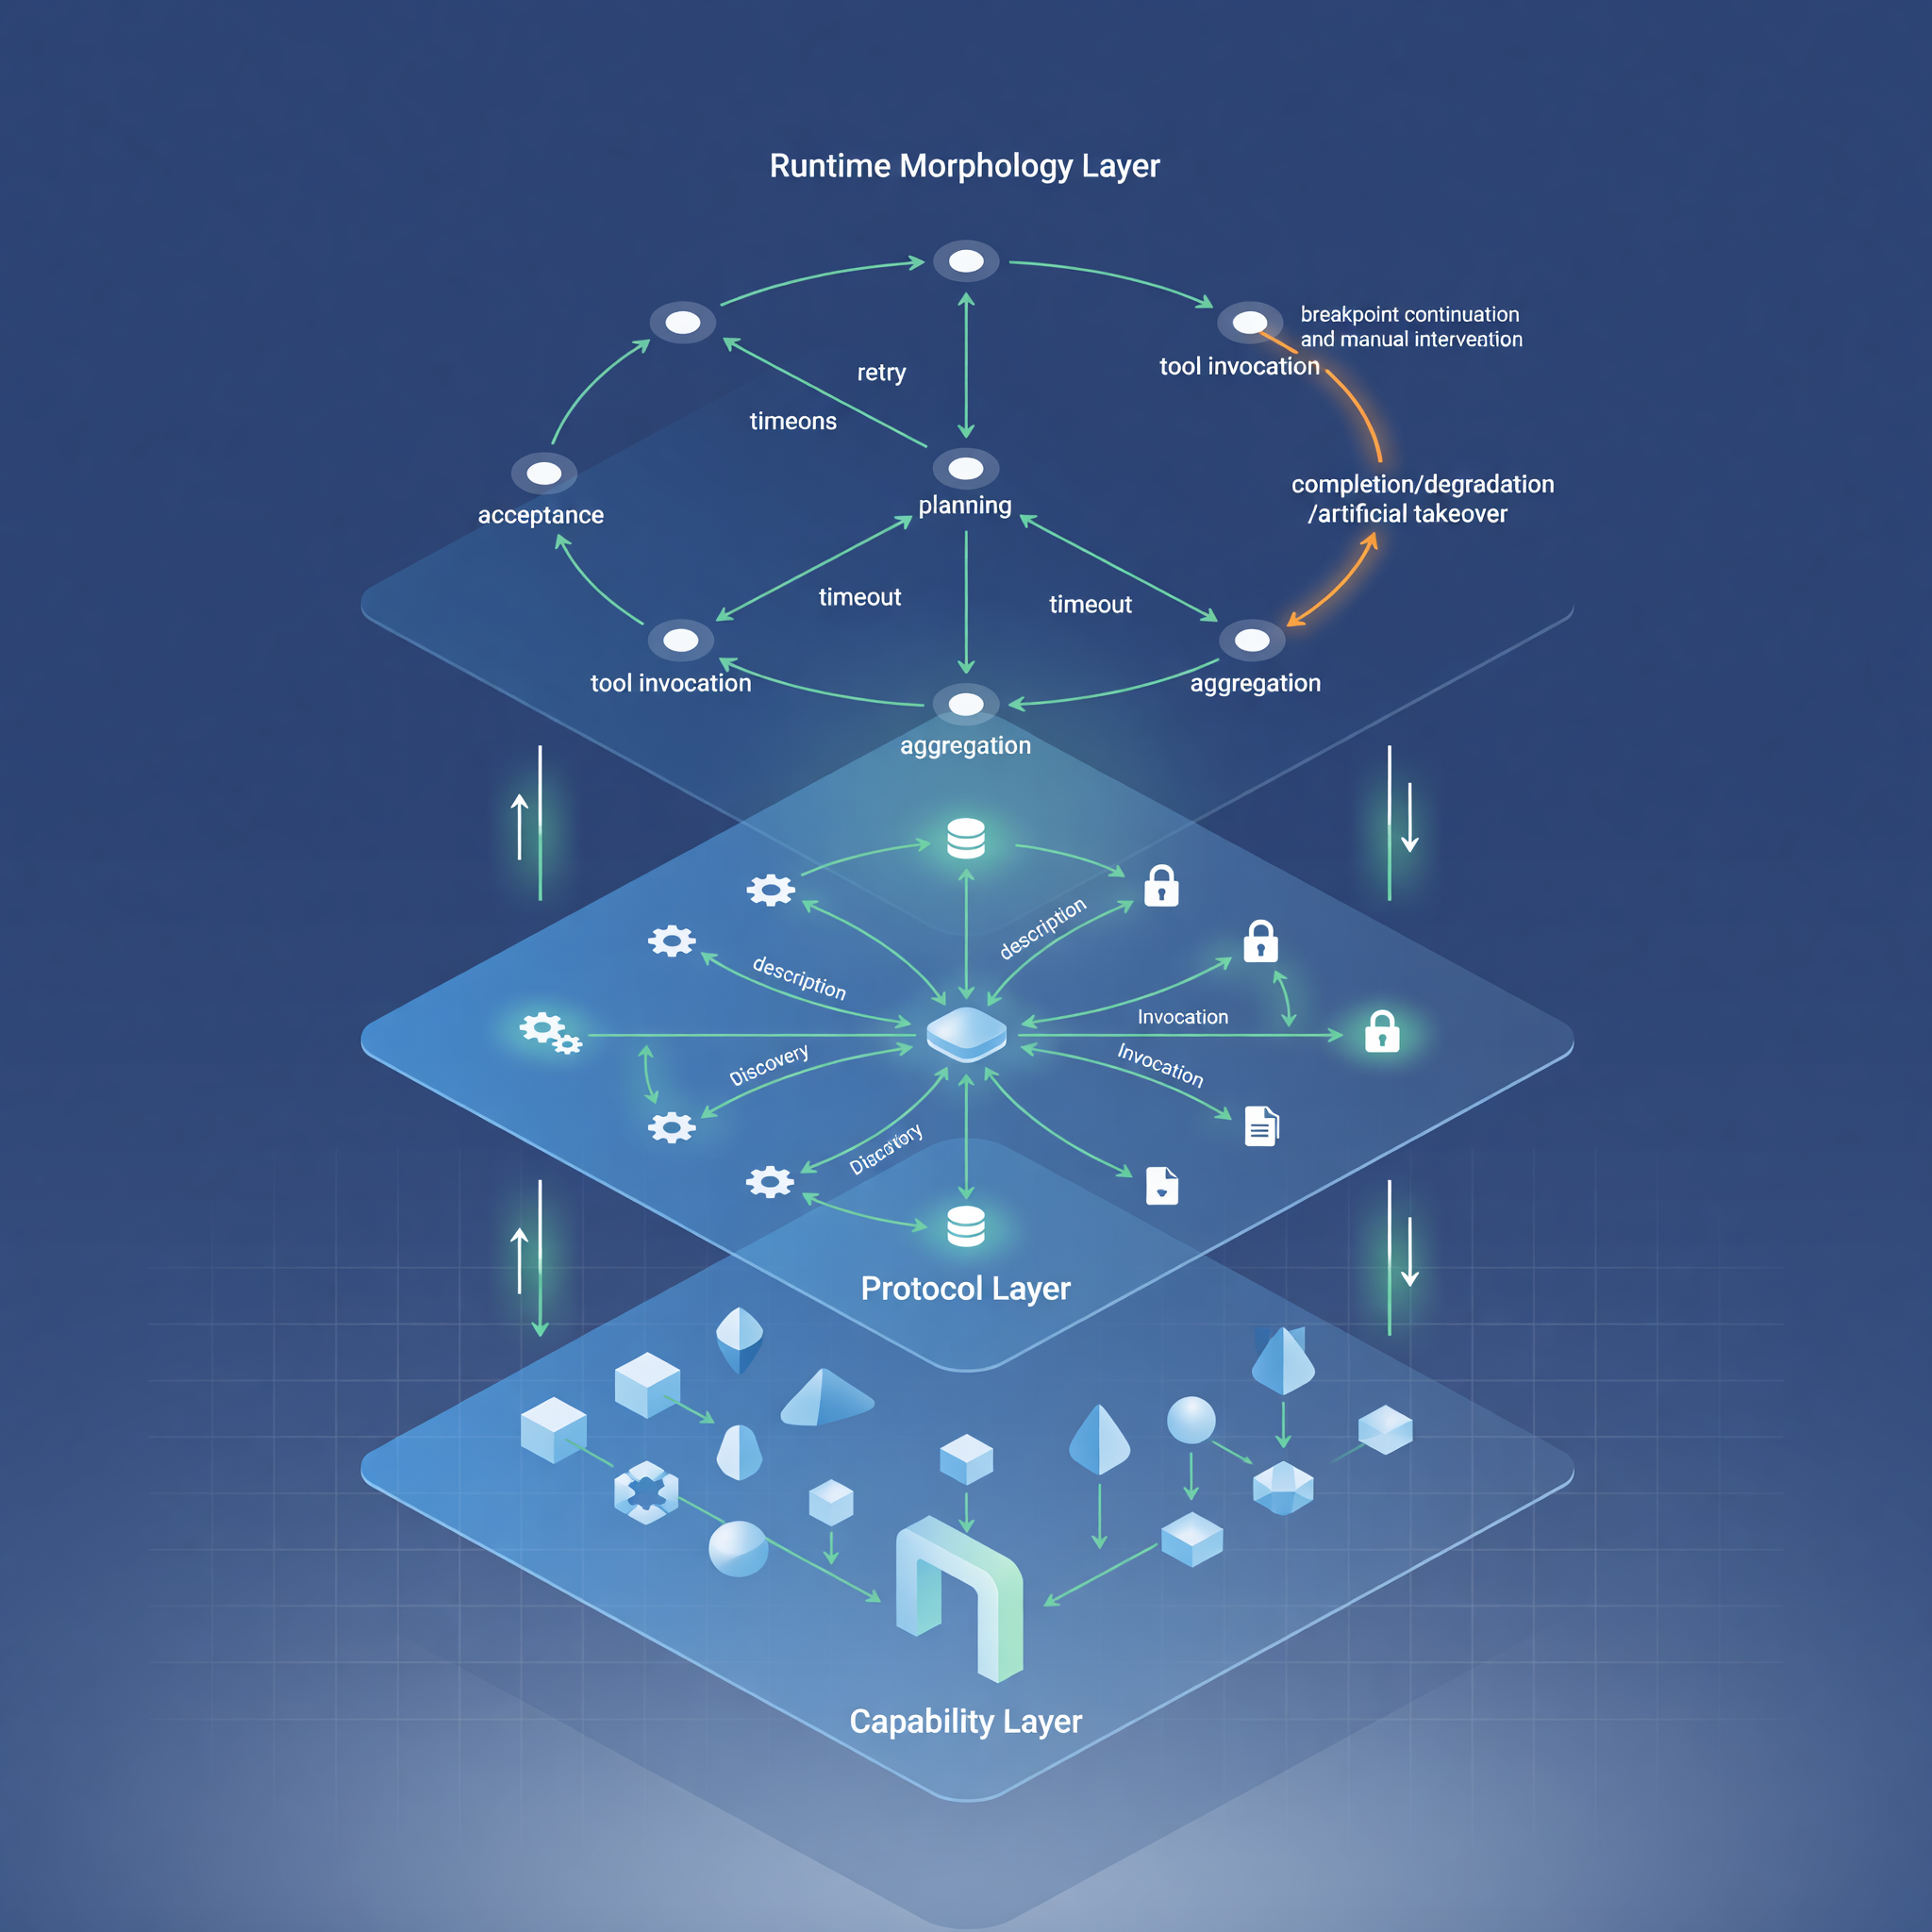
虚拟线程解决的是IO 等待期间的并发承载问题:模型调用与工具调用的大部分时间在等待网络响应,虚拟线程能让大量在途任务不必占用大量平台线程。社区有"IO 密集型吞吐量提升 3~5 倍""整体提升 300%"的说法 [7],这些数字未给出压测条件、请求模型、依赖版本与硬件环境,只能作为社区主张,不能写进容量规划。该文同时给出了三类值得注意的坑:低版本监控与链路追踪工具对虚拟线程支持不完善、锁等待依然会阻塞载体线程、以及相关 pinning 类问题 [7]。这些属于经验性提示,具体表现需在自己的 JDK 与框架版本组合上实测。
虚拟线程不能解决的问题同样明确:工具调用的幂等性、模型限流、成本控制、锁竞争导致的吞吐下降、以及可观测工具链的适配。
4.3 降级、超时与幂等
Agent 链路的失败点比普通 RPC 多一个量级,必须在设计期定义降级表:
| 模型超时/不可用 | 重试一次后转规则或缓存结果 | 多模型路由与健康度探测 |
| 工具调用失败 | 按工具风险等级决定跳过或中止 | 工具级熔断与降级实现 |
| 工具超时 | 只读工具跳过,写操作转人工 | 分级超时预算 |
| 上游限流 | 削减上下文、降低调用频次 | 队列化与优先级调度 |
| 结果不可信 | 标记低置信度,返回引用与人工入口 | 评测集回归与质量门禁 |
// 结构示意:降级骨架,不绑定具体 API
Answer result = executor.run(task)
.timeout(Duration.ofSeconds(totalBudget))
.onToolFailure(f -> f.riskLevel() == RiskLevel.READ
? Action.skip() // 只读工具可跳过
: Action.abortAndEscalate()) // 写操作转人工
.onModelFailure(() -> fallback.answer(task)) // 规则/缓存兜底
.execute();
工具重试的前提是幂等。写操作工具必须具备幂等键(如业务流水号),否则任何重试策略都在制造重复副作用。
五、开源样本:Java 版 Personal Agent 能借鉴什么
掘金在 2026 年 10 月 10 日介绍了 Java 版 Personal Agent 项目 ClawRunr(前身 JavaClaw),称其为 OpenClaw 的 Java 实现,基于 Java 25 + Spring Boot 4 + Spring AI 2.0,采用 MIT 协议开源 [2]。这些技术栈与许可证信息来自二手文章,落地参考前应以仓库的 README 与构建文件(pom/Gradle)为准。
这类样本真正值得借鉴的是结构,而不是代码本身:
从样本走到生产,还差一份差距清单:
| 鉴权与多租户 | 单用户假设 | 租户隔离、工具级权限 |
| 审计 | 日志为主 | 工具调用与模型调用可追溯、可导出 |
| 可观测 | 缺失或简陋 | token、时延、失败率、每任务成本 |
| 限流与降本 | 基本没有 | 预算、配额、降级出口 |
| 发布 | 单实例 | 灰度、回滚、配置隔离 |
| 数据合规 | 未考虑 | 脱敏、留存期、跨境约束 |
同样地,QuickBlue 这类"把 AI 应用当一等公民"的底座项目 [3],价值在于提供模块切分与治理位置的参考,其真实结构需以项目仓库为准,不宜按文章描述直接套用。
六、存量 Spring Boot 微服务的最小引入路径
阶段 0:单点试点
选一个高频、容错、收益可量化的场景,一个模型,一个工具。例如内部文档问答、工单摘要、日志异常初判。试点评分可参考:
| 调用频次 | 越高频,收益越容易量化 |
| 容错度 | 允许答案有瑕疵、有人工复核出口 |
| 数据敏感度 | 优先选低敏感数据,降低合规前置成本 |
| 可度量收益 | 有基线指标(平均处理时长、人工成本) |
验收标准建议写成三条:效果达标(人工评测通过率)、成本可控(单次调用成本上限)、故障可控(降级链路演练通过)。不满足就停在阶段 0,不要推进。
阶段 1:能力收口到统一抽象
把散落在各服务里的模型 HTTP 调用收敛到统一的 ChatService 一类抽象,保留厂商逃生通道:配置化切换 provider、厂商差异集中在扩展点、切换演练纳入发布流程。此阶段不引入 Agent 循环,先做单轮调用。
阶段 2:工具与资源 MCP 化
梳理工具清单,字段至少包括:名称、输入 schema、输出 schema、权限、是否幂等、超时预算、单次成本、失败语义。第一批只上只读工具;补齐网关鉴权、审计、限流之后再开放跨团队复用 [8]。
阶段 3:Agent 内嵌与事件驱动结合
只有当业务确实需要多轮决策(例如"查三处信息后给出结论并执行一次操作")时才引入 Agent 循环;单轮调用能解决的,不要 Agent 化。长任务改为异步任务 + 状态持久化 + 断点续跑,Agent 执行体与业务事务解耦。
| 0 试点 | 有基线指标与容错场景 | 效果、成本、降级三项达标 | 停止投入 |
| 1 能力收口 | 试点验证有效 | 业务代码不再直连厂商 SDK | 保留旧调用路径灰度回切 |
| 2 工具 MCP 化 | 有跨服务/跨框架复用需求 | 工具白名单与审计上线 | 工具退回服务内部 API |
| 3 Agent 内嵌 | 存在真实多轮决策需求 | 长任务可恢复、可降级 | 降级为单轮调用 |
版本与兼容性:必须核验的清单
| Java 运行时 | 目标 JDK 版本的支持状态与 LTS 定位 | JDK 发布说明 |
| Spring Boot | 目标版本与所需特性(虚拟线程启用方式、AOT 支持) | Spring Boot 官方文档 |
| Spring AI | 2.0 的 GA 状态、模块坐标、相对 1.x 的破坏性变更 | Spring AI 官方文档与 release notes |
| MCP | 规范当前版本、Java SDK 与 Spring 集成模块的可用性 | MCP 官方规范、所用 Spring AI 版本文档 |
| 观测组件 | 链路追踪与指标组件对虚拟线程的支持情况 | 各组件官方文档 |
样本项目采用 Java 25 + Spring Boot 4 + Spring AI 2.0 的组合 [2],这说明生态在向新版本靠拢,但不代表该组合已满足你的生产基线。版本矩阵必须由团队自己锁定并写进构建约束,升级按"小步、可回滚"执行。
七、观测、成本与降本
Agent 场景的观测指标应至少覆盖:token 输入/输出量、模型调用时延与失败率、工具调用时延与失败率、单任务总耗时、单任务成本、上下文命中与缓存命中率、降级触发次数。
成本归因按"场景 / 团队 / 模型 / 工具"四维拆分,否则账单只能看到总量,无法定位优化点。降本手段按"见效速度 × 实施成本"排序:
有社区文章提出用 AI Agent 动态调整限流阈值,并称可将算力成本降低 60% 以上 [10]。该数字来自单篇二手文章,未见实测条件与交叉验证,本文只作为一种思路引用,不作为降本承诺。真实成本应以所用模型厂商官方价目与自身账单为准。
八、避坑清单与决策速查
| 过早平台化 | 试点还没跑通就立项底座 | 先完成阶段 0,用真实需求倒逼平台边界 |
| 治理缺位 | 工具直接暴露、无审计 | 上线前补齐鉴权、审计、白名单 |
| 把社区数字当承诺 | 容量规划写入 +300%、-70% | 一律以自测数据为准,社区数字只作线索 [7][9] |
| Agent 化一切 | 一个单轮调用也写成循环 | 用决策树判断:多轮决策需求是否存在 |
| 忽视降级 | 只有成功路径 | 上线前做故障注入演练 |
| 抽象层泄漏 | 业务代码里出现厂商字段 | 把厂商差异收敛到扩展点并做切换演练 |
| 工具副作用失控 | 重试导致重复写入 | 写操作强制幂等键与人工确认 |
三变量选型速查:
- 只需要"换个模型不改业务代码" → 从 Spring AI 能力层收口开始。
- 需要"同一工具被多个框架/团队复用" → 在收口之后做 MCP 协议化。
- 需要"多轮决策 + 多步工具调用" → 才考虑 Agent 内嵌,并同时补齐事件驱动与可观测。
- 三者都要,但资源有限 → 严格按 0 → 1 → 2 → 3 推进,不要并行铺开。
九、结语
对已有 Spring Boot 微服务的团队,2026 年的合理顺序是:先收口,再协议化,最后才是内嵌。Spring AI 2.0 解决的是"用统一编程模型接住多厂商与 RAG",MCP 解决的是"工具与资源跨框架复用的契约",Agent 内嵌解决的是"多轮任务在你的服务体系里如何长期运行"。三者各司其职,任何一个都不能替代另两个。
最后再次强调本文的核验纪律:Spring AI 2.0、Spring Boot 4、Java 25 与 MCP 的具体版本、API 与兼容矩阵,以官方文档与 release notes 为准;所有性能与成本数字,以团队自己的压测与账单为准;开源样本以仓库实际代码为准。把二手社区结论直接写进架构决策,是这一轮 AI 工程化里代价最高的错误之一。
参考资料
[1] 《2026 后端 AI 集成实战:Spring AI 2.0、MCP 协议与 Agent 内嵌的三条落地路径》,CSDN,https://blog.csdn.net/m0_74899094/article/details/166905088
[2] 《重磅!Java 版 Personal Agent 来了:Spring Boot + Spring AI 全栈开源,生产级细节全摊开了》,掘金,https://juejin.cn/post/7694882064270098447
[3] 《QuickBlue:基于 Spring Cloud 的 AI 应用底座,解决微服务与模型接入痛点》,CSDN,https://blog.csdn.net/weixin_30231327/article/details/166976884
[4] 《收藏!2026年 AI 后端开发终极指南:Spring AI 2.0 vs LangChain vs NestJS,生产级项目到底怎么选?》,CSDN,https://blog.csdn.net/weixin_44705473/article/details/163311682
[5] 《2026 后端架构进入 AI 原生阶段:事件驱动 + 虚拟线程 + Agent 内嵌三驾马车怎么落地》,CSDN,https://blog.csdn.net/m0_74899094/article/details/166991079
[6] 《Java 2026:从 JDK 24 到企业级 AI Agent 实战——后端开发者的技术跃迁指南》,CSDN,https://blog.csdn.net/qq_42055933/article/details/161519799
[7] 《SpringBoot3 + Java21 虚拟线程实战:吞吐量提升 300%,彻底告别线程池调优》,CSDN,https://blog.csdn.net/m0_75223114/article/details/162530537
[8] 《SpringCloud Gateway + OAuth2.0 + JWT 微服务认证授权实战》,CSDN,https://blog.csdn.net/weixin_31742871/article/details/167695106
[9] 《2026 Java 技术栈进阶实战:JVM 调优 + Spring AI + 微服务优化全攻略》,CSDN,https://blog.csdn.net/GD_ChenBiao/article/details/162517858
[10] 《AI Agent + PHP 实现智能接口限流,避开算力成本陷阱》,CSDN,https://blog.csdn.net/chen501986411/article/details/160260118
[11] 《⚙️ AI 基础设施日报 2026-10-05 · Issue #3623》,GitHub(duanyytop/agents-radar),https://github.com/duanyytop/agents-radar/issues/3623
[12] 《SpringBoot+Cloud 私有化部署停在哪一档:单体够用,还是该拆微服务(2026)》,CSDN,https://blog.csdn.net/zhouzhongyan/article/details/166990528
[13] novel-cloud(Spring Cloud 微服务学习型项目),Gitee,https://gitee.com/99fu/novel-cloud
说明:Spring AI 官方文档、MCP 官方规范、Spring Boot 官方文档及 Java 发布说明的链接未包含在本次研究资料中,故未在此列出;正文涉及版本、API 与兼容矩阵之处,请以上述官方来源的最新内容核验后再填入项目决策文档。


评论前必须登录!
注册