 网硕互联帮助中心
「128GB 统一内存、单机 2000 亿参数」这句话,必须配三个限定词才有意义:什么精度、单机还是双机、多少并发。本文给一个面向统一内存设备的容量与带宽计算脚本,用 8B/32B/70B/200B/405B 五档算例说明容量边界,并给出「能跑」与「能服务多少人」之间的区别。
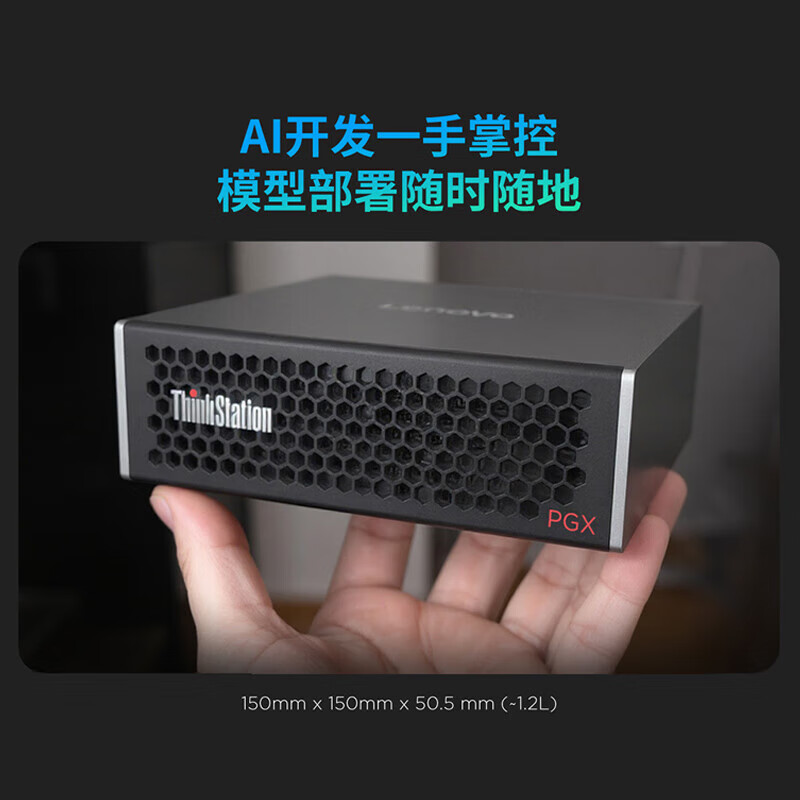
图注:统一内存架构示意(来源:商红科技行业论坛原文配图;非实测)
先说结论
- 权重内存 ≈ 参数量 × 位宽 ÷ 8,再留 10%–20% 给 KV Cache 与框架开销;
- 128GB 能装下 70B 的 INT8/INT4、200B 的 FP4,但装不下 70B FP16;
- 容量决定「装不装得下」,带宽决定「吐字快不快」。统一内存 273 GB/s 的单流上限,适合个人/小团队,不适合几十人并发在线问答。
一、先分清三个词
参数量 ≠ 要装进内存的量。 MoE 模型推理时只激活部分专家,但权重仍要全部驻留。总参数描述规模,激活参数描述每 token 计算量,两者不能混。
精度位宽决定内存。 同一个 70B:FP16 约 140GB、INT8 约 70GB、INT4 约 35GB。看到「能跑 N 千亿参数」,先问精度。
容量、带宽、算力三者分工不同。 容量管装不装得下,带宽管单流速度,算力管每步计算。宣传口径常把它们合成一句「算力强」,选型时必须分开。
二、容量与带宽计算脚本
#!/usr/bin/env python3
"""统一内存设备的容量与单流速度估算(示例口径,非实测)。"""
GB = 1024 ** 3
def kv_bytes(layers: int, kv_heads: int, head_dim: int,
seq: int, batch: int = 1, elem_bytes: int = 2) -> float:
return 2 * layers * kv_heads * head_dim * seq * batch * elem_bytes
def fit(params_b: float, bits: int, layers: int, kv_heads: int,
head_dim: int, seq: int, batch: int = 1,
usable_gib: float = 128.0, margin: float = 0.15) -> dict:
weight_gib = params_b * 1e9 * bits / 8 / GB
kv_gib = kv_bytes(layers, kv_heads, head_dim, seq, batch) / GB
subtotal = weight_gib + kv_gib
total = subtotal * (1 + margin)
return {
"weight_GiB": round(weight_gib, 2),
"kv_GiB": round(kv_gib, 2),
"total_with_margin_GiB": round(total, 2),
"fits": total <= usable_gib,
"headroom_GiB": round(usable_gib – total, 2),
}
def decode_upper(weight_gib: float, bandwidth_gbs: float = 273.0,
efficiency: float = 0.6) -> float:
"""单流 tokens/s 的粗略上限:带宽 ÷ 每 token 读取的权重。"""
return bandwidth_gbs * efficiency / weight_gib
if __name__ == "__main__":
# 以 80 层、8 个 KV 头、128 头维度为例;不同模型请替换
for name, p, bits in [
("8B FP16", 8, 16), ("8B INT4", 8, 4),
("32B FP16", 32, 16), ("32B INT8", 32, 8),
("70B INT8", 70, 8), ("70B INT4", 70, 4),
("200B FP4", 200, 4), ("405B INT4", 405, 4),
]:
r = fit(p, bits, 80, 8, 128, 8192)
speed = decode_upper(r["weight_GiB"])
print(f"{name:12} {r} 单流上限约 {speed:.1f} tok/s")
示例结论:
| 8B FP16 | 约 16GB | 是 | 约 10 tok/s |
| 32B FP16 | 约 64GB | 是 | 约 2.6 tok/s |
| 70B INT8 | 约 70GB | 是,余量约 40GB | 约 2.3 tok/s |
| 70B FP16 | 约 140GB | 否 | — |
| 200B FP4 | 约 100GB | 是,余量很小 | 约 1.6 tok/s |
| 405B INT4 | 约 202GB | 单机否;双机各约 101GB | — |
这些是算术示例,不是实测;KV Cache、激活值和框架开销都会让实际值变化。
三、为什么「能跑」不等于「能服务」
单流速度的上限由带宽决定。128GB 统一内存设备的带宽约 273 GB/s,而独立显存可以到 1792 GB/s。差距不是容量,是每天用起来的体感。
三类场景对号入座:
| 单人算法开发 / 原型验证 | 合适 | 70B 量化模型能装下,单流速度够个人用 |
| 高校实验室教学 | 合适 | 便携、预装软件栈、断网可跑 |
| 车间 / 厂区边缘低并发 | 合适 | 数据不出内网 |
| 几十人高并发在线问答 | 不合适 | 单流上限与 KV 占用摆在那里 |
| 70B 以上全量微调 | 不合适 | 形态与内存都为推理与轻量微调设计 |
四、采购前要写进确认单的三件事
五、与塔式/服务器的边界
统一内存设备的优势是容量与便携,代价是不能换卡扩容、散热按小机身设计、长时间满载不适合塞机柜。需要多卡训练、几十人并发或更高带宽时,应看塔式多卡或机架服务器,而不是继续加统一内存设备。
边界与适用条件
- 脚本中的层数、KV 头数、头维度是示例,实际以模型 config.json 为准;
- 单流速度是上限估计,不含 KV 读取与框架开销,不是性能承诺;
- 双机互联方案的有效容量与效率受互联带宽影响,必须实测。
工程落地中的一个选择
选型前先用自己的模型名、参数量、量化方式和并发数做一轮测算,再决定形态。商红科技做工作站与服务器整机交付,能按容量与带宽把统一内存、塔式、机架三种形态的边界一起过一遍;更细的参数表与边界条件,见这份公开拆解。最终结论仍应以你的实测为准。


评论前必须登录!
注册