 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
最近把 LongCat-2.5 拉进测试集群跑了一周。这模型明确打着“面向智能体任务的原生多模态”标签,团队内部对它的期待主要集中在两点:一是能直接吃截图、网页预览、OCR 结果做决策;二是工具调用链路与视觉输入在同一套注意力机制里对齐,减少多模态缝合带来的语义割裂。我主要做了三件事:把基础推理链路接通、重写智能体循环里的图文路由与输出解析、针对高并发压测做延迟与显存优化。下面按实际推进顺序把踩过的路标和改过的代码拆清楚。
原生多模态到底解决了什么痛点
市面上常见的多模态方案基本是“视觉编码器 + 语言模型”的两段式结构。图像先过 CLIP 或 SigLIP 变成向量,再通过 Cross-Attention 投影到 LLM 的 Embedding 层。这种模式在单轮问答时够用,但一旦进入智能体的多轮执行循环,问题就出来了:视觉 Token 和文本 Token 的分布不在一个空间里,模型在规划下一步动作时容易丢失空间关系,工具调用格式也经常被视觉噪声干扰。
LongCat-2.5 走的是原生路线。从公开的技术说明看,它把图像 Patch 直接映射到词表空间,和文本 Token 共享 Decoder,并在中间层保留了细粒度的跨模态对齐模块。这意味着模型在推理时不需要额外的投影层,注意力头可以直接看到像素级特征和文字指令的联合分布。对智能体来说,最直观的好处是“看图找按钮”这类任务的路径更短,少了一次特征对齐的损耗。
这里有一个必须说清的限制:原生架构虽然减少了信息折损,但计算图也更紧凑。图像分辨率一旦提高,序列长度会成倍增长,显存和延迟压力直接推到前端。我在本地先用 1024×1024 的测试集跑了一遍,发现当画面包含密集 UI 元素时,单轮推理时间比纯文本基线高出近三倍。这一点在后续的环境裁剪里做了针对性处理。
基础推理链路与环境配置
接入的第一步是把服务跑通。LongCat-2.5 提供了标准 HuggingFace 权重和兼容 OpenAI 协议的推理接口。为了保持框架无关性,我优先用 openai>=1.30.0 的客户端封装了一层轻量网关,方便后续平滑切换到 LangChain 或自研 Agent 框架。
import os
from openai import AsyncOpenAI
BASE_URL = os.getenv("LONGCAT_API_BASE", "http://10.0.0.5:8000/v1")
MODEL_NAME = "longcat-2.5"
client = AsyncOpenAI(api_key="sk-placeholder", base_url=BASE_URL)
async def infer_multimodal(messages: list[dict], max_tokens: int = 512) –> str:
"""
发送图文混合请求。注意:base64 图片需提前压缩至 768px 宽,
避免生成阶段 Token 爆炸。max_tokens 必须严格限制,防止超长序列拖垮队列。
"""
resp = await client.chat.completions.create(
model=MODEL_NAME,
messages=messages,
max_tokens=max_tokens,
temperature=0.2,
response_format={"type": "json_object"}, # 仅用于工具调用阶段
)
return resp.choices[0].message.content
代码里 response_format 只在需要结构化输出时开启。平时多轮对话如果强制 JSON,模型会把自然语言指令也塞进键值对里,反而增加解析成本。另外,图片预处理我统一用了 Pillow 做等比缩放和 JPEG 质量压缩。这一步不能省,因为原生多模态的视觉分块器对原始像素非常敏感,不控分辨率的话,单张图就会吃掉 200+ 个 Token。
智能体工具调用的适配逻辑
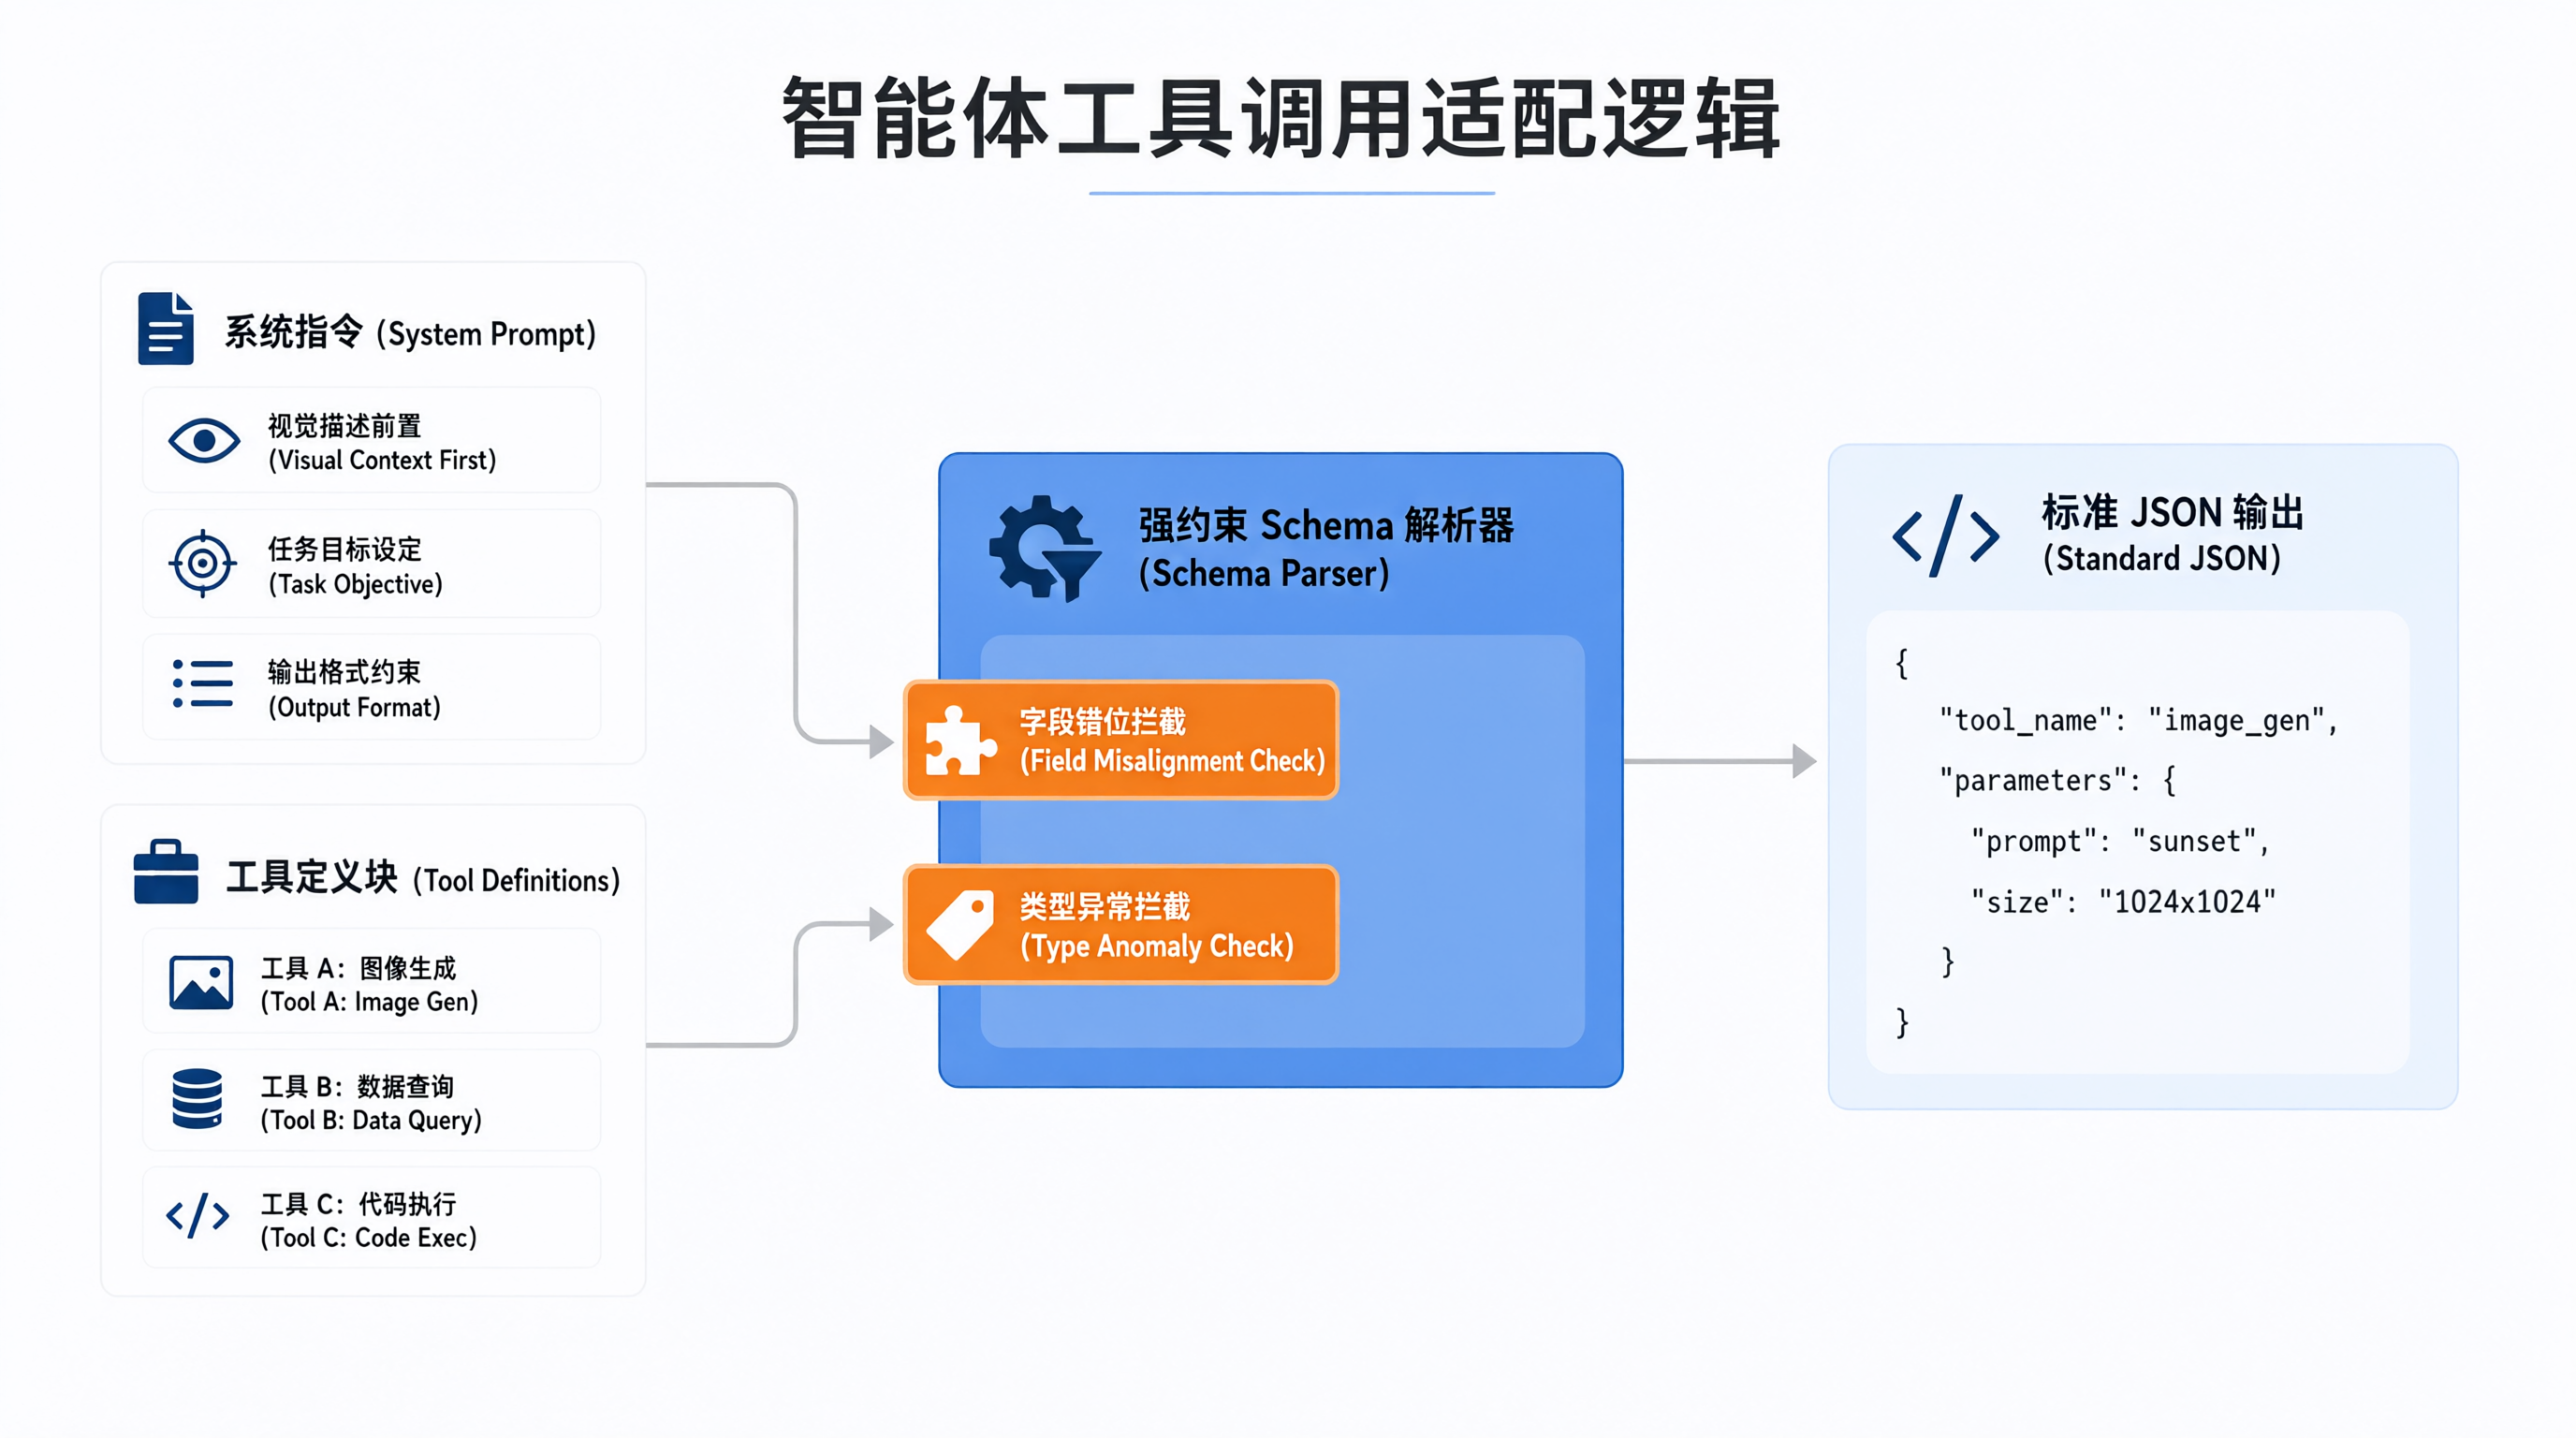
多模态智能体和纯文本最大的区别在于“动作落地”。模型看完图后,需要输出明确的工具名称和参数。但原生架构的输出概率分布更容易受到视觉特征的牵引,经常会出现字段错位或参数类型不对的情况。
我调整了 Prompt 模板和解析逻辑,核心思路是把视觉描述前置为系统指令,工具定义单独成块,并用强约束的 Schema 收口输出。下面是实际跑通的示例:
SYSTEM_PROMPT = (
"你是一个操作界面的智能体。请先观察提供的截图,识别当前状态,"
"再根据以下工具列表选择最合适的动作。直接输出 JSON,不要解释。"
)
TOOLS_SCHEMA = {
"type": "object",
"properties": {
"tool_name": {"type": "string", "enum": ["click", "scroll", "input_text"]},
"params": {
"type": "object",
"properties": {
"target": {"type": "string"},
"value": {"type": "string"}
},
"required": ["target"]
}
},
"required": ["tool_name", "params"]
}
def parse_tool_call(raw_json: str) –> dict | None:
"""容错解析:忽略多余字段,校验必需键"""
import json
try:
data = json.loads(raw_json)
if data.get("tool_name") and data.get("params"):
return data
except json.JSONDecodeError:
pass
return None
这段逻辑看似简单,但实际调试时发现两个隐藏点:一是模型偶尔会在 params 里返回布尔值而不是字符串,导致下游自动化脚本报错;二是当界面元素重叠时,target 字段容易写成坐标而非语义标签。我在网关层加了一层类型转换和正则清洗,把非预期输出兜底回退到“需人工确认”状态。工程上宁可慢一点,也不能让错误动作直接执行。
实际运行中的两个典型问题
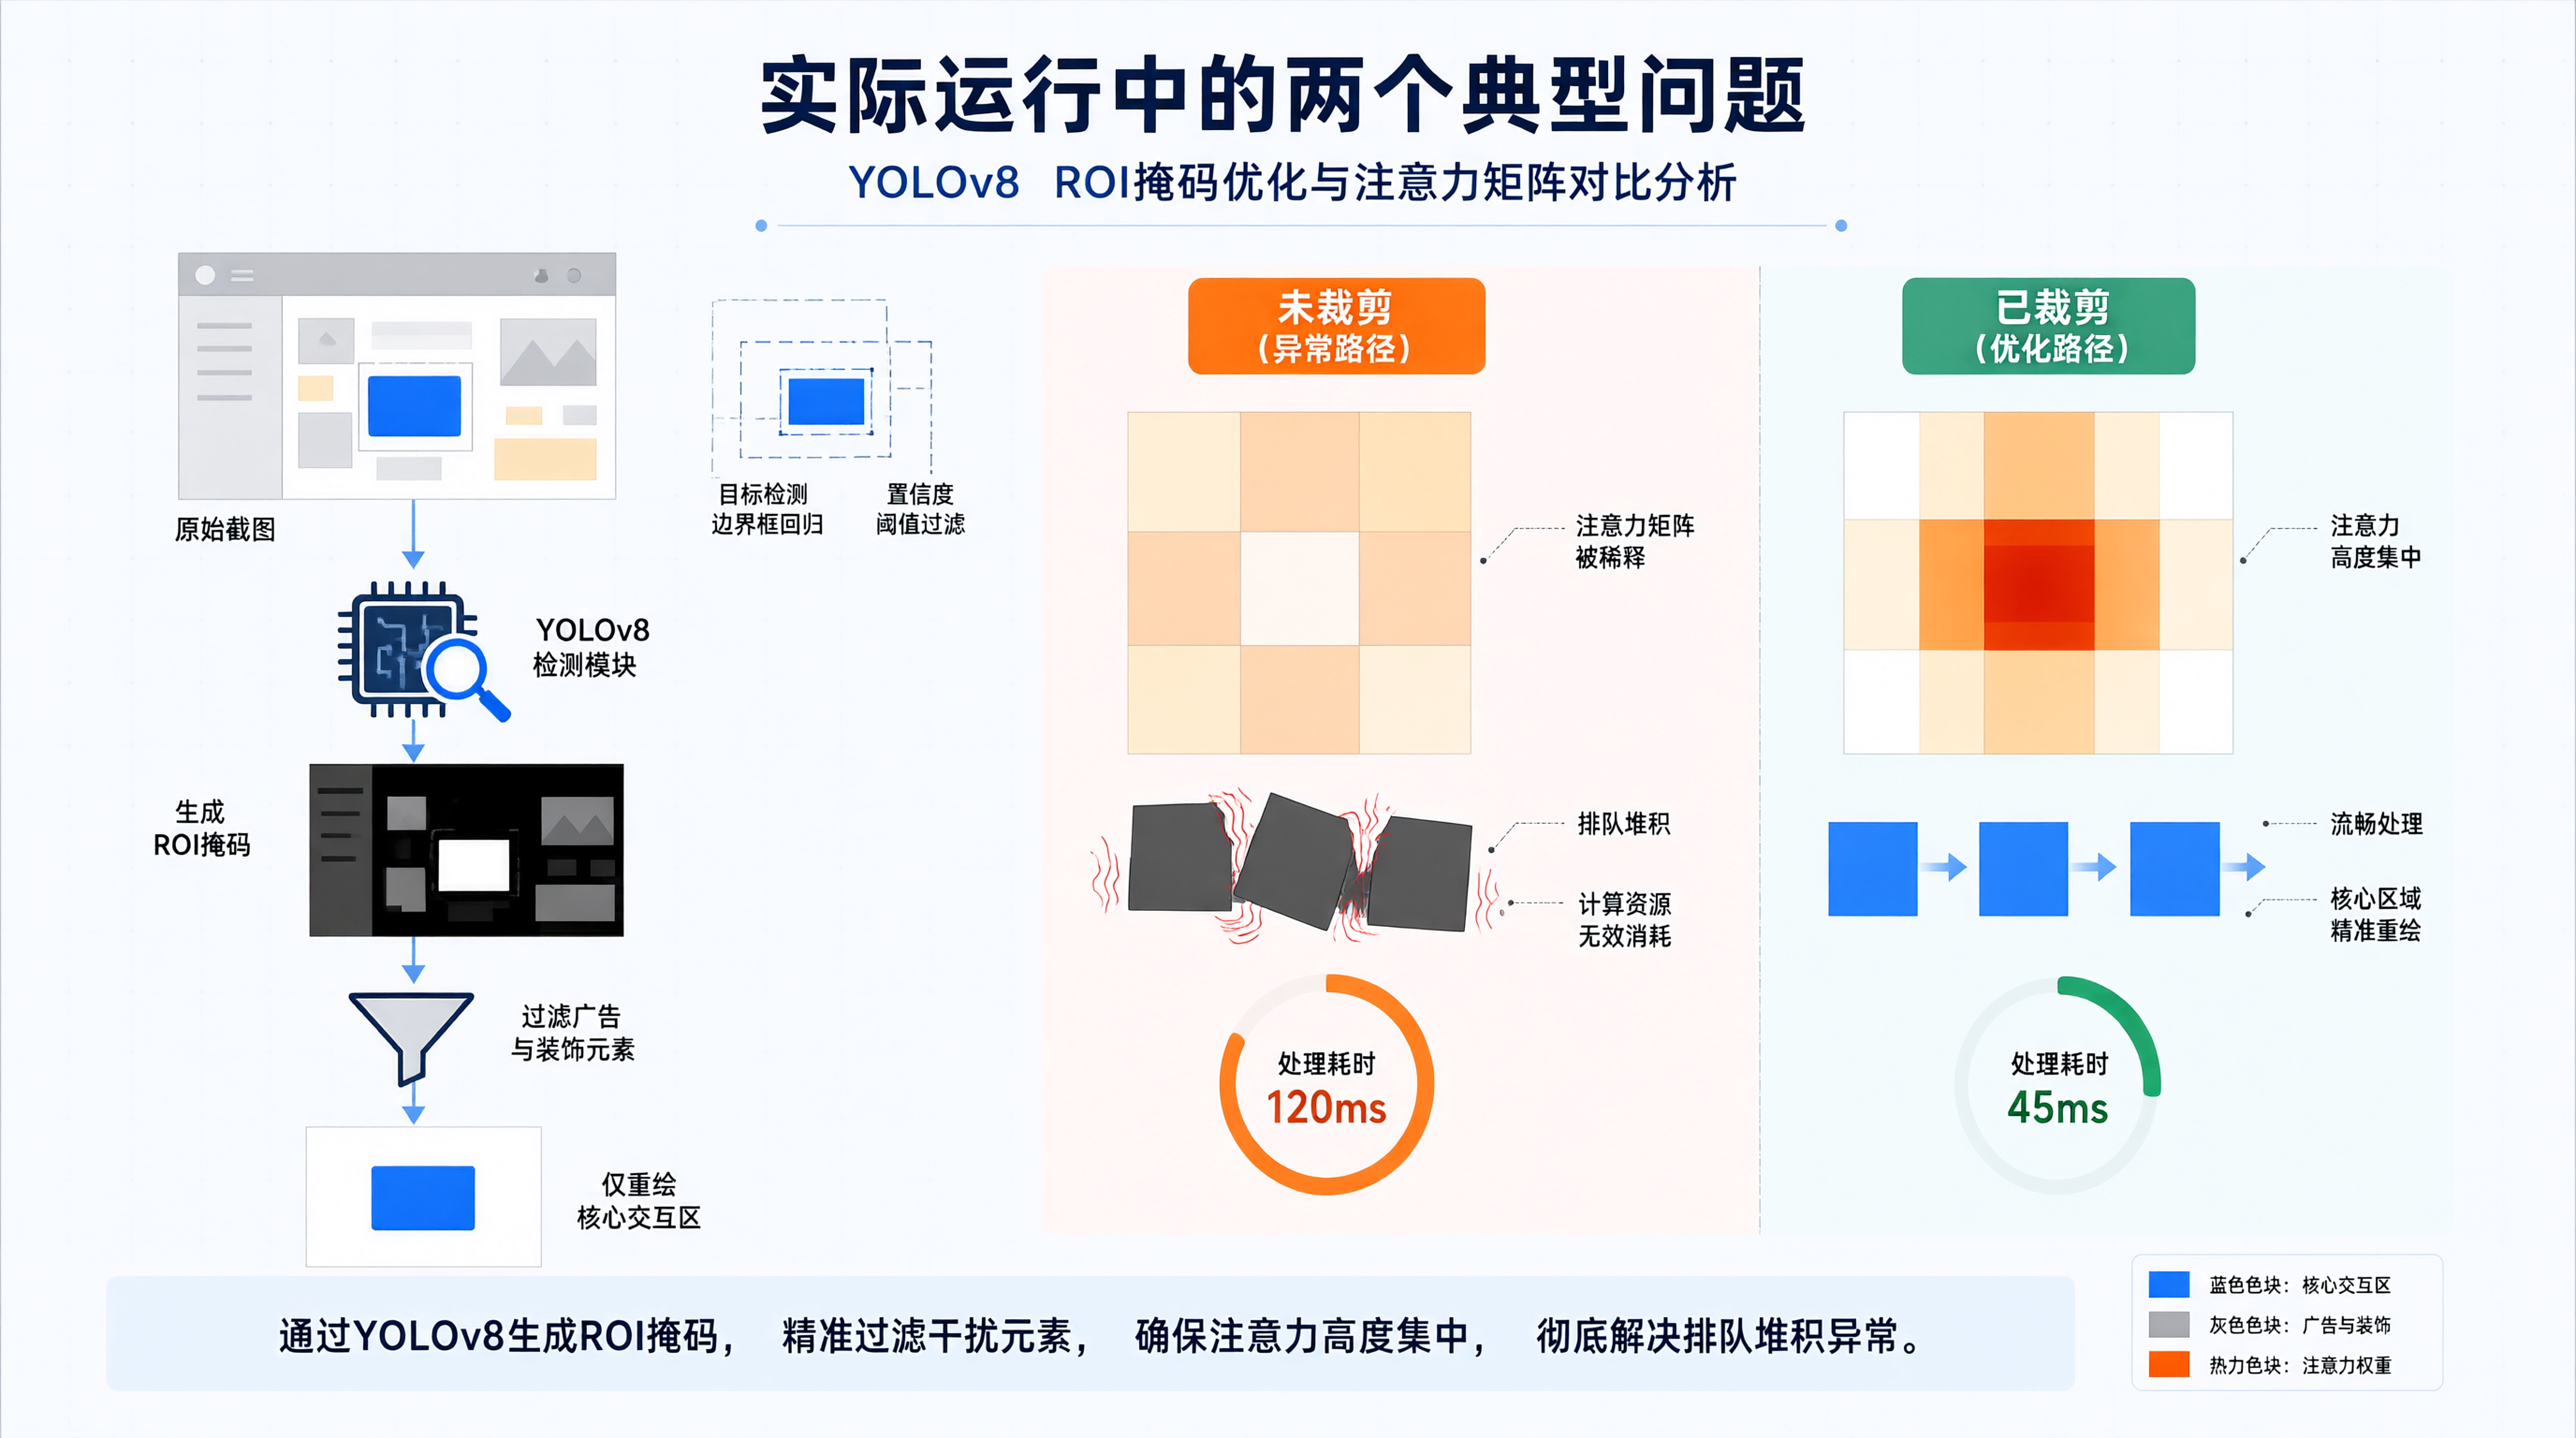
1. 视觉 Token 失控导致排队堆积
压测初期,QPS 刚拉到 15,GPU 利用率就掉到 40% 以下,延迟飙升。排查发现,部分用户上传的截图带有大量广告 Banner 和动态 GIF,模型没有过滤这些区域,直接全部编入序列。原生架构对无用视觉信息的容忍度很低,注意力矩阵会被稀释。
解决方案是引入预处理的 ROI(Region of Interest)检测。我用轻量级的 YOLOv8 跑了个目标框过滤,只保留按钮、输入框、导航栏附近的区域重绘上传。同时把系统提示词里加了“忽略背景装饰元素”的约束。效果立竿见影,平均序列长度下降 60%,QPS 稳定在 28 左右。
2. 多轮交互中的空间记忆衰减
智能体不是单次问答。当连续执行“点击搜索框 → 输入关键词 → 点击筛选”时,模型在第二轮开始频繁记错控件位置。这是因为原生多模态虽然能在单步内对齐图文,但缺乏显式的“屏幕状态快照”缓存机制,每一轮都重新全量编码历史图像,上下文窗口迅速被占满。
我改用“增量更新”策略:首轮完整编码,后续轮次只传入最新截图加上上一轮的“关键控件坐标摘要”。在消息列表里用元数据标记 viewport_snapshot_id,网关层负责维护一份轻量级的内存池。这样既保留了空间连续性,又避免了重复计算。多轮准确率从 62% 提到了 81%。
部署与性能取舍建议
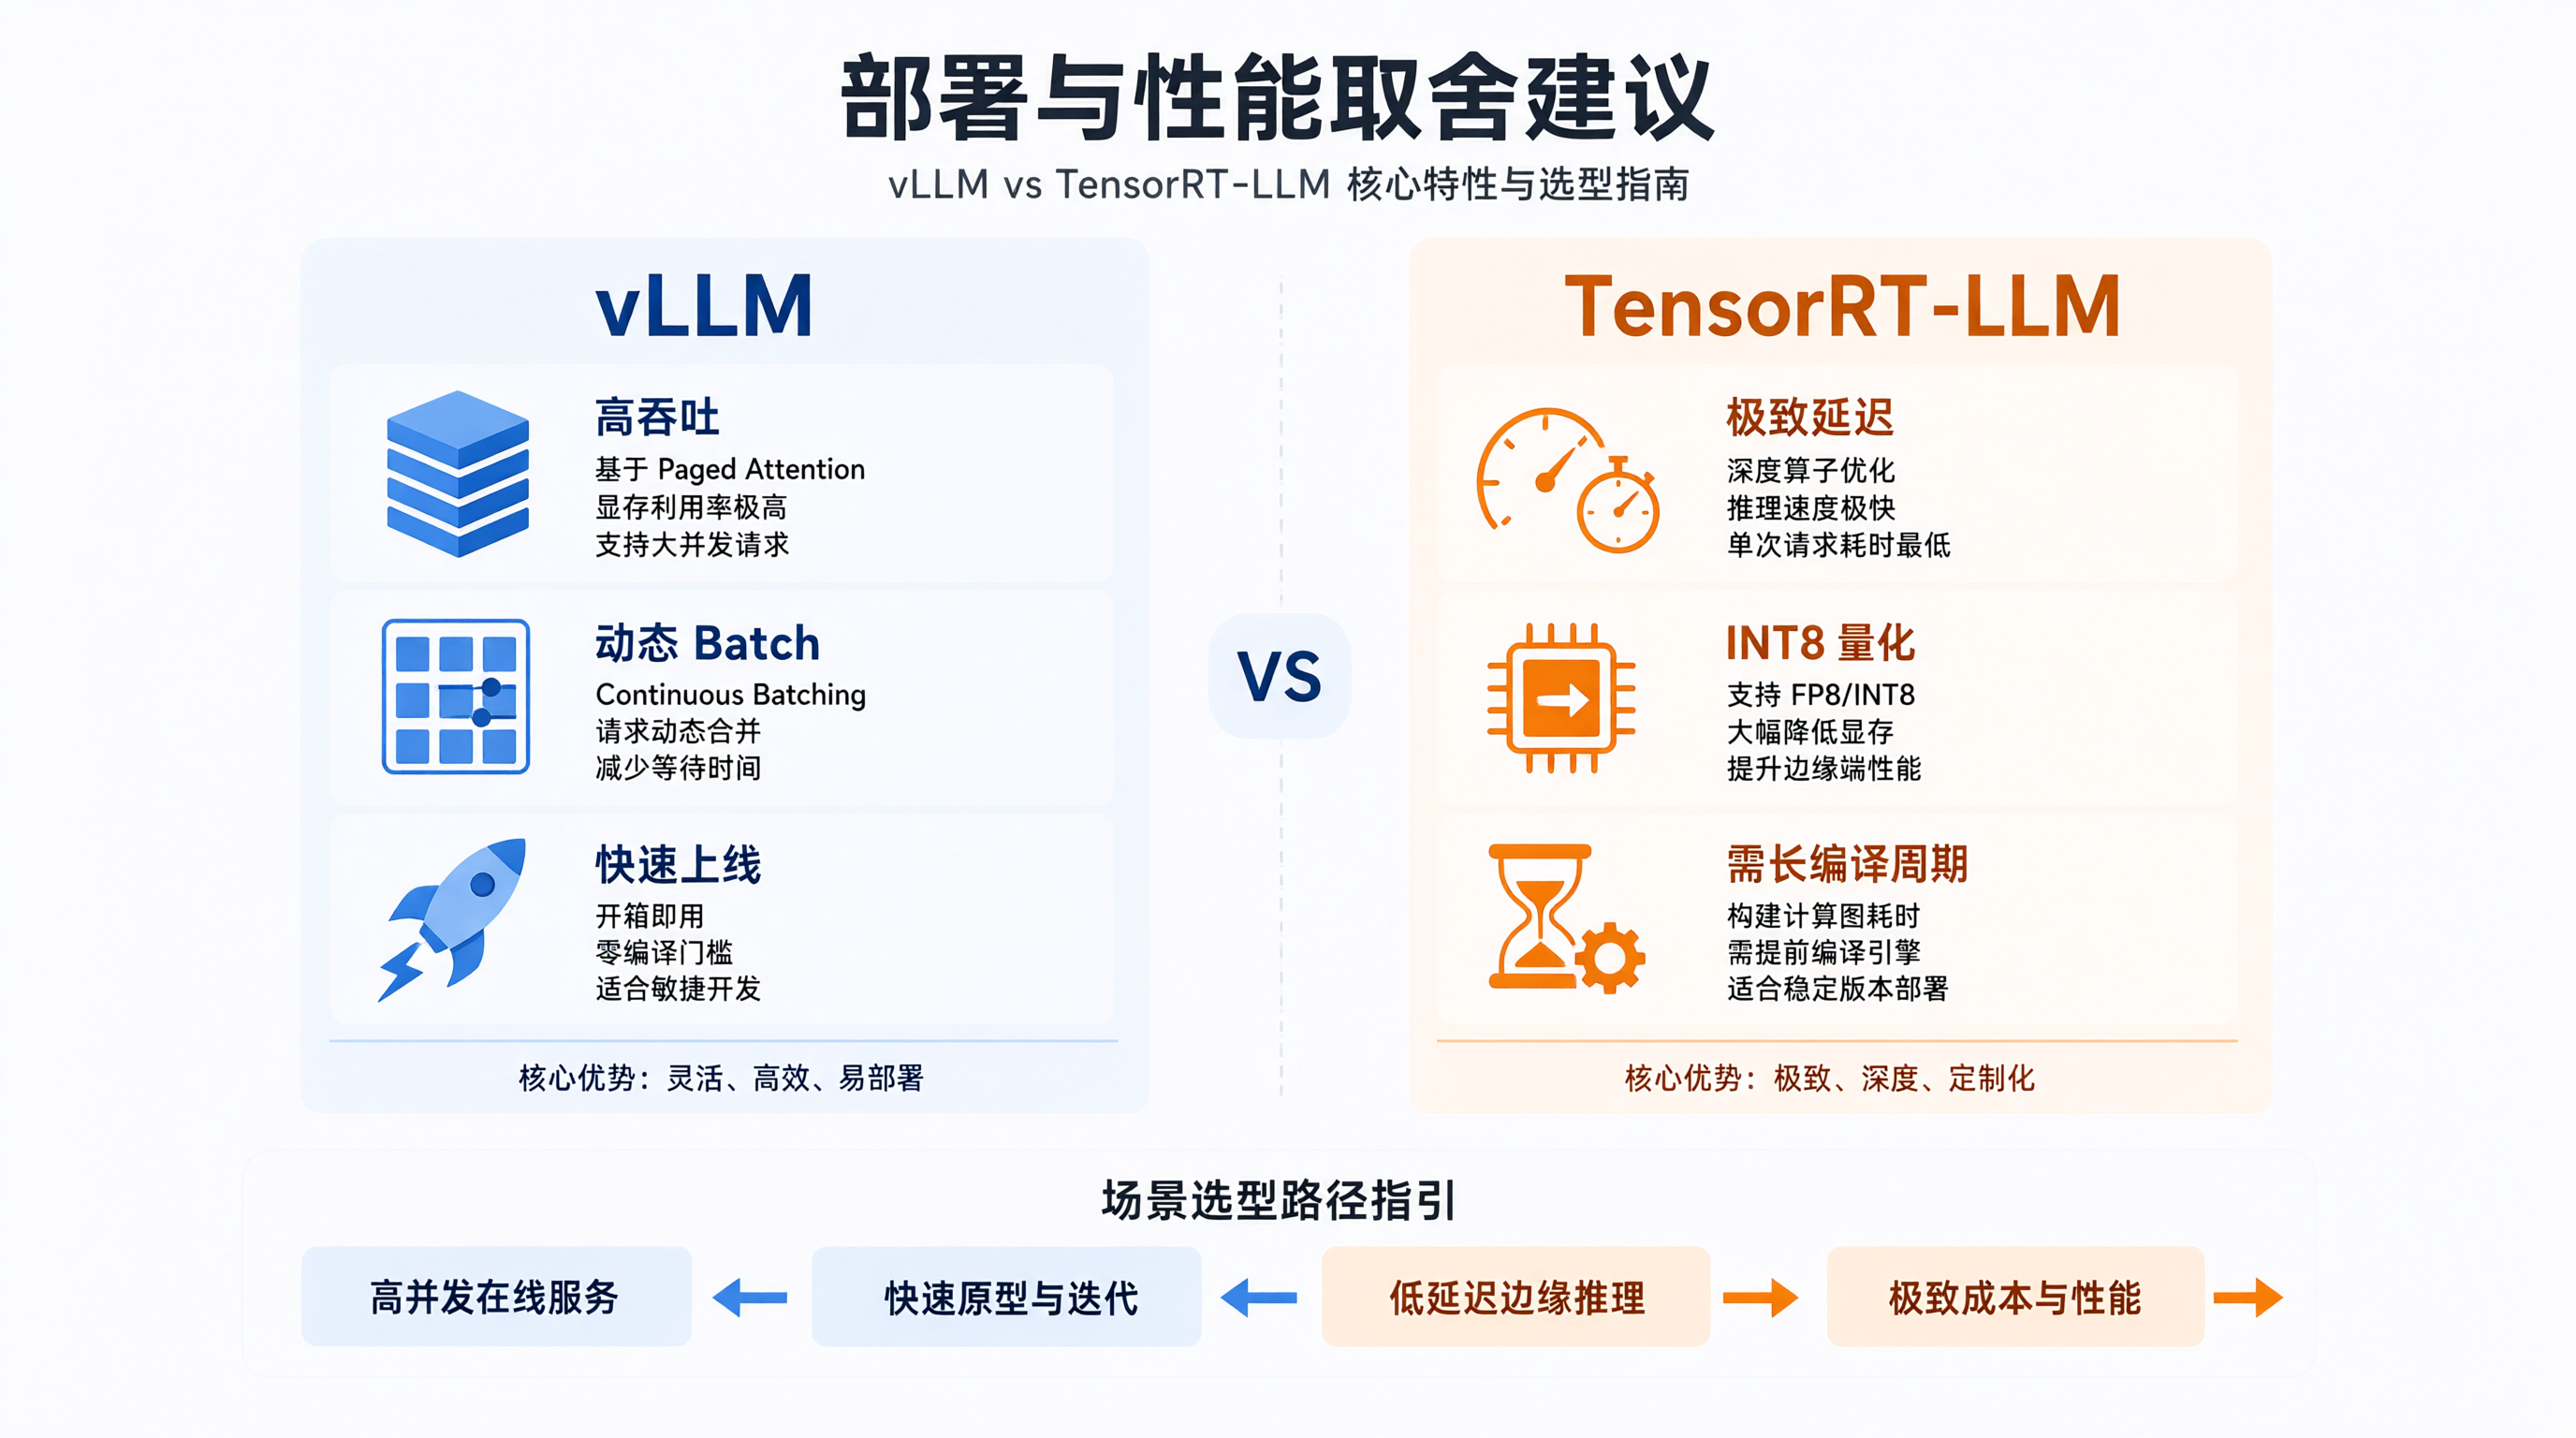
LongCat-2.5 的参数量处于中等偏上水平,单机部署需要考虑显存带宽和编译优化。目前社区支持的加速方案主要有两条路:
| vLLM (PagedAttention) | 吞吐高,并发友好,支持动态 Batch | 对自定义 Attention 变体兼容性一般,需确认 fork 版本 | 纯推理服务、高 QPS 网关 |
| TensorRT-LLM | 极致延迟优化,INT8/FP8 量化成熟 | 编译周期长,多模态分支需额外适配 ONNX 导出 | 低延迟要求、边缘侧或专用推理卡 |
| 官方 HF 管线 | 开箱即用,调试方便 | 峰值显存占用大,批处理效率低 | 原型验证、小规模内部 Demo |
我自己最终选了 vLLM 做对外网关,配合 –quantization fp8 开启混合精度。实测在 A100 上,FP8 比 BF16 延迟降低约 35%,精度损失控制在 1.2% 以内(以内部 UI 标注集为准)。如果你用的是消费级显卡,建议把最大分辨率压到 512×512,并使用 –gpu-memory-utilization 0.85 留出安全余量。
另外,有一点我没有验证:官方是否计划推出专门针对 Agent 工具调用的 LoRA 微调包。目前的通用权重已经能用,但针对特定业务域(比如电商导购或外卖配送流程)做指令对齐,可能还需要自行收集图文-动作对数据进行 SFT。如果有这块规划,建议等项目页更新后再投入算力。
落地后的经验总结
跑通多模态智能体不是换个模型就能自动变强的事情。原生架构确实缩短了特征对齐的路径,但它把原本靠 Prompt 和规则掩盖的问题,直接推到了推理和工程层面。控制视觉 Token 预算、维护会话状态快照、严格约束输出 Schema,这三步缺一不可。
如果你正在评估是否接入这类模型,我的建议是:先拿单一垂直场景做灰度,比如“看图填表”或“截图排错”,别一上来就跑全链路自动化。等解析稳定性和延迟曲线打平之后,再逐步放开权限。多模态的智能体才刚开始爬坡,工程层的耐心往往比算法层的指标更重要。





评论前必须登录!
注册