 网硕互联帮助中心
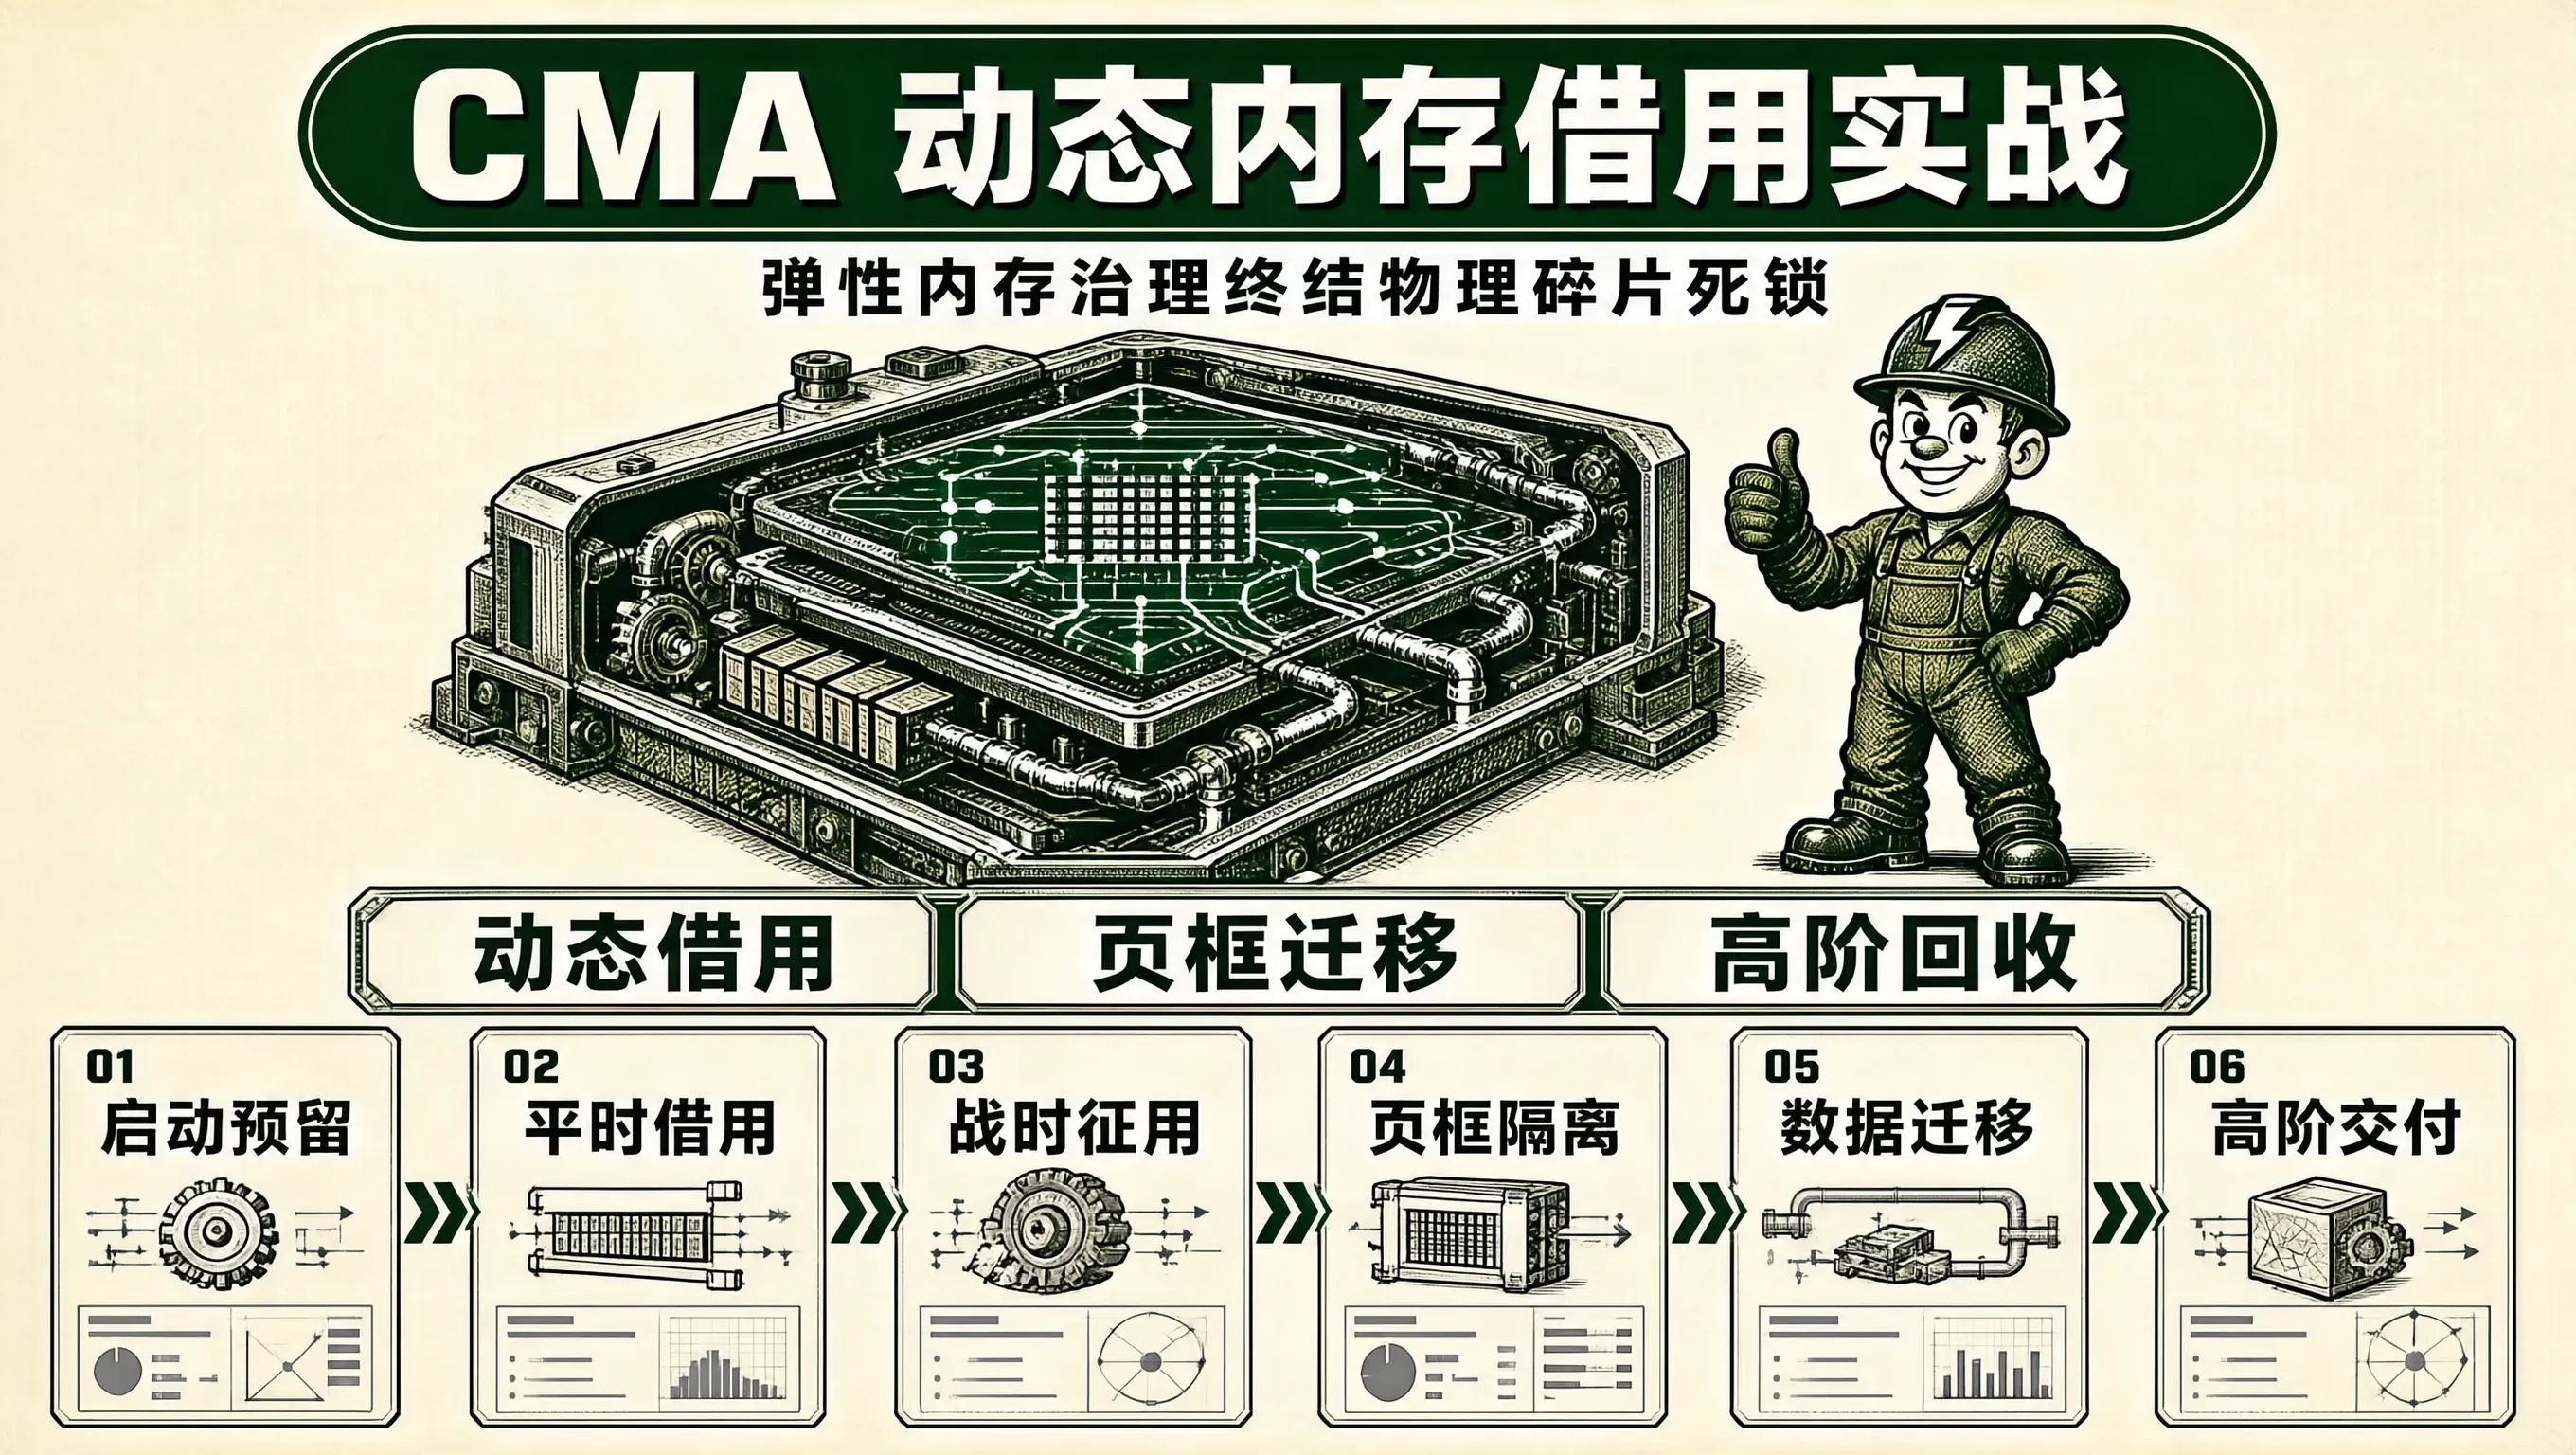
在工业视觉检测装备、高速激光点云雷达以及医疗影像采集系统中,主控板通常需要为高帧率硬件传感器开辟动辄 128MB 至 512MB 的超大尺寸物理连续内存缓冲区。然而,许多专为低功耗设计的嵌入式 SoC 芯片内部并没有配备强大的输入输出内存管理单元(IOMMU),或者为了追求亚微秒级的极低 DMA 传输延迟而必须强制硬件绕过 IOMMU 的两级页表映射。这意味着硬件外设的 DMA 控制器必须直接向物理地址严格连续的内存空间发起直接总线突发传输。
面对这种物理约束,传统的内存规划往往陷入非黑即白的极端两难困境:
- 若在 Bootloader 阶段通过静态保留内存(Reserved Memory)将 256MB 物理内存强行划走,当工业相机处于待机或分时工作模式时,这部分宝贵的物理 RAM 将被永久雪藏,其他关键工控软件和数据库进程会因为可用内存吃紧而频发 OOM(Out of Memory)惨剧;
- 若放弃预留,单纯依赖 Linux 内核标准的伙伴系统(Buddy System)动态申请,系统在多进程高负荷并发运行数天后,物理内存极易被切割为碎片化的单页(4KB)。此时驱动一旦尝试申请 Order > 3(即大于 32KB)的连续物理页框,分配失败率极高。
为破除这一死结,Linux 内核开发了连续内存分配器(Contiguous Memory Allocator, CMA),确立了“平时共享借用,战时迁移归还”的弹性内存治理体系。
一、CMA 核心架构与动态内存借用机制
CMA 的核心设计思想建立在内核“物理页迁移(Page Migration)”与“页类型分组(Migration Types)”的代数拓扑之上。
[系统启动阶段]
CMA 预留池 (如 256MB 连续物理区间)
全量标记为: MIGRATE_CMA
|
+———————————————+
| |
[平时: 驱动未发起 DMA 申请] [战时: 驱动调用 dma_alloc_coherent]
允许系统借给普通应用: 触发 alloc_contig_range():
– 用户空间匿名页 (Anonymous Pages) 1. 锁定并标记 CMA 区域为隔离态 (ISOLATE)
– 文件页缓存 (Page Cache) 2. 脏页紧急刷盘,数据页迁移至普通内存池
– 必须严格为可移动页 (MIGRATE_MOVABLE) 3. 腾空整片连续物理页框交付 DMA 控制器
1. 平时借用法则:可移动页(MIGRATE_MOVABLE)的栖身之地
在系统启动阶段,CMA 子系统将划定的连续物理内存池注册为独立的分配区,并将其内部的所有物理页框(struct page)标记为专属的 MIGRATE_CMA 属性。在工业相机未开启的日常工况下,伙伴系统完全被允许从这片预留池中划走内存,但施加了铁一般的准入限制:只允许分配“可移动页”(Movable Pages),主要包含用户进程的数据堆栈匿名页以及磁盘文件读写缓存(Page Cache)。这些页面的物理存储位置与虚拟地址之间存在解耦映射关系,其物理页框内容随时可以在不破坏应用程序运行状态的前提下被搬迁挪走。
2. 战时征用流程:页框隔离与动态内存迁移
当工业相机启动并调用驱动中的 dma_alloc_coherent() 时,CMA 触发底层的核心函数 alloc_contig_range() 发起强力内存收回风暴:
二、致命的“钉子户”:不可移动页渗透与 -EBUSY 崩溃溯源
在真实的工业驱动长期稳定性压测中,开发者常会目睹系统偶尔报出经典的 -EBUSY(Device or resource busy)错误,导致连续大内存申请宣告失败。深挖其底层机理,这往往是因为 CMA 区域内渗透进了无法被驱逐的“钉子户”。
1. 驱动内存锁死(Page Pinning)
某些第三方数据采集驱动直接调用了 get_user_pages() 强行锁定了用户空间虚拟内存对应的物理页引用计数(page->_refcount 被非法增加)。当内核内存迁移引擎试图搬迁该物理页时,发现引用计数异常,为了防止破坏正在进行的 DMA 或并发访问,迁移流程只能无奈放弃,判定迁移失败。
2. 内核 Slab 内存越界渗透
虽然 Linux 内核调度器做了严格限制,但在某些系统高阶内存极度耗尽的极限瞬间,内核模块申请 kmalloc(不可移动的内核核心对象,如 struct task_struct、网络报文缓冲区 sk_buff)若配置不当,可能意外借道穿透进入 CMA 池。这些内核专用数据结构直接使用物理线性映射地址,MMU 无法对其重定向,导致整块物理连续区间彻底断裂,形成永久性的物理空洞死锁。
三、Linux 内核 CMA 动态分配驱动与监控 C 语言实战
以下内核驱动代码演示了标准的高性能 DMA 连续内存安全申请、映射与释放流程,并展示了如何通过内核接口诊断分配健康状态:
#include <linux/init.h>
#include <linux/module.h>
#include <linux/kernel.h>
#include <linux/device.h>
#include <linux/platform_device.h>
#include <linux/dma-mapping.h>
#include <linux/slab.h>
MODULE_LICENSE("GPL");
MODULE_AUTHOR("23chenchongdai");
MODULE_DESCRIPTION("Industrial CMA Dynamic DMA Allocator");
MODULE_VERSION("1.0");
#define BUFFER_SIZE_MB 128
#define BUFFER_SIZE_BYTES ((size_t)BUFFER_SIZE_MB * 1024 * 1024)
static struct device *cma_dev;
static void *dma_cpu_addr = NULL;
static dma_addr_t dma_handle = 0;
/* 模拟平台设备虚拟结构体 */
static void platform_dev_release(struct device *dev)
{
pr_info("[CMA_DRV] 虚拟平台设备已释放\\n");
}
static struct platform_device dummy_pdev = {
.name = "cma_industrial_cam",
.id = -1,
.dev = {
.release = platform_dev_release,
}
};
static int __init cma_industrial_init(void)
{
int ret;
pr_info("[CMA_DRV] 正在注册工业相机 DMA 测试设备…\\n");
ret = platform_device_register(&dummy_pdev);
if (ret) {
pr_err("[CMA_DRV] 平台设备注册失败: %d\\n", ret);
return ret;
}
cma_dev = &dummy_pdev.dev;
/* 必须显式声明 DMA 寻址位宽掩码 (32 位或 64 位) */
ret = dma_set_mask_and_coherent(cma_dev, DMA_BIT_MASK(32));
if (ret) {
pr_err("[CMA_DRV] 设置 DMA 掩码失败: %d\\n", ret);
platform_device_unregister(&dummy_pdev);
return ret;
}
pr_info("[CMA_DRV] 正在尝试动态申请 %d MB 物理连续内存…\\n", BUFFER_SIZE_MB);
/*
* 核心分配函数: dma_alloc_coherent
* 底层自动路由至 CMA 区域触发动态高阶页回收与数据迁移
* 返回非缓存的 CPU 虚拟地址与硬件直接使用的物理 DMA 地址
*/
dma_cpu_addr = dma_alloc_coherent(cma_dev, BUFFER_SIZE_BYTES, &dma_handle, GFP_KERNEL | __GFP_NOWARN);
if (!dma_cpu_addr) {
pr_err("[CMA_DRV] 致命错误: 连续内存分配失败 (-EBUSY 或物理空间耗尽)!\\n");
pr_err("[CMA_DRV] 请检查 /sys/kernel/debug/cma 观测是否存在不可移动页锁定\\n");
platform_device_unregister(&dummy_pdev);
return -ENOMEM;
}
pr_info("[CMA_DRV] 连续内存分配大获成功!\\n");
pr_info("[CMA_DRV] CPU 访问虚拟首地址: %px\\n", dma_cpu_addr);
pr_info("[CMA_DRV] 硬件 DMA 物理首地址: 0x%llx\\n", (unsigned long long)dma_handle);
/* 模拟硬件 DMA 初始填充: 写入特征测试数据 */
memset(dma_cpu_addr, 0xA5, 4096);
return 0;
}
static void __exit cma_industrial_exit(void)
{
if (dma_cpu_addr) {
pr_info("[CMA_DRV] 正在释放 DMA 连续内存池,将物理页框归还内核…\\n");
/* 释放内存: 区域自动解绑,重新降级为可被普通用户进程借用的状态 */
dma_free_coherent(cma_dev, BUFFER_SIZE_BYTES, dma_cpu_addr, dma_handle);
dma_cpu_addr = NULL;
}
platform_device_unregister(&dummy_pdev);
pr_info("[CMA_DRV] 驱动已完全卸载并恢复系统内存共享池\\n");
}
module_init(cma_industrial_init);
module_exit(cma_industrial_exit);
四、工业工况实测与设备树配置指南
在典型多任务工业网关(配备 1GB 内存,搭载 Linux 6.1 内核)上,分别对比了系统在连续运行 48 小时且高负荷进行文件读写后的三种内存管理方案表现:
| 相机未启动时系统可用内存 | 768 MB (256MB 被死锁) | 1024 MB (全部可用) | 1024 MB (全量可用) |
| 长期运行后 256MB 连续分配成功率 | 100% (但严重浪费) | 4.2% (碎片化严重崩溃) | 99.8% (高成功率保障) |
| 高负荷文件 I/O 吞吐带宽 | 受内存限制下降 35% | 正常 | 保持全速 (缓存利用充分) |
| DMA 内存申请时延 | < 1 $\\mu s$ (无需迁移) | 瞬间失败 | 12 ~ 28 ms (平滑迁移回收) |
| 抗 OOM 崩溃能力 | 脆弱 (极易触发 OOM) | 强 | 极强 (弹性缓冲空间充裕) |
设备树最佳实践配置片段
在设备树(Device Tree)中定义独立的专用 CMA 节点,避免不同外设之间的内存征用冲突:
reserved-memory {
#address-cells = <2>;
#size-cells = <2>;
ranges;
/* 专属工业相机的高优先级 CMA 区域 */
camera_cma_reserved: linux,cma-cam {
compatible = "shared-dma-pool";
reusable;
size = <0x0 0x10000000>; /* 256MB 大小 */
alignment = <0x0 0x02000000>; /* 32MB 严格物理对齐 */
linux,cma-default;
};
};
通过合理运用设备树中的 reusable 属性与 CMA 机制,工业系统在保证严苛硬件物理连续寻址的前提下,实现了全系统内存利用效率的质变飞跃,彻底终结了静态大内存锁死引发的资源贫血顽疾。


评论前必须登录!
注册