 网硕互联帮助中心
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
大模型服务侧信道分析:Token 生成时间与文本长度推断风险
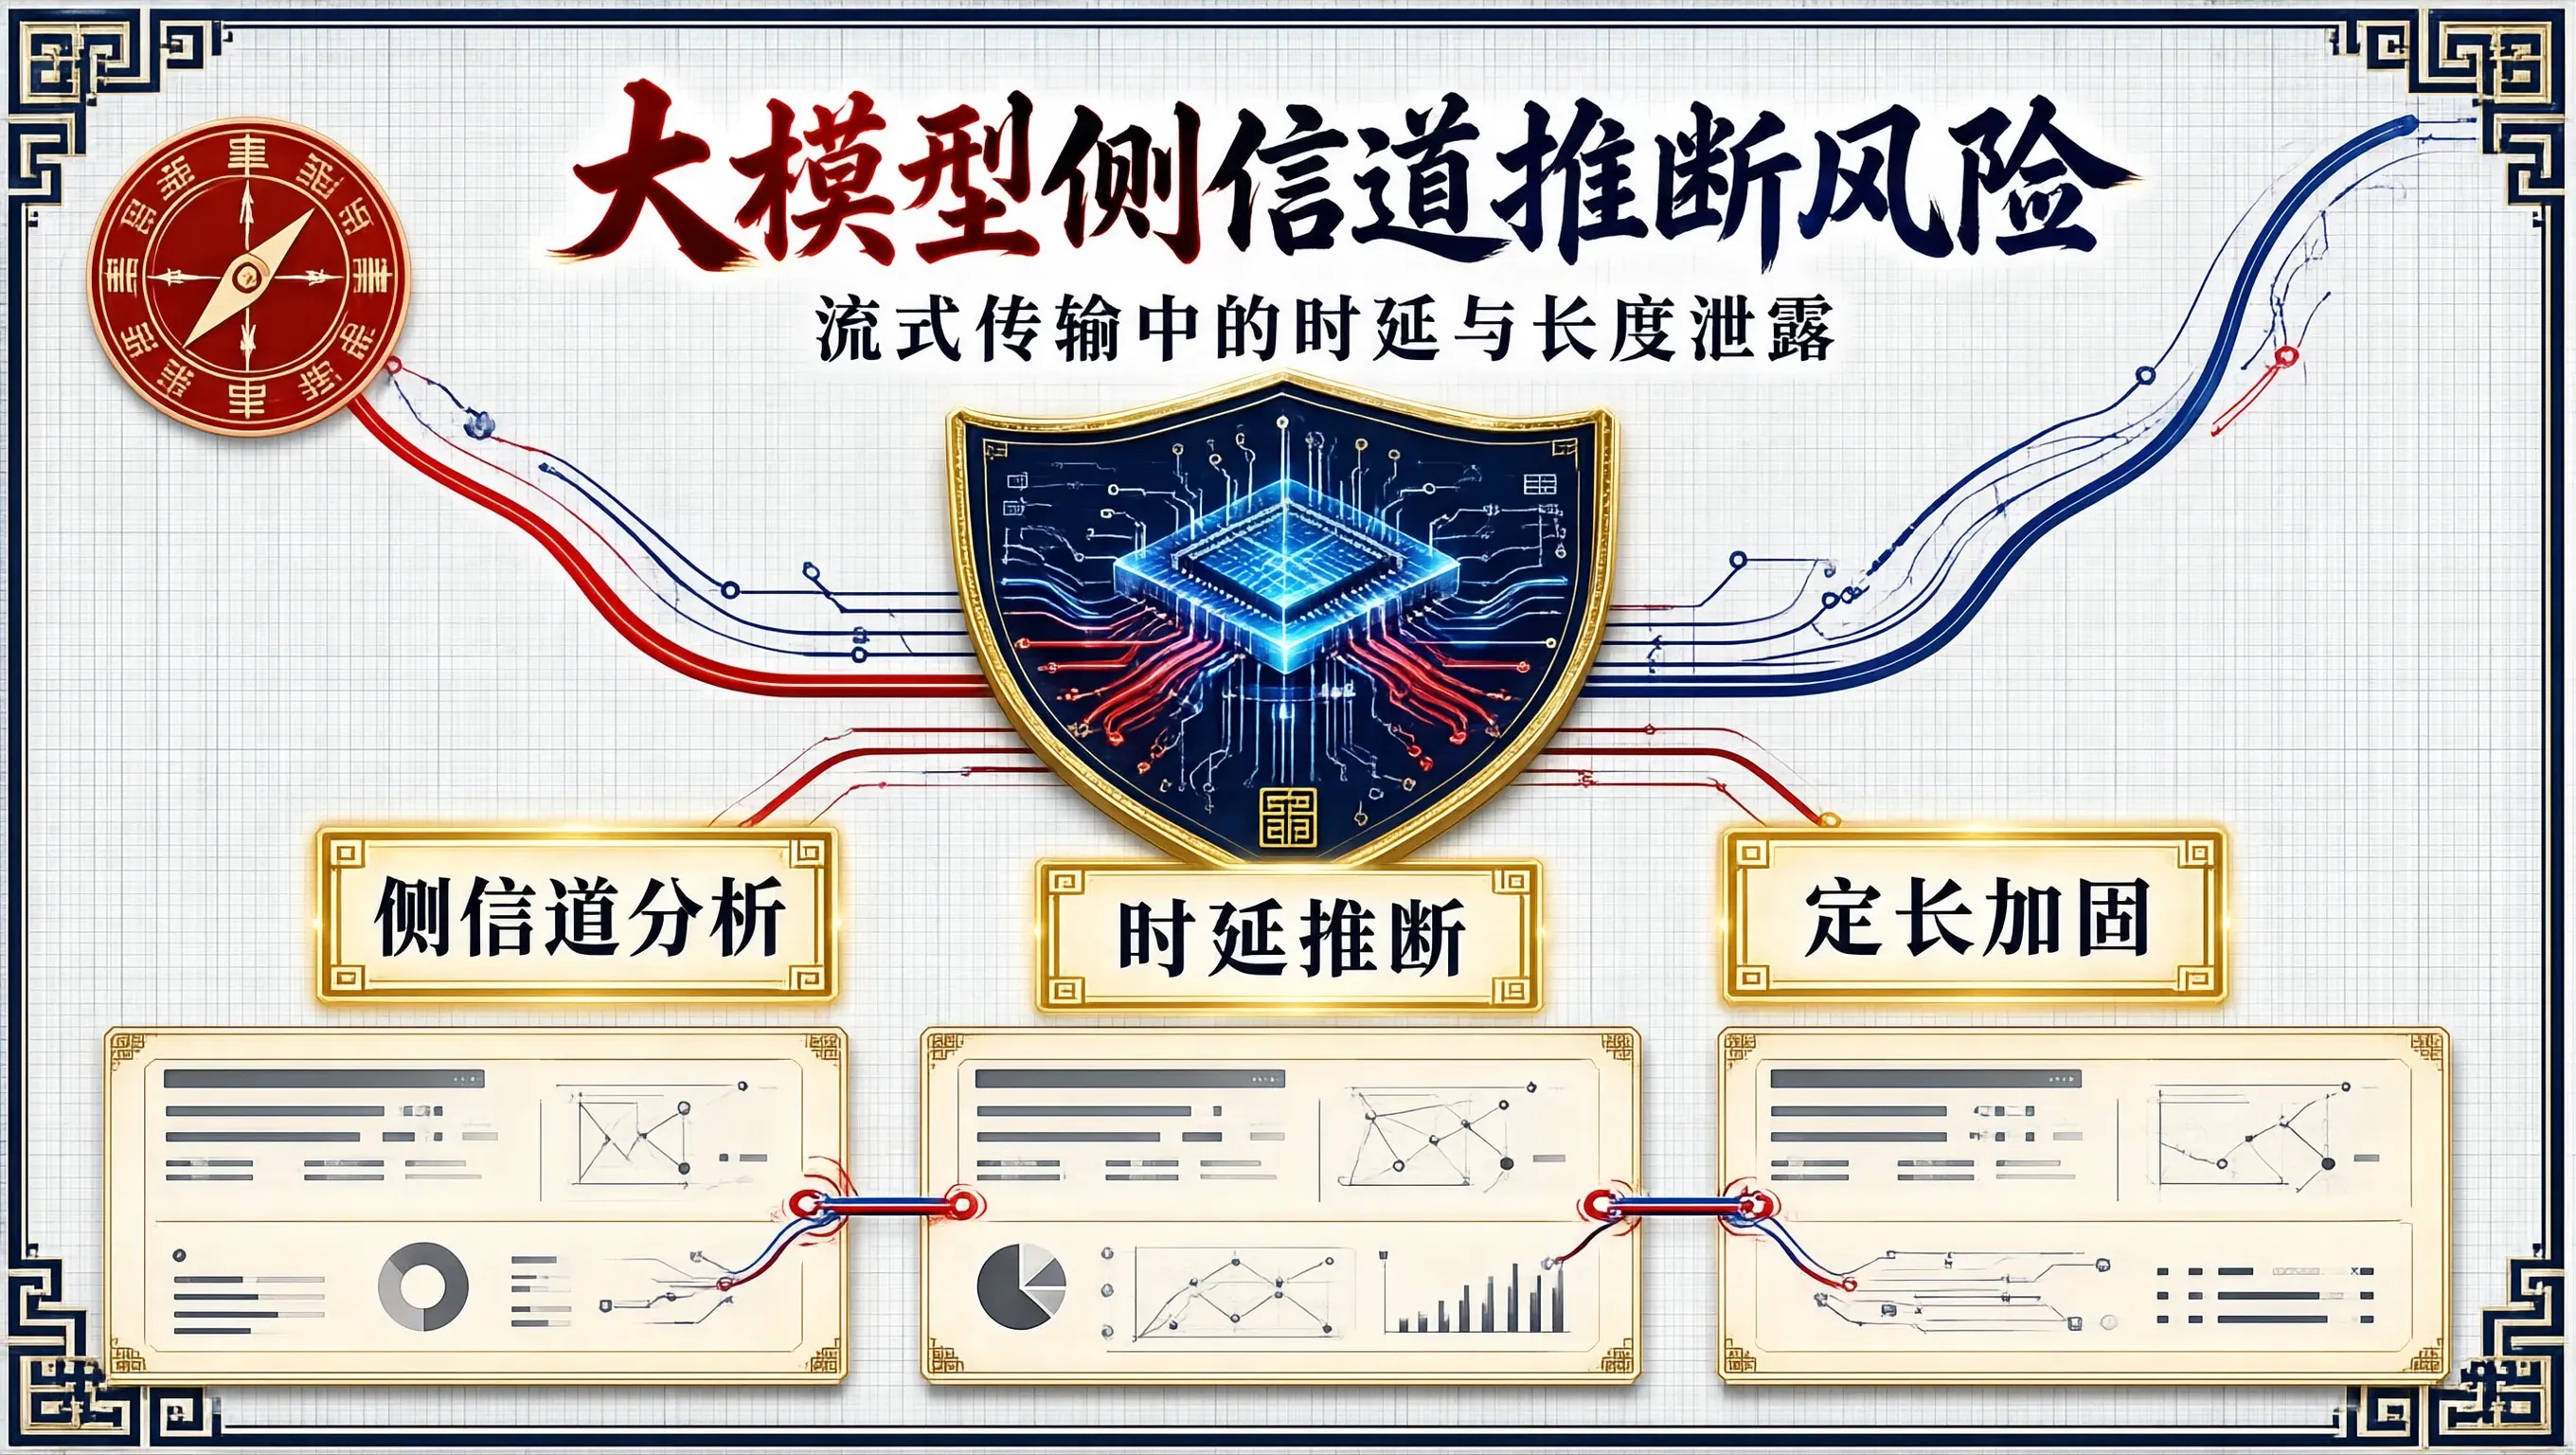
在主流大语言模型(LLM)API 服务中,为了给终端用户带来极致的交互体验,绝大多数供应商都默认开启了流式传输(Server-Sent Events, SSE)。在这种模式下,模型每自回归生成一个 Token,后端网关就会立即封装成一个网络数据包发往客户端。
然而,这种“实时生成、实时吐出”的流式机制在带来流畅体验的同时,也打开了一扇严重的网络侧信道(Side-Channel)风险之门。即使传输层启用了 TLS 加密,攻击者通过分析数据包的到达时间间隔(Inter-Token Latency, ITL)、首字时间(Time To First Token, TTFT)以及密文数据包的长度序列,仍然能够高精度还原用户的输入长度、推测模型输出的主题范畴,甚至在特定场景下重构私密敏感文本。
侧信道泄露机理与物理特征分析
LLM 在底层推理时,受限于计算架构和词表分词机制,其网络流量具备高度规律的统计学指纹:
客户端请求 (Encrypted TLS)
——————————————> LLM 推理网关
Prefill 阶段计算 (时间 = T_prefill)
<—————————————— 首包返回 (TTFT 泄露 Prompt 长度)
<– 数据包 1 (Len: 128B) [间隔: 35ms] —— Token 1 生成
<– 数据包 2 (Len: 132B) [间隔: 42ms] —— Token 2 生成
<– 数据包 3 (Len: 128B) [间隔: 31ms] —— Token 3 生成
侧信道特征采集与长度推断实验
在受控局域网或具备端口镜像权限的网络节点上,攻击者无需解密 TLS 流量,仅通过抓取 TCP 流的时间戳与报文尺寸序列,即可建立特征向量。
以下是一个用于解析并量化大模型流式传输侧信道特征的 Python 分析脚本:
import time
import math
from typing import List, Tuple, Dict
class StreamSideChannelAnalyzer:
def __init__(self):
# 记录捕获的数据包时间戳与负载大小 (timestamp, payload_len)
self.packet_stream: List[Tuple[float, int]] = []
def record_packet(self, payload_length: int):
"""模拟网络层捕获到一个包含 SSE Token 的 TLS 数据包"""
self.packet_stream.append((time.perf_counter(), payload_length))
def extract_features(self, request_send_time: float) -> Dict[str, float]:
"""提取首包延迟、平均 Token 间隔与长度波动特征"""
if not self.packet_stream:
return {}
first_packet_time, first_len = self.packet_stream[0]
ttft = (first_packet_time – request_send_time) * 1000.0 # 毫秒
inter_token_latencies = []
payload_lengths = [p[1] for p in self.packet_stream]
for i in range(1, len(self.packet_stream)):
delta_t = (self.packet_stream[i][0] – self.packet_stream[i – 1][0]) * 1000.0
inter_token_latencies.append(delta_t)
avg_itl = sum(inter_token_latencies) / len(inter_token_latencies) if inter_token_latencies else 0.0
# 计算 ITL 标准差
variance = sum((x – avg_itl) ** 2 for x in inter_token_latencies) / len(inter_token_latencies) if inter_token_latencies else 0.0
std_itl = math.sqrt(variance)
total_tokens_estimated = len(self.packet_stream)
return {
"estimated_tokens": total_tokens_estimated,
"ttft_ms": round(ttft, 2),
"avg_itl_ms": round(avg_itl, 2),
"std_itl_ms": round(std_itl, 2),
"total_bytes": sum(payload_lengths)
}
def infer_prompt_and_response_profile(self, features: Dict[str, float]) -> str:
"""基于时延特征推断输入与输出的规模画像"""
ttft = features.get("ttft_ms", 0.0)
tokens = features.get("estimated_tokens", 0)
# 经验阈值模型(需针对具体模型算力基准校准)
prompt_scale = "SHORT (1-100 Tokens)"
if ttft > 800:
prompt_scale = "VERY LONG (> 2000 Tokens / 大文档问答)"
elif ttft > 350:
prompt_scale = "MEDIUM (300-1000 Tokens)"
response_scale = f"输出规模约 {tokens} 个 Token"
return f"[侧信道推断结论] 输入负载: {prompt_scale}, 输出负载: {response_scale}"
# 验证测试
if __name__ == "__main__":
analyzer = StreamSideChannelAnalyzer()
# 模拟客户端在 t0 发送提示词请求
req_time = time.perf_counter()
# 模拟 GPU 预填充耗时 420ms
time.sleep(0.42)
# 模拟流式吐出 8 个 Token,包长微弱变动(120~135 字节)
mock_payload_sizes = [124, 128, 132, 124, 120, 136, 128, 120]
for size in mock_payload_sizes:
analyzer.record_packet(size)
time.sleep(0.04) # 单个 Token 约 40ms 生成时延
features = analyzer.extract_features(req_time)
print("[*] 捕获的网络侧信道统计特征:")
for k, v in features.items():
print(f" – {k}: {v}")
inference = analyzer.infer_prompt_and_response_profile(features)
print(f"\\n{inference}")
服务端与网络网关防护加固方案
要抹除或大幅削弱此类侧信道信息泄露,不能指望单纯依靠传输层 TLS 加密,必须在大模型推理网关与传输调度层引入针对性的“时延噪声与报文混淆”:
1. 定长 Padding 与块对齐(Fixed-Size Padding)
在网关向客户端发送 SSE 数据包时,禁止直接按照原始 JSON 字符串长度下发,而是对每个数据包填充无意义的空白字符或扩展字段,将其强制对齐到固定块大小(例如统一填充为 512 字节或 1024 字节),彻底破坏密文长度与明文 Token 长度的对应关系。
def pad_sse_chunk(raw_data: str, target_block_size: int = 512) -> str:
"""对 SSE 数据块进行定长填充,消除报文长度指纹"""
padding_needed = target_block_size – len(raw_data.encode('utf-8'))
if padding_needed > 0:
# 使用 SSE 协议允许的注释行或字段填充
padded_content = raw_data + f"\\n:pad={'x' * (padding_needed – 7)}\\n\\n"
return padded_content
return raw_data + "\\n\\n"
2. 微批次汇聚与自适应抖动(Micro-Batching & Jittering)
取消单 Token 即刻推送机制,改为“N 个 Token 聚合发送”或基于随机时间窗口(如 50~120ms)批量打包推送。网关在下发数据流时,主动引入高斯分布随机抖动(Jitter),打乱 ITL 的时间规律。
[GPU 推理引擎] —> (逐字产出 Token)
|
v
[防护网关缓冲队列] —> (微批次聚合 + 定长 512B 填充 + 随机时延抖动)
|
v
[加密 TLS 网络流] —> (外部观察者只能看到固定尺寸与均匀间隔的数据流)
对于涉及高度敏感业务(如医疗问诊、法律咨询、内部金融决策)的私有化大模型网关,安全团队必须将流式传输的侧信道指纹纳入威胁模型。通过实施定长数据包对齐与批量抖动调度,可以在保障用户交互流畅度的同时,将网络嗅探与长度推断的风险降至最低。


评论前必须登录!
注册