 网硕互联帮助中心
论文题目: Category knowledge-guided few-shot bearing fault diagnosis(类别知识引导的少样本轴承故障诊断)
期刊: Engineering Applications of Artificial Intelligence,2025
摘要: 实时轴承故障诊断对于保障复杂工业系统的安全性与可靠性至关重要。然而,故障样本采集困难、标注成本高造成的标签数据稀缺,使得模型难以从有限且复杂的监测信号中学习具有判别性的故障特征。少样本学习(Few-Shot Learning,FSL)为严重故障信号的特征提取和准确分类提供了有效方法,但数据稀缺和环境噪声等问题仍严重制约现有 FSL 方法对初期故障的有效诊断。这主要是因为现有 FSL 策略未充分考虑噪声环境中的类别间相关性,限制了模型将已知类别的特征知识推广至新类别的能力。因此,迫切需要一种能够利用类别间相关性、克服数据不足和环境复杂性,并支持少样本初期故障诊断的方法。本文提出一种面向少样本多任务场景的新型类别知识引导模型。该模型利用基础类别的属性数据及新类别样本之间的相似性,高效建立面向未见任务的映射关系,显著增强初期故障诊断及多任务应用中的泛化能力,使模型能够在未知工况下快速、准确地完成少样本故障诊断。在凯斯西储大学(CWRU)轴承数据集和早期轻微故障牵引电机轴承(EMF-TM)数据集上的对比实验表明,该模型优于所比较的先进少样本学习与迁移学习方法。
一、研究背景与核心问题
早期故障比严重故障更难诊断。 严重故障通常有明显冲击,初期损伤却常被载荷变化与背景噪声掩盖。工业现场也难以为每种未知故障收集大量标签:模型既要学会识别弱信号,又要适应新类别。
度量型 FSL 比较支持集与查询集的特征,却可能受到任务无关信息干扰;少量支持样本也不足以刻画一个类别。迁移学习在故障类别或运行工况变化时容易退化。作者的关键洞察是:新故障虽然样本少,但不同故障仍具有可借鉴的共享模式与特有结构。
作者据此提出 Category Knowledge-Guided(CKG):前端学习任务相关特征,后端通过**类别知识引导的不完整多核聚类(CKG-IMK)**组织跨类别关系,使新任务不仅依赖孤立的两两样本相似度。
二、CKG 整体框架:特征学习与类别知识协同工作
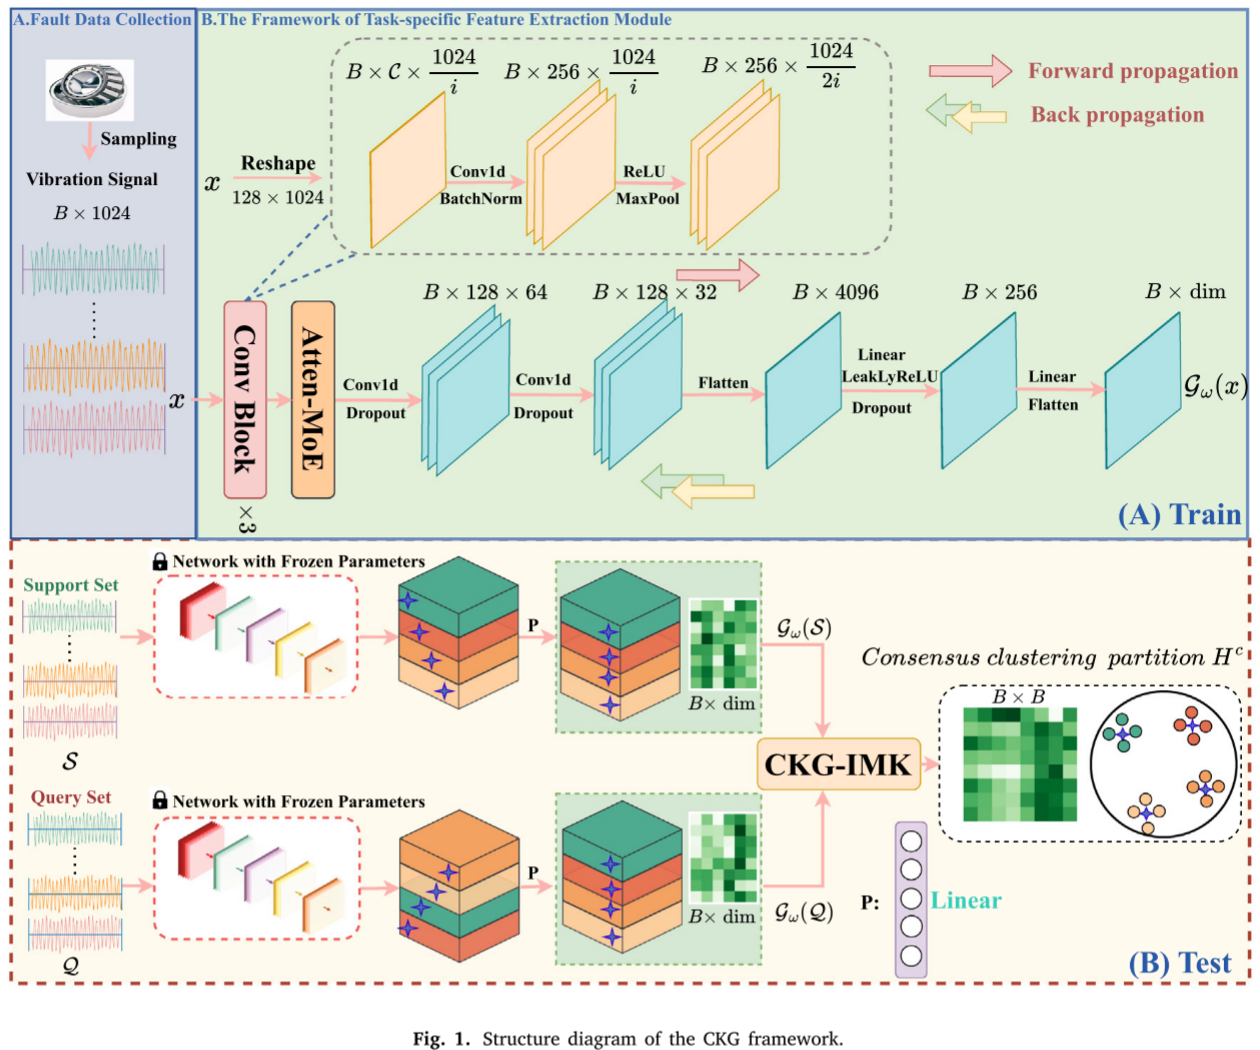
论文 Figure 1:CKG 训练与测试整体结构
Figure 1 上半部训练特征提取器,下半部执行少样本推断。长度为 1024 的振动序列经标准化、卷积、Atten-MoE、一维卷积和全连接层形成嵌入;测试时支持集与查询集共享冻结的编码器,经 CKG-IMK 形成共识聚类后进行分类。
一条核心数据流可以概括为:
振动序列 → Conv Block → Atten-MoE → Conv1D / FC → Support–Query 特征 → CKG-IMK → 类别判断
N-way K-shot 表示 N 类、每类 K 个标注支持样本。元训练与元测试的类别不重叠,考察对未知故障的适应能力;本文使用 1-shot、3-shot、5-shot。
预处理将原信号随机分段,每类取 500 个样本,并使用全局 z-score 标准化。未采用数据增强,以避免相邻片段冗余。输入是一维振动序列,不是时频图。
三、Atten-MoE:怎样找到与新任务有关的特征?
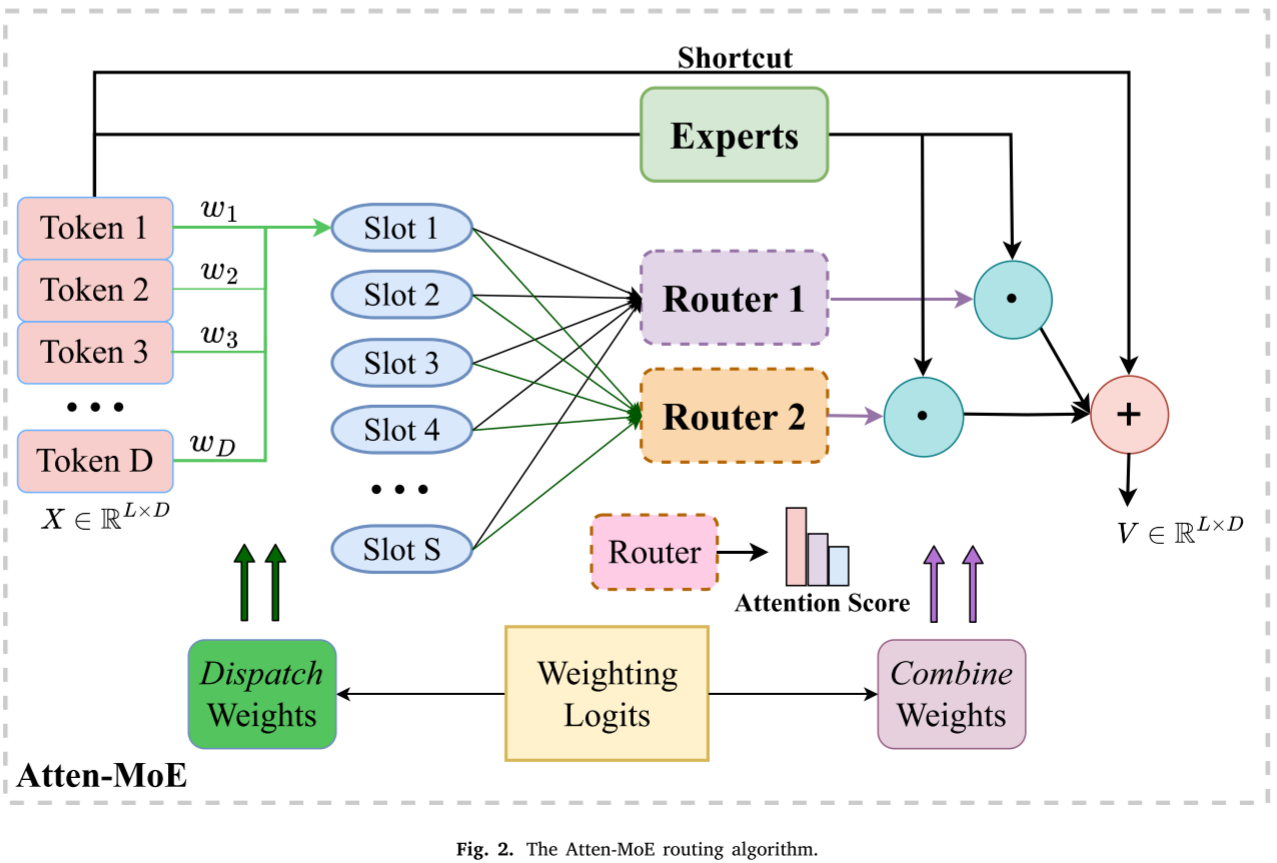
论文 Figure 2:Atten-MoE 的 Slot、Router、Experts 与融合路径
不同故障与工况对特征的需求不同。本文引入 Attention Mixture of Experts(Atten-MoE),让轻量级专家分别建模局部模式,由注意力路由决定各专家贡献,从而减少对任务无关特征的依赖。
输入序列映射为 Slot,Router 产生注意力分数,专家产生特征响应,最后归一化融合。论文式(8)为:
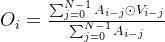
其中 $A$ 是路由权重,$V$ 是专家特征,$N$ 是专家数量,$\\odot$ 为逐元素乘法。直观地看:让专家分工,再按输入动态选择重要响应。 作者还加入局部均衡约束,缓解专家偏向训练任务的问题。
编码器还包含 1 × 1 卷积、BatchNorm、ReLU、MaxPool、后续 Conv1D、全连接层,以及概率 0.5 的 Dropout。Atten-MoE 负责学习任务相关表示,CKG-IMK 负责跨类别匹配,两者分工不同。
四、CKG-IMK:从单一相似度走向跨类别一致性聚类
4.1 为什么引入多个核?
单一特征距离难以刻画多种故障间的非线性和共享关系。作者借鉴 Multiple Kernel k-Means(MKKM),对多个基础核自适应加权,使不同视角的类别联系互补。
论文式(15)将支持样本  与查询样本
 的多核相似度表示为:
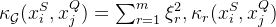
m 为核数量, 为第 r 个核函数,
 为学习权重。通过数据确定哪些相似度更有价值,而非固定单一度量。
4.2 一致性聚类矩阵如何传递类别知识?
少样本任务只观察到部分类别与核关系,单核聚类容易不稳定。CKG-IMK 为多个基础核学习共同的 Consensus Clustering Matrix( ),使不同核的结果相互校准。式(12)可简写为:
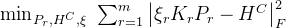
 表示基础核矩阵,
 为正交约束下的对齐映射,
 为 Frobenius 范数。进一步的式(16)—(17)引入聚类中心一致性,联合支持集、查询集与共识聚类;算法交替优化核权重、映射及聚类中心。
基础类别间的结构成为新任务的先验,未知样本由多视角共识分类。 “不完整”指少样本任务中只能部分观察到的类别/核关系,而非直接填补缺失的振动数据。理解重点是“多核互补—共识对齐—类别聚合”。
五、实验结果:少样本、早期微弱故障、噪声与效率
5.1 两个数据集与实验设置
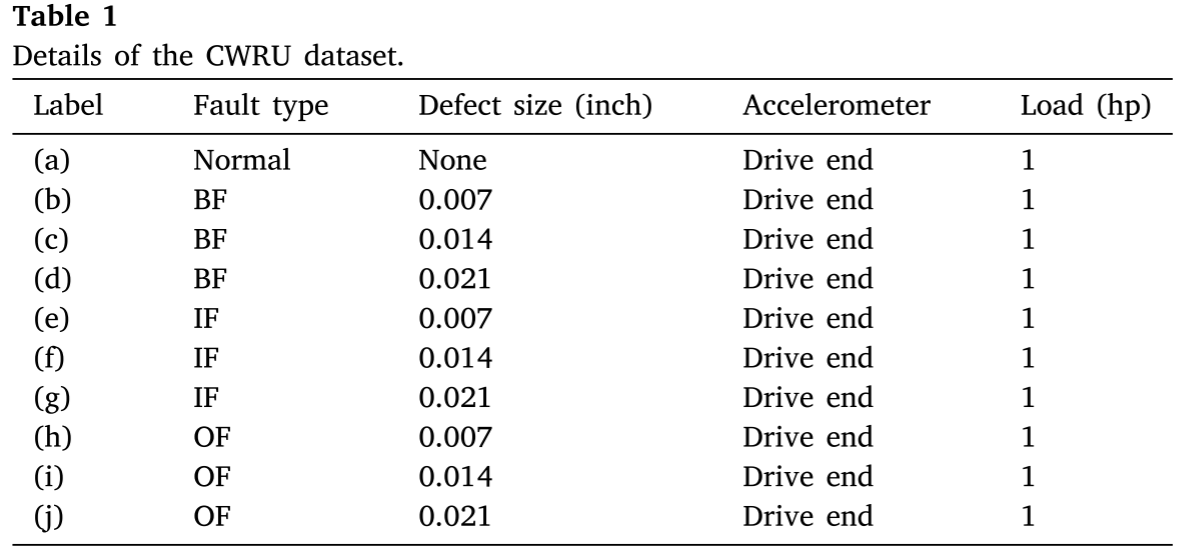
论文 Table 1:CWRU 故障类型、尺寸及采集条件
CWRU 包含健康状态及滚动体(BF)、内圈(IF)、外圈(OF)故障,尺寸为 0.007/0.014/0.021 英寸。作者以未知类别构造含健康状态的 4-way 元测试任务。
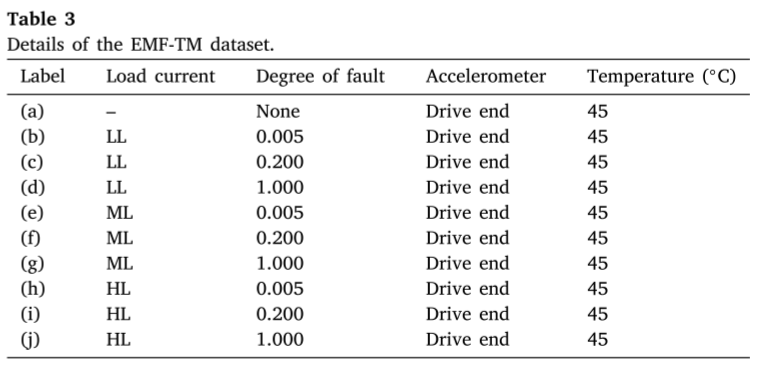
论文 Table 3:EMF-TM 的载荷、故障程度与标签设置
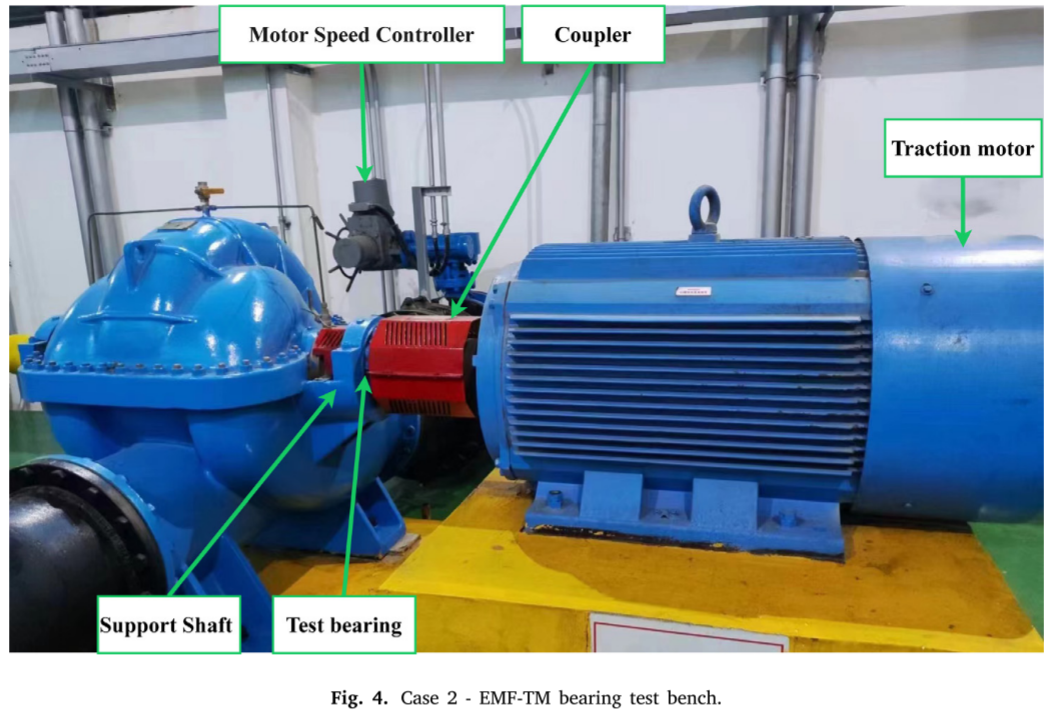
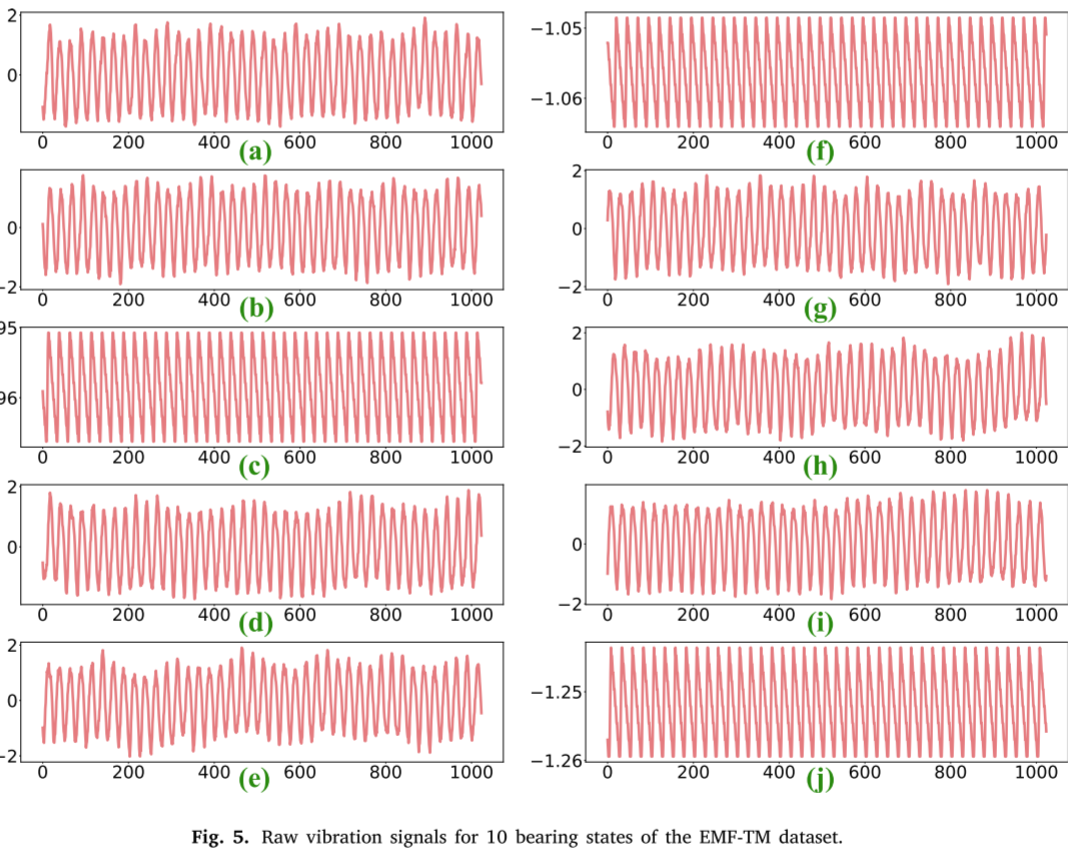
论文 Figure 4–5:EMF-TM 试验平台与十种轴承状态的振动波形
EMF-TM 包含健康状态,以及轻载(LL,0.2 A)、中载(ML,0.5 A)、重载(HL,0.8 A)下三档损伤 0.005/0.200/1.000,共 10 类,采样率 2.4 kHz。其中 0.005 是重点考察的早期微弱故障。
训练采用 Adam、学习率 1e-4、100 次迭代、Batch Size 128,GPU 为 GTX 3090;与 KNN、DPDAN、CNN-MMD、MANN、UCPMnet、MAML、ProtoNet、MD-SN、RelationNet 等九种方法比较。
5.2 CWRU:未知故障类别能否可靠识别?
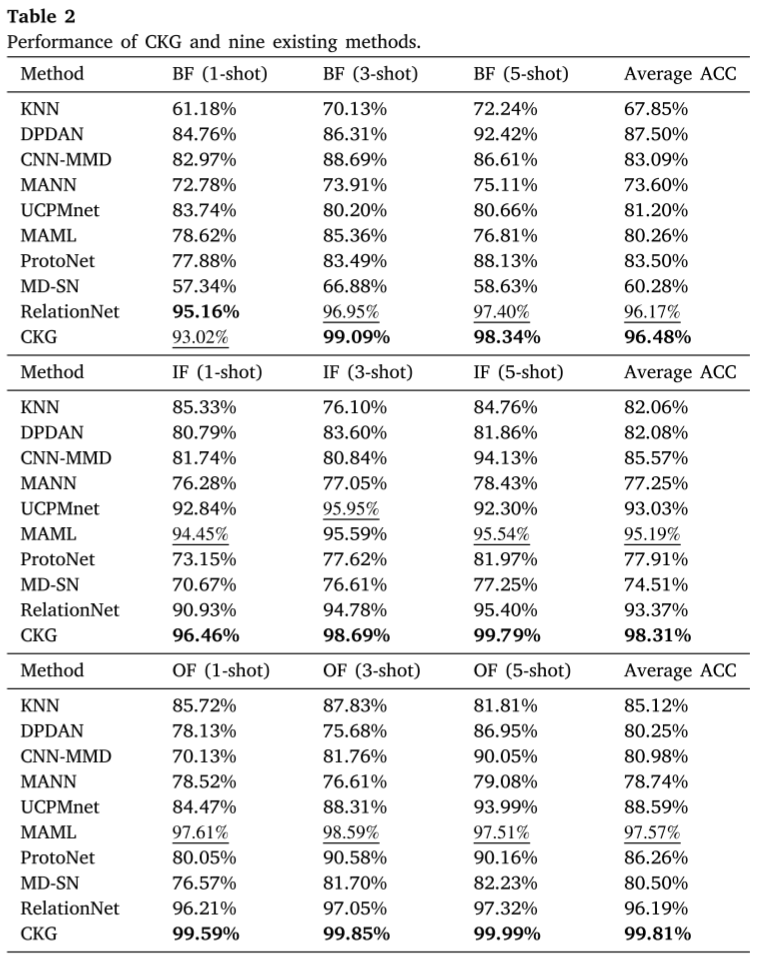
论文 Table 2:CWRU 上 BF、IF、OF 三组 4-way 少样本对比
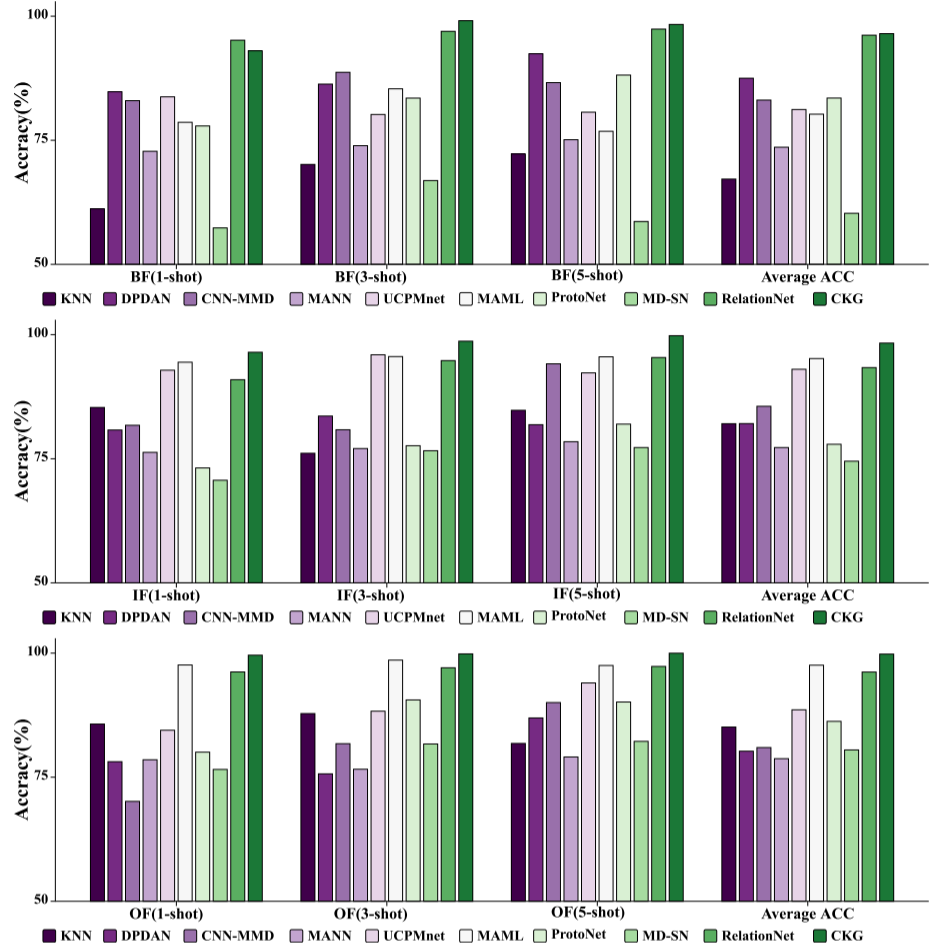
论文 Figure 3:CWRU 在 1-shot/3-shot/5-shot 下的诊断表现
CWRU 的滚动体 BF 任务中,CKG 的 1-shot Accuracy 为 93.02%,低于 RelationNet 的 95.16%;但 3-shot 达 99.09%,超过 RelationNet 的 96.95%。内圈 IF 的 5-shot 为 99.79%;外圈 OF 的 1-shot/5-shot 为 99.59%/99.99%。总体优势明显,但并非全部场景第一。
5.3 EMF-TM:能否分辨更接近健康状态的早期故障?
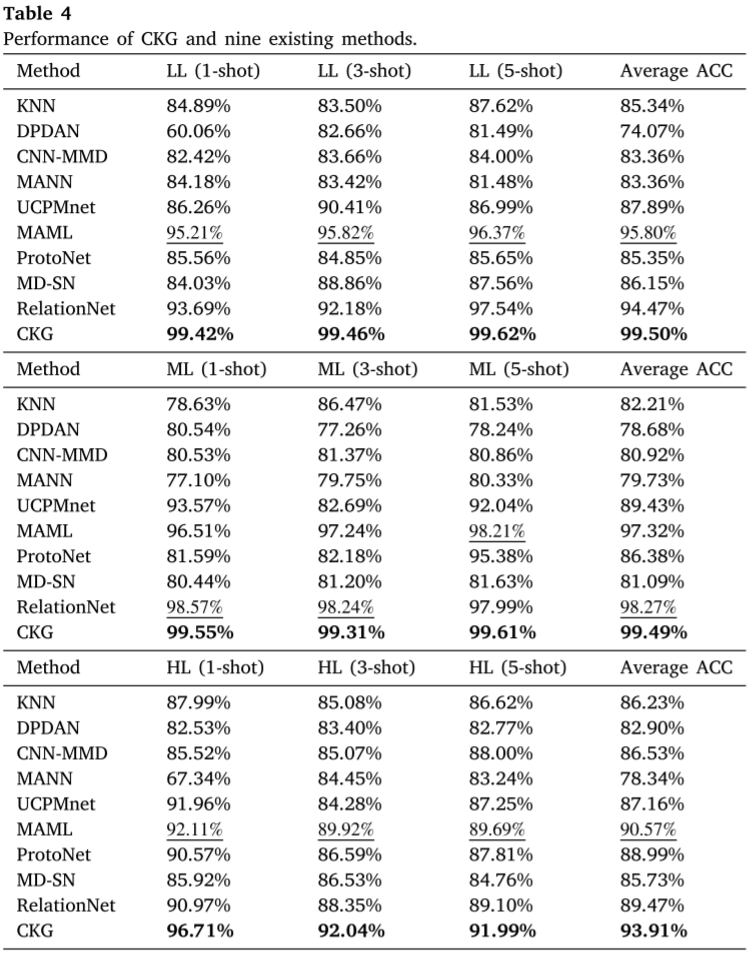
论文 Table 4:EMF-TM 三种载荷下与九种方法的少样本对比

论文 Figure 6:轻载、中载、重载下的 1-shot/3-shot/5-shot 结果
EMF-TM 上,CKG 的轻载、中载、重载平均 Accuracy 分别为 99.50%、99.49%、93.91%;相应较强对照 MAML、RelationNet、MAML 的平均值分别为 95.80%、98.27%、90.57%。高载荷任务更困难,但 CKG 仍占优。需要注意:重载 1-shot 为 96.71%,5-shot 为 91.99%,Shot 增加不保证准确率单调提升。
5.4 噪声鲁棒性:强干扰下的表现是否稳定?

论文 Table 5:EMF-TM 在 −4 至 10 dB 信噪比条件下的比较
在 −4 dB 时,CKG 轻/中/重载 1-shot Accuracy 分别达 99.37%/99.18%/94.59%,整体抗噪表现较强。但重载 −2 dB 下,MD-SN 为 97.03%,高于 CKG 的 96.34%,因此不能称其所有条件均最优。
5.5 计算效率与模块对比

论文 Table 6:十种方法每秒处理样本量的效率比较
CKG 约处理 1,030,634 样本/秒,仅次于 CNN-MMD 的约 1,088,193 样本/秒,而前者诊断准确率更高。该吞吐量不等于现场报警端到端时延。

论文 Table 8:Dense-MoE、Soft-MoE 与 Atten-MoE 的准确率、速度和内存对比
Table 8 比较三种 MoE:Atten-MoE 轻/中/重载 1-shot 为 99.42%/99.55%/96.71%,均优于 Dense-MoE 与 Soft-MoE;内存为 10.22 M,也是三者最低。速度为 1.03 M samples/s,快于 Dense-MoE(0.83),慢于 Soft-MoE(1.09)。优势是精度与资源的平衡,并非速度最快。此表只比较 MoE 类型,不能当成去掉 CKG-IMK 的完整消融。
5.6 稳定性、特征可视化与现场案例

论文 Table 7:十次独立实验的 Accuracy、Precision、Recall、F1

论文 Figure 7:最差与最佳试验的混淆矩阵
4-way 1-shot 下,十次重复试验平均 Accuracy 98.62%、平均 F1 98.34%,最低 Accuracy 95.81%。Figure 7 显示最好与最差试验仍有分类波动;这证明重复试验的稳定性,不等于长期工业可靠性。

论文 Figure 8:多种方法的 t-SNE 特征分布比较
Figure 8 中,CKG 在健康状态与三档重载故障间形成更紧凑、分界更清楚的特征簇。t-SNE 仅提供定性佐证,仍须结合分类指标。

论文 Figure 9:类别知识引导故障诊断的工程执行流程

论文 Figure 10:风机齿轮箱轴承故障诊断案例平台
作者展示了数据采集、分类、更新类别知识库的流程和风机齿轮箱现场案例。不过,文中没有足够的长期部署精度或报警时延数据,案例照片不能代替量化验证。
六、总结与思考
CKG 的关键是:先借助 Atten-MoE 获得任务相关特征,再由 CKG-IMK 将多核与多类别知识汇聚为一致聚类结构。 这比只匹配少数支持样本更适合微弱故障与未知类别的共同挑战。
证据链涵盖 CWRU 未见类别、EMF-TM 早期故障、噪声、吞吐量、MoE 对比、重复试验以及 t-SNE 和现场平台。优势显著但有边界:个别 1-shot/噪声设置并非第一,Atten-MoE 也不是最快。
作者明确指出,超参数选择复杂会影响不同采样率、转速下的泛化,未来计划自适应选参。进一步复现还应补充独立的 CKG-IMK 消融、跨转速评估与真实报警时延,分别量化多核聚类与专家特征提取的作用。


评论前必须登录!
注册