 网硕互联帮助中心
真实项目里 Redis 用起来很慢,或者 Redis 与 MySQL 的数据不一样,应该怎么排查?
BigKey 为什么危险、HotKey 为什么会压垮单个节点,以及 Cache Aside 双写为什么不能天然保证一致性。
1. BigKey 到底是什么?
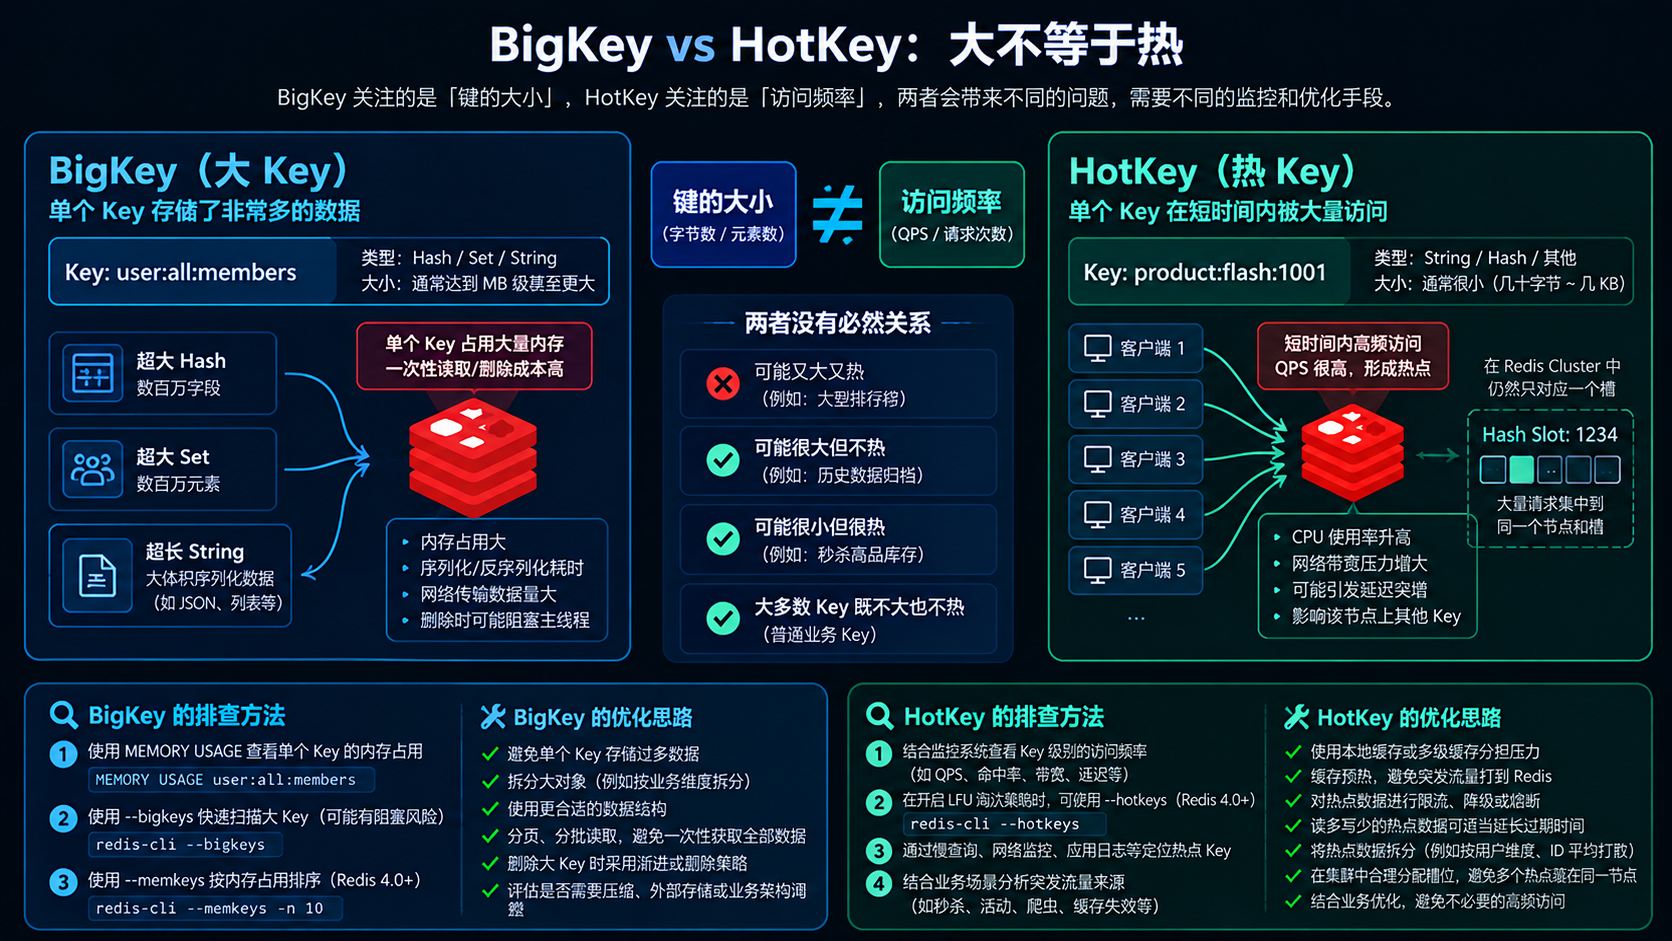
BigKey(大 Key) 指某个 Key 对应的 Value 特别大,或者集合里包含特别多元素。
例如一个 String 保存数 MB 的 JSON、一份 Hash 保存几十万个 Field、一份 Set 保存海量用户 ID。
注意,Key 的名称很长不是 BigKey 的主要含义,重点是单个 Key 背后的数据规模。
此外,Redis 没有一个对所有业务都适用的统一阈值,究竟多大算危险,要根据数据类型、单次操作量、网络条件、实例资源和延迟目标来判断。
2. 大 Key 为什么可能拖慢 Redis?
大 Key 危险不只是占内存。一次 GET 巨型 String 或 HGETALL 巨型 Hash,可能产生大量序列化和网络传输;HGETALL、SMEMBERS 这种取整个集合的命令,其开销与数据规模相关。
对大型复杂对象直接使用 DEL,可能涉及大量内存释放工作,阻塞命令处理。
大 Key 还会增加 RDB、AOF、复制、迁移以及写时复制期间的资源开销。
Redis 的这类延迟不应直接归结为 Java GC,因为 Redis Server 自身并不是一个运行在 JVM 中的程序。
3. 怎样发现大 Key?
可以先在授权的测试环境或低峰期使用:
redis-cli –bigkeys
redis-cli –memkeys
–bigkeys 主要按数据类型寻找较大的 Key,–memkeys 更关注内存占用。
两者通常需要扫描大量 Key,生产上应评估时间、负载和权限,不要认为使用 SCAN 就完全没有开销。
如果已经知道怀疑对象,可以进一步查看:
TYPE user:all:members
MEMORY USAGE user:all:members
HLEN user:all:members
SCARD article:likes
STRLEN article:blob
HLEN、SCARD、STRLEN 分别适用于不同类型,不能对所有 Key 随便套用。
MEMORY USAGE 返回的是 Redis 对该 Key 及 Value 的内存占用估计,包含相关结构开销;对于聚合类型,它可能使用抽样估算。
4. 大 Key 怎么优化?
常见方法是拆分、分页、限制增长和避免整对象操作。
例如不要把所有用户的信息塞进 user:all,可以按业务 ID 拆成 user:1001 等 Key。
列表、Hash 和集合可按批读取,使用 HSCAN、SSCAN、ZSCAN 等增量迭代方式处理大集合,而不是每次 HGETALL 全部取回。
对于需要删除的大集合,可以考虑:
UNLINK user:all:members
UNLINK 先把 Key 从键空间移除,再由后台线程处理内存释放,通常比直接 DEL 大对象更有利于降低主线程阻塞。
它不意味着内存一定会在命令返回的瞬间释放完毕,也不是允许无限创建大 Key 的理由。
5. HotKey 又是什么?
HotKey(热 Key) 是短时间内被非常频繁访问的 Key。它可能只有几十字节,例如:
product:flash:1001
当秒杀活动期间大量用户都查询它时,即使单次 GET 很快,也可能让对应 Redis 节点的 CPU、网络带宽或连接处理成为瓶颈。
在 Redis Cluster 中,一个 Key 只会映射到一个哈希槽,由某个分片负责,所以增加其他 Master 不会自动分摊这个 Key 的写入流量。
6. BigKey 和 HotKey 有什么本质区别?
| 核心指标 | Value 大小、元素数量 | 访问频率、单 Key QPS |
| 典型问题 | 内存、传输、遍历、删除耗时 | 单节点 CPU / 带宽 / 请求集中 |
| 主要办法 | 拆分、分页、避免全量操作、UNLINK | 本地缓存、合并请求、预热、限流、合理分流 |
因此,大不一定热,热也不一定大;一个 Key 同时又大又热时,风险会叠加。
7. 热 Key 如何定位?
优先使用业务指标:给缓存访问记录 Key 模式、请求量、命中率和 P95/P99 耗时;在 Redis Cluster 中结合具体分片的 CPU、入出流量、命令统计排查。
某些配置下可以尝试:
redis-cli –hotkeys
这个模式依赖 Redis 的 LFU 访问频率统计,通常需要启用合适的 maxmemory-policy,例如 allkeys-lfu,不是任意 Redis 实例都能直接得到准确热 Key 排名。
生产环境不建议长时间使用 MONITOR 全量观察所有命令,因为其本身会造成额外开销,还可能暴露敏感参数。
更稳妥的是应用侧采样、代理统计和针对性诊断。
8. 热 Key 怎样解决?
如果是读多写少的数据,可以在应用节点使用 Caffeine 等本地缓存,降低 Redis 往返和单 Key 压力;必要时配合 Redis 的客户端缓存失效通知机制。
关键是设置合理 TTL,并处理各实例间的失效一致性。
如果热点突然出现,可以通过缓存预热、请求合并(Singleflight)、限流和降级缓解;有条件的部署可以分散读请求到副本,但需要接受复制延迟。
对于读写极频繁的 Key,不能想当然通过随机后缀复制几份就解决:这可能破坏计数器、库存、排行榜的正确性。
读缓存副本和可拆分的业务数据可以有策略地分散,不能把同一份可变状态随意复制成多份独立真相。
9. MySQL 和 Redis 为什么会不一致?
假设商品名称在 MySQL 里是“旧名称”,Redis 也缓存了旧名称。用户修改商品后,需要同时让 MySQL 和 Redis 表达新状态。
但 MySQL 事务和 Redis DEL 不属于同一个原子事务,因此可能出现数据库已提交、缓存尚未清理,或者并发查询把旧数据重新写回 Redis。
没有跨系统原子提交,就不能说双写天然强一致。
10. 为什么通常先更新数据库,再删除缓存?
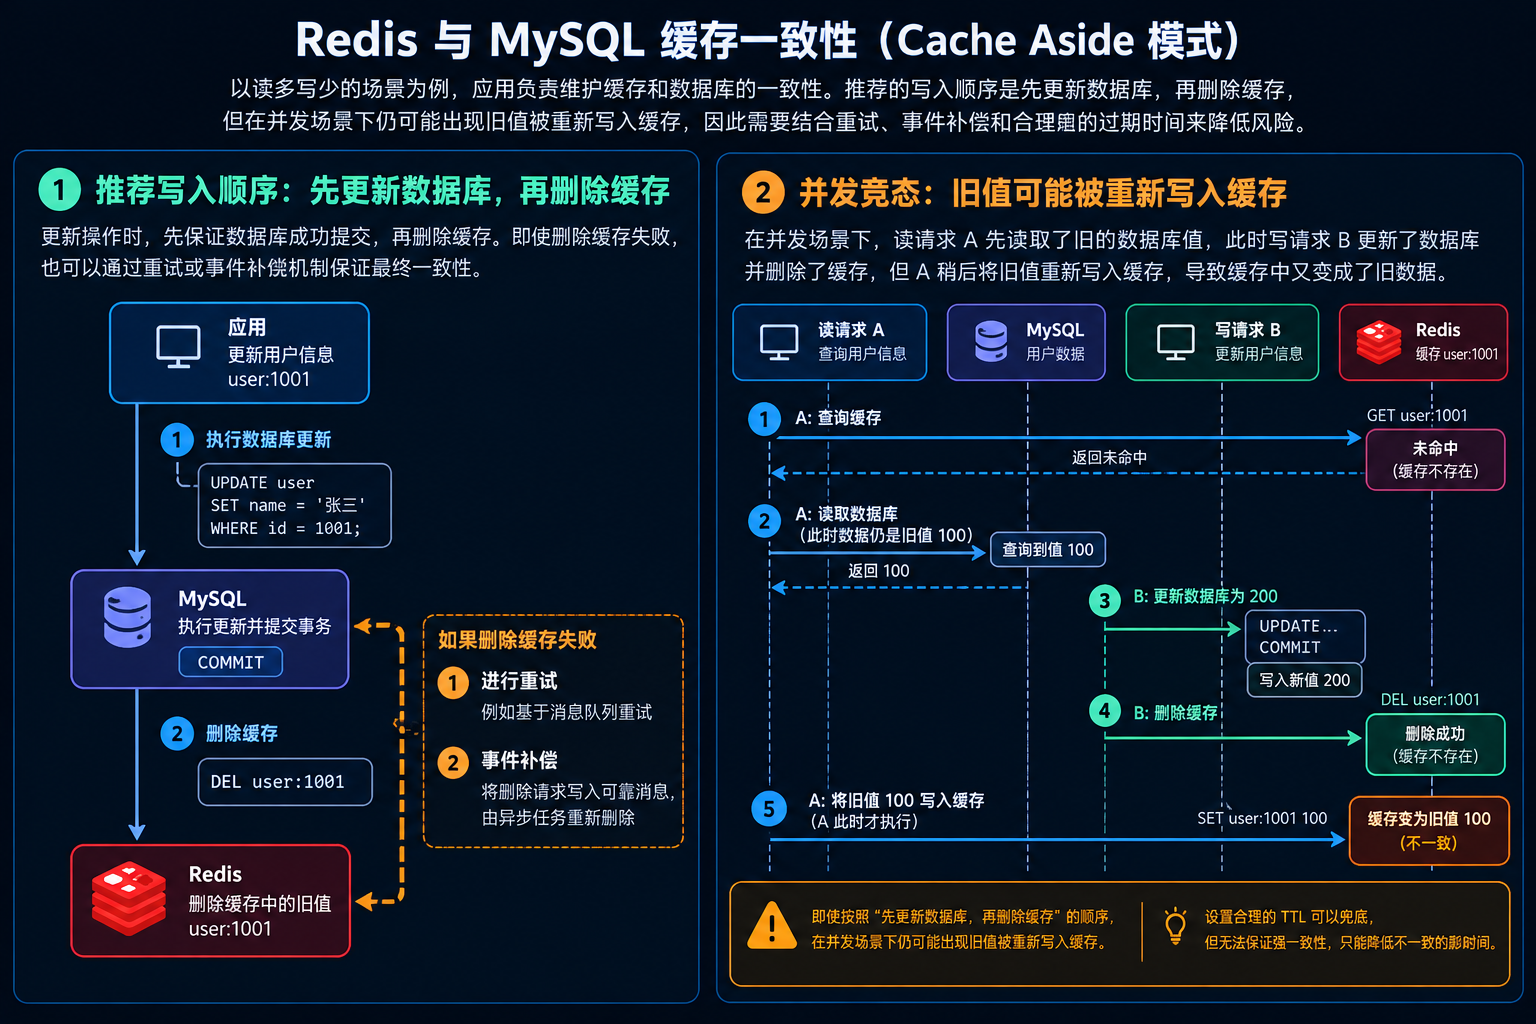
Cache Aside(旁路缓存) 的典型读取顺序是:查 Redis,未命中再查 MySQL,最后将查询结果写回 Redis。
对于更新,常见顺序是:
业务更新请求
↓
MySQL 事务提交成功
↓
删除对应的 Redis 缓存
↓
下一次读取时,从 MySQL 重建缓存
伪代码:
async def update_product(product_id, new_name):
await db.update_product_and_commit(product_id, new_name)
await redis.delete(f"product:{product_id}")
这比每次同时更新 MySQL 和 Redis 中的完整对象通常更简单:删除动作是幂等的,下一次读取按数据库当前状态重新构建,减少了缓存部分字段漏更新和双写顺序错误的机会。
但它只是实践中常见的最终一致性方案,并不能保证永远不会出现短暂旧值。
11. 为什么不推荐先删除缓存,再更新数据库?
考虑两个并发请求:
写请求 B:删除缓存
读请求 A:Redis Miss,读取 MySQL 旧值
读请求 A:把旧值写入 Redis
写请求 B:提交 MySQL 新值
最后 MySQL 是新值,Redis 反而长期保存了旧值,直到 TTL 到期或再次被删除。
所以“先删除缓存再更新数据库”的顺序非常容易让并发读把旧数据重新写回去。
12. 先更新数据库再删除缓存,还会不一致吗?
仍然可能。
考虑更特殊但真实存在的并发窗口:
A:查询 Redis,未命中
A:开始查询 MySQL,拿到旧值 100
(暂未回填)
B:更新 MySQL,新值 200,提交事务
B:删除 Redis 缓存
A:把之前拿到的旧值 100 写入 Redis
结果仍然是 Redis=100、MySQL=200。
也就是说,改变顺序可以降低风险,却无法单凭顺序完全消除竞态。
如果 B 的数据库事务已提交但删除 Redis 失败,同样会出现不一致。
13. 这些一致性问题怎么补救?
先根据业务判断允许多长时间的旧数据。一般缓存可以使用以下组合:
- TTL:给缓存设定合理过期时间,限制旧数据可能持续存在的时间。但若过期后读操作反复遇到并发竞态或其他写入,TTL 不是强一致证明。
- 失败重试:数据库提交成功、删缓存失败后,对删除动作进行有界重试并记录告警。避免只打印日志后丢失任务。
- 可靠事件补偿:可以通过 MySQL 事务 Outbox 或 Binlog CDC 产生失效事件,并在异步消费者中重试删除。需要关注重复、顺序、延迟和消费者故障。
- 版本号或原子校验:对读回填和写失效之间建立可比较的版本/序号,在写入缓存时拒绝过时版本;必须在 Redis 侧正确保证比较与写入的原子性。
- 延迟双删:更新后先删除一次,稍后再删除一次,可以缩小某些旧值回填窗口,但不是严格正确性保证;延迟时间很难总是覆盖最慢读请求。
对资金余额、支付状态、严格库存等关键业务,不应只靠缓存判断正确性。
应由 MySQL 等主存储的事务、条件更新、唯一约束或其他一致性机制保障最终结果;缓存可以用于非关键加速或者明确可容忍陈旧读的字段。
14. Redis 慢,是命令执行慢还是整个请求慢?
用户感受到的耗时通常包含连接等待、网络 RTT、Redis 命令排队与执行、序列化和结果传输。
SLOWLOG 只记录 Redis 命令实际执行耗时,不包括与客户端进行网络 I/O 的完整时间。
所以一次客户端请求花了 100ms,而 SLOWLOG 没有记录,并不代表 Redis 端到端访问没有问题。
可能是网络抖动、连接池耗尽、大响应结果传输或应用线程阻塞。
15. 排查 Redis 性能可以先看哪些指标?
可以先查看:
INFO memory
INFO stats
INFO commandstats
INFO latencystats
INFO persistence
SLOWLOG GET 20
LATENCY DOCTOR
INFO memory 关注内存占用、峰值、RSS 和碎片化;INFO stats 关注 keyspace_hits、keyspace_misses、evicted_keys 等累计指标;commandstats 帮助定位哪些命令消耗了资源。
SLOWLOG GET 能看到超过阈值的慢命令,阈值单位通常为微秒;LATENCY DOCTOR 属于 Redis 延迟监控框架,需要相应配置和采样数据才有分析价值。
不要在生产环境随意调整诊断配置或执行高开销的全量扫描命令。
16. 哪些操作经常带来不必要的延迟?
例如使用 KEYS * 全量遍历大量 Key、对巨型 Hash 执行 HGETALL、对巨型集合执行 SMEMBERS、一次返回超大响应、单条命令处理过多元素、执行耗时 Lua、频繁建立连接、同步处理大量 Key 删除,以及持久化过程中的 fork 和磁盘 I/O 压力。
更合理的替代方案通常包括:用 SCAN 渐进遍历、限制单次返回元素数量、分页或分批处理、使用 UNLINK 释放大集合,以及在应用侧使用连接池和超时管理。
17. Pipeline 为什么能提高性能?
普通请求经常是:发送命令 → 等待响应 → 再发送下一条。多次网络往返在高延迟网络中成本很明显。
Pipeline 允许客户端连续发送多条命令,再批量读取结果,减少大量 RTT。
不过要注意:Pipeline 不是事务,也不会自动给多个命令提供原子性。
部分客户端库有自己的事务选项,不能把某个库的默认配置当成 Redis Pipeline 语义本身。
批次也不能无限大,因为服务器需要为待发送响应保留内存,应该分批执行。
18. 把所有问题放到一张排查表
| 内存高、删除某个 Key 卡顿 | BigKey | –memkeys、MEMORY USAGE、拆分、UNLINK |
| 某个 Cluster 分片 CPU / 带宽异常高 | HotKey | 单 Key QPS、应用采样、本地缓存、请求合并 |
| 缓存值偶尔比 MySQL 旧 | 双写竞态、删除失败 | 更新后删缓存、重试、版本控制、可靠失效事件 |
| Redis 没有慢日志但客户端 P99 很高 | 网络、连接池、大响应 | 应用侧耗时分段、连接池、网络与数据大小 |
| 慢日志经常有 HGETALL/SMEMBERS | O(N) 大集合操作 | 分批分页、SCAN 家族 |
| 很多小命令但总体响应慢 | RTT、请求往返多 | Pipeline、批量 API、合理批次 |
19. 最容易搞错的几个地方
第一,BigKey 主要看单 Key 的数据规模,HotKey 主要看访问频率,不能混为一谈。
第二,Redis 很快,不代表所有命令都永远是 O(1),也不代表一次返回几十 MB 数据不会慢。
第三,UNLINK 是把昂贵的内存释放任务移到后台,不代表后台没有资源成本。
第四,SCAN 是渐进迭代,不是零成本操作,也不承诺在遍历期间数据改变时返回一个严格快照。
第五,数据库更新后删缓存是很常见的 Cache Aside 策略,但不是跨 MySQL 和 Redis 的原子事务。
第六,延迟双删、TTL、CDC、Outbox 解决的是特定失败场景或缩小不一致窗口,不能简单称为绝对强一致。
第七,Redis SLOWLOG 记录命令执行耗时,不包含网络往返;没有慢日志不代表用户端到端就不慢。
第八,Pipeline 提高吞吐不等于保证多命令原子性,更不等于 SQL 事务。


评论前必须登录!
注册