 网硕互联帮助中心
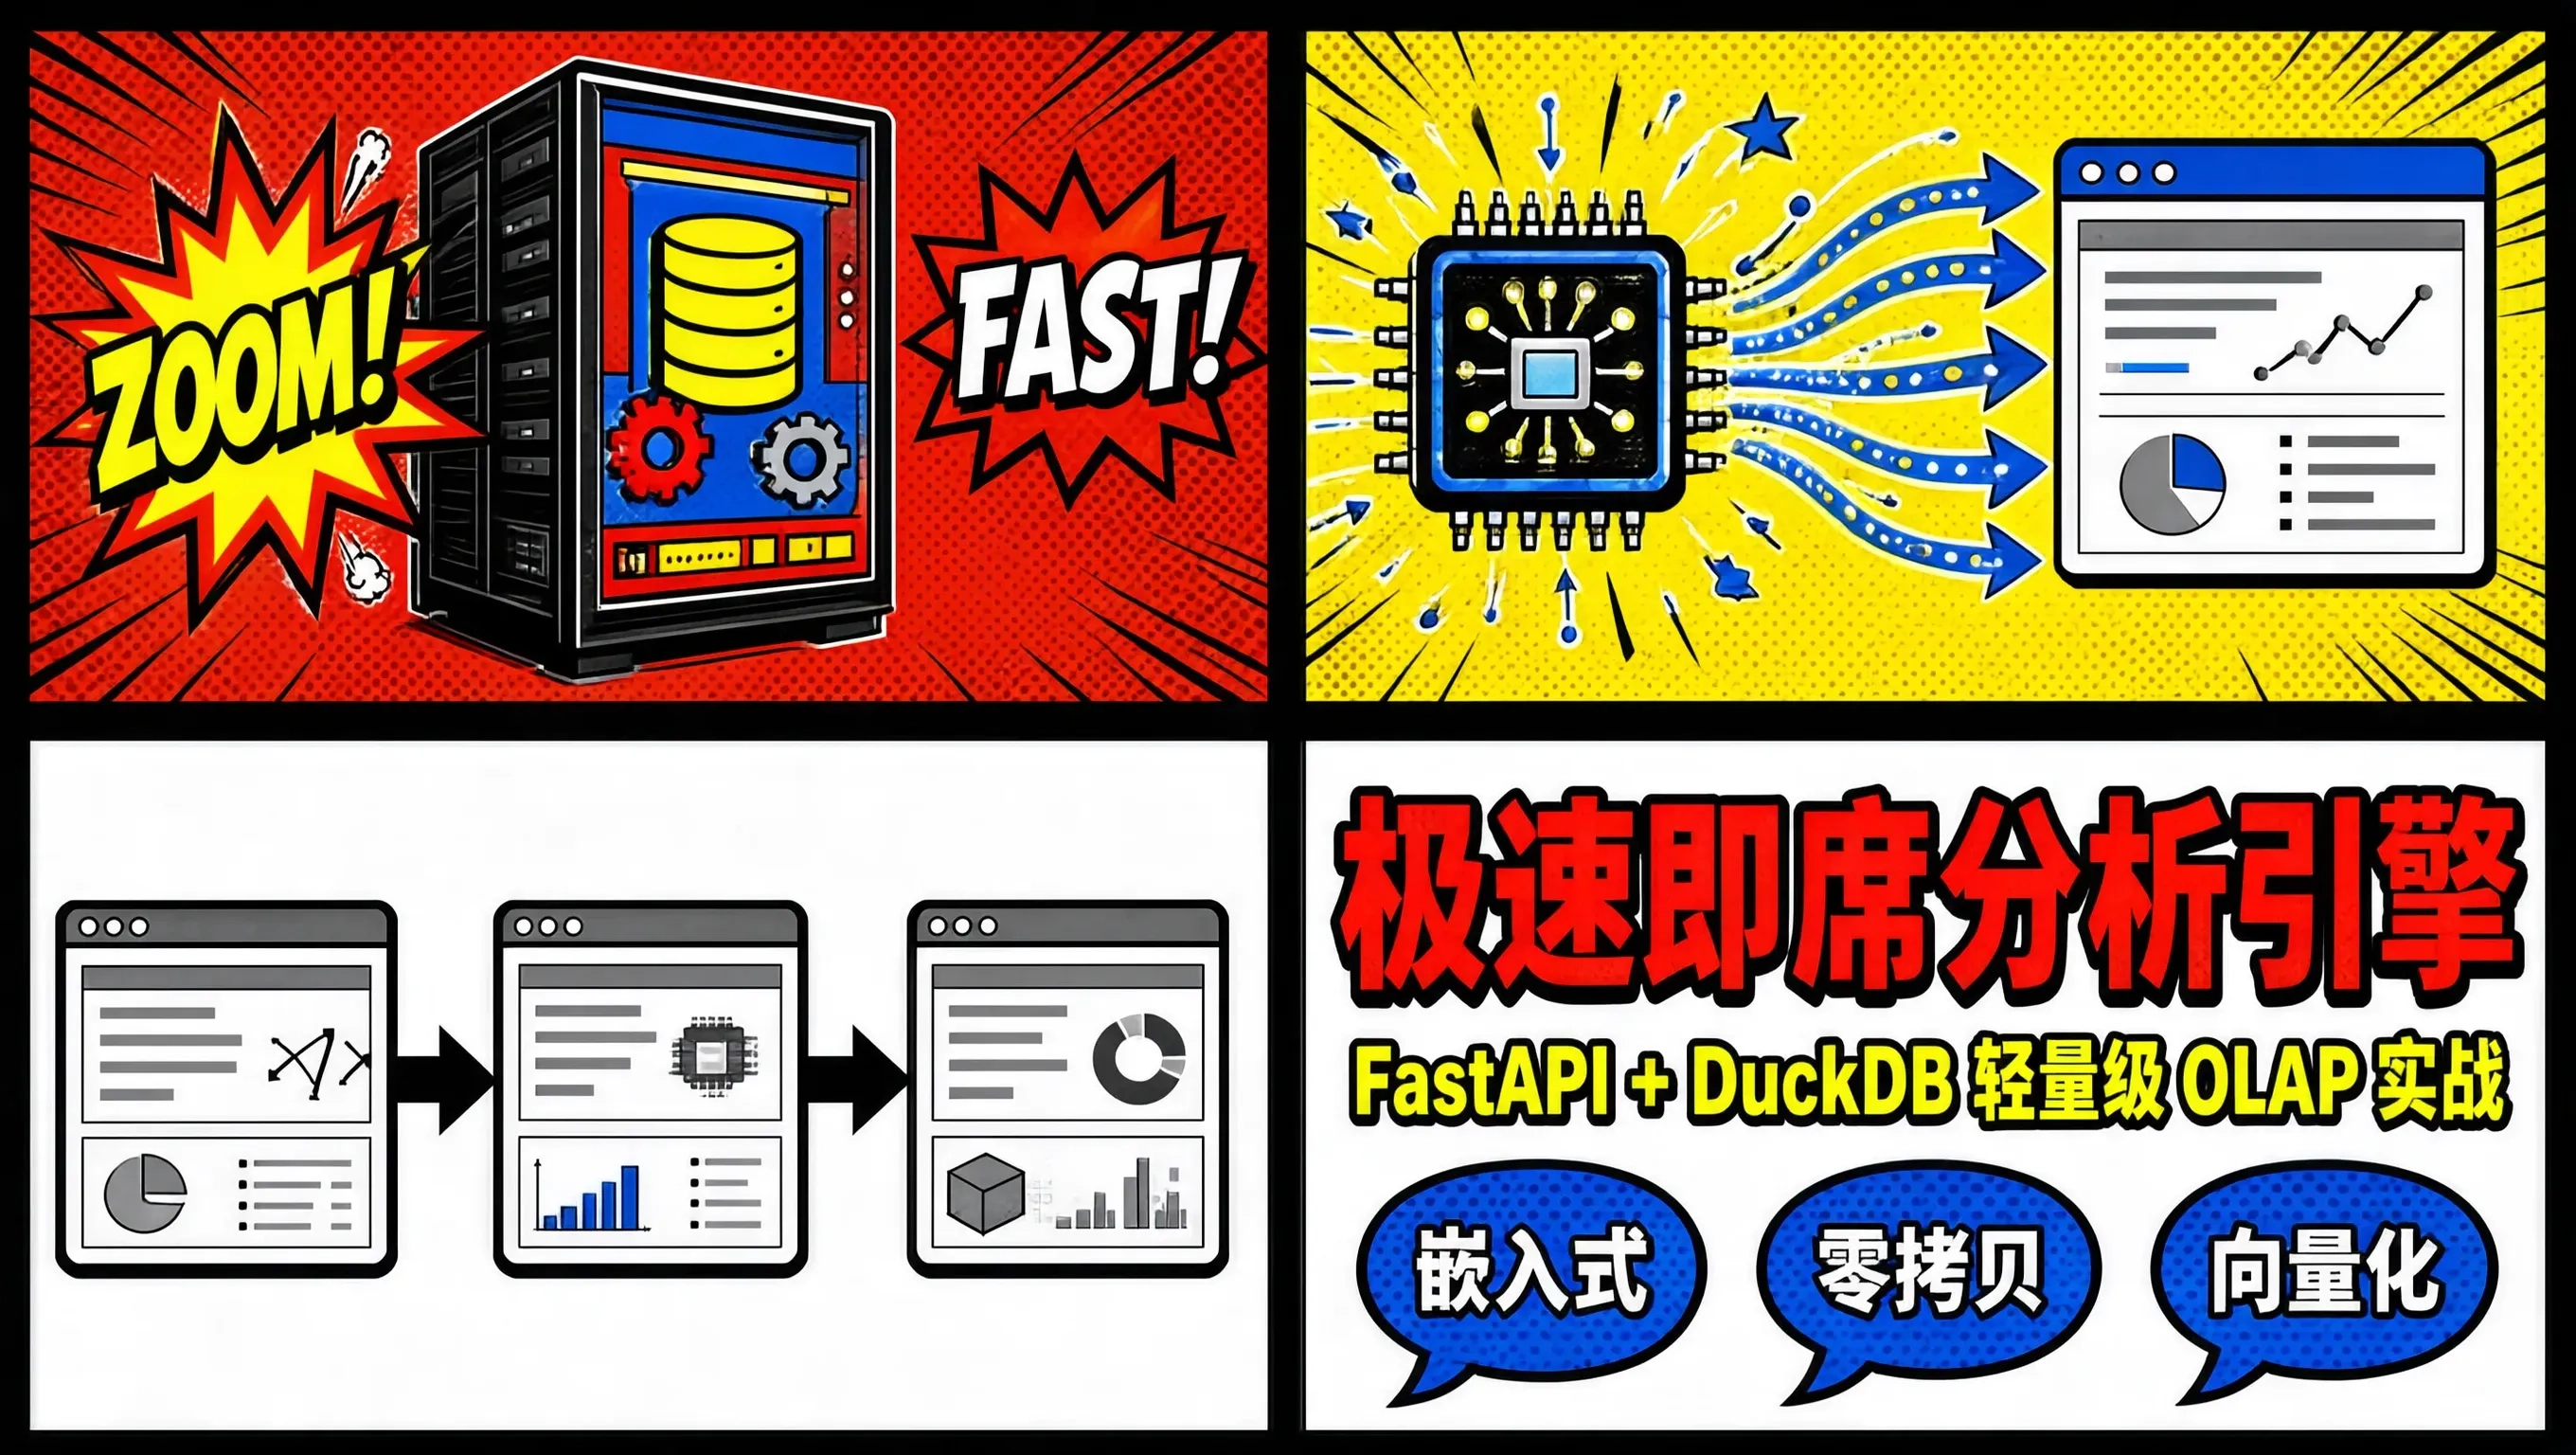
在很多中台型企业的数据架构中,常常会面临这样一种尴尬的“微分析”场景:某个业务中台(如商家端后台、客服质检平台、或者供应链追踪系统)需要为前端提供高度灵活的即席过滤与多维交叉分析能力。数据量其实不大——几个核心 Parquet 分区或离线 Hive 导出的数据量在几百万到几千万行之间,体量在 500MB 到 10GB 左右。
针对这种需求,如果去向大数据平台组申请一套独立的 Presto / Trino 集群,或者拉起昂贵的 Spark ThriftServer:
- 资源浪费严重:起步就要几台 32C/64G 的独立节点,空闲时资源完全闲置;
- 冷启动与网络延迟高:分布式调度开销大,简单查询也要 1~2 秒才能返回;
- 运维成本陡峭:JVM 调优、协调节点(Coordinator)高可用、Zookeeper 依赖令人心力交瘁。
DuckDB 作为单机向量化分析的“瑞士军刀”,与现代异步 Web 框架 FastAPI 简直是天作之合。通过将 DuckDB 嵌入到 Python 微服务进程中,借助 Apache Arrow 的内存零拷贝技术,我们可以在一台普通的 4 核 8G 云主机上,搭建出一套支撑每秒数百并发、响应延迟低至几十毫秒的微型 Serverless OLAP 查询引擎。
今天我们就来手把手落地一套生产级的 FastAPI + DuckDB 极速即席分析微服务。
一、架构设计:为什么 DuckDB + FastAPI 是微分析绝配?
在深入代码之前,我们先厘清这套架构的三大核心优势:
[前端 Web / BI Dashboard]
│ (HTTP REST / JSON / Arrow Stream)
▼
┌─────────────────────────────────────────────────────────────┐
│ FastAPI 异步微服务进程 (Uvicorn Async Worker) │
│ ├── 动态安全限流与 AST 白名单拦截中间件 │
│ ├── 异步连接池调度 (DuckDB Connection Cursor Pool) │
│ └── Apache Arrow 零拷贝序列化管道 │
└──────────────────────────────┬──────────────────────────────┘
│ In-Process C++ 调用 (Zero IPC)
▼
┌─────────────────────────────────────────────────────────────┐
│ 嵌入式 DuckDB 向量化计算引擎 (共享本地或挂载的 Parquet 数据) │
│ ├── SIMD 列式内存执行内核 │
│ └── 多线程外排序与并发只读隔离 (read_only=True) │
└─────────────────────────────────────────────────────────────┘
二、生产级工程实战:完整微服务构建
我们采用分层架构编写服务代码:包含数据源挂载、连接池管理、只读查询执行以及全局异常熔断。
1. 核心查询服务实现(query_service.py)
import duckdb
import pyarrow as pa
from contextlib import asynccontextmanager
from typing import Dict, Any, List
from fastapi import FastAPI, HTTPException, Request
from fastapi.responses import StreamingResponse
from pydantic import BaseModel
import io
# 1. 定义入参模型
class QueryRequest(BaseModel):
dataset: str # 数据集名称,映射到特定目录下的 Parquet 文件
metrics: List[str] # 指标列表,如 ["count(*)", "sum(amount)"]
dimensions: List[str] = [] # 维度列表,如 ["region", "category"]
filters: str = "" # 过滤表达式,如 "status = 'PAID' AND amount > 100"
limit: int = 500
# 2. 全局 DuckDB 管理中心
class DuckDBEngine:
def __init__(self, data_root_path: str):
self.data_root = data_root_path
# 初始化只读全局共享实例,利用内存多线程
self.conn = duckdb.connect(database=":memory:", read_only=False)
self._setup_views()
def _setup_views(self):
"""预先注册本地或挂载云盘上的 Parquet 文件为虚拟视图"""
# 支持按日期分区的通配符直接加载
self.conn.execute(f"""
CREATE OR REPLACE VIEW sales_orders AS
SELECT * FROM read_parquet('{self.data_root}/sales_orders/*.parquet');
""")
# 设置单机最大并发工作线程数
self.conn.execute("SET threads TO 4;")
self.conn.execute("SET max_memory = '4GB';")
def execute_ad_hoc(self, req: QueryRequest) -> List[Dict[str, Any]]:
"""基于安全构造执行动态即席聚合"""
# 严格校验维度与指标字段,防止 SQL 注入
allowed_chars = set("abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789_(),*+-/ ")
for expr in req.metrics + req.dimensions:
if not set(expr).issubset(allowed_chars):
raise ValueError(f"检测到非法字符: {expr}")
# 动态构造安全 SQL
select_cols = ", ".join(req.dimensions + req.metrics)
where_clause = f"WHERE {req.filters}" if req.filters.strip() else ""
group_clause = f"GROUP BY {', '.join(req.dimensions)}" if req.dimensions else ""
limit_clause = f"LIMIT {min(req.limit, 5000)}"
sql = f"""
SELECT {select_cols}
FROM {req.dataset}
{where_clause}
{group_clause}
{limit_clause}
"""
# 创建独立轻量游标执行,规避状态串扰
cursor = self.conn.cursor()
try:
# 直接转换为 Python 原生字典列表(也可直接走 .arrow() 导出)
df = cursor.execute(sql).df()
return df.to_dict(orient="records")
finally:
cursor.close()
# 3. 初始化 FastAPI 应用与生命周期管理
db_engine = None
@asynccontextmanager
async def lifespan(app: FastAPI):
global db_engine
# 模拟数据目录
db_engine = DuckDBEngine(data_root_path="./data")
yield
if db_engine and db_engine.conn:
db_engine.conn.close()
app = FastAPI(title="DuckDB-Lite-Analytics-Service", lifespan=lifespan)
# 4. 暴露即席分析 API 端点
@app.post("/api/v1/analytics/adhoc")
async def execute_query(req: QueryRequest):
if not db_engine:
raise HTTPException(status_code=500, detail="查询引擎尚未就绪")
try:
results = db_engine.execute_ad_hoc(req)
return {
"code": 200,
"message": "success",
"total_rows": len(results),
"data": results
}
except ValueError as ve:
raise HTTPException(status_code=400, detail=str(ve))
except Exception as e:
raise HTTPException(status_code=500, detail=f"查询引擎内部错误: {str(e)}")
三、性能飙升:基于 Apache Arrow 的流式导出优化
当业务需要将 10 万行级别的结果集下载或传递给前端时,传统的 JSON 序列化在 Python 里极其缓慢,CPU 会被 json.dumps() 彻底打满。
DuckDB 原生支持将结果集导出为 Apache Arrow IPC Streaming 格式。通过 HTTP 二进制流输出,传输性能可以提升 10 倍以上:
@app.post("/api/v1/analytics/export/arrow")
async def export_arrow_stream(req: QueryRequest):
"""利用 Arrow 零拷贝二进制流极速响应"""
# 构造 SQL …
cursor = db_engine.conn.cursor()
# 提取 Arrow 表对象
arrow_table: pa.Table = cursor.execute("SELECT …").arrow()
cursor.close()
# 将 Arrow 数据流式写入 HTTP 响应
sink = io.BytesIO()
with pa.ipc.new_stream(sink, arrow_table.schema) as writer:
writer.write_table(arrow_table)
sink.seek(0)
return StreamingResponse(
sink,
media_type="application/vnd.apache.arrow.stream",
headers={"Content-Disposition": "attachment; filename=export.arrow"}
)
前端只需在浏览器端通过 JavaScript 的 apache-arrow 库,直接解析这个 ArrayBuffer 二进制流,瞬间即可驱动 Canvas 图表渲染,没有一丁点文本解析负担。
四、生产环境稳定性加固
在实际生产部署中,必须加入三层防护罩,防止个别极端查询拖死整个微服务:
五、总结
并不是所有的数据分析都需要动用成百上千节点的分布式重型武器。在数据局部化、中轻量即席分析的广阔天地中,FastAPI + DuckDB 的极简组合展现了惊人的能效比。
它以单机轻量级的姿态,交付了媲美分布式 MPP 引擎的分析体验。架构师的成熟,正在于懂得为不同的数据体量匹配最合适、最克制的优雅解法。


评论前必须登录!
注册