 网硕互联帮助中心
省略一个参数就是永久 · 两套格式差 17 处 · 有条约 64 MiB 的上限摸不到
数据截止 2026 年 10 月 7 日 | 全文约 2.7 万字符、4 张文本制图与 2 张图表 | 官方一手文档 + 本机可复算推算,每条来源与口径均标注
目录
一、先把结论放前面:你上传的不是一张图,是一个资源
二、五个错觉总览
三、错觉一:文件会过期 —— 不写这个参数就是永久
四、错觉二:两套 API 是同一套 —— 17 处字段差异
五、错觉三:限额是给你用的 —— 三个上限互相打架
六、错觉四:文件是你的 —— 它属于 API key
七、错觉五:删了就没了 —— 五个未定义分支
八、最要命的自省盲区:列表里没有「最后使用时间」
九、容量账:25 GiB 能装多少,多久吃满
十、巡检脚本:把永久文件变回可控状态
十一、迁移检查清单
十二、未验证的边界与写在最后
|
重点提示 |
|
上一篇我们拆了「模型自省」,结论有点别扭:你问「你是谁」,它只答「我能干什么」。 这一篇换一个方向。假设你已经接受了「你是在用一把 API key,跟一个会变的服务说话」,那么下一步你会问: 我在这台服务器上留下的东西,归谁管? 如果你用过 Files API,你把图片交给他保管了。那这些文件会不会过期?谁能访问?删掉之后还剩下什么? 我把官方文档逐页翻了一遍,发现五个「听起来很合理、但和官方原文不一样」的直觉。 这一篇就是把它们一个一个拆开。 |
一、先把结论放前面:你上传的不是一张图,是一个资源
第 7 篇讲过三种传图方式,顺便算清了 Files API 的盈亏平衡点:同一张图用第 2 次,就该换它。
但那篇文章有个视角限制:它把 Files API 当作「传图方式之一」,只比了成本和带宽。
换个视角看,这件事的性质完全不同:
|
你现在做的事 |
性质 |
|
base64 内联 |
每次请求 自带 图片,服务端不留东西 |
|
外部 URL |
每次请求 指路 ,服务端临时去下载 |
|
Files API |
你先 存了一份 在他那里,之后每次只报一个编号 |
前两种是无状态的——请求结束,一切归零。 第三种不是。你在他的服务器上创建了一个对象,这个对象有创建时间、有体积、有归属、有寿命、有配额。
官方对这个子系统的定位写得很清楚(原文):
|
要点 |
|
The Files API lets you upload images and reference them later by file_id. It is the recommended way to:
|
注意「recommended way」这两个词。官方推荐你走这条路。
而一旦你走了这条路,你就从「无状态调用」进入了「有状态资源管理」。有状态意味着四件事会同时出现:
|
有状态带来的东西 |
对应的问题 |
|
生命周期 |
它什么时候消失? |
|
归属 |
谁有权访问它? |
|
一致性 |
删掉之后还剩什么? |
|
容量 |
我能存多少? |
这四个问题,每一个都有一个「听起来很自然」的错误答案。这就是本文的五个错觉。
|
一句话记住:你上传的不是一张图,是一个有生命周期、有归属、有配额的资源。 |
顺手把本文讨论的接口列全,方便你对照:
|
操作 |
OpenAI 兼容 |
Anthropic 兼容 |
|
上传 |
POST /files |
POST /anthropic/v1/files |
|
列表 |
GET /files |
GET /anthropic/v1/files |
|
详情 |
GET /files/{file_id} |
GET /anthropic/v1/files/{file_id} |
|
删除 |
DELETE /files/{file_id} |
DELETE /anthropic/v1/files/{file_id} |
|
引用 |
{"type": "file", "file_id": "…"} |
{"type": "image", "source": {"type": "file", …}} |
base_url 分别是 https://api.deepseek.com 和 https://api.deepseek.com/anthropic。
二、五个错觉总览
先给一张总表。每一条的结构都一样:一个「听起来合理」的直觉,配一句「官方原文」的反例。
|
错觉 |
直觉 |
官方原文 / 事实 |
|
一、文件会过期 |
上传的东西过一阵子就自动清掉了 |
省略 expires_after 就是 永久保存 |
|
二、两套 API 是同一套 |
只是换个 base_url 而已 |
字段名、游标、时间格式、删除响应 全都不同 |
|
三、限额是给你用的 |
标了上限,那就是我能达到的 |
三个上限互相打架, 64 MiB 那条用 base64 永远摸不到 |
|
四、文件是我的 |
在账号里,哪把 Key 都能用 |
官方原句: Files belong to your API key |
|
五、删了就没了 |
返回 deleted: true ,说明清干净了 |
返回的是 布尔值 ,不含任何级联信息 |
这五条里,第一条最容易被忽略,因为它是一条默认行为——默认行为不需要你写任何代码,所以也没有任何机会被你在 Code Review 里注意到。
三、错觉一:文件会过期 —— 不写这个参数就是永久
上传接口有两个可选的过期字段:
|
示意图 · 文本绘制 |
|
expires_after[anchor] = created_at (唯一允许的值) expires_after[seconds] = 3600 ~ 2592000 (1 小时 ~ 30 天) |
规则有两条,都要记住:
第 2 条是官方原文,一个单词都不含糊:
Omit both expires_after fields to keep the file permanently.
「permanently」这个词,是整个 Files API 里最重的一个词。
3.1 可表达的寿命区间,中间断了一截
把官方允许的区间画出来,你会发现一个奇怪的形状:
|
你想要的寿命 |
秒数 |
落在允许区间内? |
结果 |
|
1 小时 |
3600 |
是(下限) |
接受 |
|
12 小时 |
43200 |
是 |
接受 |
|
7 天 |
604800 |
是 |
接受 |
|
30 天 |
2592000 |
是(上限) |
接受 |
|
31 天 |
2678400 |
否 |
被拒 |
|
45 天 |
3888000 |
否 |
被拒 |
|
90 天 |
7776000 |
否 |
被拒 |
|
1 年 |
31536000 |
否 |
被拒 |
|
永久 |
(省略参数) |
不适用 |
接受 |
31 天比上限多了 2678400 – 2592000 = 86400 秒,也就是整整一天。
于是出现了一个尴尬的断层:「保存 31 天到 1 年」这个需求区间,参数表达不出来。
你只有两个选项:不超过 30 天,或者永久。中间没有档位。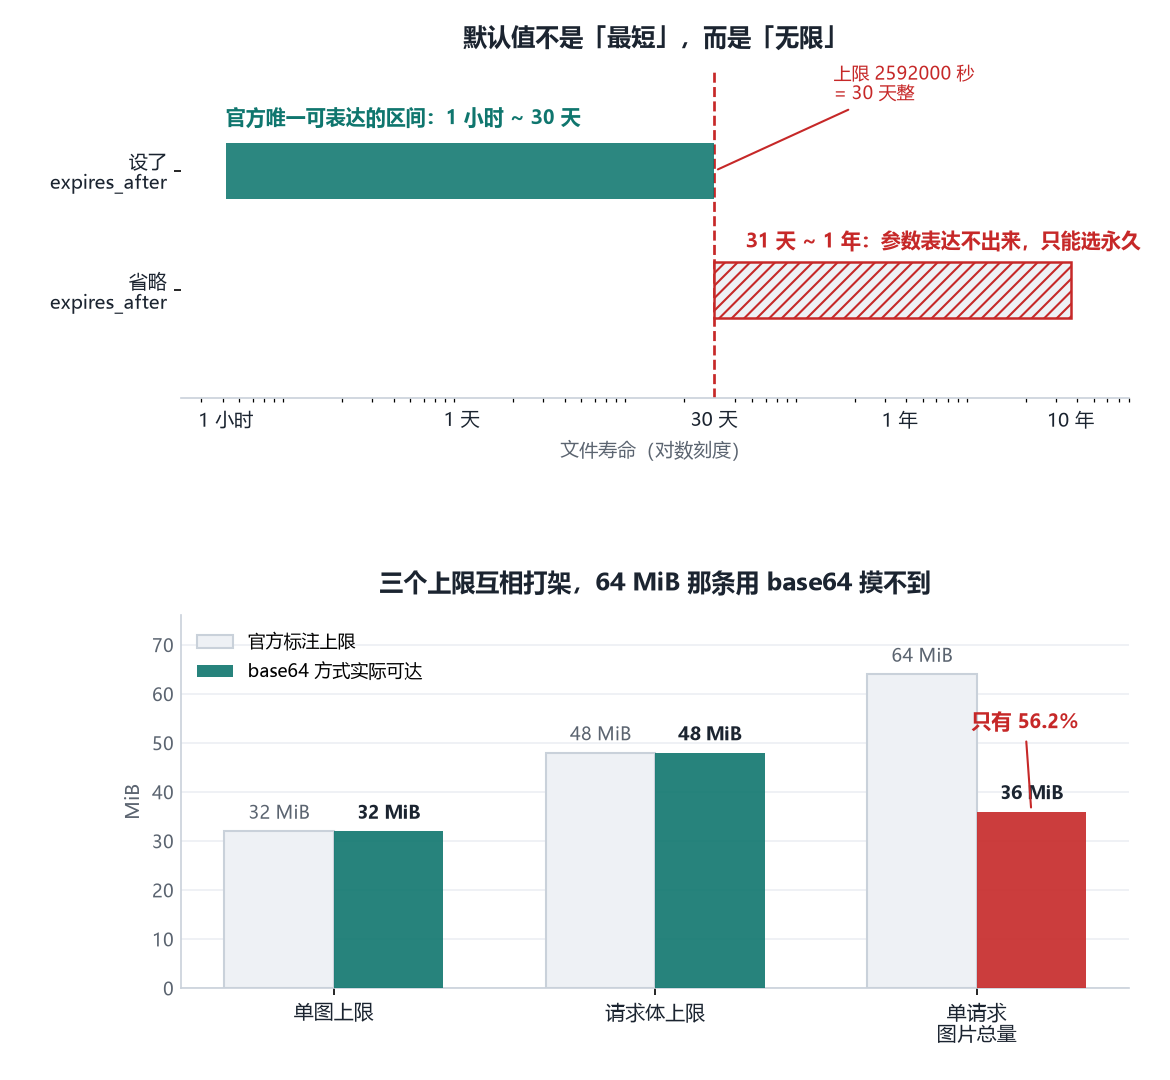 图 1 寿命区间与三个上限:中间断了一截,64 MiB 那条摸不到
|
示意图 · 文本绘制 |
|
文本图 A 不写 expires_after,文件就是永久的(纯 ASCII) +————————————————————————–+ | POST /files purpose=user_data | +————————————————————————–+ | | | expires_after[seconds] = 3600 .. 2592000 (1 hour .. 30 days) | | ———————————————————- | | | | SET -> auto-delete at expires_at. your app must | | survive a 404 on that file_id. | | | | OMITTED -> PERMANENT. no expiry date is written at all. | | | | only two brakes remain: | | (1) manual DELETE /files/{file_id} | | (2) hitting the 25 GiB / 10000-file quota | | | | and hitting quota is not a brake – it is a failure. | | uploads simply start erroring out. | | | | want 31 days ? NOT EXPRESSIBLE (max = 2592000 = 30d) | | want 90 days ? NOT EXPRESSIBLE | | want 1 year ? NOT EXPRESSIBLE | | | | -> you must choose: <= 30 days, or forever. | +————————————————————————–+ The default value is not the shortest one. It is infinity. |
3.2 好消息:永久文件是可以被识别出来的
这一节有个实用的小技巧。
上传响应里有个字段叫 expires_at,官方对它的描述是:
The Unix timestamp (in seconds) of when the file expires. Only present when an expiration was set at upload time.
注意后半句。这句话反过来读就是:
expires_at 不存在的文件,就是永久文件。
所以你不需要在应用里额外记一张表,就能把「有寿命的文件」和「永久文件」分开:
|
Python |
|
page = client.files.list(limit=1000) for f in page.data: if getattr(f, "expires_at", None) is None: print("永久文件:", f.id, f.filename, f.bytes) |
这行判断,是后面第九节巡检脚本的基础。
|
一句话记住:不写 expires_after,文件就是永久的;而 expires_at 字段为空,就是你现成的永久文件探测器。 |
3.3 把「永久」换算成运维后果
|
你的选择 |
到期后发生什么 |
你的应用必须能承受什么 |
|
设了 expires_after |
文件自动消失 |
引用该 file_id 的请求会失败 |
|
省略了 expires_after |
什么都不会发生 |
你的存储只增不减,直到撞配额 |
第二种情况的两条刹车,都值得单独说:
- 手动 DELETE:需要你自己判断该删谁。而判断依据是什么?这正是第八节要讲的问题。
- 撞配额:请注意,撞配额不是刹车,是故障。上传会开始报错,而报错发生在业务请求里,不在你的清理任务里。
四、错觉二:两套 API 是同一套 —— 17 处字段差异
官方对 Files API 提供了两个入口,区别看起来只是加个 /anthropic 后缀:
|
示意图 · 文本绘制 |
|
OpenAI 兼容 https://api.deepseek.com Anthropic 兼容 https://api.deepseek.com/anthropic |
「同一个功能的两套入口」这个说法只在概念层成立。落到报文上,逐字段都不一样。
我把官方两套文档并排抄了一遍,数出 17 处差异:
|
示意图 · 文本绘制 |
|
文本图 B 同一个功能,两张脸:17 处字段差异(纯 ASCII) +——————–+————————–+————————–+ | field | OpenAI-compatible | Anthropic-compatible | +——————–+————————–+————————–+ | size field | bytes | size_bytes | | type field | object | type | | created_at | Unix seconds (integer) | RFC 3339 string | | mime_type | absent | present | | list cursor | after | after_id / before_id | | list limit default | 1000 | 20 | | list order | asc / desc | not supported | | list purpose | supported | not supported | | list top object | "list" | omitted | | required header | none | anthropic-beta: files-* | | auth header | Authorization: Bearer | x-api-key | | delete response | {object:"file",deleted} | {type:"file_deleted"} | +——————–+————————–+————————–+ limit default differs 50x: a 'list all files' loop takes 1000 per page on one side and 20 per page on the other. |
完整对照长这样:
|
差异项 |
OpenAI 兼容 |
Anthropic 兼容 |
|
认证头 |
Authorization: Bearer |
x-api-key |
|
必需 beta 头 |
无 |
anthropic-beta: files-api-2025-04-14 |
|
体积字段名 |
bytes |
size_bytes |
|
类型字段名 |
object |
type |
|
创建时间格式 |
Unix 秒(整数) |
RFC 3339 字符串 |
|
mime_type 字段 |
无 |
有 |
|
列表顶层 object |
"list" |
省略 |
|
分页游标 |
after |
after_id / before_id (互斥) |
|
limit 默认值 |
1000 |
20 |
|
order 参数 |
支持 |
不支持 |
|
purpose 参数 |
支持 |
不支持 |
|
删除响应形状 |
{object:"file", deleted:true} |
{type:"file_deleted"} |
其中三处最容易造成线上事故,一个一个说。
4.1 第一处:limit 默认值差 50 倍
一份「列出我所有文件」的代码:
|
Python |
|
def all_files(client): out, cursor = [], None while True: page = client.files.list(limit=1000, after=cursor) out.extend(page.data) if not page.has_more: return out cursor = page.last_id |
如果这段代码里的 limit=1000 被漏掉、走了默认值,那么在 Anthropic 侧:
|
文件总数 |
OpenAI 侧翻页数 |
Anthropic 侧翻页数 |
倍数 |
|
100 |
1 |
5 |
5 倍 |
|
1000 |
1 |
50 |
50 倍 |
|
5000 |
5 |
250 |
50 倍 |
|
10000 |
10 |
500 |
50 倍 |
但真正的问题不是「慢」,而是如果你没写翻页循环。
很多人的第一版代码就是 files = client.files.list().data——不翻页。在 OpenAI 侧 1000 条以内看不出问题;换到 Anthropic 侧,你会只拿到 20 条。
而失败的样子是:你不会看到「少拿了 980 条」,你只会看到「文件不见了」。
4.2 第二处:创建时间一个是整数,一个是字符串
created_at 在 OpenAI 侧是 Unix 秒(整数),在 Anthropic 侧是 RFC 3339 字符串。
这一条算是「好坑」:类型不同,写惯一边的代码换到另一边会直接抛错,会暴露出来。
真正的风险在于松散解析。如果你为了「两边都能跑」,写了这种代码:
|
Python |
|
ts = str(f.created_at) # 危险:把两种格式强行统一成字符串 |
那么排序会全错——字符串排序下,"1767" 排在 "2026" 后面。而它不会报错,只会给你一个看起来合理的、错误的时间顺序。
4.3 第三处:删除响应形状不同,判空恒为 False
OpenAI 侧删除返回:
|
JSON |
|
{ "id": "file-api-xxxxxxxxxxxxxxxx", "object": "file", "deleted": true } |
Anthropic 侧删除返回:
|
JSON |
|
{ "id": "file-api-xxxxxxxxxxxxxxxx", "type": "file_deleted" } |
于是这段「看起来最自然」的代码会翻车:
|
Python |
|
resp = delete_file(fid) if resp.get("deleted"): log.info("已删除") else: log.warning("删除失败") |
在 Anthropic 侧,resp.get("deleted") 恒为 None,所以永远走 else 分支。
结果就是:文件确实删掉了,但你的日志和告警会一直告诉你「删除失败」。
4.4 还有一个容易忽略的:/v1 前缀谁补
官方对 Anthropic 兼容侧写了一句很容易跳过的说明:
the Anthropic SDK appends /v1 automatically when you point it at the base URL above, but with a plain HTTP client (e.g., curl) you must write the full path.
意思是:
|
你的客户端 |
你该写什么 |
|
Anthropic SDK |
base_url = https://api.deepseek.com/anthropic ,路径由 SDK 补 |
|
curl / requests |
必须自己写全 https://api.deepseek.com/anthropic/v1/files |
所以 Anthropic 兼容侧的删除请求,实际长这样:
|
Bash |
|
# Anthropic 兼容侧:路径要写全,还要带 beta 头 curl -L -X DELETE \\ 'https://api.deepseek.com/anthropic/v1/files/file-api-xxxxxxxxxxxxxxxx' \\ -H 'x-api-key: <DeepSeek API Key>' \\ -H 'anthropic-beta: files-api-2025-04-14' |
少任何一个头、或者路径里少一个 /v1,你都会拿到一个 4xx。
两条路的最终地址一样,但写错的那一条不会给你明确的错误提示——你只会拿到一个 404,然后开始怀疑是不是权限问题。
|
一句话记住:换 base_url不等于换语言,字段名全都不一样;尤其是那个恒为 False 的deleted。 |
五、错觉三:限额是给你用的 —— 三个上限互相打架
官方在 Vision 页面里列了一张 Limits 表,里面有几条和 Files API 直接相关:
|
限额项 |
官方值 |
|
请求体大小 |
48 MiB |
|
单图上限( base64 / 外部 URL ) |
32 MiB |
|
单图上限( Files API file_id ) |
64 MiB |
|
单请求图片数 |
600 |
|
单请求图片总量(不含 file_id ) |
64 MiB |
|
单请求图片总量(含 file_id ) |
最多 200 MiB |
|
单边像素上限 |
8192 px |
|
含 15 张以上图片时的单边上限 |
4096 px |
直觉是:「标了上限,那就是我能达到的能力。」
现实是:这三个上限不是三个独立的天花板,而是三条互相约束的线。真正生效的,永远是最先撞上的那一条。
5.1 base64 会膨胀三分之一
先明确一件事。官方对 base64 的计入口径写得很直白:
The encoded data counts toward the 48 MiB request body limit.
也就是说,48 MiB 这条线卡的是编码后的体积:
|
项 |
计算 |
结果 |
|
膨胀率 |
4/3 |
+33.33% |
|
32 MiB 原图编码后 |
32 x 4/3 |
42.67 MiB (占请求体 88.9% ) |
|
留给其它内容的额度 |
48 – 42.67 |
5.33 MiB(11.1%) |
|
想用满 48 MiB 时图片上限 |
48 x 3/4 |
36 MiB |
先看单图场景:一张 32 MiB 的满配图编码后是 42.67 MiB,请求体只剩 5.33 MiB。一张图加一段提示词,就贴到天花板了。
但这里其实是 32 MiB 这条线先起作用——它比 36 MiB 更小。
5.2 真正的问题是 64 MiB 那条线
多图场景才暴露出矛盾。官方允许「单请求图片总量 64 MiB(不含 file_id)」。
那么算一下:
|
项 |
计算 |
结果 |
|
64 MiB 原图编码后 |
64 x 4/3 |
85.33 MiB |
|
请求体上限 |
— |
48 MiB |
|
超出幅度 |
85.33 / 48 – 1 |
超了 77.8% |
|
base64 下实际可达 |
48 x 3/4 |
36 MiB |
|
占官方标注上限 |
36 / 64 |
只有 56.2% |
所以结论是:
64 MiB 这个总量上限,用 base64 永远摸不到。你会在摸到它之前,先撞上 48 MiB 的请求体。
缺口那 43.8%,只能用 file_id 补。
|
示意图 · 文本绘制 |
|
文本图 C 三个上限互相打架,真正生效的永远是最先撞上的那一条 +————————————————————————–+ | three caps, one wall (base64 path) | +————————————————————————–+ | | | cap 1 single image …………… 32 MiB REACHABLE | | cap 2 request body …………… 48 MiB REACHABLE | | cap 3 total images / request ….. 64 MiB NOT reachable | | | | why cap 3 is unreachable over base64: | | 64 MiB raw x 4/3 = 85.33 MiB encoded | | > 48 MiB request body | | | | and cap 1 leaves almost no room for anything else: | | 32 MiB raw x 4/3 = 42.67 MiB encoded | | -> only 5.33 MiB left (11.1%) | | | | so the real ceiling over base64 is 36 MiB raw, | | which is 56.2% of cap 3. the missing 43.8% needs file_id. | +————————————————————————–+ |
5.3 换了 file_id,另外两个上限又开始打架
走 file_id 方式后,单图能到 64 MiB、总量能到 200 MiB。但这一侧同样不自洽:
|
约束 |
计算结果 |
结论 |
|
200 MiB 总量 / 64 MiB 单文件 |
3.125 |
最多只能放 3 个 满配文件 |
|
200 MiB / 600 张 |
341.33 KiB |
想用满 600 张,平均每张不能超过 341 KiB |
|
600 张 x 64 MiB |
38400 MiB |
是 200 MiB 的 192 倍 |
|
64 MiB / 600 张 |
109.23 KiB |
不含 file_id 时,平均每张只有 109 KiB |
也就是说:600 这个计数上限,和 200 / 64 MiB 这两个体积上限,同样互相打架。
5.4 顺带把一次请求的图像上限换算成钱
第 7 篇已经推导过图像计费(每图上限 1024 token、按约 1300×1300 归一),这里不重复,只把「一次请求最多能塞多少图」换算成金额。
600 x 1024 = 614,400 token。按官方价格表(每 1M token):
|
模型 / 时段 / 缓存 |
输入单价 |
单请求图像输入成本 |
|
flash / 谷时 / 未命中 |
$0.150 |
$0.0922 |
|
flash / 高峰 / 未命中 |
$0.300 |
$0.1843 |
|
pro / 谷时 / 未命中 |
$0.660 |
$0.4055 |
|
pro / 高峰 / 未命中 |
$1.320 |
$0.8110 |
一次请求的图像输入,光输入就最多要 $0.81——而这只是一次请求、只有图像、还没算文本和输出。
|
重点提示 |
|
一句话记住:官方标了三个上限,但真正生效的永远是最先撞上的那一条; 在 base64 这条路上,64 MiB 是一条你根本摸不到的线。 |
六、错觉四:文件是你的 —— 它属于 API key
这一节的起点是一句官方原句:
Files belong to your API key and can be referenced from either API family.
这句话很短,但有两层信息。
6.1 第一层:跨协议可引用,但两个头的行为不一样
「要么 API family 都能引用」是好消息。但引用的时候,Anthropic 侧必须带一个 beta 头。
而同一个头在同一个 base_url 下,行为是不对称的。官方在兼容性表格里是这么写的:
|
端点 |
anthropic-beta 头 |
官方表述 |
|
/messages |
被忽略 |
Ignored for /messages |
|
Files API 全部端点 |
必需 |
required (files-api-2025-04-14) for Files API endpoints |
也就是说:你在 /messages 上带着这个头跑了半年都没报错,不代表 Files API 上也能不带。
带错了会怎样?官方没写。但这类「缺失必需头」在 Anthropic 协议里通常是直接的 4xx——比静默失败好。
6.2 更隐蔽的一层:这个版本号不是 DeepSeek 的
那个头的取值是 files-api-2025-04-14。
请注意这里的日期:2025-04-14。
而本文讨论的模型是 2026 年的 V4.1。一个 2026 年的功能,要求你带一个 2025 年的版本标识——这说明这个字符串是上游(Anthropic)的 API 版本号,被原样转发过来了。
风险在这里:如果上游轮换这个取值,你不会收到任何官方信号。
- 没有 /versions 接口
- 没有变更日志条目(第七节会验证这一点)
- 你的集成测试如果只跑 happy path,也不会发现
所以工程上的正确姿势是:把这个 beta 头的取值当成一个外部依赖的常量,放进配置中心,而不是硬编码在代码里。
6.3 第二层:归属单位是 API key,不是账号
「belong to your API key」这句话,至少引出三个官方没有回答的问题:
|
场景 |
问题 |
为什么重要 |
|
轮换 API key |
旧的 file_id 还能用吗? |
决定你能不能做密钥轮换 |
|
同账号多把 Key |
命名空间共享还是隔离? |
决定多服务能否复用同一批文件 |
|
Key 被吊销 |
文件被删还是被冻结? |
决定你的数据留存策略 |
这三个问题,官方文档一个字都没写。
所以工程上有一条稳妥的原则:
不要把 file_id 当成长期资产。把「原始图片」当作你的资产,把 file_id 当作可再生的缓存。
这句话的实际含义是:你的原始图片必须存在你自己的存储里(对象存储、本地磁盘、随便什么),file_id 只是一个加速器。如果哪天 key 换了、文件没了,你能一键重新上传,而不是去找备份。
6.4 三条可以直接落地的做法
把「file_id 是缓存不是存储」这句话落到工程上,就是三件事:
|
做法 |
具体动作 |
收益 |
|
原图自有 |
上传前先把原图写进你自己的对象存储 |
key 换了也不丢 |
|
编号可弃 |
数据库里只把它当 加速字段 ,不当唯一指向 |
丢了能重建 |
|
上传可重 |
封装一个 ensure_file(path) ,本地有原图就能重传 |
恢复是自动的 |
第三条最关键,因为它决定了「恢复」是一次运维操作还是一次代码改动:
|
Python |
|
def ensure_file(client, path, cache, keep_days=7): """本地有原图就能保证拿到可用 file_id。""" key = os.path.abspath(path) fid = cache.get(key) if fid and still_valid(client, fid): return fid up = upload(client, path, keep_days=keep_days) cache.set(key, up.id) return up.id |
反过来看:如果你的系统里 file_id 是唯一指向某张图的东西,那你其实是把一张图片的全部所有权,交给了一个你既没有 SLA、也没有删除凭证、还没有使用记录的对象。
七、错觉五:删了就没了 —— 五个未定义分支
删除接口的响应,官方给得很简单:
|
JSON |
|
{ "id": "file-api-xxxxxxxxxxxxxxxx", "object": "file", "deleted": true } |
这是一个布尔值。它回答的问题是「这次调用有没有把文件删掉」。
它没有回答的问题,我数出来五个:
|
分支 |
维度 |
触发条件 |
未定义的是什么 |
|
A |
在途引用 |
有请求正引用这个 file_id 时删除它 |
请求失败?静默降级?还是照常完成? |
|
B |
幂等性 |
删除一个已经删掉的 file_id |
返回 deleted: true 还是 404 ? |
|
C |
级联 |
删除后,历史请求里的那些引用 |
是否有任何留存、审计或恢复途径? |
|
D |
配额释放 |
删除后 25 GiB / 10000 计数何时返还 |
立即?延迟?决定清理脚本怎么写 |
|
E |
自然到期 |
expires_at 到期之后的数据 |
立即销毁?宽限期?能否恢复? |
|
示意图 · 文本绘制 |
|
文本图 D 删除返回一个布尔值,和它没有回答的五个问题(纯 ASCII) +————————————————————————–+ | DELETE /files/{file_id} -> { "deleted": true } | +————————————————————————–+ | | | the response is a BOOLEAN. | | it answers exactly ONE question: did this call delete it? | | | | what it does NOT answer: | | A an in-flight request still referencing this file_id | | B deleting an already-deleted file (idempotent? 404?) | | C any record that survives the deletion | | D when the 25 GiB / 10000 quotas are released | | E natural expiry: destroy? grace period? recoverable? | | | | and GET /files returns 7 fields. none of them is: | | last_used_at reference_count last_caller_id | | | | permanent storage + no usage signal = | | you cannot tell a dead file from a hot one. | +————————————————————————–+ |
其中分支 A 最容易被忽略,因为它的失败是分布式的:
你看到的现象是「某个请求偶发失败」,而不是「删除操作有问题」。删除和请求是两个独立的调用者,它们之间没有任何官方协调机制。
分支 C 值得单独说一句。deleted: true 看起来像一句「已清理」的确认,但它不是一个凭证:
- 没有时间戳
- 没有内容摘要
- 没有签名
如果你有合规要求(例如「能证明某张图在某个时刻已被删除」),这个响应提供不了任何证据级别的信息。你需要自己在应用侧落一条带时间的审计日志。
|
一句话记住:deleted: true 是一个回答,不是一个凭证;它告诉你「这次调用做了什么」,不告诉你「现在还剩什么」。 |
八、最要命的自省盲区:列表里没有「最后使用时间」
这是本篇我认为最值得单独成节的一条。
先把 GET /files 返回的字段全列出来:
|
字段 |
类型 |
含义 |
|
id |
字符串 |
file-api-… |
|
object |
字符串 |
恒为 file |
|
bytes |
整数 |
文件体积 |
|
created_at |
整数 |
创建时间( Unix 秒) |
|
filename |
字符串 |
文件名 |
|
purpose |
字符串 |
恒为 user_data |
|
expires_at |
整数 |
仅在上传时设了过期才有 |
七个字段。请注意里面有什么,以及缺什么:
|
你需要的字段 |
官方有吗 |
|
创建时间 created_at |
有 |
|
最后访问时间 last_used_at |
没有 |
|
被引用次数 reference_count |
没有 |
|
访问它的调用方标识 |
没有 |
后果非常直接:
永久保存 + 无法判断谁在用 = 你没有任何官方依据做清理。
一个上传于 300 天前、从未被再次引用的文件,和一个上传于 300 天前、每分钟被引用一次的文件,在 GET /files 的返回里长得完全一样。
所以「清理永久文件」这件事,服务端不给你任何依据。你只有一条路:在应用侧自己记账——每次引用 file_id 时写一行日志。
这一条直接决定了第十节的巡检脚本只能做成什么样子。
|
一句话记住:列表里有 created_at,没有 last_used_at;所以「这个文件还有没有人用」这个问题,只能由你自己回答。 |
8.1 不想自己记账?那就把问题换成寿命问题
自己记账最麻烦的地方不是写代码,而是你得有一个地方存这些计数(Redis、数据库、随便什么),并且要在每一个引用点都记得写。漏一处,那部分的文件就永远进了「无记录」名单。
如果你不想引入这套东西,还有一条退路:给所有文件都设一个寿命上限,把「清理问题」转成「生命周期问题」。
|
做法 |
代价 |
适合什么场景 |
|
自己记账 + 定期清理 |
需要一个存储,且每处引用都要埋点 |
长期在用、量大、有合规要求 |
|
所有文件都带上限寿命 |
热图过期后要重传,多花一点带宽 |
图的复用窗口本来就短 |
|
全部永久 + 人工定期盘点 |
盘点时你手上没有任何依据 |
只有前两种都做不了时才选 |
第三条要特别警惕。「永久」+「没有依据」+「人工」,这三个词放在一起,实际结果就是「永远不会被清理」——因为盘点的人打开列表,看到 10000 个长得一模一样的文件,然后关掉列表。
这也是第五节那条 30 天上限的价值所在:它虽然表达不了 31 天到 1 年,但它能把「默认永久」这个最危险的默认值,换成一个安全的默认值。
九、容量账:25 GiB 能装多少,多久吃满
官方给了两个存储配额:
|
配额 |
值 |
|
单用户存储容量 |
25 GiB |
|
单用户文件个数 |
10000 个 |
|
单文件上限 |
64 MiB |
|
文件名长度上限 |
512 字符 |
|
上传超时 |
10 分钟 |
9.1 两个配额不在同一个刻度上
先做除法:
|
算法 |
计算 |
结果 |
|
按体积顶满 |
25 GiB / 64 MiB |
400 个文件 |
|
按数量顶满 |
25 GiB / 10000 |
平均每个 2.56 MiB |
|
400 占配额的比例 |
400 / 10000 |
只有 4% |
也就是说:只要 400 个满配文件就能吃满 25 GiB,而此时你连 10000 这个数字的 4% 都没用到。
两个配额相差 25 倍口径,谁先到,取决于你的文件大小。
9.2 不设过期、也不删,多久吃满
|
使用强度 |
每天增长 |
填满 25 GiB 需要 |
|
每天 20 张 x 2 MiB |
40 MiB |
640 天 |
|
每天 100 张 x 5 MiB |
500 MiB |
51.2 天 |
|
每天 100 张 x 20 MiB |
2000 MiB |
12.8 天 |
|
每天 400 张 x 64 MiB |
25600 MiB |
1 天 |
最后一行说明:在极端情况下,25 GiB 一天就能吃满。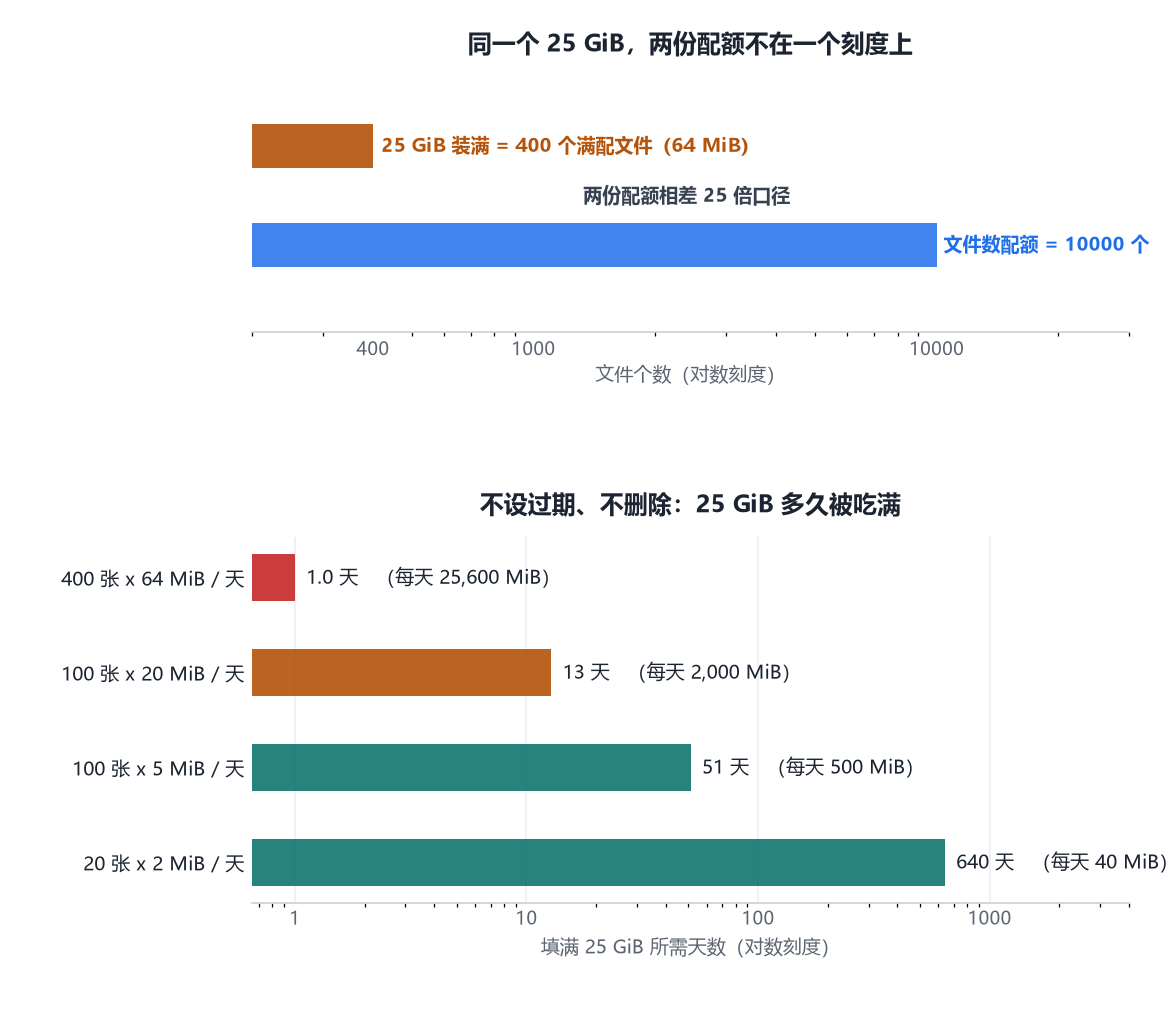 图 2 25 GiB 的两份配额不在一个刻度上,以及多久被吃满
而这也是「默认永久」最危险的地方:它不是慢慢逼近的,它是在某一天突然变成故障的。
十、巡检脚本:把永久文件变回可控状态
目标很朴素:把「永久文件」从一个看不见的状态,变成一个可度量、可告警的数字。
约束也很明确:官方不提供 last_used_at,所以你必须自己维护引用日志。
10.1 第一步:应用侧记账
在每次引用 file_id 的地方,加一行记账:
|
Python |
|
import time def note_use(file_id, redis_like): """每次请求引用某个 file_id 时,写一条使用记录。""" redis_like.hincrby("files:use", file_id, 1) redis_like.hset("files:last", file_id, int(time.time())) |
引用点通常只有一个(拼 messages 的地方),所以成本很低。
10.2 第二步:每天跑一次巡检
|
Python |
|
def audit_files(client, redis_like, stale_days=30): files, cursor = [], None while True: page = client.files.list(limit=1000, after=cursor) files.extend(page.data) if not page.has_more: break cursor = page.last_id total_bytes = sum(f.bytes for f in files) permanent = [f for f in files if getattr(f, "expires_at", None) is None] now = int(time.time()) stale = [] for f in permanent: uses = int(redis_like.hget("files:use", f.id) or 0) if uses == 0 and (now – f.created_at) > stale_days * 86400: stale.append(f) return { "count": len(files), "bytes": total_bytes, "count_pct": len(files) / 10000.0, "bytes_pct": total_bytes / (25 * 1024 ** 3), "permanent_n": len(permanent), "permanent_pct": len(permanent) / max(1, len(files)), "stale_n": len(stale), "unaccounted_n": sum(1 for f in files if int(redis_like.hget("files:use", f.id) or 0) == 0), } |
10.3 第三步:四条告警规则
|
维度 |
触发条件 |
对应哪个错觉 |
|
容量 |
bytes_pct > 0.80 |
错觉三:配额比你想象的近 |
|
计数 |
count_pct > 0.80 |
错觉三:两个配额口径不同 |
|
永久占比 |
permanent_pct > 0.30 |
错觉一:默认永久,会静默累积 |
|
无记录文件 |
unaccounted_n > 0 |
错觉五:你无法判断它是否还在用 |
第 4 条最关键:unaccounted_n 大于 0,说明有文件你从来没有记录过使用。
而这通常不是异常,是常态——除非你从第一天就开了记账。
10.4 第四步:把「该不该永久」变成上传期的决策
最省事的做法是:默认给所有上传都带一个过期时间,只有明确需要长期复用的才省略。
|
Python |
|
def upload(client, path, keep_days=None): """keep_days=None 表示永久;否则带过期时间上传。""" kw = {"purpose": "user_data"} if keep_days is not None: kw["extra_body"] = { "expires_after": { "anchor": "created_at", "seconds": max(3600, min(2592000, int(keep_days * 86400))), } } with open(path, "rb") as fh: return client.files.create(file=fh, **kw) |
注意这里那个 min(2592000, …):它不是为了防御,而是因为 31 天会直接被拒。 这就是第三节那个断层在代码里的样子。
十一、迁移检查清单
如果你准备(或者已经)用上 Files API,这 15 条建议逐条过一遍。
|
# |
检查项 |
为什么 |
|
1 |
所有上传是否显式传了 purpose="user_data" |
该字段必填,且只接受这一个值 |
|
2 |
是否有意使用「永久」 |
省略 expires_after 就是永久,请确认这是你的意图 |
|
3 |
是否需要 31 天到 1 年之间的寿命 |
官方表达不出来,必须改需求或改设计 |
|
4 |
上传时有没有设超时 |
官方要求 10 分钟内完成 |
|
5 |
文件名是否可能超过 512 字符 |
生成的文件名容易超 |
|
6 |
列表代码是否写了翻页循环 |
默认值 1000 vs 20 ,不翻页就漏 |
|
7 |
列表代码是否显式传了 limit |
不要依赖默认值 |
|
8 |
删除后的判空逻辑是否可靠 |
deleted 与 type 两种形状 |
|
9 |
created_at 是否做了跨协议兼容 |
整数 vs RFC 3339 字符串 |
|
10 |
是否记录了每次 file_id 的使用 |
官方没有 last_used_at ,只能自己记 |
|
11 |
是否有配额告警 |
25 GiB / 10000 ,两个口径都要盯 |
|
12 |
是否有永久文件占比告警 |
默认永久会静默累积 |
|
13 |
Anthropic 侧是否统一带了 beta 头 |
缺失该头的失败方式官方未写 |
|
14 |
beta 头取值是否放在配置里 |
它是上游的版本号,可能被轮换 |
|
15 |
原始图片有没有独立备份 |
file_id 应视为可再生的缓存 |
如果只能记住三条,我建议是 2、6、10:
- 2 决定你的成本曲线会不会在某天突然垂直上升;
- 6 决定你会不会在换协议之后「丢掉」98% 的文件;
- 10 决定你有没有能力做任何清理。
十二、未验证的边界与写在最后
这一节有四部分:还没被验证的边界、一个和第 9 篇重复出现的发现、把全文收成一页纸,以及这个系列走到哪里了。
如果你今天只打算记一件事,请直接跳到 12.3 那张表。
12.1 十二条还没被验证的边界
以下全部来自官方文档的沉默区。它们不影响本文任何结论,但会决定你在生产环境的取舍。
|
# |
未验证的问题 |
|
1 |
存储本身是否计费( Files API 与定价页均未提存储费用) |
|
2 |
轮换 API key 后,旧文件是否仍可访问 |
|
3 |
同账号下多把 Key 是否共享文件命名空间 |
|
4 |
删除已被删除的文件:返回 deleted: true 还是 404 (幂等性) |
|
5 |
在途请求引用某文件时删除它,会发生什么 |
|
6 |
expires_at 到期后数据的处置(立即销毁 / 宽限期 / 可否恢复) |
|
7 |
配额在删除后何时释放 |
|
8 |
purpose 传别的值:报错还是静默忽略 |
|
9 |
OpenAI 侧 limit 默认 1000 与 Anthropic 侧 20 ,是否有意为之 |
|
10 |
两种删除响应形状哪个是规范 |
|
11 |
同一 file_id 能否同时被两套格式引用(文档说可以,但没给例子) |
|
12 |
file_id 的格式是否可预测(是否可枚举) |
其中最想验证的三条:
好消息是:这三条里有两条,只需要一次只读、零 token 消耗的 GET /files 就能部分回答。
12.2 和第 9 篇一样的那个发现
上一篇文章里,我发现 GET /models 这个接口在官方变更日志里没有任何上线条目。
这一篇我又检索了一次,关键词是 Files API 相关的六个词:
|
检索词 |
变更日志命中 |
|
Files API |
0 |
|
file_id |
0 |
|
files-api-2025-04-14 |
0 |
|
storage |
0 |
|
vision limits |
0 |
|
file upload |
1 (但指的是模型优化,不是 Files API ) |
唯一那条「file upload」命中来自 2024-12-10 的一条模型更新(原文):
Additionally, the new version of the model has optimized the user experience for file upload and webpage summarization functionalities.
注意:这句说的是「模型对文件上传场景的体验做了优化」,不是说「新增了文件上传接口」。这是两件完全不同的事。
所以结论是:Files API 是又一次「安静上线」。
一个引入了持久化存储、配额、过期策略、跨协议差异的子系统,在官方变更日志里没有任何上线条目。这和上一篇文章里 /models 的情况一模一样。
这里补一句方法论:「官方有没有为某件事提供接口」和「官方有没有为这件事发公告」,是两个独立的问题。 只订阅变更日志,会漏掉那些「安静地加了但没宣传」的能力。
12.3 把五个错觉收成一句话
|
错觉 |
一句话 |
|
一、文件会过期 |
不写 expires_after 就是永久; expires_at 为空就是永久文件 |
|
二、两套 API 是同一套 |
换 base_url 不等于换语言,字段名全不一样 |
|
三、限额是给你用的 |
三个上限互相打架,生效的是最先撞上的那条 |
|
四、文件是我的 |
归属单位是 API key ,不是账号 |
|
五、删了就没了 |
deleted: true 是回答,不是凭证 |
12.4 这个系列走到哪了
|
# |
角度 |
|
1 |
定价结构:降价的不是输出价 |
|
2 |
思考模式:一个 tools 参数决定推理链去哪 |
|
3 |
工具调用:为什么 schema 管不住模型 |
|
4 |
1M 长上下文:塞得进去,不等于看得见 |
|
5 |
成本治理:默认开着的那个开关 |
|
6 |
本地部署:从 7B 谣言到 763B 现实 |
|
7 |
视觉输入:图传进去了,为什么还是用不起来 |
|
8 |
模型名静默接管:代码一行没改,模型已经换了 |
|
9 |
模型自省:你问「你是谁」,它只答「我能干什么」 |
|
10 |
文件仓库:少写一个参数,文件就永久留在他服务器上 |
本文的数据来源与口径:
|
来源 |
用途 |
|
Files API 指南 |
上传 / 列表 / 详情 / 删除、配额、两套格式对照 |
|
Create File / List Files / Retrieve File / Delete File 接口文档 |
字段级 schema |
|
Vision 指南 Limits 段 |
48 MiB / 32 MiB / 64 MiB / 600 张 / 200 MiB |
|
Anthropic API 指南 |
anthropic-beta 的支持状态与 beta 头取值 |
|
Models & Pricing |
文中所有单价 |
|
Change Log |
第 12.2 节的零条目检索 |
所有推算部分都可以用纯标准库脚本复算,不依赖任何 API 调用。数据截止 2026 年 10 月 7 日。
12.5 写在最后
这个系列写到现在十篇,有一条线索一直在重复:
官方文档里最危险的不是写错的地方,而是写得很短的地方。
Omit both expires_after fields to keep the file permanently —— 一句话,一个默认值,一个永久承诺。
Files belong to your API key —— 一句话,一个归属声明,三个未定义问题。
the response is a BOOLEAN —— 严格来说这句官方没写,但响应确实只有一个布尔。
你要做的事很简单:把每一个「默认值」都当成一个设计决策来审查,而不是当成一个「不填就行」的空格。
因为默认值是唯一一种不需要你写代码、也不需要你 review、就能永久生效的配置。


评论前必须登录!
注册