 网硕互联帮助中心
Redis集群实战:3主3从与容器部署
文章目录
- Redis集群实战:3主3从与容器部署
-
- redis集群(3主3从)
-
- 一、核心概念
- 二、工作原理
- 三、使用场景
- 四、操作步骤(3 主 3 从实战)
- redis1
- redis2
-
- 容器部署redis
-
- 容器部署基础
redis集群(3主3从)
Redis 集群(Cluster)是 Redis 3.0+ 官方推出的分布式解决方案,核心是数据分片(Sharding)+ 主
从复制 + 去中心化故障转移,解决单机 Redis 的容量、性能、单点故障瓶颈,实现水平扩展、高可用、
高并发。
一、核心概念
1. 基本定义
Redis 集群是无中心架构的分布式系统,数据自动分散到多个节点,每个节点只存部分数据;节点间通过Gossip 协议通信,自带故障转移,无需 Sentinel。
2. 关键角色
主节点(Master):处理读写、管理哈希槽、参与故障投票,是核心节点。
从节点(Replica/Slave):异步复制主节点数据,默认只读;主节点宕机时自动选举晋升为主。
哈希槽(Hash Slot):集群固定16384个槽(0~16383),是数据分片的最小单位。
节点 ID:每个节点唯一标识,用于集群内识别与通信。
3. 核心特性
数据分片:突破单机内存限制,总容量 = 所有主节点内存之和。
高可用:部分节点故障不影响整体,自动故障转移。
线性扩展:加节点即可提升容量与并发。
去中心化:无中心节点,避免单点瓶颈。
自动路由:客户端连接任意节点,自动重定向到目标节点。
二、工作原理
1. 数据分片(哈希槽机制)
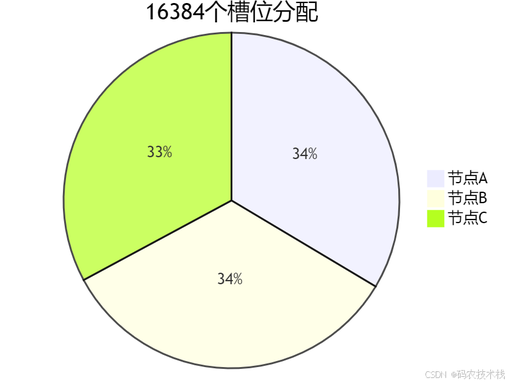
槽位总数:16384(2¹⁴)。
键→槽映射
HASH_SLOT = CRC16(key) mod 16384
槽位分配
:每个主节点负责一段连续槽位(如 3 主集群:0-5460、5461-10922、10923-16383)。
2. 节点通信(Gossip 协议)
节点间通过集群总线(独立端口,默认 + 10000)通信。
消息类型:
PING/PONG:心跳检测、状态同步。
FAIL:广播节点失效。
UPDATE:槽位映射、集群拓扑更新。
3. 请求路由流程
客户端连接任意节点,发送命令。
节点计算 key 所属槽位。
槽位归属本节点→直接处理;否则→返回MOVED重定向。
智能客户端缓存槽位映射,减少重定向。
4. 故障转移(高可用)
故障检测:某主节点超时无响应,多数主节点标记为FAIL 。
从节点选举:该主节点的从节点发起FAILOVER请求。
投票晋升:主节点投票通过,从节点升级为主,接管槽位。
拓扑更新:Gossip 同步新状态,集群恢复。
5. 数据一致性
异步复制:主从复制异步,存在短暂数据不一致。
最终一致性:故障转移后数据最终一致,不保证强一致。
写安全:多数主节点可达时,写操作尽量保留。
三、使用场景
1. 海量数据存储(>100GB)
电商商品库、用户画像、社交内容、IoT 设备数据。
突破单机内存上限,分布式存储海量热数据。
2. 高并发读写(QPS≥5 万)
秒杀、抢购、热点评论、实时排行榜。
多主节点并行处理,并发能力线性提升。
强事务、多键跨槽操作(如MSET多键不同槽)。
数据量小、低并发(哨兵 / 主从更简单)。
需强一致性(可搭配分布式事务)。
四、操作步骤(3 主 3 从实战)
架构
| Centos7.9 | 192.168.108.21 | redis1 |
| Centos7.9 | 192.168.108.22 | redis2 |
| Centos7.9 | 192.168.108.23 | redis3 |
| Centos7.9 | 192.168.108.24 | redis4 |
| Centos7.9 | 192.168.108.25 | redis5 |
| Centos7.9 | 192.168.108.26 | redis6 |
cluster集群是Redis从3.0版本开始支持,自带的一种集群方式。它的原理使用了分布的思想,其数据会均分到所有的主节点上。此部署方式,当数据量过大时,会让服务器均摊压力。在各个主节点上分配的数据都不是全量的。是分片存储的。目前此种部署方式在生产环境的较多。至少六台,三台主,三台从。
目的:同时解决高可用、海量数据存储和高并发读写的问题,即分布式扩展。
原理:Redis Cluster 是 Redis 官方提供的分布式数据库解决方案。它通过数据分片 (Sharding)
进行数据存储,并通过多主多从架构来实现高可用。
准备6台安装了redis的虚拟机同时操作:关闭防火墙,修改配置文件
配置
所有主机操作
#修改配置文件
[root@localhost ~]# systemctl stop firewalld
[root@localhost ~]# cd /usr/local/redis-6.2.14/
[root@localhost redis-6.2.14]# vim redis.conf
#监听地址
75 bind 0.0.0.0 -::1
#启动cluster集群
1387 cluster-enabled yes
#启动Redis
[root@localhost redis-6.2.14]# redis-server redis.conf &
#查看启动端口
[root@redis1 redis-6.2.14]# netstat -anpt | grep redis
tcp 000.0.0.0:6379 0.0.0.0:* LISTEN
55036/redis-server
tcp 000.0.0.0:16379 0.0.0.0:* LISTEN
55036/redis-server
tcp6 00 ::1:6379 :::* LISTEN
55036/redis-server
tcp6 00 ::1:16379 :::* LISTEN
55036/redis-server
任意一台即可
[root@redis1 redis-6.2.14]# redis-cli –cluster create 192.168.108.21:6379
192.168.108.22:6379 192.168.108.23:6379 192.168.108.24:6379 192.168.108.25:6379
192.168.108.26:6379 –cluster-replicas 1
>>> Performing hash slots allocation on 6 nodes...
Master[0] –> Slots 0-5460
Master[1] –> Slots 5461-10922
Master[2] –> Slots 10923-16383
Adding replica 192.168.108.25:6379 to 192.168.108.21:6379
Adding replica 192.168.108.26:6379 to 192.168.108.22:6379
Adding replica 192.168.108.24:6379 to 192.168.108.23:6379
M: fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379
slots:[0-5460] (5461 slots) master #[0-5460]是负责槽位0-5064,
(5461 slots) 是共5461个槽位
M: f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379
slots:[5461-10922] (5462 slots) master
M: 90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379
slots:[10923-16383] (5461 slots) master
S: 95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379
replicates 90507dea1ca425cfe6ca993f8c453b2377ded5f0
S: 18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379
replicates fcbf04a3649f4e9e6b381861a94393c31eb67e67
S: 8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379
replicates f3cb00b07a7836666bd3fd391040ff308ad35685
Can I set the above configuration? (type 'yes' to accept): yes#回答yes
>>> Nodes configuration updated
>>> Assign a different config epoch to each node
55036:M 03 Feb 202611:35:48.414 # configEpoch set to 1 via CLUSTER SET-CONFIG-
EPOCH
>>> Sending CLUSTER MEET messages to join the cluster
55036:M 03 Feb 202611:35:48.445 # IP address for this node updated to
192.168.108.21
Waiting for the cluster to join
55036:M 03 Feb 202611:35:49.510 * Replica 192.168.108.25:6379 asks for
synchronization
55036:M 03 Feb 202611:35:49.510 * Partial resynchronization not accepted:
Replication ID mismatch (Replica asked for
'5ada9eaab85561721d9411eee29d9e15bf2b87b1', my replication IDs are
'868d3acb992f408196b2367647b0cf6c3e02912a' and
'0000000000000000000000000000000000000000')
55036:M 03 Feb 202611:35:49.510 * Replication backlog created, my new
replication IDs are 'cef440df5f9f0706ac9ab7e60a450839e702f045' and
'0000000000000000000000000000000000000000'
55036:M 03 Feb 202611:35:49.510 * Starting BGSAVE for SYNC with target: disk
55036:M 03 Feb 202611:35:49.606 * Background saving started by pid 55327
>>> Performing Cluster Check (using node192.168.108.21:6379)
M: fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379
slots:[0-5460] (5461 slots) master
1 additional replica(s)
S: 8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379
slots: (0 slots) slave
replicates f3cb00b07a7836666bd3fd391040ff308ad35685
S: 95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379
slots: (0 slots) slave
replicates 90507dea1ca425cfe6ca993f8c453b2377ded5f0
M: 90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379
slots:[10923-16383] (5461 slots) master
1 additional replica(s)
S: 18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379
slots: (0 slots) slave
replicates fcbf04a3649f4e9e6b381861a94393c31eb67e67
M: f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379
slots:[5461-10922] (5462 slots) master
1 additional replica(s)
55327:C 03 Feb 202611:35:49.733 * DB saved on disk
55327:C 03 Feb 202611:35:49.733 * RDB: 4 MB of memory used by copy-on-write
55036:M 03 Feb 202611:35:49.736 * Background saving terminated with success
55036:M 03 Feb 202611:35:49.737 * Synchronization with replica
192.168.108.25:6379 succeeded
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
[root@redis1 redis-6.2.14]# 55036:M 03 Feb 2026 11:35:53.476 # Cluster state
changed: ok
查看集群状态
[root@redis1 redis-6.2.14]# redis-cli
127.0.0.1:6379> cluster nodes
8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379@16379 slave
f3cb00b07a7836666bd3fd391040ff308ad35685 017700898970002 connected
95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379@16379 slave
90507dea1ca425cfe6ca993f8c453b2377ded5f0 017700899003143 connected
90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379@16379 master -0
17700898980003 connected 10923-16383
18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379@16379 slave
fcbf04a3649f4e9e6b381861a94393c31eb67e67 017700898990001 connected
f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379@16379 master -0
17700898992672 connected 5461-10922
fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379@16379 myself,master
-017700898990001 connected 0-5460
127.0.0.1:6379> cluster info
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:6
cluster_my_epoch:1
cluster_stats_messages_ping_sent:1134
cluster_stats_messages_pong_sent:1172
cluster_stats_messages_sent:2306
cluster_stats_messages_ping_received:1167
cluster_stats_messages_pong_received:1134
cluster_stats_messages_meet_received:5
cluster_stats_messages_received:2306
创建数据
创建数据需要到提示的地方创建;或者在redis-cli -c的命令创建数据
redis1
127.0.0.1:6379> set name gqd
(error) MOVED 5798192.168.108.22:6379 #提示在redis2操作
# redis2
127.0.0.1:6379> set name 'gqd'
OK
127.0.0.1:6379> get name
"gqd"
# redis1
127.0.0.1:6379> get name #创建,查看都只能在redis2
(error) MOVED 5798192.168.108.22:6379
#如何创建集群能够看到的
[root@redis1 redis-6.2.14]# redis-cli -c
127.0.0.1:6379> set age 18
OK
127.0.0.1:6379> get age
"18"
[root@redis3 redis-6.2.14]# redis-cli -c
127.0.0.1:6379> get age
–> Redirected to slot [741] located at 192.168.108.21:6379
"18"
模拟故障
关掉redis1节点,再次查看集群信息
[root@redis1 redis-6.2.14]# init 0
# redis 2
127.0.0.1:6379> cluster info
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:7
cluster_my_epoch:2
cluster_stats_messages_ping_sent:1486
cluster_stats_messages_pong_sent:1419
cluster_stats_messages_meet_sent:1
cluster_stats_messages_fail_sent:5
cluster_stats_messages_auth-ack_sent:1
cluster_stats_messages_sent:2912
cluster_stats_messages_ping_received:1419
cluster_stats_messages_pong_received:1487
cluster_stats_messages_fail_received:1
cluster_stats_messages_auth-req_received:1
cluster_stats_messages_received:2908
查看节点信息
结果可知,仍保持3台master,原来的redis5节点被选举为新master节点
redis2
127.0.0.1:6379> cluster nodes
90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379@16379 master -0
17700911760003 connected 10923-16383
18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379@16379 master -0
17700911774327 connected 0-5460
f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379@16379 myself,master
-017700911750002 connected 5461-10922
8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379@16379 slave
f3cb00b07a7836666bd3fd391040ff308ad35685 017700911740002 connected
95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379@16379 slave
90507dea1ca425cfe6ca993f8c453b2377ded5f0 017700911764223 connected
fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379@16379 master,fail –
177009114369517700911400001 connected
再把redis 业务修复,看集群状态
完整过程
如果你的 Redis Cluster 中192.168.108.21:6379** (Master 1)挂掉**,而它的从节点192.168.108.25:6379仍然存活,那么整个集群会自动完成故障转移(failover),服务不会中断,数据也不会丢失。下面详细说明会发生什么:
🧩当前角色回顾(基于你之前的cluster nodes输出)
| 192.168.108.21 | Master | 0 – 5460 | ← 由 .25 复制 |
| 192.168.108.25 | Slave | (无槽) | 复制 .21 |
其他节点(.22/.26 , .23/.24 )正常运行。
🔥如果192.168.108.21挂掉,会发生什么?✅第 1 步:故障检测(约 15 秒内)
其他 master 节点(.22和.23 )通过Gossip 协议发现.21无响应。
经过cluster-node-timeout (默认 15 秒)后:
多数 master(≥2/3)将其标记为FAIL(客观下线)。
⏱️在这 15 秒内,访问槽 [0–5460] 的请求会失败或超时。
✅第 2 步:Slave .25自动发起选举
.25 (原.21的 slave)检测到 master 已 FAIL。
等待一个短暂随机延迟(通常 < 1 秒),然后向其他master 节点(.22和.23** )**请求投票。
✅第 3 步:获得多数票,晋升为新 Master
.22和.23收到请求后,验证.25是合法副本。
因为有2 个 master 投票(超过半数),.25成功当选。
.25 执行:
SLAVEOF NO ONE
并接管槽 0–5460。
✅第 4 步:集群拓扑更新,恢复服务
所有节点收到通知,更新集群视图:
.25变为master
槽0–5460的 owner 变为.25
集群状态重新变为:
cluster_state: ok cluster_slots_fail: 0
客户端再次写入 key(如SET user:1001 “Alice” ,假设其槽在 0–5460):
自动重定向到192.168.108.25:6379
操作成功!
📊故障前后对比
| Master 节点 | .21, .22, .23 | .25, .22, .23 |
| Slave 节点 | .25, .26, .24 | (.25 已晋升,剩下 .26, .24) |
| 槽覆盖 | 0–16383 | 0–16383(完整) |
| 集群状态 | ok | 短暂 fail → 恢复为 ok |
| 数据完整性 | 完整 | 完整(无丢失) |
| 客户端影响 | 写入槽 0–5460 暂时失败(< 30 秒) | 自动恢复 |
✅整个过程全自动,无需人工干预!
❗极端情况:如果.21和.25同时挂掉?
槽0–5460 将无人负责
集群状态变为:
cluster_state: fail cluster_slots_fail: 5461
所有涉及这些槽的读写都会失败(返回(error) CLUSTERDOWN The cluster is down )
必须手动恢复.21或.25才能恢复服务。
🔒这就是为什么主从节点必须部署在不同物理机/可用区!
🔧如何验证?(动手测试)
# 1. 在 redis1 (.21) 上停止 Redis
systemctl stop redis
# 2. 在 redis2 (.22) 上观察集群状态
redis-cli -c-h192.168.108.22 -p6379 cluster nodes
你会看到:
.21状态变为fail?→fail #faile?状态停留很短暂
.25角色从slave变为master ,并拥有0-5460槽
几十秒后,cluster info显示cluster_state:ok
✅总结
| 仅 .21 (master)挂 | ✅ 是 | ✅ 是 | ✅ 是(由 .25 接管) |
| .21 + .25 同时挂 | ❌ 否 | ⚠️ 槽 0–5460 不可用 | ❌ 否 |
你当前的3主3从架构完全能容忍任意一个 master 宕机,这是 Redis Cluster 高可用的核心价值!
挂掉radis5测试
[root@redis5 redis-6.2.14]# init 0
[root@redis2 redis-6.2.14]# redis-cli -c -h 192.168.108.22 -p 6379 cluster nodes
90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379@16379 master -0
17700923432253 connected 10923-16383
18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379@16379 master,fail –
177009224633817700922432117 connected 0-5460
f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379@16379 myself,master
-017700923410002 connected 5461-10922
8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379@16379 slave
f3cb00b07a7836666bd3fd391040ff308ad35685 017700923420002 connected
95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379@16379 slave
90507dea1ca425cfe6ca993f8c453b2377ded5f0 017700923452593 connected
fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379@16379 master,fail –
177009114369517700911400001 connected
[root@redis2 redis-6.2.14]# redis-cli -c -h 192.168.108.22 -p 6379 cluster info
cluster_state:fail #集群状态fail
cluster_slots_assigned:16384
cluster_slots_ok:10923
cluster_slots_pfail:0
cluster_slots_fail:5461
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:7
cluster_my_epoch:2
cluster_stats_messages_ping_sent:2545
cluster_stats_messages_pong_sent:2417
cluster_stats_messages_meet_sent:1
cluster_stats_messages_fail_sent:5
cluster_stats_messages_auth-ack_sent:1
cluster_stats_messages_sent:4969
cluster_stats_messages_ping_received:2417
cluster_stats_messages_pong_received:2545
cluster_stats_messages_fail_received:2
cluster_stats_messages_auth-req_received:1
cluster_stats_messages_received:4965
恢复集群监控
将关掉的两台服务器开机,开启redis服务即可
# 集群
[root@redis2 redis-6.2.14]# redis-cli -c -h 192.168.108.22 -p 6379 cluster info
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:7
cluster_my_epoch:2
cluster_stats_messages_ping_sent:3130
cluster_stats_messages_pong_sent:2952
cluster_stats_messages_meet_sent:1
cluster_stats_messages_fail_sent:5
cluster_stats_messages_auth-ack_sent:1
cluster_stats_messages_sent:6089
cluster_stats_messages_ping_received:2952
cluster_stats_messages_pong_received:3130
cluster_stats_messages_fail_received:3
cluster_stats_messages_auth-req_received:1
cluster_stats_messages_received:6086
[root@redis2 redis-6.2.14]# redis-cli -c -h 192.168.108.22 -p 6379 cluster nodes
90507dea1ca425cfe6ca993f8c453b2377ded5f0 192.168.108.23:6379@16379 master -0
17700929777823 connected 10923-16383
18b45e542ebbf318fd9a92cfe2adcde4c255c72b 192.168.108.25:6379@16379 master -0
17700929788167 connected 0-5460
f3cb00b07a7836666bd3fd391040ff308ad35685 192.168.108.22:6379@16379 myself,master
-017700929770002 connected 5461-10922
8f5e04a03ae0984d843dab8fb9cd0cc4c4537624 192.168.108.26:6379@16379 slave
f3cb00b07a7836666bd3fd391040ff308ad35685 017700929770002 connected
95fd02ecaf3fb34822fd56ed7ae61b05d782d892 192.168.108.24:6379@16379 slave
90507dea1ca425cfe6ca993f8c453b2377ded5f0 017700929767653 connected
fcbf04a3649f4e9e6b381861a94393c31eb67e67 192.168.108.21:6379@16379 slave
18b45e542ebbf318fd9a92cfe2adcde4c255c72b 017700929770007 connected
容器部署redis
docker容器方式安装
[root@localhost ~]# docker run –name redis -p 6379:6379 -d -v /data/redis:/data
redis
[root@localhost ~]# docker exec redis redis-cli info server
# Server
redis_version:8.6.0
redis_git_sha1:00000000
redis_git_dirty:1
redis_build_id:a7d515010e105f80
redis_mode:standalone
os:Linux 4.18.0-553.6.1.el8.x86_64 x86_64
arch_bits:64
monotonic_clock:POSIX clock_gettime
multiplexing_api:epoll
atomicvar_api:c11-builtin
gcc_version:14.2.0
process_id:1
process_supervised:no
run_id:a2ee2aa49069ff42d23ca8d46f82d3ac61f1d385
tcp_port:6379
server_time_usec:1770950461439156
uptime_in_seconds:109
uptime_in_days:0
hz:10
configured_hz:10
lru_clock:9342781
executable:/data/redis-server
config_file:
io_threads_active:0
listener0:name=tcp,bind=*,bind=-::*,port=6379
[root@localhost ~]#
[root@localhost ~]# docker exec redis redis-cli set name ma
OK
[root@localhost ~]# docker exec redis redis-cli set age 18
OK
[root@localhost ~]# docker exec redis redis-cli get name
ma
[root@localhost ~]# docker exec redis redis-cli get age
18
[root@localhost ~]# docker exec redis redis-cli save
OK
[root@localhost ~]# ls /data/redis/ -1
dump.rdb
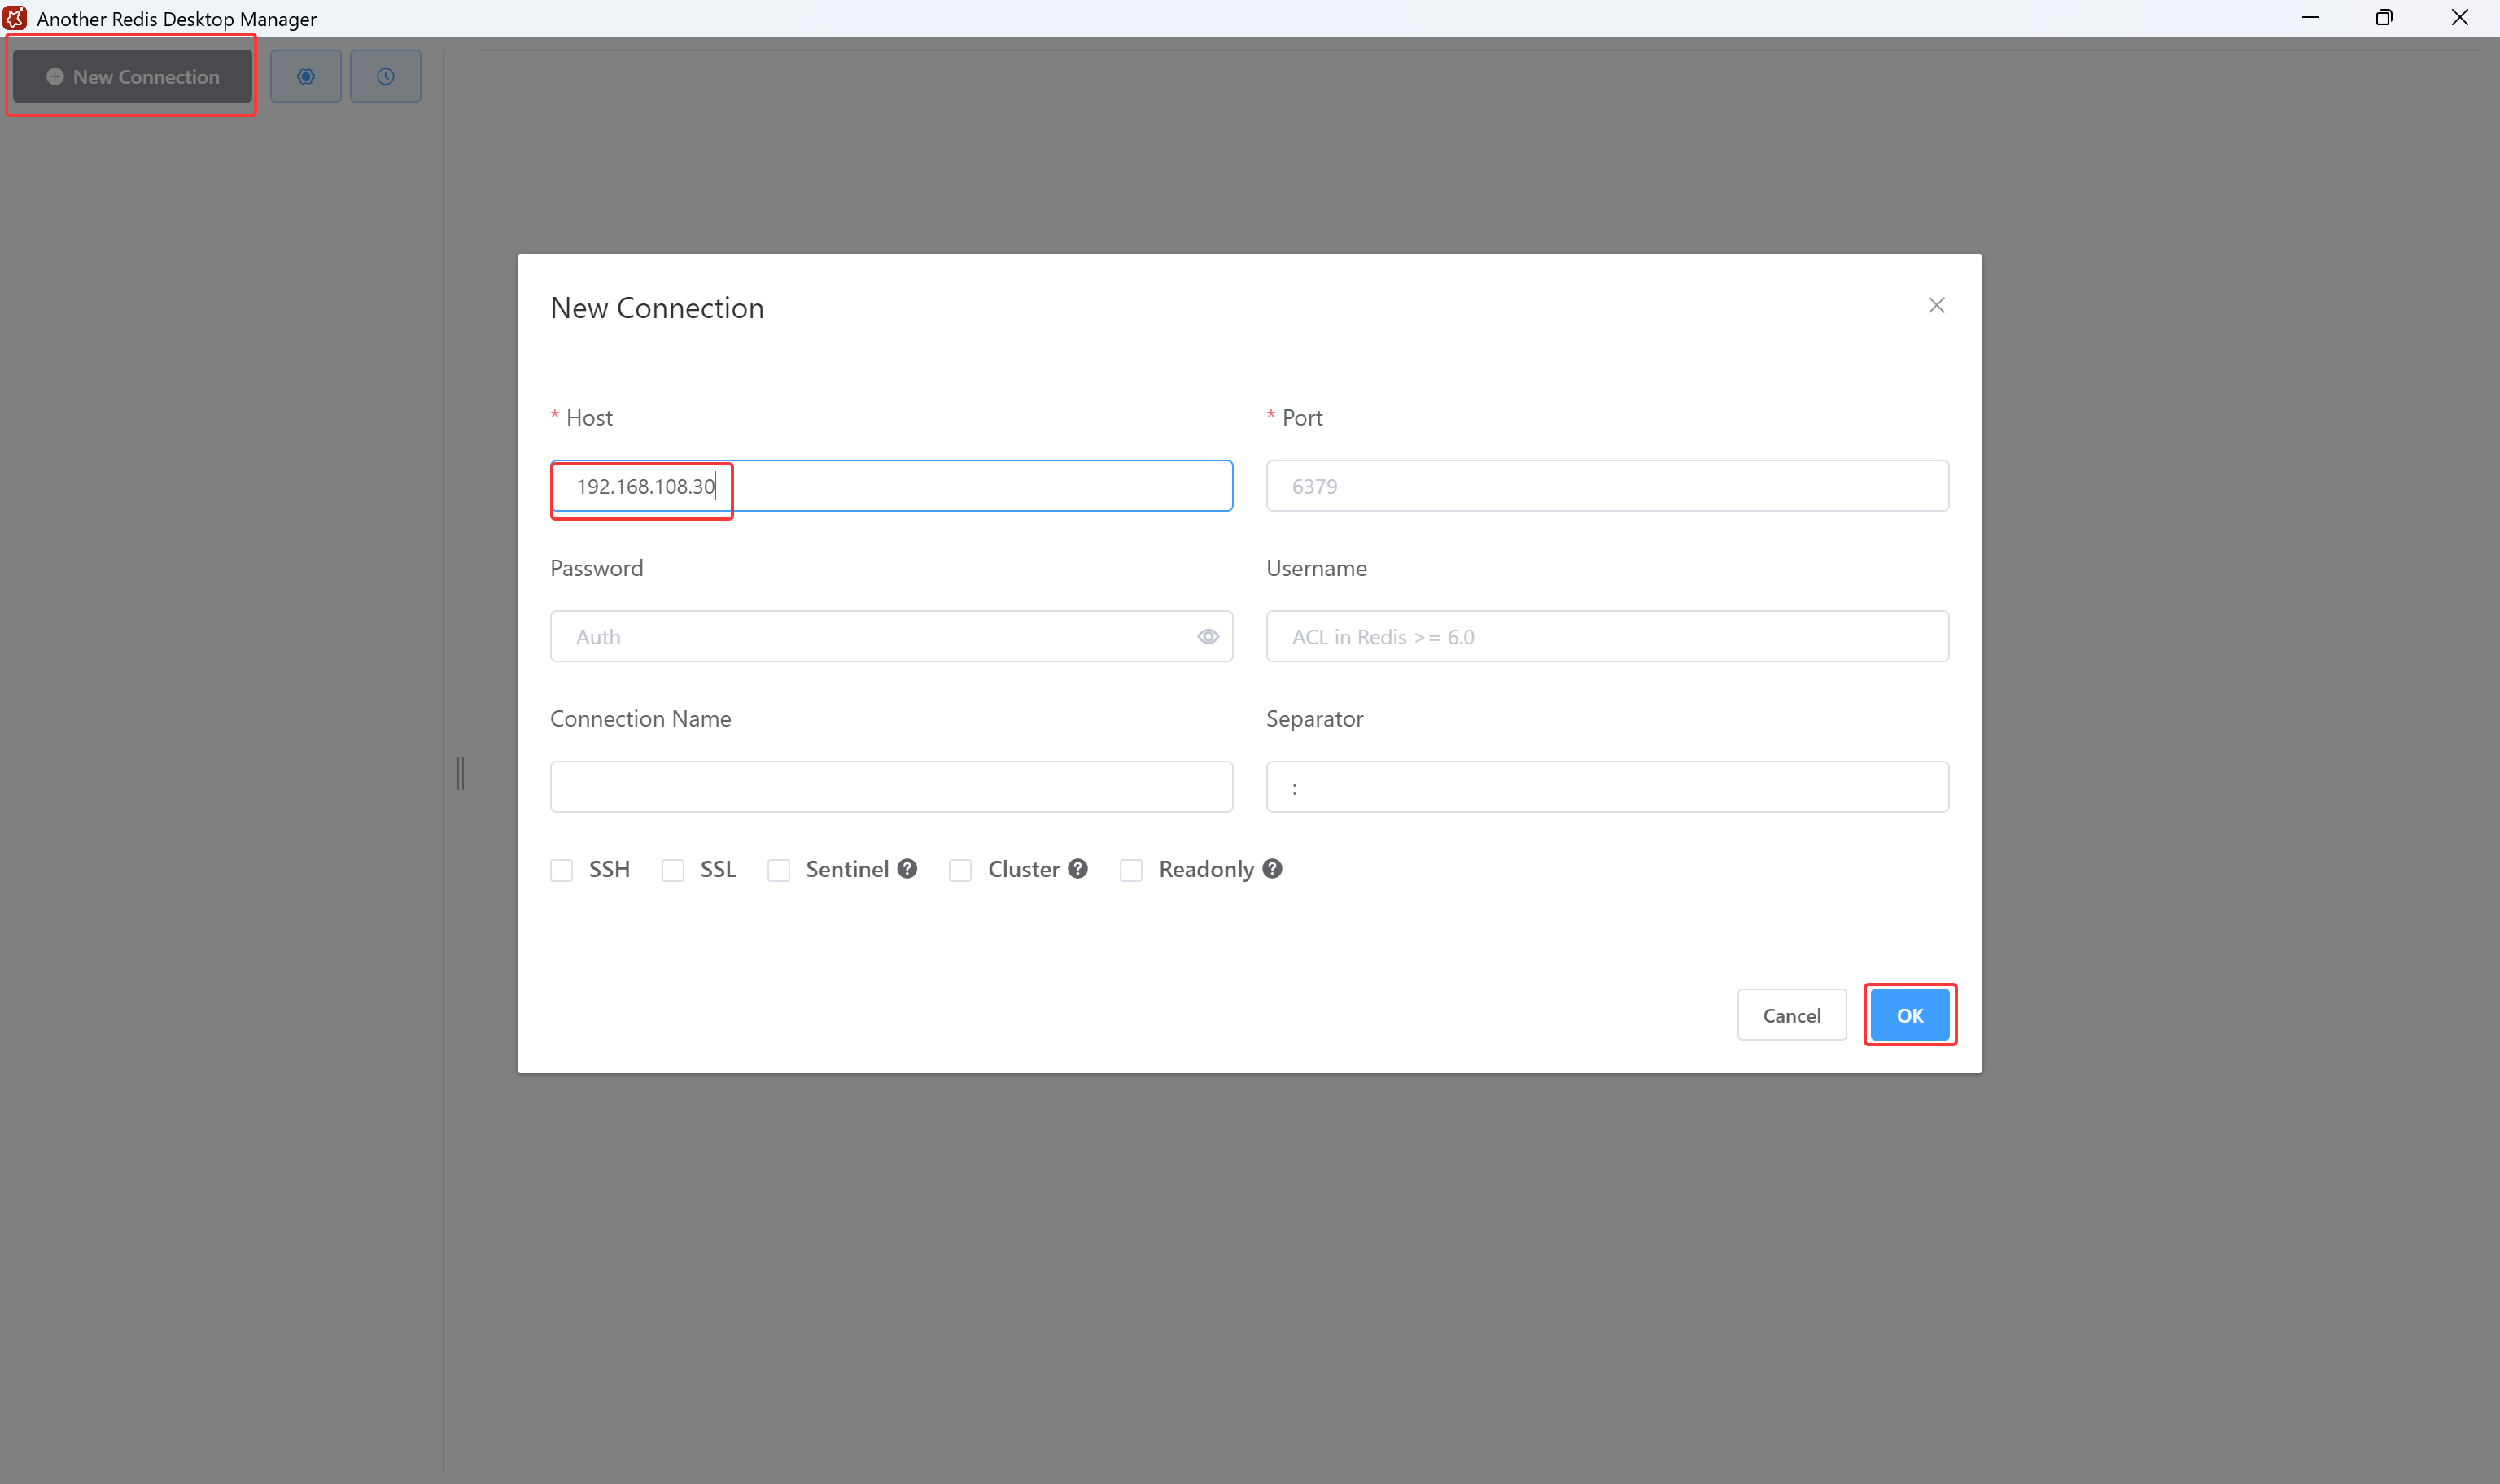
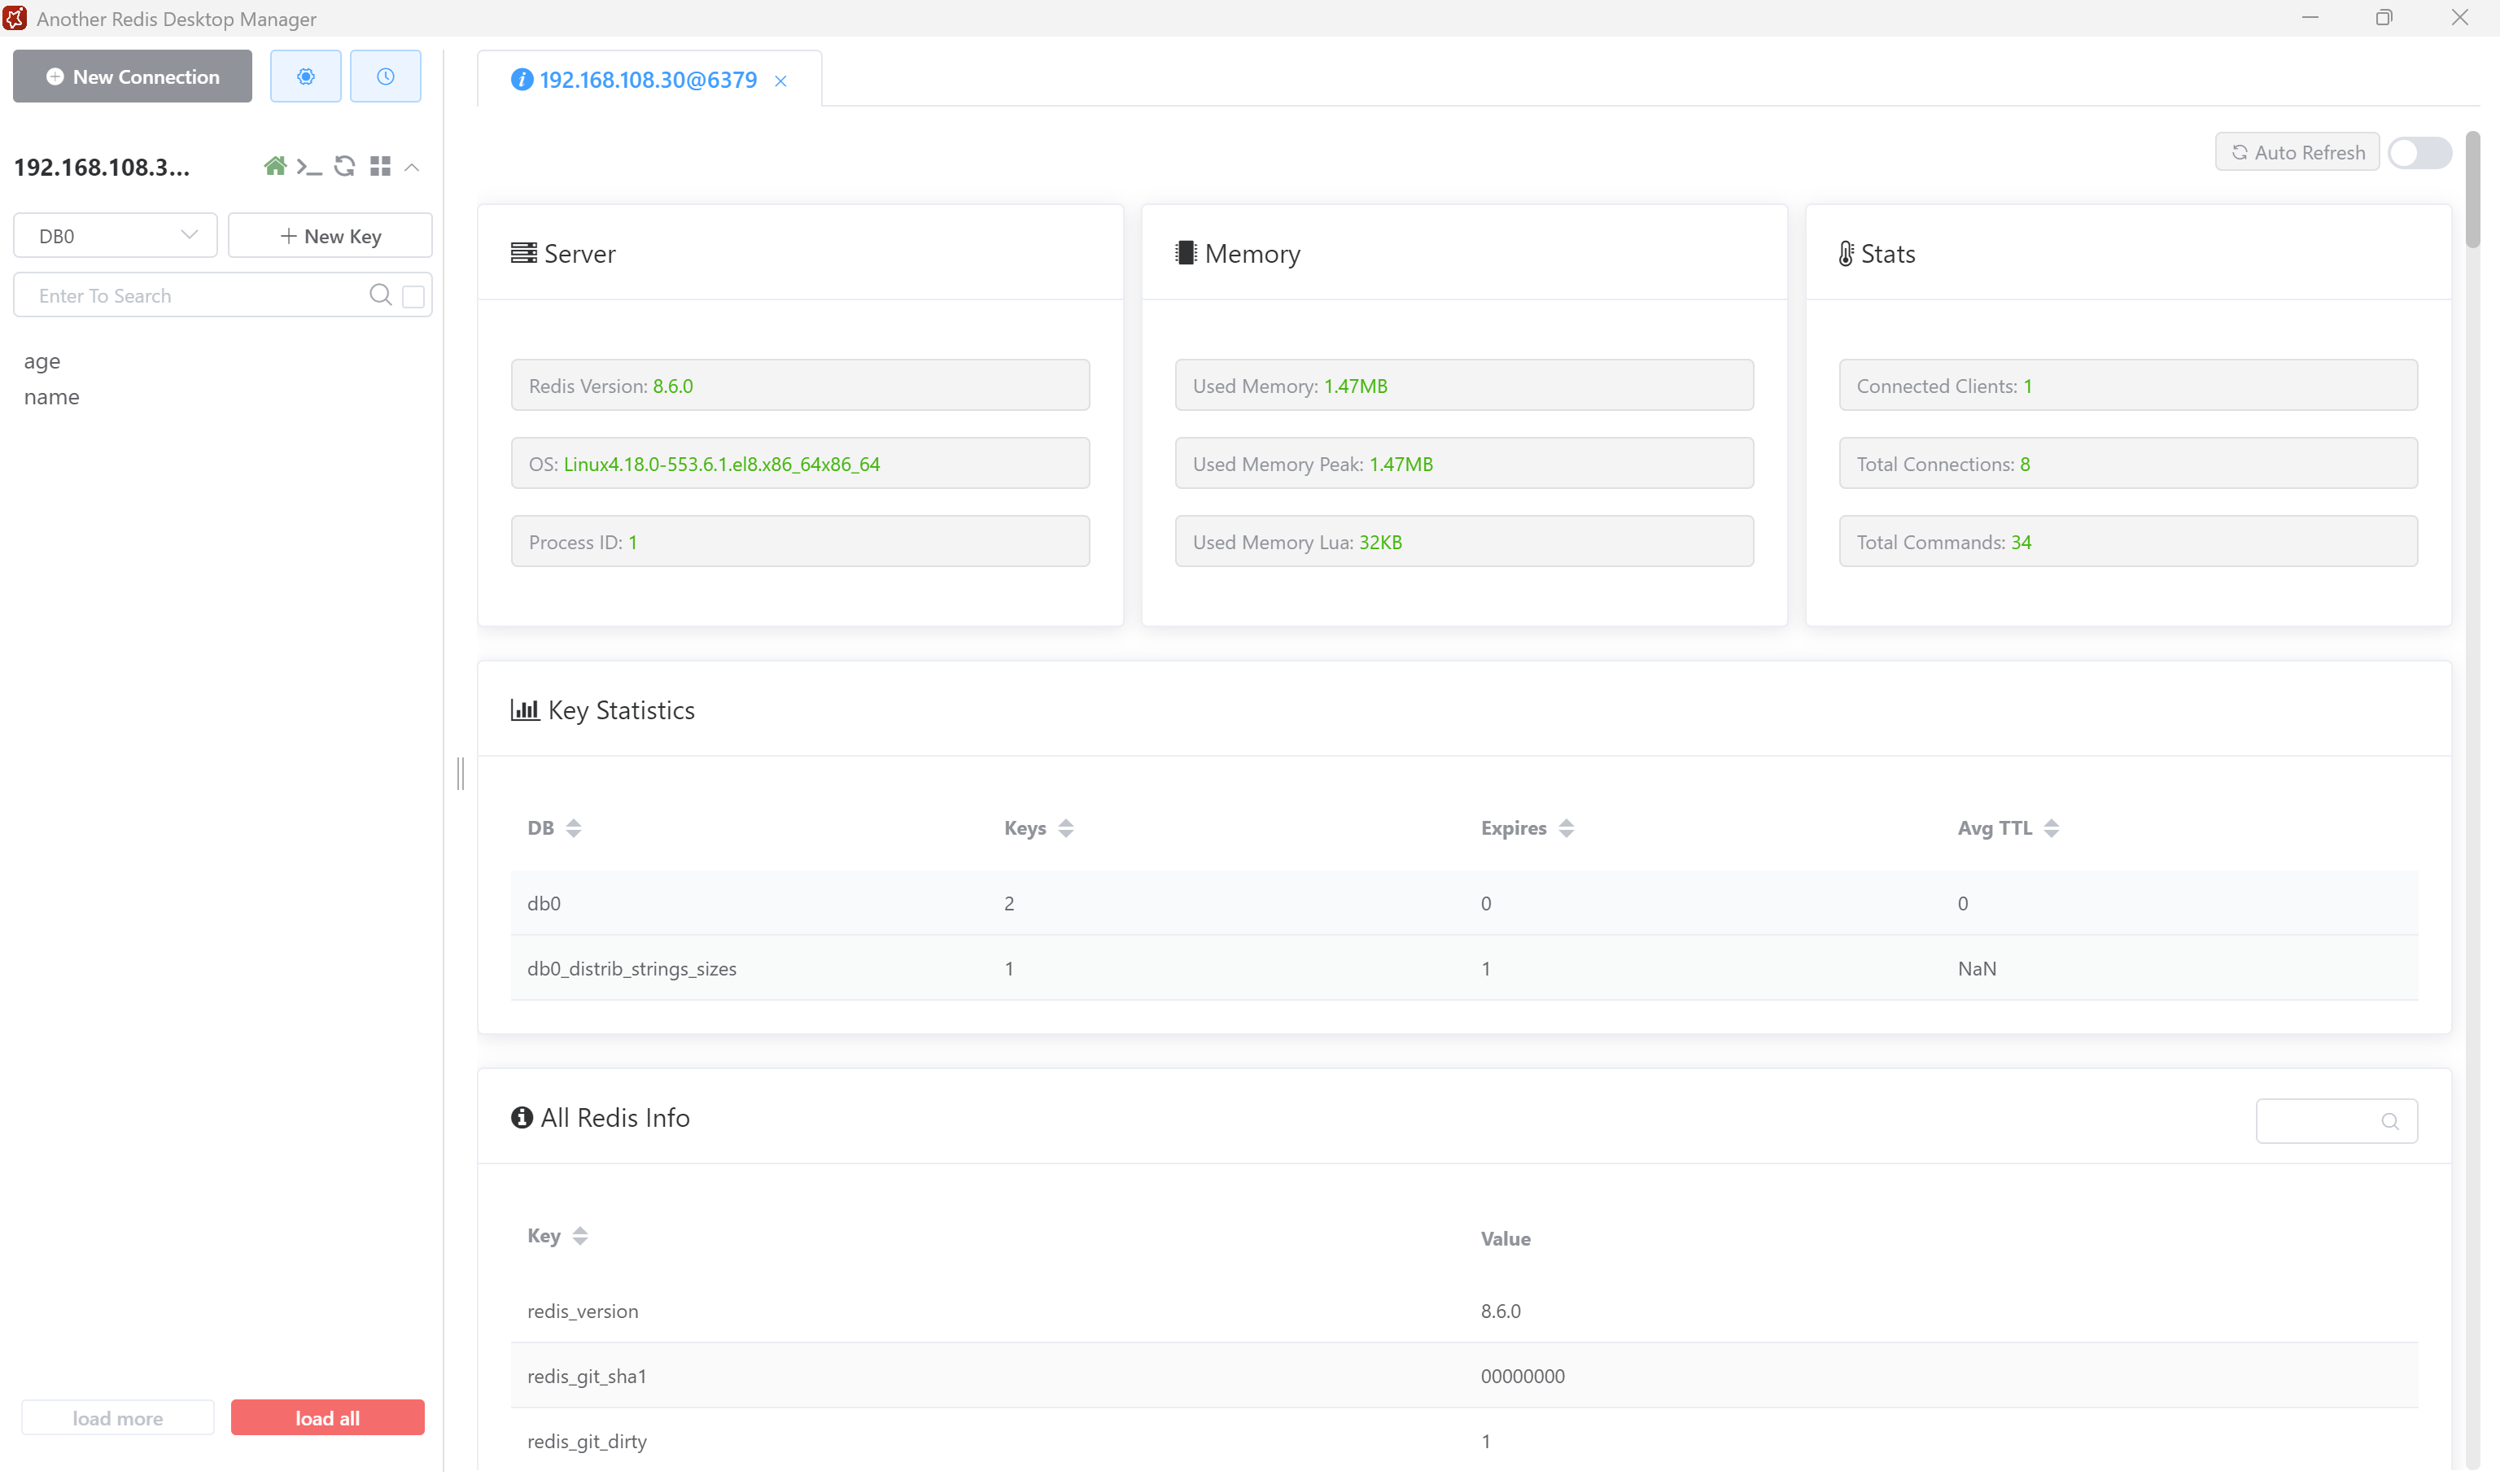
默认Redis容器可以支持远程连接
容器部署基础
[root@docker ~]# vim docker-compose.yml
version: '2.27'
networks:
redis-cluster-net:
driver: bridge
ipam:
config:
– subnet: 192.168.109.0/24
services:
# Master1 192.168.109.21
redis-21:
image: redis:latest
container_name: redis-21
restart: always
ports:
–"6379:6379"
–"16379:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.21
volumes:
– ./node21/data:/data
– command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.21
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
# Master2 192.168.109.22
redis-22:
image: redis:latest
container_name: redis-22
restart: always
ports:
–"6380:6379"
–"16380:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.22
volumes:
– ./node22/data:/data
command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.22
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
# Master3 192.168.109.23
redis-23:
image: redis:latest
container_name: redis-23
restart: always
ports:
–"6381:6379"
–"16381:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.23
volumes:
– ./node23/data:/data
command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.23
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
# Slave1 192.168.109.25 主:192.168.109.21
redis-25:
image: redis:latest
container_name: redis-25
restart: always
ports:
–"6382:6379"
–"16382:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.25
volumes:
– ./node25/data:/data
command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.25
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
# Slave2 192.168.109.26 主:192.168.109.22
redis-26:
image: redis:latest
container_name: redis-26
restart: always
ports:
–"6383:6379"
–"16383:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.26
volumes:
– ./node26/data:/data
command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.26
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
# Slave3 192.168.109.24 主:192.168.109.23
redis-24:
image: redis:latest
container_name: redis-24
restart: always
ports:
–"6384:6379"
–"16384:16379"
networks:
redis-cluster-net:
ipv4_address: 192.168.109.24
volumes:
– ./node24/data:/data
command: >
redis-server
–bind0.0.0.0
–port6379
–cluster-enabledyes
–cluster-config-file nodes.conf
–cluster-node-timeout5000
–cluster-announce-ip192.168.109.24
–cluster-announce-port6379
–cluster-announce-bus-port16379
–appendonlyyes
–protected-mode no
[root@docker ~]# docker compose up -d
[root@docker ~]# docker exec -it redis-21 redis-cli –cluster create \\
> 192.168.109.21:6379 \\
> 192.168.109.22:6379 \\
> 192.168.109.23:6379 \\
> 192.168.109.24:6379 \\
> 192.168.109.25:6379 \\
> 192.168.109.26:6379 \\
> –cluster-replicas1
>>> Performing hash slots allocation on 6 nodes...
Master[0] –> Slots 0-5460
Master[1] –> Slots 5461-10922
Master[2] –> Slots 10923-16383
Adding replica 192.168.109.25:6379 to 192.168.109.21:6379
Adding replica 192.168.109.26:6379 to 192.168.109.22:6379
Adding replica 192.168.109.24:6379 to 192.168.109.23:6379
M: c6650ac0779839061763eb305340410d148a3497 192.168.109.21:6379
slots:[0-5460] (5461 slots) master
M: ec9e43bfc9b98c08419191fcf02a109fcbc32602 192.168.109.22:6379
slots:[5461-10922] (5462 slots) master
M: a973f431bda8ad53d0b9937b6045878710a4b52d 192.168.109.23:6379
slots:[10923-16383] (5461 slots) master
S: a982afa38457757b7f17ee72aa41440cb4752c70 192.168.109.24:6379
replicates a973f431bda8ad53d0b9937b6045878710a4b52d
S: 1d7a85c06a826e45a95e5af0361eeb1b6a99d1fe 192.168.109.25:6379
replicates c6650ac0779839061763eb305340410d148a3497
S: d98d9750c468f763a2ace5684f626a807e36dcb5 192.168.109.26:6379
replicates ec9e43bfc9b98c08419191fcf02a109fcbc32602
Can I set the above configuration? (type 'yes' to accept): yes
>>> Nodes configuration updated
>>> Assign a different config epoch to each node
>>> Sending CLUSTER MEET messages to join the cluster
Waiting for the cluster to join
...
>>> Performing Cluster Check (using node192.168.109.21:6379)
M: c6650ac0779839061763eb305340410d148a3497 192.168.109.21:6379
slots:[0-5460] (5461 slots) master
1 additional replica(s)
S: a982afa38457757b7f17ee72aa41440cb4752c70 192.168.109.24:6379
slots: (0 slots) slave
replicates a973f431bda8ad53d0b9937b6045878710a4b52d
M: a973f431bda8ad53d0b9937b6045878710a4b52d 192.168.109.23:6379
slots:[10923-16383] (5461 slots) master
1 additional replica(s)
S: 1d7a85c06a826e45a95e5af0361eeb1b6a99d1fe 192.168.109.25:6379
slots: (0 slots) slave
replicates c6650ac0779839061763eb305340410d148a3497
M: ec9e43bfc9b98c08419191fcf02a109fcbc32602 192.168.109.22:6379
slots:[5461-10922] (5462 slots) master
1 additional replica(s)
S: d98d9750c468f763a2ace5684f626a807e36dcb5 192.168.109.26:6379
slots: (0 slots) slave
replicates ec9e43bfc9b98c08419191fcf02a109fcbc32602
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.
# 验证
root@docker ~]# docker exec -it redis-21 redis-cli
127.0.0.1:6379> cluster info
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:6
cluster_my_epoch:1
cluster_stats_messages_ping_sent:124
cluster_stats_messages_pong_sent:128
cluster_stats_messages_sent:252
cluster_stats_messages_ping_received:123
cluster_stats_messages_pong_received:127
cluster_stats_messages_meet_received:5
cluster_stats_messages_received:255
total_cluster_links_buffer_limit_exceeded:0
cluster_slot_migration_active_tasks:0
cluster_slot_migration_active_trim_running:0
cluster_slot_migration_active_trim_current_job_keys:0
cluster_slot_migration_active_trim_current_job_trimmed:0
cluster_slot_migration_stats_active_trim_started:0
cluster_slot_migration_stats_active_trim_completed:0
cluster_slot_migration_stats_active_trim_cancelled:0
127.0.0.1:6379>


评论前必须登录!
注册