 网硕互联帮助中心
Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations 在新知识上微调LLM是否会助长幻觉? 论文
摘要
当大型语言模型通过监督微调进行对齐时,它们可能会遇到未通过预训练获得的新事实信息。人们常推测,这可能会教会模型产生事实不正确回答的幻觉行为,因为模型被训练生成并非基于其已有知识的事实。在这项工作中,我们研究这种接触新知识对微调模型利用其已有知识的能力的影响。为此,我们设计了一个受控设置,聚焦于闭卷问答,其中我们改变引入新知识的微调样本比例。我们证明,大型语言模型难以通过微调获得新的事实知识,因为引入新知识的微调样本的学习速度显著慢于与模型知识一致的样本。然而,我们还发现,随着带有新知识的样本最终被学会,它们会线性地增加模型的幻觉倾向。综合来看,我们的结果凸显了通过微调引入新事实知识的风险,并支持这样一种观点:大型语言模型主要通过预训练获得事实知识,而微调则教会它们更有效地使用这些知识。
1.引言
在文本语料库上预训练大型语言模型(LLMs)会将大量事实知识嵌入其参数中(Petroni et al., 2019; AlKhamissi et al., 2022; Cohen et al., 2023),这对于在各种下游应用中表现出色至关重要。这些模型通常需要进一步对齐至期望行为,这通常通过在指令遵循任务上进行监督微调(Wei et al., 2022; Mishra et al., 2022)以及基于人类反馈的偏好学习(Ouyang et al., 2022; Rafailov et al., 2024)来实现。
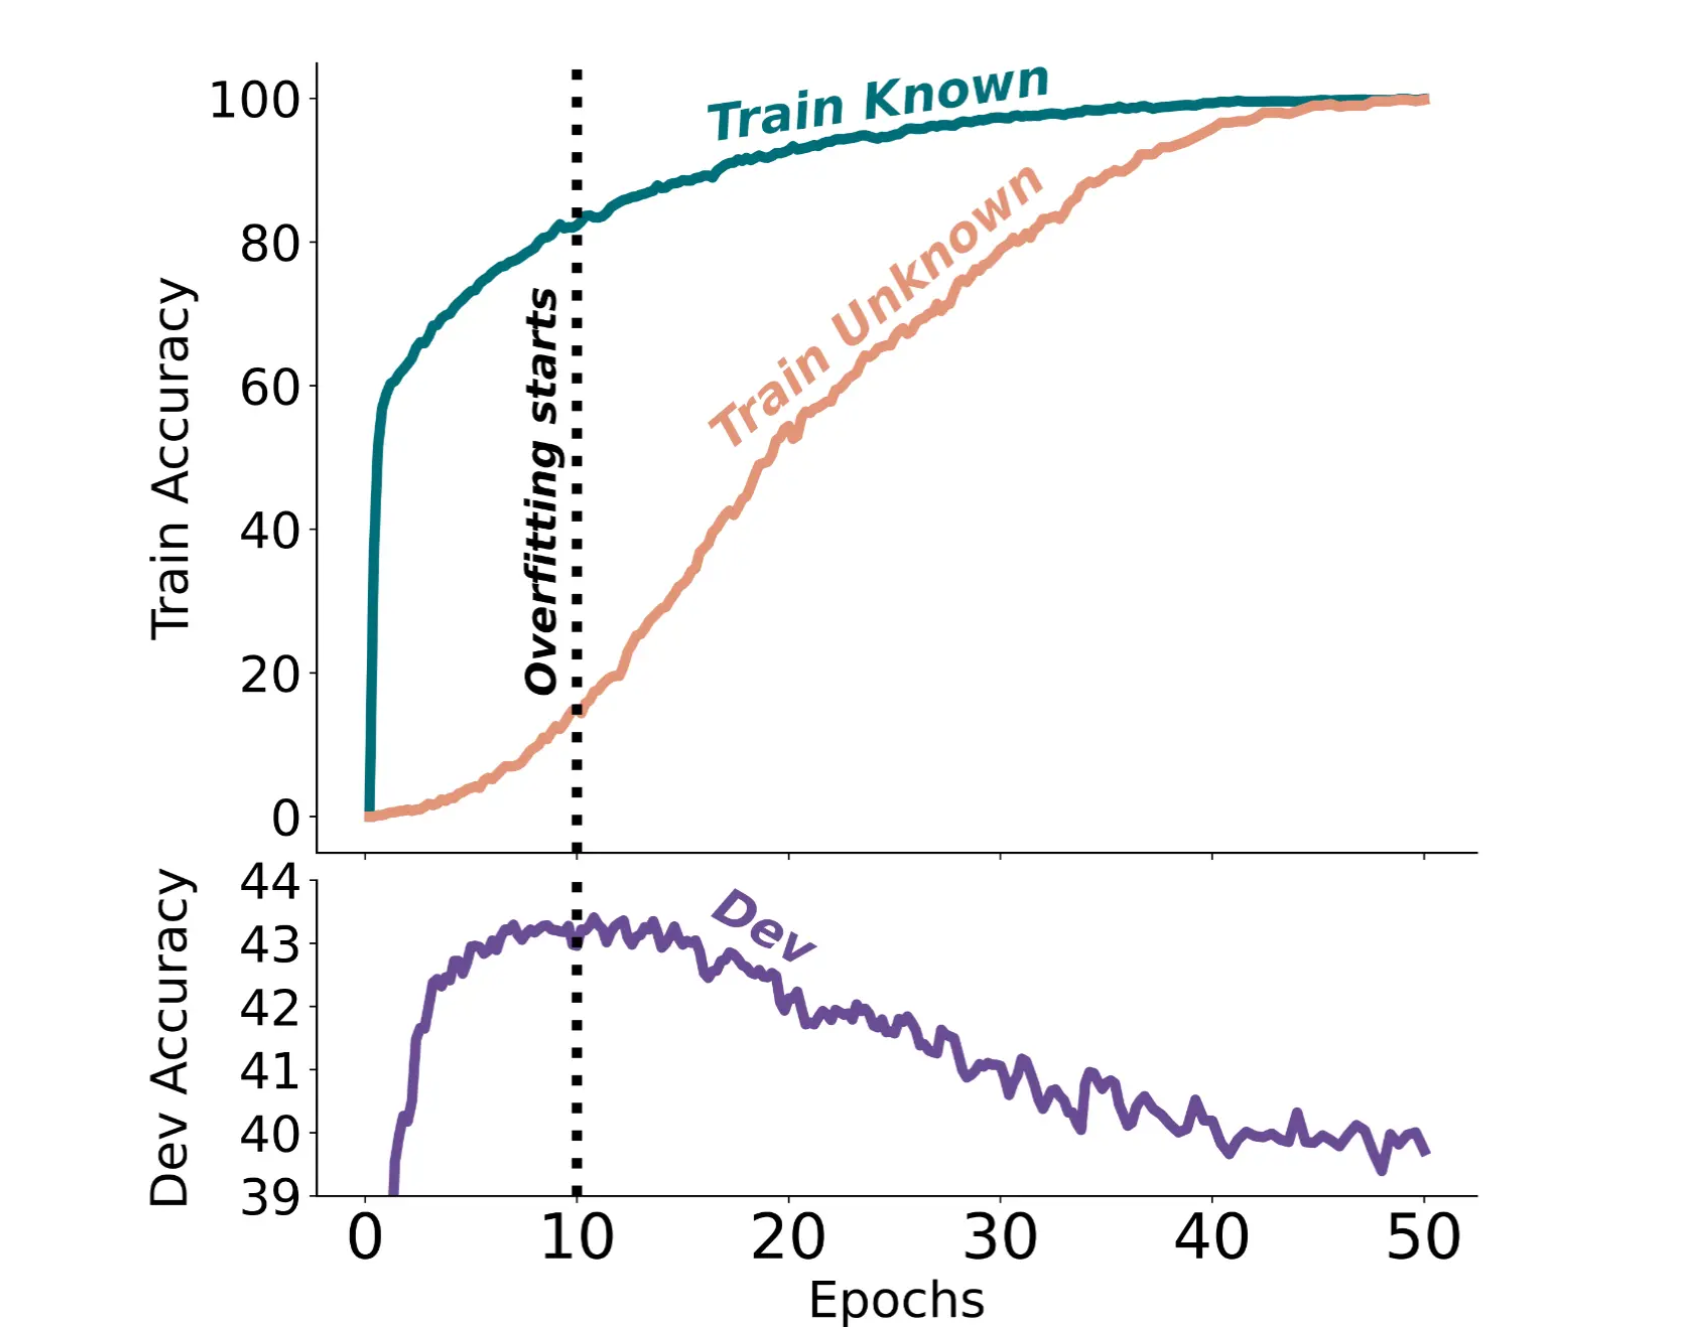
图1:当在50%已知样本和50%未知样本上进行微调时,训练准确率和开发准确率作为微调时长的函数。未知样本的拟合速度显著慢于已知样本。当LLM拟合大多数已知训练样本但仅拟合少数未知样本时,可获得最佳 开发性能。从这一点开始,拟合未知样本会降低性能。
在微调阶段,模型通常在由人类标注者或其他 LLM 创建的输出上进行训练。因此,模型可能接触到新的事实信息,这些信息超出了其在预训练期间所获得的知识范围。这引出了一个问题:LLM 如何整合其既有知识之外的新事实。一种可能性是,模型只是通过学习这些新事实信息来适应。然而,一种常见的猜想认为,这种对新知识的接触可能促使模型产生事实错误的幻觉响应,因为模型本质上被训练来生成并非以其既有知识为基础的事实(Schulman, 2023; Huang et al., 2023; Gao, 2021; Goldberg, 2023; Gudibande et al., 2023)。在本工作中,我们研究通过微调学习新的事实知识(arXiv:2405.05904v3 [cs.CL] 2024年10月1日)如何影响模型在其既有知识方面产生幻觉的倾向,从而探索上述猜想。¹ 为了研究新知识的影响,我们必须能够评估单个微调样本是否与模型的知识一致。我们提出 SliCK,一个由四个知识类别组成的层级体系,它源自一个连续度量,该度量量化模型生成的答案与真实标签之间的一致性。在 SliCK 中,样本首先被分为已知(Known)和未知(Unknown)类型,其中后者对应于包含模型最可能未知的事实的样本。已知样本随后被分为三个类别:高度已知(HighlyKnown)、可能已知(MaybeKnown)和弱已知(WeaklyKnown)(图 2)。
借助上述方法,我们精心设计了一项受控研究,聚焦于闭卷问答(QA),其中我们改变被归类为未知的微调样本比例,同时控制其他因素。我们的研究实证表明,从未知微调样本中学习与模型在其既有知识方面产生幻觉的倾向线性相关(§4)。相反,从已知样本中学习与更好地利用既有知识相关。通过分析训练动态,我们发现 LLM 拟合未知微调样本的速度显著慢于拟合已知样本(图 1 的上图)。这表明,在微调期间,LLM 难以²整合新的事实知识(存在于未知微调样本中)。相反,它们大多学会展现其既有知识(使用已知微调样本)。从实践角度看,使用早停(图 1 中的垂直虚线)来缓解过拟合,可以最小化由拟合未知样本所导致的幻觉风险,因为这些幻觉主要出现在训练后期,作为一种过拟合形式(如图 1 的下图中开发性能下降所示)。或者,我们还表明,过滤掉未知微调样本会显著降低了过拟合风险,且不牺牲性能。我们进一步评估来自三类 Known 知识类别的微调示例对性能的影响(第5节)。出乎意料的是,我们发现,仅在来自最高知识程度(记为 HighlyKnown)的示例上微调的模型并未取得最佳结果。我们的分析表明,纳入 MaybeKnown 微调示例——其表示确定性程度较低的事实——在测试时正确处理此类示例方面起着重要作用。这表明,微调示例的构成显著影响 LLMs 有效利用其已有知识的程度。总而言之,我们通过设计一个隔离该因素的受控设置,研究微调数据中新事实知识的影响。我们发现,引入新知识的微调示例学习缓慢,这表明 LLMs 难以通过微调整合新知识,并支持 LLMs 主要通过预训练获取知识的观点(Zhou et al., 2023; Lin et al., 2023)。然而,我们还发现,随着模型最终通过微调学习到新知识,它就其已有知识而言变得更容易产生幻觉。总体而言,我们的发现凸显了通过微调引入新知识时可能产生意外后果,并意味着微调作为一种增强已有知识利用的机制可能更为有用。
1尽管我们聚焦于监督微调,但我们的发现可能对诸如 DPO(Rafailov 等,2024)这类可能添加新知识的离线偏好优化方法具有参考价值,我们将此留待未来工作。 2我们使用“挣扎”一词来描述 LLMs 在包含新事实知识的示例上收敛缓慢的现象。由于该术语带有情感色彩,我们指出,我们并不将任何情感属性赋予 LLMs。
2 研究设置
给定一个微调数据集
D
D
D 和一个预训练 LLM
M
M
M,我们将通过在
D
D
D 上微调
M
M
M 得到的模型记为
M
D
M_D
MD。为了研究
D
D
D 中的新知识如何影响
M
D
M_D
MD 的性能,我们设计了一个受控设置,构造
D
D
D 的变体,这些变体包含不同比例的对
M
M
M 未知的示例。 在构建
D
D
D 时,我们的目标是在保持对实验设置的控制的同时,体现面向多样化知识密集型任务的指令微调。因此,我们关注可以结构化为(主语,关系,宾语)三元组的事实性知识,并将其转换为闭卷问答(QA)格式。在此设置中,
D
=
{
(
q
i
,
a
i
)
}
i
=
1
N
D = \\{(q_i, a_i)\\}_{i=1}^N
D={(qi,ai)}i=1N,其中
q
q
q 是对应于特定三元组的知识寻求型问题(例如,“巴黎位于哪里?”),而
a
a
a 是真实答案(例如,“法国”)。为此,我们使用 ENTITYQUESTIONS (Sciavolinoet al., 2021)中,来自 Wikidata(Vrandecˇic ́ 和 Krötzsch,2014)的一组多样化关系中的三元组被转换为问答对。这些关系涵盖广泛的事实知识,包括传记信息、地理数据、所有权与作者身份细节、历史等。我们使用原始的开发集和测试集划分,并对训练集划分进行子采样,以创建
D
D
D 的不同变体。我们关注 12 种多样化的关系,并保留 7 种额外关系用于分布外测试集,该测试集(仅)在 §4.5 中使用。作为
M
M
M,我们使用 PaLM 2-S 基础模型3(Anil et al., 2023)。我们以精确匹配(EM)作为评估指标。4 完整技术细节见 §A。
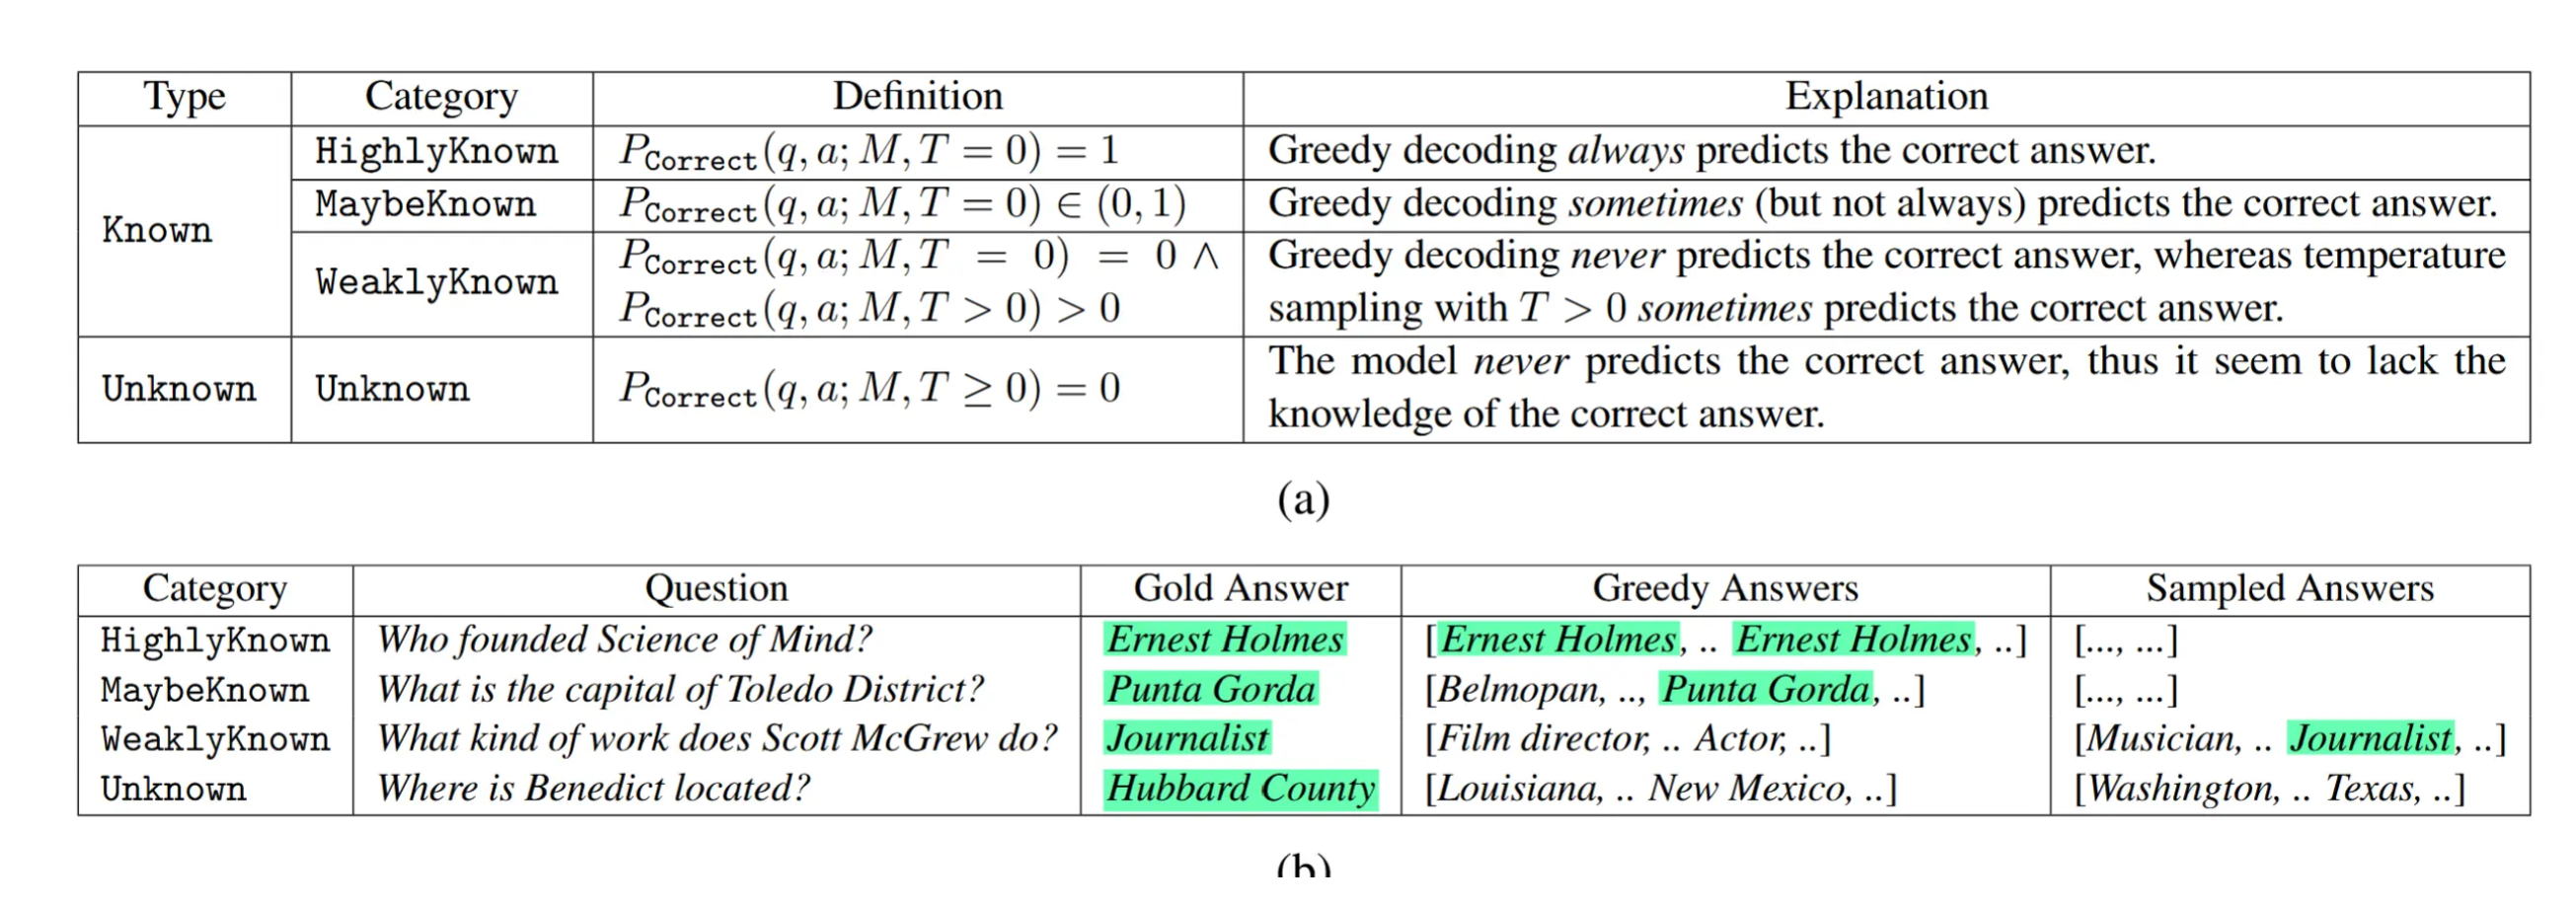
图2:SliCK 知识类别的形式化定义,基于 §3 中定义的
P
Correct
P_{\\text{Correct}}
PCorrect 度量(a),并附有我们研究中使用的已标注 ENTITYQUESTIONS 数据集中的真实示例(b)。
3 量化大语言模型中的知识
为了评估
D
D
D 中的新知识对
M
D
M_D
MD 性能的影响,我们必须标注
D
D
D 中的每个
(
q
,
a
)
(q, a)
(q,a) 对,以标明
M
M
M 是否知道
q
q
q 的答案是
a
a
a。⁵ 为了估计这一点,我们基于来自
M
M
M 的样本定义一个连续的
P
Correct
P_{\\text{Correct}}
PCorrect 度量,并用它把
(
q
,
a
)
(q, a)
(q,a) 对划分为四个知识类别。我们将这种方法命名为 SliCK(基于采样的知识分类)。
定义
P
Correct
P_{\\text{Correct}}
PCorrect。我们采用这样的观点:如果
M
M
M 在被提示回答
q
q
q 时生成
a
a
a,那么
M
M
M 就知道
q
q
q 的答案是
a
a
a(Kadavath et al., 2022; Manakul et al., 2023)。由于
M
M
M 是一个基础模型对于尚未专门微调以遵循指令的
M
M
M,我们使用少样本示例通过上下文学习来提示
M
M
M。遵循 Rubin 等人 (2022),我们确保少样本示例与
q
q
q 具有高语义相似度。6 在实践中,
M
M
M 可能预测出不同答案,因为 (1) 示例的选择会影响单个预测,且 (2) 温度采样(如果使用)会引入随机性。为反映这一点,我们将
P
Correct
(
q
,
a
;
M
,
T
)
P_{\\text{Correct}}(q, a; M, T)
PCorrect(q,a;M,T) 定义为:当用随机少样本示例提示并使用解码温度
T
T
T 时,
M
M
M 准确生成
q
q
q 的正确答案
a
a
a 的可能性的估计。 出于我们研究的目的,我们使用
N
ex
=
10
N_{\\text{ex}} = 10
Nex=10 个不同的随机 4-shot 提示来近似
P
Correct
P_{\\text{Correct}}
PCorrect 的值。7 对于每个 4-shot 提示,我们使用
T
=
0
T = 0
T=0 预测贪心答案,并使用
T
=
0.5
T = 0.5
T=0.5 预测 16 个采样答案。
P
Correct
(
q
,
a
;
M
,
T
=
0
)
P_{\\text{Correct}}(q, a; M, T = 0)
PCorrect(q,a;M,T=0) 通过正确贪心答案的比例来估计,而
P
Correct
(
q
,
a
;
M
,
T
>
0
)
P_{\\text{Correct}}(q, a; M, T > 0)
PCorrect(q,a;M,T>0) 通过正确采样答案的比例来估计。完整细节见 §C。 从
P
Correct
P_{\\text{Correct}}
PCorrect 推导知识类别。我们将未知类别(图 2a 和 2b 中的底行)定义为表示
M
M
M 从不对
q
q
q 预测正确答案的
(
q
,
a
)
(q, a)
(q,a) 对。在我们的记号中,这意味着
P
Correct
(
q
,
a
;
M
,
T
≥
0
)
=
0
P_{\\text{Correct}}(q, a; M, T \\geq 0) = 0
PCorrect(q,a;M,T≥0)=0。或者,如果
P
Correct
(
q
,
a
;
M
,
T
≥
0
)
>
0
P_{\\text{Correct}}(q, a; M, T \\geq 0) > 0
PCorrect(q,a;M,T≥0)>0,即
M
M
M 有时会预测出
q
q
q 的正确答案,我们将
(
q
,
a
)
(q, a)
(q,a) 视为已知。在这种选择中,我们假定,如果提示
M
M
M 回答
q
q
q 有时会产生正确回答
a
a
a,那么
M
M
M 必定与相关事实存在某种关联。认识到知识在确定程度和范围上可能有所不同,我们将已知的
(
q
,
a
)
(q, a)
(q,a) 对划分为三个不同的类别(表 2a 和 2b 中的前三行)。受以下原则驱动:如果
(
q
,
a
)
(q, a)
(q,a) 是已知的,
M
M
M 应一致地预测
a
a
a,我们着重关注贪心解码结果,其由
P
Correct
(
q
,
a
;
M
,
T
=
0
)
P_{\\text{Correct}}(q, a; M, T = 0)
PCorrect(q,a;M,T=0) 表示。高度已知表示
M
M
M 总是通过贪心解码预测
a
a
a 的
(
q
,
a
)
(q, a)
(q,a) 对。如果
M
M
M 有时(但并非总是)通过贪心解码预测
a
a
a,我们将
(
q
,
a
)
(q, a)
(q,a) 视为可能已知。最后,如果
M
M
M 从未通过贪心解码预测
a
a
a,我们将
(
q
,
a
)
(q, a)
(q,a) 归类为弱已知。我们应用 SliCK 为我们数据集中的每个
(
q
,
a
)
(q, a)
(q,a) 对标注其相对于
M
M
M 的知识类别。8 我们在 §6 中分析这些类别的质量。
3PaLM-2 有五种规模:XXS、XS、S、M、L,其中 S 版本代表该范围中的中等规模。 4我们验证了,在我们的设置中,EM 与词级 F1 强相关(Rajpurkar et al., 2016),并且我们选择 EM,因为它对于我们分析的目的而言更直观。 5我们还考虑过使用虚假事实来引入新知识,但我们担心这会给我们的研究引入混杂因素,因为虚假事实的表现可能与真实事实不同。我们在 §F 中详细讨论这一点。 6在本研究中,我们通过使用来自同一关系的示例来实现这一点。例如,如果
q
=
q =
q=“巴黎位于何处?”,示例将遵循“{X}位于何处?”的模式。 7我们采用4-shot,仅仅是因为我们发现这已足以让M以正确的格式输出答案。
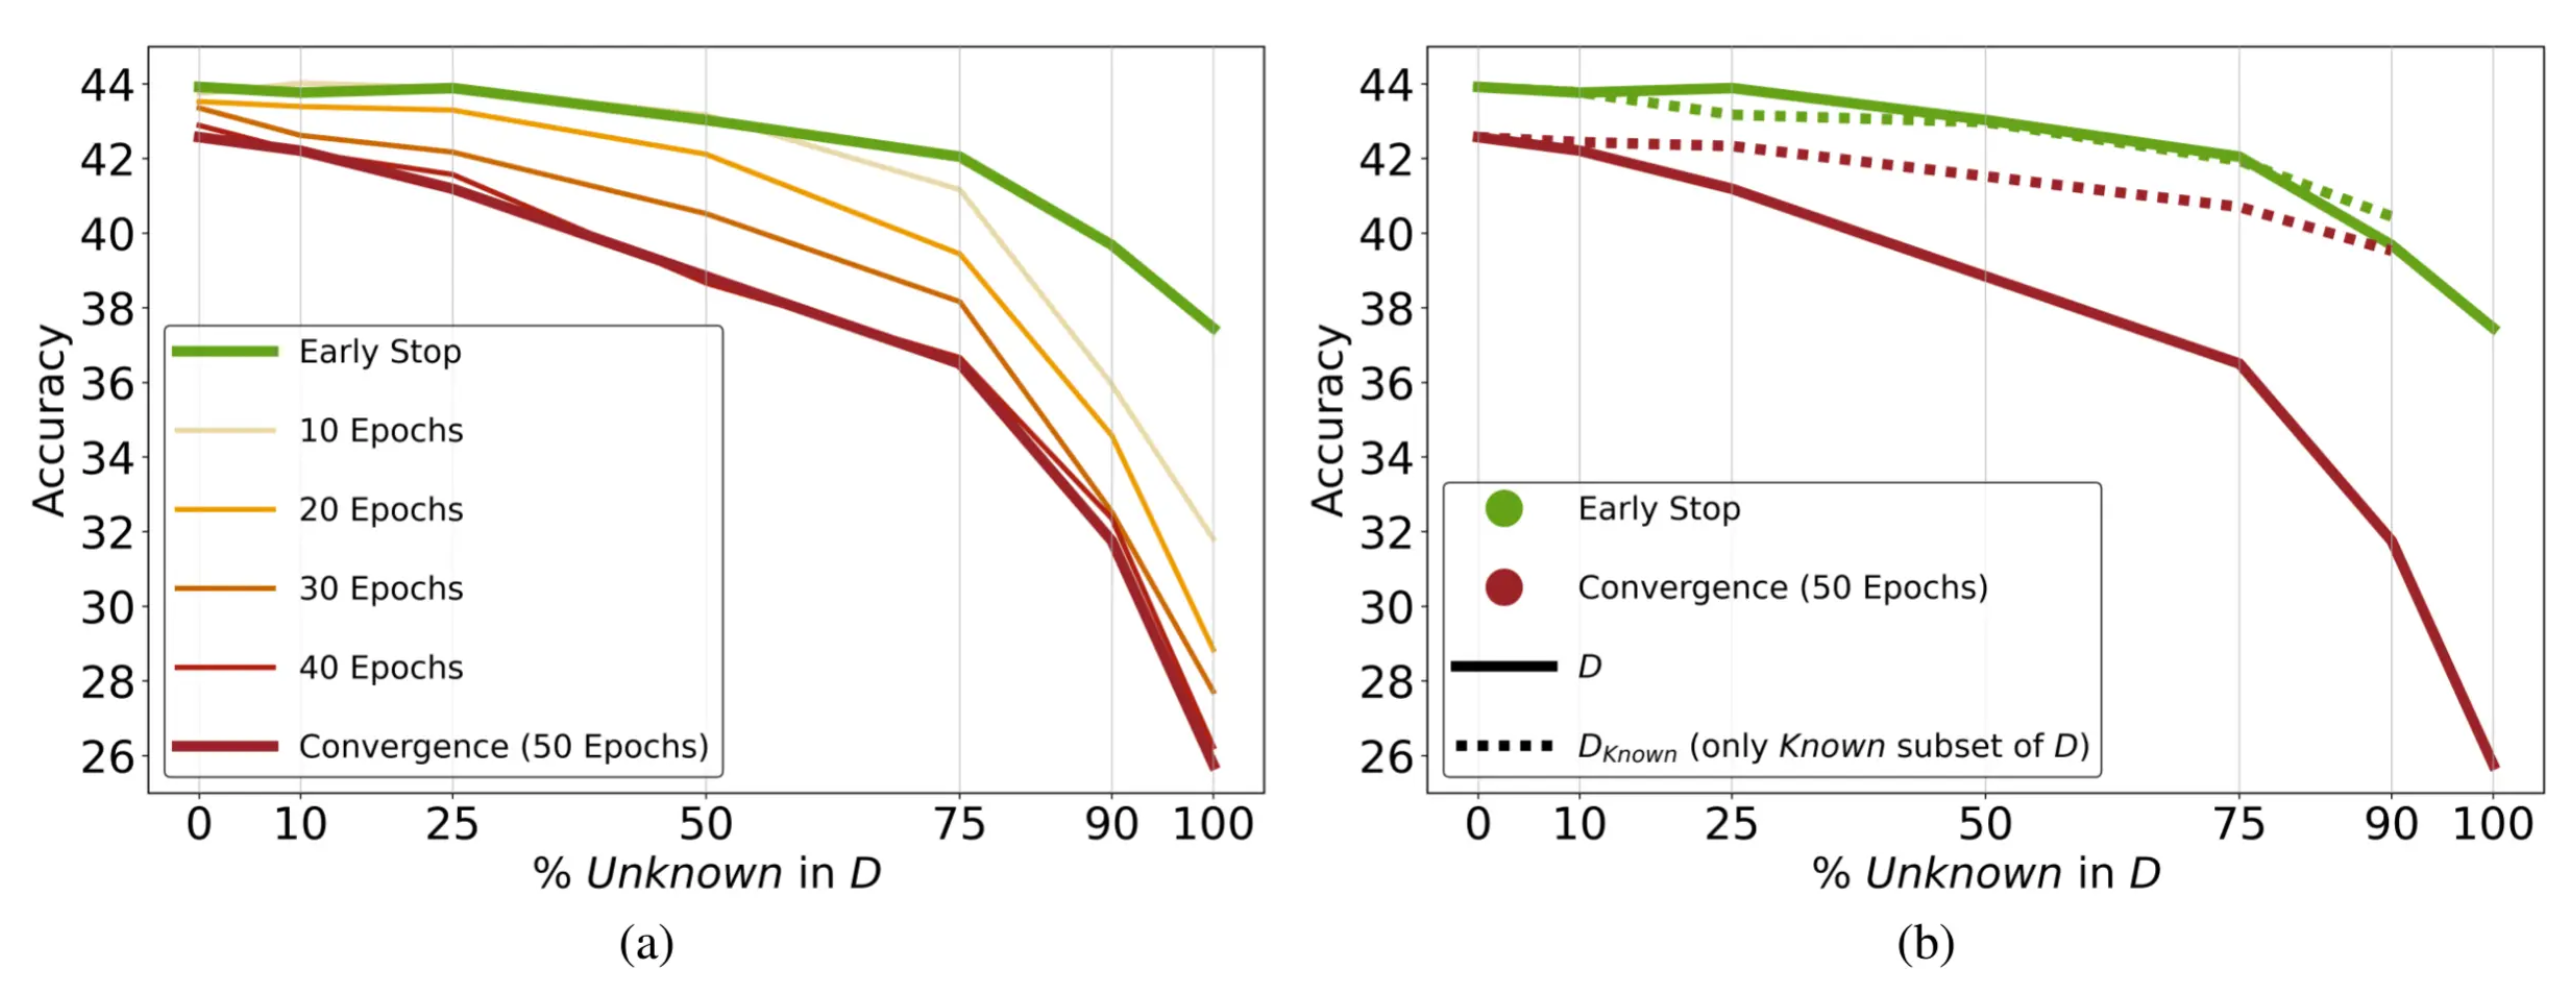 图 3:测试性能随微调数据集
D
D
D 中未知样本百分比的变化。在 (a) 中,每条线对应不同的(固定)训练轮数,但 EARLY_STOP 除外,其对应使用开发集进行早停(见 §4)。在 (b) 中,我们展示了来自 §4.2 的消融实验。实线对应于在
D
D
D 上微调,并与 (a) 相同。虚线对应于在消融变体
D
Known
D_{\\text{Known}}
DKnown 上微调,其中未知样本被过滤掉。对于
0
%
0\\%
0% 未知样本,
D
=
D
Known
D = D_{\\text{Known}}
D=DKnown;对于
100
%
100\\%
100% 未知样本,不存在
D
Known
D_{\\text{Known}}
DKnown。
4 未知样本有多有害?
在本节中,我们研究微调数据集
D
D
D 中的新知识对性能的影响。为了分离这一效应,我们改变
D
D
D 中未知样本的比例,同时控制其他因素。具体而言,我们固定
∣
D
∣
|D|
∣D∣,并创建
D
D
D 的变体,其中包含
X
%
X\\%
X% 的未知样本和
(
100
−
X
)
%
(100 – X)\\%
(100−X)% 的已知样本(完整细节见 §E)。我们将已知类别合并处理(见图 2a),并在 §5 中提供逐类别分析。我们将基于开发集的早停记为 EARLY_STOP(发生在 5-10 个 epoch 之后)以及 50将微调轮数记为 CONVERGENCE,因为此时
M
M
M 总是完全拟合
D
D
D(即 100% 训练准确率)。我们将测试性能作为幻觉的代理指标进行测量,因为我们处于具有不相交训练/测试划分的闭卷问答(QA)设置中,模型必须使用其预先存在的知识来回答测试问题(进一步讨论见 §B)。
4.1 更高的 Unknown 比例与性能退化成正比
图 3a 展示了在不同微调时长下,性能作为
D
D
D 中 Unknown 示例百分比的函数。更高的 Unknown 百分比会导致性能退化,无论微调时长如何,这表明 Unknown 示例比 Known 示例的用处更小。性能也受到微调时长的强烈影响,其中 EARLY_STOP 通常产生最佳性能。训练更多轮次通常会降低性能(在 CONVERGENCE 时观察到最低性能),这可归因于对
D
D
D 的过拟合。有趣的是,这种效应随着 Unknown 百分比的增大而增强(EARLY_STOP 的线间间距沿正
x
x
x 轴呈现单调增加),表明更高的 Unknown 百分比会增加过拟合风险。
4.2 Unknown 示例:有害还是中性?
由于
∣
D
∣
|D|
∣D∣ 固定,更高的 Unknown 百分比导致的性能下降可能仅仅源于 Known 微调示例数量更少。因此,仍不清楚 Unknown 示例是有害还是中性。为了解决这一问题,我们测量从
D
D
D 中过滤掉所有未知样本的影响。对于每个
D
D
D 变体,我们创建一个对应的消融变体
D
Known
D_{\\text{Known}}
DKnown,其仅由
D
D
D 中的已知样本组成。例如,如果
D
D
D 中有
25
%
25\\%
25% 的未知样本,我们将其过滤掉,剩下
75
%
75\\%
75% 的已知样本,并得到
∣
D
Known
∣
=
0.75
×
∣
D
∣
|D_{\\text{Known}}| = 0.75 \\times |D|
∣DKnown∣=0.75×∣D∣。图 3b 展示了结果。也许令人惊讶的是,对于 EARLY_STOP,
D
D
D 的结果与
D
Known
D_{\\text{Known}}
DKnown 几乎相同,这表明未知样本对性能具有中性影响(因为移除它们的影响极小)。相反,CONVERGENCE 结果表明,随着训练时间延长,未知样本实际上非常有害。在这种情况下,
D
D
D 的表现不如
D
Known
D_{\\text{Known}}
DKnown,并且二者之间的差距与未知样本比例成正比。有趣的是,对于
D
Known
D_{\\text{Known}}
DKnown,EARLY_STOP 与 CONVERGENCE 之间的差距非常小(虚线),而对于
D
D
D,这一差距非常大(实线)。这表明,正是未知样本的存在使得未知样本比例更高的变体更容易过拟合。
4.3 未知样本的拟合速度慢于已知样本
我们表明,未知样本是有害的,但它们的负面影响主要在训练后期显现,因此可以通过早停从经验上加以避免。为了更好地理解这些趋势,我们通过考察在
D
D
D 中的哪些微调样本在不同微调阶段被
M
M
M 拟合,来分析训练动态。图 1 展示了
D
D
D 的已知子集和未知子集的训练准确率随微调时长的变化。开发准确率在底部的放大图中展示,因为它处于较窄的范围内。我们在 §G 中按已知类别给出了训练准确率的细分。
M
M
M 拟合未知微调样本大量初始时比已知样本慢。在 EARLY_STOP(垂直虚线)处,
M
M
M 在开发集上达到峰值性能,同时拟合了大多数已知样本,但仅拟合了一小部分未知样本。在图 4 中,我们表明这一行为在我们所有
D
D
D 变体中都是一致的。这可以解释为什么在 EARLY_STOP 处未知样本对性能产生了中性影响(§4.2),因为此时
M
M
M 仍未拟合其中大多数样本。最后,由于未知样本是可能引入新事实知识的样本,其显著缓慢的拟合速率表明,LLM 难以通过微调获得新的事实知识,相反,它们学会利用已知样本来暴露其已有知识。
4.4 未知与已知对准确率的影响:线性模型视角
图 1 表明,在开发集性能于 EARLY_STOP(垂直虚线)处达到峰值后,随着
M
M
M 逐渐拟合更多未知样本,性能会恶化。本节旨在通过评估一个简单的线性依赖关系能否将拟合已知和未知训练样本的影响与测试准确率联系起来,从而更准确地刻画这一关系。为此,我们使用以下线性回归模型:
A
c
c
u
r
a
c
y
=
β
0
+
β
k
n
⋅
N
k
n
∣
D
∣
+
β
u
n
k
⋅
N
u
n
k
∣
D
∣
(1)
\\mathrm{Accuracy} = \\beta_0 + \\beta_{kn} \\cdot \\frac{N_{kn}}{|D|} + \\beta_{unk} \\cdot \\frac{N_{unk}}{|D|} \\tag{1}
Accuracy=β0+βkn⋅∣D∣Nkn+βunk⋅∣D∣Nunk(1)
其中
N
k
n
N_{kn}
Nkn 和
N
u
n
k
N_{unk}
Nunk 是
M
M
M 在
D
D
D 中拟合的已知和未知样本数量。
我们通过从在所有
D
D
D 变体上微调的模型中收集每个 epoch 后的
(
A
c
c
u
r
a
c
y
,
N
k
n
,
N
u
n
k
)
(\\mathrm{Accuracy}, N_{kn}, N_{unk})
(Accuracy,Nkn,Nunk) 值来估计系数⁹。表 1 给出了结果(第一行)。高
R
2
R^2
R2 表明测试准确率与所拟合训练样本的类型之间存在强线性关系。我们的模型意味着,拟合未知样本会损害性能(
β
u
n
k
<
0
\\beta_{unk} < 0
βunk<0),而拟合已知样本会提升性能(
β
k
n
>
0
\\beta_{kn} > 0
βkn>0)。来自未知样本的估计负面影响大致匹配来自已知样本的正面影响(
∣
β
u
k
n
∣
≈
∣
β
k
n
∣
|\\beta_{ukn}| \\approx |\\beta_{kn}|
∣βukn∣≈∣βkn∣)。
8 在 ENTITYQUESTIONS 中,我们有 24% 高度已知、23% 可能已知、17% 弱已知,以及 36% 未知。各关系的完整统计见 §D。 ⁹完整细节见 §H。我们指出,该线性模型仅在
N
k
n
≤
∣
D
∣
N_{kn} \\leq |D|
Nkn≤∣D∣、
N
u
n
k
≤
∣
D
∣
N_{unk} \\leq |D|
Nunk≤∣D∣ 的有界区域内有效。
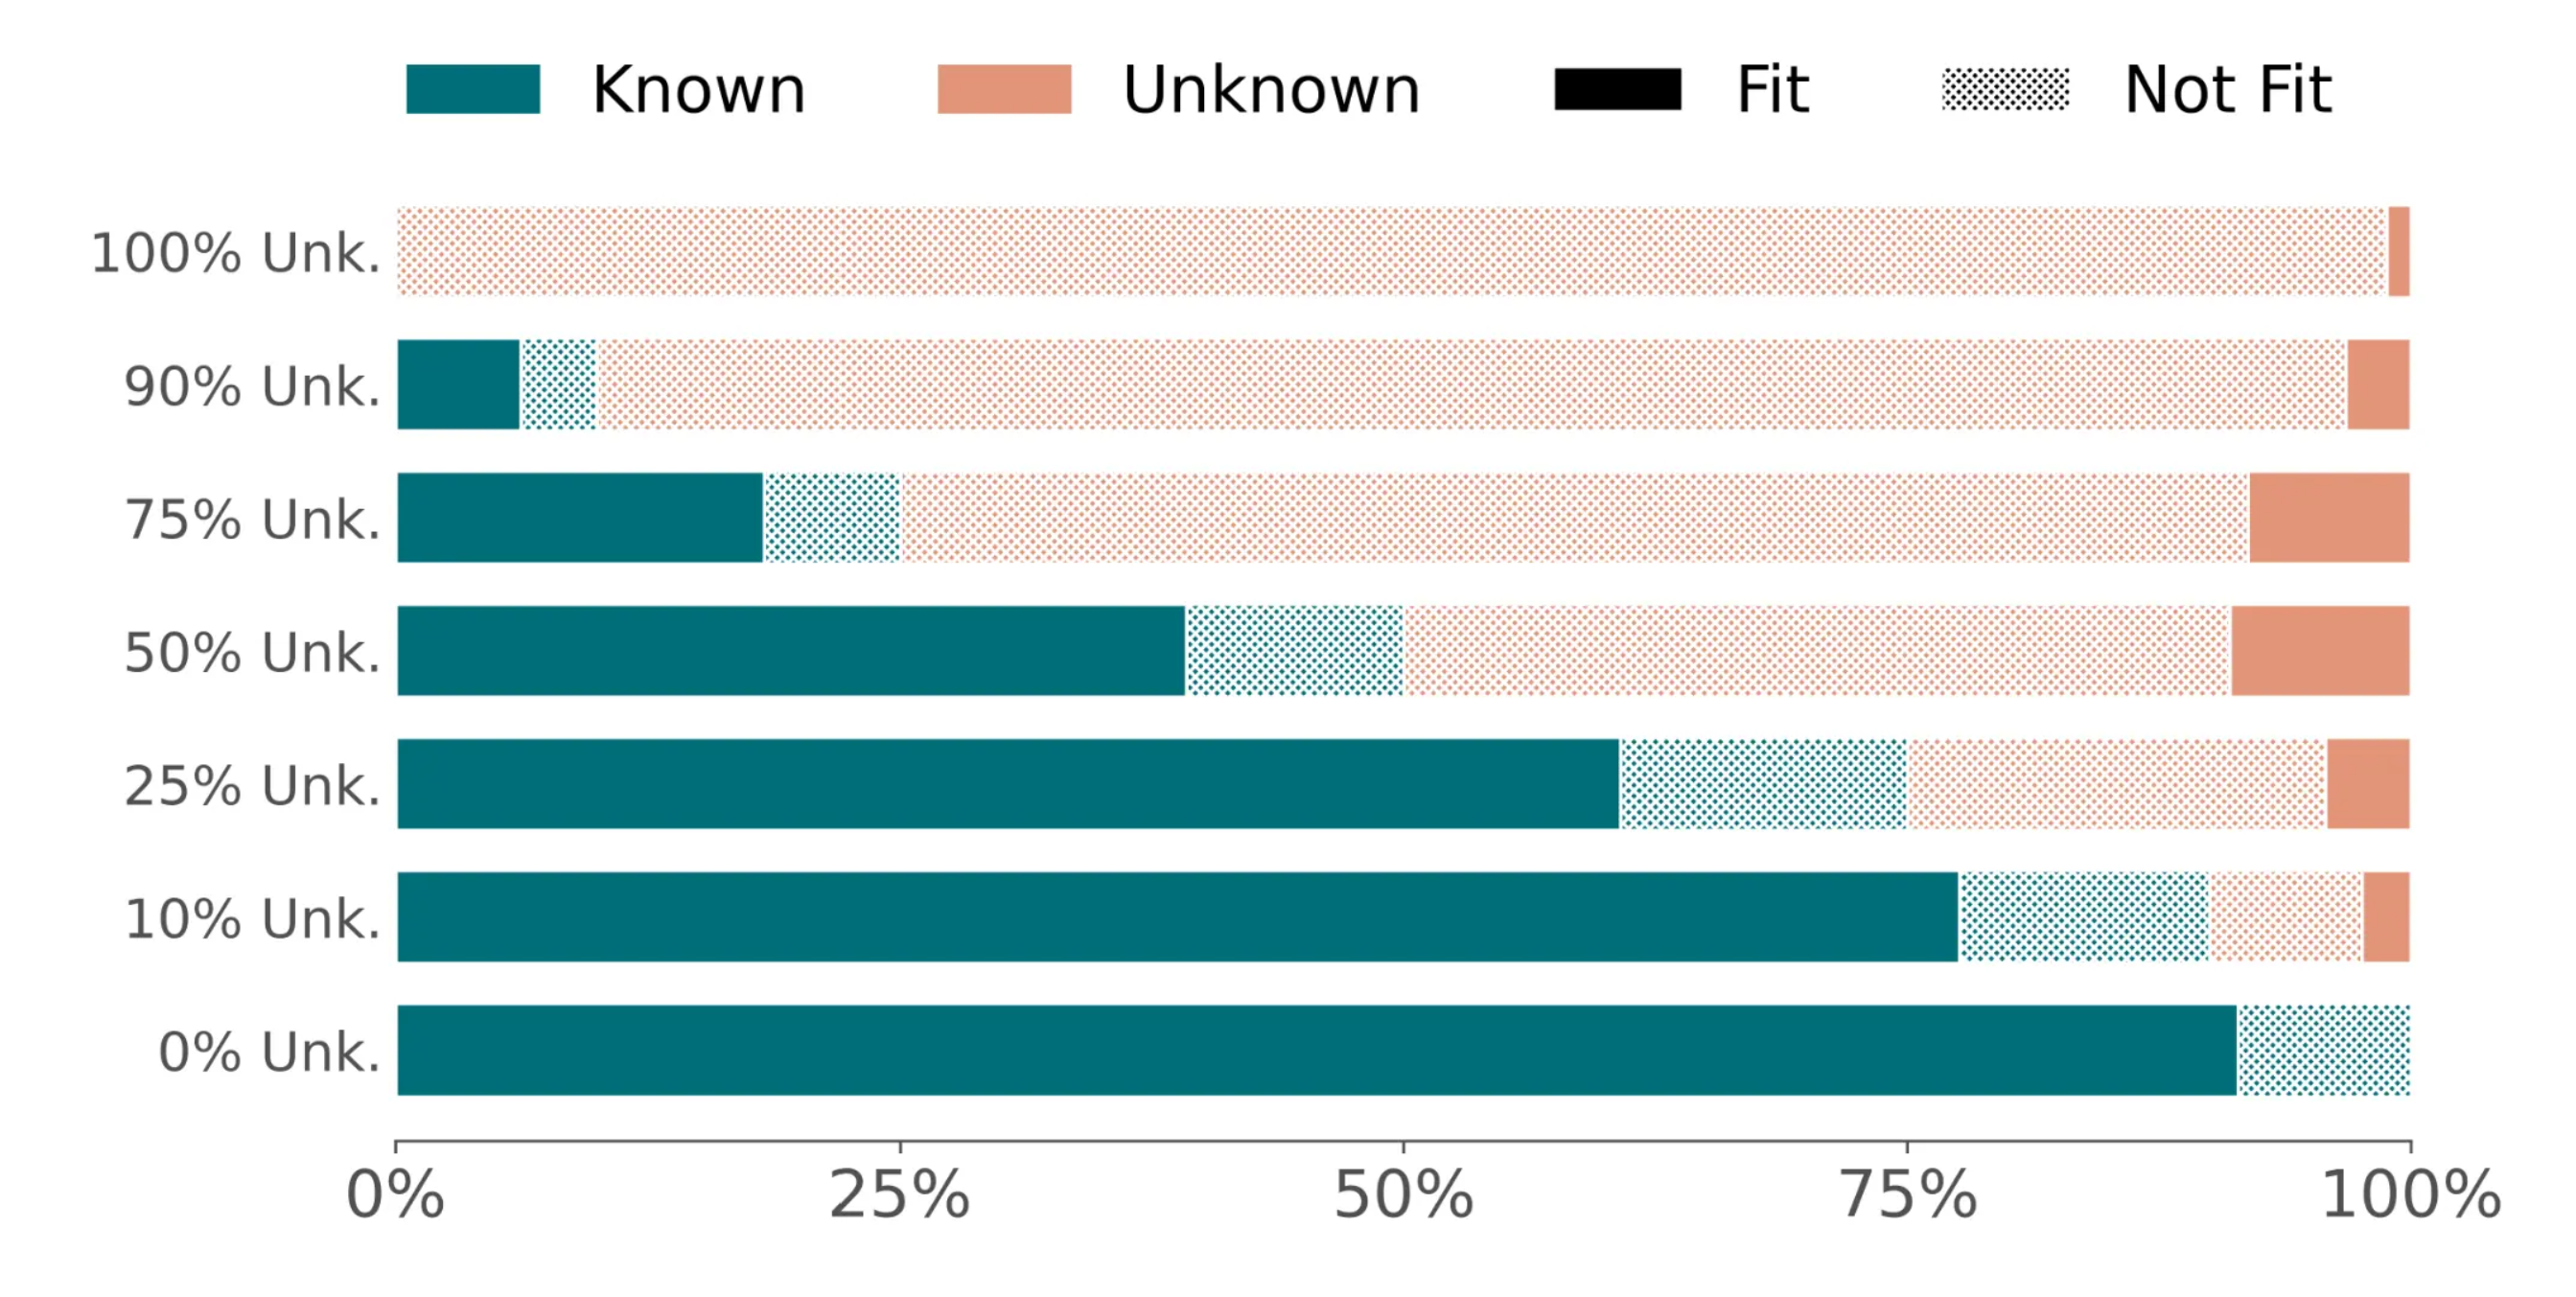 图 4:EARLY_STOP 之后微调数据集
D
D
D 中示例的状态。对于
D
D
D 的每个变体(纵轴),我们展示了模型拟合了
D
D
D 中示例的哪一部分(即为
q
q
q 预测正确答案)。
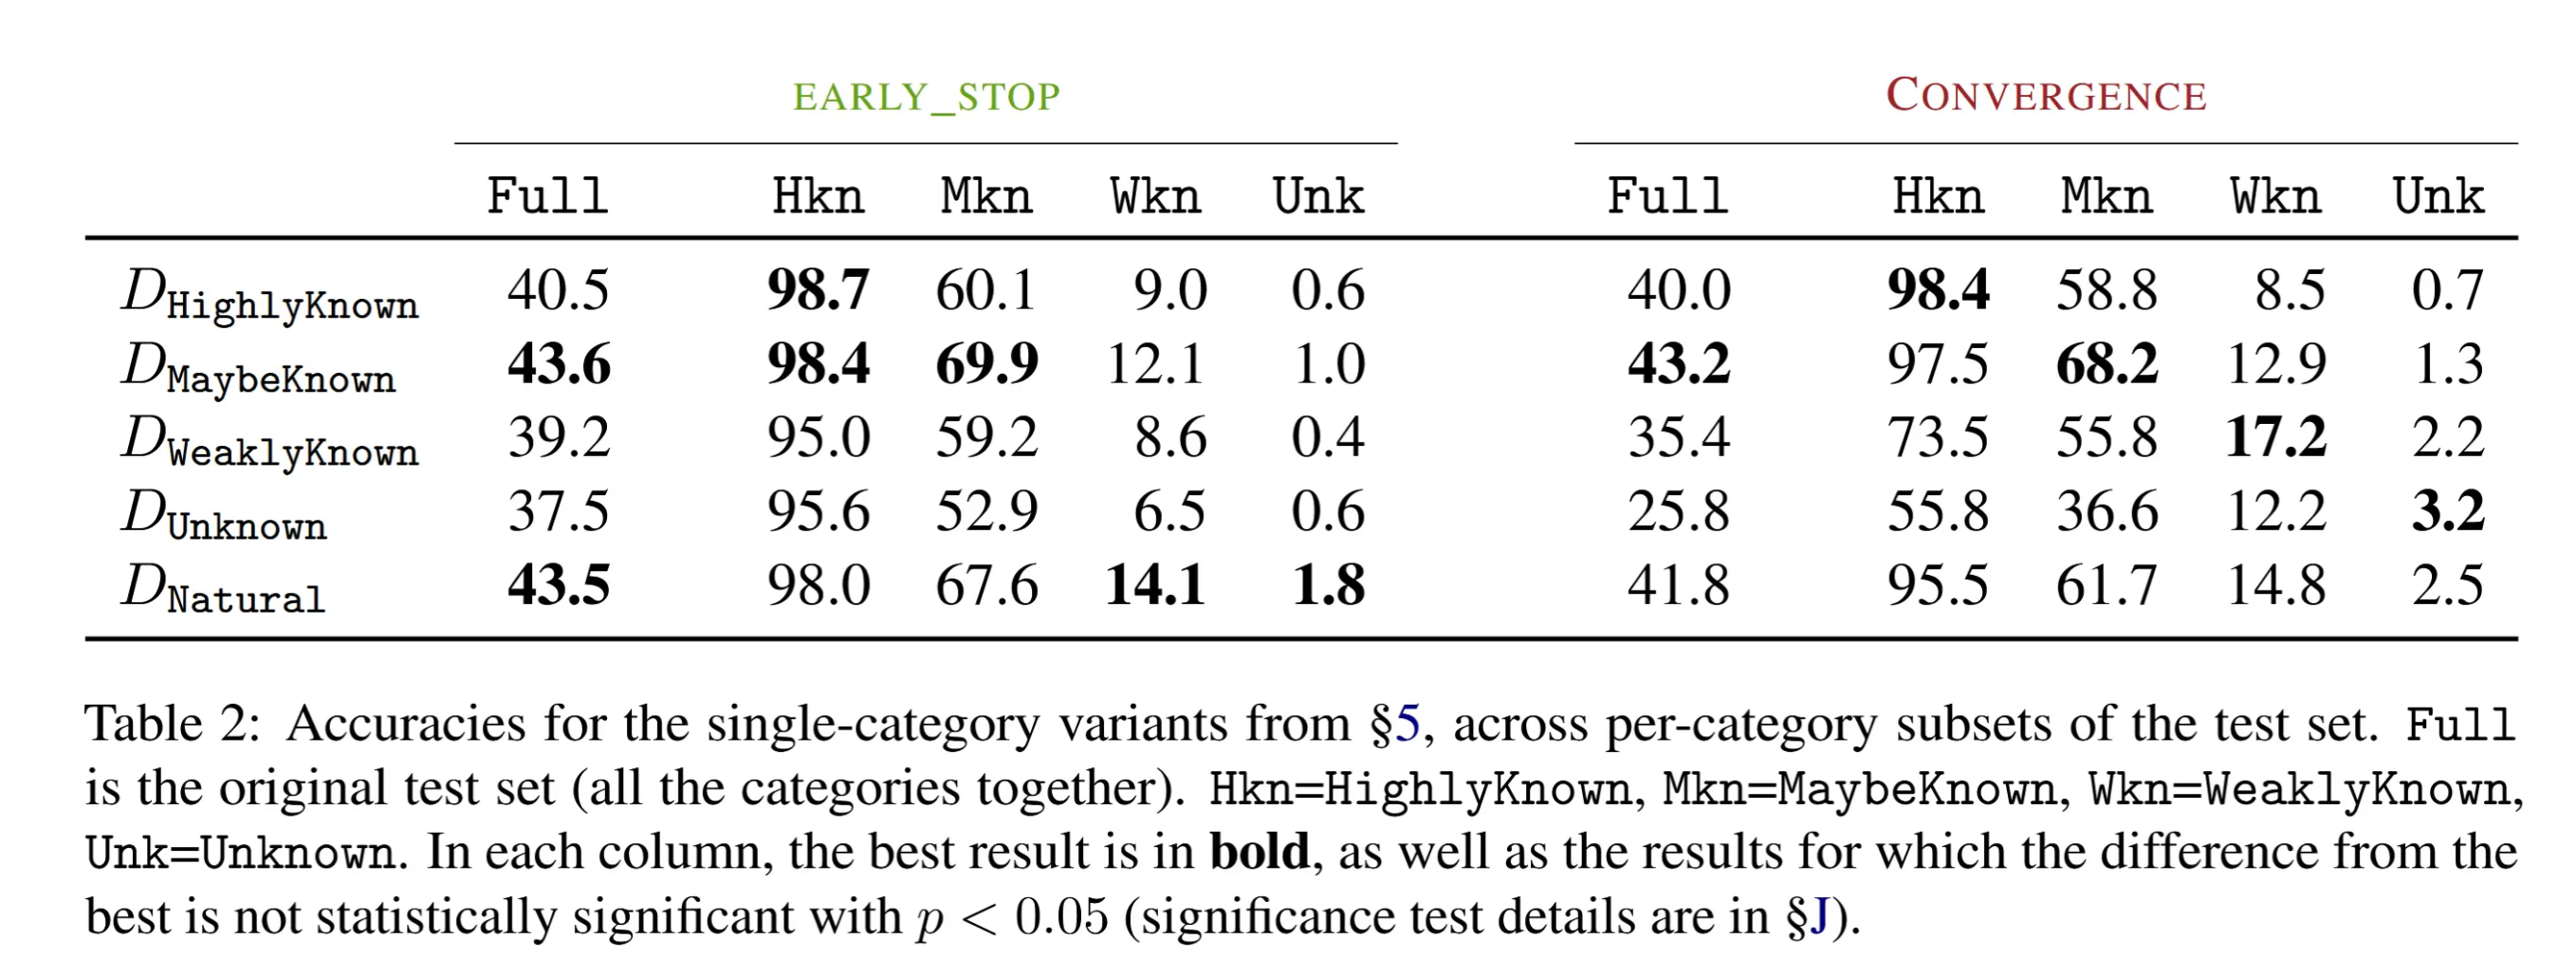
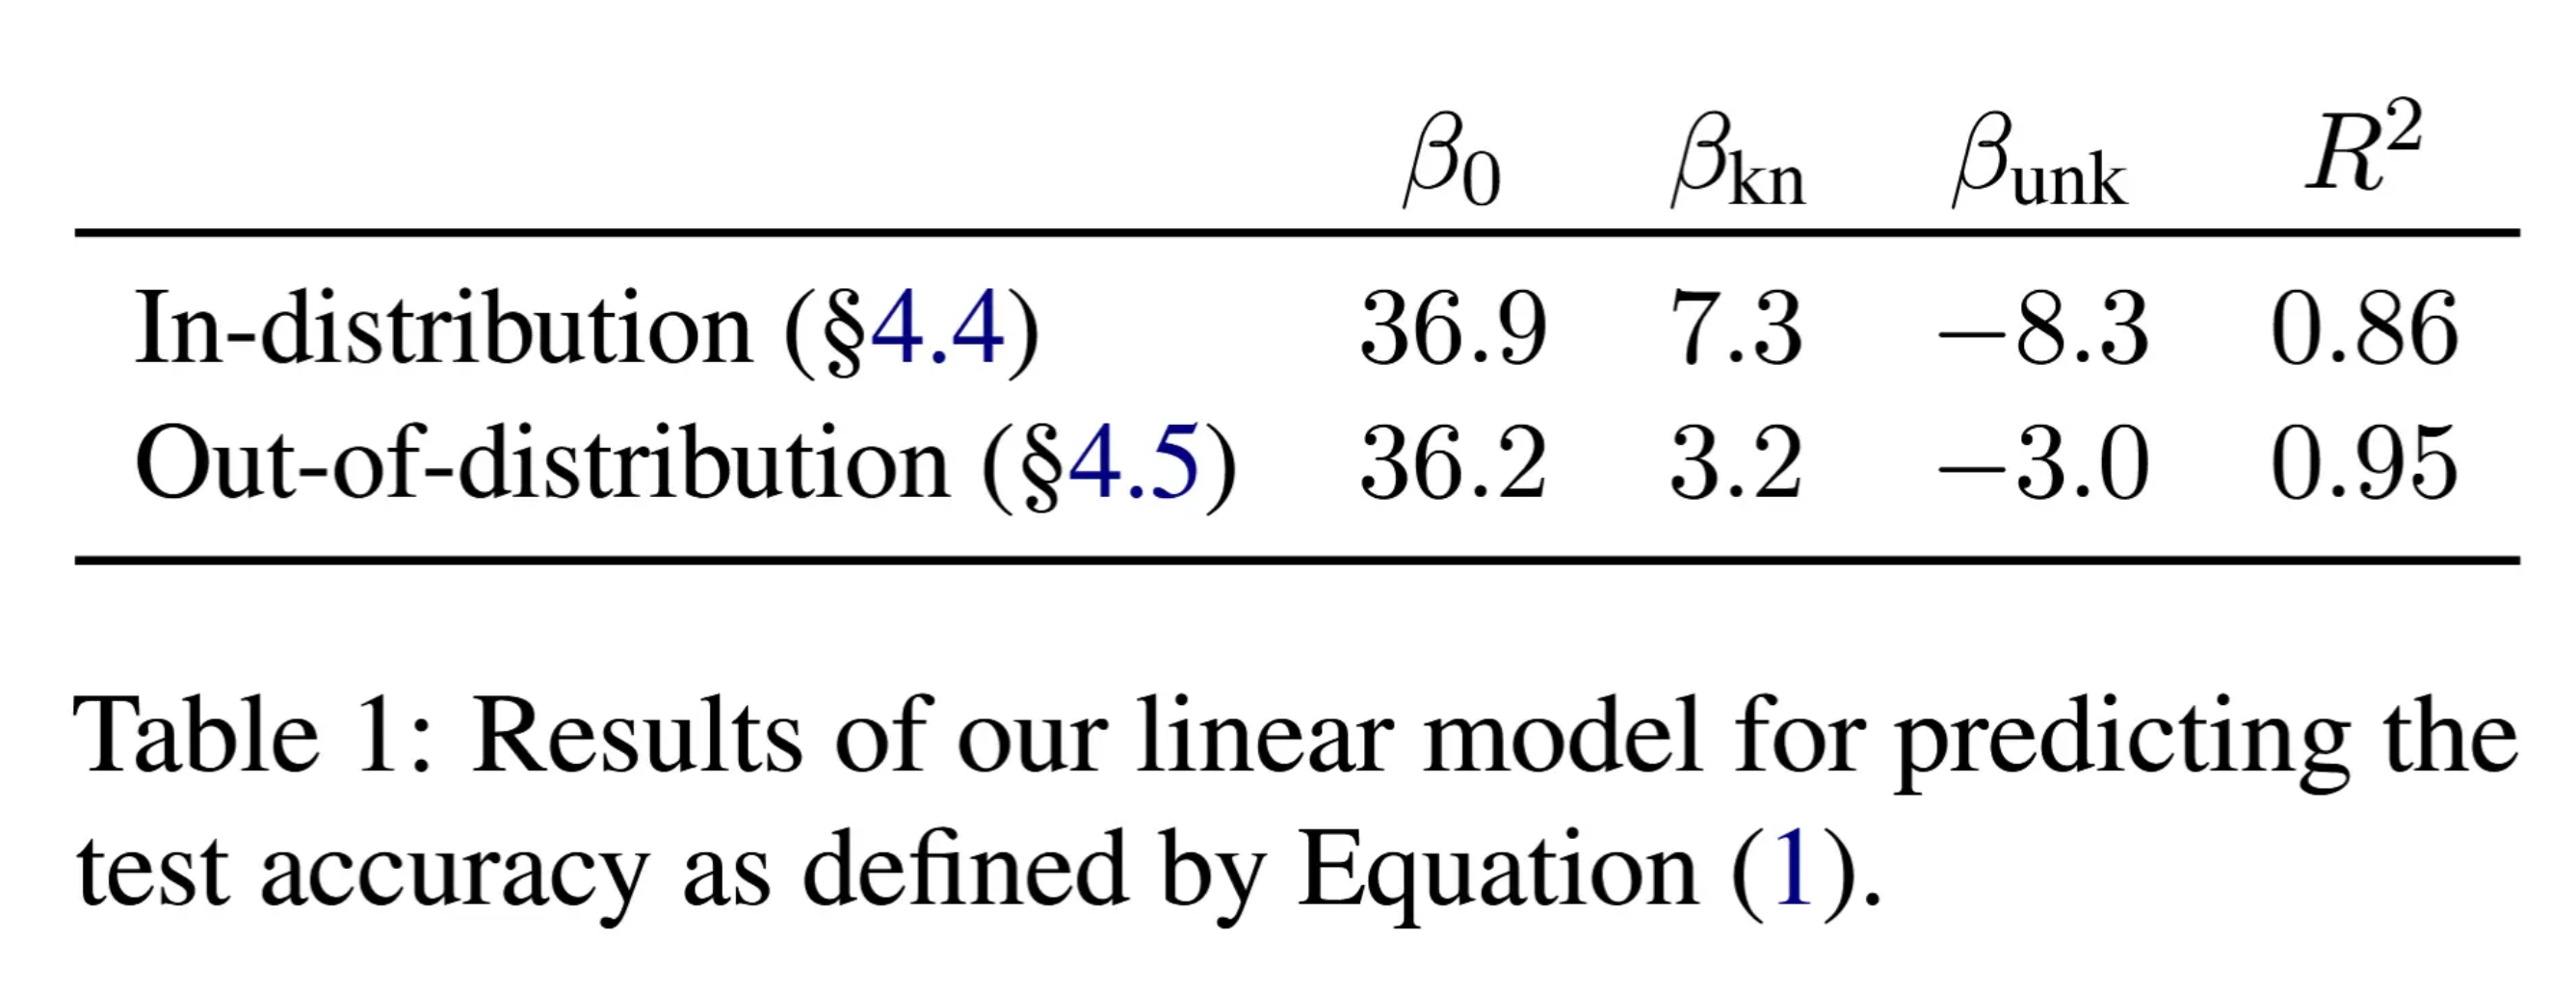 表 2:来自§5的单类别变体在测试集各按类别子集上的准确率。Full 是原始测试集(所有类别合在一起)。Hkn=HighlyKnown(高度已知),Mkn=MaybeKnown(可能已知),Wkn=WeaklyKnown(弱已知),Unk=Unknown(未知)。在每一列中,最佳结果以粗体显示;与最佳结果差异在
p
<
0.05
p < 0.05
p<0.05 下不具统计显著性的结果也同样以粗体显示(显著性检验细节见§J)。
4.5 泛化到新关系
在上述设置中,测试集中的
(
q
,
a
)
(q, a)
(q,a) 对对应于与
D
D
D 中出现的相同 12 种关系集合的三元组。我们现在研究:我们观察到的动态是否对模型知识具有更广泛的影响,并可迁移到
D
D
D 中未表示的关系。为检验这一点,我们保留一部分关系用于分布外(OOD)测试集,并将它们从训练集和开发集划分中排除。详见 §A;分布内与 OOD 关系的对比见表5和表6。
我们在 OOD 测试集上的结果揭示了类似的关键发现:(1) 更高的 Unknown 比例会导致更低的 OOD 测试性能;(2) Unknown 示例对 OOD 性能有害,但主要是在
M
M
M 拟合它们时。OOD 测试准确率的线性模型(方程 (1))显示出类似趋势:
β
unk
<
0
\\beta_{\\text{unk}} < 0
βunk<0、
β
kn
>
0
\\beta_{\\text{kn}} > 0
βkn>0、
∣
β
ukn
∣
≈
∣
β
kn
∣
|\\beta_{\\text{ukn}}| \\approx |\\beta_{\\text{kn}}|
∣βukn∣≈∣βkn∣ 以及
R
2
=
0.95
R^2 = 0.95
R2=0.95(见表1)。更多细节见 §I。
总体而言,我们的发现可跨关系迁移。这本质上表明,在诸如“[E1] 位于哪里?”这样的 Unknown 示例上进行微调,可能会在看似无关的问题上助长幻觉,例如“谁创立了 [E2]?”。这进一步支持了如下结论:所观察到的效应很可能源于模型学习到了一种生成并不基于其既有知识的答案的行为。
5 理解知识类型:其价值与影响
在解决我们关于 Unknown 微调示例影响的主要研究问题时,为简单起见,我们将 Known 类别作为一个整体来处理(见图2a)。我们现在考察每个类别的效果,探讨以下问题:Q1:来自每个类别的训练示例如何影响测试性能?Q2:模型在来自每个类别的测试示例上的表现如何?为解决 Q1,我们创建了微调数据集
D
D
D 的单类别变体。仅由类别 CAT 的示例组成的
D
D
D 变体记为
D
CAT
D_{\\text{CAT}}
DCAT。作为参照,我们纳入了一个具有 ENTITYQUESTIONS 中自然类别分布的变体,记为
D
Natural
D_{\\text{Natural}}
DNatural。
∣
D
∣
|D|
∣D∣ 固定,并与 §4 中的实验相同。为解决 Q2,我们进一步按类别分解测试集性能。表2给出了结果。
MaybeKnown 示例至关重要。由于 Unknown 示例有害,人们可能会预期,最好在最具代表性的 HighlyKnown 示例上进行微调。令人惊讶的是,
D
HighlyKnown
D_{\\text{HighlyKnown}}
DHighlyKnown 并未取得最佳总体结果:它在 HighlyKnown 测试示例上表现出色,但在其余类别上的性能较差。
D
MaybeKnown
D_{\\text{MaybeKnown}}
DMaybeKnown 取得了最佳总体性能。与
D
HighlyKnown
D_{\\text{HighlyKnown}}
DHighlyKnown 相比,
D
MaybeKnown
D_{\\text{MaybeKnown}}
DMaybeKnown 提升了
M
D
M_D
MD 在 MaybeKnown 上的性能(
60.1
→
69.9
60.1 \\rightarrow 69.9
60.1→69.9),且未损害其在 HighlyKnown 上的性能(
98.7
→
98.4
98.7 \\rightarrow 98.4
98.7→98.4)。这表明 MaybeKnown 微调示例对于
M
D
M_D
MD 在推理时正确处理此类示例至关重要。它还表明,在合适的微调示例下,
M
D
M_D
MD 更有能力利用其既有知识。
有限知识会加剧过拟合。在 §4.2 中,我们证明了 Unknown 微调示例会增加过拟合风险。我们现在观察到,这也适用于 WeaklyKnown,尽管程度较轻。具体而言,在 CONVERGENCE 时,
D
WeaklyKnown
D_{\\text{WeaklyKnown}}
DWeaklyKnown 和
D
Unknown
D_{\\text{Unknown}}
DUnknown 相较于 EARLY_STOP 出现显著性能下降(
39.2
→
35.4
39.2 \\rightarrow 35.4
39.2→35.4 和
37.5
→
25.8
37.5 \\rightarrow 25.8
37.5→25.8)。当训练至 CONVERGENCE 时,它们在 WeaklyKnown 和 Unknown 上表现出适度提升,但在 HighlyKnown 和 MaybeKnown 上大幅退化。这突显出,性能下降在很大程度上归因于相对于
M
M
M 在预训练后已经知道的事实的幻觉率上升。
有趣的是,
D
Natural
D_{\\text{Natural}}
DNatural 在 EARLY_STOP 中与
D
MaybeKnown
D_{\\text{MaybeKnown}}
DMaybeKnown 表现相当,这表明
D
D
D 中只要存在 MaybeKnown 示例,就足以在 MaybeKnown 上取得高性能,即使
D
D
D 还包含来自其他类别的额外示例。然而,
D
Natural
D_{\\text{Natural}}
DNatural 的性能在 CONVERGENCE 后显著下降
10
^{10}
10,表现不如
D
MaybeKnown
D_{\\text{MaybeKnown}}
DMaybeKnown——这表明它仍受过拟合影响,而这很可能是因为存在 WeaklyKnown 和 Unknown 示例。综合来看,这些结果表明,
D
MaybeKnown
D_{\\text{MaybeKnown}}
DMaybeKnown 在最高性能和降低过拟合风险两方面都表现突出
6 SliCK 知识类别分析
评估模型的知识仍然是一个开放问题,特别是由于缺乏关于模型真正知道什么的真实基准,评估此类方法的质量具有挑战性。在这项工作中,我们提出了 SliCK(§3):一种相对于模型知识的事实的四类别分类。现在我们进一步分析和讨论我们的设计选择,希望 SliCK 能够作为一个有用的分类体系,指导未来关于该主题的研究。
细粒度的 Known 类别 我们首先反思,我们根据贪心解码结果将 Known 划分为更细粒度类别的选择是否已被证明有意义。如表 2 所示,HighlyKnown 确实捕捉了具有高知识程度的事实,因为它在微调后始终超过 95% 的准确率,而 MaybeKnown 和 WeaklyKnown 似乎代表较弱的知识程度。正如预期,WeaklyKnown 上的性能差于 MaybeKnown,但好于 Unknown。此外,我们所做的精确类别区分被证明是有用的,因为它揭示了关于 MaybeKnown 微调样本重要性的重要洞见,详见 §5。
对 Unknown 测试样本进行基准测试 对于测试集中出现的被分类为 Unknown 的
(
q
,
a
)
(q, a)
(q,a) 对,一个期望的性质是
M
M
M 在微调后会错误地回答
q
q
q(否则它们就不是真正的未知)。11 在表 2 中我们可以看到,未知上的准确率极低(3.2% 或更低),这强烈表明大多数未知样本实际上对
M
M
M 而言是未知的。作为对比的案例研究,我们分析了 Kadavath 等人 (2022) 的
P
(
T
r
u
e
)
\\mathrm{P(True)}
P(True) 方法:一种连续分数,用于估计模型赋予特定答案正确性的概率。
P
(
T
r
u
e
)
\\mathrm{P(True)}
P(True) 最初用于自我评估模型生成的答案,而我们用它来评估
M
M
M 是否将真实答案视为正确。 12 在图 5 中,我们探索将低于
P
(
T
r
u
e
)
\\mathrm{P(True)}
P(True) 阈值的样本分类为未知,并将这一方法与 SliCK 进行比较。我们的结果表明,至少在我们的设定中,我们的方法所归类的未知样本,其模型在微调后的性能显著更差。具体而言,观察
x
x
x 轴上的固定值可以发现,如果我们用两种方法将相似比例的测试样本标记为未知,那么基于
P
(
T
r
u
e
)
\\mathrm{P(True)}
P(True) 的未知样本在微调后的准确率会高得多。13 最后,蓝线表明,使用来自多个少样本提示的样本来近似
P
C
o
r
r
e
c
t
P_{\\mathrm{Correct}}
PCorrect 至关重要,因为使用
N
e
x
<
10
N_{ex} < 10
Nex<10 会导致在 SliCK 未知样本上更高的测试准确率。
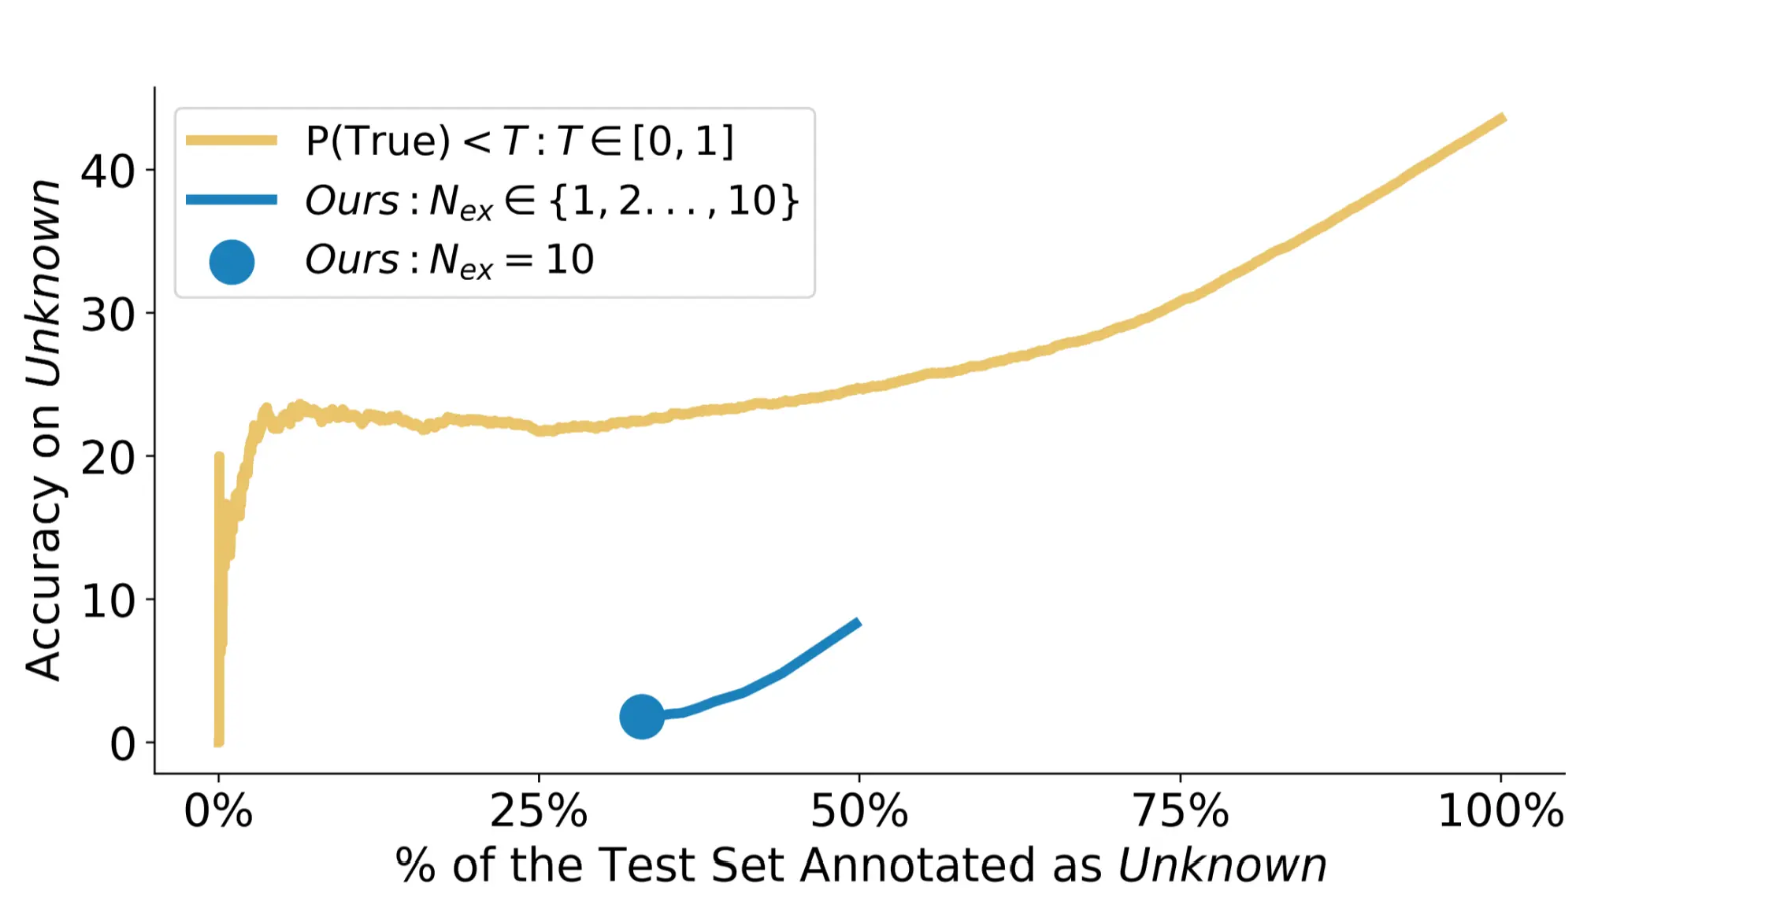 图 5:SliCK Unknown 分类与将
P
(
True
)
<
T
P(\\text{True}) < T
P(True)<T 的示例分类为 Unknown 的对比。x 轴是被分类为 Unknown 的测试示例百分比,y 轴是这些示例在微调后的准确率。黄色线是
T
∈
[
0
,
1
]
T \\in [0, 1]
T∈[0,1] 时的
P
(
True
)
P(\\text{True})
P(True)。我们的 Unknown 类别是蓝色圆圈,蓝色线对应于用少于 10 个随机 4-shot 示例来近似
P
Correct
P_{\\text{Correct}}
PCorrect(见 §3 和 §C)。
10参见§J了解关于此统计显著性检验的详细内容。 11由于在我们的闭卷 QA 设定中,训练集和测试集不相交,模型必须依赖其已有知识来回答测试问题。 12给定一个
(
q
,
a
)
(q, a)
(q,a) 对,
P
(
T
r
u
e
)
\\mathrm{P(True)}
P(True) 反映模型赋予
a
a
a 是
q
q
q 的答案的概率。它可以应用于模型生成的答案以进行自我评估,如原始研究中所做的那样;也可以应用于真实答案,以检查
M
M
M 是否将其视为正确,如我们的研究中所做的那样。 13这是一项初步分析,我们将全面比较留待未来工作。更多细节见 §K。
7 微调以对未知示例弃权
我们展示了,拟合未知微调示例会对测试性能产生负面影响(§4.2 和 §4.4)。然而,这种负面影响表现为一种过拟合形式。从实践角度来看,我们展示了可以通过使用早停或从微调数据集中过滤掉未知示例来缓解过拟合。
我们现在探索一种额外方法,即微调模型以对未知示例弃权,作为一种潜在缓解措施。具体而言,我们将未知微调示例的标签替换为“我不知道”这一表述,并检验这是否能缓解所观察到的过拟合。
表 3 给出了已回答的测试问题百分比(即 MD 未以“我不知道”作答)以及这些问题上的准确率。与先前工作的发现一致(Zhang et al., 2023),我们观察到在主动回答的测试示例上准确率有所提高(比较 D 与 DIDK 时)。当我们对 D 比较 EARLY_STOP 与 CONVERGENCE 时,观察到性能下降(
43.0
→
38.8
43.0 \\rightarrow 38.8
43.0→38.8),这说明了过拟合效应。然而,我们观察到,用不确定性表述重新标注未知示例似乎降低了过拟合风险。具体而言,DIDK 的准确率在 EARLY_STOP 和 CONVERGENCE 下均保持为 61.8,同时主动回答的问题数量略有下降(
58.7
→
55.6
58.7 \\rightarrow 55.6
58.7→55.6)。
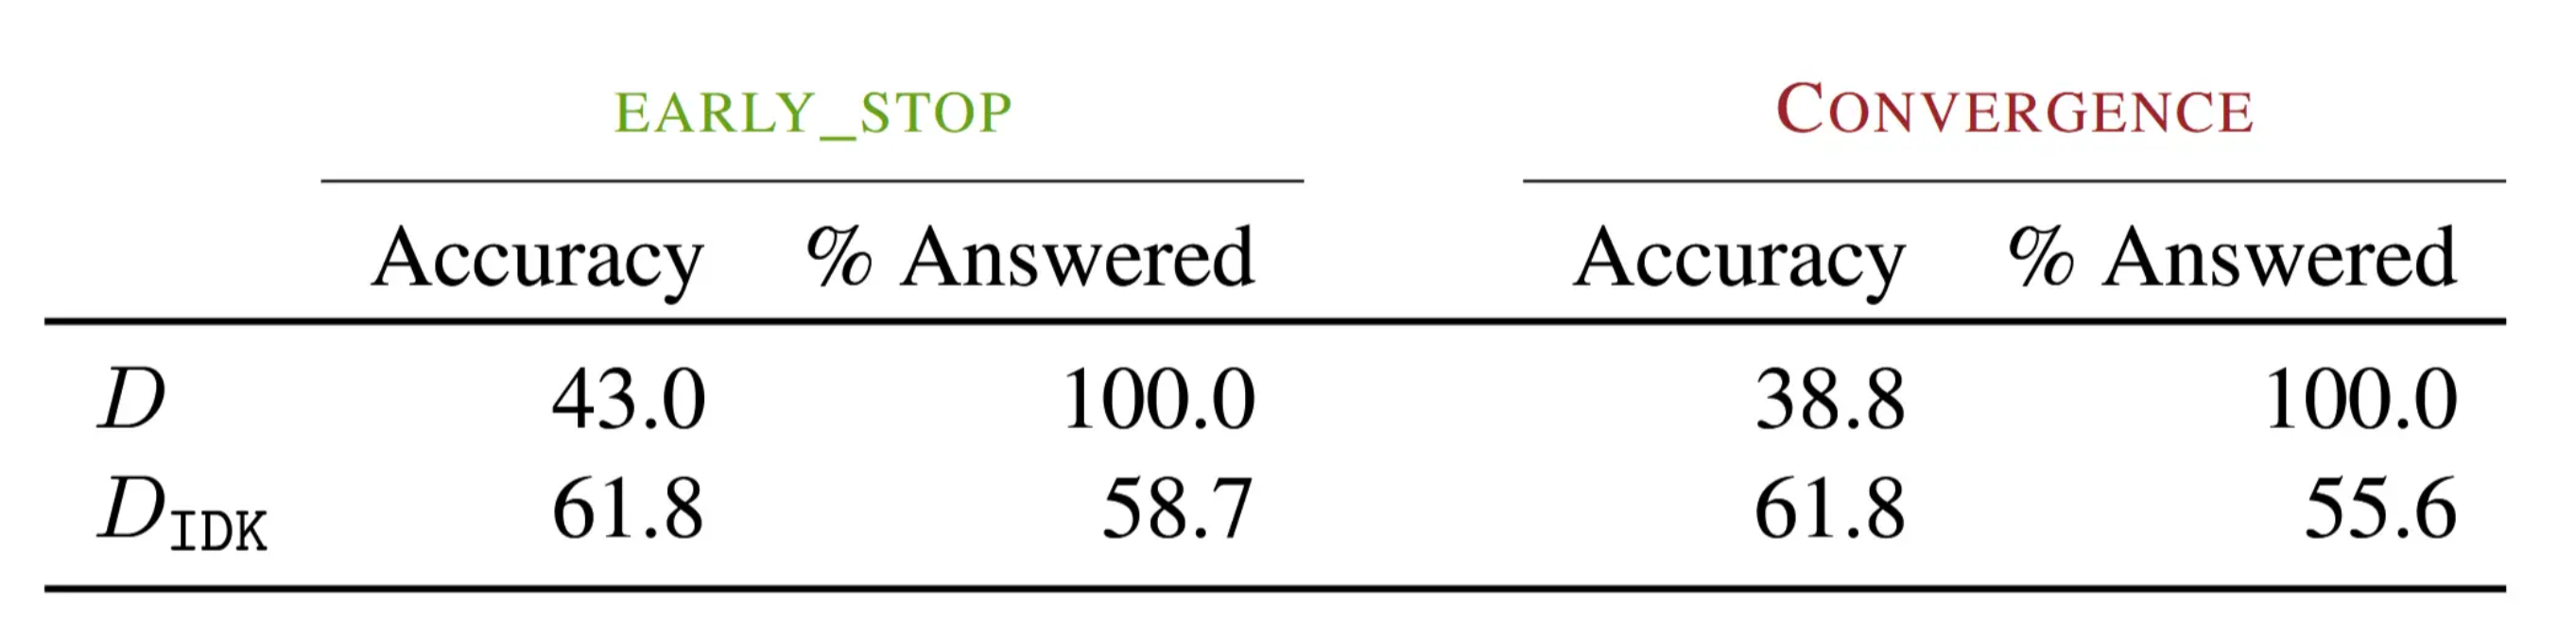
表 3:将 Unknown 微调示例的标签替换为“I don’t know”后的结果。此处的
D
D
D 是包含
50
%
50\\%
50% Known 和
50
%
50\\%
50% Unknown 的变体。DIDK 是将所有
50
%
50\\%
50% Unknown 微调示例重新标注为“I don’t know”的变体。准确率在已作答的测试问题子集上测量,即 MD 未以“I don’t know”作答。
8 讨论
实践意义。这项工作凸显了使用监督微调来更新 LLM 知识所存在的风险,因为我们提供了经验证据,表明通过微调获取新知识与关于既有知识的幻觉相关。此外,这项工作提出了关于微调实践的重要问题,有待未来探索。我们发现,未知示例比已知示例拟合得更慢,因此其负面影响表现为一种过拟合形式,这强调了使用早停而非固定数量的微调步骤的重要性。然而,当在众多具有不同最优停止点的任务上进行微调时,早停可能不那么有效。另一种解决方案可以是,通过过滤使微调数据与模型的知识对齐,从而避免添加新知识。剔除 Unknown 示例。我们展示了初步证据,表明这可以在不损害性能的情况下降低过拟合风险。过滤的一个可能缺点是,Unknown 微调示例仍可能有助于教会 LLM 在 Unknown 测试示例上表达不确定性(Zhang et al., 2023; Yang et al., 2023)。这提出了一个问题:用不确定性表达(例如“我不知道”)重新标注 Unknown 微调示例,能否减少其负面影响?我们的实验(第 7 节)表明答案是肯定的,这表明此类方法可能最有前景。 浅层对齐假说。Zhou et al. (2023) 假设 LLM 的知识和能力主要是在预训练期间习得的,而对齐则是一个简单过程,模型在其中学习与用户交互的风格或格式。他们通过表明仅在 1k 高质量示例上进行微调就能得到一个有竞争力的助手 LLM(名为 LIMA),从而证实了这一假说。如第 4.3 节所讨论,我们展示了证据,表明 LLM 难以获取 Unknown 示例中存在的新知识,而主要学会利用其已有知识。我们还表明,在 HighlyKnown 示例上进行微调会导致已有知识的次优利用,尽管我们的任务格式比 LIMA 的更简单,且我们的数据集大六倍。综上所述,我们的发现表明,尽管 LLM 的大部分知识确实是通过预训练获得的,但模型通过微调学到的不仅仅是风格或格式,因为微调示例的选择会显著影响模型在微调后利用其已有知识的能力。
9 相关工作
新知识与幻觉。Schulman (2023)、Goldberg (2023) 和 Gudibande et al. (2023) 提到一种猜想:在新事实知识上进行微调可能会助长幻觉。Huang et al. (2023) 对幻觉成因进行了分类,并将这一场景正式定义为能力错位,同时强调由于定义 LLM 知识边界的挑战,针对能力错位的研究有限。
近期研究支持我们的发现。例如,Ghosal et al. (2024) 表明,在众所周知的事实上微调的模型,相比在冷门事实上微调的模型,表现出更强的事实性,这可归因于模型对冷门事实的熟悉程度较低。另一个例子是 Lin et al. (2024),他们分别使用预训练模型或检索增强变体生成的数据来微调模型。他们发现后者导致事实性降低,这可归因于检索文本中引入了新的事实知识。Ren et al. (2024) 也在一个相当不同的方法设置中研究了通过微调引入新事实知识的影响,他们聚焦于多项选择题,进行相对较短的微调运行,并且仅测试 100% 已知和 100% 未知的混合情况。他们的结果与我们的结果一致,这进一步强化了我们的结论。最后,这些见解也被整合到 Llama 3 模型(Dubey et al., 2024)的指令微调阶段,以确保示例与预训练知识保持一致。
另一条工作方向探讨模型在测试时面对新知识的行为。Kang et al. (2024) 表明,当微调后的 LLM 在测试时遇到未知查询时,其响应会模仿微调数据中与未知示例相关联的响应。Yin et al. (2023) 表明,当 LLM 在其输入上下文中面对新知识时,其性能并不令人满意;Lee et al. (2023) 分析了未知上下文学习示例的影响。
量化 LLM 中的知识。SliCK 可以被视为一种针对真实标签的置信度引出方法(
M
M
M 知道
(
q
,
a
)
(q, a)
(q,a),如果它确信
a
a
a 是
q
q
q 的答案)。现有工作通过检查多个样本之间的一致性(Kuhn et al., 2023; Manakul et al., 2023; Tian et al., 2023a; Lyu et al., 2024)、探查内部表示(Azaria and Mitchell, 2023; Burns et al., 2022)、引出言语化概率(Tian et al., 2023b)或直接提示(Kadavath et al., 2022),从 LLM 中获得校准置信度。Kadavath et al. 还训练了一个单独的
P
(
IK
)
P(\\text{IK})
P(IK) 模型,以预测 LLM 是否知道
q
q
q 的答案。
P
(
IK
)
P(\\text{IK})
P(IK) 的标签由正确采样答案的比例近似,这在概念上与
P
Correct
P_{\\text{Correct}}
PCorrect(§3)一致。一个关键区别在于,我们还定义了 SliCK 类别,并提供证据表明我们捕捉到了有意义且有用的类别。
10 结论
我们研究通过微调整合新事实知识对模型产生幻觉倾向的影响。我们首先提出 SliCK,一种依据 LLM 知识对事实进行的分类。然后,我们设计了一项受控研究,在其中隔离新知识的影响,并严格评估其效应。我们提供了关于微调动态的多项见解,关键发现如下:(1) 通过监督微调获取新知识与针对已有知识的幻觉相关。(2) LLM 难以通过微调整合新知识,并且大多学会使用其已有知识。
11 局限性
我们的实验仅使用单个 LLM 进行,因此尚不清楚结果是否会随不同 LLM 而变化。话虽如此,我们的研究计算开销极大,因此难以在多个 LLM 上复现:首先,我们的微调计算开销很大,因为其运行时间非常长,我们想要分析微调不同阶段(包括过拟合阶段)中的行为。其次,也是最重要的一点,为了促进我们的研究,我们需要依据 SliCK 类别标注一个大规模数据集。为了得出可靠结论,准确评估模型相对于单个微调示例的知识至关重要。在我们的情况中,我们对每个示例运行 170 个推理步骤,即超过 1500 万次推理步骤来对我们完整数据集进行分类。
此外,由于我们聚焦于闭卷问答,我们研究的实际意义,例如过滤掉未知微调示例,仍需要在涉及长文本生成的场景中验证。为了在长文本生成任务中过滤掉引入新事实知识的示例,需要对 SliCK 进行调整,并提出一种有效方法来比较采样答案与真实答案,以近似
P
Correct
P_{\\text{Correct}}
PCorrect。我们将此留待未来工作。长文本生成任务带来了评估挑战,导致基于 LLM 的评估被广泛采用。我们明确选择聚焦于闭卷问答,这有助于实现更准确的评估,从而增强我们发现的可靠性。
最后,我们没有测试将来自不同任务的额外微调示例加入微调混合数据中的效果。虽然这可能更接近典型的指令微调场景,但此类数据集扩展可能以不可控的方式引入新的事实知识,从而限制我们的发现。
引用文献
Badr AlKhamissi, Millicent Li, Asli Celikyilmaz, Mona Diab, and Marjan Ghazvininejad. 2022. A review on language models as knowledge bases. arXiv preprint arXiv:2204.06031. Rohan Anil, Andrew M Dai, Orhan Firat, Melvin Johnson, Dmitry Lepikhin, Alexandre Passos, Siamak Shakeri, Emanuel Taropa, Paige Bailey, Zhifeng Chen, et al. 2023. Palm 2 technical report. arXiv preprint arXiv:2305.10403. Amos Azaria and Tom Mitchell. 2023. The internal state of an llm knows when its lying. arXiv preprint arXiv:2304.13734. Dan Biderman, Jacob Portes, Jose Javier Gonzalez Ortiz, Mansheej Paul, Philip Greengard, Connor Jennings, Daniel King, Sam Havens, Vitaliy Chiley, Jonathan Frankle, Cody Blakeney, and John Patrick Cunningham. 2024. LoRA learns less and forgets less. Transactions on Machine Learning Research. Featured Certification. Collin Burns, Haotian Ye, Dan Klein, and Jacob Steinhardt. 2022. Discovering latent knowledge in language models without supervision. arXiv preprint arXiv:2212.03827. I Chern, Steffi Chern, Shiqi Chen, Weizhe Yuan, Kehua Feng, Chunting Zhou, Junxian He, Graham Neubig, Pengfei Liu, et al. 2023. Factool: Factuality detection in generative ai–a tool augmented framework for multi-task and multi-domain scenarios. arXiv preprint arXiv:2307.13528. Roi Cohen, Mor Geva, Jonathan Berant, and Amir Globerson. 2023. Crawling the internal knowledgebase of language models. In Findings of the Association for Computational Linguistics: EACL 2023, pages 1856–1869, Dubrovnik, Croatia. Association for Computational Linguistics. Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. 2024. The llama 3 herd of models. arXiv preprint arXiv:2407.21783. Leo Gao. 2021. Behavior cloning is miscalibrated. AI Alignment Forum. Zorik Gekhman, Jonathan Herzig, Roee Aharoni, Chen Elkind, and Idan Szpektor. 2023. TrueTeacher: Learning factual consistency evaluation with large language models. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 2053–2070, Singapore. Association for Computational Linguistics. Gaurav Rohit Ghosal, Tatsunori Hashimoto, and Aditi Raghunathan. 2024. Understanding finetuning for factual knowledge extraction. In Forty-first International Conference on Machine Learning, ICML 2024, Vienna, Austria, July 21-27, 2024. OpenReview.net. Yoav Goldberg. 2023. Reinforcement learning for language models. Arnav Gudibande, Eric Wallace, Charlie Snell, Xinyang Geng, Hao Liu, Pieter Abbeel, Sergey Levine, and Dawn Song. 2023. The false promise of imitating proprietary llms. arXiv preprint arXiv:2305.15717. Zeyu Han, Chao Gao, Jinyang Liu, Sai Qian Zhang, et al. 2024. Parameter-efficient fine-tuning for large models: A comprehensive survey. arXiv preprint arXiv:2403.14608. Or Honovich, Roee Aharoni, Jonathan Herzig, Hagai Taitelbaum, Doron Kukliansy, Vered Cohen, Thomas Scialom, Idan Szpektor, Avinatan Hassidim, and Yossi Matias. 2022. TRUE: Re-evaluating factual consistency evaluation. In Proceedings of the 2022 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, pages 3905–3920, Seattle, United States. Association for Computational Linguistics. Or Honovich, Leshem Choshen, Roee Aharoni, Ella Neeman, Idan Szpektor, and Omri Abend. 2021. q2: Evaluating factual consistency in knowledgegrounded dialogues via question generation and question answering. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, pages 7856–7870, Online and Punta Cana, Dominican Republic. Association for Computational Linguistics. Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang, and Weizhu Chen. 2022. Lora: Low-rank adaptation of large language models. In The Tenth International Conference on Learning Representations, ICLR 2022, Virtual Event, April 25-29, 2022. OpenReview.net. Lei Huang, Weijiang Yu, Weitao Ma, Weihong Zhong, Zhangyin Feng, Haotian Wang, Qianglong Chen, Weihua Peng, Xiaocheng Feng, Bing Qin, et al. 2023. A survey on hallucination in large language models: Principles, taxonomy, challenges, and open questions. arXiv preprint arXiv:2311.05232. Adam Ibrahim, Benjamin Thérien, Kshitij Gupta, Mats Leon Richter, Quentin Gregory Anthony, Eugene Belilovsky, Timothée Lesort, and Irina Rish. 2024. Simple and scalable strategies to continually pre-train large language models. Transactions on Machine Learning Research. Zhengbao Jiang, Zhiqing Sun, Weijia Shi, Pedro Rodriguez, Chunting Zhou, Graham Neubig, Xi Lin, Wen-tau Yih, and Srini Iyer. 2024. Instruction-tuned language models are better knowledge learners. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 5421–5434, Bangkok, Thailand. Association for Computational Linguistics. Saurav Kadavath, Tom Conerly, Amanda Askell, Tom Henighan, Dawn Drain, Ethan Perez, Nicholas Schiefer, Zac Hatfield-Dodds, Nova DasSarma, Eli Tran-Johnson, et al. 2022. Language models (mostly) know what they know. arXiv preprint arXiv:2207.05221. Ehsan Kamalloo, Nouha Dziri, Charles L. A. Clarke, and Davood Rafiei. 2023. Evaluating open-domain question answering in the era of large language models. In Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), ACL 2023, Toronto, Canada, July 9-14, 2023, pages 5591–5606. Association for Computational Linguistics. Katie Kang, Eric Wallace, Claire Tomlin, Aviral Kumar, and Sergey Levine. 2024. Unfamiliar finetuning examples control how language models hallucinate. arXiv preprint arXiv:2403.05612. Wojciech Kryscinski, Bryan McCann, Caiming Xiong, and Richard Socher. 2020. Evaluating the factual consistency of abstractive text summarization. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP), pages 9332–9346, Online. Association for Computational Linguistics. Lorenz Kuhn, Yarin Gal, and Sebastian Farquhar. 2023. Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. arXiv preprint arXiv:2302.09664. Philippe Laban, Tobias Schnabel, Paul N. Bennett, and Marti A. Hearst. 2022. SummaC: Re-visiting NLIbased models for inconsistency detection in summarization. Transactions of the Association for Computational Linguistics, 10:163–177. Yoonsang Lee, Pranav Atreya, Xi Ye, and Eunsol Choi. 2023. Crafting in-context examples according to lms’ parametric knowledge. arXiv preprint arXiv:2311.09579. Bill Yuchen Lin, Abhilasha Ravichander, Ximing Lu, Nouha Dziri, Melanie Sclar, Khyathi Chandu, Chandra Bhagavatula, and Yejin Choi. 2023. The unlocking spell on base llms: Rethinking alignment via in-context learning. ArXiv preprint. Sheng-Chieh Lin, Luyu Gao, Barlas Oguz, Wenhan Xiong, Jimmy Lin, Wen-tau Yih, and Xilun Chen. 2024. Flame: Factuality-aware alignment for large language models. arXiv preprint arXiv:2405.01525. Qing Lyu, Kumar Shridhar, Chaitanya Malaviya, Li Zhang, Yanai Elazar, Niket Tandon, Marianna Apidianaki, Mrinmaya Sachan, and Chris Callison-Burch. 2024. Calibrating large language models with sample consistency. arXiv preprint arXiv:2402.13904. Potsawee Manakul, Adian Liusie, and Mark JF Gales. 2023. Selfcheckgpt: Zero-resource black-box hallucination detection for generative large language models. arXiv preprint arXiv:2303.08896. Kevin Meng, David Bau, Alex Andonian, and Yonatan Belinkov. 2022. Locating and editing factual associations in GPT. In Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, November 28 – December 9, 2022. Kevin Meng, Arnab Sen Sharma, Alex J. Andonian, Yonatan Belinkov, and David Bau. 2023. Massediting memory in a transformer. In The Eleventh International Conference on Learning Representations, ICLR 2023, Kigali, Rwanda, May 1-5, 2023. OpenReview.net. Sewon Min, Kalpesh Krishna, Xinxi Lyu, Mike Lewis, Wen-tau Yih, Pang Koh, Mohit Iyyer, Luke Zettlemoyer, and Hannaneh Hajishirzi. 2023. FActScore: Fine-grained atomic evaluation of factual precision in long form text generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 12076–12100, Singapore. Association for Computational Linguistics. Swaroop Mishra, Daniel Khashabi, Chitta Baral, and Hannaneh Hajishirzi. 2022. Cross-task generalization via natural language crowdsourcing instructions. In Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 3470–3487, Dublin, Ireland. Association for Computational Linguistics. Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll L. Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul F. Christiano, Jan Leike, and Ryan Lowe. 2022. Training language models to follow instructions with human feedback. In Advances in Neural Information Processing Systems 35: Annual Conference on Neural Information Processing Systems 2022, NeurIPS 2022, New Orleans, LA, USA, November 28 – December 9, 2022. Jupinder Parmar, Sanjev Satheesh, Mostofa Patwary, Mohammad Shoeybi, and Bryan Catanzaro. 2024. Reuse, don’t retrain: A recipe for continued pretraining of language models. arXiv preprint arXiv:2407.07263. Fabio Petroni, Tim Rocktäschel, Sebastian Riedel, Patrick Lewis, Anton Bakhtin, Yuxiang Wu, and Alexander Miller. 2019. Language models as knowledge bases? In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP), pages 2463–2473, Hong Kong, China. Association for Computational Linguistics. Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D Manning, Stefano Ermon, and Chelsea Finn. 2024. Direct preference optimization: Your language model is secretly a reward model. Advances in Neural Information Processing Systems, 36. Pranav Rajpurkar, Jian Zhang, Konstantin Lopyrev, and Percy Liang. 2016. SQuAD: 100,000+ questions for machine comprehension of text. In Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, pages 2383–2392, Austin, Texas. Association for Computational Linguistics. Mengjie Ren, Boxi Cao, Hongyu Lin, Cao Liu, Xianpei Han, Ke Zeng, Wan Guanglu, Xunliang Cai, and Le Sun. 2024. Learning or self-aligning? rethinking instruction fine-tuning. In Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 60906105, Bangkok, Thailand. Association for Computational Linguistics. Ohad Rubin, Jonathan Herzig, and Jonathan Berant. 2022. Learning to retrieve prompts for in-context learning. In Proceedings of the 2022 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, pages 2655–2671, Seattle, United States. Association for Computational Linguistics. John Schulman. 2023. Reinforcement learning from human feedback: Progress and challenges. Thomas Scialom, Paul-Alexis Dray, Sylvain Lamprier, Benjamin Piwowarski, Jacopo Staiano, Alex Wang, and Patrick Gallinari. 2021. QuestEval: Summarization asks for fact-based evaluation. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, pages 6594–6604, Online and Punta Cana, Dominican Republic. Association for Computational Linguistics. Christopher Sciavolino, Zexuan Zhong, Jinhyuk Lee, and Danqi Chen. 2021. Simple entity-centric questions challenge dense retrievers. In Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, EMNLP 2021, Virtual Event / Punta Cana, Dominican Republic, 7-11 November, 2021, pages 6138–6148. Association for Computational Linguistics. Katherine Tian, Eric Mitchell, Huaxiu Yao, Christopher D Manning, and Chelsea Finn. 2023a. Finetuning language models for factuality. arXiv preprint arXiv:2311.08401. Katherine Tian, Eric Mitchell, Allan Zhou, Archit Sharma, Rafael Rafailov, Huaxiu Yao, Chelsea Finn, and Christopher D Manning. 2023b. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. arXiv preprint arXiv:2305.14975. Pranav Narayanan Venkit, Tatiana Chakravorti, Vipul Gupta, Heidi Biggs, Mukund Srinath, Koustava Goswami, Sarah Rajtmajer, and Shomir Wilson. 2024. " confidently nonsensical?": A critical survey on the perspectives and challenges of’hallucinations’ in nlp. arXiv preprint arXiv:2404.07461. Denny Vrandeˇci ́c and Markus Krötzsch. 2014. Wikidata: a free collaborative knowledgebase. Commun. ACM, 57(10):78–85. Cunxiang Wang, Sirui Cheng, Qipeng Guo, Yuanhao Yue, Bowen Ding, Zhikun Xu, Yidong Wang, Xiangkun Hu, Zheng Zhang, and Yue Zhang. 2023. Evaluating open-qa evaluation. In Advances in Neural Information Processing Systems 36: Annual Conference on Neural Information Processing Systems 2023, NeurIPS 2023, New Orleans, LA, USA, December 10 – 16, 2023. Jason Wei, Maarten Bosma, Vincent Y. Zhao, Kelvin Guu, Adams Wei Yu, Brian Lester, Nan Du, Andrew M. Dai, and Quoc V. Le. 2022. Finetuned language models are zero-shot learners. In The Tenth International Conference on Learning Representations, ICLR 2022, Virtual Event, April 25-29, 2022. OpenReview.net. Yuqing Yang, Ethan Chern, Xipeng Qiu, Graham Neubig, and Pengfei Liu. 2023. Alignment for honesty. Xunjian Yin, Baizhou Huang, and Xiaojun Wan. 2023. ALCUNA: Large language models meet new knowledge. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 1397–1414, Singapore. Association for Computational Linguistics. Gal Yona, Roee Aharoni, and Mor Geva. 2024. Narrowing the knowledge evaluation gap: Open-domain question answering with multi-granularity answers. arXiv preprint arXiv:2401.04695. Hanning Zhang, Shizhe Diao, Yong Lin, Yi R Fung, Qing Lian, Xingyao Wang, Yangyi Chen, Heng Ji, and Tong Zhang. 2023. R-tuning: Teaching large language models to refuse unknown questions. arXiv preprint arXiv:2311.09677. Zexuan Zhong, Zhengxuan Wu, Christopher D. Manning, Christopher Potts, and Danqi Chen. 2023. Mquake: Assessing knowledge editing in language models via multi-hop questions. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, EMNLP 2023, Singapore, December 6-10, 2023, pages 15686–15702. Association for Computational Linguistics. Chunting Zhou, Pengfei Liu, Puxin Xu, Srinivasan Iyer, Jiao Sun, Yuning Mao, Xuezhe Ma, Avia Efrat, Ping Yu, Lili Yu, Susan Zhang, Gargi Ghosh, Mike Lewis, Luke Zettlemoyer, and Omer Levy. 2023. LIMA: less is more for alignment. In Advances in Neural Information Processing Systems 36: Annual Conference on Neural Information Processing Systems 2023, NeurIPS 2023, New Orleans, LA, USA, December 10 – 16, 2023. Chen Zhu, Ankit Singh Rawat, Manzil Zaheer, Srinadh Bhojanapalli, Daliang Li, Felix Yu, and Sanjiv Kumar. 2020. Modifying memories in transformer models. arXiv preprint arXiv:2012.00363.


评论前必须登录!
注册