 网硕互联帮助中心
本章摘要:这一章是全书从「看懂」转向「做出东西」的分水岭,核心技能只有一句话——先问「我要加的行为挂在哪个扩展点」,再问「怎么写」。全章包含六个可直接照做的实操:写一个工具、写一个权限门禁、写一个模型适配器、让界面显示实时输出、写一个协议驱动、委派给子 agent。每个实操都按「它挂在哪 → 最小可用代码 → 跑起来看什么 → 容易踩的坑」的节奏展开,最后用一张「加新行为的完整清单」和三句话收尾。读完这一章,第九章之前提到的每一个扩展点你都会亲手碰到一遍。
10.1 第一步:学会问「挂在哪」
这是全部开发工作的核心技能。不要一开始就想「我要写什么代码」,先问:「我要加的这个行为,应该挂在哪个扩展点上?」
官方在架构文档里给了一张「新行为的归属位置」表,在实操手册里给了另一张更贴近产品的「功能→机制」映射表。两者合起来,就是一张完整的地图。下面按「你想做什么」重组一次,方便检索。
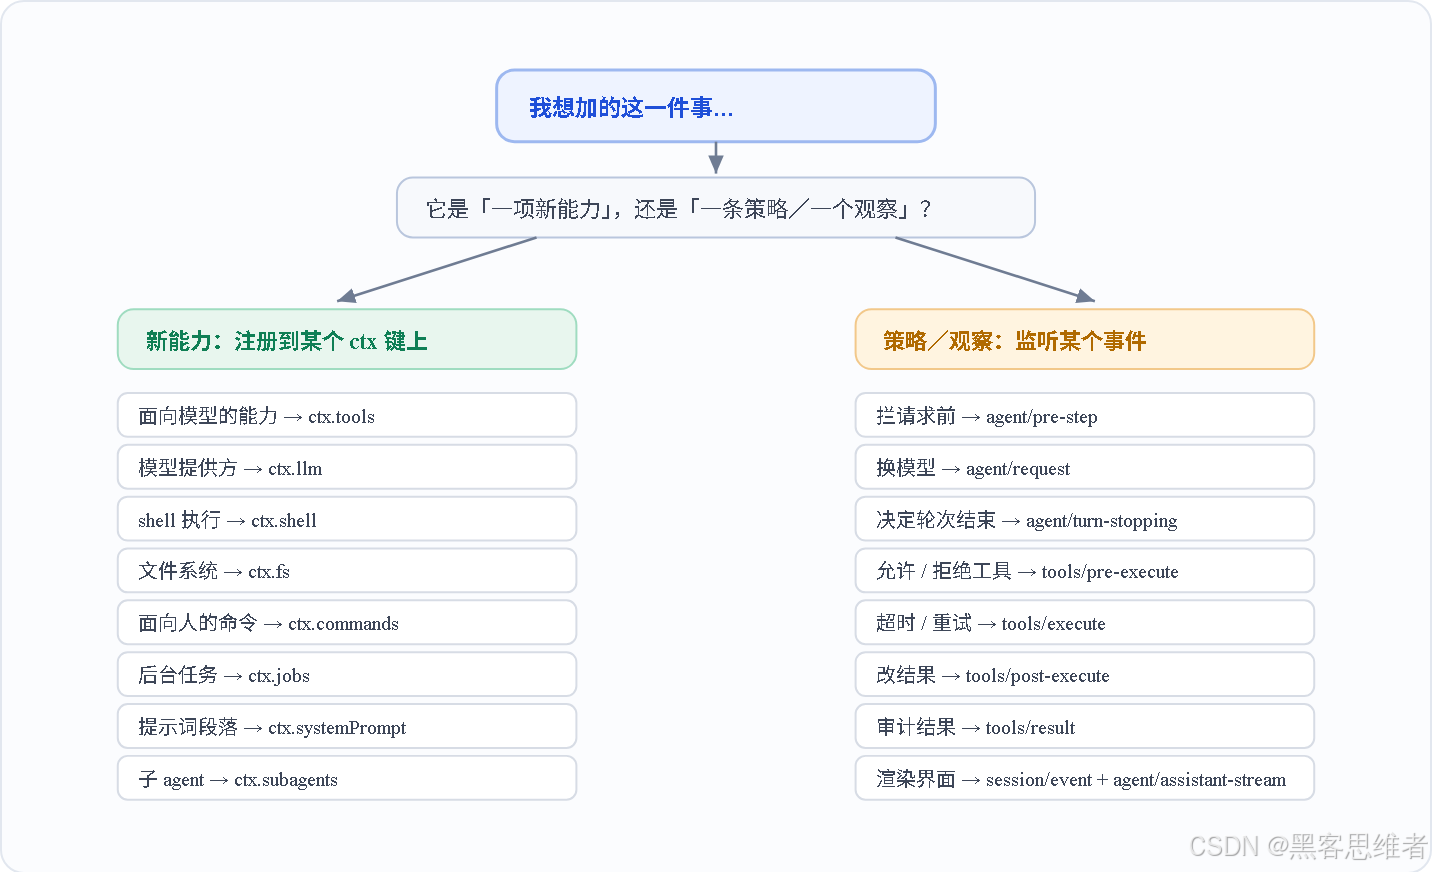
这张图请记住。它回答的是这本书一开始提出的那个问题。
10.2 零基础环境搭建:先把东西跑起来
在写任何插件之前,先让它跑起来。官方给了两条路。
路线一:直接用 npm(最快)
npx @deepseek-ai/dsh web
这会默认在 http://127.0.0.1:3080 启动 Web UI,本机启动时还会用默认浏览器打开页面。
两个实用参数:
| –no-open | 只运行服务器,不打开浏览器 |
| –patch <路径> | 临时叠加一层 patch。开发插件时最常用它,因为你不想每次都改 profile |
官方还提到一个 SSH 场景的细节:通过 SSH 启动时只打印宿主机 URL,因为本地转发地址由 SSH 客户端或编辑器持有。
路线二:从源码运行(要读源码、写插件时必须)
git clone https://github.com/deepseek-ai/deepseek-harness.git
cd deepseek-harness
pnpm install
pnpm run build
pnpm dsh web
两个命令的差别值得注意:pnpm run build 准备仓库产物;pnpm dsh web 直接使用这些已构建产物,不会重新构建。开发时你大概想要的是 pnpm run dev:web——它在源码修改时重建客户端 bundle。
陷阱
官方在 README 里用加粗写了一条:**运行本项目前,请阅读安全说明。**另外项目处于「开发者预览」阶段并且明确写着「未来将出现破坏兼容性的变更」。所以:不要在关键生产环境上直接依赖它,读到的一切请以你手上那份代码为准。
学 Cordis 之后再动 harness
官方给了一条很明确的路径建议:Cordis 有一份七章的动手教程(第一个插件 → 生命周期与 effect → 服务 → 事件 → 配置 → 组合与 HMR → 进入 harness),每一章都是一个可以运行的示例,而且全程不需要 API 密钥。如果你想认真做插件,把这七章过一遍的收益远高于直接读架构文档。教程的第一章从 tmp/cordis-tutorial 目录里跑 node –import tsx ../../vendor/cordis/bin.js 开始。
10.3 实操一:写一个工具(最完整的例子)
这是最常做的开发。第 6 章给了骨架,这里给一个完整、带解释的版本。
import { readFile } from 'node:fs/promises'
import type { Context } from '@deepseek-ai/cordis'
import { defineTool } from '@deepseek-ai/dsh-tools'
export const name = 'my-tools'
export const inject = ['tools']
export function apply(ctx: Context) {
ctx.tools.register(defineTool({
name: 'read_file',
description:
'Read a UTF-8 text file from disk. ' +
'Use this before editing a file. ' +
'Returns the file content as text.',
parameters: {
path: { type: 'string', required: true, description: 'Absolute path' },
limit: { type: 'number', description: 'Max lines to return' },
},
output: {
schema: { type: 'string' },
render: (_args, value) => [{ type: 'text', text: value }],
},
timeoutMs: 10_000,
async execute(args, exec) {
const text = await readFile(args.path, { encoding: 'utf8', signal: exec.signal })
const lines = text.split('\\n')
return args.limit ? lines.slice(0, args.limit).join('\\n') : text
},
}))
}
逐段解释这份代码「为什么这么写」:
| inject = ['tools'] | 让 Cordis 等工具注册表就绪。少了它,你的 ctx.tools 可能是 undefined |
| description 写了三句话 | **这是模型理解这个工具的唯一依据。**第一句说做什么,第二句说什么时候用(很重要,能显著减少误用),第三句说返回什么 |
| parameters 里 path 标了 required | defineTool 会在执行前校验。execute 收到的 args 已经是强类型且合法的 |
| output.schema 是 { type: 'string' } | 函数体返回一个字符串。注册表会按这个 schema 校验返回值——返回不对的类型会被转成 isError |
| render 把字符串包成一个 text 块 | 规范值 → 模型可见内容的投影。这个分离让 PTC 里的代码能拿到裸字符串,而不是一段包装过的内容块 |
| timeoutMs: 10_000 | 声明超时预算。注意:它同时是一份承诺——你声明了它,就意味着这个工具会把 exec.signal 转给一个能收敛的实现。readFile 支持 signal,所以这里成立 |
| signal: exec.signal | 把取消信号传下去。用户按停止时,这个读操作会被真正取消 |
怎么跑起来
官方教程给的方式是:把插件写在一个目录里,用 –patch 指过去:
pnpm dsh web –patch ./scratch-plugin/cordis.yml
然后在界面里对模型说:Use the greet tool to greet Ada.(这是官方教程里的原话,把 greet 换成你的工具名即可)。
进阶要点速查
| 参数校验更复杂(非空、正数、跨字段) | schema DSL 表达不了的,在 execute 里手动检查 |
| 让模型看到结构化结果 | 把 output.schema 设计成实用的程序化 API:直接返回句柄与字段 |
| 给界面做漂亮卡片 | 用 presentCall / presentResult 返回渲染意图。必须是纯函数 |
| 让卡片在回放时也能还原 | 用 output.presentationMeta(args, value) 投影出可回放的 JSON |
| 跑很久的任务 | 用 ctx.jobs.start({ kind, label, owner: exec.agent, run }) |
| 工具执行后给模型补一段说明 | exec.deferContext(…)——会在 tool/result 之后追加一条 user/message |
| 让这个工具结束整个轮次 | exec.concludeTurn()(只在成功结果上有效) |
| 异步通知模型(不唤醒) | exec.agent.inject({ content, source: { kind: 'plugin', plugin: '你的名字' } }),并 try/catch 防已销毁的 agent |
10.4 实操二:写一个权限门禁(钩子插件)
第 1 章已经给过这个例子。这里补充「完整版」要考虑的几件事。
import type { Context } from '@deepseek-ai/cordis'
import type { PreToolDecision, ToolExecution } from '@deepseek-ai/dsh-tools'
// 危险命令清单(示意)
const DANGEROUS = [/rm\\s+-rf\\s+\\//, /mkfs/, /:\\(\\)\\{:\\|:&\\};:/]
function inspect(exec: ToolExecution): { deny?: string; ask?: boolean } {
if (exec.name !== 'bash') return {}
const cmd = String((exec.arguments as { command?: string })?.command ?? '')
if (DANGEROUS.some(re => re.test(cmd))) {
return { deny: 'This command matches a destructive pattern and is blocked.' }
}
if (/\\bgit\\s+push\\b/.test(cmd)) {
return { ask: true } // 让它走人工确认
}
return {}
}
export const name = 'my-permission-gate'
export const inject = ['tools']
export function apply(ctx: Context) {
ctx.on('tools/pre-execute', async (exec, next): Promise<PreToolDecision> => {
const verdict = inspect(exec)
if (verdict.deny) {
return { kind: 'deny', reason: verdict.deny }
}
if (verdict.ask) {
return {
kind: 'ask',
reason: 'push-to-remote', // 审计用的原因
displayReason: { en: 'Push to remote?', zh: '要推送到远端吗?' },
}
}
return next() // 没意见,交给下游
})
// 一条不可撤销的底线:无论谁放行,都不允许在根目录做破坏性写操作
ctx.tools.guard((exec) => {
if (exec.name === 'bash' && /\\brm\\s+-rf\\s+\\/\\s*$/.test(String((exec.arguments as any)?.command ?? ''))) {
return 'Refusing to remove the filesystem root.'
}
return undefined
})
}
这个版本比第 1 章多了三个要点:
| deny 和 ask 分开用 | deny 是「绝对不行」,ask 是「让用户决定」。 ask 会走 ctx.approval,只有 allowed-once 才继续,而且没有回答方时直接拒绝 |
| displayReason 做了本地化 | 它是给用户看的文案;而 reason 是审计用的稳定标识。两者的读者不同,不要混用 |
| 最后挂了一条 guard | **守卫没有 allow,所以这条底线无法被任何后续监听器翻案。**这就是「单调」的价值 |
10.5 实操三:写一个模型适配器
接入一家新的模型厂商,需要实现 LlmAdapter。它的接口设计得很精简——只有一个抽象方法必须实现。
import { LlmAdapter } from '@deepseek-ai/dsh-llm'
import type { Context } from '@deepseek-ai/cordis'
class MyProviderAdapter extends LlmAdapter {
/** 唯一的必填方法:把一次调用变成原始分片流 */
async *stream(options) {
const res = await fetch(this.baseURL, {
method: 'POST',
headers: { …this.headers, 'User-Agent': attributionHeaders().UserAgent },
body: JSON.stringify(toProviderPayload(options)),
signal: options.signal, // 必须遵守
})
// 把提供方的 SSE 逐条翻译成 StreamChunk
for await (const evt of parseSSE(res.body)) {
yield toStreamChunk(evt) // block-start / *-delta / block-end / usage / finish
}
}
/** 展示元信息 */
providerInfo(provider) { return { id: provider, name: 'My Provider' } }
/** 可发现模型列表(给界面用的参考目录,不是请求白名单) */
async listModels() { return [{ provider: this.id, id: 'my-model', name: 'My Model' }] }
/** 精确模型能力:上下文容量、默认输出上限、推理档位、更新模式 */
async resolveModel(provider, model) {
return { provider, id: model, name: model, context: { contextWindow: 128_000 } }
}
}
export const name = 'my-llm-provider'
export const inject = ['llm']
export function apply(ctx: Context) {
ctx.llm.registerAdapter(['my-provider'], new MyProviderAdapter())
}
写适配器时要记住的约定(第 7 章那张表的浓缩版):
必须做
usage 在 finish 之前发,finish 之后什么都不发
工具调用的 arguments 全程保持原始 JSON 字符串
每个 HTTP 请求带上 attributionHeaders()
把上下文溢出归一化为 CONTEXT_WINDOW_EXCEEDED
把无内容块的终止性 stop 映射为 EMPTY_RESPONSE 错误
遵守 options.signal
不要做
不要在适配器里实现重试——那是 agent 层的职责
不要自己拼装块——用共享的 BlockAssembler
不要用提供方文本做错误路由——按 code
不要把 catalog 当请求白名单——它只是参考目录,适配器才是权威
不要把私有元数据当共享词汇——它是不透明的,只有「切分方式」是共享的
官方还给了一个很实用的提醒:**一次适配器调用就是一次提供方尝试。**agent 层的恢复会打开另一个持久、带编号的轮次;直接调 ctx.llm.stream() 的调用方仍然只尝试一次。所以如果你在写一个直接调用层的东西,要知道重试不是自动的。
10.6 实操四:让界面显示实时输出
如果你在写 UI 或编辑器集成,模式是这样的:
import { brandString } from '@deepseek-ai/dsh-brand'
import { createUserMessage } from '@deepseek-ai/dsh-llm'
export const name = 'my-ui'
export const inject = ['agents']
export function apply(ctx) {
// 1) 实时 token 流:给「打字机效果」用
ctx.on('agent/assistant-stream', ({ frame }) => {
if (frame.type === 'chunk' && frame.chunk.type === 'text-delta') {
render(frame.chunk.text)
}
})
// 2) 持久事实:给「历史记录」「工具卡片」「审计」用
ctx.on('session/event', (session, event) => {
if (event.type === 'tool/call') showToolCard(event.data)
if (event.type === 'tool/result') finishToolCard(event.data)
if (event.type === 'turn/end') markTurnDone(event.data.reason)
})
// 3) 把输入送回去
onUserInput(text => ctx.agents
.get(brandString('client-session'))
?.followup(createUserMessage({
content: [{ type: 'text', text }],
source: { kind: 'user' },
})))
}
关键
官方给了两条不同用途的通道,别用错:
· 实时 token 呈现 → agent/assistant-stream(瞬态,不写日志,唯一的远程消费方是 Web Session-follow 适配器)
· 可回放的持久数据 → session/event(持久,可以重放、可以审计、可以做 trace)
官方原话:「需要可回放 transcript 数据的 SDK 用户应当消费 session/event;agent/* 是用于队列与状态、提示词拦截、请求构造、steering、继续执行和错误处理的实时协调接口。」
还有一个专门针对 Web Client 的细节:如果要往里加「业务行」,你要注册 ConversationNodeDefinition 加一个 keyed renderer。而且官方有一条要求:**如果同一个插件事件族里的多条事件要组装成一个 Conversation Node,那么这个族里的每条 start/update/result/resource/interruption 事件,都必须携带或独立推导出同一个稳定的业务 id。**理由很直接——不想让客户端靠「相邻关系」去猜归属,也不想让它去扫历史。
10.7 实操五:写一个协议驱动
「协议驱动」是把一个外部协议的对端接到 ctx.agents 上——它可能服务于界面,也可能服务于自动化客户端。官方在实操手册里给了标准做法:
- stdio 驱动拥有 stdout,通过工厂创建或恢复 agent,把协议请求映射成 followup() 或 cancel()。
- 底层提示词请求返回的是「持久的入队回执」,它不会通过把 MessageId 和 turn/end 关联起来获得结果。
- 整个 agent 的状态要单独发布。
- 拆卸要用 AgentHandle.dispose(),这样 dispose 才能达到完全停稳。
官方点名了一个完整的参考实现:packages/acp/acp——它通过 ACP(Agent Client Protocol)的 JSON-RPC stdio 提供全新文本会话,发出已提交的助手文本,并为其拥有的 agent 注册一次性机器权限应答器。
其中有一段关于「等一下还是持续观察」的说明很有价值:
自动化方法可以从回执等待到下一次 idle,并概括这一显式拥有的区间;UI 通常则会持续观察开放式事件流。
10.8 实操六:委派给子 agent
「让主 agent 把一部分工作交给子 agent」是一个常见需求。它挂在一个独立的 seam 上。
官方在归属位置表里的说法是:子 agent 委派用 ctx.subagents 提供方注册表,然后用 dsh-tool-subagent 向模型暴露一个已配置的提供方。
可选的提供方包括:
| subagent-spawn-in-process | 在同一进程里新建一个子 agent |
| subagent-fork-in-process | 在同一进程里从当前会话 fork 出一个子 agent |
| subagent-acp | 通过 ACP 协议委派给另一个产品 |
| subagent-codex | 委派给 Codex |
| subagent-claude-code | 委派给 Claude Code |
| subagent-dsh-sdk | 通过 dsh 自己的 SDK 委派 |
官方对 ctx.subagents 的职责描述是:**提供方实现传输;该服务还负责可选的、基于 Activation 的延续编排。**而且消费方的分工也很清楚:
- tool-subagent 选择「一次性」或「可延续」委派。
- tool-subagent-control 传递后续消息。
- tool-ralph 要求一条全新的结构化输出路由。
反直觉
子 agent 和主 agent 的关系,在运行时的所有权和持久会话的血缘上是两件独立的事。官方在注册表里专门说明:isOwnedBy(id, owner) 判断的是「运行时所有权」,它「与持久会话血缘无关,并且在不相关的提供方复用一个 id 时依然无歧义」。所以恢复出来的一个 fork,在运行时可能仍然是一个 root。
10.9 加新行为的完整清单
把这一章的内容压缩成一张可以照着走的清单:
10.10 这一章要带走的三句话
这一章要带走的三句话
这一章之后
六个实操覆盖了本书提到的全部主要扩展点。做完之后建议回到第 1 章重新读一遍 Cordis 的五种分发模式——
你会发现那些当时抽象的概念,现在都对应着你刚写过的某行代码。
如果你只想留一张纸在桌上,那就是 10.9 节的「加新行为的完整清单」:
先问挂在哪,再查该扩展点用什么分发模式,最后确认副作用要不要可逆。
内容整理自 DeepSeek Harness 官方仓库 docs/architecture.zh.md 及其引用的 Cookbook、开发文档。
官方项目处于开发者预览阶段,具体命令、包名与字段请以你手上的代码为准。


评论前必须登录!
注册