 网硕互联帮助中心
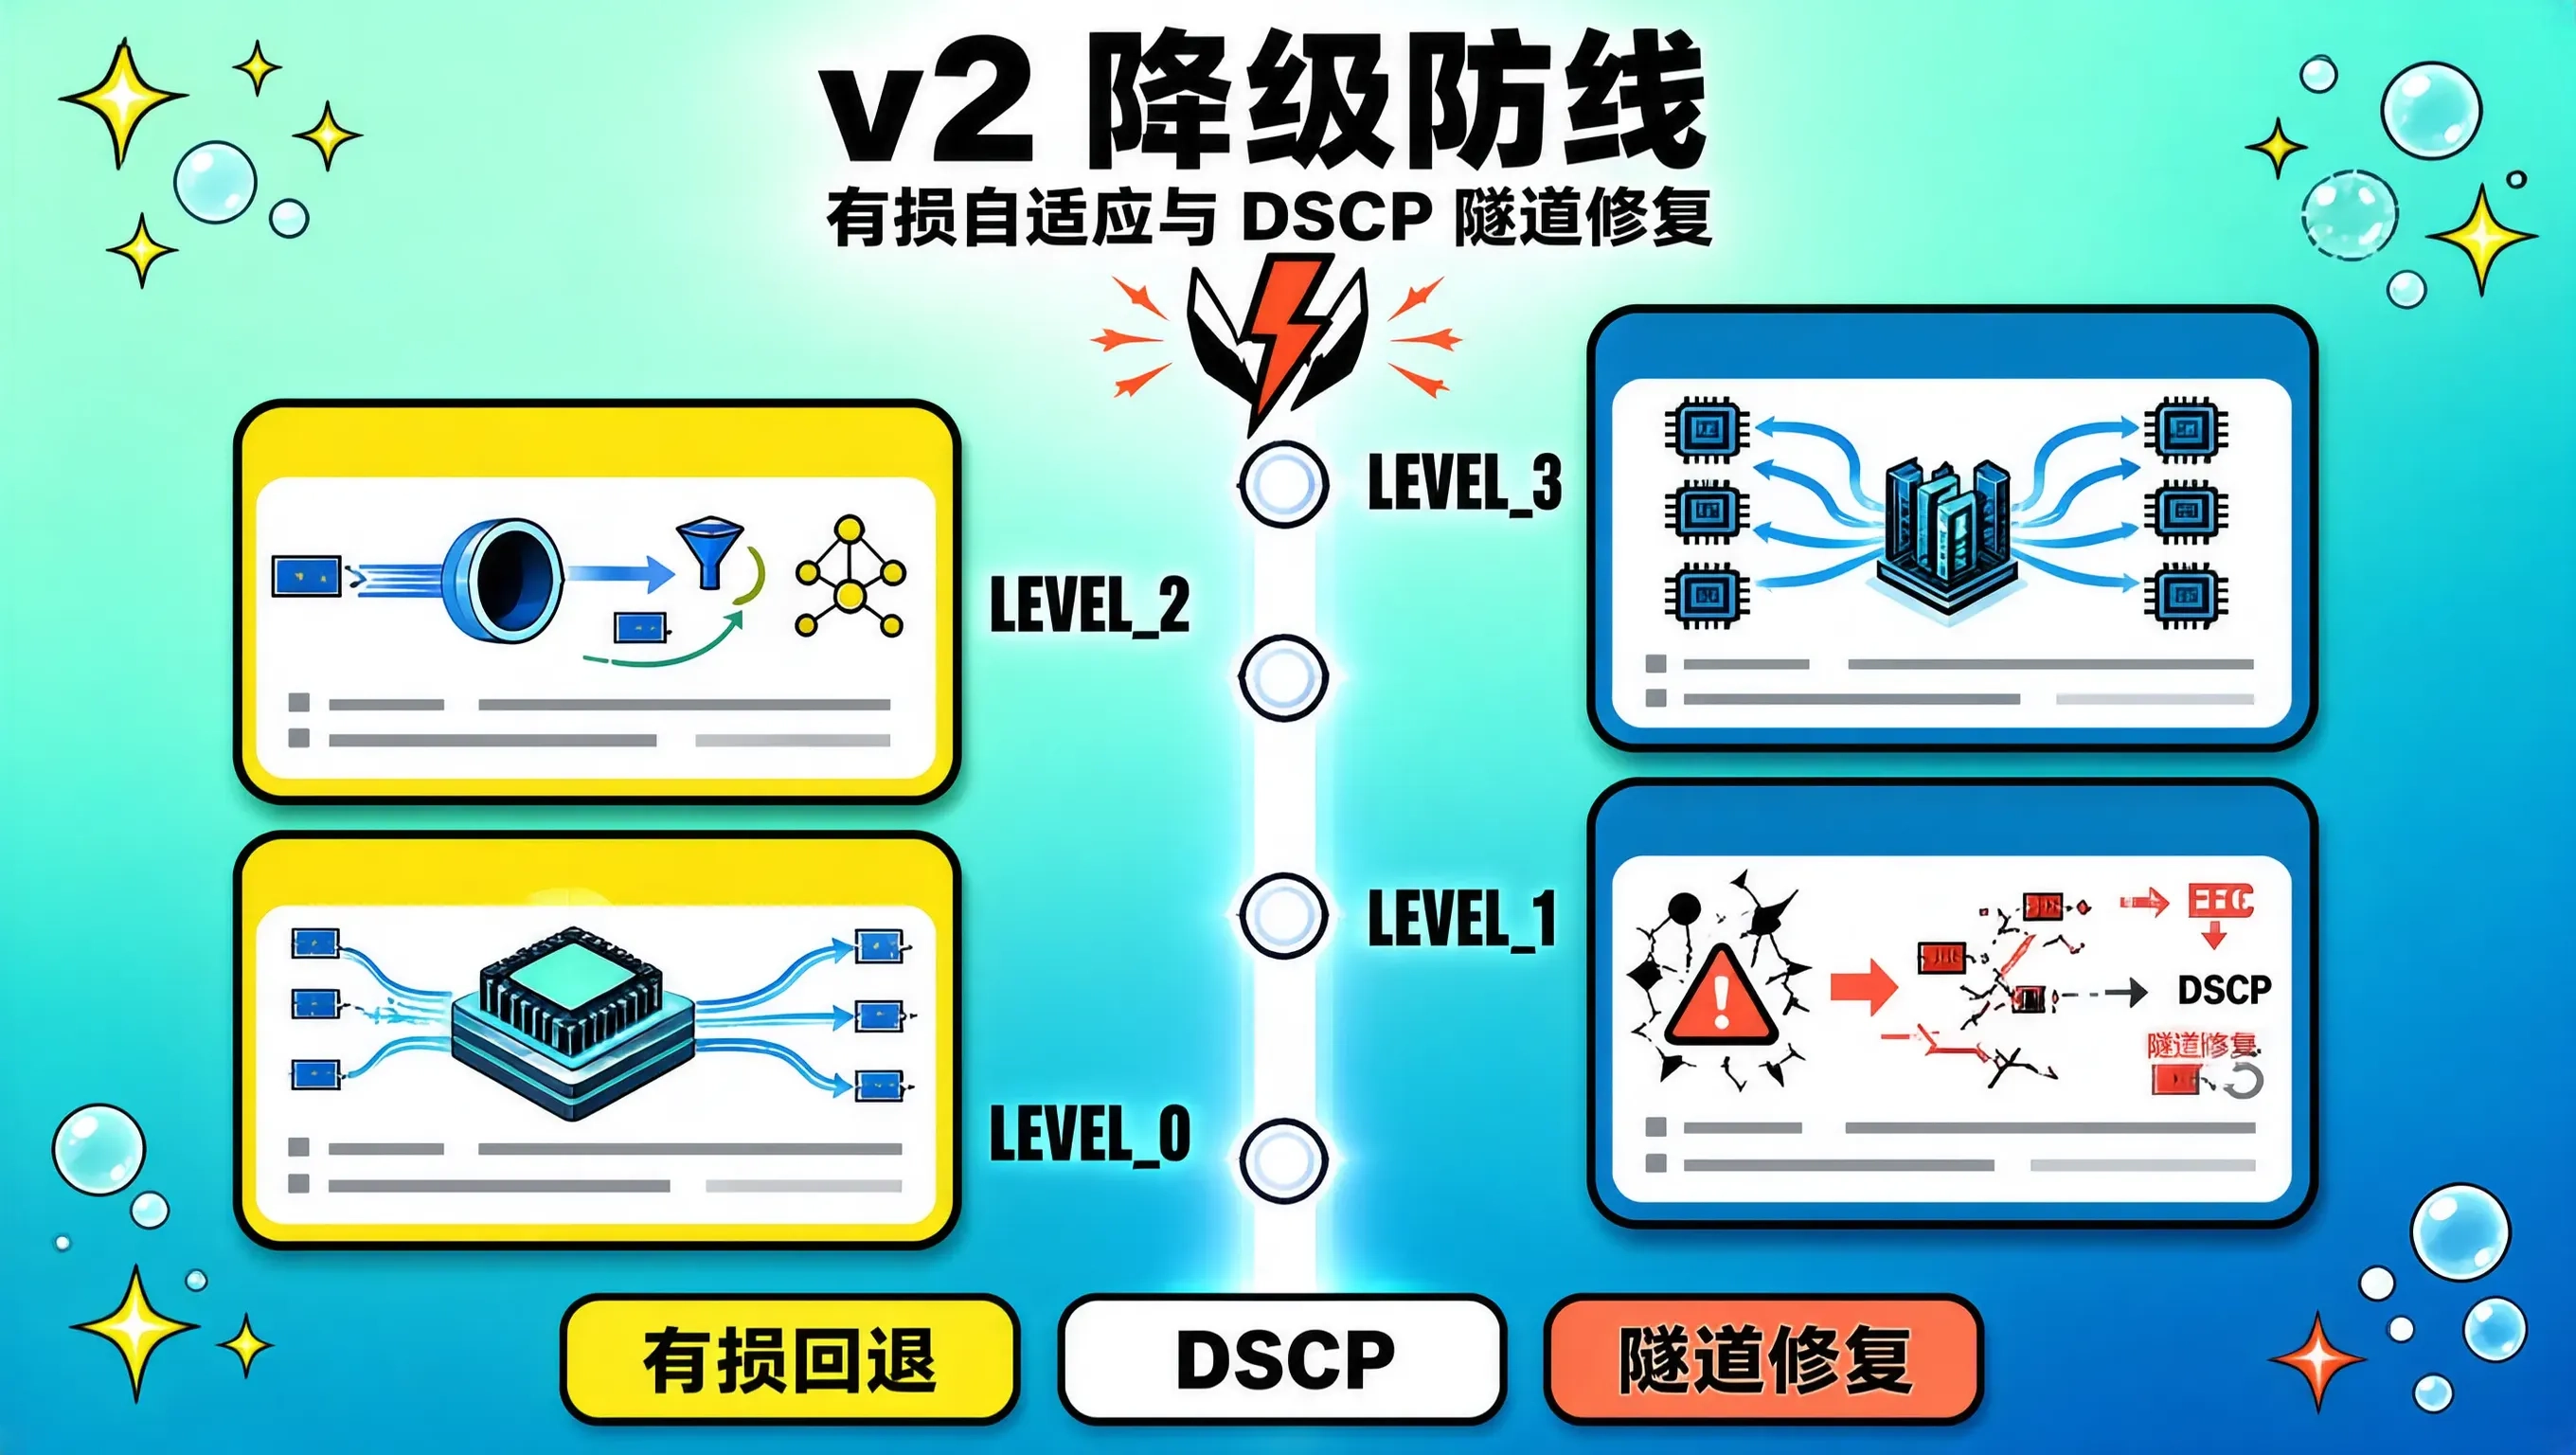
在绝大多数 AI 智算网络白皮书中,关于 RoCE v2(以太网 RDMA)的架构设计都建立在一个极其严苛的物理假设之上:所有 GPU 服务器必须被圈定在同一个数据中心机房内部、同一个严格受控的三层 Spine-Leaf 网络无损域中。全网所有交换机必须整齐划一地开启 PFC(基于优先级的流控)与 ECN,杜绝任何一个数据包的丢失。
然而,当企业的算力规模跨入双 11 混合云(Hybrid Cloud)与多可用区(Multi-AZ)时代,这一理想假设被现实彻底粉碎了:为了应对双 11 狂暴的峰值算力,企业不仅使用自有智算中心的物理机房,还必须在公有云上临时按需租赁数千张高端 GPU。当分布式微调的梯度同步或者跨可用区的大模型推理流水线必须跨越机房边界、流经城域网光缆或者公有云虚拟私有云(VPC)底层时,系统会瞬间遭遇毁灭性的网络断崖:
公有云厂商或者第三方骨干网运营商,坚决在跨边界路由设备上完全关闭了 PFC PAUSE 帧的透传(因为在跨租户或广域网上开启 PFC 极易引发跨地域的全网级死锁与广播风暴);不仅如此,中间的虚拟化网关默认还会粗暴地将 IP 报文头部的 DSCP/TOS 优先级字段直接清零。结果就是,原本在机房内部跑得极速飞起的 RoCE v2 流量,一旦跨出机房边界,就会因为 0.01% 的正常网络丢包而陷入死循环般的 Go-Back-N 硬件重传风暴,NCCL 频繁报出致命的 IBV_WC_RETRY_EXC_ERR,导致整个混合云算力底座全面瘫痪。
要让算力冲破单一物理机房的围墙,必须建立基于有损网络自适应回退(Lossy RoCE v2)与硬件级 DSCP 隧道修复的跨网段降级防线。
机房内部无损 RoCE vs 混合云跨边界有损降级
IDC 内部受控局域网 (纯无损环境)
GPU 节点 A ──► [交换机 100% 支持 PFC / ECN 硬件流控] ──► GPU 节点 B (零丢包运行)
混合云跨网段传输 (边界击穿与降级自愈)
IDC 私有算力节点 ──► 跨越城域网 / 公有云 VPC (PFC 帧被中间路由直接丢弃!DSCP 被踩平!)
│
▼ 启动自适应降级防线
┌────────────────────────────────────────────────────────┐
│ 1. 硬件级 DSCP 封装保护 (通过 Geneve/VXLAN 封包穿透) │
│ 2. 激活网卡级快速选择性重传 (Selective Repeat 替代 GBN)│
│ 3. 启用 BBR-based 跨地域低延迟拥塞控制算法 │
└────────────────────┬───────────────────────────────────┘
│
▼ 即使存在 0.1% 正常物理抖动
公有云 GPU 弹性节点稳定接流,NCCL 通信带宽稳健跑满 85% 线速!
1. 观念颠覆:RoCE v2 离开 PFC 真的不能活吗?
在很多网络工程师的传统观念里,有一种根深蒂固的误解:“RoCE v2 必须依赖 PFC,丢一个包就会死掉,所以它绝对不能跨网段在有损网络上跑。”
这一观念在早期硬件上确实是事实;但随着现代高性能智能网卡(如 NVIDIA ConnectX-6/7/8、BlueField DPU)的演进,纯有损 RoCE v2(Lossy RoCE)不仅完全可行,而且是跨机房大算力协同的唯一解法。
现代网卡在硬件底层补齐了两项颠覆性武器:
这意味着,即使在完全没有 PFC 保护的普通以太网甚至公有云网络上,RoCE v2 依然能够保持极高吞吐。
2. 核心战役:DSCP 优先级跨边界隧道修复
跨网段通信面临的最凶险陷阱,是中间设备对 QOS 优先级的无情抹杀。
RoCE v2 报文依赖 IP 报文头部的 DSCP(区分服务代码点,通常为 DSCP 26 或 46)来让网卡识别其进入专用的无损或高优先硬件队列。然而,当报文跨越公有云 VPC 网关或企业级软件定义网络(SDN)时,中间网关往往会将外部报文一律重写为 DSCP 0 (Best Effort)。
一旦进入 Best Effort 队列,RoCE 报文在网卡底层会从高优先级硬件通道跌落至与普通后台备份、日志下载同流合污的垃圾队列,导致微秒级通信彻底退化为不可预测的毫秒级阻塞。
生产解法:基于 Geneve / VXLAN 隧道的优先级透传
我们通过在边界网关与容器宿主机层,使用 eBPF 与 Open vSwitch(OVS)构建了一套外层 DSCP 继承(DSCP Inheritance)流水线:
# 1. 在宿主机层面配置流量控制器 (tc),确保本地发出的 RoCE 流量强制打上 DSCP 46 (EF 极速转发类)
tc qdisc add dev eth0 root handle 1: prio
tc filter add dev eth0 parent 1: protocol ip prio 1 u32 \\
match ip dport 4791 0xffff \\
action skbedit mark 0x100
tc filter add dev eth0 parent 1: handle 0x100 fw \\
action pedit munge ip tos set 0xb8 # 设置 DSCP 46 (0xb8 = 46 << 2)
# 2. 在跨地域 Overlay 隧道配置中,强制开启 Outer Header 继承 Inner Header 的 DSCP 属性
ip link add dev geneve-roce type geneve \\
id 100 \\
remote 10.250.0.1 \\
tos inherit # 关键指令:外层 UDP 报文头完美继承内层 RoCE 报文的 DSCP 优先级!
通过指定 tos inherit,外部中间公有云网络看到的只是一个普通带有高优先级标记的 UDP 报文,从而给予最高优先级的交换转发,并在到达对端解封装后毫发无损地还原给 GPU 网卡处理。
3. 宿主机网卡驱动参数自适应降级配置
为了在混合云跨网段环境下激活纯有损快速重传特性,必须在算力节点的 Linux 系统中对网卡底层参数进行显式声明:
# 1. 彻底关闭该端口对外部 PFC PAUSE 帧的依赖,避免在跨地域网络中盲目等待暂停
echo 0 > /sys/class/net/eth0/ecn/roce_np/prio
# 2. 强制要求网卡在硬件底层启用 Selective Repeat (选择性重传) 模式
# 写入特定硬件寄存器掩码 (以 NVIDIA ConnectX 驱动为例)
mstflint -d 0000:01:00.0 set_param RO_SELECTIVE_REPEAT_EN=1
# 3. 调大网卡端重传超时定时器的敏感度 (压至微秒级自愈)
# 将 ACK 超时从默认保守的数十毫秒调整为 500 微秒
echo 14 > /sys/class/net/eth0/ecn/roce_rp/local_ack_timeout
通过将 local_ack_timeout 压制在安全区间,一旦跨机房光纤发生偶发丢包,发送端网卡在 500 微秒内即可敏锐发现并在本地触发单包重传,彻底消除了过去动辄卡死数秒的通信停滞。
4. 架构师的一线避坑铁律
在部署跨网段 RoCE v2 的生产实战中,有两个足以导致链路彻底黑洞的深坑必须设死防线:
基础设施的强大,不仅体现在它在理想温室里能够跑得多快,更体现在它在面对破碎复杂的真实网络时能够展现出多强的生存韧性。通过破除 PFC 的单一神话,打通有损自适应降级与 DSCP 穿透修复,我们彻底撕破了地域与机房对 AI 算力的物理封锁,让混合云海量异构 GPU 资源在大促前夜真正凝聚成了一个无缝协同的算力共同体。

评论前必须登录!
注册