 网硕互联帮助中心
写在前面
欢迎大家关注Rocky的知乎:Rocky Ding 《三年面试五年模拟》AIGC/LLM/AI Agent算法工程师/开发工程师求职面试秘籍独家资源:【三年面试五年模拟】WeThinkIn/AIGC-Interview-Book,欢迎大家Star~
Rocky最新撰写的10万字AI Agent(AI智能体)深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC/LLM/AI Agent算法岗/开发岗求职面试内推学习社群(涵盖AIGC、LLM大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI等AI行业最新面试干货经验与核心知识)欢迎大家加入:https://t.zsxq.com/33pJ0
大家好,我是Rocky。
核心导读:一首完整歌曲,需要在两种时间尺度上同时成立
生成几秒自然的声音,与生成一首具有主歌、副歌、歌词发展和稳定人声的歌曲,难度并不相同。前者更关注局部声学连续性,后者还要维持分钟级结构:旋律什么时候回归,歌词如何落在节拍上,编曲如何随段落发展,音色与立体声细节如何保持一致。
Qwen-Music Technical Report 给出的答案是明确分工:Tokenizer 把音乐压缩成可由语言模型处理的语义序列;3B 自回归 LLM 负责歌曲组织,并可先规划旋律;Render 再把语义草图变成 48 kHz 立体声。本文分析 arXiv:2607.11699 的 v3 内容,保留全部 8 幅标准图、9 张表与 8 个编号公式。
Rocky认为,这项工作的本质,是为音乐创作建立一个信息保留程度可调的中间接口。 旋律需要足够明确,才能被复用和控制;声学细节又不能全部锁死,否则改变风格、编曲和歌手特征会变得困难。低码率语义表示与生成式渲染分别承担不同约束,这种分工比“把 LLM 用到音乐上”更值得研究。
1. 先看证据:接近顶尖系统,需要说清比较口径
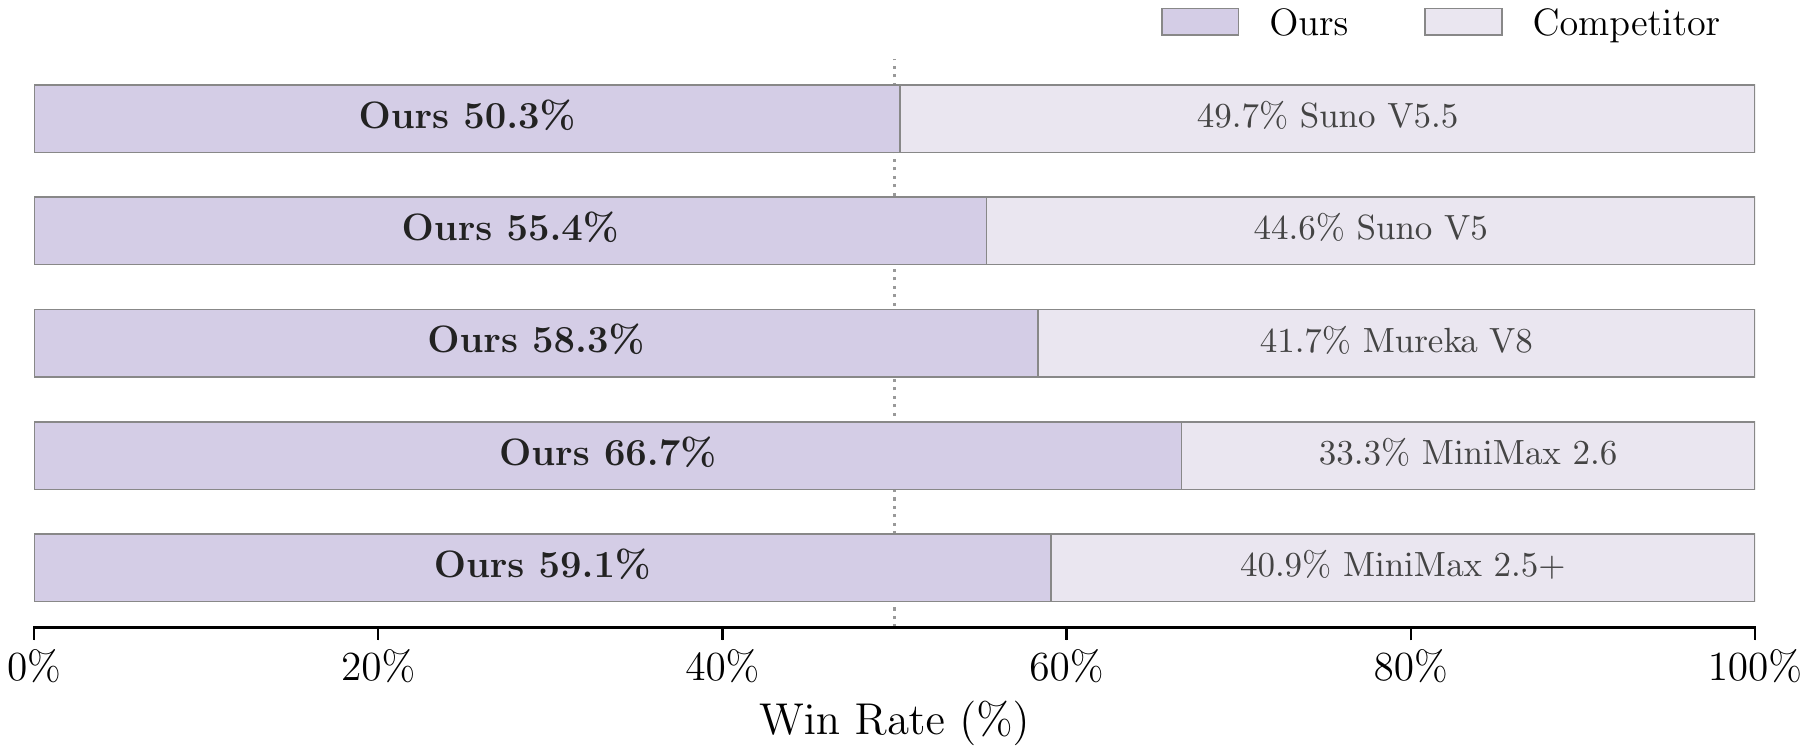
论文招募了 50 位有音乐创作或制作经验的听评者,每一对音频由三个不同专家独立判断,播放顺序随机。Qwen-Music 对 MiniMax Music 2.5+、Music 2.6、Mureka V8、Suno V5 的偏好率分别为 59.1%、66.7%、58.3%、55.4%;对 Suno V5.5 是 50.3%,后者为 49.7%。
50.3% 是点估计接近持平,不能仅凭略高于一半就宣称显著超越。投票还存在同一提示、同一音频和同一评委造成的相关性,显著性分析不宜把每张票视为完全独立样本。本文没有重做听评,也不把论文内部评价等同于全体音乐用户的普遍偏好。
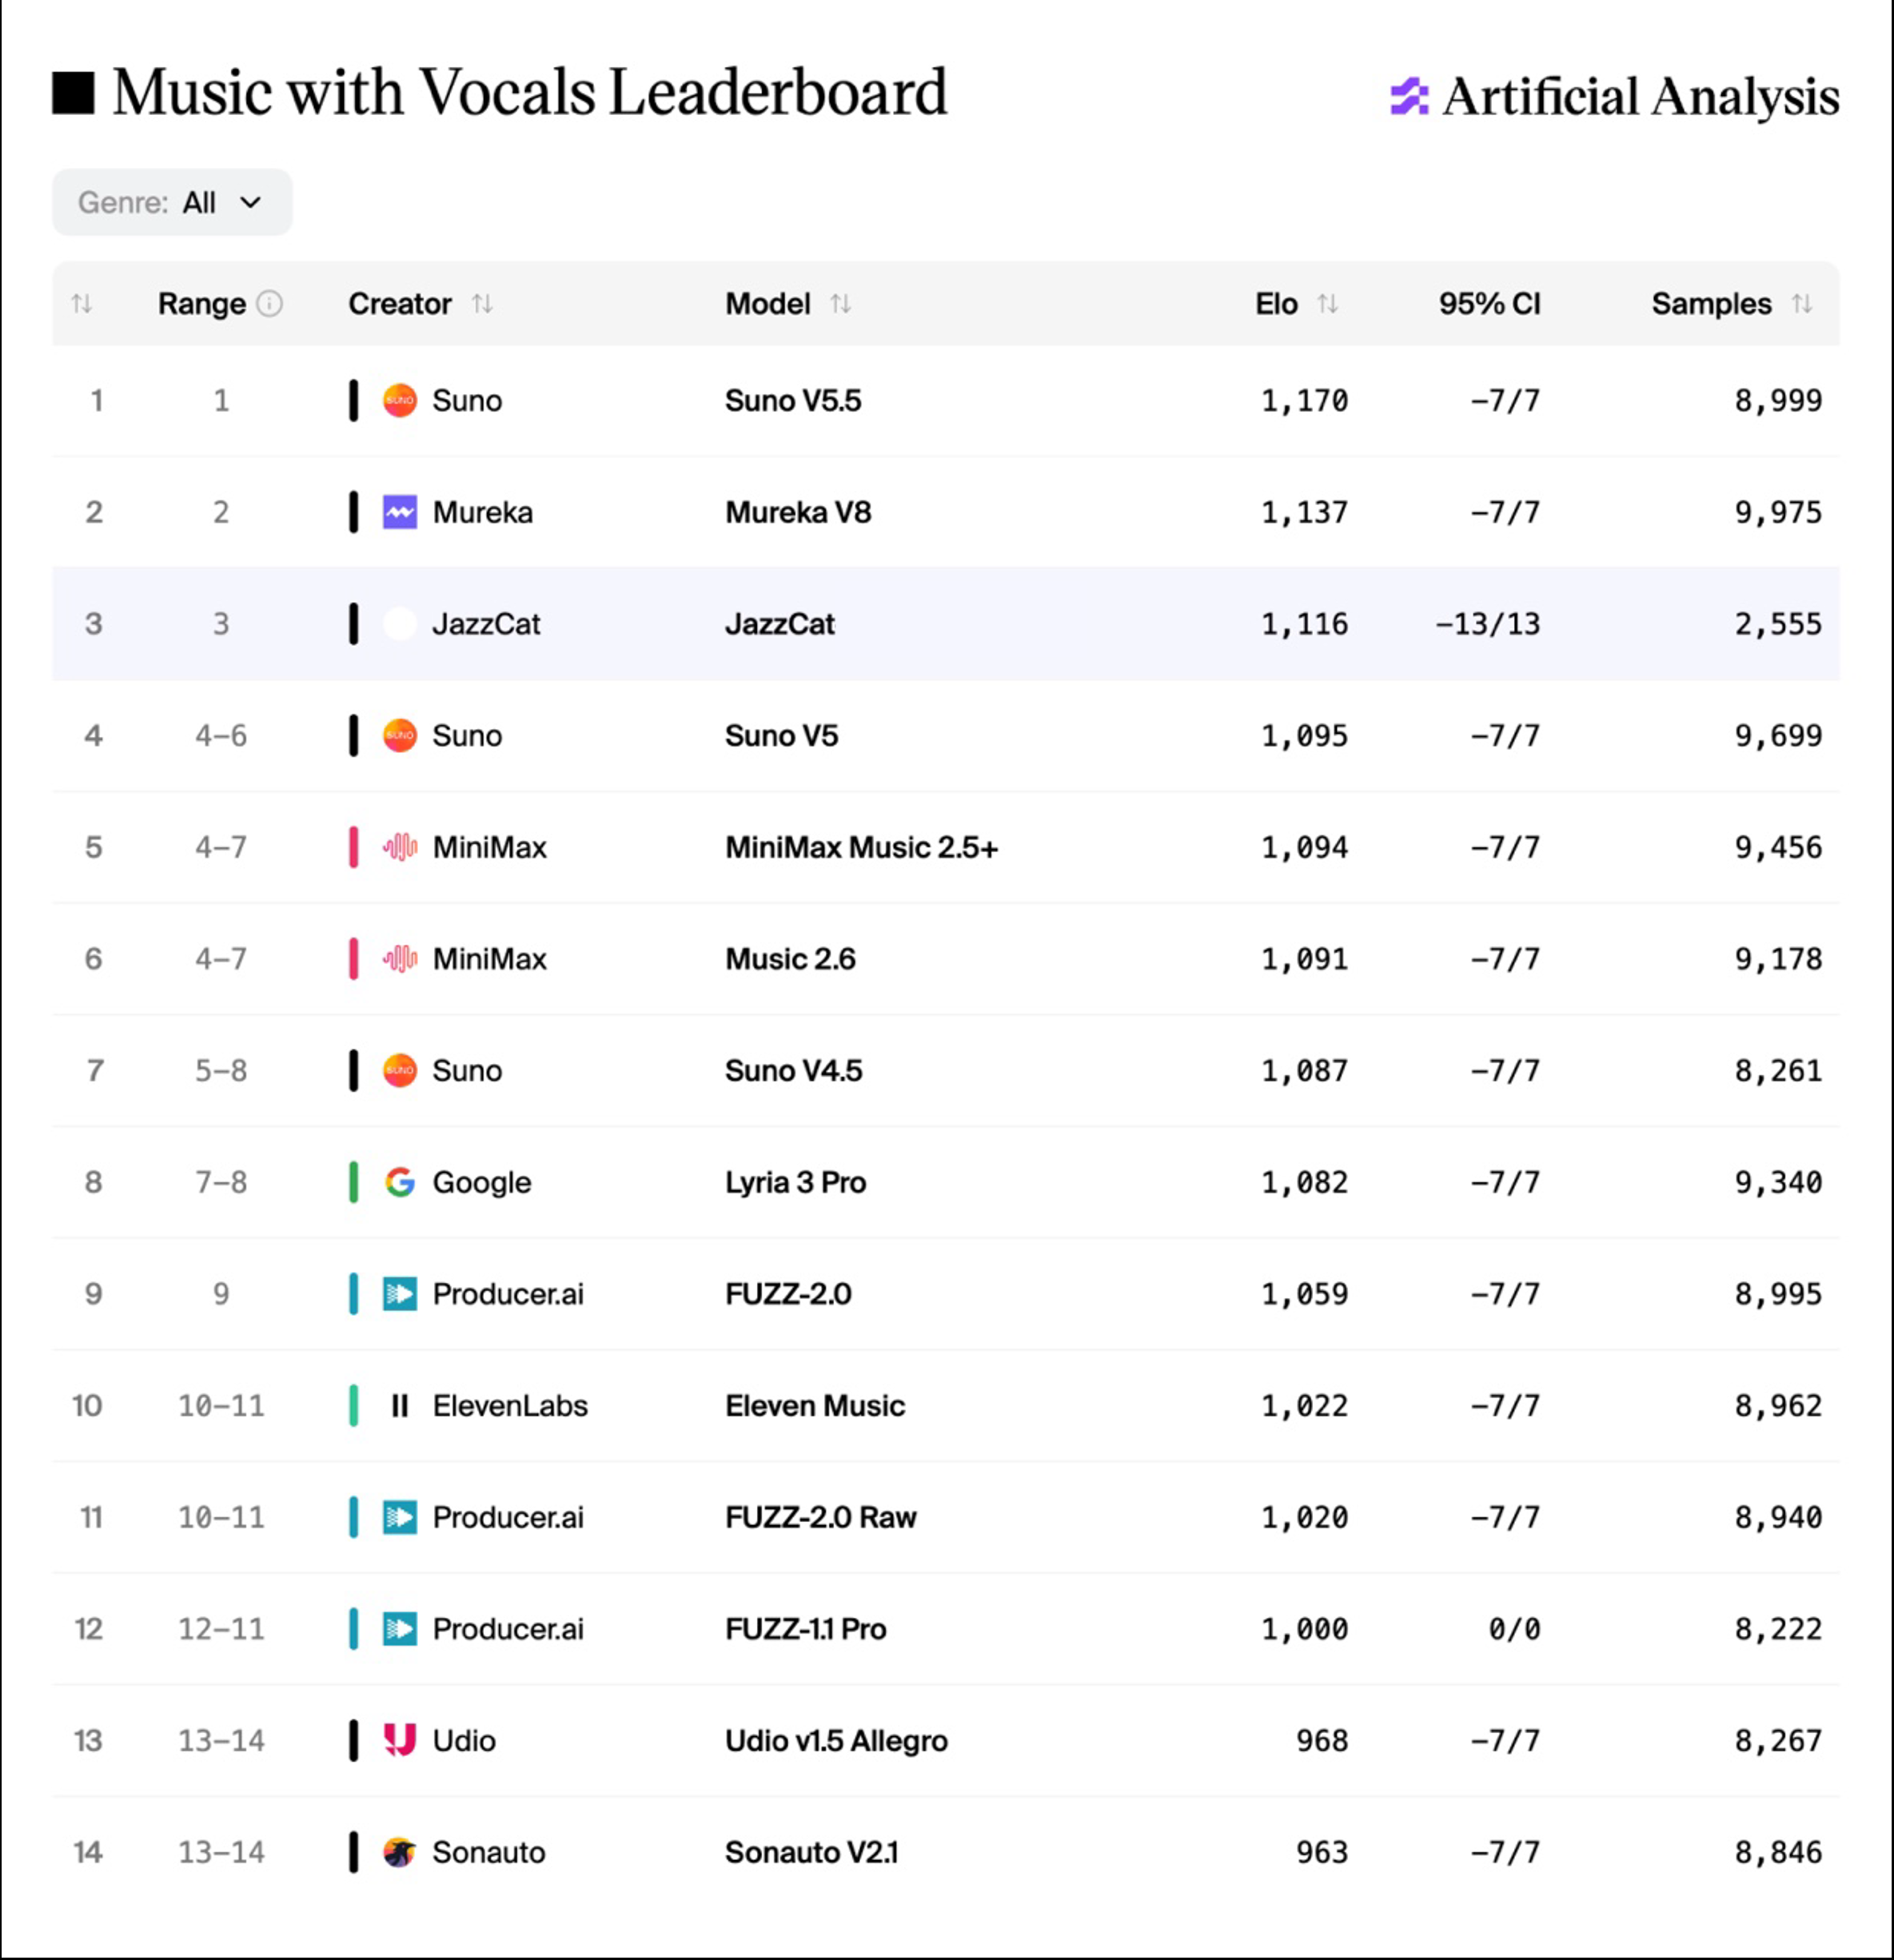
论文说明 Qwen-Music 以 JazzCat 身份参与榜单,图中位列第三。这是论文版本所记录的外部快照,支持另一种分布下的竞争力观察;它与内部 A/B 测试不是同一批用户、相同提示或相同评分体系,不能把排名直接转换成上述胜率,也不应当作实时榜单名次。
2. 总体架构:语义作曲与声学渲染分别优化
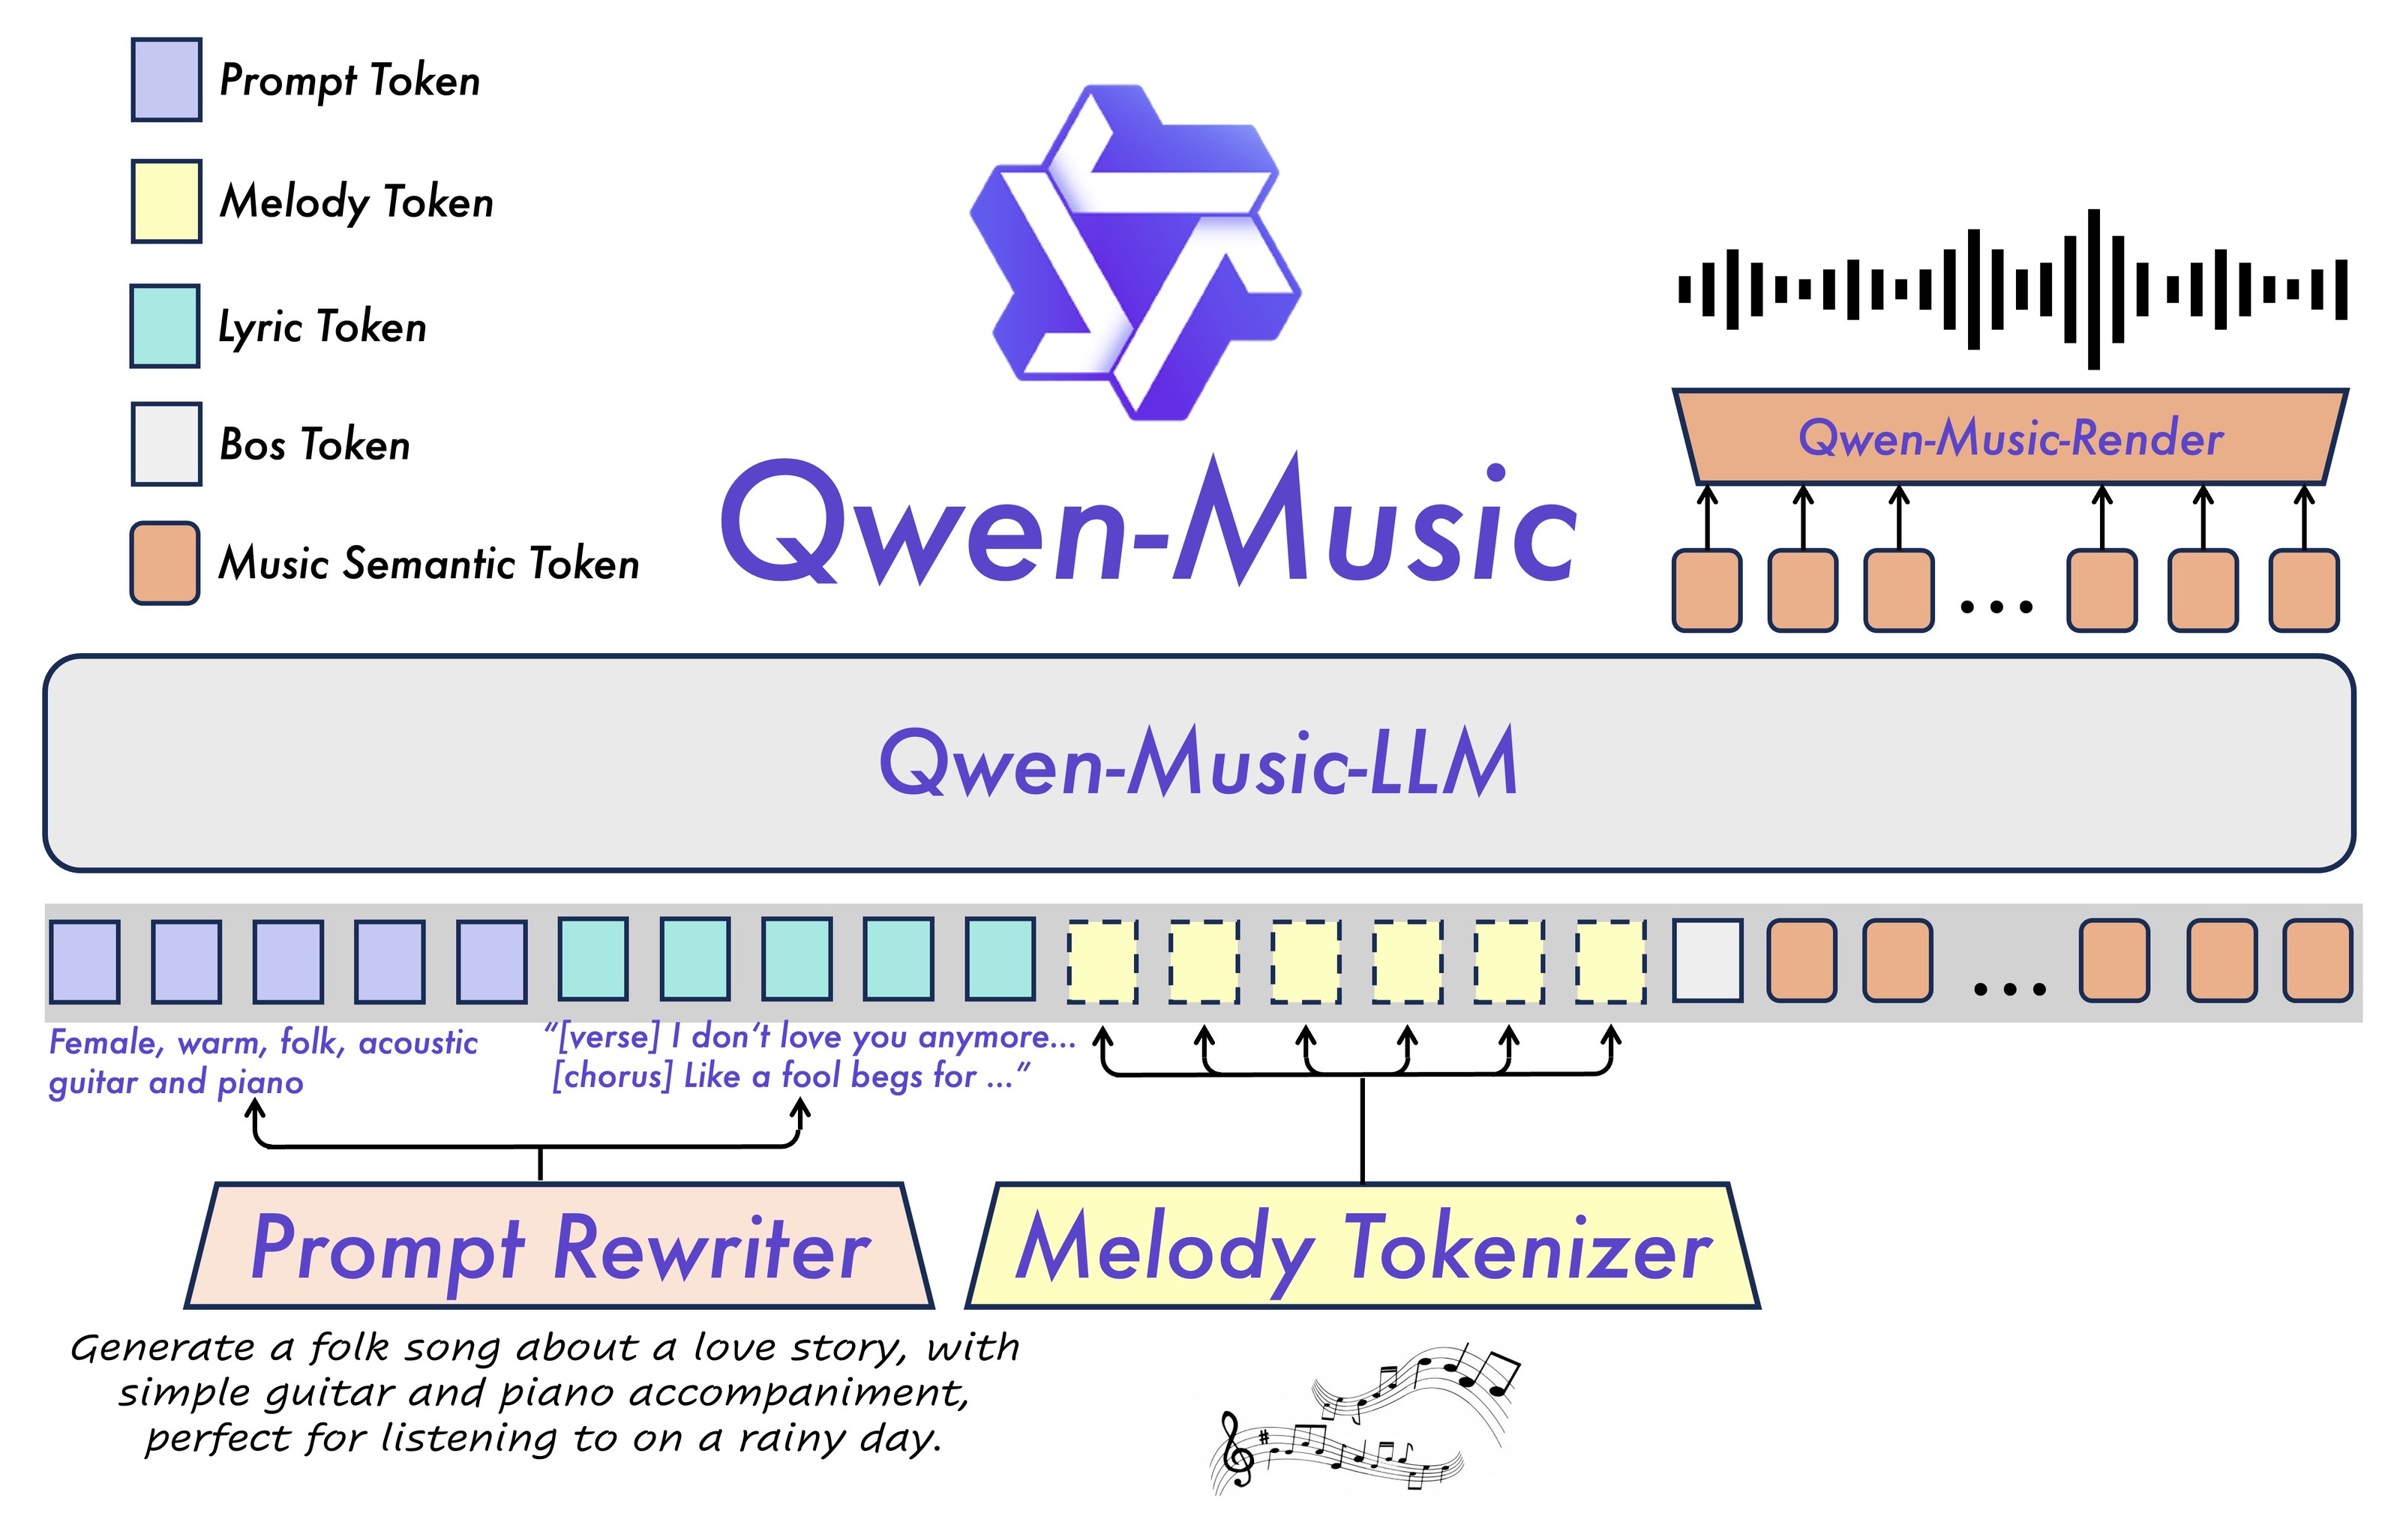
系统先把自然语言请求整理成音乐标签与结构化歌词。Qwen-Music-LLM 在这些条件下生成 Music Semantic Tokens;有参考歌曲时,还可以引入提取出的旋律 token。Render 同时读取语义 token 和文本条件,恢复连续声学潜变量,再合成波形。
这里存在三个不同对象。音乐语义 token 包含歌曲内容和编排线索;旋律 token 是更低频、更专注人声曲线的中间控制;声学潜变量保留供高保真重建使用的连续信息。把它们都叫作“音频 token”,会掩盖各自的损失函数、码率和可控性边界。
以五分钟音乐计算,25 Hz 语义序列约有 7,500 个 token。相较 48 kHz 波形逐采样建模,这为长程结构提供了更可行的自回归接口。但时间压缩并不意味着所有信息被无损保留,渲染器需要根据条件补充音色、相位与高频细节;其生成结果可以合理,却不必等同于唯一原始录音。
3. Tokenizer:先学连续表示,再逐步引入离散瓶颈
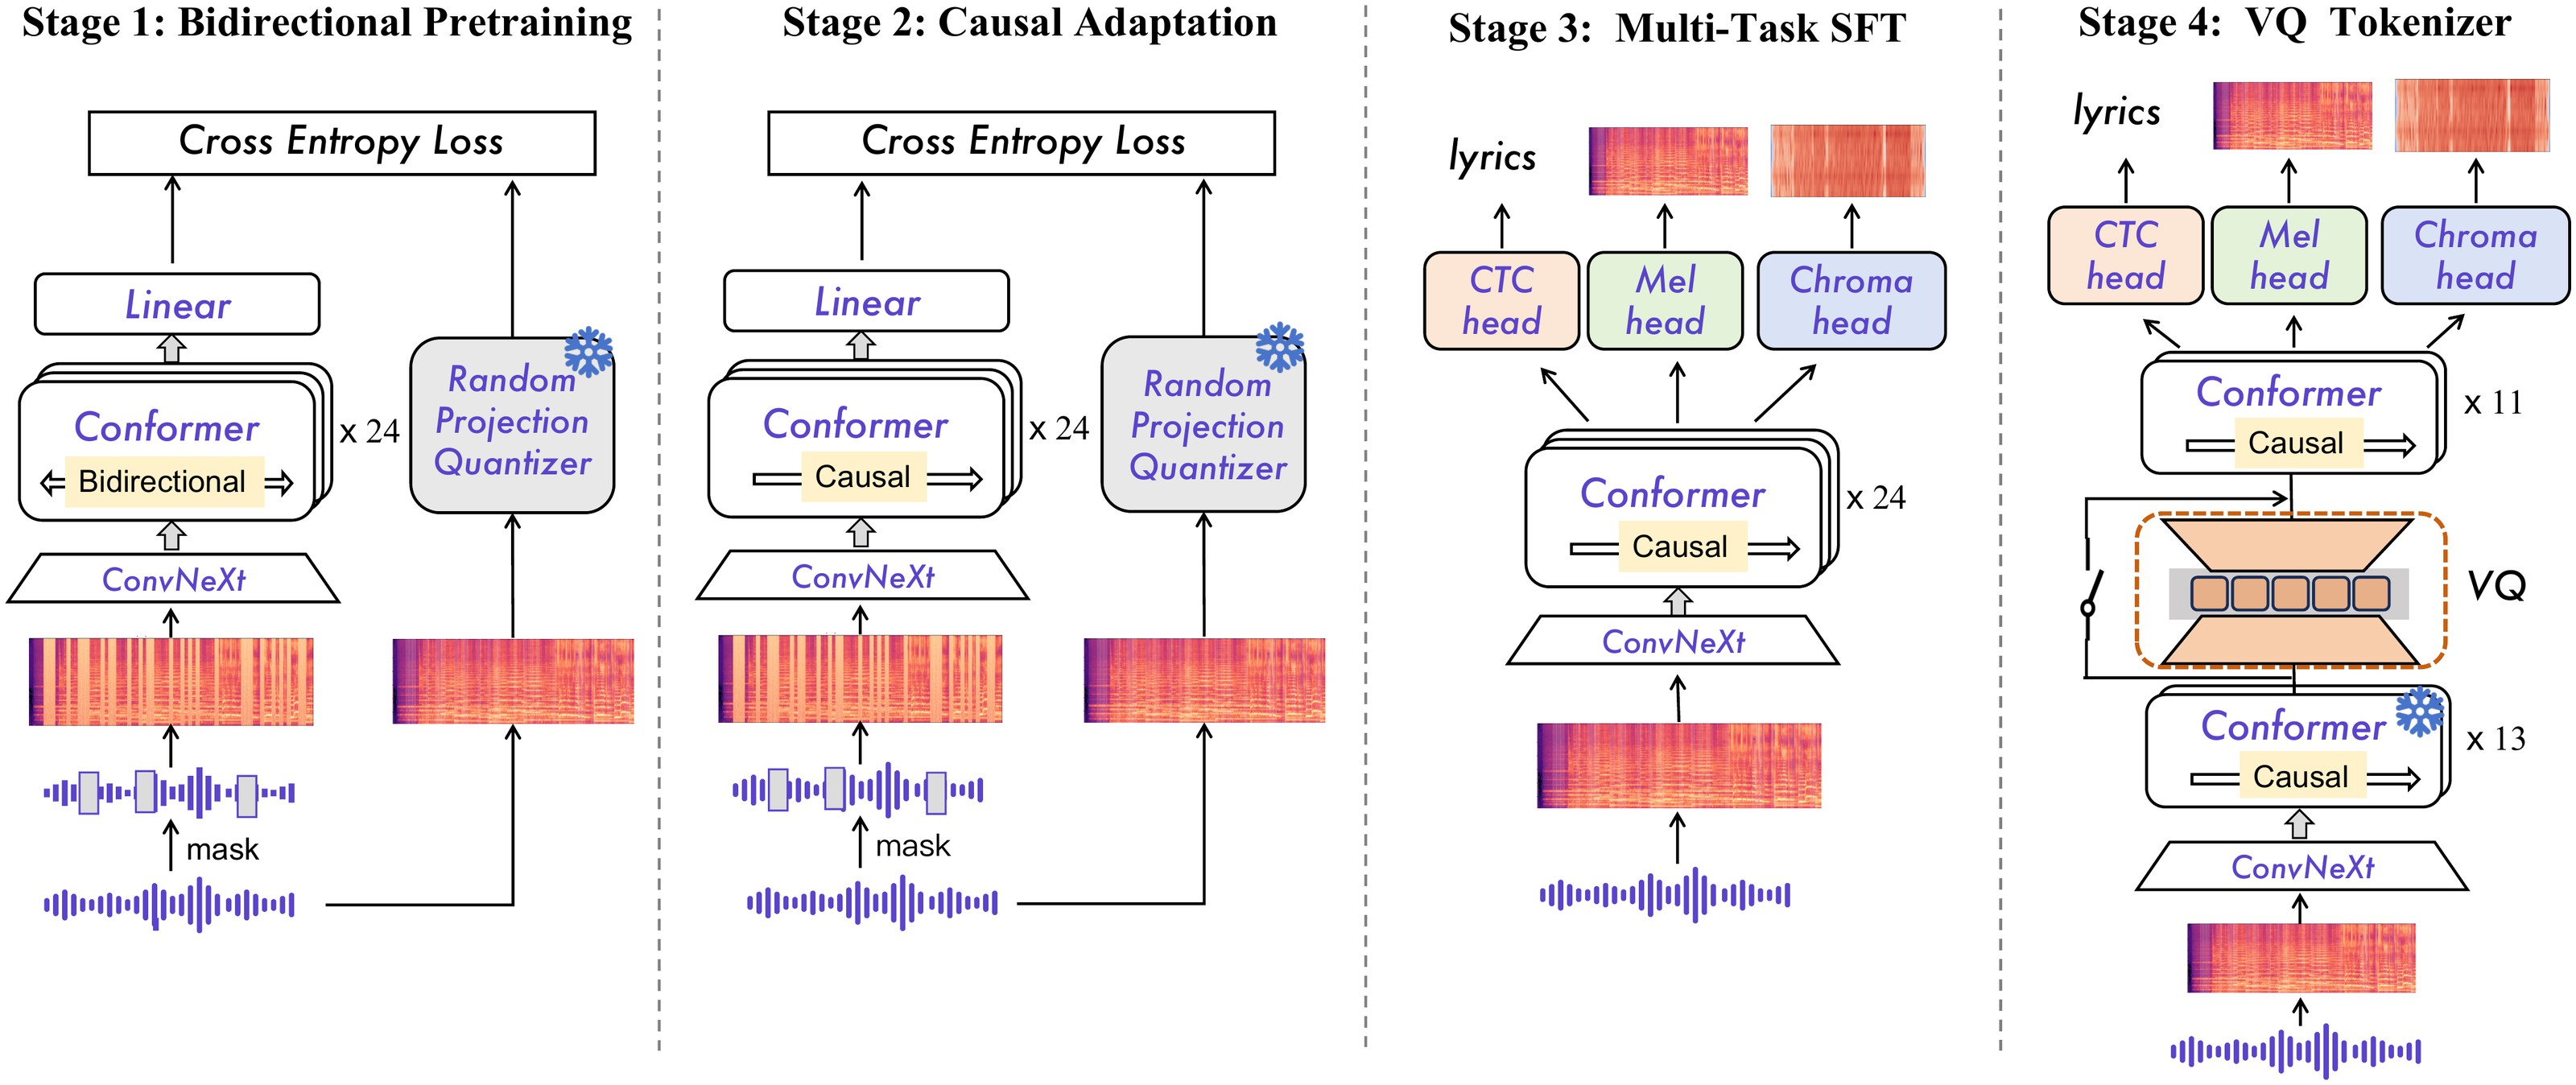
Tokenizer 的训练骨干是 24 层、约 0.6B 参数的 Conformer,宽度 1024、16 个注意力头。音频先转换为 24 kHz 单声道与 log-Mel 特征,经卷积前端降到 25 Hz,也就是每 40 ms 一个位置。四阶段共享骨干,但部署提取代码只保留前端、VQ 插入位置之前的编码层和量化器,不应把训练期全部模块都算成推理必经路径。
3.1 BestRQ:用冻结随机目标学习音乐表示
第一阶段从随机初始化开始,采用双向 BestRQ。干净特征经过固定随机投影与固定随机码本形成目标;输入音频按 0.4 秒跨度、0.3 概率进行掩码,用低方差高斯噪声替换。模型从被破坏的上下文恢复掩码位置目标。
公式(1):
L
B
e
s
t
R
Q
=
1
∣
M
∣
∑
t
∈
M
C
E
(
p
(
h
t
)
,
q
(
x
t
)
)
.
\\mathcal L_{\\mathrm{BestRQ}}=\\frac{1}{|\\mathcal M|}\\sum_{t\\in\\mathcal M}\\mathrm{CE}\\bigl(p(h_t),q(x_t)\\bigr).
LBestRQ=∣M∣1t∈M∑CE(p(ht),q(xt)).
其中
q
q
q 是冻结的随机投影量化器,
p
p
p 为预测头。这里的随机码本只构造自监督目标,与最终可学习的音乐 VQ 码本不同。无需目标网络并不等于编码器没有学习任务;学习发生在用上下文预测固定目标的过程中。
第二阶段改为因果注意力,继续使用 BestRQ 目标适配。先在双向条件下获得较好表示,再限制未来信息访问,可以降低从零训练因果编码器的难度。论文同时说明编码时仍对完整音频离线提取,因此“因果编码器”不能直接推导出端到端实时音乐生成能力。
3.2 多任务监督:为歌词、音高与声谱留下信息
第三阶段增加三个头:CTC 预测歌词,Mel 头重建声谱,chroma 头预测 12 维音级特征。音级分布能表达和声与音高类别,CTC 则约束语音内容,避免音乐表示只保留伴奏而丢掉歌词。
公式(2):
L
S
F
T
=
λ
c
t
c
L
C
T
C
+
λ
m
e
l
L
s
p
e
c
m
e
l
+
λ
c
h
r
L
s
p
e
c
c
h
r
o
m
a
,
λ
c
t
c
=
λ
m
e
l
=
λ
c
h
r
=
1.
\\mathcal L_{\\mathrm{SFT}}=\\lambda_{\\mathrm{ctc}}\\mathcal L_{\\mathrm{CTC}}+\\lambda_{\\mathrm{mel}}\\mathcal L_{\\mathrm{spec}}^{\\mathrm{mel}}+\\lambda_{\\mathrm{chr}}\\mathcal L_{\\mathrm{spec}}^{\\mathrm{chroma}},\\qquad \\lambda_{\\mathrm{ctc}}=\\lambda_{\\mathrm{mel}}=\\lambda_{\\mathrm{chr}}=1.
LSFT=λctcLCTC+λmelLspecmel+λchrLspecchroma,λctc=λmel=λchr=1.
这一阶段的掩码概率降至 0.01,训练输入扩展到最长 300 秒完整歌曲。阶段变化体现出目标转移:先获得通用表征,再让其满足后续作曲模型和渲染器需要的可读内容。
3.3 VQ:硬量化之前,先平滑接入
第四阶段在编码器中间层插入 32,768 项单码本,使用余弦度量、直通估计和 commitment loss。硬量化容易破坏已经收敛的表示,因此采用门控插值
h
o
u
t
=
h
+
α
(
h
q
−
h
)
h_{\\mathrm{out}}=h+\\alpha(h_q-h)
hout=h+α(hq−h),让
α
\\alpha
α 从 0 渐进到 1,并先冻结前端与部分骨干,再逐步解冻。CTC 权重降到 0.5,Mel、chroma 和 VQ 的权重为 1。
论文报告码本利用率超过 99%。它说明离散容量被广泛使用,但不等于每个码都携带同样的信息,也不能证明熵编码后的真实码率。按固定 15 bit 索引计算,
25
×
15
=
375
25\\times15=375
25×15=375 bit/s;这是语义代码的名义码率,不包含模型权重、文本条件、容器开销或高保真音频的全部信息。
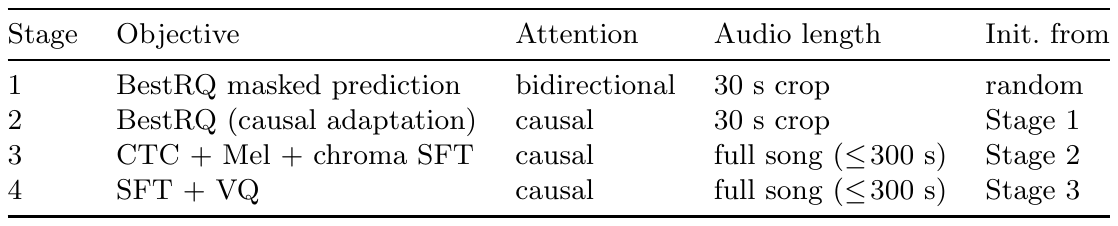
表1完整保留阶段间的目标、注意力、音频长度与初始化关系。训练链的顺序尤其重要:离散化发生在表征已经受歌词与声学监督塑形之后。
4. Melody-CoT:用低频旋律曲线约束长程生成
Qwen-Music-LLM 初始化自 Qwen3.5-Omni 的一个 3B dense 变体。它既支持直接从文本生成语义 token,也学习先输出 Melody-CoT,再输出完整音乐语义序列。这里的 CoT 指的是旋律 token 组成的中间计划,并非解释“我为什么选择这个和弦”的自然语言推理文本。
参考旋律首先由 RMVPE 提取 50 Hz 人声音高曲线,经过八倍中值池化降到 6.25 Hz。公式(3):
f
~
=
MedianPool
8
(
f
)
.
\\widetilde{\\mathbf f}=\\operatorname{MedianPool}_{8}(\\mathbf f).
f
=MedianPool8(f).
池化忽略无声帧;若窗口主要无声,则输出零。低频率有意抑制颤音、装饰音等表演细节,保留较粗的作曲轮廓。随后转成 MIDI,减去全曲有声帧的 MIDI 中位数:
m
ˉ
=
median
{
round
(
hz2midi
(
f
~
i
)
)
∣
f
~
i
>
0
}
.
\\bar m=\\operatorname{median}\\{\\operatorname{round}(\\operatorname{hz2midi}(\\widetilde f_i))\\mid\\widetilde f_i>0\\}.
mˉ=median{round(hz2midi(f
i))∣f
i>0}.
公式(4):
z
i
=
{
clip
(
round
(
hz2midi
(
f
~
i
)
)
−
m
ˉ
,
−
127
,
127
)
+
127
,
f
~
i
>
0
,
255
,
f
~
i
=
0.
z_i=\\begin{cases} \\operatorname{clip}\\bigl(\\operatorname{round}(\\operatorname{hz2midi}(\\widetilde f_i))-\\bar m,-127,127\\bigr)+127,&\\widetilde f_i>0,\\\\ 255,&\\widetilde f_i=0. \\end{cases}
zi={clip(round(hz2midi(f
i))−mˉ,−127,127)+127,255,f
i>0,f
i=0.
相对音高弱化了绝对调高与歌手音域的信息,使新音色和目标风格仍有调整空间;它并没有证明所有歌手特征已被严格去除。pitch 提取误差、节奏、音程与重复结构仍可能保留参考作品的个性。
Melody-CoT 有两种主要组织方式。section-level 为每个含歌词段落保留旋律,并标注 verse、chorus 等类型,省去纯器乐片段;unique-section-level 则按段落类型选一个代表,例如多个副歌只提供一段。前者更强地约束参考旋律,后者降低条件强度、缩短序列,为风格迁移和重新编排留下自由度。
这揭示一个跨模态控制原则:条件越详细,可复用的信息越多,被一起带入的非目标属性也可能越多。 系统需要明确希望保留什么、允许变化什么,才能决定中间表示的颗粒度。
5. Render:把语义草图变成可听的 48 kHz 立体声
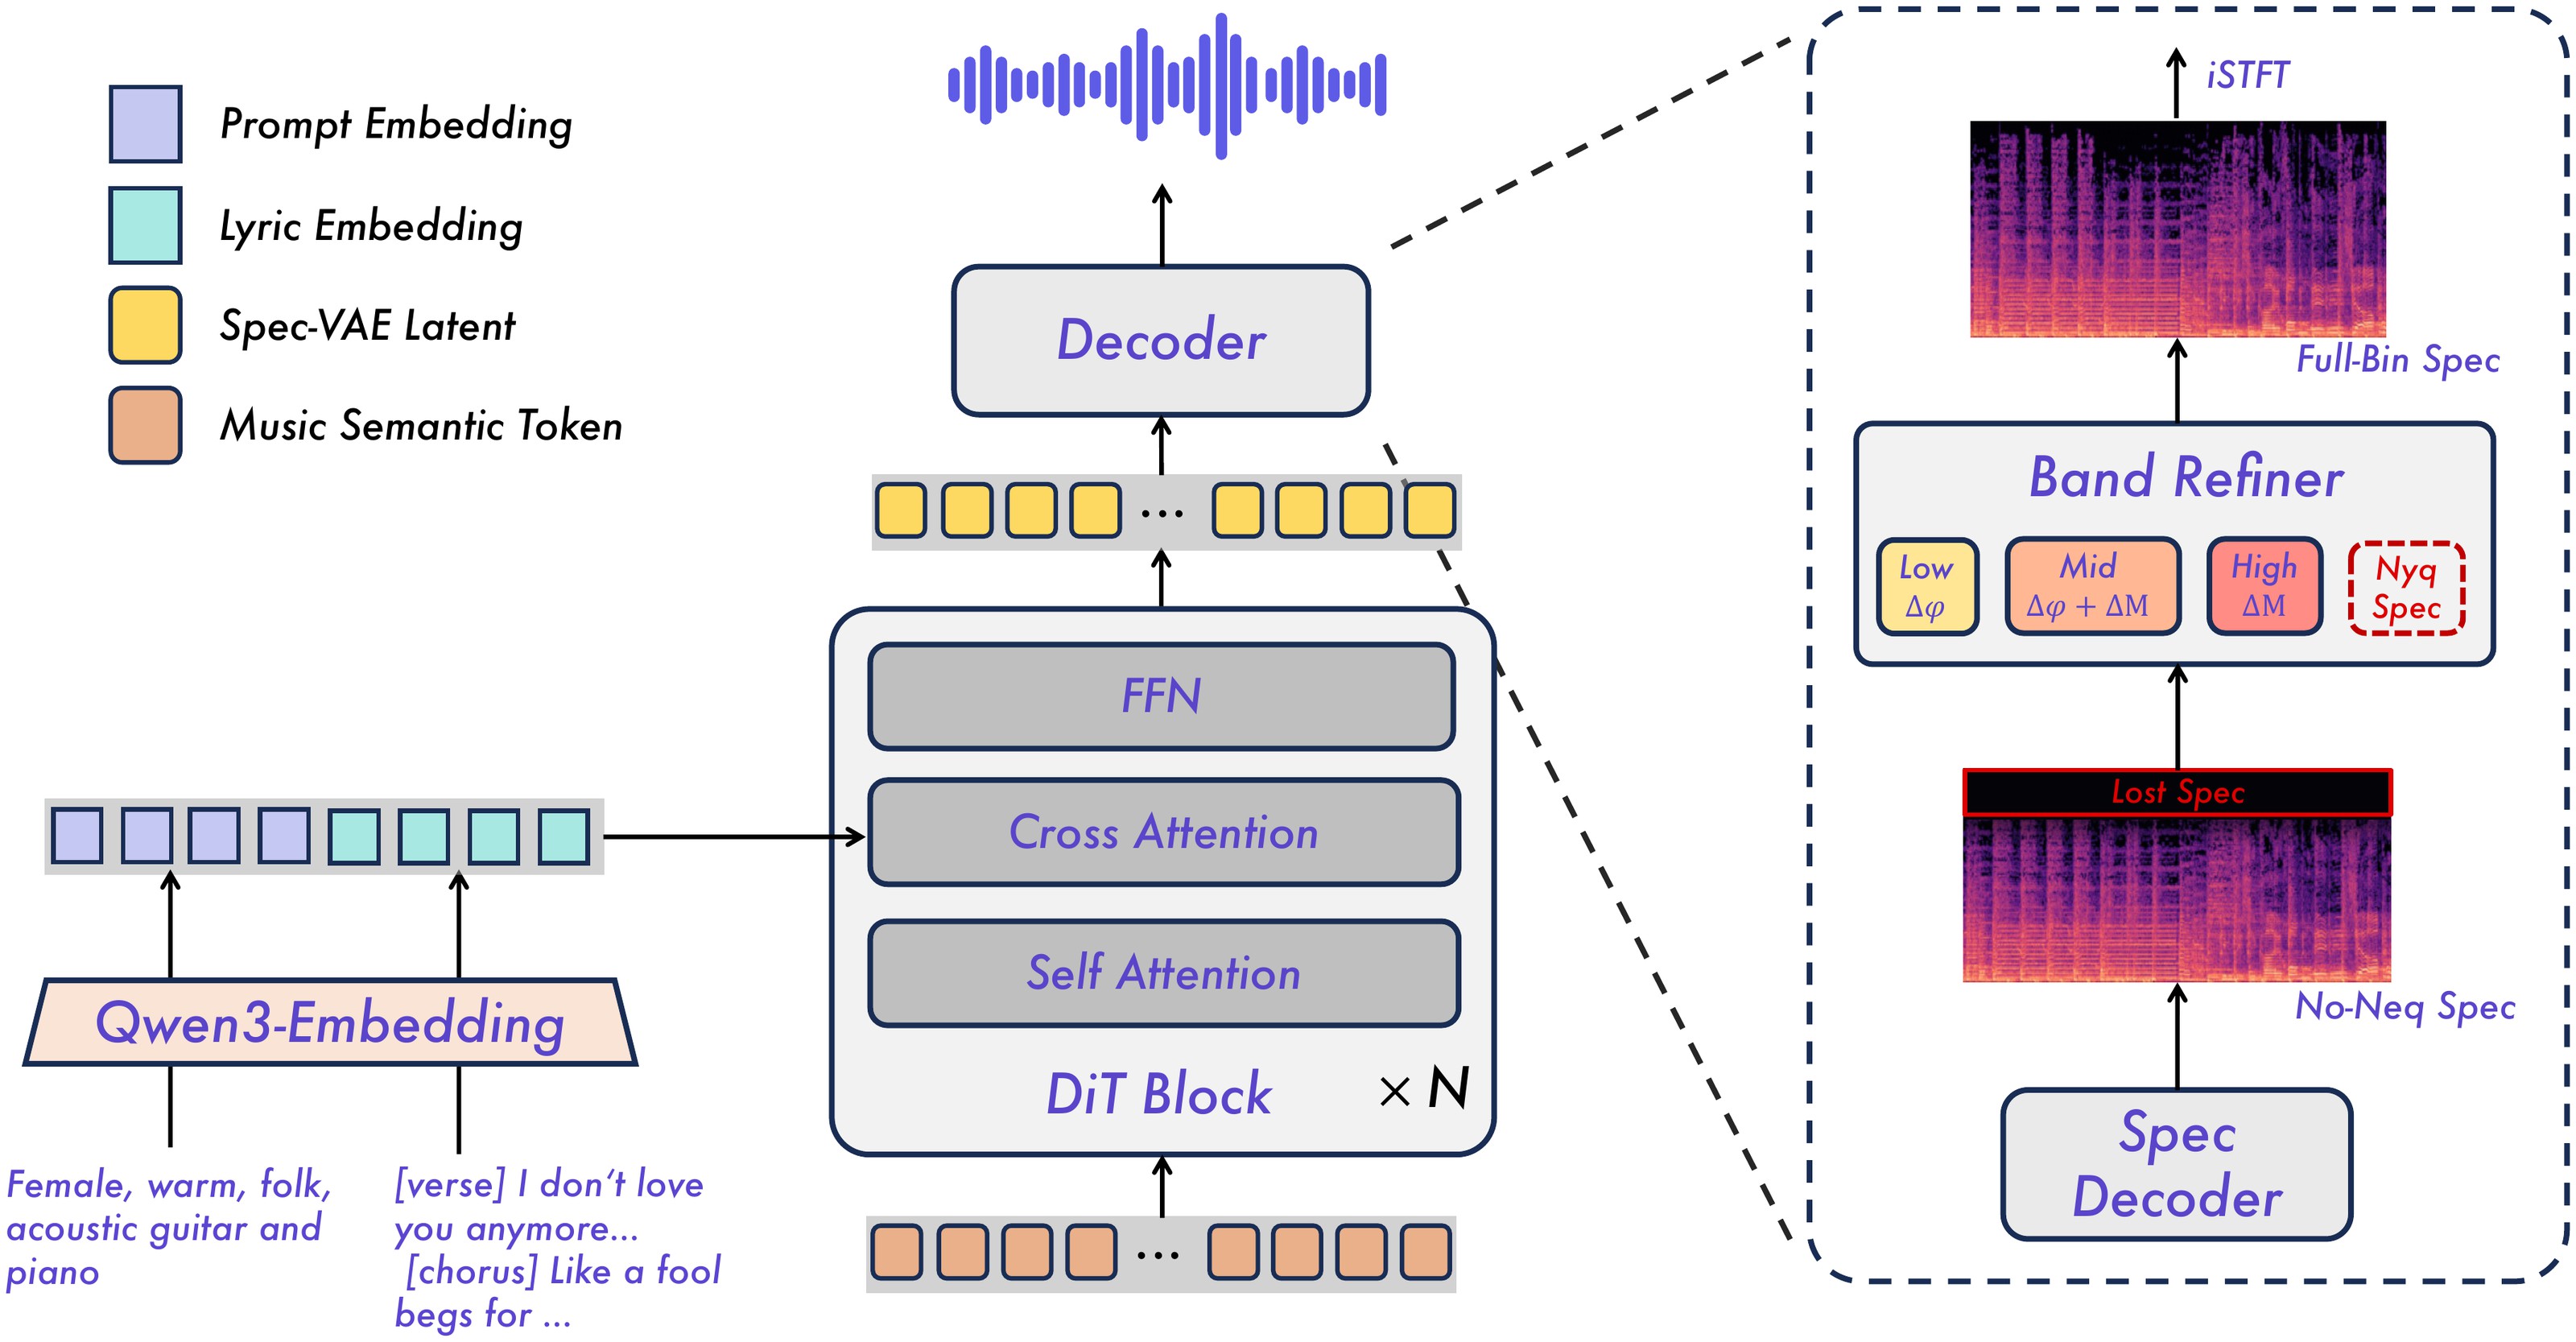
渲染器采用 1.3B DiT,通过条件 flow matching 预测连续声学潜变量。论文给出32个 Transformer block、隐藏宽度1024、24个注意力头等配置;具体头维度和投影实现仍应以实际代码为准,不能仅从这些字段自行补全内部张量布局。潜变量维度128、频率25 Hz,与音乐语义 token 逐帧对齐。
除了语义 token,DiT 还读取文本标签与歌词。冻结的 Qwen3-Embedding-0.6B 提取文本特征;歌词额外通过六层 RoPE Transformer,与描述一起构成交叉注意力上下文。DiT 的训练音频最长六分钟,即约9,000帧;描述与歌词上下文分别截断为256和1536 token。这个训练长度限制不等于服务端对所有用户承诺的歌曲时长。
CFG 的设计值得单独看。条件分支使用语义 token 与完整文本;空条件分支仍保留语义 token,只替换文本上下文。这样,增强的是文本对风格、歌词和表达的约束,而不是同时撤走歌曲的主要语义骨架。过度引导或拿掉骨架都可能改变结构稳定性。
5.1 频率感知激活:不同频段不共享同一种周期先验
Spec-VAE 把48 kHz立体声转换成复数声谱,七块编码器压缩到25 Hz、128维连续潜变量,解码器再重建粗声谱。编码端延迟融合左右声道、解码端较早分开;论文报告总压缩比192倍。
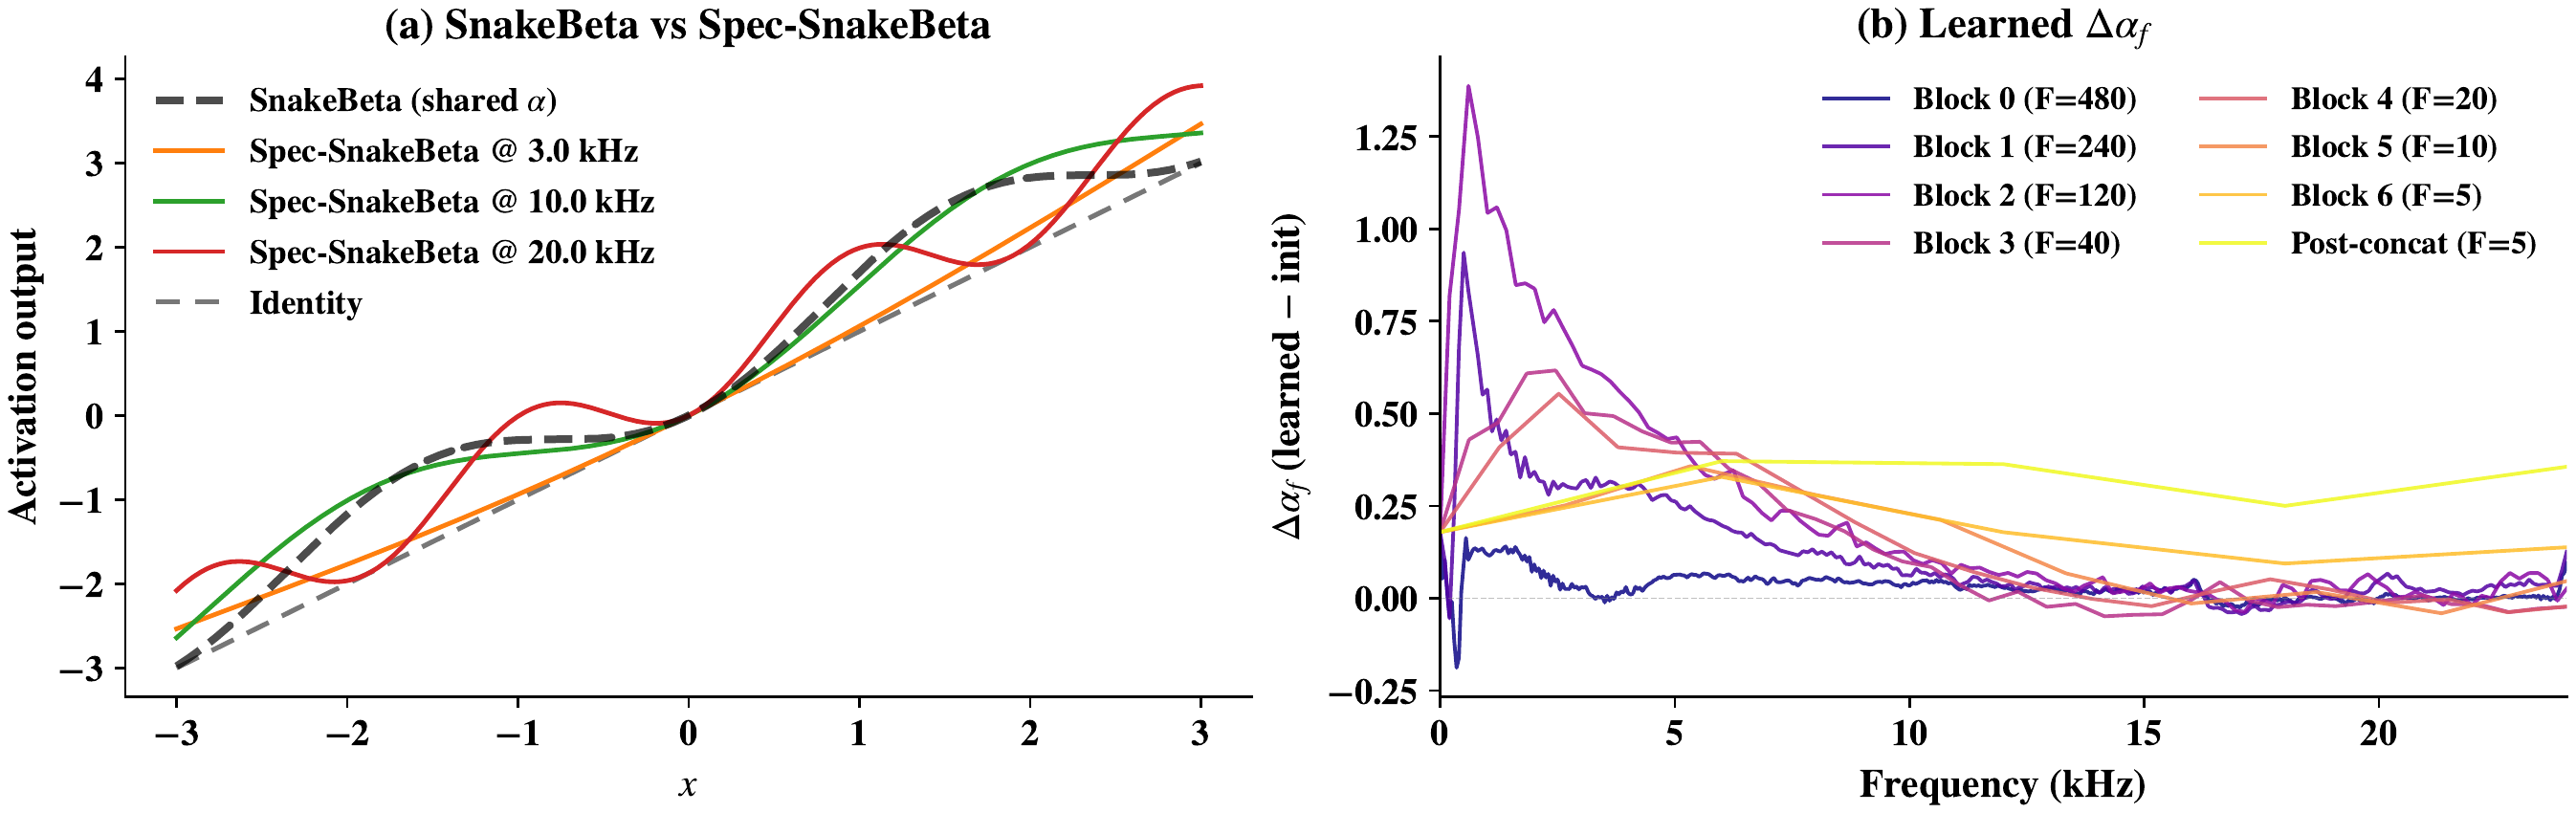
公式(5):
Spec - SnakeBeta
(
x
)
b
,
c
,
t
,
f
=
x
b
,
c
,
t
,
f
+
sin
2
(
x
b
,
c
,
t
,
f
exp
(
α
f
)
)
exp
(
β
f
)
+
ϵ
.
\\operatorname{Spec\\!\\text{-}\\!SnakeBeta}(x)_{b,c,t,f}=x_{b,c,t,f}+\\frac{\\sin^2\\bigl(x_{b,c,t,f}\\exp(\\alpha_f)\\bigr)}{\\exp(\\beta_f)+\\epsilon}.
Spec–SnakeBeta(x)b,c,t,f=xb,c,t,f+exp(βf)+ϵsin2(xb,c,t,fexp(αf)).
公式(6):
α
f
=
log
(
freq
f
f
ˉ
+
ϵ
)
,
f
ˉ
=
1
F
∑
f
freq
f
.
\\alpha_f=\\log\\left(\\frac{\\operatorname{freq}_f}{\\bar f}+\\epsilon\\right),\\qquad \\bar f=\\frac1F\\sum_f\\operatorname{freq}_f.
αf=log(fˉfreqf+ϵ),fˉ=F1f∑freqf.
STFT 的频率轴对应真实物理频率,因此按频率参数化具有明确动机。图7显示学习后的参数在保留先验结构的同时,低中频区域作出了较强调整。它证明模型在使用频段差异,不应被扩大为已经建立完整的人类听觉机制。
5.2 Band-Mode Refiner:分频段修复幅度和相位
Refiner 是轻量 ConvNeXt-1D:低频只修相位,中频同时修幅度与相位,高频只修幅度。其参数以零初始化,使初始输出等于原解码结果,减少接入新模块时对已有重建的扰动。
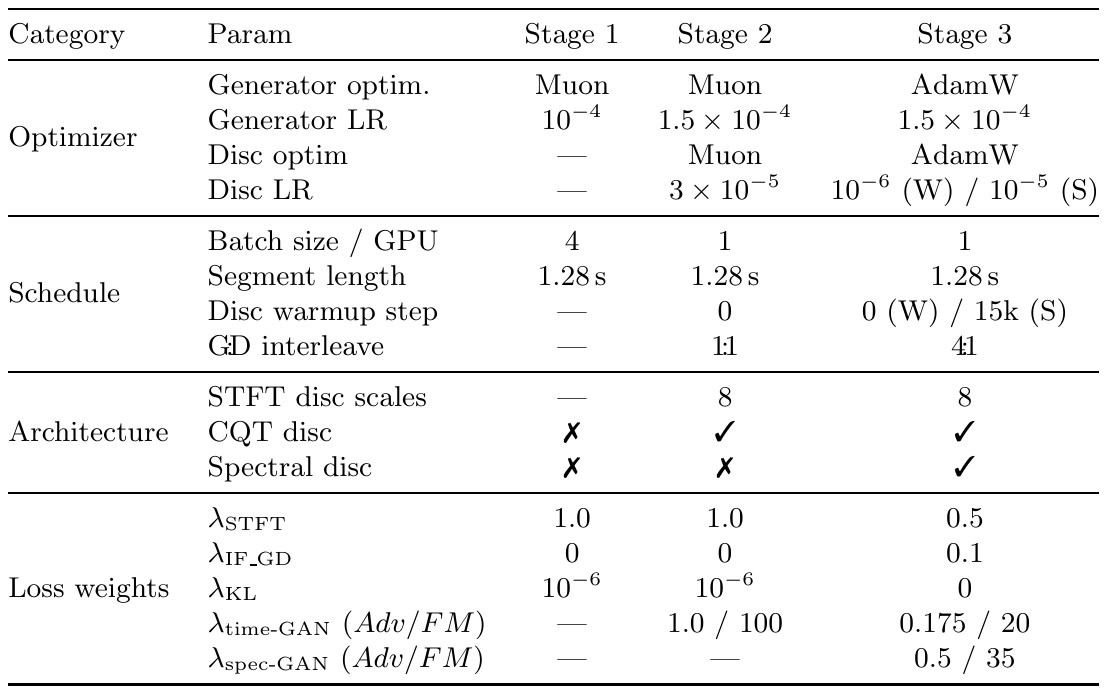
先进行重建预训练,再引入波形域对抗训练,最后冻结编解码器、训练 Refiner,并加入波形与频谱判别器。表2完整列出了优化器、学习率、裁剪长度、判别器和损失权重。这说明高保真效果并非只来自一个后处理层,而是表示、感知损失与分阶段优化共同作用。
6. 数据质量:采样率高,不代表原始内容高保真
从 MP3 转为无损容器、把单声道复制成双声道、把低采样率音频上采样到48 kHz,都可能让文件属性看起来合格,却没有增加真实内容。对生成式渲染器来说,这类数据会教会模型错误的高频结构和立体声分布。
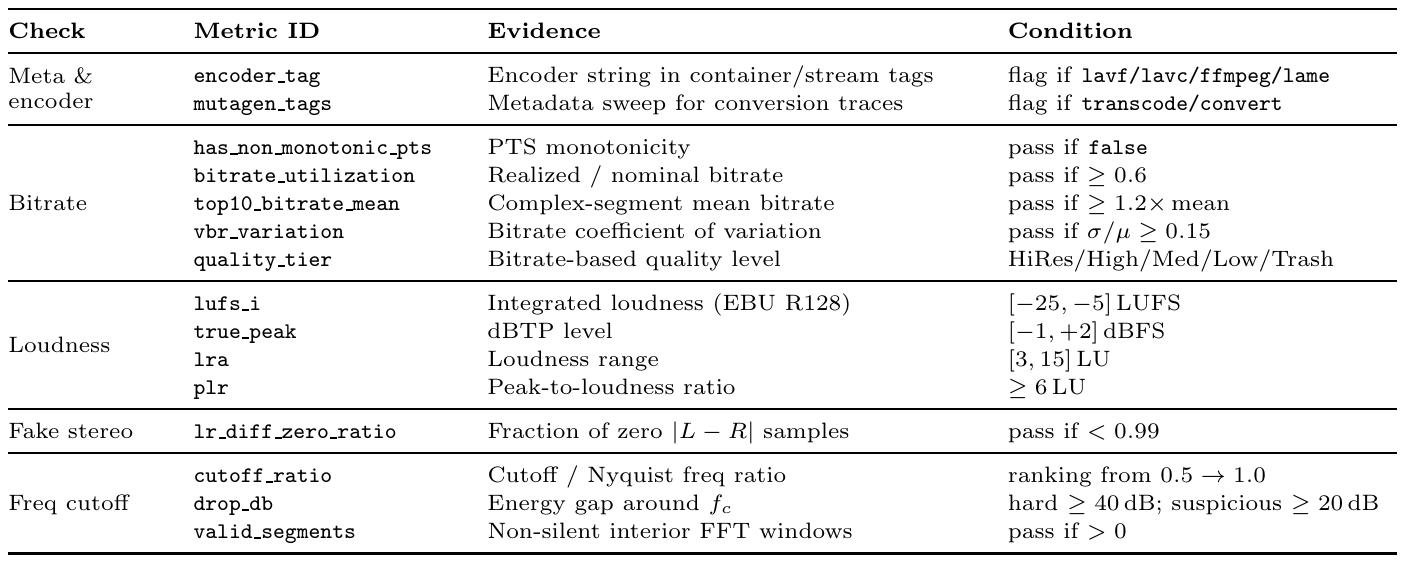
表3包含码率变化、响度、削波风险、左右声道差异和频率截止等指标。编码器标识与转换痕迹是规则引擎的提示信号,不是“使用某个软件处理过就一定劣质”的普适结论。筛选阈值还需要随体裁和母带处理方式校准,否则可能排斥本就低动态或窄频的音乐。
频率截止检测把边缘噪声底与中段信号分开估计。对开头、结尾各10%的片段做8192点RFFT,归一化并平均幅度,在最高10%频率 bins 上取中位数。公式(7):
η
^
=
20
log
10
(
median
(
M
‾
e
d
g
e
[
t
o
p
10
%
b
i
n
s
]
)
)
.
\\widehat\\eta=20\\log_{10}\\left(\\operatorname{median}\\bigl(\\overline{\\mathbf M}_{\\mathrm{edge}}[\\mathrm{top}\\ 10\\%\\ \\mathrm{bins}]\\bigr)\\right).
η
=20log10(median(Medge[top 10% bins])).
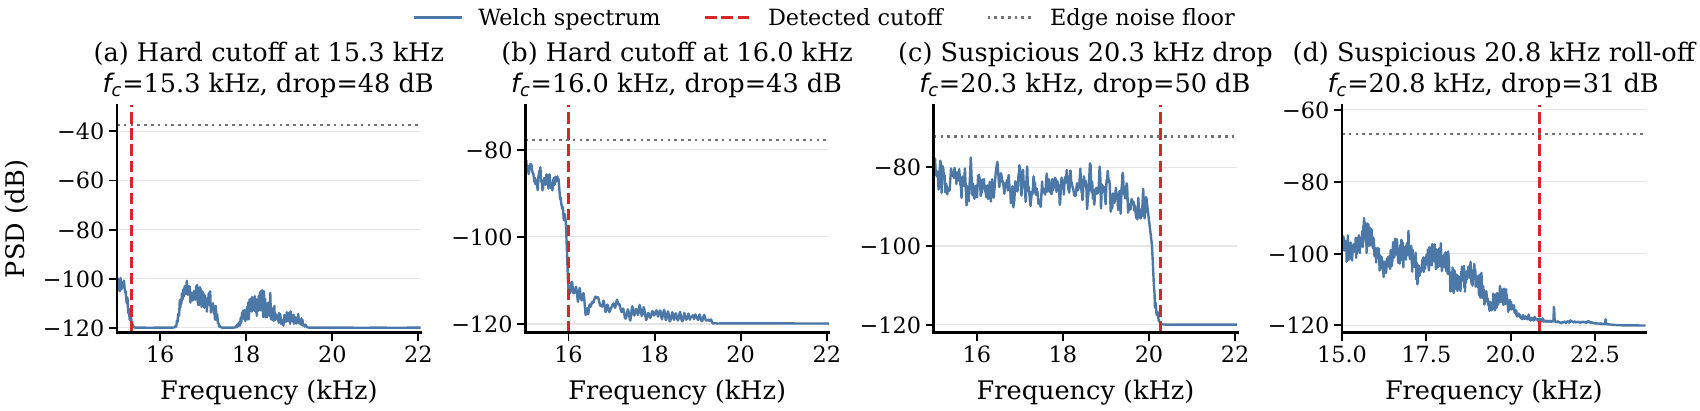
在五个内部窗口寻找相对峰值仍高于−80 dB的最高频点
f
c
f_c
fc,比较其两侧各2 kHz范围的能量下降。公式(8)按文中的分贝谱口径可写为:
Δ
d
B
=
max
M
‾
i
n
t
[
f
c
−
2
k
H
z
:
f
c
]
−
max
M
‾
i
n
t
[
f
c
:
f
c
+
2
k
H
z
]
.
\\Delta_{\\mathrm{dB}}=\\max\\overline{\\mathbf M}_{\\mathrm{int}}[f_c-2\\mathrm{kHz}:f_c]-\\max\\overline{\\mathbf M}_{\\mathrm{int}}[f_c:f_c+2\\mathrm{kHz}].
ΔdB=maxMint[fc−2kHz:fc]−maxMint[fc:fc+2kHz].
这里两项应理解为同一参考下的分贝谱值;若实现存储的是线性幅度,必须先转换成对数值,不能把线性幅度差当作 dB。没有可靠截止后信号时,以估计噪声底替代后项。阈值同时看截止频率占Nyquist的比例与落差:例如比例低于0.85且下降至少40 dB,或者接近噪声底时至少25 dB,会判为硬截止;比例低于0.90且下降至少20 dB为可疑。
这是一套声学质量启发式,不能证明数据版权、原创性或全部频段的听感质量。其研究价值在于把“高保真数据”转化为可检查的证据,而非只相信容器元信息。
7. 训练课程与偏好优化:质量提升也需要防止奖励偏差
LLM 预训练使用质量分桶。内部MOS预测器在每个音乐体裁内排序,以90%、75%、50%、25%、5%、1%等分位阈值分成Q1至Q7,Q1质量最高,移除Q7。按体裁归一化可以缓解主流风格主导打分的问题,但分桶最终仍依赖预测器的审美与覆盖范围。
课程先用Q3–Q6学习广泛映射,再在Q2退火,最后用Q1与额外精选样本强化。第一阶段加入20%器乐并做语言平衡,避免把所有音乐都压成“有歌词的人声生成”。后训练依次采用高质量SFT、反复生成候选并构造偏好对的离线DPO、在线GSPO。奖励包括内部音乐性MOS、由Qwen3.5-Omni评价的指令遵循,以及Qwen3-ASR参与的歌词一致性。
这些阶段构成合理的稳定到探索路径,但论文没有用完整消融把每一阶段的增益独立拆开。奖励模型与评价指标间可能存在偏好相关,优化自动分数也可能降低风格多样性。后续研究应观察少数语言、非主流体裁、长结构变奏和强表达歌唱,并使用独立人评检查奖励是否真正改善用户体验。
8. 实验结果:音乐性、可控性与旋律保持存在不同最优点
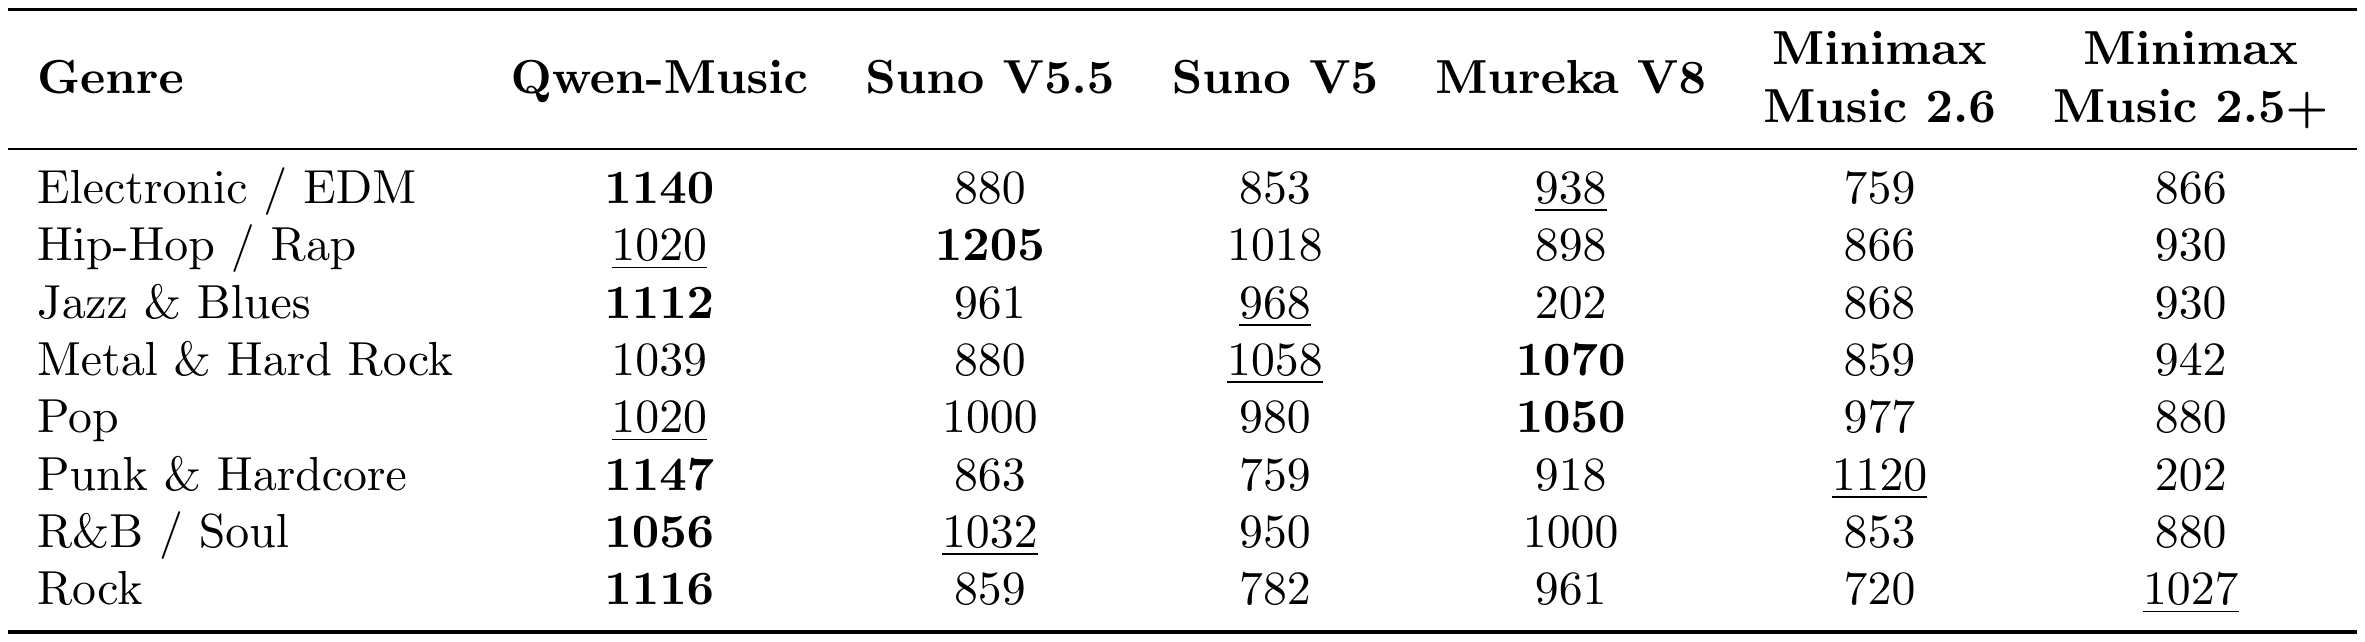
Qwen-Music 在八个体裁中五项获得最高评分,但这些评分按体裁独立估计,只适合同一行内比较。例如不能把电子音乐的1140与流行音乐的1020相减,解释为该模型电子音乐能力高出120分。体裁细分表也表明总体领先不会自动转化为每一种风格都最好。
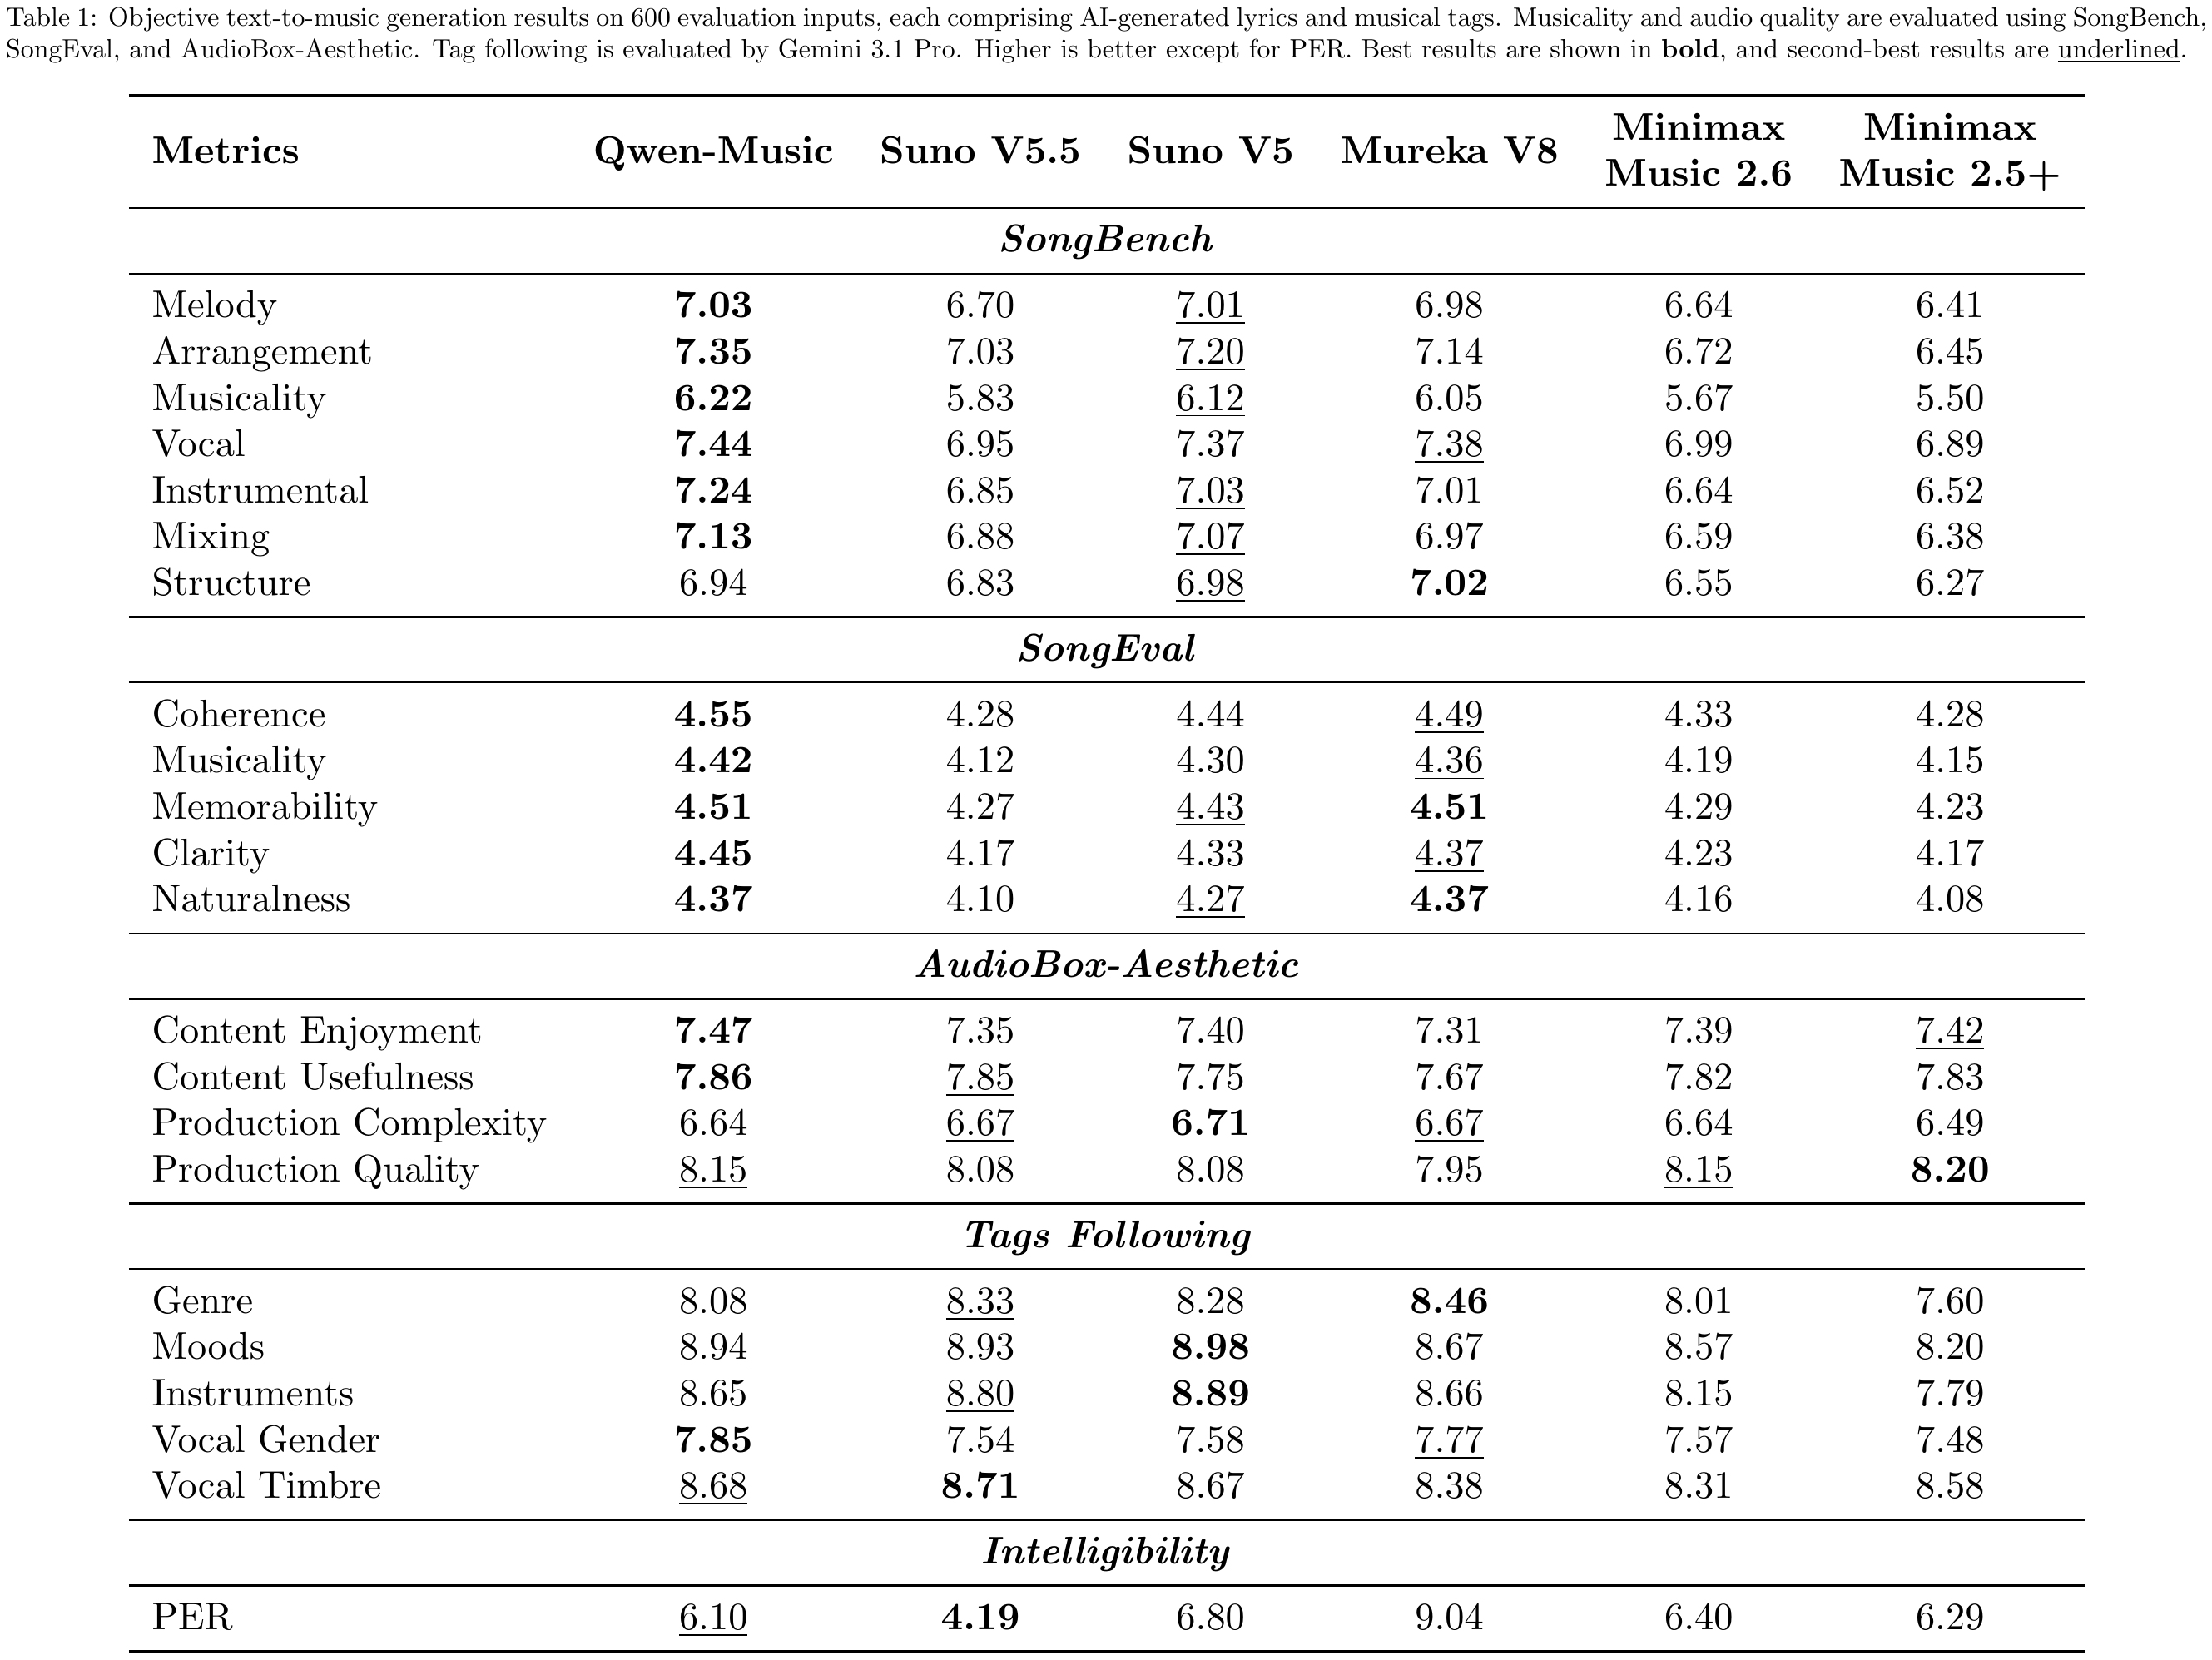
论文报告在SongBench、SongEval和AudioBox-Aesthetic共16个音乐性与音质指标中13项取得最优,包含表中显示的并列最优。结构评分6.94低于Mureka V8的7.02,PER为6.10,高于Suno V5.5的4.19,后者在歌词可懂度指标上更好。标签遵循也并非全面领先。由此更合理的判断是它取得了较强的综合平衡,而不是所有维度都获胜。
PER来自ASR转写与输入歌词比较,因此同时受ASR错误影响;Gemini对风格标签的1–10分评级属于模型评审,也不等于人类客观真值。600组输入由AI生成,能够提供统一测试条件,但覆盖范围仍可能偏离真实创作者的复杂编辑请求。
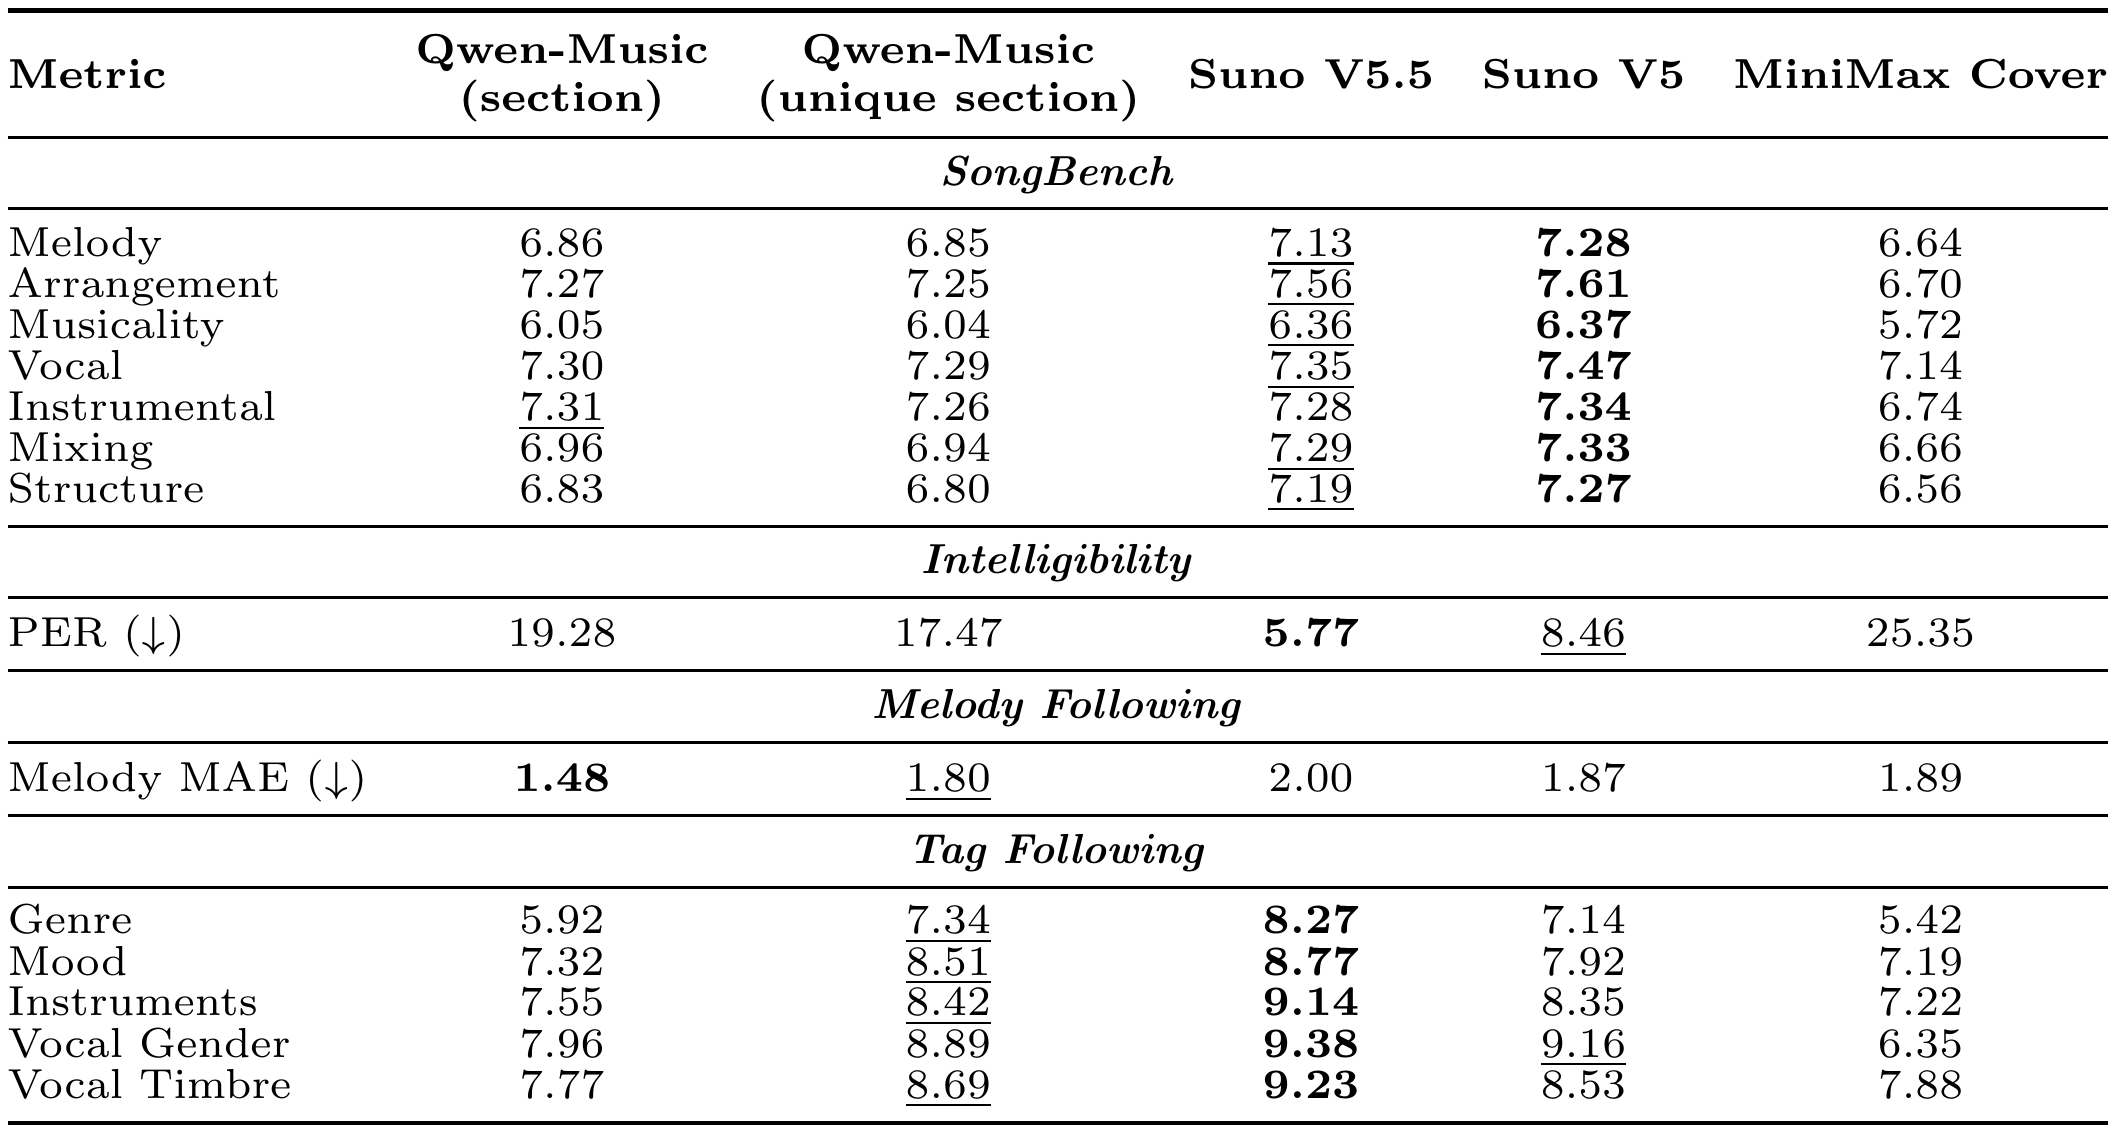
此集合包含100个英文与100个中文例子,可以比较Suno V5.5、Suno V5与MiniMax Cover。旋律保持使用相对MIDI表示,经DTW对齐后计算半音MAE。该指标更关注旋律轮廓,而不是绝对调高、歌手身份或完整编曲复刻。
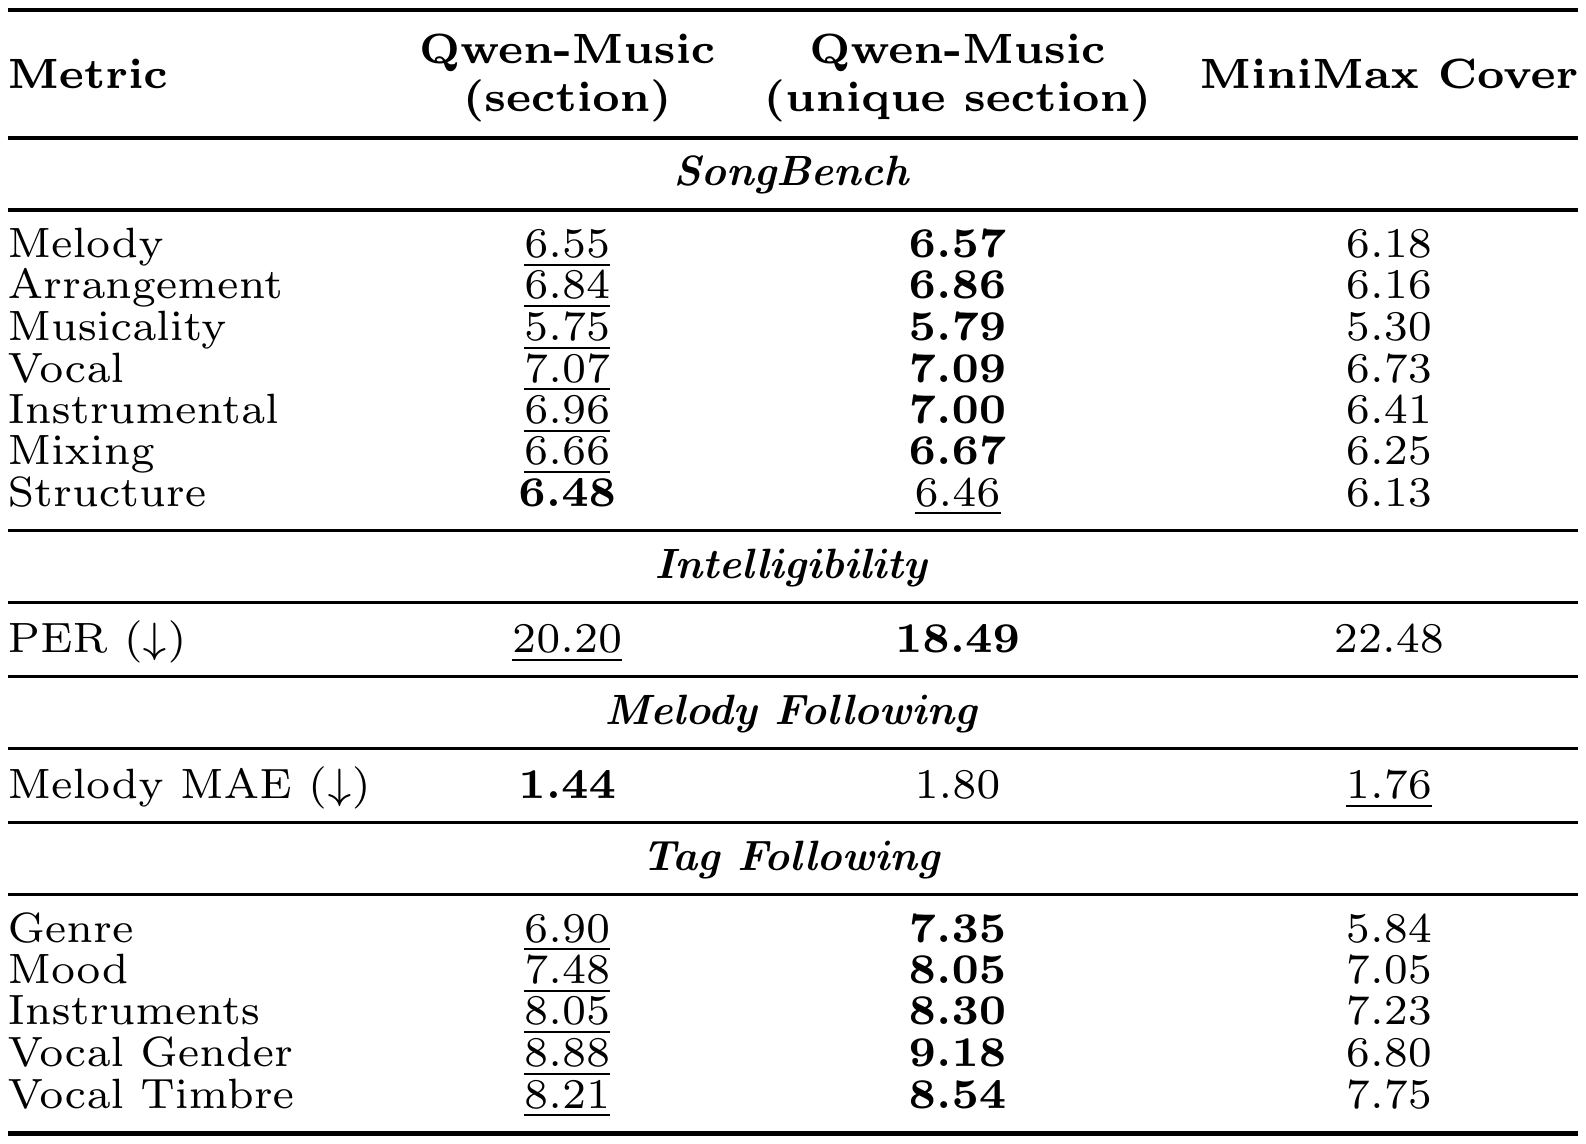
第二组同样各含100个中英文样本,表注为开放许可音乐。Suno不接受这类现实歌曲参考输入,因此没有纳入该组比较,不能把缺席当作生成失败。Qwen-Music的section模式MAE为1.44,unique-section为1.80,MiniMax为1.76;unique-section的PER却从20.20改善到18.49,并在多项标签遵循上更好。条件粒度确实改变了旋律忠实度与再创作自由之间的平衡。
8.1 渲染消融:保留骨架,增强文本条件
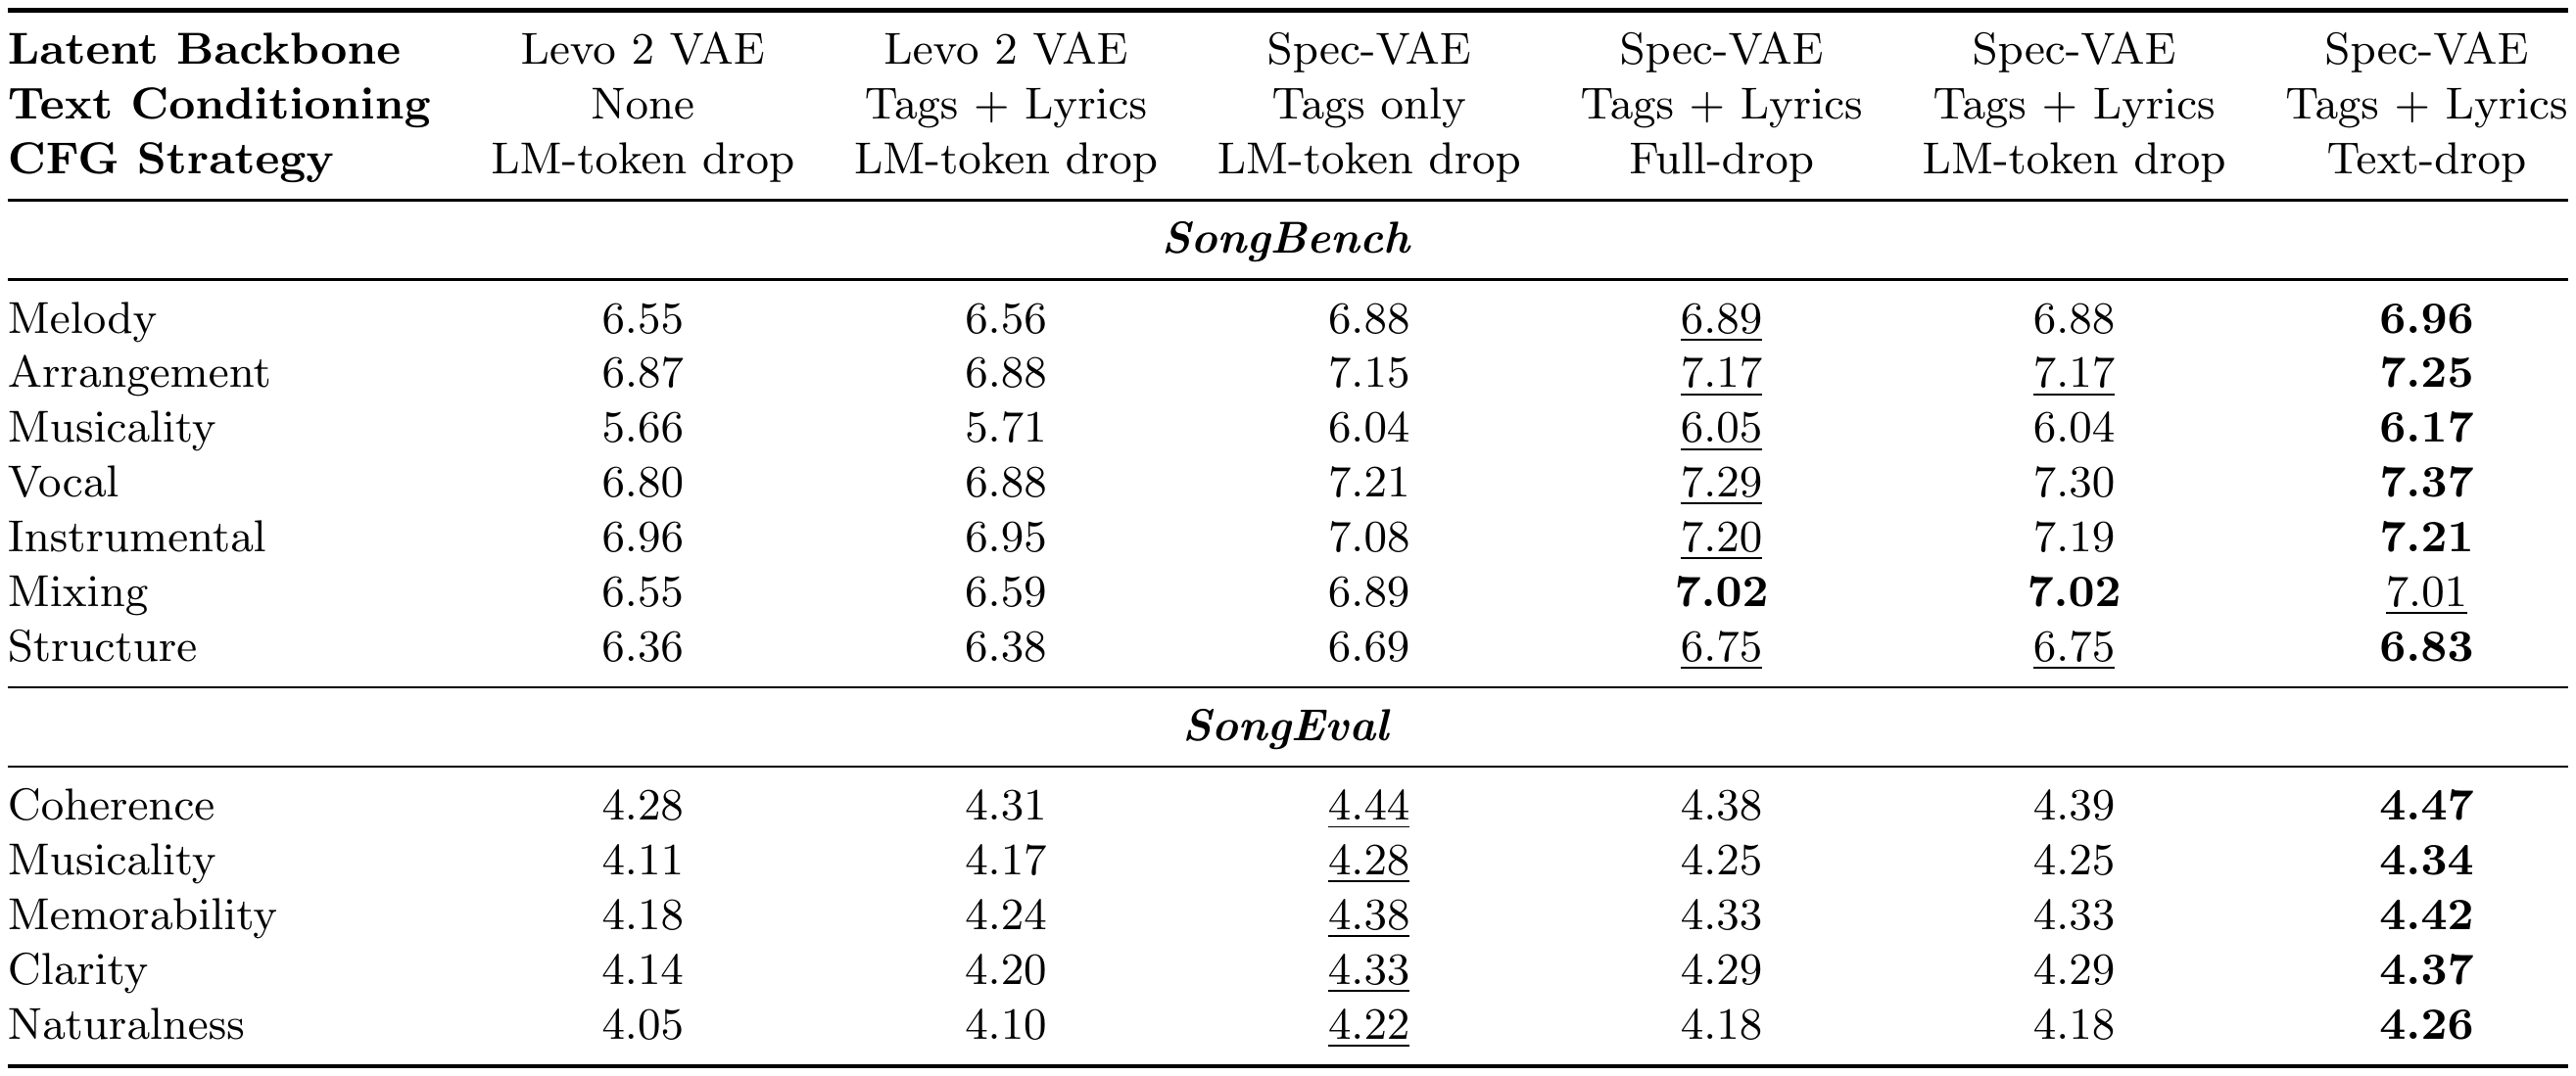
这一组中英文各100样本的实验,为公平比较绕过了Band-Mode Refiner。最优总体组合是Spec-VAE、标签加歌词、Text-drop CFG。应逐列检查控制变量:表内“无文本”列使用Levo 2 VAE,而部分其他列同时改变了潜变量骨干,不能把全部差异都单独归因于文本条件。比较同一Spec-VAE下不同CFG设置,才更直接支撑空分支设计的作用。
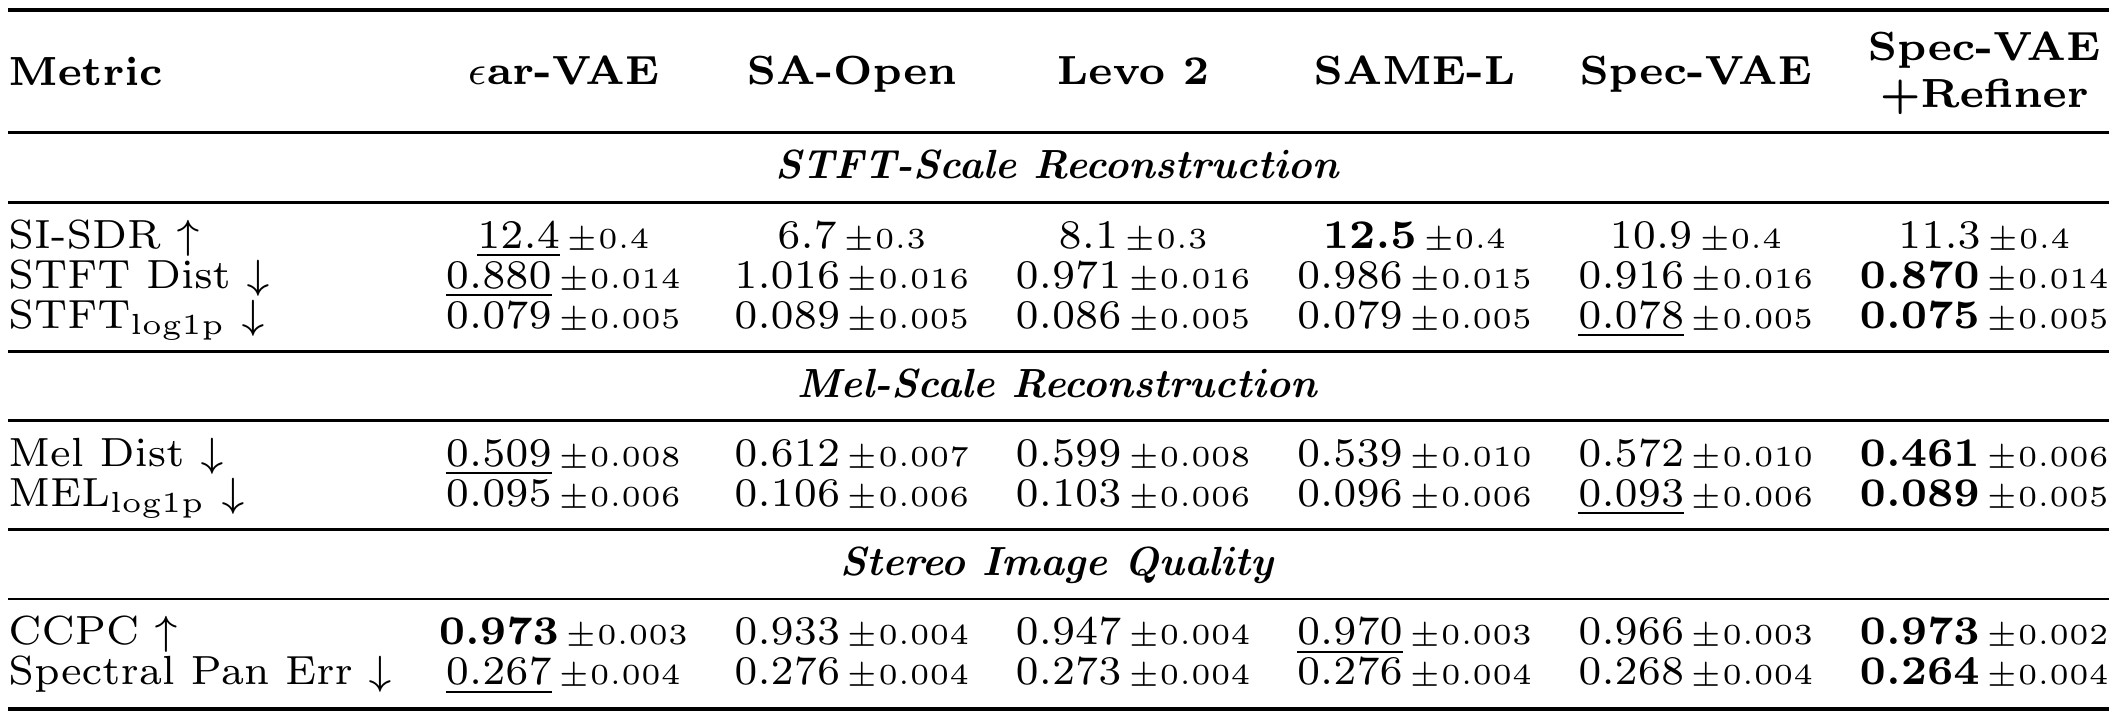
Refiner使Mel Distance从0.572降到0.461,STFT Distance从0.916降到0.870,CCPC从0.966提升到0.973。表中保留了逐文件统计的95%置信区间。它也没有在SI-SDR上超过全部其他系统:11.3仍低于表中的12.5。这说明频谱、声道与波形指标评估的性质不同,不能压成一个无条件的“音质最好”。各系统按原生工作条件评测,也不构成相同码率或算力预算下的严格比较。
9. 可复现边界与工程落地
报告公开了架构、训练课程、损失、部分超参数和详细评测,但不能仅因名称带Qwen就推断权重、训练集和完整代码均可下载。本次核验没有确认与报告对应的官方完整权重和训练复现包;独立社区重建项目也不能作为官方权重或质量等价的证据。
论文同时缺少覆盖完整系统的生成速度、硬件、内存和每分钟音乐成本测量。25 Hz是语义序列频率,48 kHz是输出采样率,都不是推理吞吐率。长歌的AR序列、DiT采样步数与渲染器占用需要联合测量,才能判断是否适用于实时伴奏、离线生产或批量素材生成。
对创作工具团队,更有意义的验收是能否固定歌词只换编曲、保留副歌旋律修改主歌、稳定重生局部片段,以及在多次编辑后保持统一风格。当前报告支持文本创作和参考旋律改编,不自动证明这些细粒度编辑接口已经提供。
10. Rocky的判断:音乐模型的长期价值在可编辑中间层
语义压缩让分钟级歌曲进入语言模型的可处理范围,旋律计划让参考控制拥有明确接口,生成式渲染再补足声学细节。Qwen-Music的价值,在于把长期结构与局部保真度分开处理,同时让二者通过可学习的条件连接。
值得继续研究的方向,是在这一中间层上建立可验证编辑:哪个token段对应副歌、哪些条件影响音色、一次修改会不会破坏相邻段落。只有能被创作者理解、迭代与纠正,生成系统才更容易进入持续的音乐制作流程。
对算法工程师,这是表示学习、序列生成、扩散渲染与偏好优化结合的完整案例;对产品与商业判断,优美样例只是起点,编辑稳定性、生成成本、作品与声音使用权、工作流集成才决定可持续价值。公开结果已经展示了较强竞争力,下一步更需要可复现的接口、长期结构实验与独立听评来证明它能稳定成为生产工具。
推荐阅读
1. 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:
深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2. 深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
Rocky对扩散模型的本质原理与和核心基础知识进行了全面系统的深入浅出分析讲解,同时不断跟进补充扩散模型的最新技术发展,希望能给大家带来帮助:
深入浅出完整解析扩散模型DDPM、DDIM、Score-Based、SDE、LDM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
3. 入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
Rocky对AIGC时代“中场时刻”之后的主流AIGC创作大模型的核心基础知识进行了全面系统的深入浅出分析讲解,力求让大家通俗易懂理解AIGC时代的技术浪潮的本质价值:
入浅出完整解析FLUX.2、Seedream(即梦)、Z-image、GLM-Image核心基础知识
4. 深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
Rocky对FLUX.1 Kontext和FLUX.1 Krea的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析FLUX.1 Kontext和FLUX.1 Krea核心基础知识
5. 深入浅出完整解析DeepSeek系列核心基础知识
Rocky对DeepSeek系列模型的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析DeepSeek系列核心基础知识
6. 深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
Rocky对Stable Diffusion 3和FLUX.1的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion 3(SD 3)和FLUX.1系列核心基础知识
7. 深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
Rocky对Stable Diffusion XL的核心基础知识作了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion XL(SDXL)核心基础知识
8. 深入浅出完整解析Stable Diffusion(SD)核心基础知识
Rocky对Stable Diffusion 1.x-2.x系列模型的核心基础知识做了全面系统的梳理与解析:
深入浅出完整解析Stable Diffusion(SD)核心基础知识
9. 深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
Rocky对Stable Diffusion中最为关键的U-Net结构进行了深入浅出的全面解析,包括其在传统深度学习中的价值和在AIGC中的价值:
深入浅出完整解析Stable Diffusion中U-Net的前世今生与核心知识
10. 深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
对于AIGC时代中的“ResNet”——LoRA模型,Rocky进行了深入浅出的全面讲解:
深入浅出完整解析LoRA(Low-Rank Adaptation)模型核心基础知识
11. 深入浅出完整解析ControlNet核心基础知识
AIGC图像创作开源社区已经形成以Stable Difffusion/FLUX为核心,ConrtolNet和LoRA作为首要AI辅助工具的变化万千的AIGC图像创作工作流。
ControlNet正是让AI图像创作社区无比繁荣的关键一环,它让AIGC图像创作过程更加的可控,更有助于广泛地将AIGC算法解决方案应用到各行各业中:
深入浅出完整解析ControlNet核心基础知识
12. 深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
AI绘画和AI视频是两个互相促进、相互交融的领域,2024年无疑是AI视频领域的爆发之年,Rocky对AI视频领域核心的Sora、Seedance、Keling等大模型进行了全面系统的梳理与解析:
深入浅出完整解析Sora、Seedance、keling等AI视频大模型核心基础知识
13. 深入浅出完整解析AIGC时代Transformer核心基础知识
在AIGC时代中,Transformer为AI行业带来了深刻的变革。Transformer架构正在一步一步重构所有的AI技术方向,成为AI技术架构大一统与多模态整合的关键核心基座,大有一统“AI江湖”之势。Rocky也对Transformer模型进行持续的深入浅出梳理与解析:
深入浅出完整解析AIGC时代Transformer核心基础知识
14. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
AIGC创作框架正是AIGC算法工作流的运行载体,目前主流的AIGC创作框架有ComfyUI、Diffusers、Stable Diffusion WebUI等。在传统深度学习时代,PyTorch、TensorFlow以及Caffe是传统深度学习模型的基础运行框架,到了AIGC时代,Rocky相信ComfyUI就是AIGC时代的“PyTorch”、Stable Diffusion WebUI就是AIGC时代的“TensorFlow”、Diffusers就是AIGC时代的“Caffe”:
深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
15. 深入浅出完整解析ComfyUI、Diffusers、Stable Diffusion WebUI等主流AIGC创作框架核心基础知识
在AIGC时代中,如何快速转身,入局AIGC产业?如何成为AIGC/LLM/AI Agent算法/开发工程师?如何在学校中系统性学习AIGC/LLM/AI Agent知识,斩获心仪的AIGC/LLM/AI Agent算法/开发offer?
Don‘t worry,Rocky为大家总结整理了全面的AIGC/LLM/AI Agent算法/开发工程师成长秘籍,为大家答疑解惑,希望能给大家带来帮助:
手把手教你成为AIGC/LLM/AI Agent算法/开发工程师,斩获AIGC/LLM/AI Agent算法/开发offer!
16. AIGC产业的深度思考与分析
2023年3月21日,微软创始人比尔·盖茨在其博客文章《The Age of AI has begun》中表示,自从1980年首次看到图形用户界面(graphical user interface)以来,以OpenAI为代表的科技公司发布的AIGC模型是他所见过的最具革命性的技术进步。
Rocky也认为,AIGC及其生态,会成为AI行业重大变革的主导力量。AIGC会带来一个全新的红利期,未来随着AIGC的全面落地和深度商用,会深刻改变我们的工作、生活、学习以及交流方式,各行各业都将被重新定义,过程会非常有趣。
那么,在此基础上,我们该如何更好的审视AIGC的未来?我们该如何更好地拥抱AIGC引领的革新?Rocky准备从技术、产品、商业模式、长期主义等维度持续分享一些个人的核心思考与观点,希望能帮助各位读者对AIGC有一个全面的了解:
深入浅出全面解析AIGC时代核心价值与发展趋势(2025年版)
17. AI算法工程师的独孤九剑秘籍
为了方便大家实习、校招以及社招的面试准备,同时帮助大家提升扩展技术基本面,Rocky将符合大厂和AI独角兽价值的算法高频面试知识点撰写总结成《三年面试五年模拟》之独孤九剑秘籍:
【三年面试五年模拟】AIGC时代的算法工程师的求职面试秘籍(持续更新中)
18. 深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识
GAN系列模型作为传统深度学习时代的最热门生成式Al模型,在AIGC时代继续繁荣,作为Stable Diffusion/FLUX系列大模型的“得力助手”,广泛活跃于AlGC图像创作的产品与工作流中:
深入浅出完整解析AIGC时代中GAN(Generative Adversarial Network)系列模型核心基础知识


评论前必须登录!
注册