 网硕互联帮助中心
一,文本处理的基本方法:
1.分词
分词使用jiaba分词器的三种方式精确查找模式,全模式,搜索引擎模式
2.词性标注
对此的一种分类方法,简称POS
3.命名实体识别
人名,地名,机构等专有名词统称为命名实体。简称NER
二,文本张量便是方法
1.one-hot方法:
也叫稀疏词向量表示. 记忆一个词为1其它为0
2.work2vec:
秘稠向量表示,
分为两种训练方式
CBOW:两侧预测中间
Skip-gram:中间预测两侧
work2vec的词向量估计了就是静态的
3.work embedding:
相同点和work2vec都可以进行文本向量的训练。
广义上work2vec可以认为是work embedding 的一种,可以使用深层神经网络
也可以使用浅层神经网络,狭义上可以认为是深度神经网络词嵌入层的一部分
产生词向量后作为词嵌入层的一部分,词向量的权重会参与更新,所以是动态的。
三,文本预料的数据分析
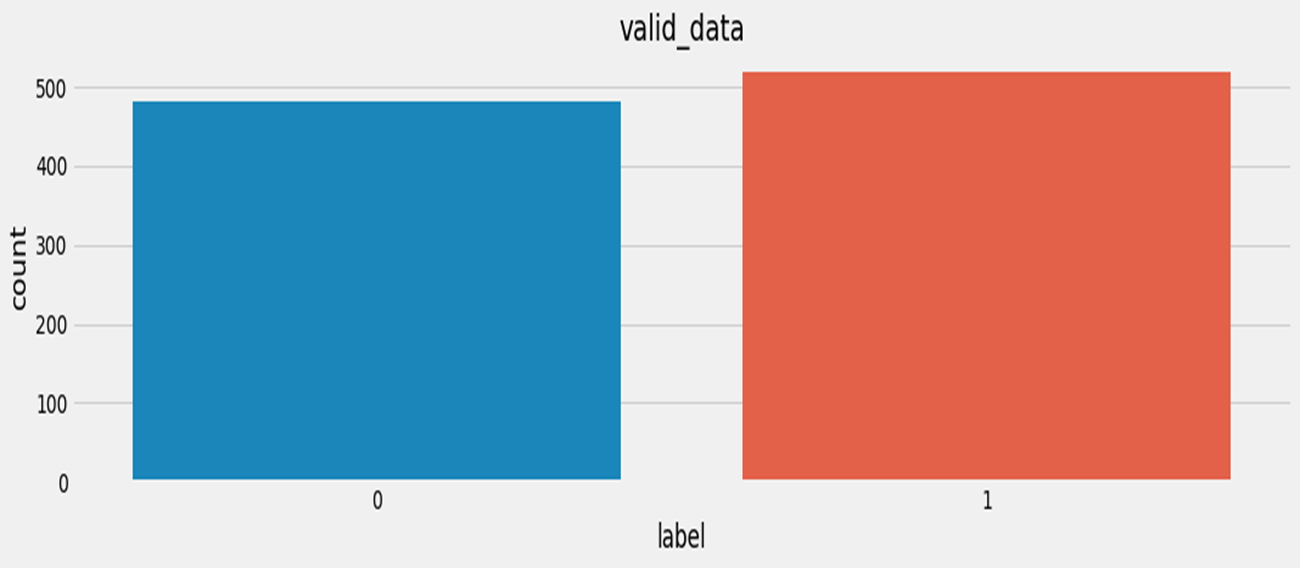
1.标签数量分布:
标签的数据统计求标签的0有多少,1有多少。
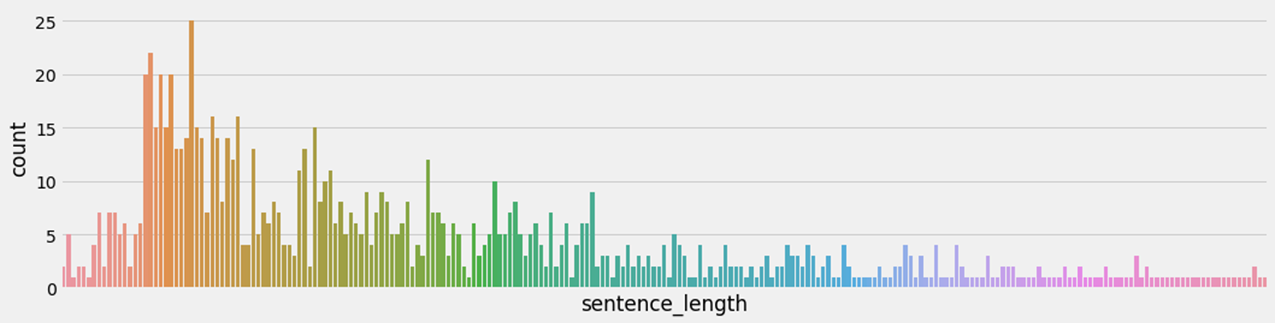
2.句子长度分布:
句子的长度为多少,如50的有多少,51的有多少。
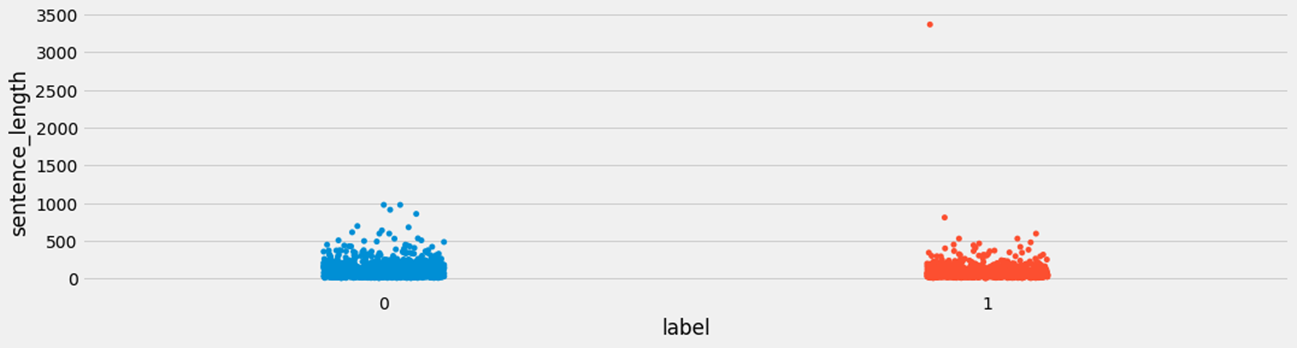
3.获取正负样本样本长度散点的分布:
按照X的正负样本进行分组,再按照y长度进行散点图
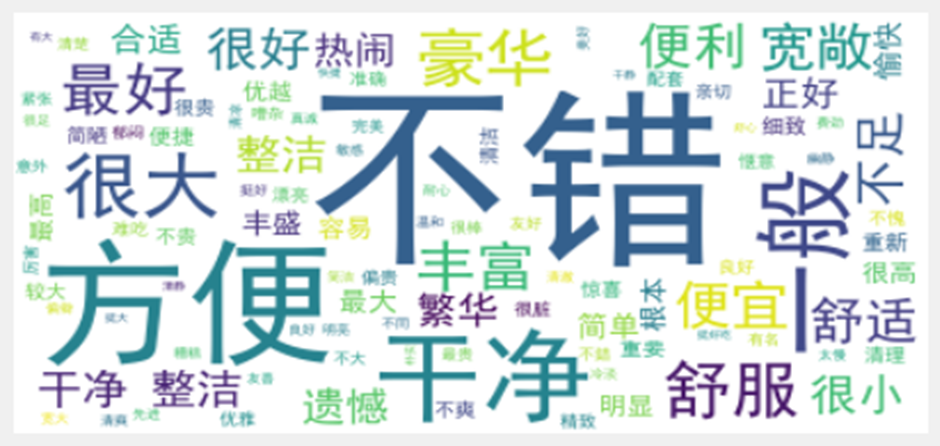
4.词频统计和关键词词云:
词云主要是人工审核
四,文本特征处理
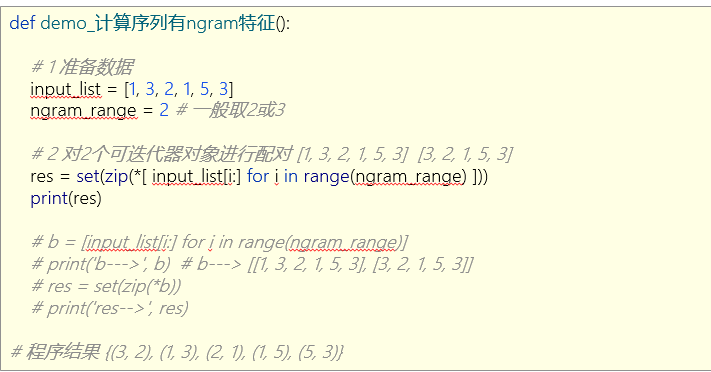
1.n-gram特征:
具有普适性的文本特征,两个单词总是相邻并共现。
常用的特征是bi-gram和tri-gram,分别对应n的2和3.
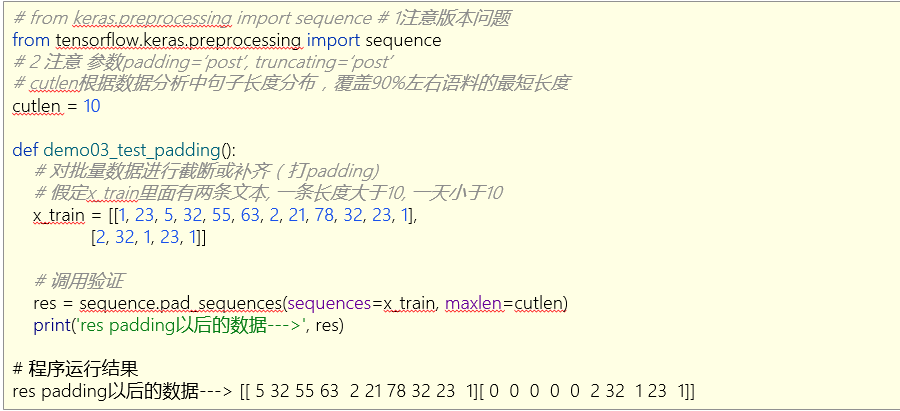
2.文本长度规范和作用
比如文本长需要截取,文本过短需要pad补齐(补零)
五,数据增强
将文本数据翻译证零一种语言之后在翻译回原语言。
新语言加入到原数据集中认为是对数据的增强。


评论前必须登录!
注册