 网硕互联帮助中心
🧠前言
你还在让 RAG 像个临考前一通乱翻的学渣吗?😩 每次提问才手忙脚乱地检索,用完即弃,知识库活成了一次性筷子 🥢
✨ 现在,换个玩法! 把检索从查询期提前到摄入期编译——在知识入库的那一刻,就把“消化”和“索引”做到位,让知识库从消耗品,彻底变成能不断增值的复利资产 💰📈
🔥 开箱即食:把“预编译”直接挂给你的 Agent
光看不过瘾?我写了一个 直接可以挂载到任意agent的Skill—— 👉GitHub: llm-wiki-skill
📖 本文带你轻松拆解
-
🧠 Andrej Karpathy 的原始 pattern
-
🔍 钻进两个开源项目,看不同技术血统怎么落地:
-
nashsu/llm_wiki 🧩
-
garrytan/gbrain 🧠
-
不用苦大仇深,跟着玩一遍,你会笑着把“预编译知识库”装进脑袋 😄🚀
📚 一、Karpathy LLM‑wiki 核心机制
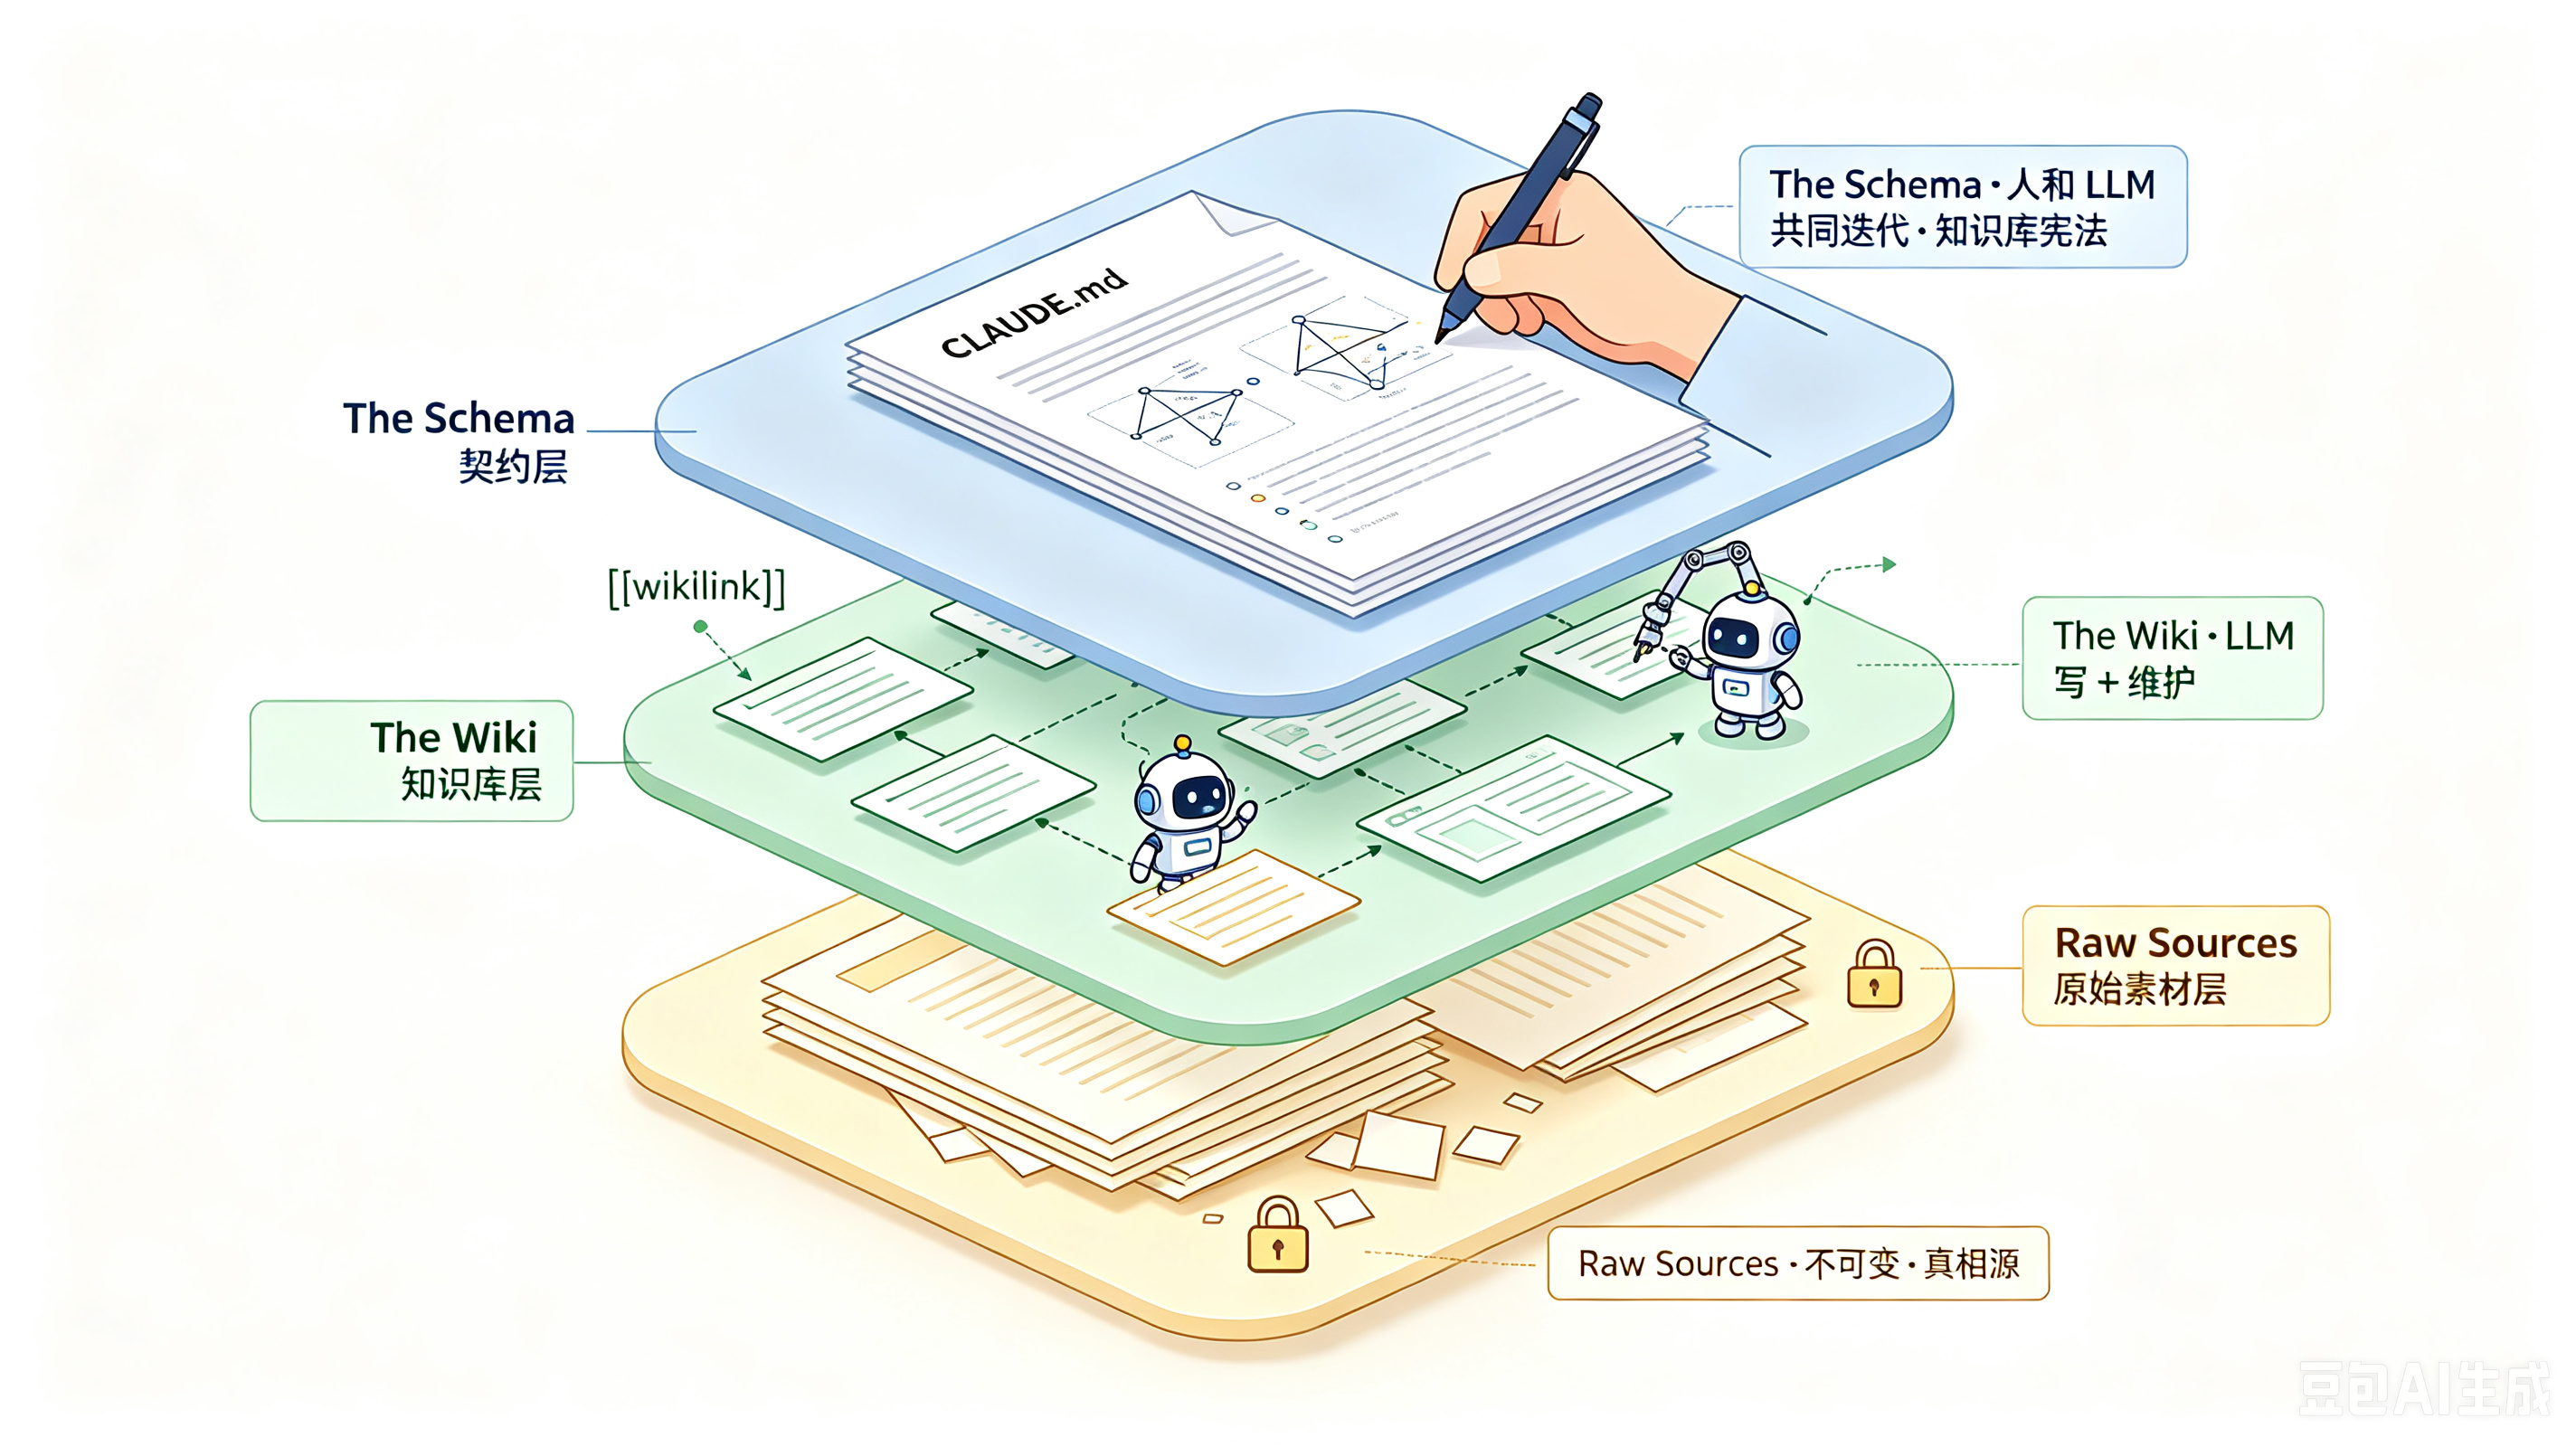
1.1 🏗️ 三层架构
-
📄 Raw sources:文章、论文、图片。LLM 只读不改——真相源
-
📝 The wiki:摘要/实体/概念/对比/综述页。LLM 全权拥有——人只读不写
-
⚙️ The schema:一份 markdown,告诉 LLM wiki 的结构、命名约定、冲突处理、何时开新页/合并页
人和 LLM 一起迭代它——本质是用自然语言写一份“知识库宪法”
1.2 ⚡ 三个核心操作
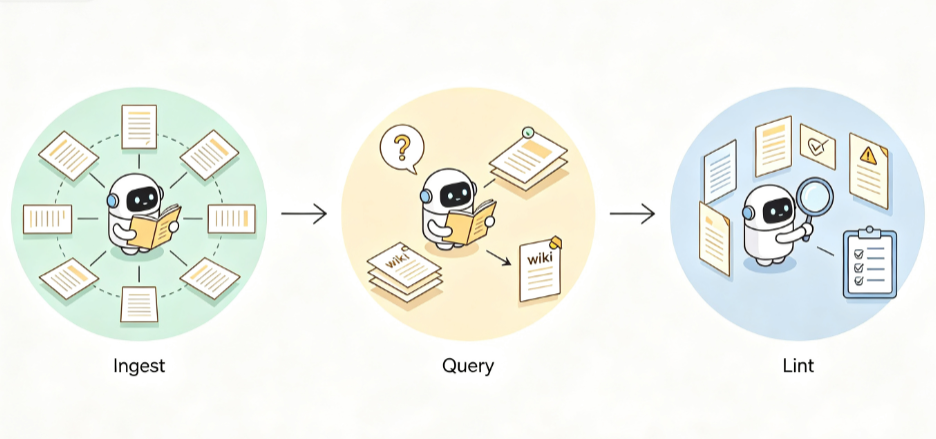
🔹 Ingest(摄入) —— 丢一份新源,LLM 做:
读源 → 讨论 key takeaways
写 summary 页
更新 index.md
触达 10–15 个相关页(实体/概念页都更新)
在 log.md 追加一条
🔹 Query(查询) —— 你问问题,LLM 做:
读 index.md 定位相关页
读这些页
综合成带引用的答案
把好答案回填进 wiki 当新页——让探索本身复利
🔹 Lint(体检) —— 定期让 LLM 健康检查:
页间矛盾、被新源推翻的旧论断、孤儿页、缺失的交叉引用、data gap。
1.3 📇 index.md:一个文件替代向量 RAG
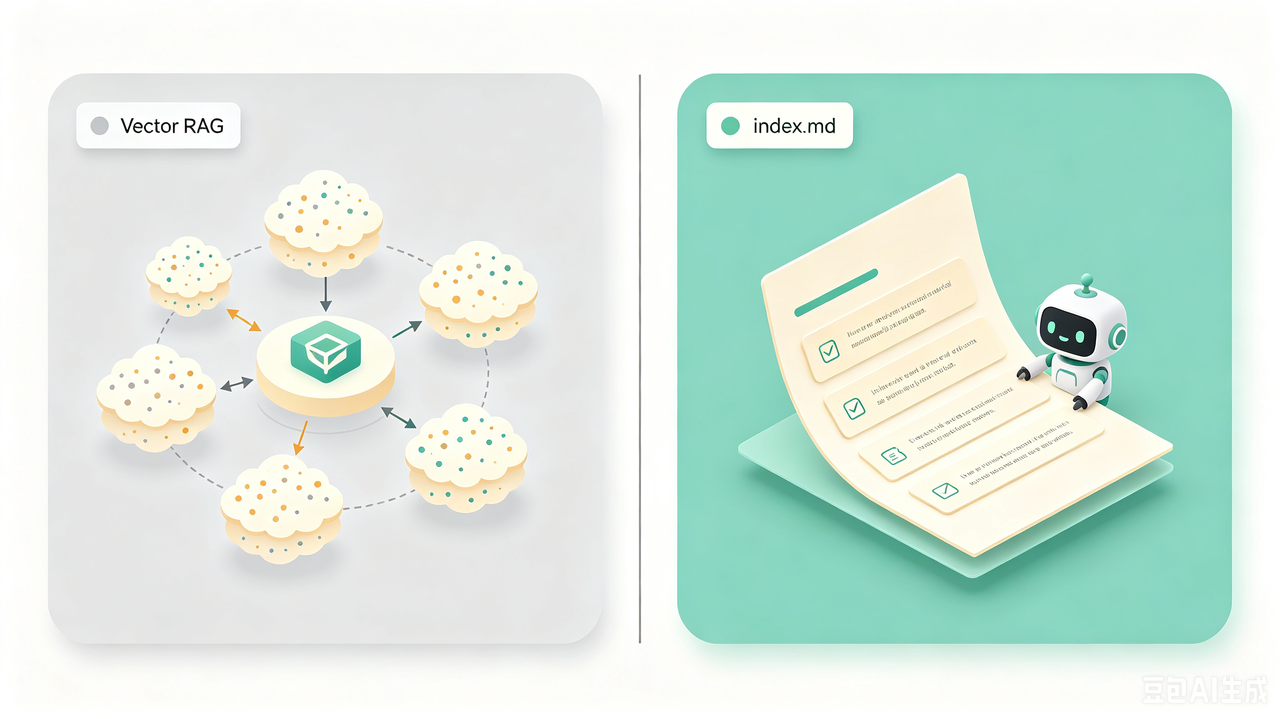
index.md 是 wiki 的目录卡片柜:每页带链接 + 一句话摘要 + metadata,按分类组织
LLM 答题前先读它定位相关页
✨ 在 ~100 源、几百页规模下,这一个文件就够替代向量 RAG 基础设施。
不需要 embedding,不需要向量库。
用 LLM 的语义理解能力替代向量相似度——小规模下前者反而更准。
一个 markdown 目录 + 一个 append‑only 日志,模拟出 mini 数据库的导航能力
🛠️ 二、两条工程落地路线
|
🤖 nashsu/llm_wiki |
🧠 garrytan/gbrain |
|
|
血统 |
显式致敬 Karpathy pattern |
独立血统,从 OpenClaw agent fork 长出来 |
|
形态 |
跨平台桌面 GUI |
CLI / daemon / MCP server |
|
目标用户 |
个人知识管理者 |
AI coding agent + 团队 |
|
后端 |
Rust + 可选 LanceDB |
TypeScript (Bun) + PGLite/Postgres+pgvector |
|
生产规模 |
个人用 |
146K 页、24K 人、5K 公司、66 cron jobs |
🖥️ llm_wiki:个人知识管理者的“自动驾驶笔记”
🎯 核心定位 把 Obsidian 变成 LLM 能自动编写、整理、交叉引用的知识库
💢 解决的痛点 你扔进去一堆文章/论文,希望 LLM 自动拆解成概念、实体,并持续维护它们之间的关联——但你仍需要保留人类的审阅权,且不信任 LLM 自由发挥时可能产生的幻觉
🧩 核心扩展(超越 Karpathy 原文的部分)
🔹 两步链式推理录入 先让 LLM 分析源材料(抽实体、概念、矛盾点、建议),再生成 wiki 页。好处是推理过程可回溯,内容更结构化
🔹 4 信号知识图谱 + 自动聚类 不只依赖 [[wikilink]],还利用直接链接、资源重合度、Adamic‑Adar 等图算法自动发现隐性关联。可以问“哪些主题被意外连在了一起?”
🔹 “仅查原始材料”模式 当你对 LLM 的总结不放心时,一键切回传统 RAG——只从原文抽取答案,不进行二次合成
⚙️ 技术形态 跨平台桌面 GUI(所见即所得的三栏布局),后端 Rust + 可选的向量数据库,面向个人
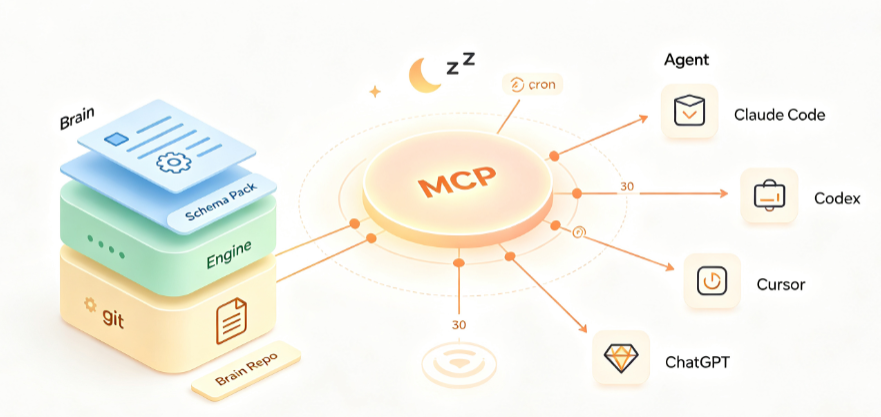
🌐 gbrain:AI Agent 和团队的“可自我演化的公司大脑”
一句话:让 agent 能像人查公司 wiki 一样,自动存取、整理、发现问题,并允许 schema 自行演化
🤔 它想解决什么?
生产环境中,Agent 跨会话会失忆,重复劳动严重。
需要一种机制,让 Agent 将对话中产生的知识持久化,且这个知识库的结构(实体类型、关系类型)能随业务自动生长,无需人类预先设计完整。
🧱 核心设计
🧩 零 LLM 调用的关系抽取
不靠 LLM 识别实体关系,而是直接匹配 [[wiki/people/bob]] 这样的链接语法,自动生成 typed edges(attended, works_at 等)
-
✅ 图随页面更新实时增长
-
✅ 无 LLM 成本、延迟和失败模式
🔌 MCP 原生接口
所有操作通过 MCP 协议暴露,Agent 用 search / think / put_page 等工具自动组装上下文,人类不再直接操作 wiki
把 Karpathy 的“人机分工”再向前推了一步:人只定规则,Agent 负责读写。
📦 可演化的 Schema 包
不再是写死一份 markdown 宪法,而是版本化、可切换的 schema 包(如 gbrain-base-v2)
-
Agent 可通过 schema suggest 提出新实体/关系类型
-
人类审核后自动纳入
-
实现 动态结构 + 动态内容
🩺 每次查询自带“诚实检查”
think 命令在每次查询时显式输出:
-
哪些页面过时了
-
哪条声明没有出处
-
哪两页相互矛盾
-
哪里有该补的洞
不等定期 lint,盲区实时暴露。
⚙️ 技术形态
CLI / 守护进程 / MCP Server TypeScript(Bun) + PGLite/Postgres + pgvector
生产规模已验证:146K 页 · 24K 人 · 5K 公司
📌 一句话选型
| 个人研究者、笔记重度用户,重视人工审阅和知识发现 | llm_wiki |
| 给 AI Agent 或团队搭建长期记忆系统,需要自动化演化、无 LLM 开销和内置诚信机制 | gbrain |
🚀 三、对 Agent 开发者的架构启示
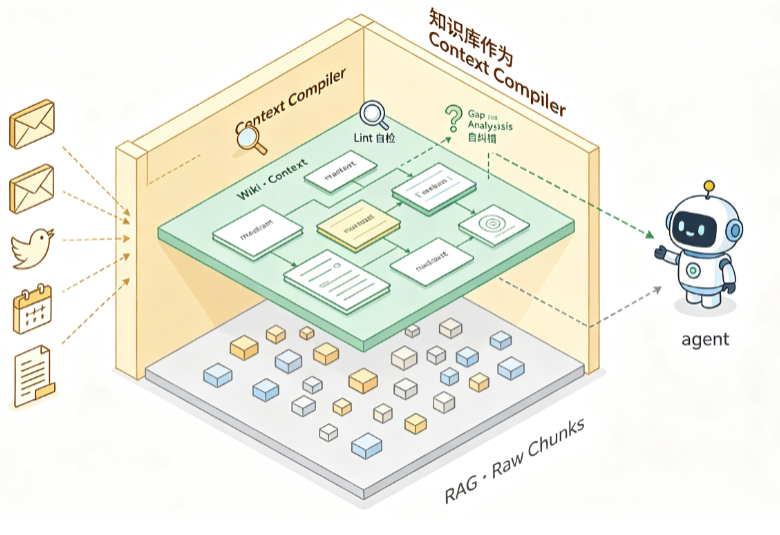
📌 知识库不做 RAG 兜底,做 Context Compiler
RAG 把 raw chunks 当“检索源”,每次 query 从头拼。
Context Compiler 则反过来:Agent 的记忆层应提前将原始信号(邮件 / 会议 / 推文 / 文档)编译成结构化的 context,每次 query 直接读取已编译好的 wiki。
-
价值跃迁:维护成本从 O(n) → O(1),知识才真正成为资产
-
未来架构:大概率走向 双层模型
-
wiki 层(综合 / 关系答案)
-
RAG 层(raw chunk 兜底)
-
🩻 Agent 记忆层:自我体检 & 自我纠错
| Lint | 让知识库不自相矛盾 | 维持内部一致性 |
| Gap Analysis | 诚实暴露盲区:“我哪里不知道” | 区别于传统 RAG 的核心优势 |
-
gbrain 的 think 命令已将这种自省能力做到了每次查询级别,而非等定期 lint 才暴露盲区,让知识进化变为实时过程


评论前必须登录!
注册