 网硕互联帮助中心
一块 1050Ti 学 AI Infra:我手搓了一个 LLM 网关,从 Redis 限流一路做到 nginx 负载均衡
4GB 显存、i5-7300HQ、11GB 内存的老笔记本,跑不动 7B 模型,更别说分布式推理。 但我用它把 AI Infra 里最常被问到的东西都做了一遍: 鉴权、限流、模型路由、SSE 流式、Prometheus/Grafana、Redis、PostgreSQL、Kafka、降级演练、 多实例部署、nginx 负载均衡、故障转移——全部有实测数据,全部能一键复现。
这篇文章不是"部署教程",而是我的实验记录:每个阶段做了什么、测出什么数字、 被哪个坑卡了多久。全文 30+ 组实测数据,都在一台 1050Ti 上跑出来的。 github: https://github.com/BumbleBee-ZDS/AI_infra_study
目录
- 0. 先说清楚:为什么用 1050Ti 学 AI Infra
- 1. 实验环境(总成本:0 元)
- 2. 这个项目是什么:一个 OpenAI 兼容的本地 LLM 网关
- 3. 学习路线:11 个阶段
- 4. 阶段 1~3:跑通、读懂主链路、流式输出
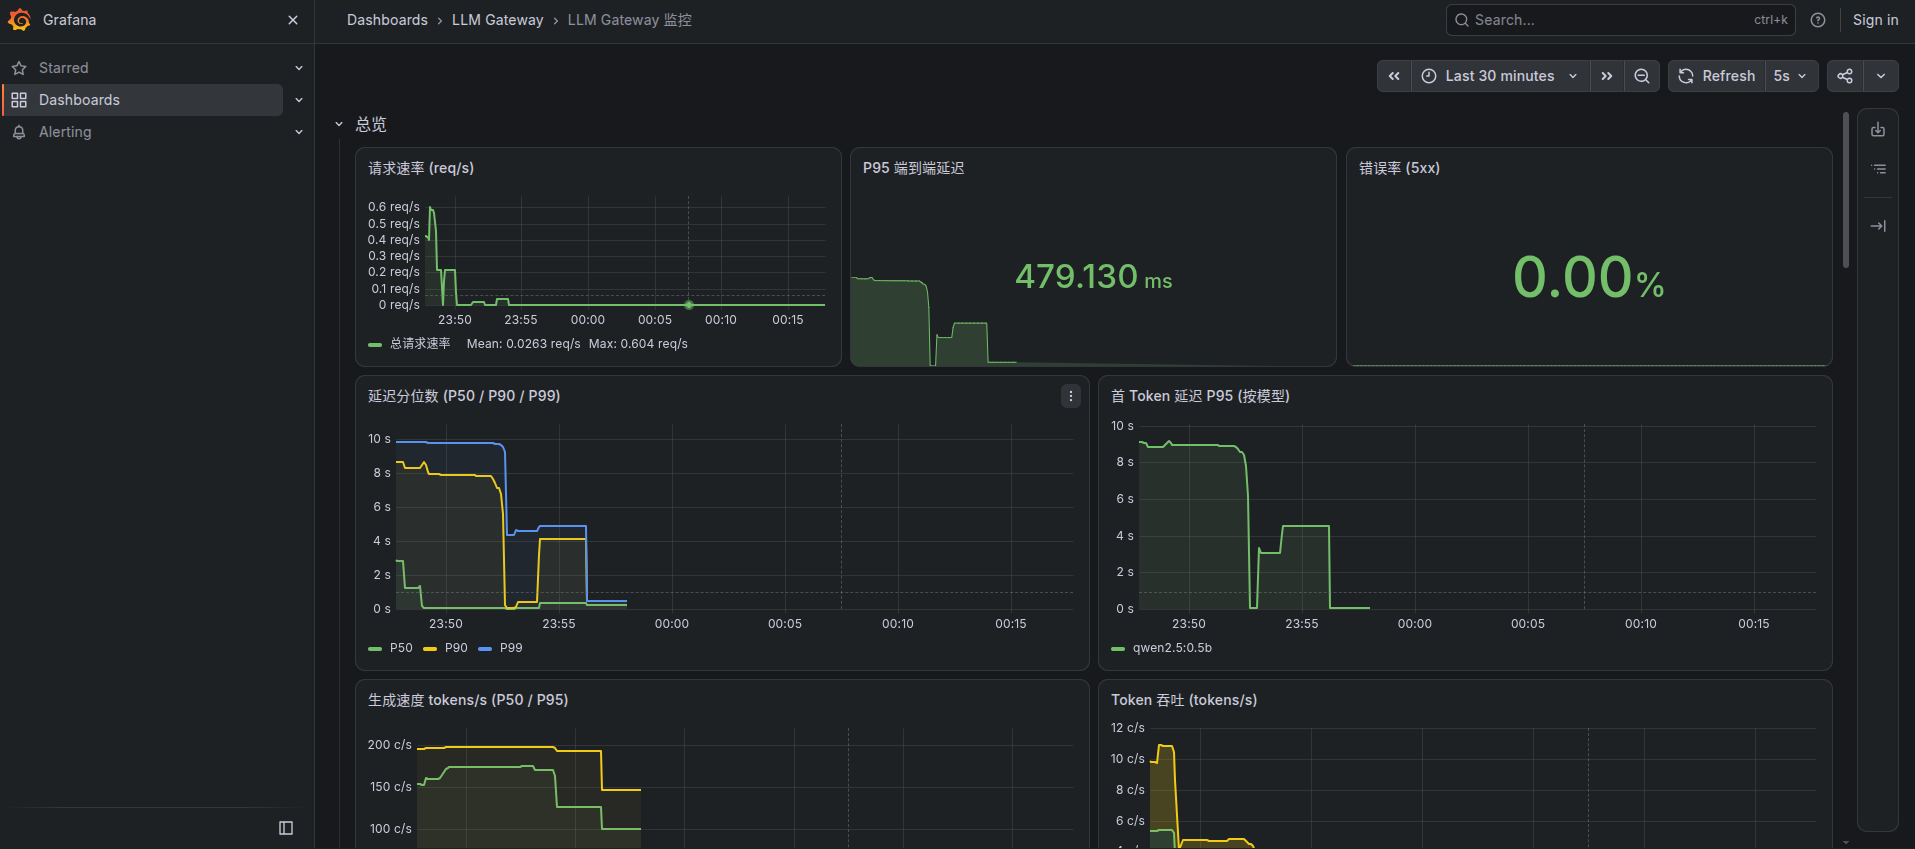
- 5. 阶段 4:可观测(Prometheus + Grafana)
- 6. 阶段 5:分布式限流——本项目的"招牌实验"
- 7. 阶段 6~7:请求历史(SQLite/PG)与 Kafka 异步事件
- 8. 阶段 8:降级演练(我认为最值钱的一章)
- 9. 阶段 9:自动化验收 + 1050Ti 参数调优实验
- 10. 阶段 11:多实例部署 + nginx 负载均衡(全文重点)
- 11. 踩坑合集:这 10 个坑,我每个都花过至少半小时
- 12. 一块 1050Ti 教会我的 5 件事
- 13. 想复现?最短路径(约一个下午)
- 14. 写在最后
0. 先说清楚:为什么用 1050Ti 学 AI Infra
我一开始也走了弯路。
刚入门 AI Infra 的时候,我以为要学的是"怎么把模型跑得更快":量化、KV cache 优化、 PagedAttention、张量并行……然后我打开 1050Ti 的 4GB 显存,发现连 qwen2.5:7b 的 量化版都装不进去。卡在一开始,很容易得出"硬件不够,学不了"的结论。
后来我想明白了一件事:真正的 AI Infra,90% 的工程量不在模型内部,而在模型外面那一圈。
把 Ollama 当成一个黑盒 HTTP 服务(事实上它确实是:POST http://localhost:11434/api/chat), 那么一个 LLM 服务上线要面对的问题,全都跟显存无关:
| 谁能调?调了多少次? | 鉴权 + 计量 | ✅ 完全能 |
| 一个用户刷爆 GPU,别人全卡死 | 限流(单机 / 分布式) | ✅ 完全能 |
| 用户等 30 秒没反应就关页面 | SSE 流式 + TTFT 观测 | ✅ 完全能 |
| 出事只知道"很慢",不知道慢在哪 | 指标、日志、链路追踪 | ✅ 完全能 |
| 上游模型换了,客户端要改代码 | 模型别名路由 | ✅ 完全能 |
| 下游 Redis / 库 / 队列挂了,服务跟着死 | 降级设计 | ✅ 完全能 |
| 单进程吃满一个核、进程崩了服务就没了 | 多实例 + 负载均衡 + 故障转移 | ✅ 完全能 |
明确一下这块卡"学不到"的东西:多卡并行、显存带宽优化的真实收益、vLLM/SGLang 那种 continuous batching 的吞吐魔法、真正的 GPU 调度(MIG/时间段共享)。这些要真卡。 但要学"AI 服务化"的完整链路,一张 1050Ti 完全够——而且因为慢,反而更容易观察到现象: 每 token 延迟被放大到几十毫秒级,一个并发上升,TTFT 从 0.03s 涨到 3.6s,肉眼可见。
所以我给自己定了个目标:手写一个 OpenAI 兼容的 LLM 网关,围绕它把上面那张表里的 每一行都亲手做一遍、测一遍,然后把整个过程写成了学习手册。
1. 实验环境(总成本:0 元)
全部在本机跑,没有任何云服务:
| CPU | Intel Core i5-7300HQ @ 2.50GHz(4 核 4 线程) |
| 内存 | 11 GiB |
| GPU | NVIDIA GTX 1050 Ti,4GB 显存,驱动 580.178.04 |
| 系统 | Ubuntu 26.04 |
| Python | 3.12.14(conda 环境 aiinfra) |
| 模型运行时 | Ollama 0.35.0 |
| 模型 | qwen2.5:0.5b(397MB) / qwen2.5:1.5b(986MB) / llama3.2:1b(1.3GB) |
| 监控 | Prometheus 3.15.0 + Grafana 13.2.3 |
| 基础设施 | Redis 8.0.5 / PostgreSQL 18.6 / Kafka(OpenJDK 25) |
| 负载均衡 | nginx 1.28.3 |
小技巧:这些组件我一个都没用 root 装。Redis/PG/Kafka/nginx/Prometheus/Grafana 全部用 apt-get download + dpkg-deb -x(或官方 tar 包)解包到 ~/opt/ 下, 用各自的配置文件指定端口与数据目录。老笔记本、没 sudo 权限、怕污染系统环境的都适用。
2. 这个项目是什么:一个 OpenAI 兼容的本地 LLM 网关
一句话:把你的请求统一收口,做「鉴权 → 限流 → 模型路由 → 转发给 Ollama → 记录指标/日志/历史/事件」,对外长得和 OpenAI 一模一样。
所以任何支持 OpenAI 协议的客户端(官方 SDK、LangChain、Cherry Studio、NextChat……) 只要把 base_url 改成 http://localhost:8000/v1 就能接上,业务代码一行不改。
2.1 架构图
┌──────────────────────────────────────────────┐
客户端 curl ───► │ FastAPI 网关 (main.py) │
│ │
│ ① 鉴权 auth.py → 失败 401 │
│ ② 限流 ratelimit.py → 超限 429 │
│ ③ 参数校验/路由 router.py → 非法 400 │
│ ④ 转发 httpx ─────────────────┐ │
│ ⑤ 记录指标/日志/历史/事件 │ │
└───────────────────────────────┼──────────────┘
▼
┌──────────────────┐
│ Ollama :11434 │
│ qwen2.5:0.5b … │
└──────────────────┘
基础设施(每一件都能独立降级,缺了也不影响推理):
② 限流计数 ──► Redis :6379 (挂了 → 进程内计数兜底)
⑤ 历史明细 ──► SQLite/PG :5433 (挂了 → 只丢历史,请求照过)
⑤ 事件流 ──► Kafka :9092 (挂了 → 降级写 logs/events.jsonl)
观测:
Prometheus :9090 ──抓取──► 网关 /metrics
Grafana :3000 ──查询──► Prometheus(5 行 / 35 个面板)
整套东西的真实端口表(后面每个实验都要用):
| 网关(单实例) | http://localhost:8000 | python main.py | logs/ |
| 网关集群入口(nginx) | http://localhost:8080 | bash scripts/cluster.sh start | ~/opt/nginx/logs |
| Ollama | http://localhost:11434 | 系统服务 ollama serve | ~/.ollama |
| Prometheus | http://localhost:9090 | bash scripts/monitoring.sh start | ~/opt/monitoring/prometheus/data |
| Grafana | http://localhost:3000 | 同上 | ~/opt/monitoring/grafana/data |
| Redis | localhost:6379 | bash scripts/infra.sh start | 无(–save '' 不落盘) |
| PostgreSQL | localhost:5433 | 同上 | ~/opt/infra/pgdata |
| Kafka | localhost:9092 | 同上 | ~/opt/infra/kafka-data |
2.2 我用到的 4 个"学习技巧"
这套项目是边学边写的,有几个让我少走弯路的小设计,值得先说:
3. 学习路线:11 个阶段
我把整个过程拆成了 11 个阶段,每个阶段都有"概念 → 动手 → 验收 → 踩坑"四段:
| 1 | 环境准备与跑通第一条请求 | curl 拿到 200,日志有记录 |
| 2 | 读懂主链路 main.py | 能画出 5 步流程,能触发 4 种错误码 |
| 3 | 流式 SSE 与首 token 延迟 | curl -N 看到逐字输出 + [DONE] |
| 4 | 指标与监控(Prometheus + Grafana) | /metrics 有数据,看板有曲线 |
| 5 | 分布式限流(Redis) | 两实例共享 10 次额度,合计只放行 10 |
| 6 | 请求历史(SQLite / PG) | /history 查到自己的请求,会直接查库 |
| 7 | Kafka 异步事件 | 命令行消费者能看到 4 类事件 |
| 8 | 降级演练 | 逐个 kill 服务,请求仍然 200 |
| 9 | 自动化验收、压测、参数调优 | 21/21 通过 + 一张参数扫描表 |
| 10 | 12 道进阶动手题 | 自己动手做 3 个以上 |
| 11 | 多实例 + nginx 负载均衡 | 杀掉一个实例,请求仍全部 200 |
下面按阶段讲我做了什么、测出了什么。
4. 阶段 1~3:跑通、读懂主链路、流式输出
4.1 第一条请求
python main.py # 默认 0.0.0.0:8000
启动日志会直接告诉你"当前生效的后端是谁"——这个设计很重要,多实例排障时一眼就能看出 某个实例是不是偷偷降级了:
限流后端: Redis(redis://localhost:6379/0,窗口 60s,多实例共享计数)
请求历史: postgresql://gw:***@localhost:5433/gateway(批量 20 行 / 1.0s)
事件总线: Kafka localhost:9092 -> topic llm-gateway-events
Uvicorn running on http://0.0.0.0:8000
发第一条请求:
curl -s -X POST http://localhost:8000/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"用一句话说明什么是TTFT"}],"options":{"num_predict":40}}'
{
"id": "chatcmpl-1791388386659",
"object": "chat.completion",
"model": "qwen2.5:0.5b",
"usage": {"prompt_tokens": 35, "completion_tokens": 32, "total_tokens": 67},
"choices": [{
"index": 0,
"message": {"role": "assistant",
"content": "TTFT是TaiShan Cloud BigData高性能计算集群平台,提供强大的计算能力、高可用性、可扩展性及自动化运维能力。"},
"finish_reason": "stop"
}]
}
顺便说个实话:0.5B 模型答得离谱(TTFT 明明是 Time To First Token)。 我用它做实验是因为它快、只占 397MB 显存,参数扫描跑 13 组不心疼。 想要回答质量就换 qwen1.5b 或 llama1b——把 "model" 换成别名即可, 网关会映射到真实的 Ollama 模型名(这就是"模型路由"):
| qwen0.5b | qwen2.5:0.5b |
| qwen1.5b | qwen2.5:1.5b |
| llama1b | llama3.2:1b |
4.2 一次请求的 5 步链路(这是网关的骨架)
读 main.py 时我建议只抓这 5 步:
① 鉴权:x-api-key → tier(free / pro)
② 限流:Redis 固定窗口计数(Lua 原子操作),超限 → 429
③ 解析与路由:options 白名单校验(防注入)→ 模型别名映射
④ 转发:httpx 打 Ollama /api/chat;流式则转成 OpenAI SSE
⑤ 留痕:一条记录同时写三处 —— JSONL 日志 + 历史库 + Kafka 事件
第 ⑤ 步是我觉得最值得抄的设计,它只有 3 行:
def _persist(record: dict, event: str = "request.completed") –> None:
"""一条请求记录同时落三处:JSONL 文件日志 + 历史库 + Kafka 事件。
三处都是「尽力而为」:history.submit / events.publish 只做入队,
队列满或后端不可用都只计数不抛错,绝不反压推理主链路。
"""
log_request(record)
history.submit(record)
events.publish(event, record)
关键在最后那句注释:所有留痕动作都只"投递",不等待、不抛异常。 这就是第 8 节降级演练能成功的根本原因。
4.3 亲手触发 4 种错误码
光看代码记不住,我用一张表把 4 个错误码都打出来(对后面排障帮助极大):
| 不带 x-api-key | 401 | 鉴权层 |
| 同一个 key 短时间内超过配额 | 429 | 限流层 |
| "options": {"num_ctx": 999999} | 400 | 参数校验(超出白名单范围) |
| 把 Ollama 停掉再请求 | 502 | 上游转发层 |
4.4 SSE 流式:为什么它是 LLM 服务的"体验命门"
非流式要等整段生成完才返回;流式(Server-Sent Events)则是一个 token 一个 data: 分片:
curl -s -N -X POST http://localhost:8000/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","stream":true,"messages":[{"role":"user","content":"数到五"}],"options":{"num_predict":20}}'
data: {"id": "chatcmpl-1791388386688", "object": "chat.completion.chunk", "choices": [{"index": 0, "delta": {"content": "好的"}, "finish_reason": null}]}
data: {"id": "chatcmpl-1791388386688", "object": "chat.completion.chunk", "choices": [{"index": 0, "delta": {"content": ","}, "finish_reason": null}]}
…
data: [DONE]
从此我脑子里多了一个指标:TTFT(Time To First Token,首 token 延迟)。 对用户体感而言,TTFT 比"总耗时"重要得多——0.5s 出第一个字,用户觉得很快; 10s 才出第一个字,用户早关页面了,哪怕后面只花 2s。
所以网关自己给每一次请求都算了 TTFT 与 TPS,并落进日志、历史库、Prometheus:
{
"api_key": "sk-test-001", "tier": "free", "model": "qwen2.5:0.5b",
"status": 200, "wall_time": 0.057, "stream": false,
"instance": "gateway-8000",
"ttft": 0.012, "tps": 130.56,
"prompt_tokens": 30, "completion_tokens": 4,
"gpu_util": 0, "gpu_mem_mb": 472,
"time": "2026-10-06T00:34:03"
}
5. 阶段 4:可观测(Prometheus + Grafana),把"黑盒"变成"仪表盘"
5.1 网关暴露了什么
curl -s localhost:8000/metrics | grep '^gateway_'
gateway_requests_total{model="qwen2.5:0.5b",status="200",stream="false",tier="pro"} 5.0
gateway_requests_total{model="unknown",status="401",stream="false",tier="unknown"} 427.0
gateway_request_duration_seconds_bucket{le="1.0",model="qwen2.5:0.5b",tier="pro"} 1.0
gateway_request_duration_seconds_bucket{le="2.0",model="qwen2.5:0.5b",tier="pro"} 4.0
…
我在这里第一次真正分清了三类指标(分清之后就不会乱用了):
| Counter(只增) | gateway_requests_total | 一共处理了多少请求?错误率多少? |
| Gauge(可增可减) | gateway_inflight_requests、GPU 利用率 | 现在有几个请求在处理? |
| Histogram(直方图) | gateway_request_duration_seconds | P50/P95/P99 延迟是多少? |
5.2 三条我天天用的 PromQL
# 每秒请求数(按状态码)
sum(rate(gateway_requests_total[1m])) by (status)
# 正在处理中的请求数(看排队情况)
gateway_inflight_requests
# P95 延迟(用直方图算分位数)
histogram_quantile(0.95, sum(rate(gateway_request_duration_seconds_bucket[5m])) by (le))
5.3 看板:5 行 35 个面板
仪表盘按"我会怎么排障"分行,而不是按指标名字排:
总览
路由、限流与错误
GPU 与进程资源
Ollama 参数调优 (num_ctx / num_gpu / num_batch)
分布式基础设施 (Redis 限流 / SQLite·Postgres 历史 / Kafka 事件)
启动只要两条命令:
bash scripts/install_monitoring.sh # 下载 Prometheus + Grafana(免 root)
bash scripts/monitoring.sh start # 起服务,自动配数据源与看板
# Prometheus: http://localhost:9090/targets Grafana: http://localhost:3000/d/llm-gateway
Prometheus 每 5 秒抓一次 /metrics;GPU 利用率与显存则是网关卡每 5 秒调一次 nvidia-smi 记下来的 (1050Ti 不支持 DCGM 那套,nvidia-smi 是唯一选择,够用)。
这里埋了后面第 10 节的一个大坑:多实例部署时,/metrics 必须直连每个实例去抓, 不能走负载均衡——否则所有实例的样本 instance 标签都会变成 nginx 的地址,曲线全糊在一起。
6. 阶段 5:分布式限流——本项目的"招牌实验"
6.1 为什么单机限流不够
我一开始的限流是纯内存字典:每个 key 每分钟最多 N 次。 单实例没问题,一旦起两个实例就废了——用户在每个实例各拿一份额度,总额度被放大成 2 倍。 所以限流状态必须外置到 Redis,两个进程共享同一个计数器:
客户端 A ──┐
├─► 网关实例 :8000 ──┐
客户端 B ──┘ ├─► Redis(固定窗口 + Lua 原子计数)
┌─► 网关实例 :8001 ──┘
客户端 C ──┘
计数用 Lua 脚本实现"读-判断-自增-首次设置过期"的原子操作,避免并发竞态。
6.2 招牌实验:两台实例共享 10 次额度
free 档配额 10 次/分钟。同时起两个实例,用同一个 key 各发 6 次:
# redis 模式:先清空计数
redis-cli -p 6379 FLUSHDB
for i in $(seq 1 6); do hit 8000; done # 实例 A
for i in $(seq 1 6); do hit 8001; done # 实例 B
实测结果(redis 模式):
200 200 200 200 200 200 <- 实例A(6 次全过,Redis 计数到 6)
200 200 200 200 429 429 <- 实例B(全局只剩 4 个名额,后 2 次被拒)
↑ 合计放行 10 次 = 配额
反证(这一步最重要):把两个实例都改成 RATE_LIMIT_BACKEND=memory 重跑:
200 200 200 200 200 200 <- 实例A(自己数到 6)
200 200 200 200 200 200 <- 实例B(自己数到 6)
↑ 合计 12 次,额度被放大 → 只能单实例用
一个 10、一个 12,这才叫"证明了共享确实生效",而不是"数字碰巧对上了"。
6.3 我实测的响应头与 Redis key
curl -sD – -o /dev/null -X POST http://localhost:8080/v1/chat/completions \\
-H 'X-API-Key: sk-test-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"hi"}],"options":{"num_predict":2}}'
HTTP/1.1 200 OK
x-ratelimit-limit: 10
x-ratelimit-remaining: 9
x-ratelimit-reset: 60
x-gateway-instance: gateway-8000 ← 多实例时用来确认落在哪个实例
redis-cli -p 6379 KEYS 'gw:rl:*'
# gw:rl:free:sk-test-001:29856467 ← 窗口号 = epoch 分钟,天然带过期语义
6.4 fail-open 还是 fail-closed?(一个真实的工程取舍)
| auto + REDIS_FAIL_OPEN=1(我用的默认) | 该实例切进程内计数,请求继续放行 | 可用性优先 |
| redis + REDIS_FAIL_OPEN=0 | 每个请求直接 429 | 配额/成本优先(按量计费的对外 API) |
| memory | 永远用进程内计数 | 单实例部署 / 做对照实验 |
我的选择理由:限流是保护措施,不是业务功能。 如果因为它挂掉就把所有推理请求全拒了,等于"为了防洪水把水龙头全关了"。 这个取舍后来在第 8 节被验证是对的。
7. 阶段 6~7:请求历史(SQLite/PG)与 Kafka 异步事件
7.1 为什么不只用日志文件
一开始我只写 logs/gateway.log(一行一个 JSON)。问题很快就来了:
- 我想知道"过去一小时 P95 TTFT 是多少"——难道要 grep + awk 算一遍?
- 我想知道"哪个 key 用得最多"——日志里搜得眼睛疼。
所以加了一个历史层:每次请求一条结构化记录入库,同时提供 /history 和 /history/stats 两个查询端点。默认 SQLite(零依赖,本地文件),设了 DATABASE_URL=postgresql://… 就切到 PostgreSQL,代码一行不用改。
写路径是异步批量的,这是我第一次认真做"写放大"的优化:
请求线程:record → 入队(不阻塞,队列满就丢弃并计数)
后台任务:攒够 20 行 或 等满 1.0 秒 → 一次批量 INSERT
请求高峰期如果每条记录都同步写库,光是 fsync 就能把延迟拖垮。批量之后写库完全在旁路。
/infra 端点(我排障时最常打开的一个)能看到队列积压和实际生效的后端:
{
"instance": "gateway-8000",
"rate_limit": {"mode": "auto", "active": "redis", "redis_up": true,
"window_seconds": 60, "fail_open": true, "error": ""},
"history": {"enabled": true, "backend": "sqlite", "queued": 0, "written": 4322,
"batch_size": 20, "flush_interval": 1.0, "error": ""},
"events": {"enabled": true, "connected": true, "topic": "llm-gateway-events",
"queued": 0, "published": 4322, "failed": 0,
"fallback_written": 0, "dropped": 0, "error": ""}
}
聚合查询也是现成的:
curl -s 'localhost:8000/history/stats'
{
"window_seconds": 3600,
"totals": {"requests": 6507, "avg_wall_time": 1.97, "avg_ttft": 0.983,
"avg_tps": 140.93, "p95_wall_time": 6.244, "p95_ttft": 5.69}
}
为什么 P95 和平均值差这么多?因为我把参数扫描、并发压测的数据也算进去了, 里面混着"冷启动 2.1s"和"8 并发排队"的样本。这也提醒我:做性能结论前一定要先看分布, 平均值会骗人。
历史表里还专门存了 num_ctx / num_gpu / num_batch 三个参数标签, 这样"同一条 prompt 在不同参数下 TTFT 是多少"可以按标签分组查——第 9 节的调优表就是这么来的。
7.2 Kafka:为什么还要一条"事件流"
数据库是"事后查",Kafka 是"实时推"。我把请求生命周期做成 4 类事件:
request.completed 请求成功
request.rate_limited 被限流
request.auth_failed 鉴权失败
request.error 上游/请求错误
这样就能接出很多玩法:实时计费、异常告警、用量看板、把请求明细同步到数据仓库…… 而且网关不需要知道下游是谁,只负责往 topic 里丢事件,彻底解耦。
事件信封长这样(instance 字段是多实例排障的关键):
{"event": "request.completed", "ts": 1791041576.094, "ts_iso": "2026-10-03T23:32:56",
"instance": "gateway-degrade", "host": "dawson-RESCUER-R720-15IKBN",
"data": {"api_key": "sk-prod-001", "tier": "pro", "model": "qwen2.5:0.5b",
"status": 200, "wall_time": 2.893, "ttft": 2.832, "tps": 113.19,
"instance": "gateway-degrade", "gpu_mem_mb": 12},
"fallback_reason": "UnknownTopicOrPartitionError: [Error3] UnknownTopicOrPartitionError"}
注意最后那个 fallback_reason:这条事件其实是降级落盘的产物 (Kafka 里还没有那个 topic,投递失败 → 写了本地 logs/events.jsonl)。 我特意把失败原因也写进去,就是为了第二天排障时不用猜。
8. 阶段 8:降级演练(我认为最值钱的一章)
前面所有模块都写了"尽力而为",但没演练过就不算会。所以我做了一轮"逐个打挂":
| 打挂 Kafka | 停 broker | ✅ 全部 200 | 事件改写 logs/events.jsonl,/infra 里 connected:false、fallback_written 增长 |
| 恢复 Kafka | 重启 broker | ✅ | 约 10 秒内自动重连,published 继续增长 |
| 打挂 Redis | kill $(cat redis.pid) | ✅ 全部 200 | /health 的 rate_limit_backend 从 redis 变 memory;gateway_ratelimit_backend_up 0 |
| 恢复 Redis | 重启 | ✅ | 5 秒内自动切回 redis,额度重新全局共享 |
| 打挂 PostgreSQL | pg_ctl stop | ✅ 全部 200 | gateway_history_up 0、gateway_history_write_errors_total 增长,只丢历史 |
其中"打挂 Redis 后连发 12 次"这个实验最直观:
200 200 200 200 200 200 200 200 200 200 429 429
↑ 限流仍然生效,只是额度不再全局共享
降级 ≠ 失效。Redis 没了,限流退化成"单实例限流",仍然在保护 GPU; 如果当初选了 fail-closed,这里就会变成 12 个 429,用户直接骂人。
还有一个小细节我挺得意:历史库写失败后不需要重启网关。 代码在写失败时会把坏连接关掉,下一批 INSERT 会用新连接重试,所以 PG 恢复后自动续上。
这章让我建立了整套项目的核心原则:
观测是增强,不是依赖;推理主链路永远优先。
9. 阶段 9:自动化验收 + 1050Ti 参数调优实验
9.1 一键验收:21 项 + 34 项
手动点 30 次 curl 太蠢,所以我写了两个验收脚本:
python verify_infra.py # 基础设施 21 项(要不要 Redis/PG/Kafka)
python verify_cluster.py # 多实例 + nginx 34 项
verify_infra.py 会自己拉起两个网关实例,把"共享限流 / 双后端历史 / Kafka 四类事件 / 降级行为"全跑一遍,最后打印 21/21 项通过; verify_cluster.py 会临时在 :8100~8102 起 3 个实例 + 一个独立端口的 nginx(不打扰你正在跑的 8080), 把负载均衡、SSE、故障转移全验一遍。
这是我的第一次"基础设施即代码"体验:把"我以为是对的"变成"脚本证明是对的"。
9.2 参数调优实验:13 组配置扫出一张表
这是我觉得最好玩、也最有收获的一步。写了个 tuning_experiment.py, 通过网关对 Ollama 的三个关键参数做受控扫描:
- num_ctx:上下文窗口大小(决定 KV cache 占多少显存)
- num_gpu:多少层放到 GPU(1050Ti 只有 4GB,放不下就得往 CPU 丢)
- num_batch:批处理大小(prompt 处理阶段的并行度)
实验设计很讲究:固定 208 token 的英文 prompt、num_predict=64、temperature=0, 每组先跑 1 次 warmup(冷加载,不计入统计)再测 3 次,同时记录端到端 TTFT、 网关内部 TTFT、tokens/s 和显存。总共 52 个请求,全部跑完约 109 秒。
实测结果(qwen2.5:0.5b,GTX 1050 Ti 4GB):
| num_ctx=512 | 0.014 | 192.88 | 472 |
| num_ctx=1024 | 0.017 | 184.29 | 478 |
| num_ctx=2048 | 0.022 | 182.04 | 490 |
| num_ctx=4096 | 0.013 | 183.92 | 516 |
| num_ctx=8192 | 0.014 | 171.66 | 568 |
| num_gpu=0(纯 CPU) | 0.079 | 71.17 | 2 |
| num_gpu=12(24 层里的 12 层) | 0.024 | 90.54 | 354 |
| num_gpu=-1(全量 GPU) | 0.016 | 176.27 | 490 |
| num_batch=64 | 0.013 | 187.96 | 460 |
| num_batch=128 | 0.013 | 178.25 | 464 |
| num_batch=256 | 0.014 | 169.80 | 472 |
| num_batch=512 | 0.015 | 186.14 | 490 |
| num_batch=1024 | 0.014 | 192.78 | 526 |
我读出来的三条结论:
还有一个"反常识"的坑:num_ctx / num_gpu / num_batch 任意一个变化, Ollama 都会重载模型(冷启动 TTFT ≈ 2.1s)。如果你在流量高峰期动态换参, 用户会看到"突然卡 2 秒"。而且 Ollama 0.35 有个 bug:从显式 num_gpu=0/12 切回 -1 时 它判定"配置没变",不换 runner——我的脚本只能先用 keep_alive=0 强制卸载来规避。
说实话,这张表本身对生产没什么指导意义(0.5B 模型谁也不会拿去上线), 但**"怎么做一次可信的性能实验"这套方法论**很值钱: 固定变量、先 warmup、多轮取均值、记录环境、剔除异常样本、永远看分布不看单个数字。
这一行 JSON 是我后来所有优化决策的依据:没有 TTFT,你根本不知道慢在哪。
10. 阶段 11:多实例部署 + nginx 负载均衡(全文重点)
前面 10 个阶段都在解决"一个进程怎么把事做对"。这一阶段回答另一个问题: 一个进程崩了怎么办?一个核不够用了怎么办?
10.1 为什么"多起一个进程"就算扩容
这是我这阶段最大的认知收获。能水平扩容的前提是:网关进程本身是无状态的。
回头看一遍前面的设计,会发现我把所有状态都搬走了:
| 限流计数 | Redis | 计数不丢,新实例接着数 |
| 请求历史 | SQLite / PostgreSQL | 记录不丢 |
| 事件缓冲 | Kafka | 事件不丢 |
| 配置 | 环境变量(端口 / 实例名 / 后端地址) | 新进程换个端口就是新实例 |
网关自己只剩纯计算,于是"扩容"退化成一件很朴素的事:再起一个进程,换个端口,把它加进负载均衡的上游列表。
bash scripts/nginx.sh install # 首次:免 root 解包 nginx 到 ~/opt/nginx
bash scripts/cluster.sh start # 起 3 个实例(8000/8001/8002) + nginx 入口 :8080
脚本跑完会直接打印分发验证,我第一次看到这个输出的时候还挺激动:
— 负载均衡入口 —
nginx lb ok
— 经 LB 请求 6 次的实例分布 —
#1 -> gateway-8000
#2 -> gateway-8001
#3 -> gateway-8002
#4 -> gateway-8000
#5 -> gateway-8001
#6 -> gateway-8002
— 日志 —
访问日志: /home/dawson/opt/nginx/logs/nginx-access.log
错误日志: /home/dawson/opt/nginx/logs/nginx-error.log
10.2 验证分发:12 次请求,3 个实例各 4 次
python3 – <<'PY'
import requests
for i in range(12):
r = requests.get("http://localhost:8080/health")
print(r.json()["instance"]) # 经 LB 的 /health 会告诉你落点
PY
实测分布:{gateway-8000: 4, gateway-8001: 4, gateway-8002: 4}(12 次均分)。
聊天接口则可以直接看响应头(/health 没有这个头,它的 instance 在 JSON body 里):
curl -sD – -o /dev/null -X POST http://localhost:8080/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"hi"}],"options":{"num_predict":2}}' \\
| grep -i x-gateway-instance
# x-gateway-instance: gateway-8000
同一时间在 Prometheus 里查 sum(gateway_requests_total) by (instance), 能看到 3 条独立曲线——每个实例的指标是分开的,这是多实例观测的前提。
10.3 nginx 配置:每一行为什么必须写
这份配置我改了很多轮才稳定,下面是最关键的几条(完整模板在 nginx/nginx.conf.tpl):
upstream llm_gateway {
zone llm_gateway 64k; # 多 worker 共享健康状态与连接数(least_conn 依赖它)
least_conn; # 按"当前连接数最少"分发:LLM 单请求耗时长,
# 轮询容易把新请求丢给"已经压着几个慢请求"的实例
server 127.0.0.1:8000 max_fails=2 fail_timeout=10s;
server 127.0.0.1:8001 max_fails=2 fail_timeout=10s;
server 127.0.0.1:8002 max_fails=2 fail_timeout=10s;
keepalive 32; # 与上游保持 32 个空闲长连接,省掉握手开销
}
location / {
proxy_pass http://llm_gateway;
proxy_http_version 1.1; # ← 这三行齐写才能与上游复用长连接
proxy_set_header Connection "";
# —— 流式(SSE)三件套:不缓冲、不缓存、不攒请求体 ——
proxy_buffering off; # ★ 最关键的一行,开着的话"逐字输出"会变成"几秒后一次性吐出"
proxy_cache off;
proxy_request_buffering off;
proxy_connect_timeout 2s; # 死实例快速失败,交给下一个上游
proxy_read_timeout 300s; # 默认 60s 会把长回答掐断
proxy_send_timeout 300s;
send_timeout 300s;
proxy_next_upstream error timeout; # 只在"连接阶段"失败时换机
proxy_next_upstream_tries 2;
}
另外两个"教学式"细节:
# LB 自身健康检查(不转发给网关,nginx 活着就能回 200)
location = /lb-health { access_log off; return 200 "nginx lb ok\\n"; }
# /metrics 必须直连每个实例抓:走 LB 的话 Prometheus 分不清是哪个实例的指标,这里显式拒绝
location = /metrics { return 404 "metrics must be scraped per-instance directly\\n"; }
关于 proxy_next_upstream 我要特别说一句:POST 是非幂等请求, nginx 默认不会把"已经发出去的请求"重试到下一个上游——这正是我们想要的, 否则用户提一个问题,可能两个实例各生成一遍(烧两倍算力)。 这里只允许"连接阶段就失败"的换机,我专门验证过:故障转移期间没有出现重复生成。
顺便记录一个我自己 review 出来的低级错误:文档里写了"用 least_conn 按连接数分发", 但模板里其实漏了 least_conn; 这一行,实际跑的是默认轮询。 我是写这篇文章时逐行对照配置才发现的,加上并 reload 之后仍然是 4/4/4 均分 (轻请求下两种策略差别不大,但长请求场景 least_conn 才更稳)。 教训:文档说的和配置写的必须一致,而唯一的验证方式是"去看真正生效的配置"。
10.4 流式(SSE)到底有没有被"憋住"?——本章最重要的一次测量
负载均衡最容易踩的坑就是:本地直连好好的逐字输出,接上 nginx 之后变成"转圈几秒然后刷出全文"。 原因就是 proxy_buffering on 会等缓冲攒满才下发。
我用"首字节时间 vs 总时长"做判据:如果被缓冲,首字节会接近总时长(比例≈100%)。
# 经 LB(-N 关闭 curl 自己的缓冲)
curl -s -N -o /dev/null -w '[LB] ttfb=%{time_starttransfer}s total=%{time_total}s\\n' \\
-X POST http://localhost:8080/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"数到二十"}],"stream":true,"options":{"num_predict":64}}'
# 直连实例(绕开 nginx)
curl -s -N -o /dev/null -w '[直连] ttfb=%{time_starttransfer}s total=%{time_total}s\\n' \\
-X POST http://localhost:8000/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"数到二十"}],"stream":true,"options":{"num_predict":64}}'
实测(verify_cluster.py 里同一项检查的输出):
经 LB : 首字节 0.041s / 总时长 0.710s ← 首字节只占 6%
直连实例: 首字节 0.094s / 总时长 0.346s
首字节远早于总时长(6%),说明 nginx 没有额外缓冲。
我在这里被坑过一次:有一次对比测出来经 LB 的首字节要 1.9 秒, 我第一反应是"nginx 缓冲没关干净",查了半天配置都没问题。 后来发现是两次对比请求的 num_ctx 不一样——Ollama 换参会重载模型(冷启动 ≈2.1s), 那 1.9 秒是模型重载时间,跟 nginx 一点关系都没有。 教训:对比实验的参数必须完全一致,否则你测的是别的东西。
10.5 故障转移:杀掉一个实例,客户端毫无感知
这是最能体现"负载均衡值不值"的一步。我直接 kill 掉 8000 这个实例:
kill "$(cat logs/cluster/run/gateway-8000.pid)"
# 然后经 LB 连打 12 次
for i in $(seq 1 12); do curl -s -o /dev/null -w '%{http_code} ' http://localhost:8080/health; done
实测结果:
200 200 200 200 200 200 200 200 200 200 200 200 ← 12 次全部成功
客户端完全看不到故障,但 nginx 的日志里留下了完整证据:
{"uri":"/health","status":200,"request_time":0.03,
"upstream_addr":"127.0.0.1:8000, 127.0.0.1:8101", ← 先试 8000(死了),自动换到 8101
"upstream_status":"502, 200"} ← 第一次 502,换机后 200
nginx-error.log:
[error] connect() failed (111: Connection refused) while connecting to upstream …
[error] upstream server temporarily disabled while connecting to upstream
| 客户端看到的 HTTP 状态 | 12 次全部 200(换机对客户端透明) |
| 响应里的实例名 | 只剩存活的两个实例 |
| 摘除是否生效 | 后续 8 次请求的访问日志里没有任何换机痕迹(不再去连死实例) |
| 实例恢复 | 重新拉起后 fail_timeout=10s 内自动加回上游,无需改配置或 reload |
这就是 max_fails=2 / fail_timeout=10s 的被动健康检查:不需要额外部署一个健康探测服务, 代价是"故障刚开始的 1~2 个请求要靠换机重试顶住"。对 LLM 服务来说这个代价可以接受—— 一次推理本来就要好几秒,而主动健康检查还得自己写。
10.6 跨实例共享限流(经 LB 的版本)
同样的"招牌实验",这次经 LB 打(3 个实例共享 free 档 10 次额度):
redis-cli -p 6379 FLUSHDB
for i in $(seq 1 12); do
curl -s -o /dev/null -w '%{http_code} ' -X POST http://localhost:8080/v1/chat/completions \\
-H 'Content-Type: application/json' -H 'x-api-key: sk-test-001' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"hi"}],"options":{"num_predict":2}}'
done
连跑两轮,结果完全一致:
round 1 经 LB 12 次: 200 200 200 200 200 200 200 200 200 200 429 429
round 2 经 LB 12 次: 200 200 200 200 200 200 200 200 200 200 429 429
3 个实例、12 次请求,只有 10 次被放行——额度确实是全局的。 再加一个反证:上面这 10 次额度用光后,直连任意一个实例也是 12 个 429:
429 429 429 429 429 429 429 429 429 429 429 429 ← 直连 :8000,额度已被全局用完
10.7 扩缩容:顺序不一样,理由很实际
bash scripts/cluster.sh scale 5 # 扩到 5 个(热加载 nginx,不断连接)
bash scripts/cluster.sh scale 3 # 缩回 3 个
| 扩容 | 先起新实例 → 再 reload nginx | 新实例没就绪就被加进上游,会白挨几次失败(max_fails 能兜住但没必要) |
| 缩容 | 先改上游并 reload → 再停实例 | 反过来的话,请求还在往要停的实例上打,会出现 502 |
这里还踩了个脚本层的坑:每次执行脚本都是新进程,环境变量记不住"现在有哪几个实例在跑", 所以 scale 一开始按环境变量算,缩容时推不出实例列表,干脆不停实例。 后来改成按 pid 文件反推当前在跑的端口(running_ports()),才真正做到扩容/缩容都幂等。
10.8 我自己加的两个实验:负载均衡到底带来了多少收益?
文档里的验收项只能证明"它能用",但我更想知道它值多少。 于是我又做了两组实验(这部分是我自己加的,不在最初的学习路线里)。
实验 A:单卡并发会不会把 TTFT 拖垮?
经 LB 发起 1/2/4/8 并发(stream=true,num_predict=128,先做一次 warmup 把模型加载进显存):
| 1 | 0.03s | 0.03s | 1.04s | 1.04s | {8000:1} |
| 2 | 0.57s | 1.09s | 1.59s | 2.12s | {8000:1, 8002:1} |
| 4 | 1.63s | 3.25s | 2.68s | 4.30s | {8000:1, 8001:2, 8002:1} |
| 8 | 3.62s | 7.26s | 4.62s | 8.26s | {8000:3, 8001:2, 8002:3} |
读法很直接:
- nginx 把请求均匀分给了 3 个实例(8 并发时 3/2/3),这一层没问题;
- 但 TTFT 随并发线性上涨(0.03 → 0.57 → 1.63 → 3.62),因为请求最终都排在同一个 Ollama 队列里, 在它前面有多少个请求,就得等多久。
这就是单机多实例的天花板:扩容的是"网关层并发",不是"算力"。
实验 B:负载均衡的吞吐收益(用不碰 GPU 的路径测)
为了把 GPU 这个变量排除掉,我挑了两条不涉及模型推理的路径来压:
# 每条路径 300 次请求;并发 8 / 16 / 32 各跑一轮,每轮重复 3 次取平均
# A) GET /health —— 会去问一次 Ollama(/api/tags)
# B) POST /v1/chat/completions —— 故意用错 key,在鉴权层就被 401 拦下(完全不碰 GPU)
| GET /health | 8 | 85.2 req/s | 196.8 req/s | 2.31× |
| GET /health | 16 | 96.3 req/s | 208.8 req/s | 2.17× |
| GET /health | 32 | 97.4 req/s | 208.4 req/s | 2.14× |
| POST 401(鉴权拦截) | 8 | 924.4 req/s | 759.9 req/s | 0.82× |
| POST 401(鉴权拦截) | 16 | 979.6 req/s | 759.8 req/s | 0.78× |
| POST 401(鉴权拦截) | 32 | 889.6 req/s | 694.5 req/s | 0.78× |
顺便测了 nginx 自己的裸转发上限(/lb-health,不转发也不记日志): 979.8 req/s(并发 16)、1102.4 req/s(并发 32)。
这两行数据背后的结论完全相反,但都很有价值:
这一组实验是我这次学习中最"反鸡汤"的收获: 教科书都说"负载均衡 → 吞吐提升",但数字要自己测。 我原本以为 3 个实例就是 3 倍,实测是 2.2 倍 / 0.8 倍,取决于瓶颈在哪一层。
10.9 想清楚天花板:单机多实例到底解决了什么
- 解决了:进程级并发与单点故障。一个进程崩了、重启,用户几乎无感; Python 单进程吃满一个核的瓶颈也被摊开了。
- 没解决:GPU 只有一块。3 个实例最终还是把请求排到同一个 Ollama 队列里, 端到端延迟不会因为实例数变多而下降(实验 A 里并发越高平均延迟越大,就是这个原因)。
- 真正的下一步:把 OLLAMA_URL 指向多台 Ollama,在网关内部或再套一层调度 (按模型 / 按队列长度选后端),才能让"水平扩容"一路扩到推理层。
一句值得记住的工程判断:负载均衡能消除瓶颈,不能创造算力。 先测出瓶颈在哪(Grafana + 压测),再决定往哪一层加机器。
11. 踩坑合集:这 10 个坑,我每个都花过至少半小时
| 1 | 接上 nginx 后"逐字输出"变成一次性刷出 | proxy_buffering 默认 on,nginx 攒够缓冲才下发 | proxy_buffering off; + 客户端 curl -N |
| 2 | 对比测出经 LB 首字节 1.9s,以为被缓冲了 | 两次请求 num_ctx 不同 → Ollama 重载模型(冷启动 ≈2.1s) | 对比实验参数必须完全一致;每组先 warmup |
| 3 | Prometheus 里多实例曲线糊成一条 | /metrics 走了 LB,instance 标签全变成 nginx 地址 | 直连每个实例抓;LB 上显式 location = /metrics { return 404; } |
| 4 | 长回答写到一半连接断了 | nginx proxy_read_timeout 默认 60s | 改成 300s(proxy_send_timeout/send_timeout 一起) |
| 5 | 缩容后偶发 502 | 先停了实例,nginx 还在往上打 | 先 reload 上游,再停实例(扩容顺序相反) |
| 6 | 上游 keepalive 没生效(全是新连接) | 少写了一行 | proxy_http_version 1.1 + proxy_set_header Connection "" + upstream { keepalive 32; } 三者缺一不可 |
| 7 | 一边压测一边跑验收,两边数据都不对 | 抢同一个限流额度、抢同一块 GPU | 实验要串行、要隔离(见 11.1) |
| 8 | cluster.sh scale 缩容时不停实例 | 新进程读不到"现在跑着哪几个实例"的环境变量 | 改成按 pid 文件反推端口列表 |
| 9 | 访问日志里出现明文 API Key | 日志格式里写了 "api_key":"$http_x_api_key" | 上线前删掉该字段,或只记哈希(见 11.2) |
| 10 | 0.35 版 Ollama 从 num_gpu=12 切回 -1 不重载 | Ollama 判定"配置未变",不换 runner | 换参前先 keep_alive=0 强制卸载 |
11.1 重点讲讲第 7 个坑:我的"实验污染"翻车现场
这个坑很值得单独说,因为它是方法论级别的坑,而不是配置问题。
那天我为了省时间,让 verify_cluster.py(34 项自动验收)在后台跑, 同时另开一个终端做"经 LB 连发 12 次的共享限流实验"。结果两边都出问题:
# 验收脚本最后的输出(第一次)
验收结果: 32/34 项通过
FAIL 未被 nginx 缓冲(首字节远早于总时长,且与直连相当)
FAIL 跨 3 个实例只放行 10 次(额度真共享)
# 我的限流实验(第一次)
200 200 200 200 200 200 200 200 200 429 429 429 ← 只有 9 个 200?为什么不是 10?
我一开始以为是代码有 bug,差点去改限流逻辑。后来想明白了:
把两个实验串行跑之后:
验收结果: 34/34 项通过
round 1 经 LB 12 次: 200 200 200 200 200 200 200 200 200 200 429 429
round 2 经 LB 12 次: 200 200 200 200 200 200 200 200 200 200 429 429
干干净净,还顺手得到了"两次复现一致"这个额外证据。
这条经验我觉得比任何配置都值钱: 性能与行为实验必须独占资源,否则你测出来的"故障"可能只是另一个实验的影子。
11.2 重点讲讲第 9 个坑:一个不该出现在日志里的字段
这是我写完 nginx 日志格式之后自己 review 出来的问题。为了排障方便, 我让访问日志把请求头也记了下来:
log_format gw escape=json '{'
'"uri":"$uri",'
'"upstream_addr":"$upstream_addr",'
'"instance":"$upstream_http_x_gateway_instance",'
'"api_key":"$http_x_api_key"' # ← 这里
'}';
打出来的日志确实好用:
{"time":"2026-10-07T23:44:13+08:00","method":"POST","uri":"/v1/chat/completions",
"status":200,"request_time":0.028,"upstream_addr":"127.0.0.1:8002",
"upstream_status":"200","instance":"gateway-8002","api_key":"sk-prod-001"}
但这是绝对不能上生产的:访问日志会被采集、转发、落盘、归档, 等于把 API Key 明文撒得满地都是。正确做法是只记"能否识别用户",不记密钥本体:
# 方案一:干脆不记(最省事,排障时用网关自己的 JSONL 日志去对)
# 删掉 '"api_key":"$http_x_api_key"' 这一行即可
# 方案二:记一个"可追溯但不敏感"的标识。
# 在网关侧额外返回一个掩码后的 key 标识(如 sk-prod-***-1a2b),
# nginx 只记这个头,不记原始密钥:
'"api_key_id":"$upstream_http_x_api_key_id"'
教训:排障便利性和数据安全经常冲突,默认应该选安全,需要时再临时打开。 (我这份模板是学习用途所以保留了该字段,但已经在文档里标注"上线必须删"。)
12. 一块 1050Ti 教会我的 5 件事
写完 11 个阶段回头看,真正让我"能力升级"的不是会用多少个组件,而是下面这 5 个认知:
1. 先找瓶颈,再谈优化。 /health 走 LB 只有 2.2 倍提升(而不是 3 倍),因为瓶颈在共享的 Ollama 上; 401 路径走 LB 反而慢 22%,因为瓶颈变成了"多一跳"。 同一个"加机器"的动作,在不同瓶颈下收益是 2.3× 和 0.8× 的差别。 数字不测出来,你根本不知道该往哪加。
2. 观测组件必须能失败,且失败不能拖死主链路。 Redis 挂了限流退化成单实例、PG 挂了只丢历史、Kafka 挂了写本地文件—— 每次打挂一个组件,推理请求都还是 200。 这是"能上线"和"只能跑 demo"之间的分界线。
3. 所有状态都要问一句"它放在哪"。 我最初想不通"为什么多起一个进程就算扩容",后来发现答案很简单: 因为网关没有状态。限流在 Redis、历史在库、事件在队列、配置在环境变量—— 进程本身变成可随意替换的"计算单元",这才是水平扩容的前提。
4. 一切都要能自动恢复。 Redis 5 秒重连、Kafka 10 秒重连、历史写失败后下批换新连接、 nginx 实例 10 秒后自动加回上游。 目标是不需要"半夜起来重启网关"。 这一点在单机环境里反而更好验证—— kill 一下就知道恢复得对不对。
5. 慢下来,才能看清。 1050Ti 生成 0.5B 模型只有 ~176 tok/s,一次 128 token 的回答要 1 秒多。 正因为慢,并发一上来 TTFT 从 0.03s 涨到 3.62s 的曲线清晰可见, 限流、降级、故障转移的每个现象都能被肉眼观察到。 如果一开始就用 A100 跑 70B,我大概会把所有现象都归因于"它太快了,看不清"。
换句话说:4GB 显存的限制,逼我把精力放在了真正重要、也真正可迁移的地方—— 服务化、可观测、降级、扩容、验收。
13. 想复现?最短路径(约一个下午)
如果你也有一张老显卡(甚至没有显卡,纯 CPU 也能跑 0.5B),可以这样开始:
# 0) 基础:Ollama + 模型
ollama serve &
ollama pull qwen2.5:0.5b
# 1) 起网关(零依赖也能跑:限流走内存、历史走 SQLite、事件写本地文件)
python main.py
curl -s -X POST http://localhost:8000/v1/chat/completions \\
-H 'X-API-Key: sk-prod-001' -H 'Content-Type: application/json' \\
-d '{"model":"qwen0.5b","messages":[{"role":"user","content":"hi"}],"options":{"num_predict":8}}'
# 2) 接上三件基础设施(免 root 解包 Redis / PostgreSQL / Kafka)
bash scripts/infra.sh install && bash scripts/infra.sh start
# 3) 起监控
bash scripts/install_monitoring.sh && bash scripts/monitoring.sh start
# Prometheus: http://localhost:9090 Grafana: http://localhost:3000/d/llm-gateway
# 4) 多实例 + 负载均衡
bash scripts/nginx.sh install
bash scripts/cluster.sh start # 3 实例 + nginx :8080
bash scripts/cluster.sh scale 5 # 热扩容
# 5) 验收(这两个脚本会告诉你"你真的会了没有")
python verify_infra.py # 期望 21/21 通过
python verify_cluster.py # 期望 34/34 通过
建议的学习顺序(也是我实际走的顺序,跳过"降级演练"会吃亏):
跑通 → 读懂主链路 → SSE → 监控 → 限流 → 历史 → 事件 → 降级演练 → 调优 → 多实例
↑
别跳过这一步,它是分水岭
难度与时间参考(业余时间做):
| 跑通 + 主链路 + SSE | 1 天 | ★ |
| 监控(Prometheus / Grafana) | 1~2 天 | ★★ |
| 分布式限流 | 1 天 | ★★ |
| 历史 + 事件(PG / Kafka) | 1~2 天 | ★★★ |
| 降级演练 | 半天 | ★★(收获最大) |
| 压测与参数调优 | 1 天 | ★★ |
| 多实例 + nginx | 1~2 天 | ★★★ |
| 12 道进阶动手题 | 按需 | ★★★★ |
14. 写在最后
有句话我特别想对同样被硬件卡住的同学说:
AI Infra 不等于"训大模型"。
在一台 1050Ti 笔记本上,我照样把工程里最难也最值钱的那部分练了一遍: 限流怎么做才不会让一个用户拖死所有人、观测组件挂了服务要不要跟着死、 多实例之间状态怎么共享、SSE 怎么才不被中间件缓冲、 一个实例崩了用户为什么毫无感知、扩容到底该扩哪一层。
这些能力换到任何一块 A100/H100 上都直接可用——只是数字会从 176 tok/s 变成 3000 tok/s, 3 个实例变成 30 个实例。而"先测瓶颈再优化"“观测是增强不是依赖”“状态要外置”“一切自动恢复” 这些判断,跟显卡型号毫无关系。
真正限制我们的,从来不是 4GB 显存,而是**“只把服务跑起来"和"说清楚它在什么条件下会坏” 之间的那段距离**。这一段,一块 1050Ti 完全够用。
本文所有数据均为本机实测(GTX 1050 Ti 4GB / Ollama 0.35.0 / Prometheus 3.15.0 / nginx 1.28.3 / Redis 8.0.5 / PostgreSQL 18.6),验收结果 21/21、34/34; 参数扫描的原始明细在 logs/tuning_experiment.jsonl。
项目文件速查(如果你也想照着写一份):
| main.py | 网关主链路(鉴权 / 限流 / 路由 / 转发 / 留痕) |
| auth.py ratelimit.py router.py | 鉴权、Redis+Lua 限流、模型别名路由 |
| storage.py events.py logger.py | 历史库(SQLite/PG)、Kafka 事件、JSONL 日志 |
| prometheus_metrics.py | 指标定义(Counter / Gauge / Histogram) |
| scripts/infra.sh scripts/monitoring.sh | Redis/PG/Kafka、Prometheus/Grafana 的一键起停(免 root) |
| scripts/nginx.sh scripts/cluster.sh | nginx 安装/渲染/热加载、多实例起停与扩缩容 |
| nginx/nginx.conf.tpl | 负载均衡配置模板(SSE、健康检查、日志格式) |
| verify_infra.py verify_cluster.py | 21 项 / 34 项自动验收 |
| tuning_experiment.py | Ollama 参数受控扫描实验 |
| README.md study.md | 速查手册 + 11 阶段逐步教学手册 |


评论前必须登录!
注册