 网硕互联帮助中心
模型漂移、重试代价、中断识别与降级预案——那些返回 200 却悄悄变坏的故障,附 ai@7.0.122 全套实测
目录
一、先说清楚:AI 系统的"腐坏"跟你想的不一样
二、模型会自己变:四种变化里,只有一种会报警
三、实跑:你到底能不能知道"这次是谁服务的你"
四、把版本钉死:别让一个别名替你做生产决策
五、重试不是免费的:把它的时间和钱算清楚
六、超时与中断:三种完全不同的原因,报的是同一个错
七、配额与限流:429 不是错误,是上游在跟你说话
八、降级预案:AI 挂了你还能不能干活
九、金丝雀的陷阱:平均数会说谎
十、值班与事故响应:AI 事故的排查顺序
十一、成本与缓存:命中率掉了,可能又是漂移
十二、第 90 天检查清单
尾声:你运维的其实是"你不拥有的那一半"
上线第一周你盯着日志,第二周你开始睡好觉,第三周你把监控面板从收藏夹里移出去了。
第九十天,客服群里出现一句:「这个功能是不是最近变傻了?」你去翻代码提交记录,最近一次改动是六周前修的一个文案。你去看错误率,平的。你去看 P99 延迟,甚至比上线时更好了。你去看成本,还降了。
没有任何一个指标告诉你出事了。但用户是对的。
这就是 AI 系统跟传统后端最不一样的地方:传统后端里,「代码没变」几乎等价于「行为没变」;AI 系统里,这句话不成立。因为你有一半的系统不在你手里——模型在供应商那边,权重、路由、量化策略、系统提示词,全都不归你管。
这篇文章讲的是第九十天才会暴露的那一类故障。前五篇我们讲了怎么把功能做出来、怎么评测、怎么接工具、怎么让 AI 自己把工具串起来干活;这一篇讲的是它跑起来之后,在没有人碰代码的情况下,是怎么一点点坏掉的,以及你该在哪些地方装上传感器。
文中的所有结论都来自实跑:ai@7.0.122 + @ai-sdk/openai@4.0.81 + MockLanguageModelV4,实验脚本全部可复现,原始输出我会直接贴在正文里。
一、先说清楚:AI 系统的"腐坏"跟你想的不一样
传统后端的故障,本质上都是崩溃。进程挂了、数据库连接池满了、依赖超时了。这类故障的特征是它会喊:日志里有堆栈,监控上有红点,值班群会响。
AI 系统多出来一类故障,它不喊。它返回 200,返回结构合法的 JSON,延迟正常,成本正常,只有答案是错的。
从监控的角度看,故障可以分成三层:
|
层级 |
现象 |
常规监控可见吗 |
谁先发现 |
|
崩溃层 |
进程死、超时、 5xx |
可见,秒级告警 |
值班工程师 |
|
错误层 |
返回了格式错误的输出、工具调用失败 |
多数可见(前提是你校验了输出) |
监控或用户 |
|
漂移层 |
一切正常,但输出悄悄变了 |
不可见 |
用户,通常在几天到几周后 |
第三层是最贵的一层。原因不在于它更严重,而在于它把发现时间推迟了。第一层故障你五分钟就知道,第三层你可能是两个月后从客服工单里倒推出来的——这时候你已经累积了两个月的不良输出,而且很难说清是从哪天开始坏的。
|
一句话记住:第一层和第二层故障在跟你说话,第三层故障在跟你装死。运维的第一原则是:给你不拥有的东西装上传感器。 |
二、模型会自己变:四种变化里,只有一种会报警
先把"模型变化"这件事拆开。很多工程师脑子里只有一种变化——"供应商发了新版本,我要不要升级"。真实的 2026 年有四种,而且它们的可见度完全不同。
第一种,别名重指向。 你调的是 gpt-x、claude-sonnet-latest 这种不带日期的名字,供应商把它指向一个新的快照。你什么都没做,行为变了。这种变化你连"提前知道"的资格都没有——你用别名的那一刻就已经同意了这件事。
第二种,静默点发布。 版本号没变,名字没变,但如果供应商在后台动了权重、安全策略或者路由层,行为照样会变。你唯一能拿到的信号是 changelog 里一行没人看的更新说明。
第三种,已公告的弃用。 供应商发邮件说"某快照将在 X 月 X 日下线,请迁移"。这类变化最容易被忽视,因为它当下什么都不影响——你的系统今天跑得好好的,那封邮件看起来只是通知。
第四种,落日。 到了下线的日子,你所有请求开始硬失败。这是唯一一种会触发常规告警的变化,而当你收到告警时,那个"从容迁移"的窗口已经关掉了。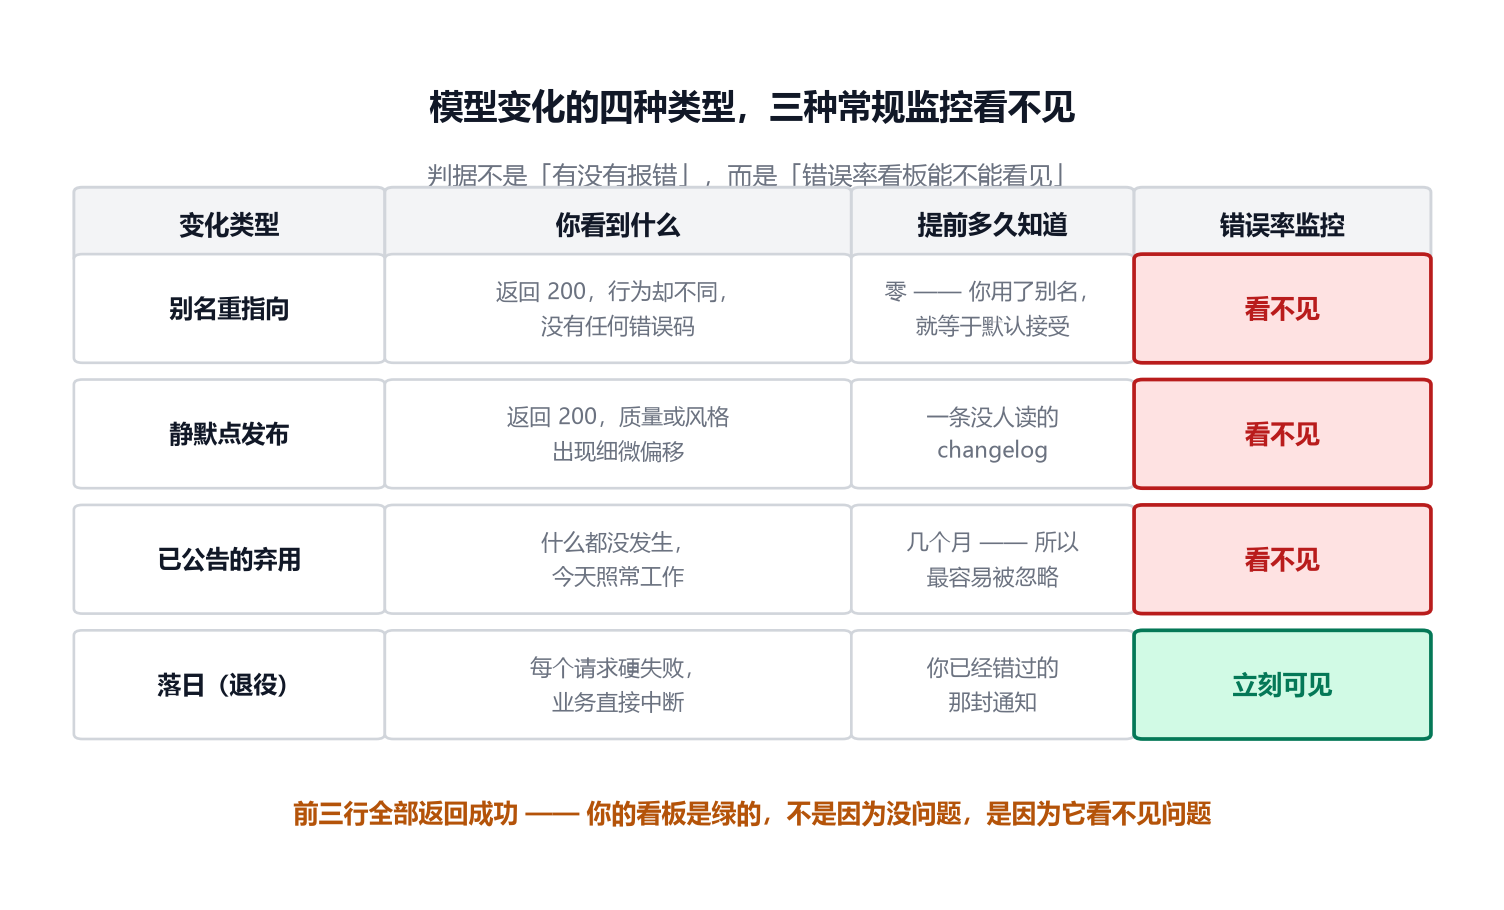 四种模型变化类型以及常规监控能否发现它们
这张图的重点是最后一列:前三行从构造上对错误率监控不可见,因为它们全部返回成功。你的看板之所以是绿的,不是因为没问题,是因为看板看不见问题。
这不是危言耸听,是正在发生的事。OpenAI 在 2026 年 4 月 22 日发了一则弃用公告,把一批 GPT-4 时代的快照统一安排在 2026 年 10 月 23 日关闭,包括 gpt-4-0613、gpt-4-1106-preview、gpt-4-turbo-2024-04-09、gpt-4o-2024-05-13、gpt-4.1-nano、o4-mini 等。如果你有服务还在用 gpt-4-turbo 这种名字,那么在你读到这篇文章的时候,距离那次硬失败只剩不到一个月。
Anthropic 的做法更透明一些:他们把模型生命周期分成 Active / Legacy / Deprecated / Retired 四态,并承诺对公开模型至少提前 60 天通知退役。但这里有个容易踩的坑——他们的文档明确写了,Amazon Bedrock 和 Google Cloud 上的同一个模型由各自平台设定退役时间表。也就是说,同一个 claude-sonnet-4-20250514,在不同平台上消失的日期可能是不同的。如果你的架构是"主用官方 API、备用走云平台",那么这两个退役日期都得进你的日历。
还有一个更隐蔽的数据点。2026 年 3 月 11 日 GPT-5.1 别名退役时,有团队实测发现:调用没有返回 404,没有错误码,响应里也没有任何版本变更提示,请求被静默路由到了新一代模型上。他们的内部测试集里,一个单字情感分类器的输出从 Neutral. 变成了 Neutral——就少了一个句号。下游用字符串相等判断的代码开始静默错误分类。在另一个 JSON 输出测试里,不同模型版本产生的空白模式和键顺序有细微差异,输出依然是合法 JSON,但字节序列变了,直接破坏了基于哈希的去重缓存。
这就是"漂移"最典型的形态:请求成功、指标正常、用户拿到错误结果、几天后支持工单出现、值班工程师花半天去找一段根本不存在的代码改动。
三、实跑:你到底能不能知道"这次是谁服务的你"
好,既然上游会变,那下一个问题就是:我能知道变了没有吗?
直觉上你可能会想:响应里不是有 modelId 吗?读它不就行了。我们来实测这个直觉对不对。
3.1 当上游如实上报时
先构造一个"诚实的网关":你请求的是浮动别名 gpt-x,但网关实际把你路由到了快照 gpt-x-2026-09-01,并且如实告诉了你。
|
TypeScript |
|
import { generateText } from 'ai'; import { MockLanguageModelV4 } from 'ai/test'; const REQUESTED = 'gpt-x'; const ACTUALLY_SERVED = 'gpt-x-2026-09-01'; const model = new MockLanguageModelV4({ provider: 'acme-gateway', modelId: REQUESTED, doGenerate: [ { content: [{ type: 'text', text: 'ok' }], finishReason: { unified: 'stop', raw: 'stop' }, usage: { inputTokens: { total: 100, noCache: 100, cacheRead: 0, cacheWrite: 0 }, outputTokens: { total: 10, text: 10, reasoning: 0 } }, modelId: ACTUALLY_SERVED, response: { id: 'resp_1', timestamp: new Date('2026-09-30T02:00:00Z'), modelId: ACTUALLY_SERVED }, providerMetadata: { 'acme-gateway': { servedModel: ACTUALLY_SERVED } }, }, ], }); const r = await generateText({ model, prompt: 'hello' }); console.log(r.response.modelId); |
实跑输出:
|
示例文本 |
|
你请求的 = gpt-x 实际服务的 = gpt-x-2026-09-01 result.response.modelId = "gpt-x-2026-09-01" → 是否等于服务端真相? 是(可用作漂移检测) result.providerMetadata = {"acme-gateway":{"servedModel":"gpt-x-2026-09-01"}} → 能否读到服务端真相? 能 |
很好,SDK 如实透传了服务端的标识。这里有个细节值得留意:response.modelId 取的是服务端返回体里的 model 字段,而不是回显你请求的值。这是判断漂移的物理基础。
3.2 当上游不上报时——这才是"静默"的真相
现在把同样的实验改一个字:让网关不上报自己的真实身份。这在现实中对应的是——中转站、自建网关、或者某些不填 model 字段的兼容实现。
实跑输出:
|
示例文本 |
|
你请求的 = gpt-x | 服务端实际(假设已被换成 gpt-x-2026-09-01,但上游没说) result.response.modelId = "gpt-x" → 是 undefined 还是回显了你请求的名字? 回显了你请求的名字(危险:看起来一切正常) result.providerMetadata = undefined |
这里是本篇最重要的一行输出。
当上游不上报时,SDK 不会给你 undefined,它会回显你自己写进去的那个名字。也就是说,你代码里那句 if (r.response.modelId !== EXPECTED) alert(…) 永远为假。
你必须理解这件事的含义:response.modelId 不是证据,它是你请求的回声。 只有当上游愿意配合时它才是证据。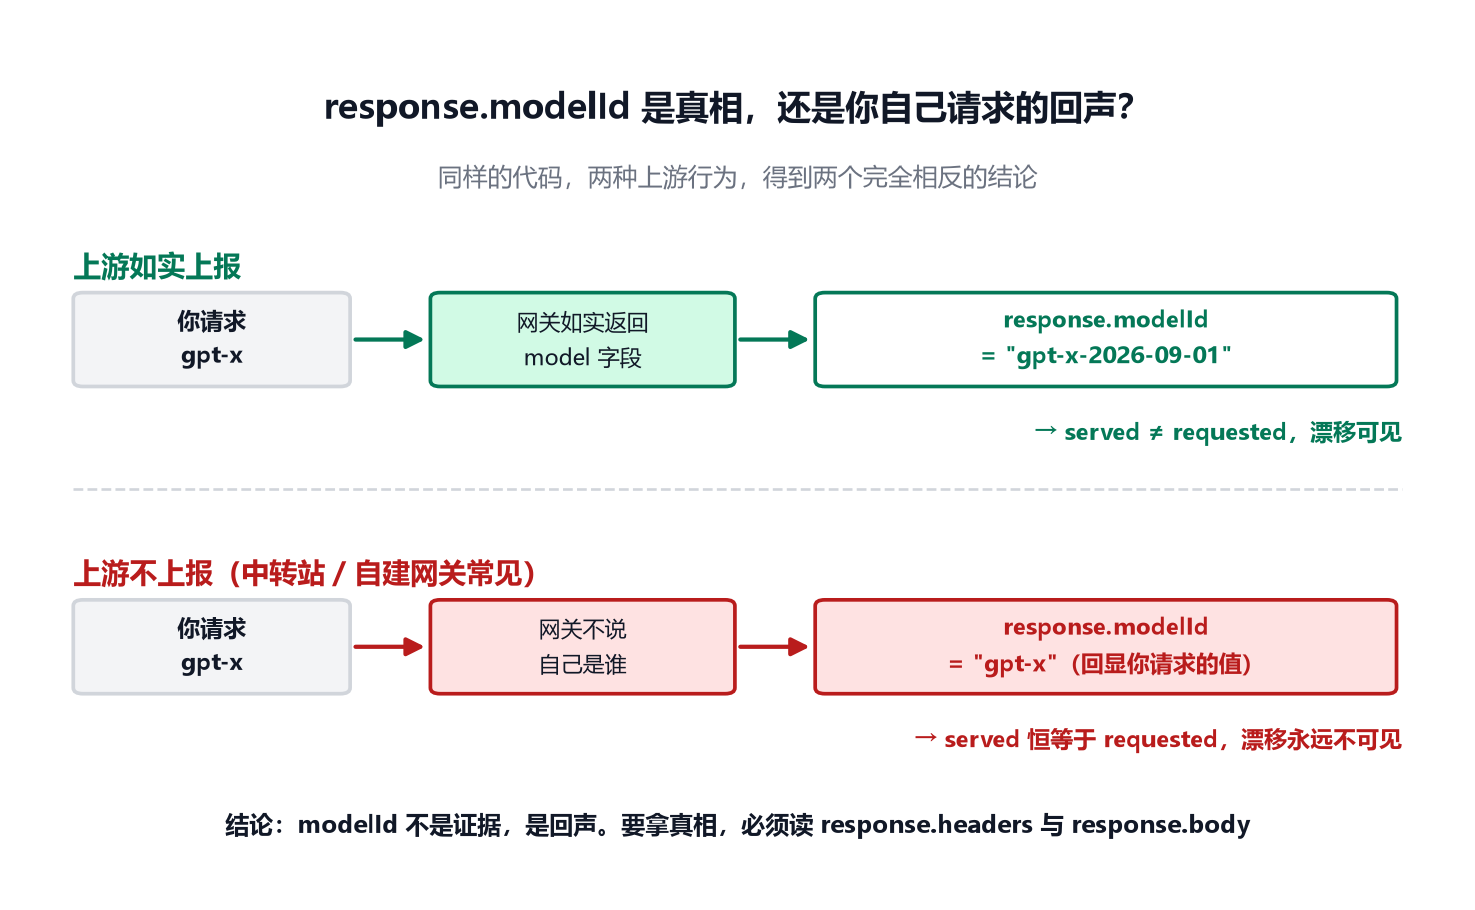 response.modelId 是真相还是回声
3.3 那该怎么办:把原始响应留下来
既然 SDK 层面可能拿不到真相,就要往下一层去拿。AI SDK 在响应对象上留了三个口子:
|
TypeScript |
|
// result.response 的完整形状 { id: 'resp_abc', // 上游给的响应 ID timestamp: Date, // 上游给的时间戳 modelId: '…', // 可能是真相,也可能是回声 headers: { … }, // 原始 HTTP 响应头 body: '…', // 原始响应体 messages: […], // 消息记录 } |
前两节实验里 headers 和 body 都是 undefined——因为 mock 模型不产生真实 HTTP 流量。那真实的 provider 填不填?我去读了 @ai-sdk/openai@4.0.81 的实现:
|
JavaScript |
|
// @ai-sdk/openai dist/index.js(节选) async doGenerate(options) { const { responseHeaders, value: response, rawValue: rawResponse } = await postJsonToApi({ url: this.config.url({ path: '/chat/completions', modelId: this.modelId }), headers: combineHeaders(this.config.headers?.(), options.headers), body, }); return { // … response: { …getResponseMetadata(response), // 从响应体取 id / model / created headers: responseHeaders, // 完整响应头(含 x-request-id 之类) body: rawResponse, // 原始响应体文本 }, }; } |
结论很清楚:真实 provider 会把完整响应头和原始响应体交给你。这就给了你两个可靠的传感器:
写成一个可以复用的采集器:
|
TypeScript |
|
type DriftRecord = { requested: string; served: string | null; drifted: boolean; requestId: string | null; }; function collectDrift(params: { requested: string; response: { modelId?: string; headers?: Record<string, string>; body?: string }; }): DriftRecord { const { requested, response } = params; // 优先从原始响应体里取真相,取不到再退回 SDK 的 modelId let served: string | null = null; if (response.body) { try { const parsed = JSON.parse(response.body) as { model?: string }; served = parsed.model ?? null; } catch { served = null; // 响应体不是 JSON,放弃 } } served = served ?? response.modelId ?? null; const requestId = response.headers?.['x-request-id'] ?? response.headers?.['request-id'] ?? response.headers?.['x-amzn-requestid'] ?? null; return { requested, served, // 关键:只有在明确拿到 served 且与请求不一致时才算 drift // 拿不到 served 不能当作"没漂移",要单独计数 drifted: served !== null && served !== requested, requestId, }; } |
注意 drifted 的计算逻辑里藏了一个判断:"拿不到"和"没漂移"是两件事。如果你的采集器把 served === null 也归到"没漂移",那你就又回到了盲区。正确的做法是三分类:same / drifted / unknown,而 unknown 的占比本身就是一个要盯的指标——它衡量的是"你还剩多少可见度"。
四、把版本钉死:别让一个别名替你做生产决策
知道了漂移的发生机理,第一个动作就是把不确定性收掉:生产环境用精确版本,不要用浮动别名。
这件事的收益不是"防止漂移"——它防不住供应商动权重——而是把"变化"从环境事件变成代码变更。用别名时,模型换了是一次没人 review 的环境变更;用精确快照时,换模型是一次可以 review、可以灰度、可以回滚的提交。
|
TypeScript |
|
// models.ts —— 全代码库唯一的模型标识来源 export const MODELS = { chat: { id: 'gpt-x-2026-09-01', // 生产:钉死快照,禁止浮动别名 pinnedOn: '2026-09-28', verifiedAgainstGoldenSet: true, // 换这个值之前必须跑过金标集 fallback: 'claude-y-20260514', // 备胎现在就选好,不要等出事再选 sunsetWatch: 'https://provider.example/deprecations', }, } as const; |
这个文件的价值在于它让"版本变更"变成一次 diff。任何模型标识的改动都有提交记录、有评审、有回滚点。
但必须清醒:钉死版本不等于安全。看真实数据——Anthropic 的 claude-sonnet-4-20250514 和 claude-opus-4-20250514 于 2026 年 4 月 14 日被宣布弃用,两个月后的 6 月 15 日就退役了。claude-opus-4-1-20250805 是 6 月 5 日宣布、8 月 5 日退役,同样两个月。也就是说,即使你钉的是带日期的精确快照,供应商给你的从容时间也可能只有两个月。
所以 pin 解决的是"可见性问题",不是"生命周期问题"。生命周期问题要靠第五节的东西解决。
还有一件事值得单独做:给 sunsetWatch 装个提醒。这个字段不是装饰品,它是把"我该去读一眼供应商文档"这件事从人脑里搬到系统里。你可以在 CI 里加一个 weekly job,抓取那几个 pubic deprecation 页面,跟你代码库里所有的模型标识做一次交集,有命中就开 issue。这件事的成本很低,但它救回的通常是整整一个下午的值班时间。
五、重试不是免费的:把它的时间和钱算清楚
上线初期最容易写下的代码是这样的:出错就重试,重试三次还失败就抛。这是对的,但很少有人算过重试到底花掉了什么。我们把它的行为跑出来。
用 mock 模型模拟上游持续返回 429(限流)和 500(服务端错误),数一数 SDK 究竟替你调用了几次、等了多久:
|
TypeScript |
|
import { generateText, APICallError, RetryError } from 'ai'; async function run(label: string, statusCode: number, isRetryable: boolean, maxRetriesArg?: number) { let calls = 0; const model = new MockLanguageModelV4({ provider: 'acme', modelId: 'm', doGenerate: async () => { calls++; throw new APICallError({ message: `HTTP ${statusCode} from upstream`, url: 'https://api.example/v1/chat/completions', requestBodyValues: { model: 'gpt-x' }, statusCode, responseHeaders: {}, responseBody: '{"error":"boom"}', isRetryable, data: { raw: 'boom' }, }); }, }); const t0 = Date.now(); const opts: Record<string, unknown> = { model, prompt: 'x' }; if (maxRetriesArg !== undefined) opts.maxRetries = maxRetriesArg; try { await generateText(opts as never); return { calls, err: '未抛错', ms: Date.now() – t0 }; } catch (e) { const isRetry = RetryError.isInstance(e); return { calls, err: e.constructor.name, reason: isRetry ? e.reason : '-', ms: Date.now() – t0, }; } } |
实跑输出(原始结果):
|
示例文本 |
|
场景 | 调用次数 | 错误类 | 原因 | 内部错误数 | 耗时 ——————————————————————————————————– 429 可重试(默认 maxRetries) | 实际调用次数=3 | 错误类=RetryError | reason=maxRetriesExceeded | errors.length=3 | 耗时=2041ms 500 可重试(默认 maxRetries) | 实际调用次数=3 | 错误类=RetryError | reason=maxRetriesExceeded | errors.length=3 | 耗时=2005ms 400 不可重试 | 实际调用次数=1 | 错误类=APICallError | reason=- | errors.length=- | 耗时=1ms 429 但 maxRetries=0 | 实际调用次数=1 | 错误类=APICallError | reason=- | errors.length=- | 耗时=1ms 429 但 maxRetries=5(观察上限) | 实际调用次数=6 | 错误类=RetryError | reason=maxRetriesExceeded | errors.length=6 | 耗时=5005ms |
(上表的耗时是带 retry-after: 1 响应头的结果。作为对照,把 retry-after 去掉、只留默认退避,一组同样配置的 500 重试实跑结果是:)
|
示例文本 |
|
C1 无 retry-after,500,默认重试 | 调用=3 次 | 总耗时=6041ms → 纯退避开销 C2 retry-after: 2,429,默认重试 | 调用=3 次 | 总耗时=4005ms → 尊重 retry-after(被拖长) |
从这两张表里能读出四件在运维上极其重要的事:
第一,maxRetries 的默认值是 2,也就是最多 3 次调用。 这不是文档里的说法,是数出来的:默认配置下 mock 被调用了 3 次。maxRetries: 5 时变成 6 次,maxRetries: 0 时是 1 次,完全对得上。
第二,错误类型本身就在告诉你"重试过没有"。 拿到 RetryError 说明重试过并且用尽了;拿到 APICallError 说明一次都没重试——要么它不可重试(400 这类客户端错误),要么你把 maxRetries 设成了 0。这个区分对值班很有用:看到 APICallError 就不该再指望"等一会儿重试会好",那是确定性失败,该去看请求本身或去处理业务降级。
第三,不重试的错误不烧钱,这一点 SDK 做对了。 400 只调用了 1 次,1 毫秒返回。它尊重了错误对象上的 isRetryable 标记,没有对客户端错误做无谓重试。
第四,也是最少被算到的一点:默认退避比上游的建议更慢。 同样 3 次调用,纯默认退避花了 6041ms,而带上游 retry-after: 2 只花了 4005ms。少了整整 2 秒。原因是默认走的是指数退避,而 retry-after 是上游明确告诉你"这么多秒后再来"——上游比你更清楚它什么时候能缓过来。
把这四件事画在一起,重试的真实成本就很直观了: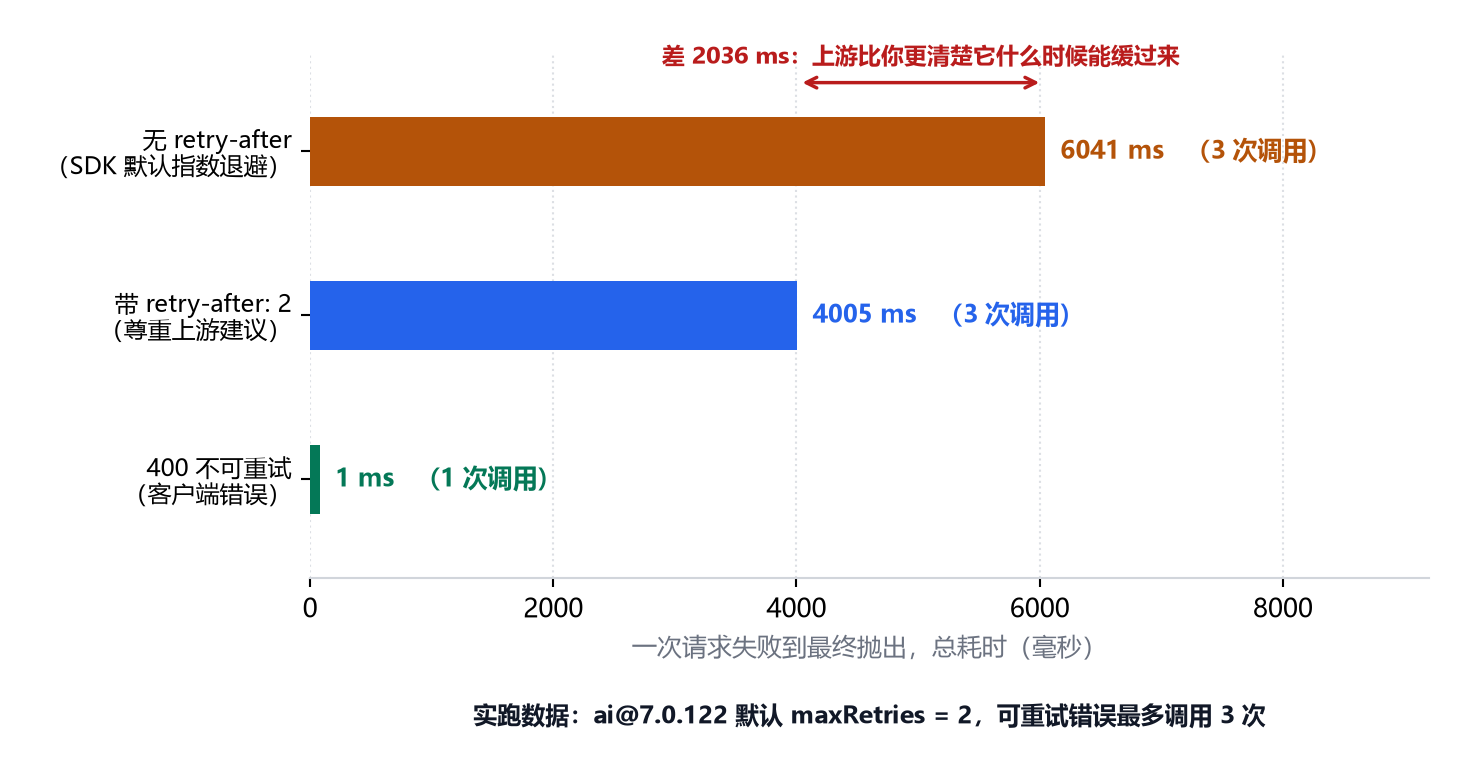 重试策略的真实时间成本
5.1 重试的隐藏成本:副作用会被执行多次
上表统计的是时间。还有个更贵的账:如果重试发生在工具调用之后,你的副作用可能已经执行了两次。
这条在第 5 篇讲 Agent 循环时出现过,但那是单次请求内的循环重试。这里的重试发生在更外层——整次模型调用失败后 SDK 自动重发。如果你的调用里包含了写数据库、发短信、扣款这类工具,一次上游抖动就可能让它们执行两遍。
所以凡是带副作用的调用,必须做两件事:
|
TypeScript |
|
// 1) 幂等键:让重复执行变成无害操作 await sendSms({ templateId: 'order_shipped', to: order.phone, idempotencyKey: `order_shipped:${order.id}`, // 同一订单只发一条 }); // 2) 明确重试预算:不要让 SDK 的默认值替你决定 const r = await generateText({ model, prompt, tools, maxRetries: 1, // 有副作用的链路,重试次数要压到最低 timeout: { totalMs: 8000 }, // 并且给它一个上限 }); |
六、超时与中断:三种完全不同的原因,报的是同一个错
这一节是我在做这轮实验时最意外的发现。
上线之后你需要区分三种"请求没完成"的情况,因为它们的业务含义完全不同:
直觉上你会觉得这三种应该有三种错误类型。我把它们全跑了一遍。
|
TypeScript |
|
// 用户主动取消 const ac = new AbortController(); setTimeout(() => ac.abort(), 300); await generateText({ model, prompt: 'x', abortSignal: ac.signal }); // 整体超时 await generateText({ model, prompt: 'x', timeout: { totalMs: 400 } }); // 单步超时 await generateText({ model, prompt: 'x', timeout: { stepMs: 400 } }); |
实跑输出(原始结果,三组):
|
示例文本 |
|
用户主动取消(abortSignal): 构造器=DOMException | name="AbortError" | message="Delay was aborted" 是 RetryError? false | 是 APICallError? false 超时中断(timeout.totalMs): 构造器=DOMException | name="AbortError" | message="Delay was aborted" 是 RetryError? false | 是 APICallError? false 单步超时(timeout.stepMs): 构造器=DOMException | name="AbortError" | message="Delay was aborted" |
三种原因,三个相同的错误对象:DOMException / AbortError / "Delay was aborted"。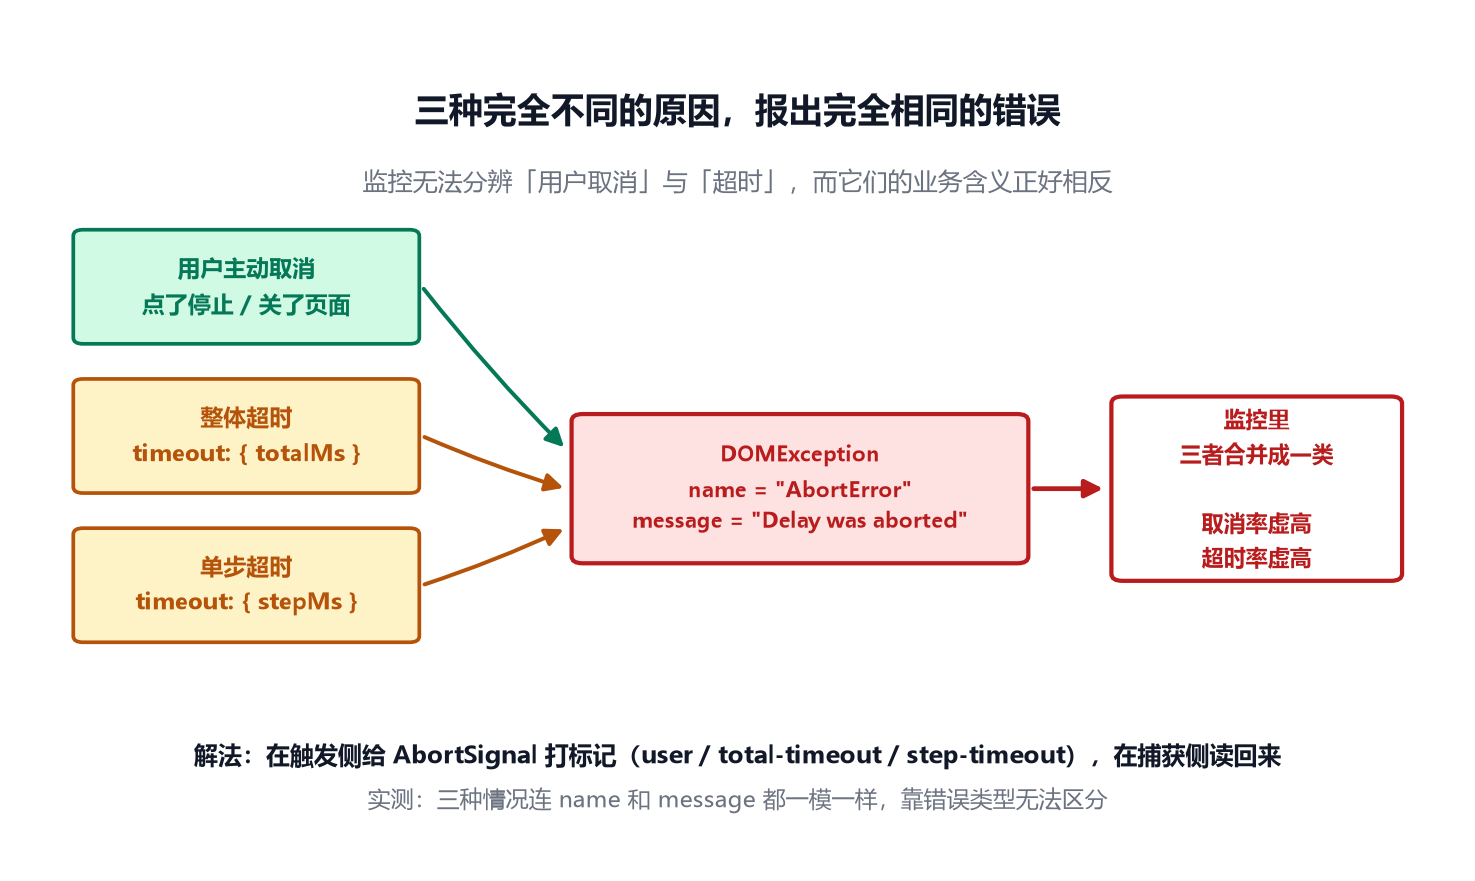 三种不同原因,同一个 AbortError
这件事的后果很具体:如果你按错误类型做监控,你无法分辨上面三种情况。于是:
- 你的"取消率"指标里混进了超时,数字虚高;
- 你的"超时率"指标里混进了用户取消,数字虚高;
- 你没办法给超时配一条独立的告警,因为触发它和触发取消的是同一个错误;
- 更糟的是,当用户抱怨"点了停止但过了好几秒才停",你从日志里看不出那是取消生效慢,还是被超时抢先中断。
好消息是 totalMs 和 stepMs 确实生效——上面第三组的单步超时和第一组的取消都成功中断了重试链(否则 3 次重试要跑 6 秒)。坏消息是它们和取消共用同一个信号。
6.1 解法:自己给中断打标记
既然错误类型不可区分,就必须在触发侧打标记,然后在捕获侧读回来。
|
TypeScript |
|
type AbortReason = 'user' | 'total-timeout' | 'step-timeout'; // 用一个映射把 AbortSignal 和"为什么中断"关联起来 const abortReasons = new WeakMap<AbortSignal, AbortReason>(); function withReason(reason: AbortReason) { const ac = new AbortController(); abortReasons.set(ac.signal, reason); return ac; } function classifyAbort(err: unknown, signal?: AbortSignal): AbortReason | null { if (!(err instanceof DOMException) || err.name !== 'AbortError') return null; if (signal && abortReasons.has(signal)) return abortReasons.get(signal)!; return null; // 拿不到标记:归入 unknown,单独计数 } // 使用 const ac = withReason('user'); const timer = setTimeout(() => ac.abort(), 30_000); try { await generateText({ model, prompt, abortSignal: ac.signal }); } catch (err) { const why = classifyAbort(err, ac.signal); metrics.increment('llm.aborted', { reason: why ?? 'unknown' }); // 只有非用户原因才告警 if (why && why !== 'user') { logger.error('llm.abort.anomaly', { reason: why }); } throw err; } finally { clearTimeout(timer); } |
注意 unknown 这个兜底分支。它的意义是诚实地记录你的盲区——所有没打上标记的中断都会落到这里。如果你的 unknown 占比开始上升,说明中断的来源变复杂了(可能加了新的调用路径忘了打标记),这本身就是一条值得看的运维信号。
七、配额与限流:429 不是错误,是上游在跟你说话
把 429 当异常来处理,是新手最常见的误读。429 的语义不是"你错了",而是"你太快了,慢一点"。它是上游的流量管理信号,不是故障信号。
这个区别决定了你该怎么响应:
|
上游信号 |
含义 |
你该做什么 |
|
429 + retry-after: 5 |
明确让你 5 秒后再来 |
尊重它,不要退避得比它还久 |
|
429 无 retry-after |
没说等多久 |
用指数退避 + 抖动,别用固定间隔 |
|
403 / 401 |
凭据或权限问题 |
别重试,直接告警(这是配置事故) |
|
400 |
请求本身不合法 |
别重试,去看请求构造代码 |
|
500 / 502 / 503 |
上游自己出问题了 |
重试 + 考虑切备用供应商 |
这里有一条前面实测已经验证过的反直觉结论值得重复一遍:上游给的 retry-after 往往比 SDK 的默认指数退避更快(4005ms 对 6041ms)。你什么都不做时,SDK 已经替你等了;但如果你想把控延迟预算,就得自己接手退避逻辑,至少在客户端侧把 retry-after 读出来做上限。
还有一层是多租户的公平性。如果你是一个 SaaS,所有租户共用一组上游配额,那么一个大租户的批量任务可以把整个配额吃干,让所有小租户一起 429。这类问题在第九十天尤其容易暴露,因为早期客户少、跑得顺,等客户多起来才炸。
|
TypeScript |
|
// 租户级配额闸门:宁可让大租户排队,也不能让它挤死所有人 type QuotaState = { tokensUsed: number; resetAt: number }; class TenantQuotaGate { private readonly states = new Map<string, QuotaState>(); constructor( private readonly perTenantLimit: number, private readonly windowMs: number, ) {} tryConsume(tenantId: string, tokens: number): { ok: true } | { ok: false; retryAfterMs: number } { const now = Date.now(); let s = this.states.get(tenantId); if (!s || now >= s.resetAt) { s = { tokensUsed: 0, resetAt: now + this.windowMs }; this.states.set(tenantId, s); } if (s.tokensUsed + tokens > this.perTenantLimit) { return { ok: false, retryAfterMs: s.resetAt – now }; // 让调用方去排队,而不是去打上游 } s.tokensUsed += tokens; return { ok: true }; } } |
这个闸门的价值不在"省配额",而在于把拒绝发生在上游之前。你在自己家里拒绝大租户,成本是零;让上游拒绝你,成本是整条链路的时间。
八、降级预案:AI 挂了你还能不能干活
现在到了运维的核心问题:当 AI 这部分彻底不可用时,你的业务能撑到什么程度?
这个问题的答案必须在出事之前写好,因为出事的当下你没有时间设计它。降级是有层级的,从上到下代价递增:
|
层级 |
手段 |
用户体验 |
什么时候用 |
|
L1 模型降级 |
换更小 / 更快的模型 |
质量下降,但功能完整 |
主模型限流或延迟飙升 |
|
L2 供应商降级 |
切到备用供应商 |
风格略有差异 |
主供应商故障或额度耗尽 |
|
L3 功能降级 |
关掉 AI 特性,回到确定性逻辑 |
功能缺失,但可用 |
所有 AI 通道都不可用 |
|
L4 人工兜底 |
转人工队列 |
慢,但正确 |
降级会导致严重后果的场景 |
关键点在于:L1 和 L2 的"可接受标准"必须提前用数据定义,否则你在事故中切到备用模型,然后祈祷它够好——那不叫降级,那叫赌运气。
|
TypeScript |
|
type Route = { name: string; model: string; provider: 'primary' | 'secondary'; acceptable: (m: { goldenSetPassRate: number; p95Ms: number }) => boolean; }; // 备用路线的准入标准:不是"能跑",而是"跑得够好" const ROUTES: Route[] = [ { name: 'primary', model: 'gpt-x-2026-09-01', provider: 'primary', acceptable: () => true, }, { name: 'secondary', model: 'claude-y-20260514', provider: 'secondary', // 关键:备用路线必须用金标集验证过,且差距在业务可接受范围内 acceptable: (m) => m.goldenSetPassRate >= 0.9 && m.p95Ms <= 4000, }, ]; function pickRoute(metrics: Record<string, { goldenSetPassRate: number; p95Ms: number }>): Route { const primary = ROUTES[0]; if (primary.acceptable(metrics.primary)) return primary; const secondary = ROUTES[1]; return secondary.acceptable(metrics.secondary) ? secondary : { …secondary, name: 'degraded' }; } |
这里的 acceptable 是整段代码的灵魂。它把"备胎能不能用"从直觉变成了一个可测试的断言。你可以在 CI 里定期跑金标集,把结果喂给 acceptable,这样"备用路线当前是否有效"就是一条随时可查的状态,而不是一次事故中的临时判断。
最后一层是 L3,它常被忽略但往往最重要:AI 不可用时,业务回到确定性逻辑能不能走通? 比如你的工单分诊,AI 不可用时能不能退回"按关键词规则分诊"?如果不能,那么你实际上是把关键业务押在了一个你不拥有的服务上。这不是技术问题,是架构决策问题,但它必须在第九十天之前想清楚——因为第九十天之后你就没有从容思考的机会了。
九、金丝雀的陷阱:平均数会说谎
切到备用模型之前,你需要验证它。标准做法是金丝雀发布:拿一小部分流量跑新模型,对比指标,没问题再全量。
但这里有个陷阱,我在模拟数据里把它挑出来了:总体指标提升的模型,可能在你最在意的那类请求上退步。
假设你的工单分诊有四个业务切片,候选模型与线上模型的金标集对比是这样的:
|
业务切片 |
线上模型 |
候选模型 |
差异 |
|
退款类工单 |
94% |
96% |
+2 |
|
物流类工单 |
92% |
95% |
+3 |
|
账号安全类工单 |
98% |
89% |
-9 |
|
其他咨询 |
88% |
91% |
+3 |
|
总体 |
93.0% |
92.8% |
-0.2 |
等一下——第三行那个 -9,被前两行和第四行的提升几乎完全掩盖了。如果只看总体,你会看到 -0.2 个百分点,很容易判断为"在噪声范围内,可以上线"。但账号安全类工单的退步是 9 个百分点,而且这类错误的后果最严重(分错了可能导致安全工单被当成普通咨询处理)。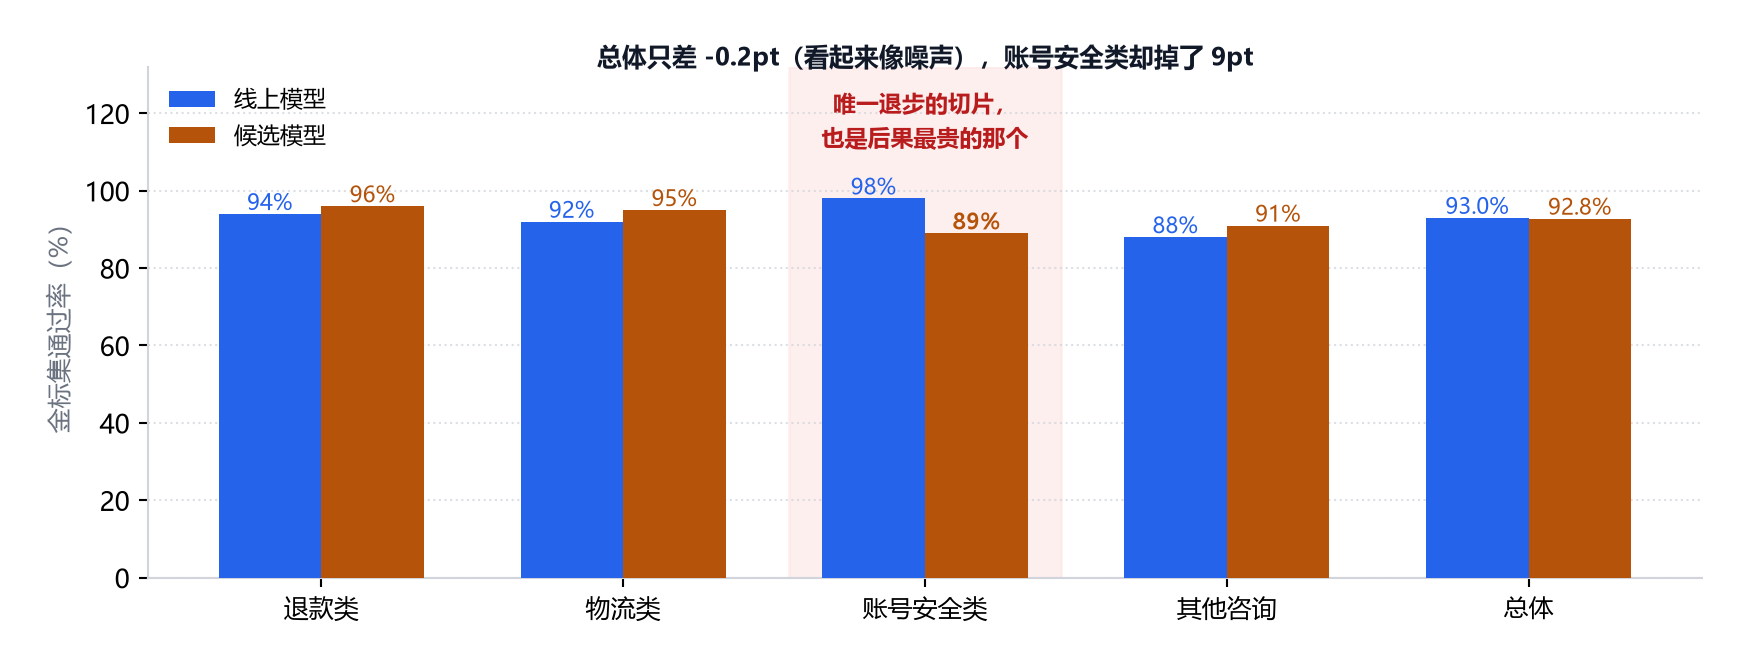 平均数如何掩盖切片回归
这就是那条被很多团队忽略的原则:切片的划分依据必须是"业务后果",而不是"数据类别"。 按数据类别切(工单类型、语言、长度)很自然,但真正该切的是"错了会很贵的那一类"。
一个实用的做法是给切片带上权重,让对比直接反映后果:
|
TypeScript |
|
type Slice = { id: string; weight: number; // 业务后果权重,不是样本占比 cases: EvalCase[]; }; type SliceResult = { id: string; currentPass: number; candidatePass: number; weight: number }; function gateOnSlices(results: SliceResult[]): { ship: boolean; blockers: string[] } { const blockers: string[] = []; // 规则一:任何高权重切片的绝对退步都不能超过 2 个百分点 for (const r of results.filter((x) => x.weight >= 2)) { const delta = r.candidatePass – r.currentPass; if (delta < -0.02) blockers.push(`${r.id} 退步 ${(delta * 100).toFixed(1)}pt(高权重切片)`); } // 规则二:总体加权分不能下降 const wSum = results.reduce((a, r) => a + r.weight, 0); const cur = results.reduce((a, r) => a + r.currentPass * r.weight, 0) / wSum; const cand = results.reduce((a, r) => a + r.candidatePass * r.weight, 0) / wSum; if (cand < cur) blockers.push(`加权总分下降 ${((cand – cur) * 100).toFixed(2)}pt`); return { ship: blockers.length === 0, blockers }; } |
注意规则一是"绝对退步",不是"相对退步"。因为一个从 98% 掉到 89% 的切片,和从 60% 掉到 51% 的切片,掉的是同样的点数,但前者意味着你损失了接近一半的剩余准确率余量。这个区别在小样本上尤其重要。
9.1 怎么区分"漂移"和"噪声"
金标集通过率从 93% 掉到 91%——这是上游变了,还是单纯的抖动?
这个问题必须回答,否则你的漂移告警会淹没在噪声里,一周之后你就会把它静音。有三件事能让判断变得可靠:
第一,尽量压低自身的随机性。 用固定的输入、固定的采样参数,把你自己这边的变量先收干净。但要有个清醒的认识:温度设为 0 不等于确定性输出。浮点运算的顺序、批处理的合并方式、上游的量化策略都可能让同样的输入产生不同的字节。所以你只能降低噪声,消除不了它。
第二,看趋势,不看单点。 单日数据没有判断力,连续多日的同向偏离才有。用基线窗口算出均值和标准差,再要求"连续 N 天低于阈值",误报率会下降一个量级。
第三,也是最有价值的一条:用输出指纹的分布,而不是通过率的均值。 第 10 章提到的 outputHash 在这里派上用场。同一批固定输入,如果过去两周的输出指纹集合和本周的指纹集合几乎不重叠,那不管通过率是多少,上游一定变了。这个证据不需要上游承认,也不需要任何人的配合——它是你自己攒下来的。
|
TypeScript |
|
type Daily = { date: string; passRate: number }; function detectDrift(baseline: number[], recent: Daily[]) { const mean = baseline.reduce((a, b) => a + b, 0) / baseline.length; const sd = Math.sqrt( baseline.reduce((a, b) => a + (b – mean) ** 2, 0) / baseline.length, ); const threshold = mean – 2 * sd; // 连续 3 天低于基线 2 个标准差,才认为是系统性变化而不是抖动 const streak = recent.slice(-3).filter((d) => d.passRate < threshold).length; return { drifting: streak >= 3, detail: `基线 ${(mean * 100).toFixed(1)}% ±${(sd * 100).toFixed(1)}%,` + `阈值 ${(threshold * 100).toFixed(1)}%,近 3 天低于阈值 ${streak} 天`, }; } // 输出指纹集合的重叠度:不依赖上游,自己就能算 function fingerprintOverlap(previous: Set<string>, current: Set<string>): number { let hit = 0; for (const h of current) if (previous.has(h)) hit++; return current.size === 0 ? 0 : hit / current.size; // 接近 1 → 行为稳定;接近 0 → 输出分布整体换了,强漂移信号 } |
fingerprintOverlap 这个函数看起来朴素,但它是整套漂移检测里唯一不依赖上游配合的一环。前面第三节我们已经验证过,上游不上报时 response.modelId 只是一句回声;而当上游不上报时,你的输出指纹仍然在你自己手里。
最后一句话要说清楚:任何阈值都会误报,也会漏报。这不是阈值调得不够好,而是这类问题的本质——你是在用有限的采样去判断一个黑箱的分布有没有变。所以有阈值比阈值精确更重要。没有阈值的时候,你连"在看"这件事都没做到。
十、值班与事故响应:AI 事故的排查顺序
现在把上面所有东西串成一套值班时能用的流程。AI 事故的排查顺序跟传统后端不一样,因为最常见的根因不在你的代码里。
|
示例文本 |
|
第一问:代码变了吗? → 看最近一次部署时间、模型标识的 git diff → 没变?进第二问(这一步就排掉了 80% 的直觉错误方向) 第二问:上游变了吗? → 查 response.headers 里的 request-id,抽 3 条最近的成功调用 → 从 response.body 里读服务端声明的 model 字段,跟你的期望值比对 → 拿到漂移记录?确认是别名重指向还是静默点发布 第三问:是"变差"还是"变慢"? → p95/p99 延迟环比 → 注意:可能是上游换了更慢的模型,而不是你的代码变慢 第四问:影响面多大? → 按业务切片看,不要只看总体 → 找出受影响最贵的那个切片 第五问:要不要降级? → 走 L1 → L2 → L3 的决策树,按预案执行,不要在事故中现场设计 |
这套流程要能跑起来,前提是你的留痕足够。所谓留痕,就是每次调用都要记下这几项:
|
TypeScript |
|
type CallRecord = { requestId: string | null; // 关联键:能凭它去问上游 requested: string; // 你请求的模型标识 served: string | null; // 服务端声明的模型(可能为 null) drifted: boolean; // requested !== served promptHash: string; // 输入指纹,方便回溯"同一个输入变了吗" outputHash: string; // 输出指纹,用于检测同类输入输出漂移 inputTokens: number; cacheReadTokens: number; // 缓存命中情况(下一节详述) latencyMs: number; finishReason: string; abortReason: string | null; // 自己打的标记:user / total-timeout / step-timeout errorClass: string | null; // RetryError 还是 APICallError,决定"是否重试过" }; // 一个最小的落地点:把关键字段写进结构化日志 function recordCall(r: { response: { id?: string; modelId?: string }; usage: { inputTokens: number; inputTokenDetails?: { cacheReadTokens?: number } } }, extra: Partial<CallRecord>) { logger.info('llm.call', { requestId: extra.requestId ?? null, requested: extra.requested, served: extra.served ?? null, drifted: extra.drifted ?? false, promptHash: extra.promptHash, outputHash: extra.outputHash, inputTokens: r.usage.inputTokens, cacheReadTokens: r.usage.inputTokenDetails?.cacheReadTokens ?? 0, latencyMs: extra.latencyMs, errorClass: extra.errorClass ?? null, }); } |
promptHash 和 outputHash 这两项是很多人想不到但特别有用的:当你怀疑漂移却拿不到上游证据时,你自己的输入输出指纹就是唯一的证据。 同一个 prompt 在过去两周的输出指纹分布发生了变化,这个事实不需要上游承认就能成立。
十一、成本与缓存:命中率掉了,可能又是漂移
第九十天你还会遇到一类"看起来是成本问题"的现象:账单悄悄涨了。在没有改代码、没有加流量的情况下,成本上升通常来自两个地方:上游调价,或者你的缓存命中率掉了。
而缓存命中率掉,往往又是漂移的一个可测量信号——因为上游改了路由或者改了缓存策略,你的前缀缓存可能不再命中。
所以先把命中率的计算做对。这里有个我实测出来的坑:AI SDK 的类型声明和运行时字段名不一样。
类型声明里,provider 层的 usage 长这样:
|
TypeScript |
|
inputTokens: { total: number; noCache: number; cacheRead: number; cacheWrite: number } |
但你从 result.usage 拿到的实际结构是这样的(实跑输出):
|
示例文本 |
|
— result.usage — 键 = inputTokens, inputTokenDetails, outputTokens, outputTokenDetails, totalTokens JSON = {"inputTokens":10000,"inputTokenDetails":{"noCacheTokens":2000,"cacheReadTokens":7000,"cacheWriteTokens":1000},"outputTokens":300,"outputTokenDetails":{"textTokens":300,"reasoningTokens":0},"totalTokens":10300} |
注意两处差别:inputTokens 是一个数字,不是对象;缓存明细被挪到了 inputTokenDetails 里,并且改名成了 cacheReadTokens / cacheWriteTokens / noCacheTokens。
如果你照着类型声明写 usage.inputTokens.cacheRead,你会拿到 undefined,然后命中率算出来是 NaN,而 NaN 在大多数监控系统里会安静地被丢弃——你的命中率看板会显示"无数据",而不是报错。这就是典型的"静默失败"在你自己的代码里重演。
正确的算法:
|
TypeScript |
|
function cacheHitRate(usage: { inputTokens: number; inputTokenDetails?: { cacheReadTokens?: number; cacheWriteTokens?: number }; }): { rate: number | null; caveat: string | null } { const read = usage.inputTokenDetails?.cacheReadTokens ?? 0; const write = usage.inputTokenDetails?.cacheWriteTokens ?? 0; if (!usage.inputTokens || usage.inputTokens <= 0) { return { rate: null, caveat: '无输入 token,无法计算' }; } if (read === 0 && write === 0) { // 关键:0 命中率有两种可能,必须区分 return { rate: 0, caveat: '无缓存明细:可能是上游不上报,也可能是真的没命中' }; } return { rate: read / usage.inputTokens, caveat: null }; } |
caveat 这个字段不是啰嗦。cacheReadTokens 全为 0 时,"真的没命中"和"上游根本不上报缓存字段"是两件完全不同的事,前者要你去优化 prompt 结构,后者要你去换供应商或者别再看这个指标。如果你的看板把它们合并显示成 0%,你会在一个假的数字上做决策。
盯命中率的时候,把它和另外一个指标放在一起看会更有信息量:
|
现象组合 |
可能原因 |
动作 |
|
命中率下降 + 成本上升 |
前缀缓存失效( prompt 结构被改动) |
检查 prompt 前缀是否稳定 |
|
命中率下降 + 成本上升 + 延迟变化 |
上游换了路由或模型 |
查漂移记录 |
|
命中率不变 + 成本上升 |
上游调价,或输 token 变多 |
对账单价,检查输出长度分布 |
|
命中率显示为 0 且恒定不动 |
可能压根拿不到缓存字段 |
换供应商或改用其它口径 |
第一列和第二列看起来很像,区别在于有没有伴随延迟变化。延迟变了,说明执行路径变了(模型或路由换了);延迟不变,说明只是计价变了。这个判断方法比去读 changelog 快。
十二、第 90 天检查清单
把上面所有内容压成一份可以照着做的清单。建议每季度跑一次,尤其是你不打算近期改动 AI 功能的时候——恰恰是没人动它的时候,它最容易悄悄坏掉。
可见性(能不能发现)
- [ ] 每次调用都记录了 requested / served / drifted 三元组
- [ ] served 取不到时归入 unknown,而不是当作"没漂移"
- [ ] unknown 占比有单独看板(这是你的"可见度余量")
- [ ] 记录了上游 request-id,能凭它回溯单次调用
- [ ] 对所有中断都打了来源标记(user / total-timeout / step-timeout)
- [ ] promptHash + outputHash 已入库,可用于无上游配合时的漂移举证
生命周期(会不会被下线)
- [ ] 生产环境全部使用精确快照,无浮动别名
- [ ] 代码库里所有模型标识都收口在一个注册表文件
- [ ] 注册表里每个模型都有 pinnedOn 和 sunsetWatch 链接
- [ ] 有一个定时任务去抓取供应商的弃用页,与注册表做交集告警
- [ ] 备用供应商现在就选好了,不在事故中现选
韧性(坏了能不能撑住)
- [ ] maxRetries 是显式配置的,不是靠默认值
- [ ] 有副作用的链路重试次数压到最低,且带幂等键
- [ ] 每个模型调用链都有 totalMs 上限
- [ ] 有租户级或链路级的配额闸门,拒绝发生在上游之前
- [ ] L1/L2/L3 三级降级预案已写,且 L2 的准入标准是金标集断言
质量(变差了知不知道)
- [ ] 金标集会定期跑线上模型(不只是发版前)
- [ ] 切片按业务后果划分,高权重切片有独立退步阈值
- [ ] 比较用的是任务级断言,不是文本相似度
- [ ] 缓存命中率口径已核对(含"拿不到字段"与"真的没命中"的区分)
尾声:你运维的其实是"你不拥有的那一半"
前五篇我们一直在解决"怎么把 AI 功能做出来、做好"。这一篇的视角是反过来的:做出来之后,你要为一些你控制不了的东西负责。
这个处境在软件工程里并不新鲜。你依赖的每一个 SaaS 都会变,每一个第三方 API 都可能退役。区别在于,传统依赖的变化通常是接口层面的——字段多了、方法废弃了、端点下线了,这些变化会以明确的错误形式撞到你脸上。
而模型的变化是语义层面的。接口一模一样,返回 200,字段齐全,只有答案不一样了。
这就决定了一件事:对 AI 系统来说,"能跑"不代表"在正常工作"。你必须自己造出"它还正常吗"的判据,然后让它定期回答这个问题。
第 90 天不是终点,它只是第一个"你已经忘了它有多脆弱"的时间点。真正的好消息是:上面那些传感器一旦装上,你能看到的东西会比传统后端多得多——因为你在用输出指纹、切片通过率、缓存命中率这些比 HTTP 状态码丰富得多的信号。
坏消息是,没有人会替你装。


评论前必须登录!
注册