 网硕互联帮助中心
阅读英文论文时,我们经常需要在 PDF、翻译工具和笔记之间来回切换。遇到公式、图表和双栏排版,直接复制文字还容易出现顺序混乱。
**Zotero PDF2zh 可以把整篇 PDF 的翻译功能接入 Zotero。**我们可以从文献库中直接发起翻译,生成译文或双语对照文件,同时尽量保留论文原来的排版与公式。
本文以 Windows 本地安装为例,介绍这个插件的基本原理、安装配置和使用方法。
zotero和PDF2x百度网盘链接:(版本要配对好 PDF2z是不断更新的 可以去github上查阅相关资料)http://通过网盘分享的文件:Zotero文档翻译插件【超推荐】 链接: https://pan.baidu.com/s/1UL4DXZEu1hnR30QyN19cJQ?pwd=b3gq 提取码: b3gq –来自百度网盘超级会员v5的分享
一、项目地址与工作方式
项目入口:
-
GitHub 项目:guaguastandup/zotero-pdf2zh
-
插件与后端下载:Releases
-
中文使用文档:Zotero PDF2zh
这个工具主要由三个部分组成:
| Zotero 插件 | 提供翻译菜单和配置界面 |
| Python 后端 | 接收任务并调用 PDF 翻译引擎 |
| 翻译服务 | 通过机器翻译或大模型完成文字翻译 |
因此,安装插件后,还需要运行后端并配置翻译服务。翻译期间,后端程序要保持运行。
这里需要分清两个概念:pdf2zh、pdf2zh_next 是处理 PDF 的翻译引擎;配置的大模型 API 等则是负责翻译文字的服务。
二、一键式安装
1. 安装插件

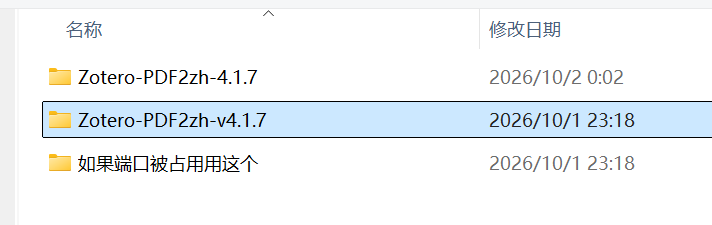
打开第一个文件
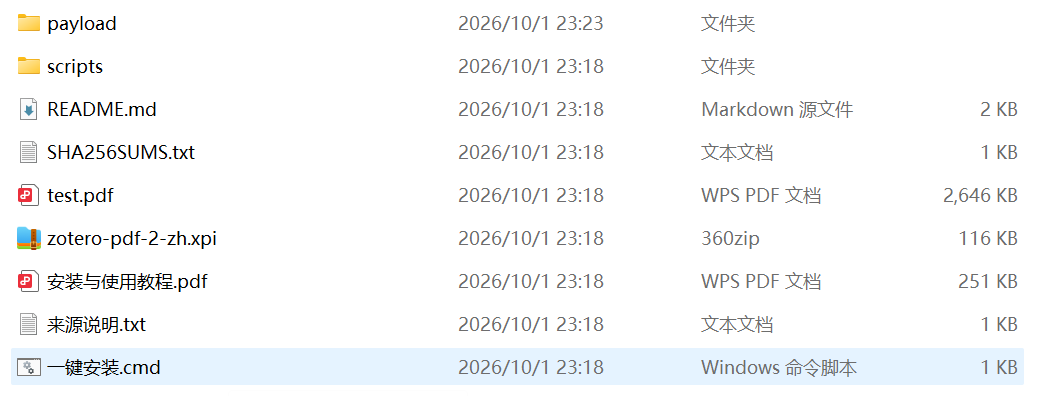
点击一键安装(时间会有点久 毕竟一个多G)
等安装好后会有提示
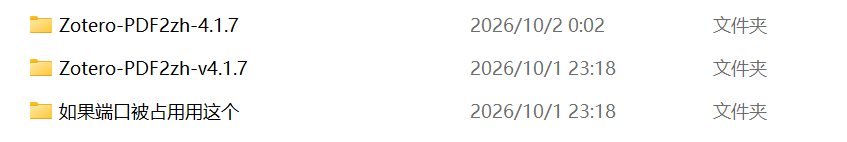
安装好后 会多出一个文件
2. 导入插件到zotero里面
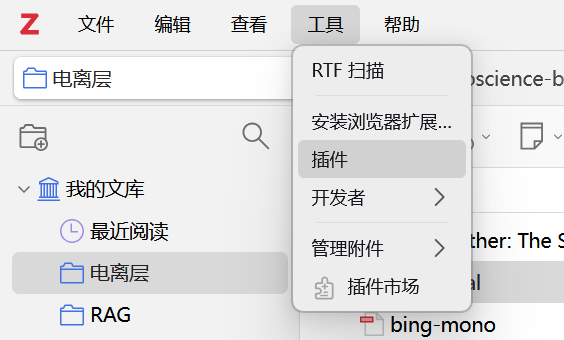
打开zotero 点击工具->插件
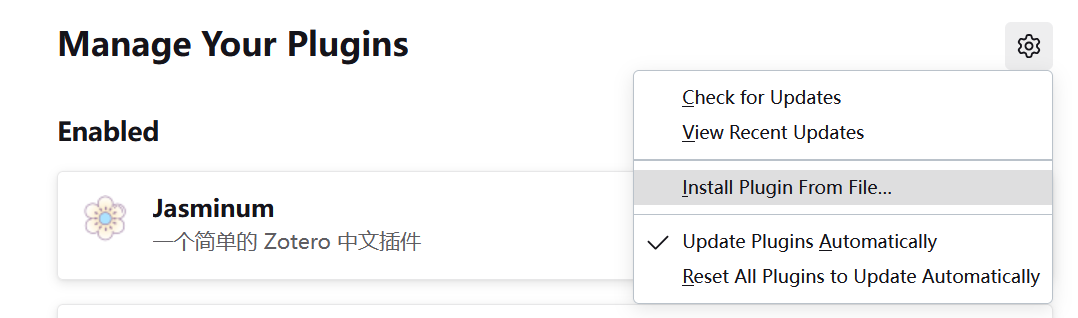
右上角小齿轮->Install Plugin From File…
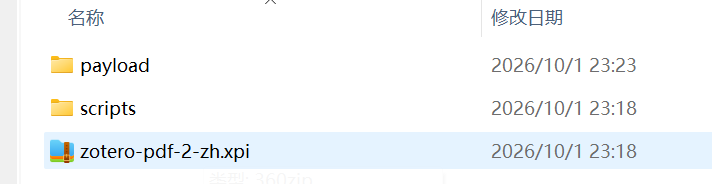
选择xpi文件导入进去就行
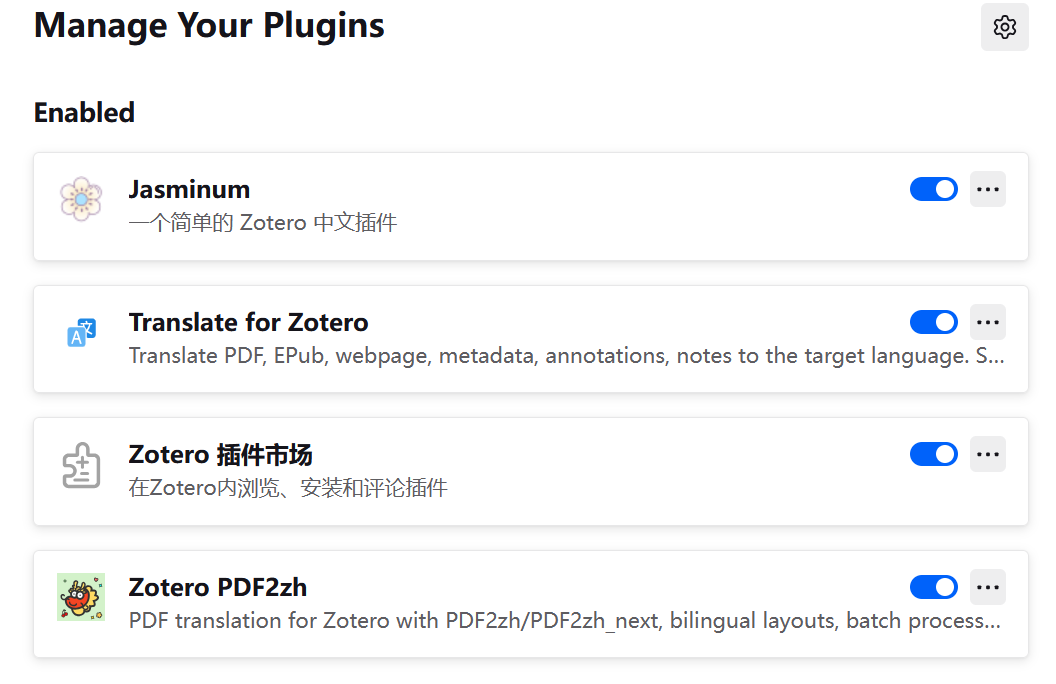
就成功啦!!!
三、使用插件
1. 启动服务
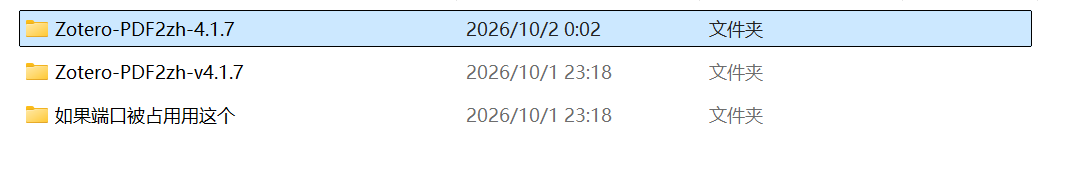
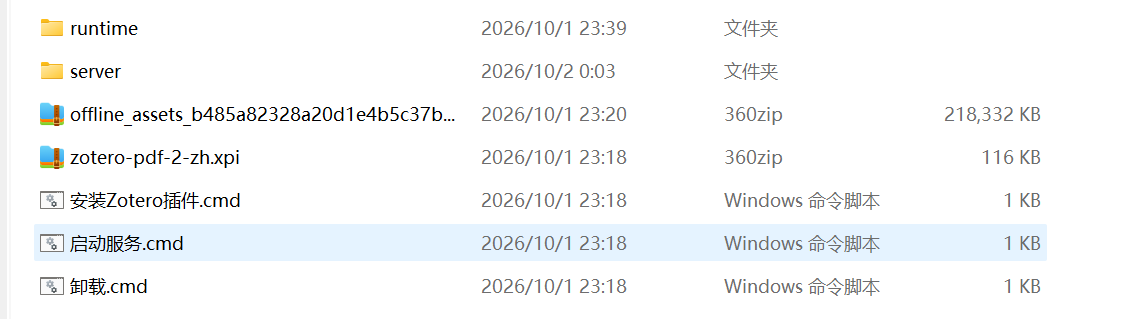
双击启动服务即可
2. 简单介绍使用流程
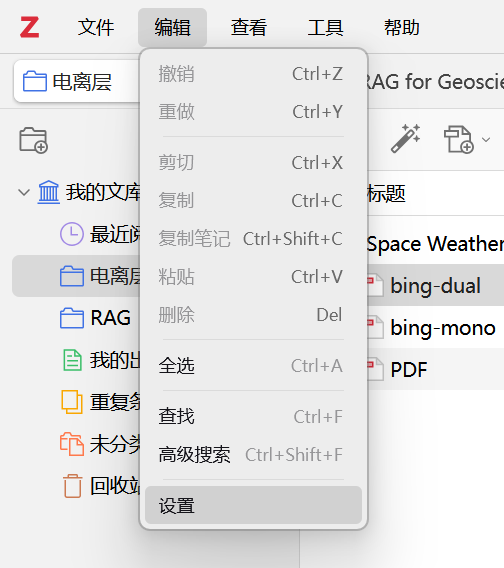
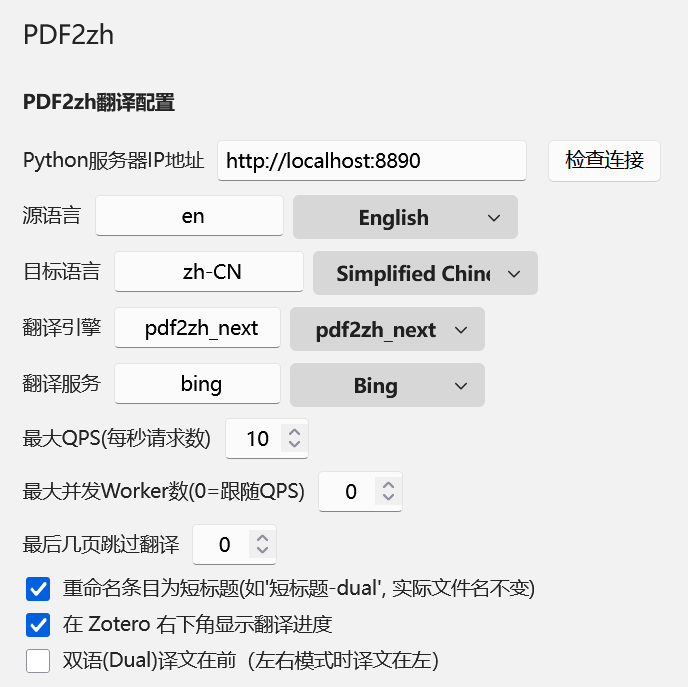
翻译服务和最大QPS是可以改的 其他的不要变动(可以把图喂给AI熟知功能)
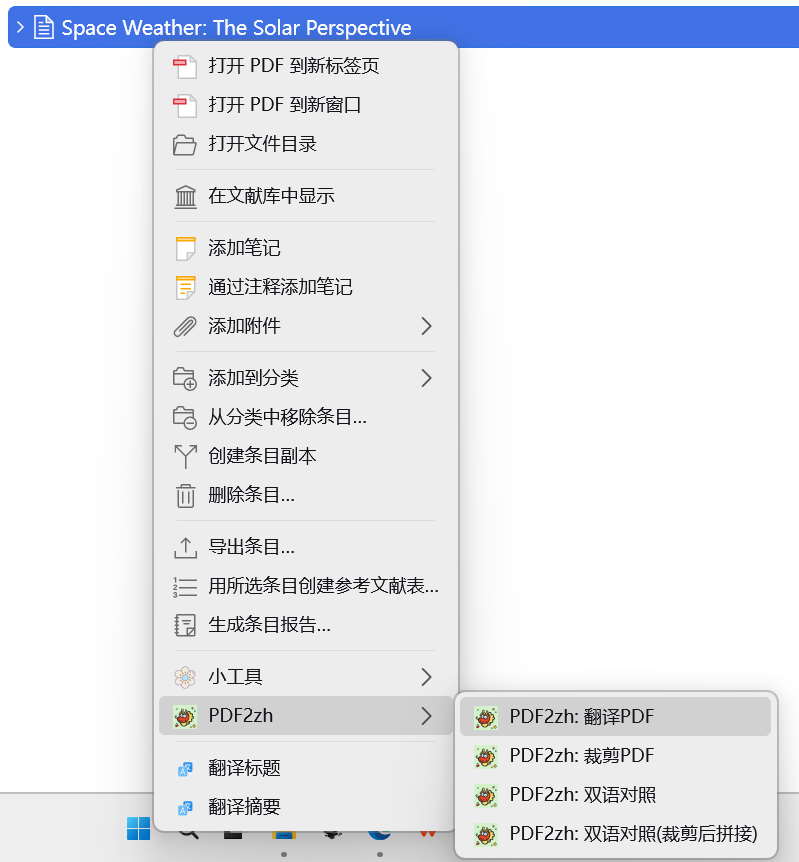
右键要翻译的文章 选择PDF2zh进行翻译即可
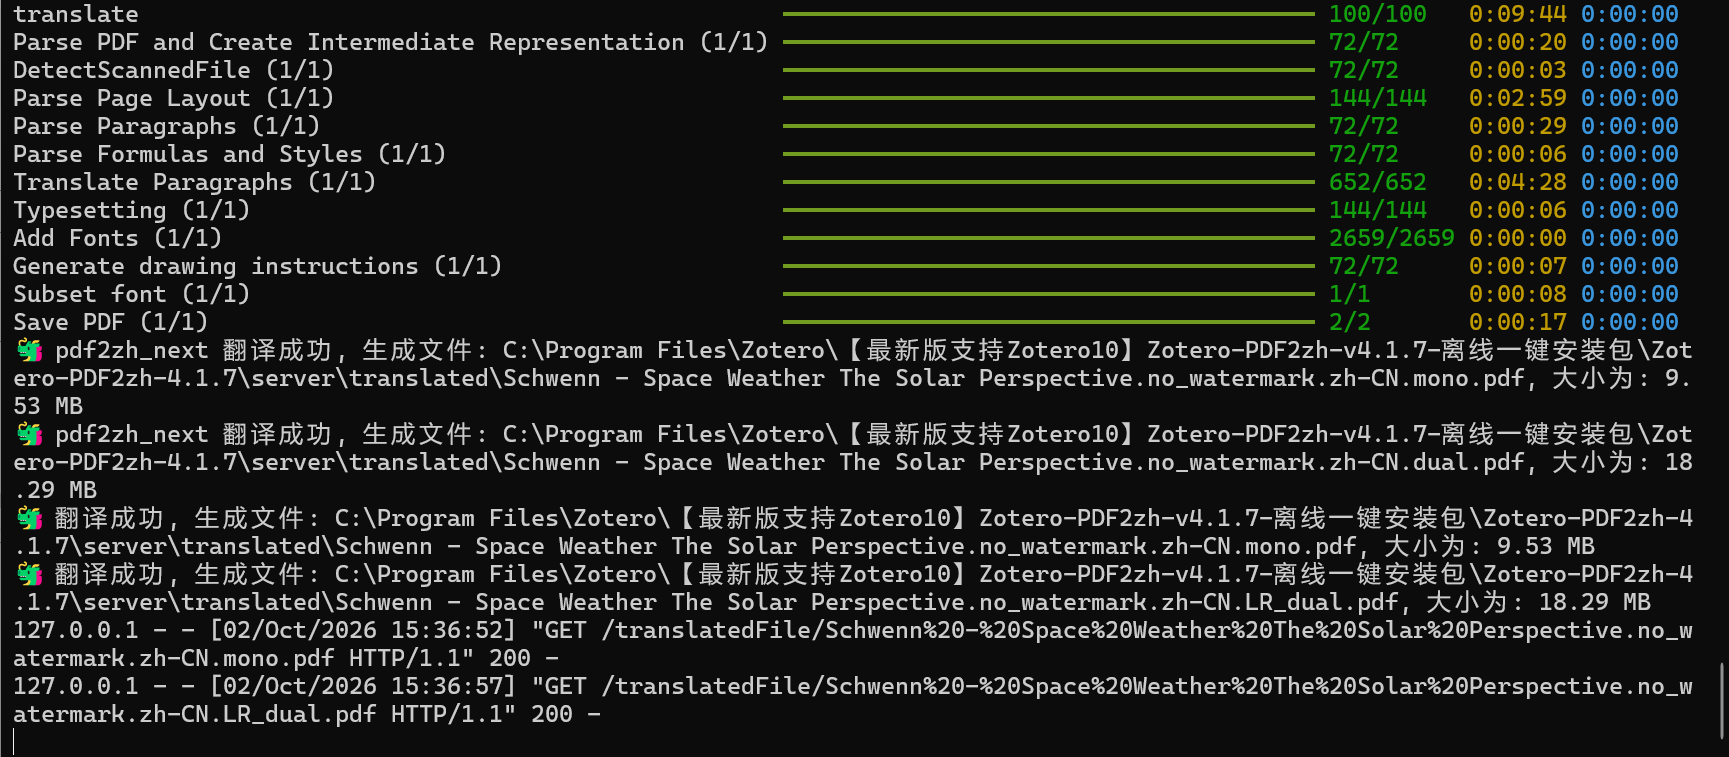
可以在终端看到翻译流程 翻译完成后会有显示
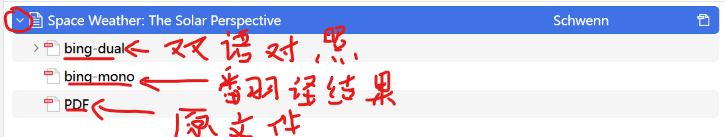
会有三种模式
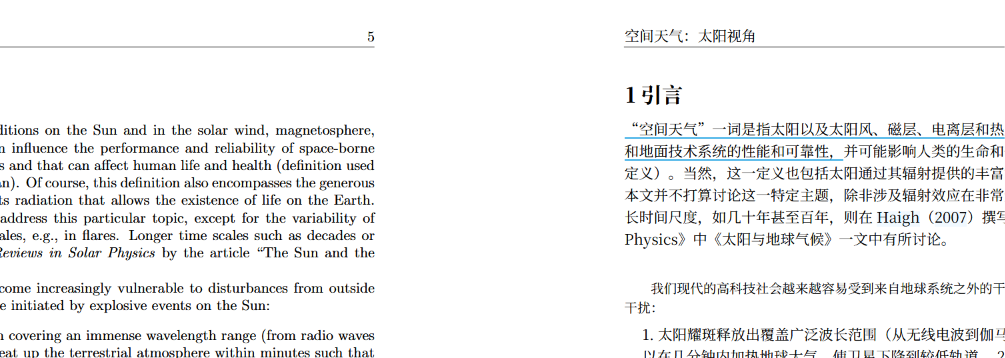
这里展示bing-dual模式
3. 选择翻译引擎和服务(感兴趣可以看看或者觉得免费的翻译引擎不好)
插件支持 pdf2zh 和 pdf2zh_next。第一次使用可以先尝试 pdf2zh_next,用一篇短论文验证效果。
如果使用自己的 API,在“LLM API 配置管理”中新增配置:
| 服务类型 | 对应的服务商或兼容接口类型 |
| URL | 服务商提供的 API 地址 |
| API Key | 自己的 API 密钥 |
| Model | 服务商支持的模型名称 |
**保存并激活配置后,还要在“翻译服务”下拉菜单中选择对应服务。**仅新增 API 配置,并没有完成全部设置。
文档也提供了 pdf2zh_next 搭配 siliconflowfree 的免 Key 使用方式,但提醒它可能出现漏译。实际可用性以服务状态为准。
四、如何翻译论文
在 Zotero 中选中论文条目或 PDF 附件,右键打开 PDF2zh 菜单,选择所需功能。
| 翻译 PDF | 按设置生成翻译文件 |
| 双语对照 | 同时查看原文与译文 |
| 裁剪 PDF | 调整页面,方便小屏幕阅读 |
| 双语对照(裁剪) | 针对双栏论文调整对照布局 |
| 批量翻译 | 多选条目后统一发起翻译 |
“双语对照(裁剪)”针对双栏论文,使用前应先确认原文布局。
对于科研阅读,建议先使用双语对照:借助译文理解段落,再回到英文核对专业术语、实验条件和关键结论。
五、常见问题与解决思路
1. 服务器连接失败
先检查后端终端是否仍在运行,以及插件地址与后端端口是否一致。再查看终端报错、端口占用和防火墙设置。
如果需要换端口,可以执行:
uv run –python 3.12 –with-requirements requirements.txt server.py –port=9999
同时将插件地址改为:
http://127.0.0.1:9999
后端与插件的端口必须一致。
2. 连接成功,但翻译失败
继续检查 API 配置有没有保存、激活并选中,以及 Key、URL 和模型名称是否正确。
终端日志通常能提供更具体的原因。文档列出的常见情况之一,就是已经填写 API Key,却没有激活配置或选择对应服务。
3. 出现漏译或术语错误
翻译效果受到服务质量、专业术语和 PDF 结构影响。可以先换一篇结构简单的论文测试,判断问题是否与原文件有关。
重要内容仍应对照原文核查,尤其是数字、否定表达、公式变量和结论成立的条件。
4. 扫描 PDF 无法正常处理
扫描文件还涉及 OCR 文字识别。项目 README 与部分文档页面对 OCR 的描述存在版本差异,应查看所安装版本的说明,确认是否需要先进行 OCR。
5. Token 消耗较多
论文长度、术语表提取和重复处理都可能增加消耗。建议先翻译一篇短论文,查看服务商后台的实际用量,再开始批量任务。
六、把插件融入文献阅读
日常使用时,可以先读标题和摘要,筛选值得深入阅读的论文,再生成双语文件。阅读过程中,用自己的话记录研究问题、方法、实验结果和局限。
如果用于英文翻译练习,也可以先自己翻译摘要,再与插件译文比较,重点检查专业词汇和长句结构。
Zotero PDF2zh 能减少翻译与切换页面的操作,让更多时间留给论文内容。阅读之后,可以尝试回答三个问题:这篇论文解决了什么问题,方法为什么有效,实验支持了哪些结论?


评论前必须登录!
注册