 网硕互联帮助中心
【老计带你懂AI算法】14:CNN卷积神经网络,让机器学会看图的功臣
开头:机器是怎么看懂图的
手机人脸解锁、拍照搜题、医学影像辅助诊断、自动驾驶识别红绿灯,这些让机器"看懂"图像的能力,背后头号功臣就是CNN(卷积神经网络,Convolutional Neural Network)。
上一篇讲了神经网络的基础。你可能会想,图像不也是一堆数字(像素)吗,直接把它们拉平了喂给上一篇那种普通全连接网络不就行了?理论上行,但实际效果差、代价大。CNN就是为了解决"怎么高效又聪明地处理图像"而生的。这一篇讲清它凭什么这么擅长看图。
普通网络看图,为什么力不从心
先说清楚普通全连接网络处理图像的两个大问题,这样你就明白CNN为什么必须存在。
第一个问题,参数爆炸。 一张不大的彩色图片,比如1000乘1000像素,就有一百万个像素点、三个颜色通道,也就是三百万个输入。如果第一层隐藏层有一千个神经元,光这一层的连接权重就是三百万乘一千,三十亿个参数。这还只是第一层,根本训练不动、也存不下。
第二个问题,丢掉了图像的结构信息。 把图像拉平成一长条数字,就把像素之间的空间关系彻底打乱了。可图像的意义恰恰藏在空间结构里,相邻的像素才构成边缘、构成物体,隔得远的像素基本没关系。把图拉平,等于把这个宝贵的结构信息扔了。
CNN的全部聪明之处,就是针对图像这两个特点,做了两个关键的设计,既大幅减少参数,又保住空间结构。 这两个设计就是卷积和池化。
卷积:用一个小窗口滑过全图找特征
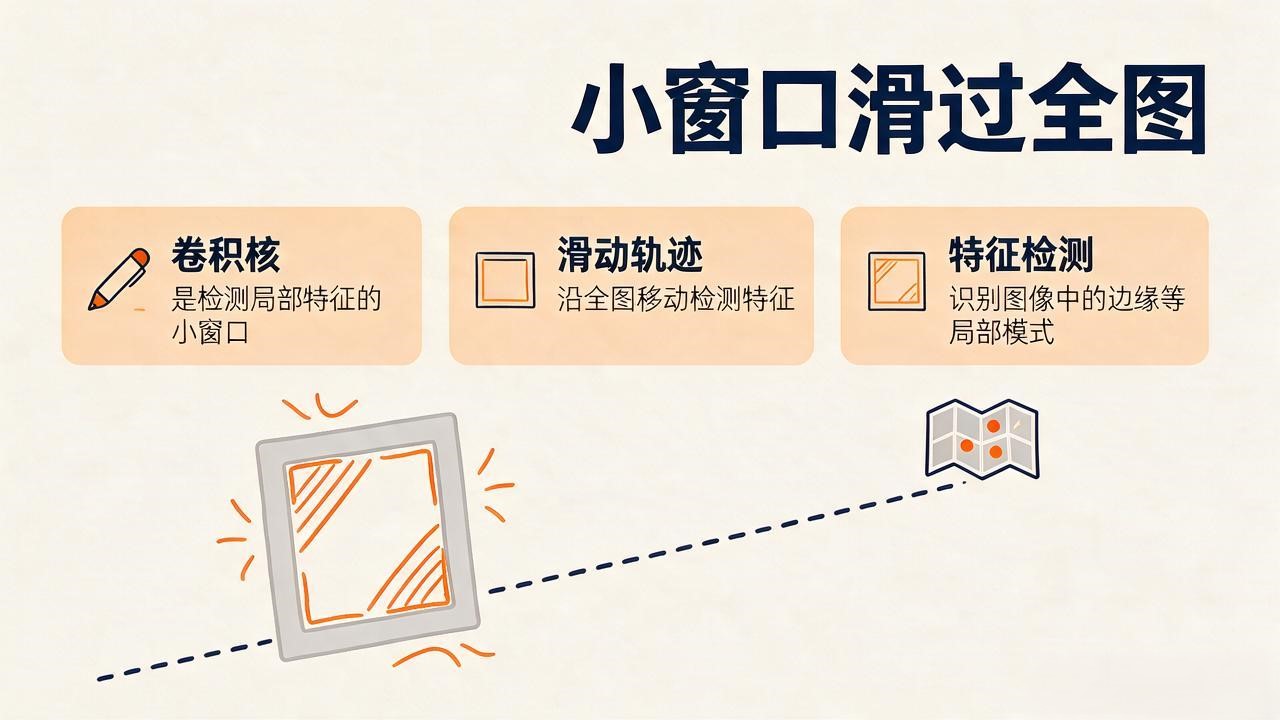
CNN的核心操作叫卷积,名字唬人,理解了特别简单。
想象你手里有一个小放大镜(术语叫卷积核,就是一个小的数字方块,比如3乘3),你拿着它从图像的左上角开始,一格一格地滑过整张图,每滑到一个位置,就用这个小窗口去和它覆盖的那一小块像素做个计算,看看这一小块像不像某种特定的图案(比如一条竖边、一个拐角)。
这个小窗口,其实就是一个"特征探测器",专门负责在全图范围内寻找某一种局部特征。 比如有的卷积核专门找横线,有的专门找竖线,有的找特定颜色的斑块。它滑过全图,就生成一张"这种特征在图上哪里出现了"的地图(术语叫特征图)。
这个设计巧妙在哪?看两点:
- 参数极少。 无论图多大,一个卷积核就那么几个数字(3乘3才9个),它靠"滑动"覆盖全图,而不是给每个像素配一套独立的权重。这就把参数从几十亿砍到了几十几百,参数爆炸问题迎刃而解。
- 保住了空间结构、还自带一个绝招叫平移不变性。 因为同一个卷积核滑过全图,所以不管那个特征(比如一只猫的耳朵)出现在图的左上角还是右下角,都能被同一个探测器抓到。猫在图里哪个位置,它都认得,这就是平移不变性,对图像识别太重要了。
打个比方:你在一大片人群照里找戴红帽子的人,你不会给照片每个位置都培训一个专职观察员,而是拿一个"红帽子识别标准",用眼睛扫过整张照片,扫到哪儿看到哪儿,红帽子无论在哪都能被你发现。 卷积核就是这个"扫过全图的识别标准"。
池化:抓住重点,缩小尺寸
卷积之后,通常跟一个叫池化的操作,它的作用是在保留重要信息的前提下,把特征图缩小。
最常用的是最大池化,做法很简单:把特征图分成一个个小区域,每个区域只保留最大的那个值(也就是这一小片里特征响应最强的信号),其余丢掉。
这么做有两个好处。一是缩小了数据尺寸,让后续计算量减少、速度更快。二是带来一点鲁棒性,图像稍微挪动、抖动一点,最强的那个信号大概率还在这个小区域里,池化结果不变,让识别更稳。
打个比方:你向别人转述一间屋子里最重要的东西,不会逐一描述每个角落的每件物品,而是每个区域挑最显眼的说,这样既抓住了重点,描述也精简了。 池化就是这种"每个小区域挑最强信号"的抓重点操作。
层层堆叠:从线条认到整张脸
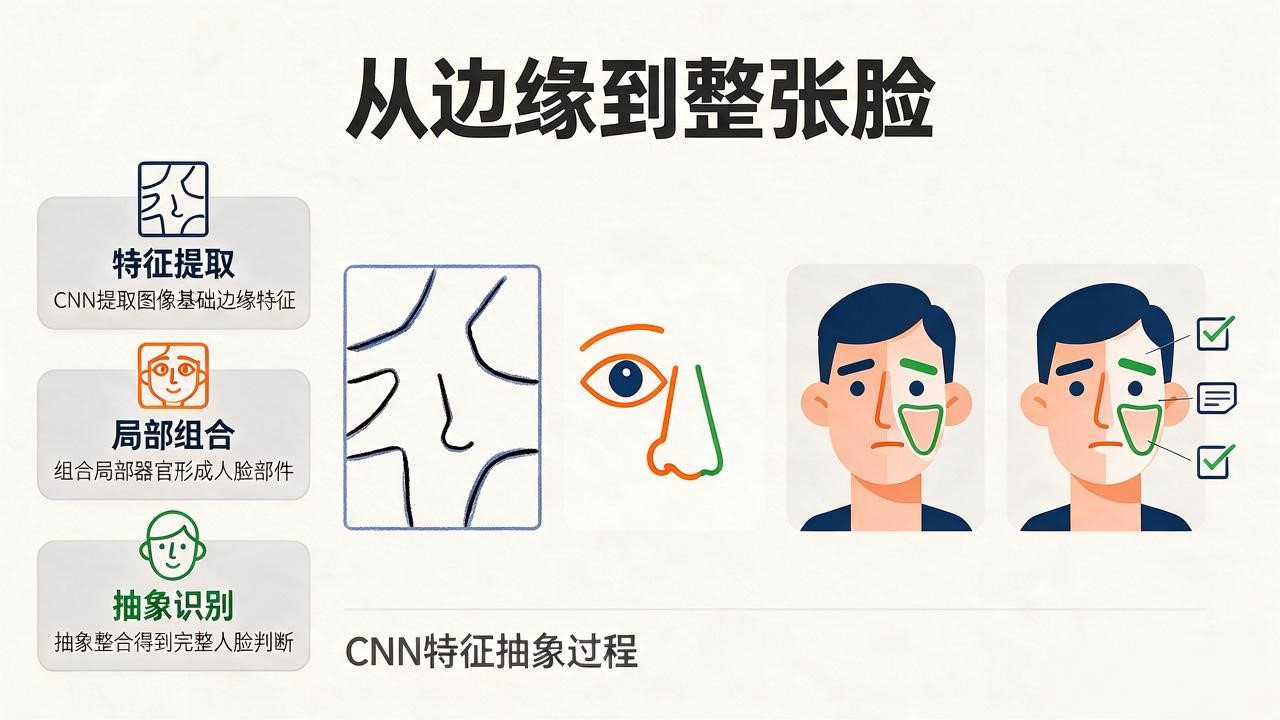
CNN的威力,在于把"卷积加池化"这样的组合,一层层堆叠起来。
前面的层看到的是局部小特征,越往后的层,看到的范围越大、特征越抽象。 这就回到了上一篇讲的"逐层抽象",在图像上体现得淋漓尽致:
- 第一层卷积:认出最基础的边缘、线条、颜色块。
- 中间层:把边缘线条组合成眼睛、鼻子、轮子这样的局部部件。
- 后面的层:把部件组合成完整的人脸、汽车、猫。
- 最后接上全连接层:根据这些高级特征,判断这张图到底是什么。
你不需要告诉CNN什么是眼睛、什么是猫,你只要给它看足够多标注好的图片,它自己就会在训练中,一层层学出从线条到部件到整体的这套特征体系。 这就是深度学习端到端自动学特征的魅力,也是它彻底改变计算机视觉的原因,在CNN之前,图像特征都要靠人手工设计,又难又不好用。
这里要引出一个在实际中极其重要、也极其省钱的技巧,迁移学习。前面说训练CNN需要大量数据和算力,可现实中你未必有几百万张标注图片、也未必有那么多GPU,怎么办?答案是站在巨人肩膀上。那些在海量图片(比如上百万张的ImageNet)上训练好的成熟CNN模型(如ResNet),它前面那些层学到的边缘、纹理、部件等基础特征,是通用的,换个任务照样管用。 于是你可以直接拿一个预训练好的模型,保留它前面学好的特征提取部分,只把最后的分类层换成你自己的任务、用你少量的数据微调一下,就能得到一个效果很好的模型。
打个比方,这就像招一个已经有多年经验的老师傅,他对这行的基本功早就烂熟于心,你只需要花很少时间教他你们厂的特定产品,他很快就能上手,而不用从头培养一个学徒。 迁移学习让没有海量数据和算力的普通团队,也能用上强大的深度模型,是深度学习能广泛落地的关键一环,这个"预训练加微调"的思路,后面讲大模型时你会看到它被发扬到极致。
输入和输出长什么样
- 输入:图像,通常是一个三维的数字块(高、宽、颜色通道),CNN能直接吃这种带空间结构的数据,不用拉平。
- 输出:看任务而定。图像分类输出各类别的概率(这是猫的概率90%);此外CNN还能做目标检测(框出图里的物体在哪)、图像分割(精确到每个像素属于什么)等更复杂的视觉任务。
上代码:搭一个识别手写数字的CNN
用PyTorch搭一个小CNN识别手写数字。输入:手写数字图像。输出:0到9的类别。
# 依赖:pip install torch torchvision
import torch
import torch.nn as nn
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
# 加载MNIST手写数字数据集(28×28的灰度图)
transform = transforms.ToTensor()
train_data = datasets.MNIST(root="./data", train=True, download=True, transform=transform)
train_loader = DataLoader(train_data, batch_size=64, shuffle=True)
# 定义一个小CNN
class SmallCNN(nn.Module):
def __init__(self):
super().__init__()
self.conv1 = nn.Conv2d(1, 16, kernel_size=3, padding=1) # 卷积:1通道进,16个卷积核
self.conv2 = nn.Conv2d(16, 32, kernel_size=3, padding=1) # 第二层卷积
self.pool = nn.MaxPool2d(2, 2) # 最大池化,尺寸减半
self.fc = nn.Linear(32 * 7 * 7, 10) # 全连接层,输出10类
self.relu = nn.ReLU()
def forward(self, x):
x = self.pool(self.relu(self.conv1(x))) # 卷积->激活->池化
x = self.pool(self.relu(self.conv2(x))) # 再来一组
x = x.view(x.size(0), –1) # 拉平,准备进全连接
return self.fc(x) # 输出10个类别的分数
model = SmallCNN()
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
# 训练一个epoch(演示,实际会训练多轮)
model.train()
for i, (imgs, labels) in enumerate(train_loader):
pred = model(imgs) # 前向
loss = loss_fn(pred, labels) # 算损失
optimizer.zero_grad()
loss.backward() # 反向传播
optimizer.step() # 更新权重
if i % 200 == 0:
print(f"第{i}批 损失: {loss.item():.4f}")
if i >= 400: # 演示只跑一部分
break
print("训练完成,这个小CNN已能识别手写数字")
运行输出(示例,训练有随机性,损失数值每次不同):
第0批 损失: 2.3018
第200批 损失: 0.1873
第400批 损失: 0.0994
训练完成,这个小CNN已能识别手写数字
运行你会看到损失快速下降。注意网络结构里卷积、ReLU激活、池化的组合堆叠,正是上面讲的CNN套路;训练循环还是上一篇那个前向、损失、反向传播、更新的四步,说明CNN只是把普通网络的全连接层换成了更适合图像的卷积层,学习机制完全一样。
关键概念
- 卷积核大小:小窗口多大,常用3乘3,决定一次看多大范围。
- 通道数:一层用多少个卷积核(即找多少种不同特征),越多能力越强也越重。
- 步长与填充:控制窗口怎么滑、边缘怎么处理,影响特征图尺寸。
- 经典网络:LeNet、AlexNet、VGG、ResNet是CNN发展史上的里程碑,其中ResNet的残差连接解决了网络太深难训练的问题,让上百层的网络成为可能。
优缺点与适用场景
优点:为图像量身定做,参数少、保留空间结构、有平移不变性,图像任务上碾压普通网络;能自动学特征,免去人工设计。缺点:需要较多数据和算力训练;主要针对有网格结构的数据(图像),不是万能的。
适合场景:几乎所有图像和视频任务(分类、检测、分割、人脸识别、医学影像),也被用在有局部结构的其他数据上(如某些音频、文本任务)。不适合:没有空间局部结构的普通表格数据(那还是树模型的天下)。
值得说一句CNN在真实世界里的分量。它几乎重塑了整个计算机视觉行业。 你手机相册能自动按人脸、按场景归类照片,是它;医院里辅助医生从X光片、CT里发现病灶的系统,很多以它为核心,在某些细分任务上已能达到甚至超过普通医生的识别水平;自动驾驶汽车实时识别车道线、行人、车辆、红绿灯,靠的也是它;工厂质检自动挑出有瑕疵的零件、农业上识别病虫害、安防里的图像分析,处处都有它的身影。可以说,凡是需要机器"看"的地方,过去这十来年基本都是CNN在扛大梁。 虽然近年Transformer也开始进军视觉领域(后面会讲到的ViT),但CNN凭借它为图像量身定做的高效结构,依然是视觉领域最重要、应用最广的基石之一,值得每个想懂AI的人认真理解。
小结与承上启下
- CNN为图像而生:解决普通网络处理图像的参数爆炸和丢失结构两大问题。
- 卷积:小窗口滑过全图找局部特征,参数少、保结构、有平移不变性。
- 池化:每个小区域挑最强信号,缩小尺寸、抓重点、增鲁棒。
- 层层堆叠:从边缘到部件到整体,自动学出特征体系,端到端不用人工设计特征。
CNN擅长处理图像这种有空间结构的数据。可还有一类数据,它的关键不在空间,而在顺序和前后依赖,比如一句话、一段语音、一串时序。处理这种序列数据,需要另一种带记忆的网络。下一篇我们讲RNN和它的升级版LSTM、GRU,看看网络怎么拥有记忆。
我们下一篇见。
延伸阅读
- PyTorch 官方文档:卷积层:https://pytorch.org/docs/stable/nn.html
- 《动手学深度学习》卷积神经网络章节:https://zh.d2l.ai
- ResNet 原始论文《Deep Residual Learning for Image Recognition》(He等,2015):https://arxiv.org/abs/1512.03385
(说明:以上为官方与经典公开资料地址,可能随版本调整,如打不开可用标题搜索。)


评论前必须登录!
注册