 网硕互联帮助中心
重磅!以公路交通事件检测后处置分级为例,尝鲜开源版 Jev!
一句话剧透:那个"只判断、不写作文"的 AI 模型 Jev,官方 API 未向中国大陆开放、也没开源——但开源社区三天就交出了 Apache-2.0 的完整复刻 Laya。本文不聊概念(概念看这篇 👉 《火爆全网的 Jev,公路交通到底能拿来干嘛?》),直接带你在自己电脑上把 Laya 跑起来,拿"公路交通事件检测后处置分级"这个真实业务场景,从头到尾走一遍:装环境、写代码、跑数据、看结果、踩坑、再到安全兜底。所有数字都是我本机实测,不是抄官方宣传。
先扔两个钩子,你猜猜看:
- Laya 在本机 Mac 上,单次决策只要 约 47 毫秒,比官方云端 API(网络往返主导)快一个数量级;
- 但零样本直接拿去判"Ⅰ/Ⅱ/Ⅲ/Ⅳ 级处置",准确率居然和"闭眼全选Ⅳ级"一样——这背后藏着决策模型落地的最大真相。
读完这篇,你会得到一个能直接复制粘贴的完整 Demo,和一个"哪些活能交给它、哪些活打死不能"的清醒判断。
一、先交代:为什么我们只能玩"开源版 Jev"
先对齐一个基本盘。
Jev 是旧金山 TypeSafe AI 在 2026 年 9 月 15 日发布的"System One 决策模型":它不生成文本,只返回结构化的判断——Choice(选项里挑一个)、Score(按标准打分)、Noul(是/否概率)。输入约 $0.042 / 百万 token,输出免费。
但它有两个对我们来说很要命的现实:
对公路交通这种要"边缘、本地、数据不出机房"的场景来说,这两条等于把它挡在了门外。好在——9 月 18 日,也就是 Jev 发布三天后,社区独立研究者 Nandakishor M(Convai Innovations)交出了开源复刻 Laya:
| 厂商 | TypeSafe AI | Convai Innovations(社区) |
| 发布时间 | 2026-09-15 | 2026-09-18(3 天后) |
| 协议 | 闭源,仅 API | Apache-2.0(代码+权重全开) |
| 架构 | 未公开 | 非自回归,单次前向,零输出 token |
| 权重 | 无 | Hugging Face 全量开源 |
| 费用 | $0.042/百万 token | 本地免费 |
Laya 有三个 checkpoint,内置路由器按"文字脚本"自动挑一个:
| convaiinnovations/laya | ModernBERT-large | 421M | 512 | 英文 |
| convaiinnovations/laya-multilingual | mmBERT-base | 322M | 1024(可到 8192) | 100+ 语言,含中文 |
| convaiinnovations/laya-typed-decisions | ModernBERT-large | 421M | 1024 | typed-decisions 微调版 |
⚠️ 划重点:中文业务必须走 laya-multilingual。英文 checkpoint 对非拉丁脚本直接摆烂(下文有实测),好在 Router 会自动识别中文并路由过去,你不用手动切。
二、为什么"事件检测后处置分级"是决策模型的绝配?
写代码前,先把业务讲明白——否则你会不知道这些"选项"该怎么设计。
2.1 公路交通突发事件的"处置分级"是门有国标的手艺
按《公路交通突发事件应急预案》,事件要依据性质、类型、严重程度、可控性、影响范围分级响应,共四档:
| Ⅰ级 | 特别重大 | 🔴 红 | 交通中断 48h 以上 / 死亡失踪 30 人以上 / 跨省保障 | 交通运输部 |
| Ⅱ级 | 重大 | 🟠 橙 | 中断 24h 以上 / 死亡失踪 10~30 人 / 跨市保障 | 省级 |
| Ⅲ级 | 较大 | 🟡 黄 | 中断 6h 以上 / 死亡失踪 3~10 人 / 跨县保障 | 市级 |
| Ⅳ级 | 一般 | 🔵 蓝 | 中断 12h 内 / 死亡失踪 3 人以下 / 县域内 | 县级 |
2.2 为什么这件事天生适合决策模型?
注意看上面那列"关键触发条件"——每一级都是"预设选项 + 明确判据"。这意味着"给一段事件描述,判它属于哪一档"这件事,本质是:
- 事件类型(抛锚/事故/抛洒物/恶劣天气…)→ 一个 Choice;
- 处置等级(Ⅰ/Ⅱ/Ⅲ/Ⅳ)→ 一个 Choice;
- 严重程度(用于多事件排队调度)→ 一个 Score;
- 是否提级响应(节假日/重要路段/可能恶化)→ 一个 Noul。
这正是决策模型的主场,也正是大模型"写一大段文字"最鸡肋的地方。整体流水线长这样:
#mermaid-svg-n0nzA9g2JLZVICWj{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-n0nzA9g2JLZVICWj .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-n0nzA9g2JLZVICWj .error-icon{fill:#552222;}#mermaid-svg-n0nzA9g2JLZVICWj .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-n0nzA9g2JLZVICWj .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-n0nzA9g2JLZVICWj .marker{fill:#333333;stroke:#333333;}#mermaid-svg-n0nzA9g2JLZVICWj .marker.cross{stroke:#333333;}#mermaid-svg-n0nzA9g2JLZVICWj svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-n0nzA9g2JLZVICWj p{margin:0;}#mermaid-svg-n0nzA9g2JLZVICWj .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-n0nzA9g2JLZVICWj .cluster-label text{fill:#333;}#mermaid-svg-n0nzA9g2JLZVICWj .cluster-label span{color:#333;}#mermaid-svg-n0nzA9g2JLZVICWj .cluster-label span p{background-color:transparent;}#mermaid-svg-n0nzA9g2JLZVICWj .label text,#mermaid-svg-n0nzA9g2JLZVICWj span{fill:#333;color:#333;}#mermaid-svg-n0nzA9g2JLZVICWj .node rect,#mermaid-svg-n0nzA9g2JLZVICWj .node circle,#mermaid-svg-n0nzA9g2JLZVICWj .node ellipse,#mermaid-svg-n0nzA9g2JLZVICWj .node polygon,#mermaid-svg-n0nzA9g2JLZVICWj .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-n0nzA9g2JLZVICWj .rough-node .label text,#mermaid-svg-n0nzA9g2JLZVICWj .node .label text,#mermaid-svg-n0nzA9g2JLZVICWj .image-shape .label,#mermaid-svg-n0nzA9g2JLZVICWj .icon-shape .label{text-anchor:middle;}#mermaid-svg-n0nzA9g2JLZVICWj .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-n0nzA9g2JLZVICWj .rough-node .label,#mermaid-svg-n0nzA9g2JLZVICWj .node .label,#mermaid-svg-n0nzA9g2JLZVICWj .image-shape .label,#mermaid-svg-n0nzA9g2JLZVICWj .icon-shape .label{text-align:center;}#mermaid-svg-n0nzA9g2JLZVICWj .node.clickable{cursor:pointer;}#mermaid-svg-n0nzA9g2JLZVICWj .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-n0nzA9g2JLZVICWj .arrowheadPath{fill:#333333;}#mermaid-svg-n0nzA9g2JLZVICWj .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-n0nzA9g2JLZVICWj .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-n0nzA9g2JLZVICWj .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-n0nzA9g2JLZVICWj .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-n0nzA9g2JLZVICWj .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-n0nzA9g2JLZVICWj .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-n0nzA9g2JLZVICWj .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-n0nzA9g2JLZVICWj .cluster text{fill:#333;}#mermaid-svg-n0nzA9g2JLZVICWj .cluster span{color:#333;}#mermaid-svg-n0nzA9g2JLZVICWj div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-n0nzA9g2JLZVICWj .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-n0nzA9g2JLZVICWj rect.text{fill:none;stroke-width:0;}#mermaid-svg-n0nzA9g2JLZVICWj .icon-shape,#mermaid-svg-n0nzA9g2JLZVICWj .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-n0nzA9g2JLZVICWj .icon-shape p,#mermaid-svg-n0nzA9g2JLZVICWj .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-n0nzA9g2JLZVICWj .icon-shape .label rect,#mermaid-svg-n0nzA9g2JLZVICWj .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-n0nzA9g2JLZVICWj .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-n0nzA9g2JLZVICWj .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-n0nzA9g2JLZVICWj :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
是
否
事件检测CV/雷达/人工上报
事件描述文本
Laya 决策模型
event_type事件类型 · Choice
disposal_level处置等级 · Choice
severity严重度 · Score
need_escalation提级 · Noul
置信度 ≥ 阈值?
自动派单/联动处置
转人工复核兜底
一个认知先立住:感知交给 CV 去"看路",决策交给 Laya 去"拍板",规则和人工去"兜底"。Laya 不吃图片视频,它只吃"那段结构化的事件文字"——所以上游"感知→文本"这半步做得好不好,直接决定下游判断的质量。
三、环境准备与安装(含两个真实踩坑)
3.1 基础要求
- Python 3.10+(我本机是 3.12.7)
- 无 GPU 硬性要求,本机 CPU / M 系列芯片即可(我全程在 Apple Silicon (arm64) Mac 上跑)
3.2 安装
python -m pip install laya
它会自动带上 torch、transformers、huggingface_hub 等依赖(我装到的是 laya-0.3.21 + torch-2.14.0 + transformers-5.17.0)。
3.3 踩坑 1:Hugging Face 超时
装完一跑,第一个报错就来了——huggingface.co 连接超时,模型权重下不下来。这是大陆环境的高频坑,解法是走镜像:
export HF_ENDPOINT=https://hf-mirror.com
3.4 踩坑 2:Xet 存储后端 401(比较隐蔽)
换成镜像后,你可能还会撞上第二个更隐蔽的报错:
RuntimeError: CAS Client Error: HTTP status client error (401 Unauthorized),
domain: https://cas-server.xethub.hf.co/v2/reconstructions/…
原因是新版 huggingface_hub 默认走 Xet 存储后端,而 Xet 的 CAS 服务器不在镜像覆盖范围内。解法是显式禁用 Xet,走普通 HTTP 下载:
export HF_HUB_DISABLE_XET=1
这两个环境变量一起设,权重就能从镜像稳稳下下来。建议直接写进你的 ~/.zshrc 或启动脚本里,别每次现设。
四、Hello Laya:30 秒跑通三种决策原语
先跑个最小的,确认环境 OK,顺便看懂 choice / score / noul 三种返回长啥样:
import os
os.environ.setdefault("HF_ENDPOINT", "https://hf-mirror.com")
os.environ.setdefault("HF_HUB_DISABLE_XET", "1")
from laya import Router
router = Router() # 懒加载:首次使用时才下载对应 checkpoint
state = "G4京港澳高速K123处,一辆小轿车与货车追尾,占用超车道,1人受伤,交警已到场。"
questions = {
"event_type": {"type": "choice", "instructions": "这是什么类型的公路交通事件?",
"criteria": {"交通事故": "车辆碰撞、追尾、刮擦",
"车辆故障": "抛锚、爆胎、故障停车",
"抛洒物": "路面障碍物、散落物"}},
"severity": {"type": "score", "instructions": "事件严重程度,0最轻4最重",
"criteria": ["可快速处置", "一般(Ⅳ级)", "较大(Ⅲ级)", "重大(Ⅱ级)", "特别重大(Ⅰ级)"]},
"need_escalation": {"type": "noul", "instructions": "是否需要提级响应?"},
}
result = router.predict(state, questions)
print(result["routing"]["model"]) # -> multilingual(自动识别中文)
print(result["answers"]["event_type"]["choice"]) # -> 交通事故
真实输出(截取关键字段):
{
"event_type": {
"type": "choice",
"choice": "交通事故",
"probabilities": {"交通事故": 0.9998, "车辆故障": 0.0001, "抛洒物": 0.0},
"answer_confidence": 0.9998
},
"severity": {
"type": "score",
"score": 0.819,
"probabilities": {"0": 0.2227, "1": 0.7491, "2": 0.0187, "3": 0.0054, "4": 0.004},
"answer_confidence": 0.7491
},
"need_escalation": {"type": "noul", "noul": 0.0, "confidence": 1.0}
}
三个要点:
五、核心实战:公路交通事件"检测 → 处置分级"全链路
现在进入正题。我把业务拆成四个决策 + 一个兜底:
QUESTIONS = {
# 决策①:事件类型(检测结果归类)
"event_type": {"type": "choice", "instructions": "该公路交通事件属于哪种类型?",
"criteria": {
"交通事故": "车辆碰撞、追尾、侧翻、起火",
"车辆故障": "抛锚、爆胎、故障停车",
"抛洒物障碍": "路面散落物、障碍物、落石",
"恶劣天气": "暴雨、冰雪、大雾、山洪",
"施工占道": "养护施工、占道作业",
"结构物损毁": "桥梁、隧道、边坡垮塌",
"行人动物闯入": "行人、动物进入行车道"}},
# 决策②:处置等级(Ⅰ/Ⅱ/Ⅲ/Ⅳ,判据直接来自国标)
"disposal_level": {"type": "choice", "instructions": "按应急预案定处置响应等级?",
"criteria": {
"Ⅰ级特别重大": "中断48h以上或死亡失踪30人以上,跨省",
"Ⅱ级重大": "中断24h以上或死亡失踪10-30人,跨市",
"Ⅲ级较大": "中断6h以上或死亡失踪3-10人,跨县",
"Ⅳ级一般": "中断12h内或死亡失踪3人以下,县域内"}},
# 决策③:严重度评分(多事件排队调度的连续量)
"severity": {"type": "score", "instructions": "严重程度评分",
"criteria": ["可快速处置", "一般", "较大", "重大", "特别重大"]},
# 决策④:是否提级(兜底信号)
"need_escalation": {"type": "noul",
"instructions": "是否在重要区域/重大活动期间或可能恶化,需提级响应?"},
}
看到没?答案空间完全由你给的 criteria 决定。判据写得越像国标原文,模型越好发挥;写得越糊,模型越瞎猜。这就是决策模型和"全知全能"LLM 最大的区别。
我构造了 8 条真实风格的事件描述,覆盖 Ⅰ~Ⅳ 全档 + 多种事件类型,逐条跑,人工标注了 ground truth。下面是本机实测的逐条结果(✓/✗ 是相对人工标注的对错):
| 1 | 特大桥垮塌(Ⅰ级) | 交通事故(0.87) ✗ | Ⅳ级(0.51) ✗ | 1.89 | 0.73 | 52ms |
| 2 | 山洪桥垮(Ⅱ级) | 结构物损毁(0.78) ✓ | Ⅱ级(0.56) ✓ | 1.26 | 0.96 | 48ms |
| 3 | 危化品泄漏(Ⅲ级) | 交通事故(0.99) ✓ | Ⅳ级(0.94) ✗ | 1.52 | 0.97 | 47ms |
| 4 | 边坡塌方(Ⅳ级) | 施工占道(0.24) ✗ | Ⅳ级(0.74) ✓ | 1.13 | 0.17 | 47ms |
| 5 | 轻微追尾(Ⅳ级) | 交通事故(1.00) ✓ | Ⅳ级(0.59) ✓ | 1.07 | 0.19 | 45ms |
| 6 | 抛洒物(Ⅳ级) | 交通事故(0.56) ✗ | Ⅳ级(0.42) ✓ | 0.92 | 0.02 | 43ms |
| 7 | 车辆抛锚(Ⅳ级) | 车辆故障(1.00) ✓ | Ⅳ级(0.57) ✓ | 1.29 | 0.06 | 47ms |
| 8 | 行人闯入(Ⅳ级) | 行人动物闯入(0.60) ✓ | Ⅳ级(0.55) ✓ | 1.14 | 0.66 | 43ms |
汇总:事件类型 5/8(0.625),处置等级 6/8(0.75)。
5.1 处置等级:看起来 0.75 不错,其实是个大坑
先别高兴。看这张混淆矩阵——模型几乎把所有事件都判成了 Ⅳ级: 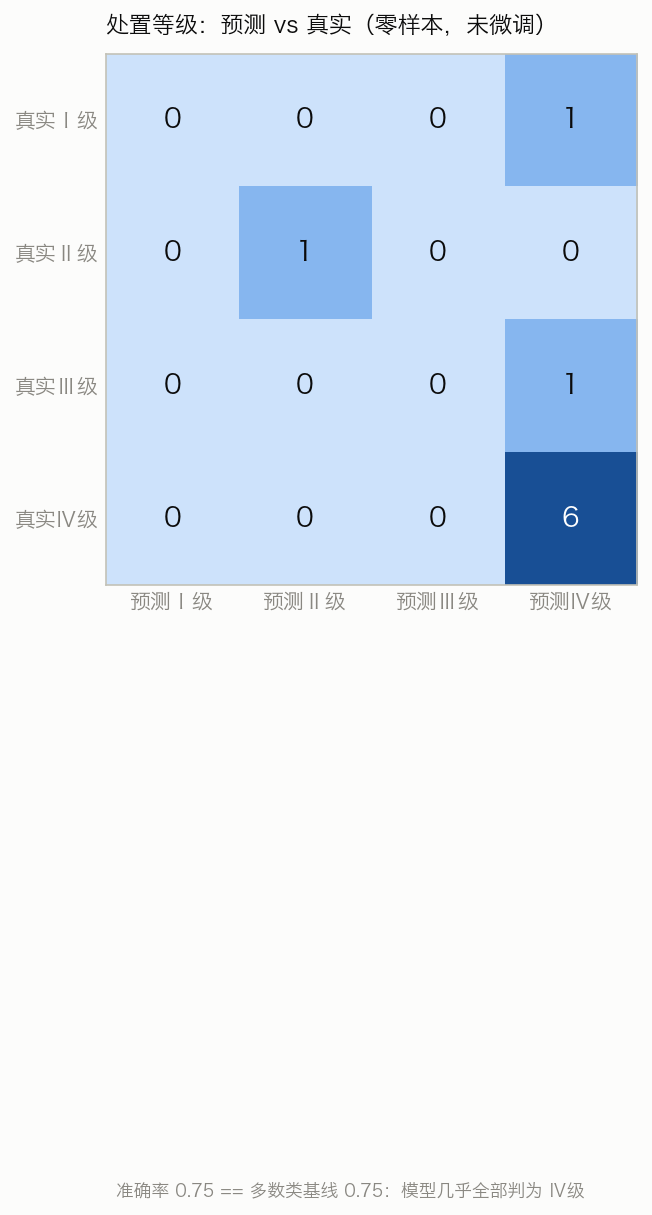 我的 8 条样本里,本来就有 6 条是 Ⅳ级。所以"闭眼全选Ⅳ级"这个多数类基线,准确率也是 0.75。也就是说:模型的 0.75 和瞎猜多数类打平,它其实没有学会分级——最致命的是,最该命中的 Ⅰ 级特大桥垮塌,它反而判成了 Ⅳ 级(第 1 行)。
这不是我数据问题,是 Laya 的已知短板:零样本基准上,laya-typed-decisions 只有 0.362,甚至低于多数类基线 0.461;对比 Jev 的 0.727 差距明显。决策模型默认是"拿来微调的底座,不是开箱即用的分级引擎"(官方 model card 原话精神)。
5.2 严重度评分:被"压缩"在低位
严重度我设计的是 0~4,但模型输出全压在 0.9~1.9 之间: 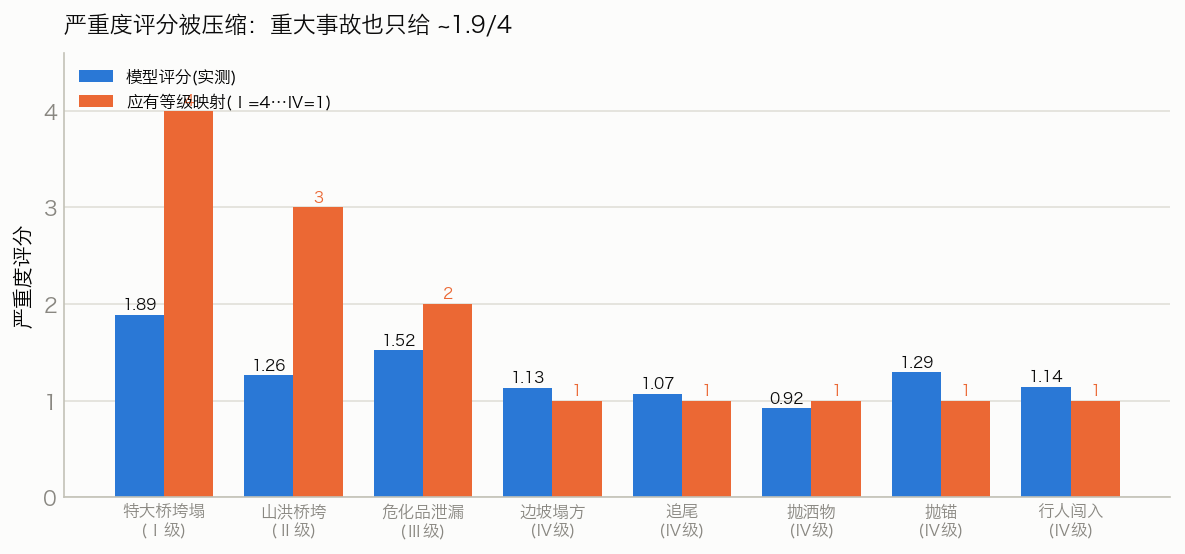
特大桥垮塌这种 Ⅰ 级事故,理论上该给 4 分,实测只给 1.89——有"它更严重"的微弱信号,但量级完全不敢往高里打。这是典型的"概率/打分校准差",下文第八节会展开。
5.3 意外的惊喜:提级信号 noul 反而很靠谱
最让我意外的是第 ④ 个决策。把 8 条按 noul(提级概率)从高到低排: 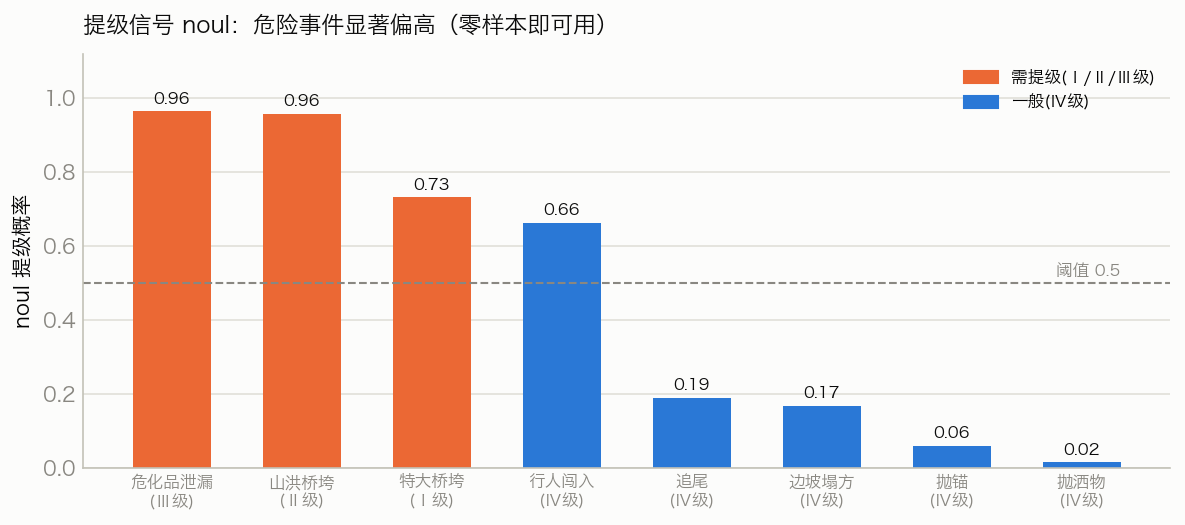
得分最高的三条,恰好就是三条真正危险的事件(危化品泄漏 0.97、山洪桥垮 0.96、特大桥垮 0.73)。也就是说:"是/否"这种二值判断,零样本下比精细的四级分级靠谱得多。这跟小模型"二值比多类稳"的普遍规律一致。
落地含义:零样本直接上线的姿势,是先用 noul 做"危险事件初筛/告警",而不是直接信任 disposal_level 的四级结果。
六、性能实测:本地到底有多快?
这是"本地部署"最核心的卖点,我做了实测(Apple Silicon,本地 CPU/MPS,权重已预热): 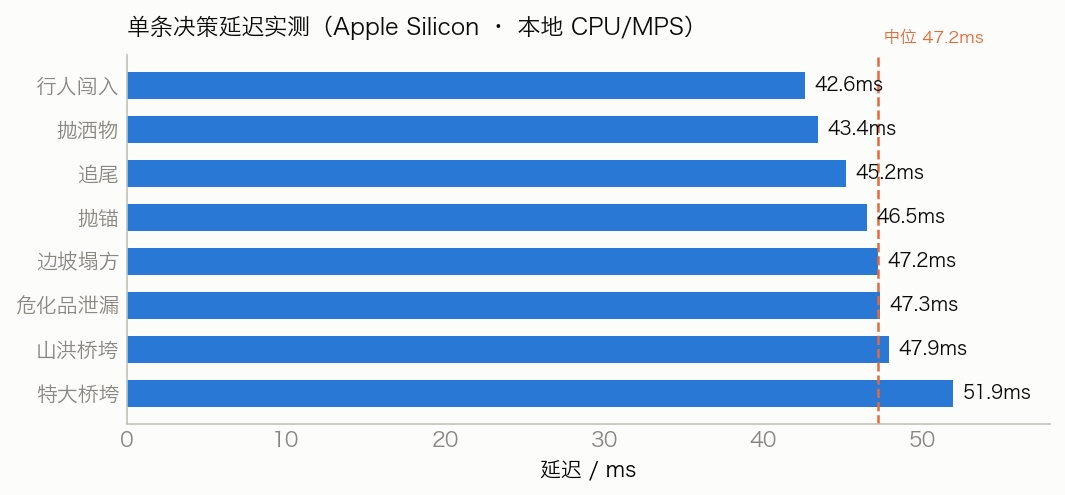
- 单条决策延迟:42.6 ~ 51.9 ms,中位 47.2 ms;
- 首次调用(含权重下载 + 加载)约 3.4 秒,之后稳定在几十毫秒;
- 批量 predict_batch:8 条共 794 ms,约 99 ms/条——小批量短文本在 CPU 上反而更慢(路由分组开销 > 前向收益),批量优势要到大 batch + GPU 吞吐时才会体现;
- 峰值内存:torch 版实测约 2.8 GiB(含 PyTorch 运行时 + mmBERT fp32 权重);社区 MLX 版仅约 0.7 GiB(多语言 checkpoint 687.6 MiB)。
对比一下"云端 API"的处境:官方 Jev API 单次决策的网络往返就主导了延迟(数百毫秒级),而且数据要出本机。对隧道、山区、长下坡这类弱网/断网场景,本地 47ms + 数据不出机房,才是关键。
七、安全兜底:min_confidence 弃权(交通场景的生命线)
交通是安全关键行业,模型可以"答不出",但不能"错得自信"。Laya 提供了一个关键机制 min_confidence:置信度低于阈值时,给结果打上 low_confidence 标记,把决策权交回给人。
用第 1 条"特大桥垮塌"(模型错判成 Ⅳ级、置信度只有 0.51)来演示:
for mc in (None, 0.7, 0.9):
r = router.predict(catastrophic, QUESTIONS, min_confidence=mc)
a = r["answers"]["disposal_level"]
print(mc, a["choice"], a["answer_confidence"], a.get("low_confidence"))
真实输出:
None -> Ⅳ级一般 0.5061 None # 不设阈值:直接吐出错误答案
0.7 -> Ⅳ级一般 0.5061 True # ✅ 置信度不足 → 标记转人工
0.9 -> Ⅳ级一般 0.5061 True # ✅ 更严 → 同样拦截
这就是"兜底"的正确姿势:模型大胆给判断,但你必须给它套一个"置信度闸门",低于阈值一律转人工复核。一条原则请刻进脑门:
对安全关键场景,置信度低 ≠ 没判断,它恰恰是模型在说"这事我没把握"。这时候的人工复核不是浪费,是在给自动化兜底。
八、要落地,你必须知道的三个真相(踩坑篇)
我把这次实测 + 社区评测里最反直觉、最容易翻车的点,浓缩成三条:
8.1 零样本别想直接上线,微调是刚需
- 零样本分级:Laya 0.362(低于多数类基线)→ 在 typed-decisions 上微调后 0.766,反超 Jev 的 0.727;
- 中文分级我实测:0.75 == 多数类基线,等于没学会。
结论:Laya 的正确用法是**“快速、便宜、可私有化的微调底座”**,而不是开箱即用的引擎。你在自己业务数据上喂几百上千条标注,它才有资格上生产。
8.2 概率校准差,要用温度重拟合修
出厂 checkpoint 的 ECE(期望校准误差)高达 0.466——意思就是它说"90% 把握"时,实际对的概率远不到 90%。按问题类型做温度重拟合后,ECE 能降到 0.081。校准不修,你的置信度闸门(第七节)就是个摆设。
8.3 中文必须 multilingual,选项别贪多
- 英文 checkpoint 对非拉丁脚本直接失效(有评测显示高棉文 0% 正确率却 0.95 置信度)——中文场景务必走 multilingual(Router 会自动路由,但你要知道这一点);
- 选项集过大(20+ 类)性能崩坏:Banking77 上 Laya 0.425 vs Jev 0.870。把你的 criteria 控制在 5~10 个互斥选项内,宁可分层拆解,也别一次塞 20 个。
九、进阶:微调 + 温度校准 + 服务化
微调:官方给了完整 notebook(Kaggle 免费 2×T4 可跑):建数据集 → 训练 → 拟合校准温度 → 评测 → 推到 Hub。中文场景照抄流程,把数据集换成你标注的交通事件即可。
服务化:装 HTTP 扩展 laya[serve],一条命令起服务,暴露 Jev 兼容的 /v1/systemone 接口(还有 /health 可查设备与 CPU 回退情况)。这意味着:你本地起的 Laya,可以直接当成"私有化 Jev"来用,上层业务代码几乎不用改。
python -m pip install "laya[serve]"
laya-serve # 详见 https://nandhakishorm.github.io/laya/
其余生态(ONNX 加速、LangChain/LangGraph 集成、MCP server、Docker、Apple MLX 版)官方文档都很全,按需取用即可。
十、总结与落地建议
一句话总结这篇文章的实话:
Laya(开源版 Jev)最值钱的不是"零样本就能用",而是"一个能本地跑、47ms、免费、Apache-2.0、可微调私有化的决策底座"。 拿它做"事件类型初筛"和"危险事件 noul 告警"很好使;但"Ⅰ/Ⅱ/Ⅲ/Ⅳ 精细分级"必须微调 + 校准 + 人工兜底,否则它只会糊弄你一个 Ⅳ级。
给交通信息化同仁的三条落地路线(按风险从低到高):
📢 互动区(你的想法对我很重要)
写这篇之前我特意把所有数字都本机跑了一遍,但你的场景一定和我不一样。三个问题,评论区等你:
如果这篇帮你省了踩坑的时间,点个赞 👍 收藏 ⭐,让更多同行看到;转发给你做公路/交通信息化的同事,咱们评论区见。
想要完整可运行代码(demo/ 目录下 00_smoke.py、02_bench_full.py、03_abstention.py + 四张图表 + results.json),评论区留言"求代码",我整理后放到置顶评论。
参考资料
- NandhaKishorM/laya — GitHub(官方 README / API / 微调 notebook)
- convaiinnovations/laya — Hugging Face 模型卡
- Laya 官方文档(hooks / 结构化决策 / Docker / 服务化)
- Laya 详解:一种零输出 token 的决策模型 — OrcaRouter
- Jev vs Laya:T4 上 33ms,低于多数基准 — OrcaRouter
- Laya 是什么,和 Jev 有什么区别:开源决策模型深度对比 — 七牛
- APUS 开源国内首批 Jev 跨平台复现 — 量子位
- 公路交通突发事件应急预案(事件分级 Ⅰ~Ⅳ 级)


评论前必须登录!
注册