 网硕互联帮助中心
做短视频最难的是什么?不是创意,而是执行。写文案、找素材、配音、加字幕、配音乐——一套流程下来,一天时间就没了。传统短视频制作的瓶颈在于"技术操作"而非"创意表达":一条1分钟的口播视频通常需要经历文案撰写、素材收集、配音录制、字幕制作、后期合成5个环节,每一环都需要不同工具和专业技巧,这让大量内容创作者被挡在"日更"的门槛之外。
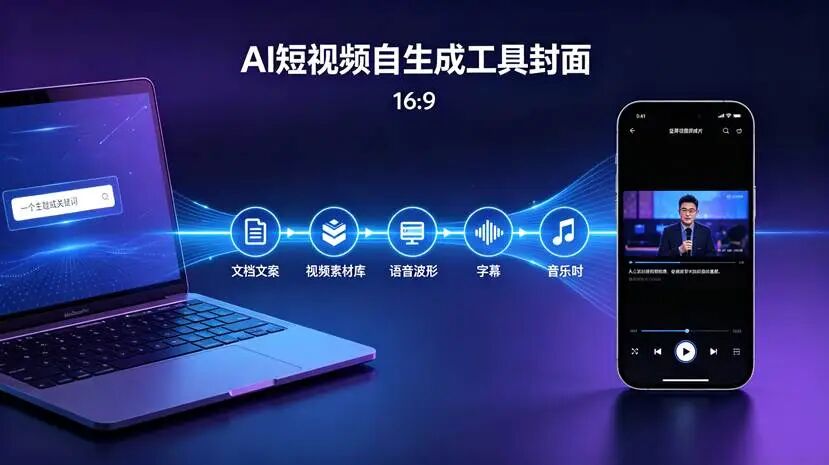
MoneyPrinterTurbo的出现,正是为了打破这一瓶颈。这是开发者harry0703在GitHub上开源的AI短视频全自动生成工具,只需提供一个视频主题或关键词,它就能自动完成:✍️生成视频文案、🎬匹配高清无版权素材、🗣️合成语音解说、📝生成字幕、🎵添加背景音乐,最后合成一条高清短视频——零剪辑经验,让"一个想法到一部成片"的路径缩到最短。项目采用MIT开源协议(可自由二次开发与商业化),截至2026年年中已在GitHub上斩获超过9.2万Star、1.3万+ Fork,成为AI短视频赛道最具影响力的开源项目之一,被社区称为"印钞机"。
本文将从项目定位、核心功能、架构设计、九步生成管线、技术栈、部署实战、配置指南、版本演进、应用场景、局限与对比等维度,系统拆解MoneyPrinterTurbo的技术实现与落地实践,为内容创作者、AI工程师、企业运营提供完整参考指南。
一、MoneyPrinterTurbo是什么:短视频赛道的"全自动工厂"
MoneyPrinterTurbo是一个基于Python 3.11构建的AI短视频全自动生成平台,以视频主题(Video Subject)或关键词为输入,输出可直接发布的1080P高清MP4成片。它的核心承诺极其简洁:只需提供一个视频主题或关键词,全自动完成文案生成→素材匹配→语音合成→字幕生成→背景音乐→视频合成。
这不是一个概念验证级Demo,而是一个完整的、可部署的产品级系统。项目数据一览:GitHub Stars超过9.2万、Forks超过1.3万、最新版本v1.3.0(2026年6月10日)、MIT许可证、Python 3.11为主语言、原生支持16+个LLM提供商(通过LiteLLM网关可扩展至100+个)、可选语音超过940种、社区贡献者69人。
|
核心能力 |
说明 |
技术实现 |
|
AI脚本生成 |
根据主题自动生成包含开场钩子、内容展开、结尾互动的完整视频脚本,支持中英文与自定义文案 |
大语言模型调用(OpenAI/DeepSeek/通义千问/Ollama等16+提供商) |
|
智能素材匹配 |
根据脚本自动提取搜索词,从无版权素材库检索匹配的高清视频片段 |
Pexels/Pixabay/Coverr等API自动检索下载 |
|
多音色语音合成 |
940+音色可选,支持语速调节与试听,中英文及多语言覆盖 |
Edge TTS(免费)、Azure TTS、SiliconFlow TTS、小米MiMo TTS |
|
字幕动态生成 |
字体、颜色、大小、位置、描边全面自定义,支持圆角半透明字幕背景 |
双引擎:Edge快速模式(时间戳对齐)/Whisper精准模式(faster-whisper) |
|
背景音乐混合 |
内置BGM库或自定义音乐文件,音量独立可调 |
resource/songs目录+MoviePy混音 |
|
视频合成输出 |
素材拼接、字幕叠加、音频混合后输出1080P高清MP4 |
MoviePy 2.x+FFmpeg(libx264编码+AAC音频) |
与同类工具的本质区别:MoneyPrinterTurbo的核心差异化在于"端到端+零门槛+全开源"。它不是在某一个单点(如文生视频)上追求极致,而是把整个短视频生产链路全部打通——LLM、TTS、ASR、素材检索、视频合成五条技术链路串联成一条自动化Pipeline,让"一个人+一个想法=无限视频产能"成为可能。MIT协议开源意味着你可以自由地二次开发和商业化,无论是个人创作者还是企业内容团队,都能把它改造成自己的短视频生产基础设施。
二、核心功能全景:从全自动生成到批量分发
2.1 全自动生成流水线
这是项目最核心的能力。用户输入一个主题(如"夏季旅游推荐"),系统自动执行以下链路:①AI脚本生成——调用大语言模型自动生成包含开场钩子、内容展开及结尾互动的完整视频脚本;②智能素材匹配——根据脚本关键词,从Pexels/Pixabay/Coverr等无版权素材库自动检索高清视频片段;③多音色语音合成——集成Edge TTS、Azure TTS、SiliconFlow TTS、小米MiMo TTS等引擎,940+音色可选;④字幕动态生成——双引擎(Edge快速模式/Whisper精准模式)支持字体、颜色、大小、位置、描边全面自定义;⑤背景音乐混合——内置BGM库,支持随机或指定音乐文件,可调节音量;⑥视频合成输出——MoviePy 2.x+FFmpeg合成最终MP4。
2.2 特色功能矩阵
|
功能 |
说明 |
典型用法 |
|
双模式文案 |
AI自动生成文案或用户自定义上传/编辑文案,WebUI中可直接修改生成结果 |
小说章节、知识短文直接粘贴成片 |
|
多分辨率输出 |
竖屏9:16(1080×1920)适配抖音/小红书/快手;横屏16:9(1920×1080)适配YouTube/视频号;方形1:1(1080×1080)适配图文平台 |
按平台选择对应画幅一键生成 |
|
批量生成 |
一键生成多个视频版本,从中选择最满意的,支持不同风格对比(max_concurrent_tasks默认5) |
A/B测试不同文案风格、配音音色 |
|
跨平台发布 |
生成完成后可自动上传至TikTok、Instagram和YouTube Shorts(需Upload-Post账号),YouTube发布时自动标注AI生成内容 |
内容工厂"生成即分发"闭环 |
|
无语音模式 |
v1.3.0新增,支持不需要旁白的视频工作流 |
纯音乐+画面类短视频 |
|
自定义素材 |
支持上传本地视频文件作为素材,WebUI支持自定义音频上传 |
产品实拍素材、品牌宣传片底料 |
2.3 多LLM提供商支持
系统采用适配器模式设计,通过统一接口封装了16+个LLM提供商的调用逻辑,配置切换只需修改config.toml中的一个字段。支持的提供商覆盖:①国际——OpenAI、Google Gemini、Azure OpenAI、Groq、Grok/xAI;②国产——DeepSeek、通义千问(Qwen)、Moonshot、文心一言、MiniMax、小米MiMo;③网关/代理——AIHubMix、AIML API、EvoLink、one-api、Pollinations、ModelScope;④本地——Ollama(支持Llama、Phi等开源模型);⑤扩展——LiteLLM网关(v1.2.8新增,一键接入100+模型)。国内用户推荐DeepSeek、Moonshot、通义千问,直连无需代理。
三、系统架构深度解析:MVC特化设计的全自动流水线
MoneyPrinterTurbo采用经典的MVC架构,并在此基础上做了视频生成领域的特化设计。整个系统从用户交互到后端执行形成完整的技术闭环:
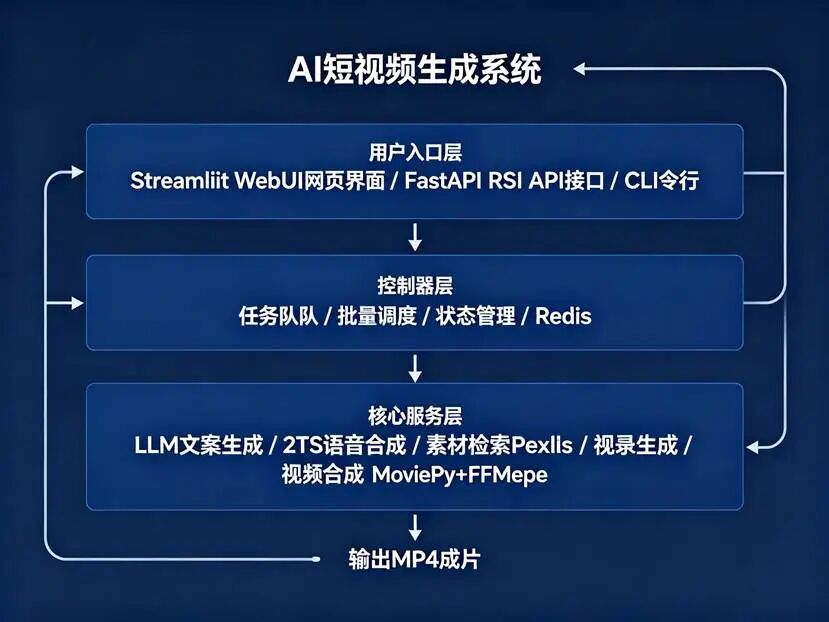
MoneyPrinterTurbo三层技术架构信息图:用户入口层(Streamlit WebUI/FastAPI REST API/CLI)→控制器层(任务队列/批量调度/状态管理/Redis)→核心服务层(LLM文案生成/TTS语音合成/素材检索/字幕生成/视频合成MoviePy+FFmpeg)→输出MP4成片
3.1 三层架构
|
层级 |
组件 |
职责 |
技术栈 |
|
用户入口层 |
WebUI、REST API、CLI |
三类入口:Streamlit WebUI提供浏览器可视化操作界面(端口8501);FastAPI REST API支持程序化集成(端口8080,自带Swagger文档);CLI命令行模式支持纯命令行生成(cli.py) |
Streamlit、FastAPI、Uvicorn、Typer |
|
控制器层 |
任务队列、批量调度、状态管理 |
协调所有下游服务的执行流程:脚本生成、搜索词提取、TTS音频创建、素材检索、字幕生成、最终合成;支持内存模式与Redis分布式模式两种状态存储 |
内存存储/Redis、异步任务队列 |
|
核心服务层 |
LLM、语音、素材、字幕、视频五大服务 |
LLM服务(脚本生成+搜索词提取)、语音服务(文本转语音)、素材服务(检索下载高清片段)、字幕服务(时间戳对齐字幕)、视频服务(MoviePy合成+FFmpeg编码) |
OpenAI SDK、edge-tts、faster-whisper、MoviePy、FFmpeg |
任务调度双模式:系统提供两种任务管理器实现——内存模式适合单机部署,轻量快速;Redis分布式模式适合高并发场景,支持水平扩展。配置切换只需在config.toml中设置Redis连接参数,系统自动切换为分布式架构。
3.2 九步生成管线详解
视频生成流水线遵循确定性的九步流程,将简单主题转化为完成的HD视频,每一步都建立在前一步输出之上,形成无缝的生产工作流:
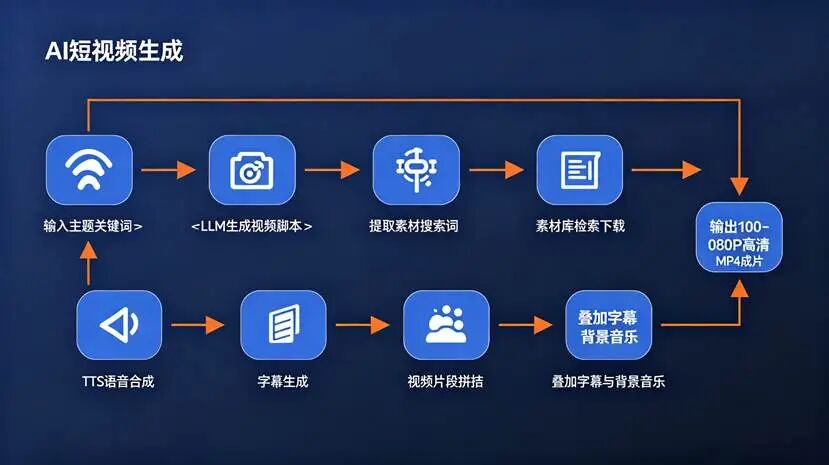
MoneyPrinterTurbo九步视频生成流水线流程图:输入主题关键词→LLM生成视频脚本→提取素材搜索词→TTS语音合成→素材库检索下载→字幕生成→视频片段拼接→叠加字幕与背景音乐→输出1080P高清MP4成片
①内容生成(Step 1-3):流水线以用户提供的主题或关键词开始。若未提供自定义脚本,LLM服务自动生成贴合主题的视频脚本,随后同一LLM从脚本中提取5个搜索词用于检索视频素材。这种"双LLM"方法确保叙事内容与视觉搜索词在语义上保持一致——对内容理解越准确,匹配到的素材就越贴题。
②文本转语音(Step 4):脚本通过配置的TTS引擎转换为音频。Edge TTS提供免费、快速的多语言合成,支持数十种音色;Azure Speech提供9种高级音色,韵律更自然,适合生产级输出。TTS引擎同时返回音频文件和词级时间戳数据,用于字幕同步。
③素材检索(Step 5):利用提取的搜索词,素材服务查询Pexels或Pixabay API获取高清视频片段,下载与搜索词匹配、时长和分辨率合适的素材。用户也可以提供本地视频文件作为自定义素材,完全掌控视觉内容。
④字幕生成(Step 6):两种字幕引擎可选:Edge模式利用TTS引擎的词级时间戳快速生成字幕,无需GPU、任何硬件可用;Whisper模式使用faster-whisper库的large-v3模型进行更高质量的对齐,需要更多计算资源(模型约3GB)。v1.3.0还新增了字幕背景选项,支持圆角半透明字幕背景,视觉效果更专业。
⑤合成与渲染(Step 7-9):视频服务使用MoviePy组装所有组件:视频片段以可配置的转场(随机/顺序/淡入淡出/滑动)拼接、字幕以可自定义的字体和位置叠加、背景音乐以可配置音量混入。FFmpeg执行最终编码,输出1080P MP4(libx264视频编码+AAC音频192kbps)。
这套九步流水线的设计亮点在于:每个环节职责单一、接口清晰,通过Task Service统一编排状态流转,用户通过WebUI或API提交任务后立即获得任务ID,视频异步生成,完成后从返回的URL下载。
四、技术栈全景:五大技术链路串联
MoneyPrinterTurbo的技术栈覆盖Web框架、视频处理、LLM集成、TTS、ASR、素材源、任务队列、容器化、国际化九大领域,每一层都选用成熟的工业级组件:
|
层次 |
技术 |
说明 |
|
Web框架 |
Streamlit |
WebUI可视化操作界面,实时预览TTS音色与配置面板 |
|
API框架 |
FastAPI |
RESTful API接口,自带Swagger文档(/docs),支持异步任务 |
|
视频处理 |
MoviePy 2.x+FFmpeg |
视频合成、字幕叠加、音频混合;v1.2.7后不再依赖ImageMagick |
|
图像处理 |
Pillow |
字幕渲染(v1.2.7后替代ImageMagick) |
|
LLM集成 |
OpenAI SDK/各厂商SDK |
统一接口封装16+LLM提供商,LiteLLM网关扩展至100+ |
|
TTS引擎 |
edge-tts/Azure Speech SDK |
双引擎语音合成,940+音色 |
|
语音识别 |
faster-whisper |
本地ASR,字幕精准对齐(Whisper模式) |
|
素材源 |
Pexels API/Pixabay API/Coverr |
高清无版权视频素材,支持多密钥轮换 |
|
任务队列 |
内存/Redis |
异步任务调度与状态管理,Redis支持分布式扩展 |
|
环境管理 |
uv+pyproject.toml |
现代Python依赖管理(v1.2.7引入) |
|
容器化 |
Docker/Docker Compose |
支持CPU(python:3.11-slim-bullseye)和GPU(nvidia/cuda)两种镜像 |
|
国际化 |
JSON语言包 |
中/英/德/葡/越/俄/土/阿拉伯八种语言 |
4.1 双引擎语音合成架构
语音合成模块通过统一调度逻辑自动分流:系统检测音色名称,Azure V2音色走Azure Cognitive Services SDK(付费高保真),其余走Edge TTS(免费标准质量)。两种引擎各有侧重:Azure TTS V1(Edge TTS)基于edge-tts库、免费无需API Key、标准质量、基础时间戳、可离线使用,适合快速原型和批量生成;Azure TTS V2基于Azure Cognitive Services SDK、需付费订阅、高保真神经网络语音、精确到字的时间戳,适合高质量商业视频。
4.2 双引擎字幕生成
系统支持三种字幕配置:edge模式使用Edge TTS返回的时间戳对齐字幕,速度快、不需要GPU,但复杂句子的时间戳偶尔不够准确;whisper模式使用本地faster-whisper转写生成的音频,生成更细粒度的词级时间戳,速度较慢、需下载模型(large-v3-turbo约250MB,large-v3约3GB),但字幕准确性通常更好;留空则不生成字幕。v1.3.0新增字幕背景选项,支持圆角半透明字幕背景,视觉效果更专业。
五、部署实战:四种方式满足不同需求
5.1 四种部署方式
|
部署方式 |
适合人群 |
核心要求 |
启动方式 |
|
Windows一键启动包 |
零基础用户(最简单) |
无需安装Python环境,依赖全部内置 |
从GitHub Release下载解压,双击start.bat启动(路径中不要有中文/特殊字符/空格) |
|
Docker部署 |
生产环境(推荐) |
Docker+Docker Compose |
docker compose -f docker-compose.release.yml up;WebUI访问http://127.0.0.1:8501,API文档http://127.0.0.1:8080/docs |
|
手动部署 |
开发者(首选) |
Python 3.11+uv |
git clone→uv sync –frozen→uv run streamlit run ./webui/Main.py |
|
Google Colab |
零配置体验用户 |
浏览器即可 |
打开项目docs目录的Colab Notebook,点击即用 |
CLI命令行模式:除WebUI和API外,还支持纯命令行生成视频,一条命令完成从主题到成片:uv run python cli.py –video-subject "金钱的作用"。
5.2 系统配置要求
|
项目 |
最低配置 |
推荐配置 |
理想配置 |
|
CPU |
4核 |
6-8核 |
8核+ |
|
RAM |
4 GB |
8 GB |
16 GB+ |
|
GPU |
非必须 |
4 GB显存+ |
8 GB显存+ |
如果你主要依赖云端LLM、云端TTS和在线素材源,CPU与内存比GPU更重要。GPU在启用faster-whisper、批量生成或更重的本地处理链路时优势明显。
5.3 快速上手:生成第一条视频
①部署项目(推荐Docker一键启动);②在config.toml中配置Pexels API Key和LLM API Key;③启动WebUI,访问http://127.0.0.1:8501;④在左侧输入视频主题,如"如何提高工作效率";⑤选择视频尺寸(9:16竖屏/16:9横屏/1:1方形)、语音、字幕样式等参数;⑥点击生成,等待几分钟;⑦下载生成的MP4文件。
更简洁的方式是纯命令行:uv run python cli.py –video-subject "如何提高工作效率"。REST API方式则通过POST /api/v1/video/generate提交视频主题、画幅、音色、拼接模式、片段时长等参数,立即获得task_id,再通过GET /api/v1/video/status/{task_id}查询异步任务状态,完成后从返回URL下载成片,适合嵌入自动化内容生产流水线。
六、配置指南:一个TOML文件控制全局
配置文件采用TOML格式,位于项目根目录的config.toml。首次使用从config.example.toml复制即可:cp config.example.toml config.toml。
6.1 素材API配置
video_source可选项为pexels(默认)、pixabay、coverr。pexels_api_keys支持多密钥轮换(数组形式),pixabay_api_keys同理,多密钥可提升检索速率与稳定性。
6.2 LLM配置
llm_provider字段控制全部LLM切换——国内用户推荐DeepSeek/Moonshot/通义千问(直连无需代理)。以DeepSeek为例:llm_provider设为deepseek,填入deepseek_api_key,deepseek_model_name设为deepseek-chat。OpenAI用户则设为openai+openai_api_key+openai_model_name(如gpt-4o-mini)。
6.3 语音与字幕配置
默认使用Edge TTS(免费),如需更高质量的Azure TTS V2,在[azure]段配置speech_key和speech_region。字幕subtitle_provider可设为edge(快速)、whisper(精准)或留空(不生成字幕)。
6.4 其他关键配置
[whisper]段配置模型大小(model_size)、设备(CPU/CUDA)与计算类型;[proxy]段配置HTTP/HTTPS代理;[azure]段配置Azure Speech密钥;[siliconflow]段配置SiliconFlow API密钥;[ui]段配置隐藏日志、字幕位置等界面参数。切换Redis分布式模式只需配置Redis连接参数。
6.5 常见问题排查
|
问题 |
原因 |
解决方案 |
|
FFmpeg Not Found |
未安装FFmpeg或路径未配置 |
下载FFmpeg并在config.toml的[app]段设置ffmpeg_path |
|
ImageMagick安全策略拦截 |
Linux上ImageMagick默认阻止临时文件操作 |
编辑policy.xml,将@模式的rights改为read|write(或升级到v1.2.7+移除依赖) |
|
Too Many Open Files |
Linux/macOS文件描述符限制 |
执行ulimit -n 10240提升限制 |
|
Whisper模型下载失败 |
HuggingFace无法访问 |
手动下载whisper-large-v3模型放入./MoneyPrinterTurbo/models/whisper-large-v3/目录 |
|
素材检索失败 |
外部API网络不稳定 |
配置代理或切换素材源(pexels/pixabay/coverr) |
七、版本演进与关键里程碑
MoneyPrinterTurbo的演进方向清晰可见:从"能用"到"好用"再到"专业级"——模型生态持续扩展、安全持续加固、创作自由度持续提升。
|
版本 |
日期 |
关键更新 |
|
v1.2.7 |
2026年4月 |
修复Edge TTS兼容性;引入uv+pyproject.toml现代依赖管理;移除ImageMagick依赖(改用Pillow) |
|
v1.2.8 |
2026年5月28日 |
新增LiteLLM网关(一键接入100+模型)、Grok/xAI支持、WebUI自定义音频上传;安全加固 |
|
v1.2.9 |
2026年5月30日 |
WebUI高级脚本设置(段落数/自定义需求/完整system prompt);小米MiMo LLM+TTS支持 |
|
v1.3.0 |
2026年6月10日 |
新增Coverr素材源、Groq LLM支持、无语音模式、字幕背景选项(圆角半透明)、多语言社交元数据生成API |
八、应用场景:谁能用好这台"视频印钞机"
|
场景 |
目标用户 |
典型内容 |
关键价值 |
|
社交媒体营销 |
品牌运营、MCN机构、个人IP |
抖音/小红书/YouTube短视频、产品种草、热点内容 |
批量生成多版本做A/B测试,跨平台自动发布,实现内容工厂化运营 |
|
知识科普 |
知识博主、教育机构 |
知识讲解、冷知识、学习方法类短视频 |
将文字内容快速转化为视频形态,日更无压力 |
|
产品演示 |
电商运营、企业市场部 |
产品介绍短视频、功能演示、宣传片 |
自定义素材上传产品实拍,AI编排文案与配音,快速产出 |
|
教育内容 |
培训机构、在线教育 |
课件视频化、知识讲解、课程预告 |
Whisper精准字幕保障无障碍与可检索性,批量生产课件视频 |
|
自媒体矩阵 |
内容代运营、矩阵账号 |
多平台、多语言内容一键分发 |
多分辨率输出适配各平台,多语言音色支持跨境内容 |
|
开发者集成 |
AI工程师、内容中台团队 |
REST API驱动的自动化视频生产线 |
FastAPI接口+任务状态管理,嵌入CMS与内容调度系统 |
九、局限性分析与同类项目对比
9.1 当前局限
①素材匹配语义深度有限:素材匹配依赖关键词检索,语义理解深度有限,偶尔会出现画面与文案不完全匹配的情况;②非AI原生视频生成:生成视频以"素材剪辑+配音+字幕"为主,尚不支持AI原生视频生成(如文生视频模型),无法凭空生成不存在的画面;③转场效果相对简单:转场支持随机/顺序/淡入淡出/滑动,丰富度有限,项目路线图中有"增加视频转场效果"的规划;④外部API依赖:视频素材依赖外部API(Pexels等),网络不稳定时可能失败;⑤同质化风险:网络素材被大量账号使用,画面同质化问题客观存在,需要结合自定义素材或后期加工建立辨识度。
9.2 与同类项目对比
|
对比维度 |
MoneyPrinterTurbo |
Pixelle-Video |
AI原生视频工具(Sora/Runway等) |
|
视频生成方式 |
素材剪辑+AI编排(LLM文案+TTS+素材检索+字幕+合成) |
AI生成配图/视频(ComfyUI工作流:FLUX/WAN等)+合成 |
AI原生视频生成(文本/图像直接生成视频画面) |
|
部署方式 |
本地/Docker/云端/Colab全支持 |
Windows整合包/源码/Docker |
纯云端SaaS |
|
GPU依赖 |
非必须(云端LLM+TTS+素材) |
完全免费方案需本地GPU |
必须(云端算力) |
|
成本 |
API调用费用(Pexels免费+LLM按量付费) |
免费0元到云端0.5-2美元/条 |
昂贵订阅费 |
|
可定制性 |
极高(开源+MIT协议可商用) |
极高(Apache 2.0+原子化替换) |
低(黑盒) |
|
端到端程度 |
全流程自动化(含跨平台发布) |
全流程自动化(含数字人/图生视频) |
部分环节 |
|
画面原创性 |
网络素材(高清无版权但同质) |
AI原创配图/视频(风格可控) |
AI原生画面(最灵活) |
|
GitHub热度 |
9.2万+Star(老牌头部) |
2.5万+Star(快速崛起) |
闭源,不适用 |
选型建议:追求低门槛、零GPU依赖、快速批量产出素材剪辑类短视频,选择MoneyPrinterTurbo;追求画面原创性与风格统一(AI生成配图而非网络素材)、需要数字人/图生视频等深度定制能力,选择Pixelle-Video;需要凭空生成不存在的动态画面,则需叠加文生视频模型(如Wan2.2、CogVideo等),技术路径上完全可以将这类能力接入MoneyPrinterTurbo的Pipeline架构。
十、总结
MoneyPrinterTurbo之所以能在GitHub上斩获9.2万+Star,根本原因在于它精准地击中了短视频内容生产的痛点:门槛高、效率低、成本不可控。它用"一键全流程"的设计理念,把LLM、TTS、ASR、视频合成、素材检索五条技术链路串联成一条自动化Pipeline,让"一个人+一个想法=无限视频产能"成为可能。
从技术角度看,项目采用MVC架构特化设计,分层清晰、模块解耦合理:用户入口层(Streamlit WebUI/FastAPI REST API/CLI)→控制器层(任务队列/批量调度/状态管理,内存或Redis双模式)→核心服务层(LLM/语音/素材/字幕/视频五大服务)→输出1080P成片。九步生成管线(脚本生成→搜索词提取→TTS→素材检索→字幕→拼接→混音→渲染)通过Task Service统一编排,双LLM机制保证叙事与画面的语义对齐,双引擎TTS与双引擎字幕在速度与质量之间灵活取舍。LLM适配器模式支持16+提供商(LiteLLM网关扩展至100+),多密钥素材源轮换、批量生成、跨平台自动发布等能力使其成为完整的内容生产基础设施。
部署上,Windows一键启动包让零基础用户双击即用,Docker方案适配生产环境,手动部署与Google Colab满足开发者与临时体验需求。MIT协议开源意味着可以自由二次开发和商业化——无论是个人创作者寻找低门槛批量生产工具,还是开发者学习"多AI能力编排成端到端应用"的工程范本,亦或是企业搭建可私有化、可API集成的短视频生产流水线,MoneyPrinterTurbo都值得一试。
当然,它目前仍是一个"智能剪辑工具"而非"AI原生视频生成器"——素材匹配的语义深度、转场的丰富度、画面与文案的对齐精度都有提升空间。但随着AI视频生成模型的持续进步(Wan2.2、CogVideo等),将这些能力接入其Pipeline架构的技术路径是通畅的。工具提供的是"生产力"而非"创造力",真正的内容竞争力依然来自创作者独特的选题视角与表达风格。在AI视频工具快速迭代的当下,掌握MoneyPrinterTurbo这类开源引擎,就是掌握了短视频工业化生产的基础能力。



评论前必须登录!
注册