 网硕互联帮助中心
GPT-6 Sol / Luna / Astra 怎么选:智力、价格、上下文与场景对照(附 5.6 Luna)
OpenAI 在 9 月把 GPT-6 拉成一条「能力—成本」曲线:Astra 扛旗舰,Sol / Luna 把同代能力摊到更低单价。后端最常踩坑的不是「哪个最强」,而是按任务错配预算。下面只抠官方文档和能核验的第三方评测,整理一张能直接落地的选型表。
检索日:2026-09-23(Asia/Shanghai)。价格取 API Standard 短上下文(USD / 1M tokens)。文中不写「GPT-6 Terra」——该型号官方模型页 404,属不存在产品。
一、先看一张价差图
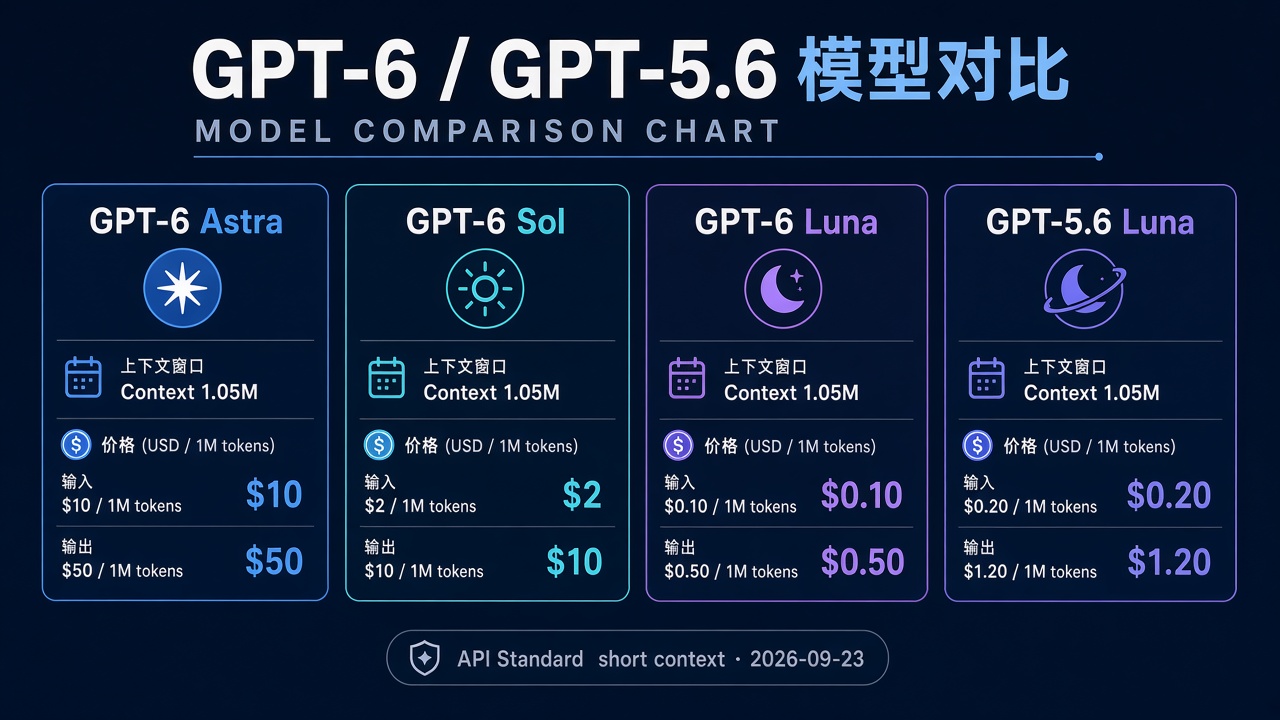 四个型号的上下文窗口都是 1.05M、最大输出 128K。差异主要在单价和官方定位,不是「谁上下文更大」。
| GPT-6 Astra | 2026-09-03 | 1.05M | $10 / $50 | 模型页 · 公告 |
| GPT-6 Sol | 2026-09-22 | 1.05M | $2 / $10 | 模型页 · Sol/Luna 公告 |
| GPT-6 Luna | 2026-09-22 | 1.05M | $0.10 / $0.50 | 模型页 |
| GPT-5.6 Luna | 家族 2026-07-09 | 1.05M | $0.20 / $1.20 | 模型页 · 5.6 家族 |
定价总表:OpenAI API Pricing。相对 GPT-5.6 促销价,官方明确 Sol / Luna 输入与输出均降约 50%(5.6 Sol $4/$20 → 6 Sol $2/$10;5.6 Luna $0.20/$1.20 → 6 Luna $0.10/$0.50)。
补充计费细则(Sol / Luna,见模型页):
- 长上下文(输入 >272K):Input/Cache 读 ×2,Output ×1.5
- Cached input 更便宜(Sol Cached $0.20;Luna Cached $0.01)
- Batch / Flex 约 50%;Fast 档约 ×2
Astra 仍是「most capable」旗舰;其 reasoning.effort 没有 none(low→max),适合不妥协质量的端到端任务。安全概述可一并阅读。
二、能力怎么读:官方定位 + 第三方边界
官方怎么说
| Astra | gpt-6-astra | most capable | 最难研究 / computer use / 旗舰 Agent |
| Sol | gpt-6-sol | complex coding and agentic workflows | ChatGPT Work / Codex(付费档)+ API |
| Luna(6) | gpt-6-luna | most efficient for focused, high-volume tasks | 高通量;Free/Go 可桌面用 Luna |
| 5.6 Luna | gpt-5.6-luna | 上一代高效档 | 旧栈基线、迁移对照 |
来源:Sol & Luna 介绍、社区公告。
可用性红线:Sol / Luna 尚未进入 Chat,只在 Work / Codex / API;Enterprise token 计费见 ChatGPT Rate Card。订阅各档「月费额度」本次未做逐档核实,选型以 API 单价为准。
第三方:别写成「全面碾压」
Artificial Analysis(2026-09-22) 的要点,更适合后端做预算:
- Sol / Luna 推的是成本效率前沿,智力指数相对 5.6 大致持平,不宜写「6 全面碾压 5.6」
- 相对 5.6 Sol,Sol(6) 任务成本约减半量级
- Luna(6) Intelligence Index max 约 37(与 5.6 Luna 同分);Coding Agent 略降;任务成本约 $0.07 vs 前代约 $0.18
官方自评(AutomationBench、FrontierCode、DeepSWE、OSWorld 等)数字多,且多为自家环境/API。本文不转述具体百分比作独立结论;若要引用,请回官方公告原文核对。
三、场景决策:xxx 情况下用谁
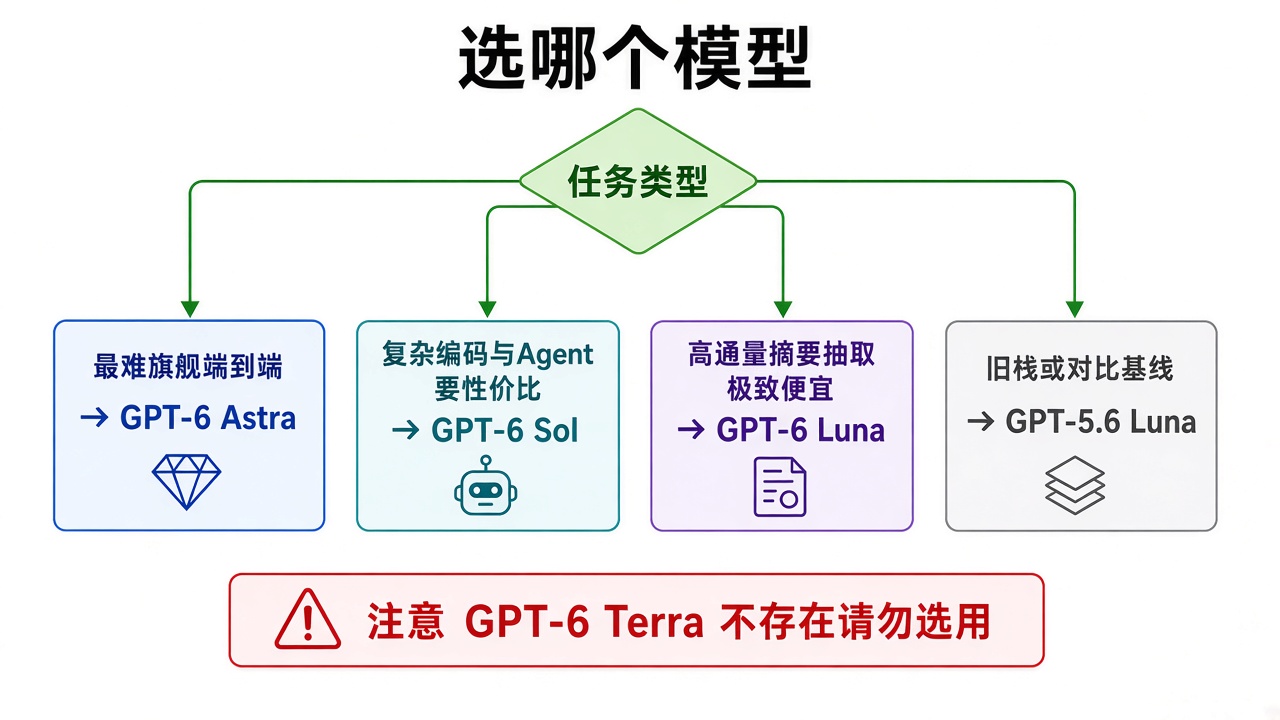
| 最难推理 / 研究 / computer use,要旗舰端到端 | GPT-6 Astra | 官方 most capable;$10/$50 |
| 复杂编码与 Agent 工作流,要能力与价平衡 | GPT-6 Sol | 官方定位 + $2/$10;相对 5.6 Sol 约半价 |
| 高通量摘要、抽取、分类、快问快答,极致成本 | GPT-6 Luna | 官方 efficient high-volume;$0.10/$0.50;Free/Go 桌面可用 |
| 仍跑旧栈,或需要与上一代对照的基线 | GPT-5.6 Luna | 仍在定价表;$0.20/$1.20 |
| 听说「GPT-6 Terra」想试用 | 不要选 | 模型页 404;存在的是 GPT-5.6 Terra |
一句话记忆:
- 钱几乎不是问题、结果必须最好 → Astra
- 写代码 / 跑 Agent、要性价比 → Sol
- 流水线灌量、每条请求都要便宜 → Luna(6)
- 暂时不迁、只做 A/B → 5.6 Luna
四、按 reasoning.effort 对照:思考强度 ≠ 上下文窗口
先拆开两个概念:
- 上下文窗口:四个型号都是 1.05M,是「一次能塞多少 tokens」的上限。
- 思考强度:API 里的 reasoning.effort,决定链式推理花多少算力。把「窗口大」当成「想得深」是常见误读。
官方档位见 Reasoning guide。没有 ultra 这一档——别把社区口头禅写进配置。
| Sol / Luna | none → low → medium(默认)→ high → xhigh → max | 模型页枚举 |
| Astra | 无 none(设 none → HTTP 400);low→max | 旗舰始终带推理 |
另有正交维度 reasoning.mode:standard(默认)/ pro(更贵更慢),不要和 effort 混成一个旋钮。
官方档位语义(摘要)
| none | 极低延迟、分类/抽取等,不需要链式推理 |
| low | 要工具/多步,但仍偏速度与成本 |
| medium | 默认;质量与成本平衡;多数 agent/编码入口 |
| high | 难推理、复杂调试;质量优先于延迟 |
| xhigh | 长跑 agent / 深研;需用 eval 证明收益盖住成本与延迟 |
| max | 最难任务;若已在 xhigh,再评估 max 是否真更强 |
AA Intelligence Index 按 effort(第三方)
Sol(AA 发布页):
| max | 48 | 最高 |
| xhigh | 44 | |
| high | 43 | |
| medium | 40 | |
| low | 34 | 单任务成本约 $0.13(AA) |
| Non-reasoning(≈none) | 28 |
Luna(AA 发布页):
| max | 37 | 最高 |
| xhigh | 34 | |
| high | 32 | |
| medium | 29 | |
| low | 21 | 单任务成本约 $0.0045(AA) |
| Non-reasoning | 18 |
速度量级(AA,tokens/s):Sol low≈129 / max≈115;Luna low≈176 / max≈154。抬 effort 换智力,也换延迟和费用。
官方公告里 Sol 常以 xhigh 出 AutomationBench 等数字,max 未必处处最优;DeepSWE 上 Sol max 68.8%、Luna max 66.6% 等为仅官方表述,引用请回 Sol/Luna 公告 核对。
怎么配(可落地)
| 默认上线 | 先 medium |
| 高量还要分数 | Luna + max(仍远便宜);别用 Sol low「假装省钱」 |
| 复杂编码 Agent | Sol high → xhigh,再用业务 eval 决定是否 max |
| 旗舰最难 | Astra high → max(永远不要传 none) |
网关里把 model 和 reasoning.effort 做成两个独立字段,比「换更大窗口」更能控账单。
五、后端落地:三条可运行对照
同一套 Messages API 形状,只换 model,方便在网关里做路由。
# 依赖:openai>=1.40;环境变量 OPENAI_API_KEY
from openai import OpenAI
client = OpenAI()
ROUTES = {
"hard": "gpt-6-astra", # 旗舰
"agent": "gpt-6-sol", # 编码 / Agent
"bulk": "gpt-6-luna", # 高通量
"baseline": "gpt-5.6-luna",
}
def chat(route: str, prompt: str, effort: str | None = None) –> str:
model = ROUTES[route]
kwargs = {
"model": model,
"messages": [{"role": "user", "content": prompt}],
}
# Sol/Luna: none|low|medium|high|xhigh|max;Astra 无 none(传 none→400)
# 勿传 ultra(非官方枚举)
if effort is not None:
kwargs["reasoning"] = {"effort": effort}
resp = client.chat.completions.create(**kwargs)
return resp.choices[0].message.content or ""
if __name__ == "__main__":
print(chat("bulk", "用三句话总结这段日志的错误类型:…", effort="low"))
print(chat("agent", "给这个失败用例写最小复现 PR 说明:…", effort="high"))
print(chat("hard", "跨仓库排障并给出最终变更清单:…", effort="max"))
网关侧建议:
六、和 5.6 世代怎么比(写进评审材料)
| 单价(Sol/Luna) | 相对 5.6 促销价约 −50% | 官方公告 |
| 智力指数(第三方) | 大致持平,勿写全面碾压 | Artificial Analysis |
| 上下文 | 四型号同为 1.05M | 各模型页 |
| 旗舰 | Astra 仍是同代顶格 | Astra 公告 |
若你线上仍是 gpt-5.6-sol(Input $4 / Output $20,促销至少至 2026-11-21,见 5.6 Sol 模型页),迁到 gpt-6-sol 通常是「单价腰斩、能力同代对齐」的优先动作;Luna 同理。
七、适用与局限
适合写进选型文档的:
- 多型号路由表 + 单价上限(Finance 友好)
- Agent / Codex 默认 Sol,批处理默认 Luna,人工升级 Astra
- 迁移期保留 5.6 Luna 作对照基线
本文明确不做的:
- 不编造 ChatGPT 各订阅档「每月多少消息」——待官方费率页核实
- 不把官方内部 factuality / deception 百分比当第三方结论
- 不讨论「GPT-6 Terra」场景
八、真实账单怎么估算(别只看标价)
假设你有一条「日处理 50 万次」的摘要流水线,每次约 2K input + 0.4K output(短上下文):
| GPT-6 Luna | 1.0e9 | 2.0e8 | 1e9×0.10/1e6 + 2e8×0.50/1e6 ≈ $200 |
| GPT-5.6 Luna | 同左 | 同左 | ≈ $440 |
| GPT-6 Sol | 同左 | 同左 | ≈ $4000 |
| GPT-6 Astra | 同左 | 同左 | ≈ $20000 |
数字是「无缓存、无 Batch」的上限感;Prompt Cache 命中升高后,Input 侧会明显下降。反过来,整仓日志塞进 300K+ 上下文,Sol/Luna 会触发长上下文溢价,账单曲线会陡起来。结论很直白:高通量场景硬上 Sol/Astra,是最常见的预算事故。
Agent 场景则相反。一次「跨文件改 bug + 跑测试」可能烧掉 80K–200K tokens;单价差会被放大,但 Luna 在 Coding Agent 上的第三方观感偏弱,官方也把 Sol 定位成 coding / agentic 主力。经验法则:
- 单次任务价值高、失败成本高(线上事故、安全变更)→ 偏 Sol,关键路径再升 Astra
- 单次任务可重试、可降级(批量打标签、夜间批处理)→ Luna
- 需要人审的「最终答案」再升档,而不是全程开旗舰
九、和常见竞品叙事怎么对齐(写给评审)
公开材料里,OpenAI 用 AutomationBench、Agents’ Last Exam、FrontierCode、DeepSWE、OSWorld 等自家或公开基准,把 Sol 描述成「接近更贵竞品、但任务成本更低」;Luna 则强调「在更低成本下追上或部分超过上一代 Sol」。写给后端评审,三句话够用:
不要把官方自评的百分点抄成「行业共识」。业务方追问「比 Claude / 某竞品强多少」时,把他们带回 Sol/Luna 公告原文 与 Artificial Analysis 文章,让对方自己读图,比二次转述更稳。
十、迁移清单(从 5.6 到 6)
十一、常见误区
- 误区 1:上下文越大越好。 四型号都是 1.05M,差别不在窗口,在价与定位。
- 误区 2:一律上 Astra。 旗舰适合「最难那 5%」;其余 95% 用 Sol/Luna 更符合官方产品叙事。
- 误区 3:Luna 便宜就拿去写大重构。 高通量定位 ≠ 复杂 Agent 最优;复杂变更优先 Sol。
- 误区 4:在 Chat 里找 Sol/Luna。 当前文档写明尚未进 Chat,只在 Work/Codex/API。
- 误区 5:搜到 GPT-6 Terra 就接进路由。 官方模型页 404;存在的是 GPT-5.6 Terra。接错 id 会在上线当天才暴露。
- 误区 6:把 AA 指数持平读成「没必要升级」。 同智更低价,本身就是升级理由;尤其是按 token 计费的 Agent 长会话。
- 误区 7:把 1.05M 窗口当成思考强度,或配置 ultra。 窗口与 reasoning.effort 正交;官方枚举无 ultra。
十二、给架构评审的一页纸结论
如果只允许带走三句话:
落地顺序建议:先改网关路由与监控 → 再迁非关键流量到 Luna → 编码 Agent 默认可迁 Sol → Astra 保留为显式升级。全程保留 5.6 Luna 对照一周,比「大爆炸切流」更容易向业务交代。
小结
GPT-6 不是「一个模型换皮」,而是 Astra(顶)— Sol(编码/Agent 性价比)— Luna(高通量低价) 三条产品线,外加仍可用的 5.6 Luna 基线。上下文都是 1.05M,真正决定账单的是单价与任务类型。按上表路由,比纠结「谁智商更高」更接近生产现实。


评论前必须登录!
注册