 网硕互联帮助中心
温馨提示:本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片🍅
🍅本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片🍅
🍅本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
一、项目概述
1.1 项目背景
2026 年全国高考报名人数为 1290 万人,比 2025 年的 1335 万减少 45 万(教育部 2026 年 6 月 3 日发布)。除新疆、西藏外,全国已有 29 个省份完成新高考落地,其中 23 个省份采用「3+1+2」模式,北京、天津、上海、浙江、山东、海南 6 省市采用「3+3」模式。
招生端的规模同样可观。截至 2026 年 6 月 17 日,全国高等学校共 3196 所,其中普通高等学校 2952 所(本科 1412 所、高职专科 1540 所),成人高等学校 244 所(教育部 2026 年 6 月 18 日发布)。与此同时,2026 年 3 月国家发改委明确,「十五五」期间「双一流」高校本科累计扩招总规模将达到 10 万人以上,优质本科名额在扩容,但分布并不均匀。
真正的问题不在数据量,而在决策窗口。从出分到志愿填报截止,多数省份只有 3 到 5 天。考生和家长要在几天里完成:查一分一段表定位次 → 读懂本省批次与投档规则 → 从几千个「院校专业组 / 专业+院校」候选中筛出几十上百条 → 判断每一条是冲、是稳还是保 → 核对选科要求、单科限制、体检限制、外语语种、学费 → 排出顺序并决定是否服从调剂。任何一个环节出错,代价是滑档或退档,而这个结果不可逆。
信息本身的碎片化加剧了难度:招生章程在高校官网,一分一段表和投档线在省考试院,选科要求在阳光高考平台,就业数据在各类第三方平台。格式不统一、更新节奏不同步,靠人工比对既慢又容易漏。
教育部「阳光志愿」信息服务系统在 2026 年完成升级,提供了权威的免费公共服务;但它解决的是信息供给问题,不解决个体决策排序问题——「以我这个位次、这个选科组合、这个偏好,志愿表应该怎么排」,仍然需要考生自己做。
本项目要做的,就是这件事的工程化实现。
1.2 项目定位
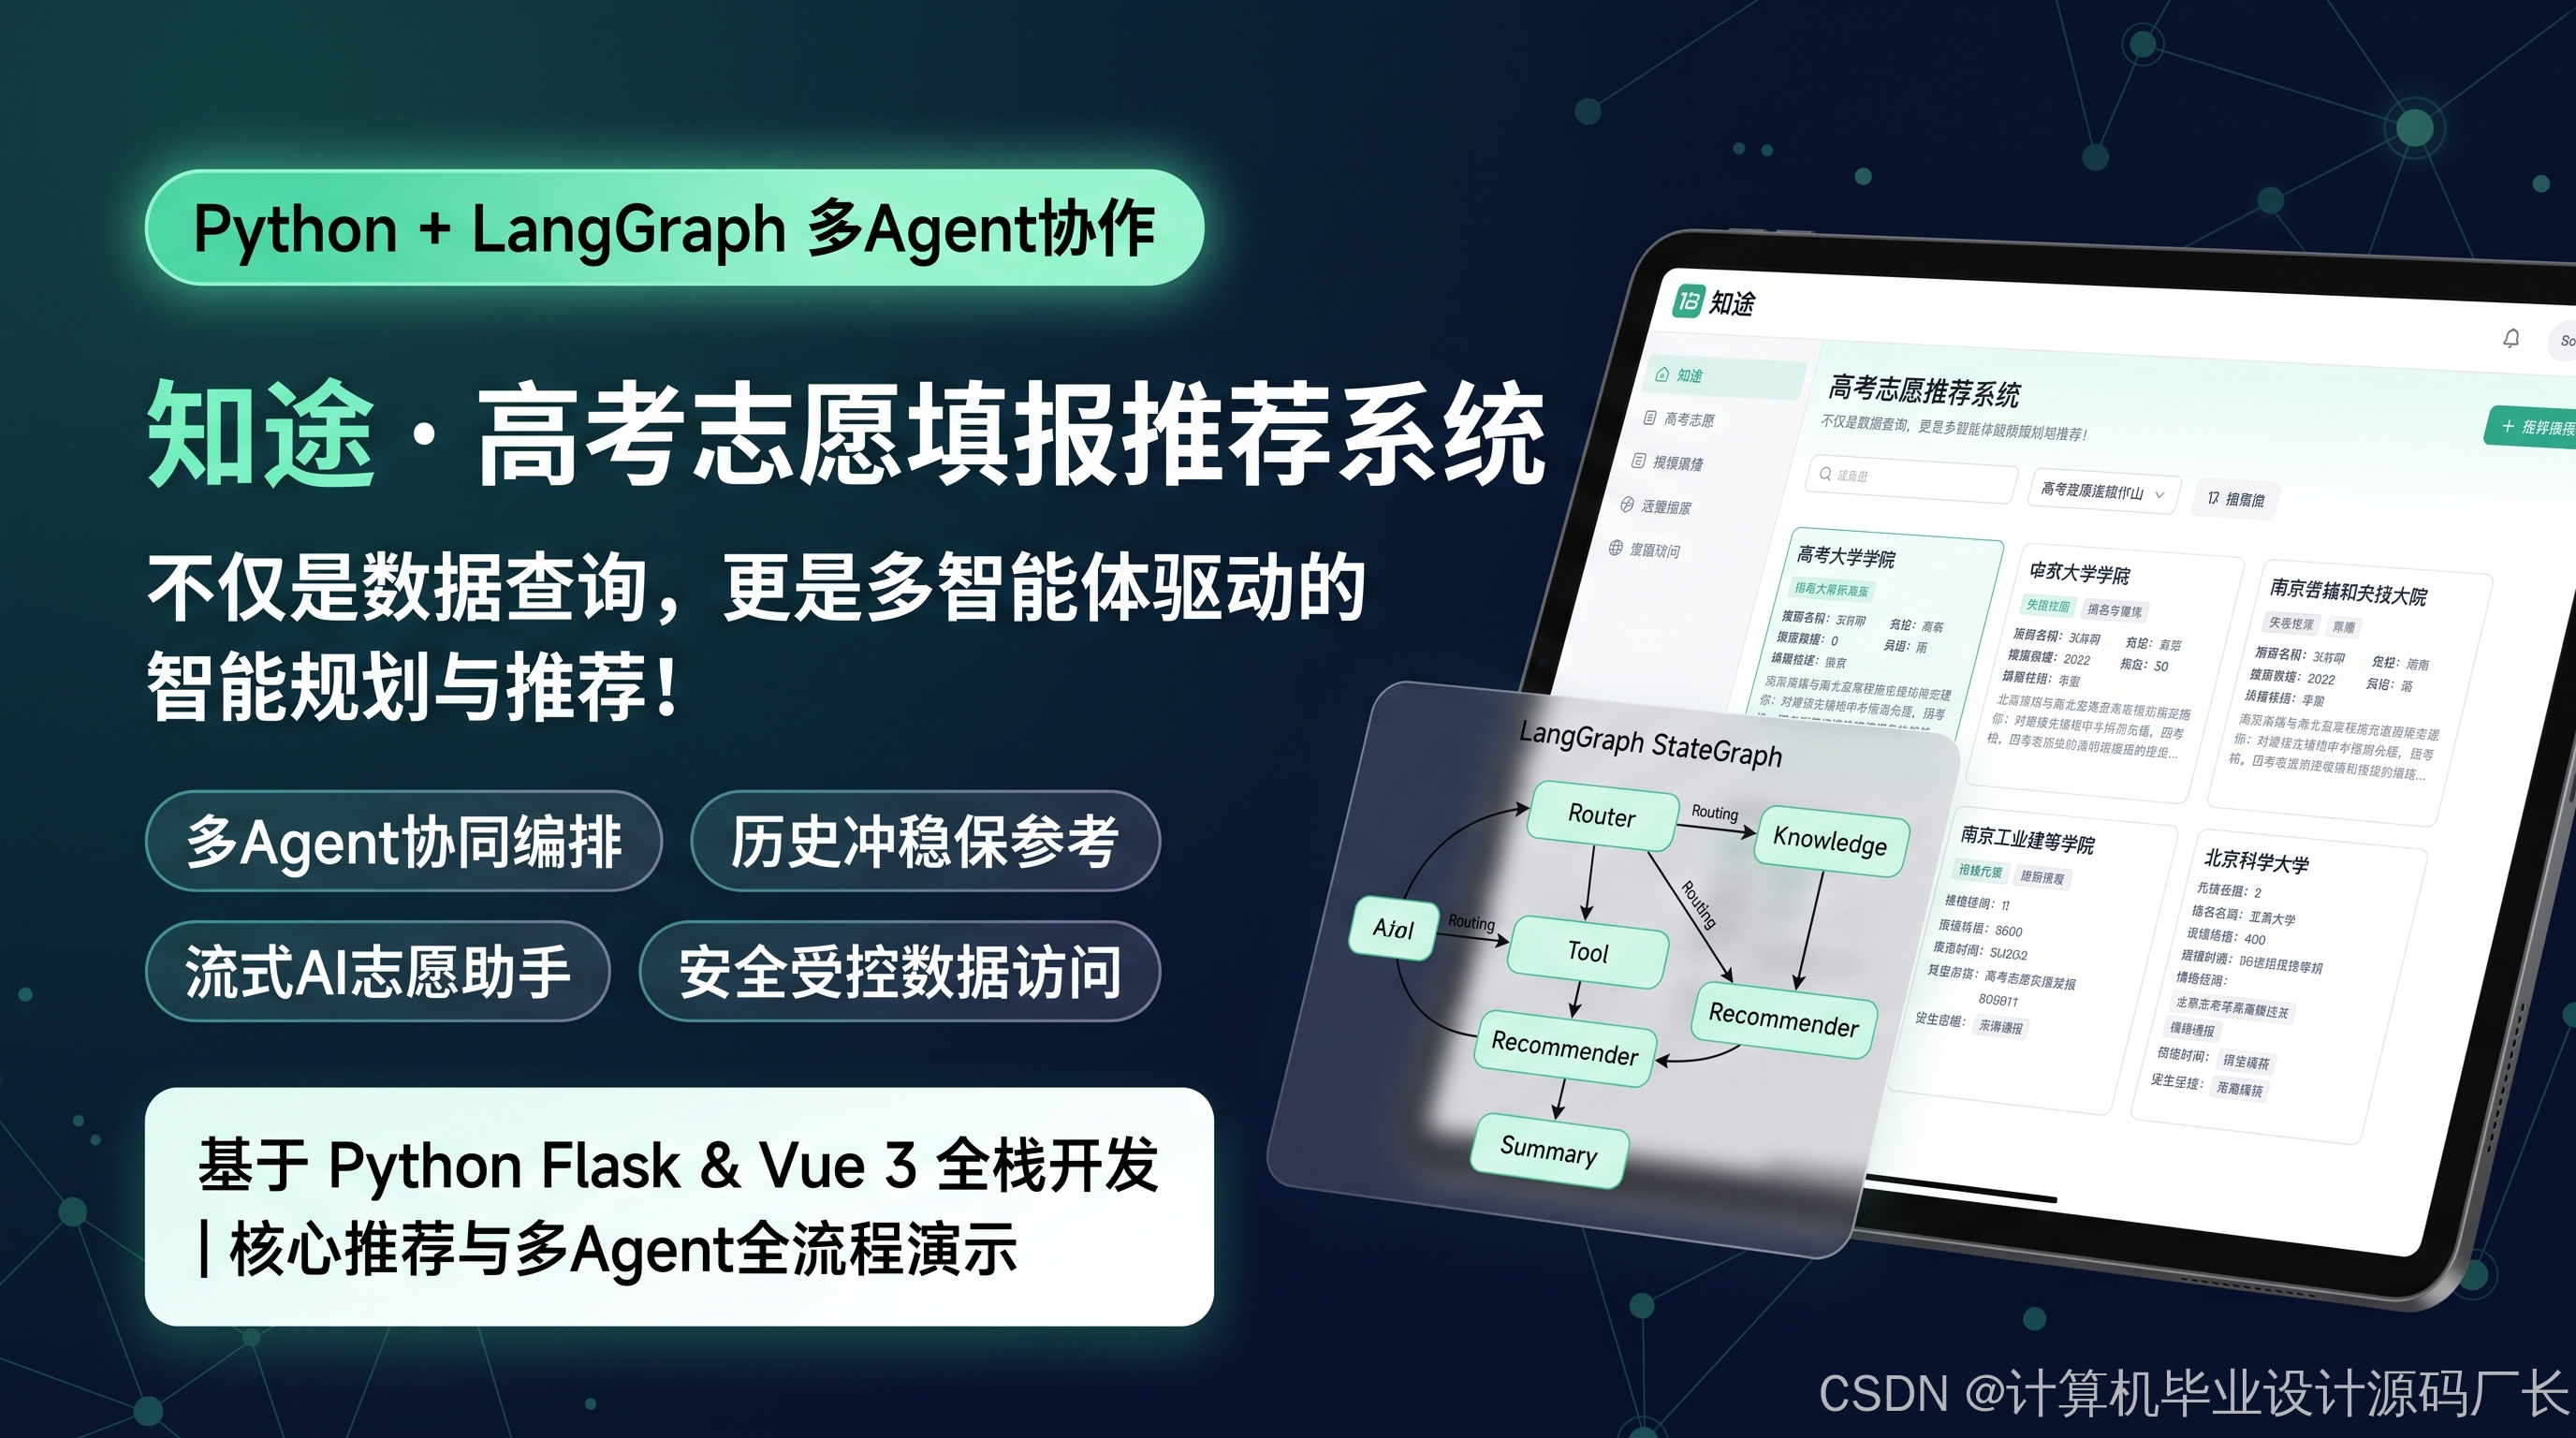
一句话说清楚:这不是一个替你填报的系统,而是一个把决策依据整理成可解释、可核验志愿草表的系统。
系统输出的是「草表 + 理由 + 风险提示」,最终填报动作仍由考生本人在省级官方填报系统中完成。这条边界必须写进产品文案、写进接口注释、写进免责声明。
1.3 项目目标(可量化)
表格
| G1 | 省份覆盖 | ≥ 29 个新高考省份,含「3+1+2」与「3+3」两类规则 |
| G2 | 数据覆盖 | 院校专业组 / 专业+院校条目 ≥ 60 万条,含近 3—5 年录取位次 |
| G3 | 响应性能 | 生成一份完整志愿草表 P95 ≤ 8 秒(流式首字节 ≤ 1.5 秒) |
| G4 | 推荐质量 | 用 2023—2025 年真实数据回测,稳档 + 保档命中率 ≥ 92%,滑档率 = 0 |
| G5 | 数据可信 | 草表中每条志愿的位次/计划数据可溯源到具体数据源,幻觉率 < 1% |
| G6 | 成本控制 | 单次会话(含多轮追问)LLM 成本 ≤ 0.15 元 |
| G7 | 并发能力 | 填报高峰期支撑 500 QPS 稳定运行,可用性 ≥ 99.9% |
1.4 项目边界
本项目要做:
- 结构化采集与治理官方招生数据
- 位次换算、冲稳保分层、硬约束过滤、志愿排序
- 多 Agent 协作生成志愿草表并给出可解释理由
- 风险提示(滑档风险、退档风险、大小年波动提示)
本项目不做:
- 不替代省级官方志愿填报系统,不做任何形式的代填报
- 不做最终录取承诺,不输出「保录取」类表述
- 不采集、不存储考生身份证号、考生号等敏感身份信息
- 不炒作「高考状元」「高分考生」「升学率」,不做付费代报业务
二、需求分析
2.1 用户角色
表格
| 考生本人 | 我这个分数/位次能报什么,怎么排不出错 | 出分后 3—5 天内的密集决策期 |
| 考生家长 | 规则看不懂,想有个能核对的参照 | 与考生共同决策,偏好城市/稳定性 |
| 升学指导老师 | 批量给学生出参考方案,需要可核验 | 学校组织的志愿填报指导会 |
| 内容运营 | 维护省份规则库与数据更新 | 每年 5—8 月数据迭代期 |
2.2 核心痛点拆解
2.3 功能性需求
表格
| FR-01 | 考生信息采集 | 支持表单录入与自然语言输入两种方式,抽取省份、科类、选科组合、分数、位次、偏好等字段 | P0 |
| FR-02 | 位次自动定位 | 依据省份 + 首选科目组 + 分数,从当年一分一段表反查全省位次 | P0 |
| FR-03 | 等效位次换算 | 将当年位次换算为往年等效位次,支持特控线/本科线两种口径 | P0 |
| FR-04 | 省份规则加载 | 按省份加载当年批次设置、志愿数量、投档规则、调剂范围 | P0 |
| FR-05 | 候选院校专业组检索 | 按位次区间、选科、地域、办学层次、学费等条件召回候选集 | P0 |
| FR-06 | 硬约束过滤 | 自动剔除选科不符、单科不达标、体检受限、语种不符的条目 | P0 |
| FR-07 | 冲稳保分层 | 按近 3 年最低位次加权均值划分冲/稳/保三档并估算录取概率 | P0 |
| FR-08 | 志愿草表生成 | 输出有序志愿表,含院校专业组代码、组内专业排序、调剂建议 | P0 |
| FR-09 | 结果校验审核 | 独立审核 Agent 复核数据真实性、梯度合理性、滑档/退档风险 | P0 |
| FR-10 | 可解释理由 | 每条志愿给出「为什么放在这一档」的数据依据与来源 | P1 |
| FR-11 | 多轮追问 | 支持「换城市」「加保底」「不接受某专业」等调整指令并重算 | P1 |
| FR-12 | 生涯倾向测评 | 集成霍兰德/MBTI 类测评,输出专业倾向标签辅助筛选 | P2 |
| FR-13 | 方案导出 | 导出为 Excel / PDF 志愿草表,供线下核对 | P2 |
| FR-14 | 规则库管理后台 | 运营维护各省规则与数据版本,支持灰度发布 | P1 |
2.4 非功能性需求
表格
| 性能 | 草表生成 P95 ≤ 8s;SSE 首字节 ≤ 1.5s;单条追问响应 P95 ≤ 4s |
| 并发 | 峰值 500 QPS,横向扩展支持至 2000 QPS |
| 可用性 | ≥ 99.9%;LLM 不可用时自动降级为纯规则引擎,保证核心功能可用 |
| 成本 | 单次会话 LLM 成本 ≤ 0.15 元;轻量任务(分类、抽取)路由到小模型 |
| 可观测 | 全链路追踪(LangSmith / OpenTelemetry),每个节点的输入输出、耗时、token 消耗可查 |
| 数据时效 | 省份规则与招生计划在官方发布后 24 小时内完成更新 |
| 安全 | 会话数据加密存储;敏感字段脱敏;不留存身份信息 |
| 合规 | 页面显著位置标注数据来源与免责声明;不出现录取承诺类表述 |
2.5 合规红线(硬性约束)
三、总体架构设计
3.1 四层架构
系统分为接入层、编排层、Agent 层、数据与模型层四层。分层的关键目的是让新增一个 Agent 不需要改动其他 Agent 的代码——只需在编排层注册节点和边。
- 接入层:Web / 小程序前端,REST API 负责常规请求,SSE 负责流式推送 Agent 执行进度。
- 编排层:LangGraph 图运行核心。所有 Agent 作为节点挂载在这张图上,节点之间的跳转、循环、并行、中断全部由图定义,而不是散落在业务代码的 if-else 里。
- Agent 层:每个 Agent 有独立的提示词、模型配置、工具集与记忆,彼此不直接通信,全部通过共享状态对象交换数据。
- 数据与模型层:PostgreSQL 存结构化招生数据,pgvector 存招生章程与专业解读的向量索引,Redis 承担缓存与任务队列,模型网关统一接入不同大模型并按任务类型路由。
mermaid
数据与模型层
Agent 层
编排层 · LangGraph
接入层
Web / 小程序前端
REST API + SSE 流式通道
Supervisor 总调度
策略子图
检索子图
审核子图
Checkpointer / Store
9 个专职 Agent 独立上下文 / 独立工具集
PostgreSQL + pgvector
Redis 缓存 / 队列
模型网关 · 按任务路由
官方数据源
3.2 技术选型
表格
| 编排框架 | LangGraph 1.2 | 状态图模型,原生支持循环、条件跳转、并行分支、断点恢复 |
| 模型层 | 多模型网关 | 抽取/分类走小模型,策略生成与审核走推理模型,成本可降 30% 以上 |
| 工具协议 | MCP | 2026 年工具接入的事实标准,便于复用外部数据工具 |
| 持久化 | PostgreSQL + PostgresSaver + PostgresStore | Checkpointer 管线程状态,Store 管跨会话长期记忆 |
| 向量检索 | pgvector | 招生章程、专业解读的语义召回 |
| 服务层 | FastAPI + SSE | 异步流式输出,前端实时展示 Agent 协作过程 |
| 缓存与队列 | Redis | 一分一段表热数据缓存、异步任务队列 |
| 可观测 | LangSmith + OpenTelemetry | 节点级 trace,便于定位协作链路问题 |
| 前端 | Vue 3 / React 19 | 表单 + 志愿表 + 协作过程可视化 |
四、多 Agent 设计与 LangGraph 编排
4.1 为什么用 LangGraph 而不是 Chain
先把一个常见误区说清楚:在系统提示词里写「你现在既是资深升学规划师,又是数据专家」,然后调用一次模型,这不是多智能体,只是一次 Prompt 更复杂的单次调用。真正的多智能体至少要满足三点:每个 Agent 有独立上下文与记忆、有独立目标与工具集、Agent 之间有结构化的协作机制。
在志愿填报这个场景里,协作链路天然是非线性的:位次换算结果不理想时要回退重新检索;审核不通过时要回到策略节点重排;用户中途改偏好要能局部重算而不是全量重来;还要在关键节点停下来等用户确认。用固定流水线写,代码会迅速膨胀到无法维护。
LangGraph 把流程建模成有向图:节点是计算步骤,边是控制流。这套模型带来三个直接好处:
4.2 Agent 角色清单
系统设 1 个 Supervisor + 9 个专职 Agent。
表格
| 0 | Supervisor(调度) | 拆解任务、决定下一个执行的 Agent、汇总结果、判断终止 | 无(纯路由决策) |
| 1 | IntakeAgent 需求解析 | 从表单或自然语言抽取结构化考生画像 | 表单校验、字段抽取 |
| 2 | PolicyAgent 政策规则 | 加载该省当年批次、志愿数量、投档规则、调剂范围 | 规则库查询 |
| 3 | ProfileAgent 生涯画像 | 兴趣/性格测评结果 + 学科能力 → 专业倾向标签 | 测评量表、标签映射 |
| 4 | RetrievalAgent 数据检索 | 按条件召回候选院校专业组,返回含近 3—5 年位次的候选集 | 结构化检索、pgvector 召回 |
| 5 | RankAgent 位次换算 | 一分一段表 + 批次线位次 → 等效位次 / 等效分 | 换算引擎 |
| 6 | StrategyAgent 冲稳保策略 | 分层、估算录取概率、分配冲稳保名额 | 概率模型、名额分配规则 |
| 7 | PlanAgent 志愿表生成 | 排序、组内专业排序、调剂建议、梯度校验 | 排序打分函数 |
| 8 | CriticAgent 校验审核 | 硬约束复核、数据溯源核对、滑档/退档风险识别 | 校验规则集、数据比对 |
| 9 | ExplainAgent 解释问答 | 生成可解释理由、支撑多轮追问 | RAG + 引用溯源 |
各 Agent 的执行边界:
- IntakeAgent、PolicyAgent 可以并行执行,两者互不依赖。
- RetrievalAgent 内部按院校层次扇出多个并行分支(985/211、省重点、普通本科、职业本科),结果汇聚。
- CriticAgent 与 StrategyAgent 之间构成反馈环,最多循环 2 轮,超过则降级为规则引擎输出并提示人工复核。
4.3 共享状态设计
所有 Agent 通过一个显式的状态对象交换数据。并行分支写回的字段必须带 reducer,否则会互相覆盖——这是多 Agent 落地时最容易踩的坑之一。
python
from typing import Annotated, Literal, TypedDict import operator class StudentProfile(TypedDict, total=False): """考生结构化画像""" province: str # 省份,如 "河南" exam_mode: str # "3+1+2" 或 "3+3" subject_group: str # 首选科目组:"物理" / "历史" electives: list[str] # 再选科目,如 ["化学", "生物"] score: int # 高考总分 rank: int # 全省位次(首选科目组内) major_pref: list[str] # 专业偏好 city_pref: list[str] # 城市偏好 tuition_limit: int # 学费上限(元/年) accept_adjust: bool # 是否服从专业组内调剂 physical_limit: list[str] # 体检受限项 single_subject: dict # 单科成绩,如 {"数学": 132} class Candidate(TypedDict): """候选院校专业组""" code: str # 院校专业组代码 school: str group: str majors: list[str] min_rank_hist: dict[int, int] # {年份: 最低录取位次} plan_count: int # 当年招生计划数 subject_req: list[str] # 选科要求 source: str # 数据来源标识,用于溯源 class PlanState(TypedDict): """图共享状态""" profile: StudentProfile rules: dict # 该省当年规则 equiv_rank: float # 等效位次 candidates: list[Candidate] buckets: dict[str, list[dict]] # {"chong": […], "wen": […], "bao": […]} draft: list[dict] # 志愿草表 review: dict # 审核意见 trace: Annotated[list[str], operator.add] # 并行分支需 reducer errors: Annotated[list[str], operator.add]
4.4 编排拓扑
采用 Supervisor + 分层 的混合拓扑,而不是纯点对点 swarm。原因是志愿填报对路由准确率的要求高于对延迟的要求:一条志愿放错档位,后果比多花两秒严重得多。Supervisor 的职责只有路由,提示词聚焦,路由准确率更稳。
拓扑结构如下:
- 入口:考生输入 → Supervisor 拆解任务
- 并行段:IntakeAgent 与 PolicyAgent 并行;RetrievalAgent 按院校层次扇出
- 汇聚段:RankAgent 结果 + 候选集 → StrategyAgent 分层
- 生成段:PlanAgent 产出草表
- 反馈环:CriticAgent 审核 → 不通过则回 StrategyAgent 重排(≤ 2 轮)
- 中断段:人工确认(Human-in-the-Loop)
- 出口:ExplainAgent 输出理由与风险提示
mermaid
不通过 · 回退重排
通过
调整偏好
确认
考生输入
Supervisor 调度
IntakeAgent 需求解析
PolicyAgent 政策规则
RankAgent 位次换算
RetrievalAgent 数据检索 按院校层次并行扇出
StrategyAgent 冲稳保分层
PlanAgent 志愿表生成
CriticAgent 校验审核
人工确认 HITL
ExplainAgent 输出草表 + 理由 + 风险
4.5 关键实现骨架
图构建部分,节点上直接挂超时与重试策略:
python
from langgraph.graph import StateGraph, START, END from langgraph.types import Command, Send, RetryPolicy from langgraph.checkpoint.postgres import PostgresSaver def build_graph(checkpointer: PostgresSaver): g = StateGraph(PlanState) # 节点:超时与重试策略挂在节点上,不用在业务代码里写 try/except g.add_node("supervisor", supervisor_node) g.add_node("intake", intake_node, timeout=20) g.add_node("policy", policy_node, timeout=15) g.add_node("retrieve", retrieve_node, timeout=30, retry_policy=RetryPolicy(max_attempts=3)) g.add_node("convert_rank", convert_rank_node, timeout=10) g.add_node("stratify", stratify_node, timeout=20) g.add_node("build_plan", build_plan_node, timeout=30) g.add_node("critic", critic_node, timeout=30) g.add_node("confirm", confirm_node) # HITL 中断点 g.add_node("explain", explain_node, timeout=30) g.add_edge(START, "supervisor") g.add_conditional_edges( "supervisor", route_from_supervisor, { "intake": "intake", "policy": "policy", "convert_rank": "convert_rank", "retrieve": "retrieve", "stratify": "stratify", "build_plan": "build_plan", "critic": "critic", "explain": "explain", "end": END, }, ) g.add_edge("intake", "supervisor") # 子 Agent 执行完回调度器 g.add_edge("policy", "supervisor") g.add_edge("convert_rank", "stratify") g.add_edge("retrieve", "stratify") g.add_edge("stratify", "build_plan") g.add_edge("build_plan", "critic") g.add_edge("critic", "confirm") g.add_edge("confirm", "explain") g.add_edge("explain", END) return g.compile(checkpointer=checkpointer)
并行扇出用 Send,让检索按院校层次同时铺开:
python
def fan_out_retrieval(state: PlanState): """按院校层次并行召回,结果通过 reducer 汇聚""" scopes = ["double_first_class", "provincial_key", "ordinary_undergrad", "vocational_undergrad"] return [Send("retrieve", {**state, "scope": s}) for s in scopes]
节点内用 Command 做条件跳转,比在边函数里写判断更直观:
python
def stratify_node(state: PlanState) -> Command[Literal["build_plan", "retrieve"]]: buckets = classify_by_rank(state["equiv_rank"], state["candidates"]) # 保底档不足 5 条时回退补检索,而不是硬着头皮往下走 if len(buckets["bao"]) < 5: return Command( goto="retrieve", update={"errors": ["保底档位不足,触发补充检索"]}, ) return Command(goto="build_plan", update={"buckets": buckets})
4.6 Human-in-the-Loop:志愿表确认
志愿填报是高风险决策,草表生成后必须让用户看一眼再输出解释。interrupt() 在节点内任意位置暂停图执行,配合 Checkpointer 把状态落盘,用户确认后再用 Command(resume=…) 续跑。
python
from langgraph.types import interrupt, Command def confirm_node(state: PlanState): decision = interrupt({ "type": "plan_review", "draft": state["draft"], "risks": state["review"]["risks"], "question": "请确认志愿草表,或提出需要调整的项", }) # decision 就是前端回传的 resume 值 return { "draft": decision.get("draft", state["draft"]), "profile": {‌**state["profile"], **‌decision.get("profile_patch", {})}, }
调用侧两阶段执行:
python
config = {"configurable": {"thread_id": session_id}} # thread_id 即持久化游标 # 第一阶段:跑到 confirm 节点暂停 graph.invoke(initial_input, config=config) # 第二阶段:用户确认后带 resume 值续跑 graph.invoke(Command(resume={"draft": adjusted_draft}), config=config)
注意:interrupt 依赖 Checkpointer,没有 Checkpointer 的中断图无法恢复;生产环境用 PostgresSaver,MemorySaver 进程重启即丢。
4.7 容错、超时与降级
LangGraph 1.2 引入了节点级超时(NodeTimeoutError)与节点级错误处理器,这对志愿填报场景很关键——检索外部数据源的节点随时可能超时。
表格
| 单个检索节点超时 | 该分支返回空结果并记录 errors,其余分支继续;不阻塞整轮 |
| 外部数据源不可用 | 降级读 Redis 缓存或上一版本快照,并在输出中标注数据日期 |
| 模型网关不可用 | 整图降级为纯规则引擎(位次换算 + 硬约束过滤 + 梯度分配),保证核心可用 |
| 审核反馈环超过 2 轮 | 中止循环,输出当前最优解并提示「建议人工复核」 |
| 状态字段缺失 | 状态对象按严格 DTO 处理,写入前序列化校验,避免静默丢字段 |
| 大文件进状态 | 状态里只存引用 URL 与元数据,避免 Checkpoint 膨胀拖慢读写 |
五、核心算法与数据
5.1 数据源与数据治理
表格
| 院校与专业基础库 | 教育部阳光高考平台、全国高等学校名单 | 院校层次、办学性质、专业目录 | 年度 |
| 招生章程与选科要求 | 高校招生网、阳光高考平台 | 硬约束过滤、专业解读 | 年度 |
| 一分一段表 | 各省教育考试院 | 位次定位与等效位次换算 | 出分后即时 |
| 批次控制线 | 各省教育考试院 | 特控线/本科线口径换算 | 出分后即时 |
| 历年投档线与录取位次 | 各省教育考试院、官方公示 | 冲稳保分层依据 | 年度 |
| 当年招生计划 | 各省招生专业目录 | 计划数与稳定性评估 | 年度 |
| 就业与深造数据 | 高校就业质量报告 | 专业推荐辅助 | 年度 |
治理规则:
5.2 等效位次换算
直接拿今年分数去比往年录取线,等于用两把不同的尺子量长度。正确做法是先换算。
当年位次换算为往年等效位次的公式:
text
往年等效位次 = 当年个人位次 × (往年对应批次线位次 ÷ 当年对应批次线位次)
其中,分数在特控线之上用特控线口径,介于本科线与特控线之间用本科线口径。
python
def equivalent_rank(rank_now: int, line_rank_now: int, line_rank_prev: int) -> float: """ rank_now: 考生当年全省位次 line_rank_now: 当年对应批次线(特控线/本科线)对应的位次 line_rank_prev: 往年同一批次线对应的位次 """ if line_rank_now <= 0: raise ValueError("批次线位次必须为正") return rank_now * line_rank_prev / line_rank_now
为什么不用等效分?举个真实存在的年份现象:某省物理组 2025 年与 2026 年特控线分数完全相同,都是 514 分,但 514 分对应的位次从 114928 名变成 117852 名,一年差了近 3000 名。等效分法在这种情况下会算出完全一致的结论,而等效位次法能捕捉到这个漂移。同分不同位次的年份,位次口径才是可靠的。
5.3 冲稳保分层与概率估计
以近 3 年最低录取位次的加权均值作为基准(越近的年份权重越高),与考生等效位次比较分层:
python
WEIGHTS = {0: 0.5, 1: 0.3, 2: 0.2} # 0 表示最近一年 def weighted_min_rank(min_rank_hist: dict[int, int], latest_year: int) -> float: total_w, acc = 0.0, 0.0 for offset, w in WEIGHTS.items(): year = latest_year – offset if year in min_rank_hist: acc += min_rank_hist[year] * w total_w += w return acc / total_w if total_w else float("inf") def classify(equiv_rank: float, base_rank: float, plan_count: int) -> str: """base_rank 为近三年加权最低位次;位次数值越小代表排名越靠前""" ratio = base_rank / equiv_rank if plan_count < 10: # 计划数少的专业组波动大,整体降一档处理 ratio *= 0.95 if ratio < 0.95: # 往年最低位次优于考生位次 → 冲刺 return "chong" if ratio <= 1.15: # 与考生位次匹配 → 稳妥 return "wen" return "bao" # 明显低于考生位次 → 保底
经验概率区间与名额分配参考:
表格
| 冲 | 往年最低位次优于考生约 5%—20% | 约 40%—79% | 30% |
| 稳 | 与考生位次相当或略低 | 约 80%—94% | 50% |
| 保 | 明显低于考生位次(15% 以上) | 约 95%—98% | 20% |
志愿总量按省份规则适配:院校专业组模式的省份志愿数通常为 30—45 个,专业+院校模式的省份可达 96—112 个。后者的保底志愿数量应适当增加,并把相邻志愿之间的位次差拉开,避免扎堆。
5.4 硬约束过滤
四条硬约束必须逐条命中,任一不满足直接剔除,且剔除理由要能展示给用户:
python
def hard_filter(cand: Candidate, profile: StudentProfile) -> tuple[bool, str]: # 1. 选科要求匹配 need = set(cand["subject_req"]) have = {profile["subject_group"], *profile["electives"]} if need and not need.issubset(have): return False, f"选科不符:要求 {sorted(need)}" # 2. 单科成绩要求(部分院校对数学/外语设最低分) for subject, floor in cand.get("single_req", {}).items(): if profile["single_subject"].get(subject, 0) < floor: return False, f"{subject} 单科未达 {floor} 分" # 3. 体检受限 if set(cand.get("physical_ban", [])) & set(profile["physical_limit"]): return False, "体检结论受限" # 4. 学费与外语语种 if cand.get("tuition", 0) > profile.get("tuition_limit", 10 ** 9): return False, "学费超出预算" return True, ""
5.5 志愿排序打分
分层之后还要在档内排序。打分函数把录取概率匹配度、院校层次、专业匹配度、城市偏好和风险惩罚加权合成:
python
def score(cand: dict, profile: StudentProfile) -> float: s = 0.0 s += 0.35 * cand["match_prob"] # 录取概率匹配度 s += 0.20 * cand["school_tier_score"] # 院校层次(双一流/省重点…) s += 0.25 * major_match(cand["majors"], profile["major_pref"]) s += 0.10 * city_match(cand["city"], profile["city_pref"]) s -= 0.10 * cand["volatility_penalty"] # 大小年波动惩罚 if cand["plan_count"] < 10: s -= 0.05 # 计划数少,稳定性差 return s
排序原则:越心仪的排在越前面,因为平行志愿按顺序检索、一轮投档,顺序直接决定投档先后。
六、接口设计
6.1 核心接口
表格
| POST | /api/v1/profile/parse | 解析自然语言或表单输入为结构化画像 |
| GET | /api/v1/rules/{province} | 获取省份当年规则 |
| POST | /api/v1/plan/stream | SSE 流式生成志愿草表,实时推送 Agent 进度 |
| POST | /api/v1/plan/{thread_id}/resume | 提交人工确认结果,恢复中断的图执行 |
| GET | /api/v1/plan/{thread_id} | 查询指定会话的草表与审核意见 |
| GET | /api/v1/plan/{thread_id}/export | 导出 Excel / PDF |
6.2 流式接口实现
python
from fastapi import FastAPI from fastapi.responses import StreamingResponse import json app = FastAPI() @app.post("/api/v1/plan/stream") async def plan_stream(req: PlanRequest): async def gen(): config = {"configurable": {"thread_id": req.session_id}} # stream_mode="updates" 逐节点推送,前端可实时展示协作过程 async for chunk in graph.astream(req.model_dump(), config=config, stream_mode="updates"): payload = json.dumps(chunk, ensure_ascii=False) yield f"data: {payload}\\n\\n" return StreamingResponse(gen(), media_type="text/event-stream")
前端按 stream_mode="updates" 的节点名映射成进度文案,例如「正在检索候选院校专业组…」「正在校验选科与体检约束…」,让多 Agent 的协作过程对用户可见。这一步对建立信任很重要——用户看不到过程,就不会相信结果。
七、项目计划与里程碑
总工期 12 周,按里程碑交付。
表格
| M1 立项与合规评审 | 第 1—2 周 | 需求确认、数据源梳理、合规红线评审、架构评审 | 需求规格说明书、数据源清单、合规评审记录 | 需求冻结,红线条款确认 |
| M2 数据底座 | 第 3—5 周 | 采集、清洗、入库、校验规则、检索层开发 | 招生数据库、数据字典、检索 API | 数据覆盖率 ≥ 60 万条,校验通过率 ≥ 99% |
| M3 Agent 与编排 | 第 6—8 周 | 9 个 Agent 实现、LangGraph 图搭建、状态设计 | Agent 代码库、图定义、单元测试 | 单链路端到端跑通,节点级 trace 可查 |
| M4 交互与 HITL | 第 9—10 周 | 前端页面、SSE 流式、人工确认与多轮追问 | 前端应用、API 文档 | 流式首字节 ≤ 1.5s,HITL 恢复成功率 100% |
| M5 评测与调优 | 第 11 周 | 用 2023—2025 年真实数据回测、幻觉率统计、成本优化 | 评测报告 | 稳保档命中率 ≥ 92%,滑档率 0 |
| M6 灰度与上线 | 第 12 周 | 灰度发布、监控告警、运营手册 | 部署文档、运维手册、用户手册 | 灰度 7 天无 P0 故障 |
关键依赖与卡点:
- M2 的数据治理质量直接决定 M5 的评测结果,若数据源受限需提前启动授权谈判。
- M3 的 Supervisor 路由准确率需在 M5 前达到 94% 以上,否则回退到规则优先路由。
- M4 的 HITL 依赖 Checkpointer 稳定运行,M3 阶段必须先完成持久化验证。
八、交付物清单
表格
| D1 | 需求规格说明书 | 文档 | 含全部 FR/NFR 编号与验收口径 |
| D2 | 系统设计说明书 | 文档 | 架构图、Agent 职责、状态定义、时序说明 |
| D3 | 源码工程 | 代码仓库 | 含 Agent 层、编排层、服务层、前端 |
| D4 | 数据字典与治理规则 | 文档 + SQL | 表结构、字段来源、校验规则 |
| D5 | 部署方案 | Docker Compose / K8s 清单 | 一键拉起全套服务 |
| D6 | API 文档 | OpenAPI | 含 SSE 与 HITL 恢复接口 |
| D7 | 评测报告 | 文档 | 回测指标、幻觉率、成本、延迟 |
| D8 | 运维手册 | 文档 | 监控指标、告警阈值、降级预案 |
| D9 | 用户使用手册 | 文档 | 含免责声明与填报边界说明 |
九、验收标准
验收分功能、性能、质量、合规四部分,全部通过方可结项。
功能验收
性能验收
表格
| 草表生成 P95 | ≤ 8 秒 |
| SSE 首字节 | ≤ 1.5 秒 |
| 单条追问 P95 | ≤ 4 秒 |
| 峰值并发 | 500 QPS 下错误率 < 0.5% |
质量验收
合规验收
十、风险与对策
表格
| R1 | 数据源版权与授权风险 | 数据不可用,项目停滞 | 高 | 优先官方开放数据;与授权方签订协议;保留降级为公开数据版本的能力 |
| R2 | 模型幻觉导致错误推荐 | 用户被误导,后果不可逆 | 高 | CriticAgent 独立复核 + 规则引擎硬校验 + 全字段溯源,任何无法溯源的数据不进入草表 |
| R3 | 各省政策差异导致规则错配 | 输出无效方案 | 高 | 规则库按省独立版本化,上线前用该省历史数据回归测试 |
| R4 | 填报高峰期并发冲击 | 服务不可用 | 中 | 无状态服务横向扩展 + Redis 缓存 + 限流降级 |
| R5 | 反馈环死循环 | 响应超时、成本失控 | 中 | 循环次数上限 2 轮,超限输出当前最优解并提示人工复核 |
| R6 | LLM 调用成本超预算 | 商业不可持续 | 中 | 任务分级路由,轻量任务走小模型;对高频查询结果做语义缓存 |
| R7 | Checkpoint 膨胀 | 读写变慢、存储成本上升 | 中 | 状态只存引用与元数据,大对象外置存储 |
| R8 | 合规口径变化 | 需紧急整改 | 低 | 合规文案与免责声明做成可配置项,支持热更新 |
十一、团队分工
表格
| 项目经理 | 1 | 进度管理、跨方协调、合规评审组织 |
| 算法工程师 | 2 | 位次换算、分层模型、排序打分、Agent 提示词与工具设计 |
| 后端工程师 | 2 | LangGraph 编排、服务层、持久化、SSE 与 HITL |
| 数据工程师 | 1 | 采集、清洗、入库、数据质量监控 |
| 前端工程师 | 1 | 表单、志愿表、协作过程可视化 |
| 测试工程师 | 1 | 功能测试、回测框架、性能压测 |
协作机制:每周一次迭代评审,M2 与 M5 两个节点设置强制评审门槛。
附录 A:术语表
表格
| 一分一段表 | 各省考试院公布的分数与累计人数对照表,位次定位的权威依据 |
| 等效位次 | 把当年位次按批次线位次比值换算到往年口径后的位次 |
| 院校专业组 | 新高考下以「院校 + 专业组」为投档单位,组内选科要求一致,可组内调剂 |
| 专业+院校 | 以单个专业为投档单位,不存在专业调剂 |
| 平行志愿 | 执行「分数优先、遵循志愿、一轮投档」的投档方式 |
| 冲稳保 | 按录取概率划分的三档志愿梯度策略 |
| Supervisor | 多 Agent 拓扑中的中央调度者,负责路由与汇总 |
| Checkpointer | LangGraph 的线程级状态快照机制,支撑断点恢复与 HITL |
| Store | LangGraph 的跨线程长期记忆机制 |
| HITL | Human-in-the-Loop,人工介入确认 |
附录 B:参考资料
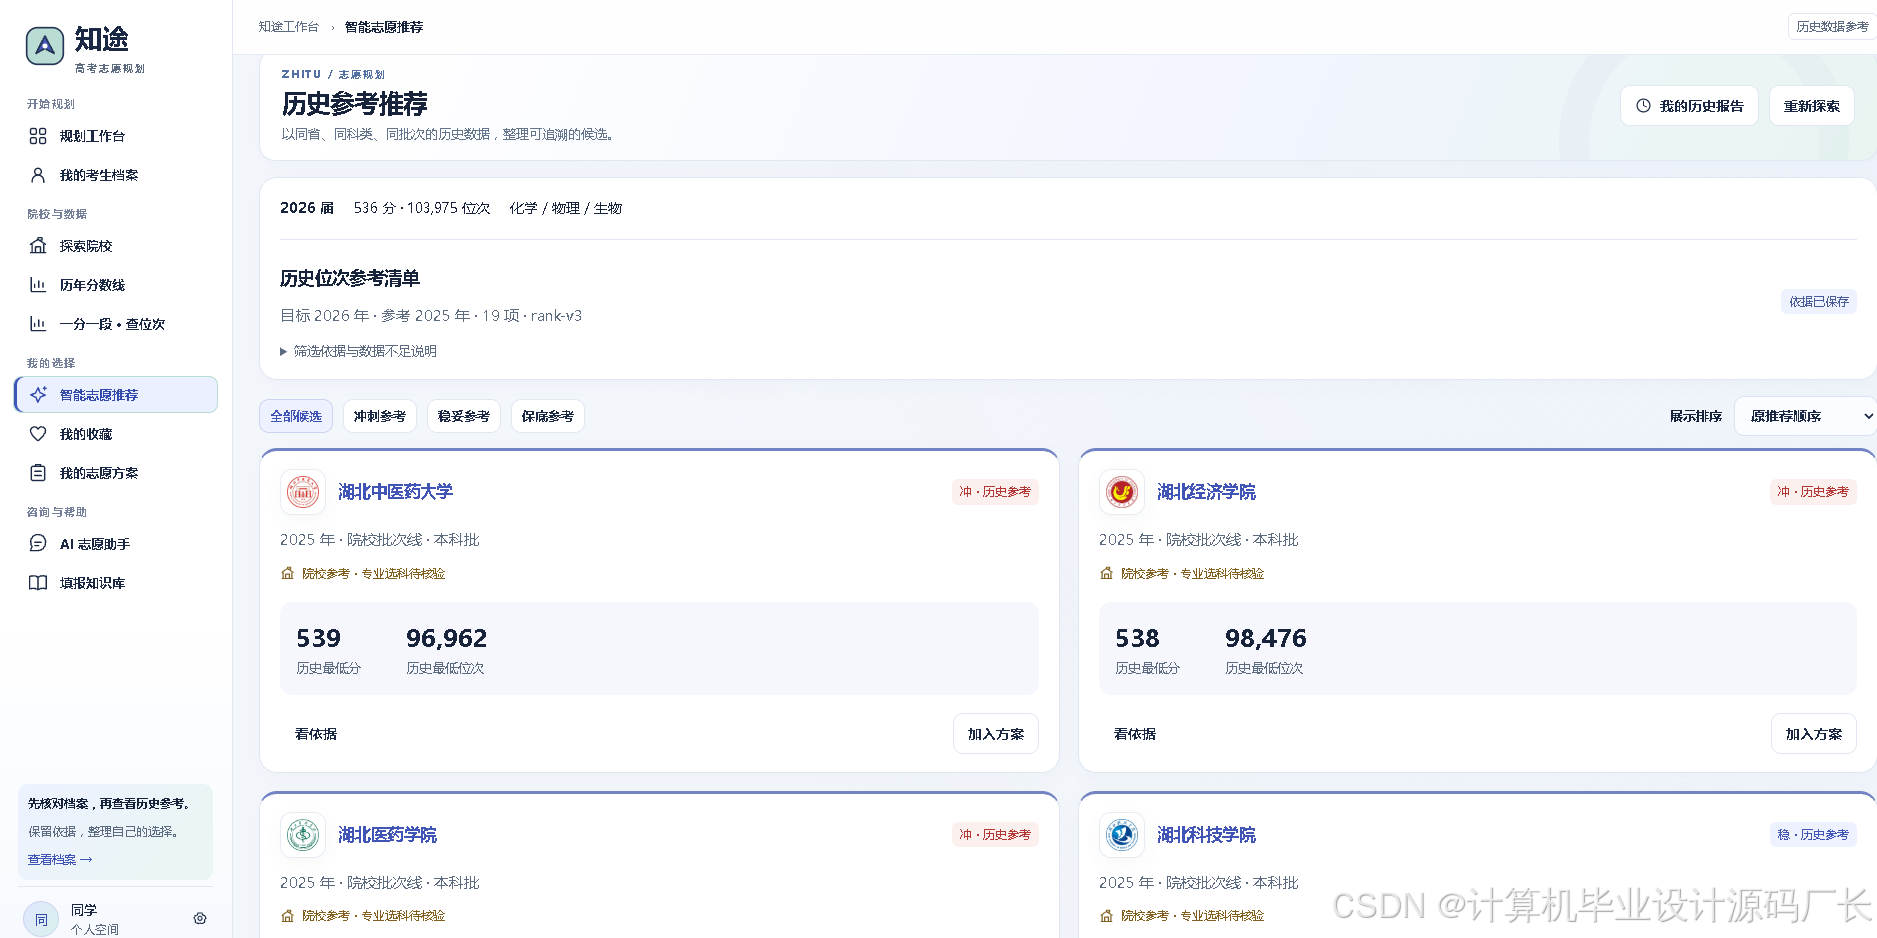
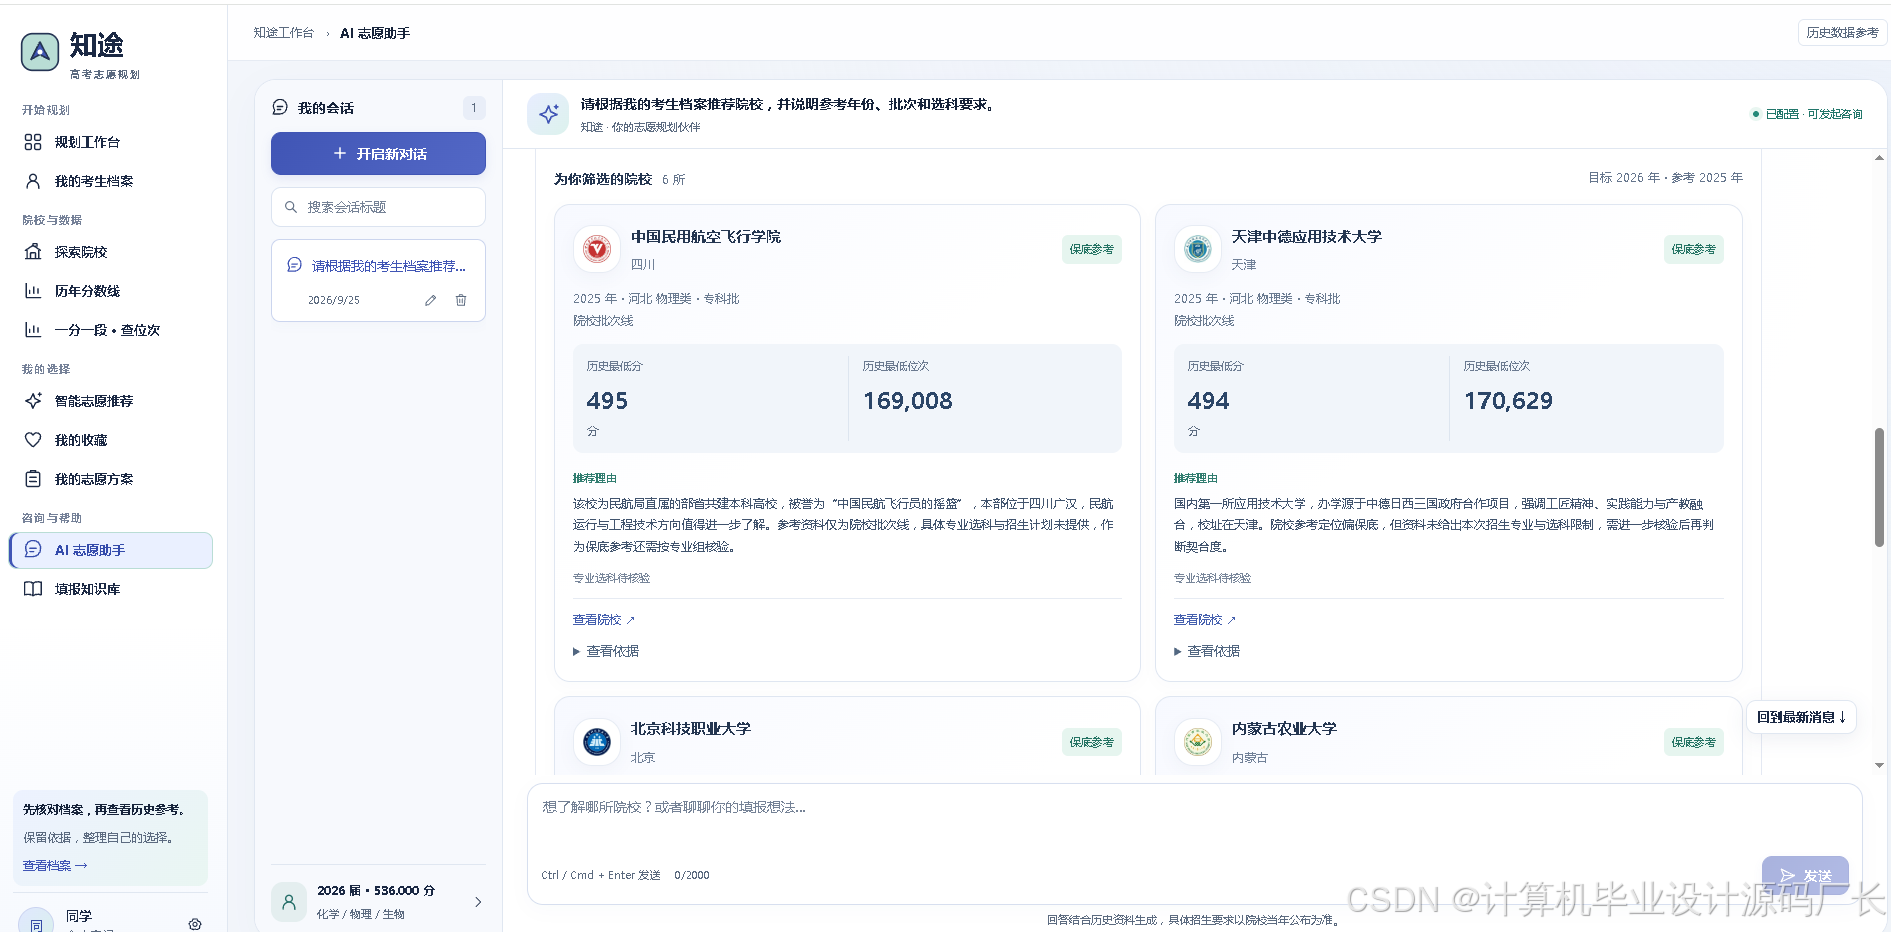
运行截图
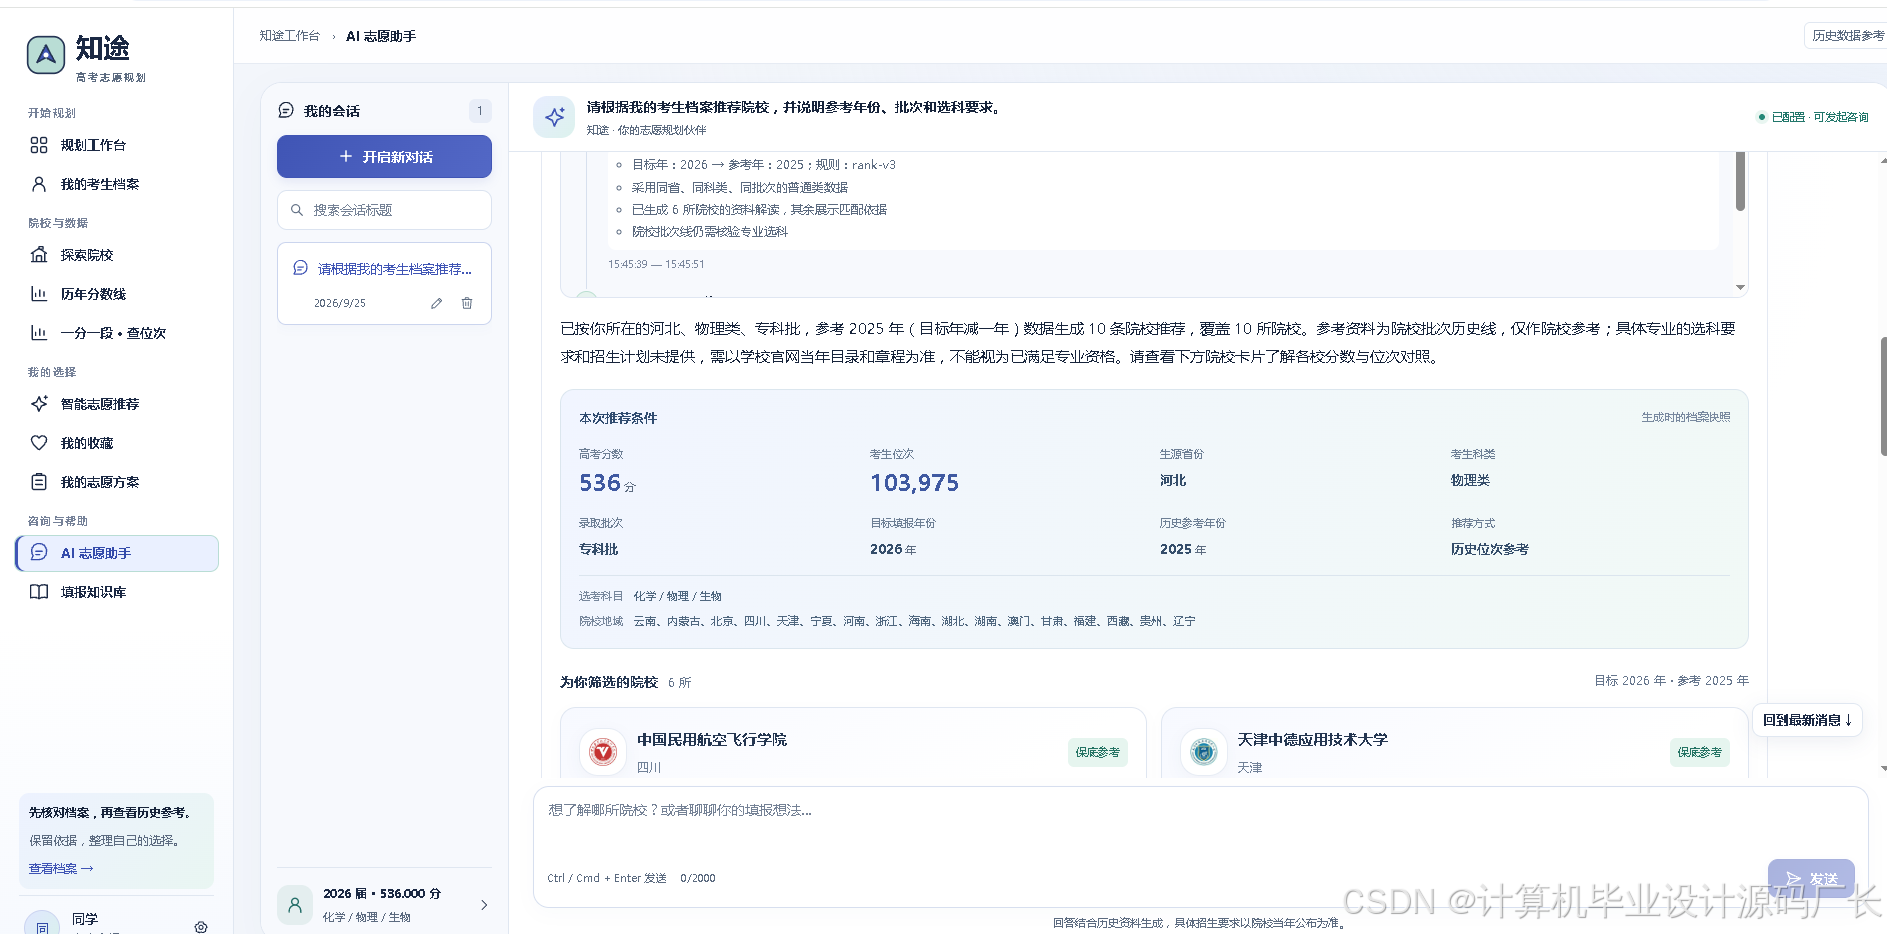
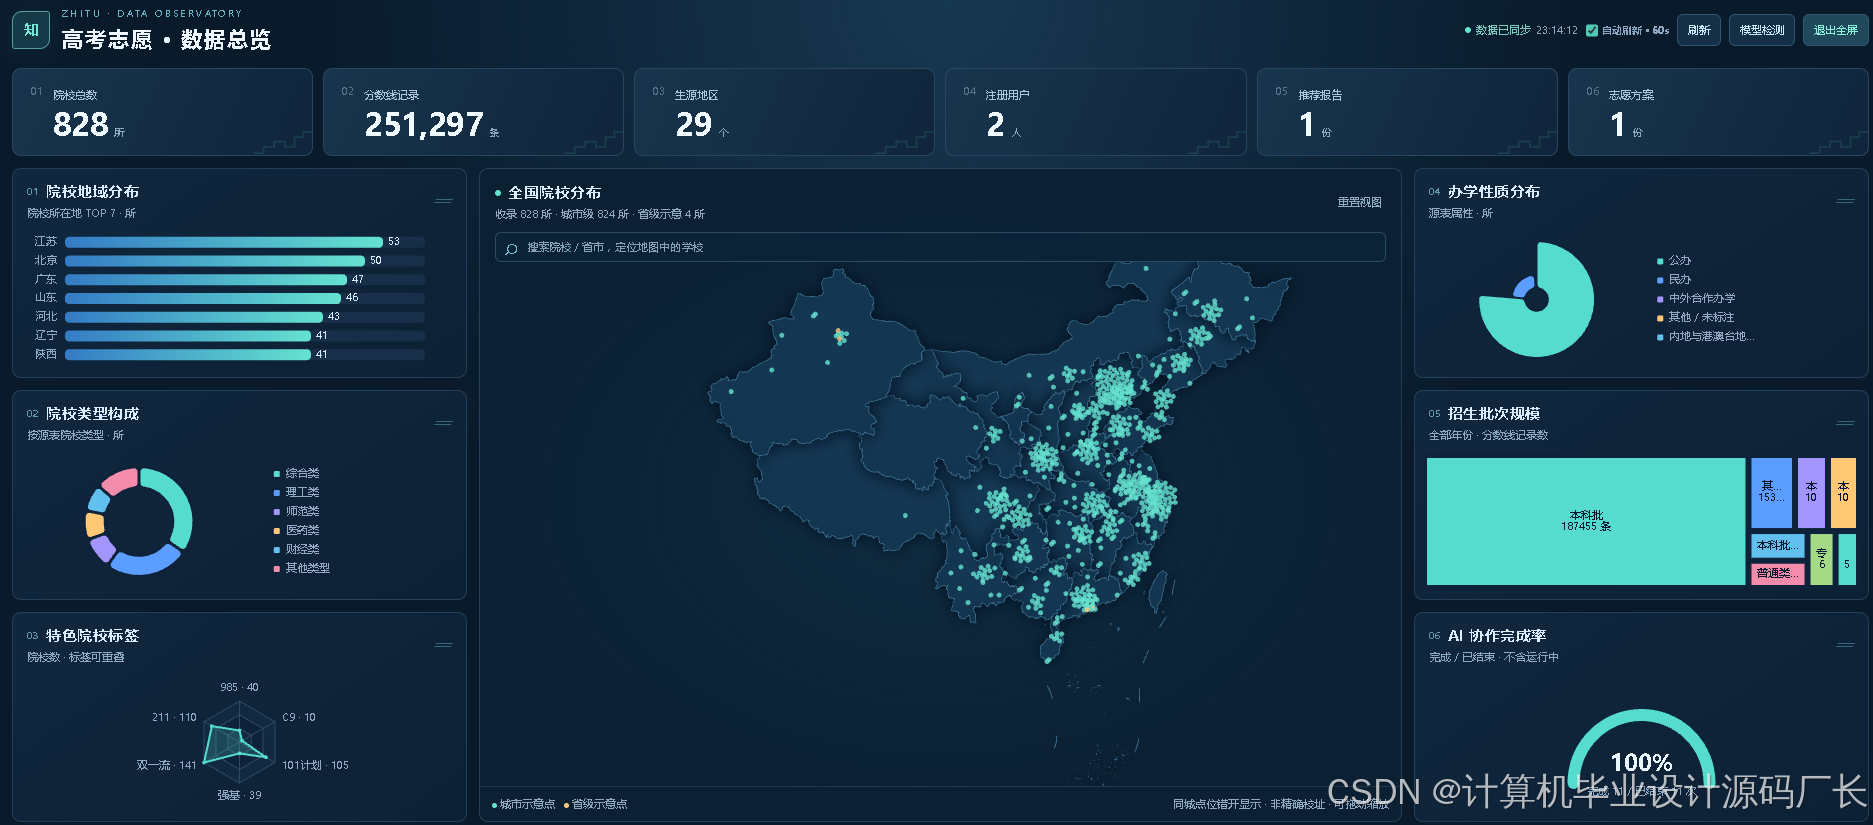
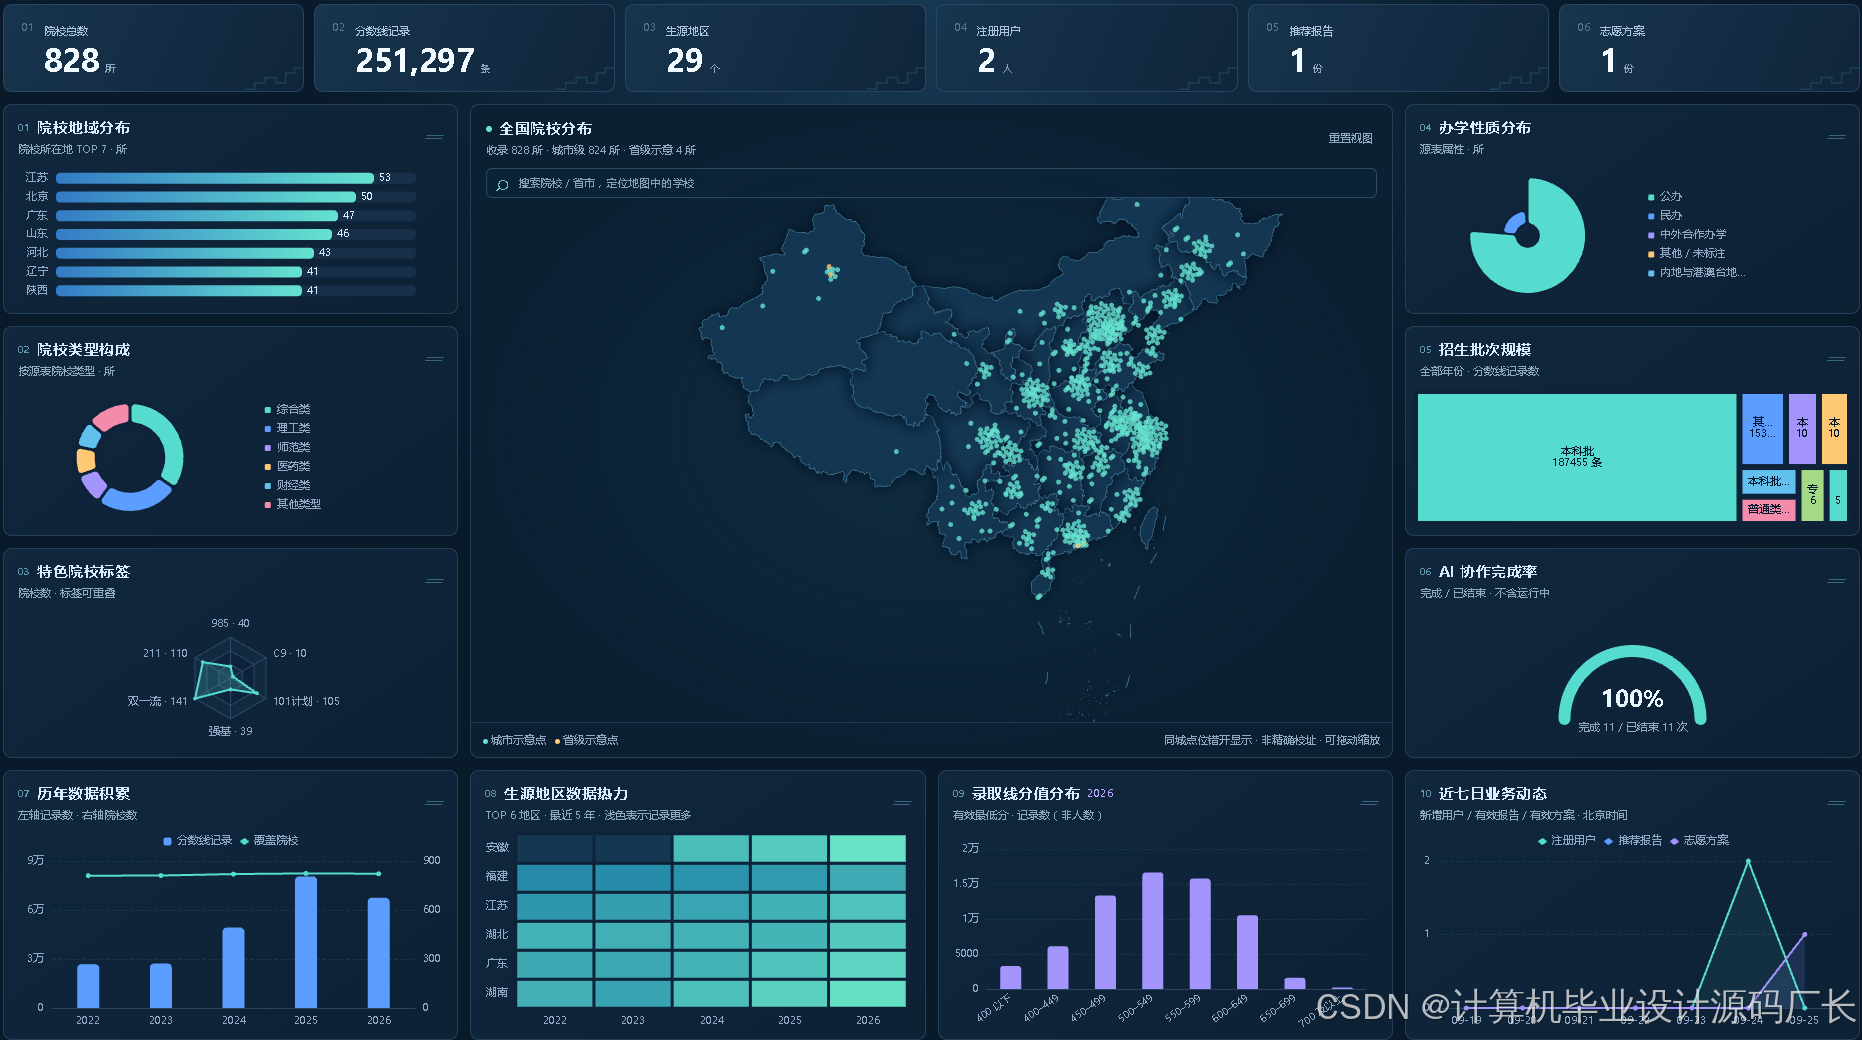
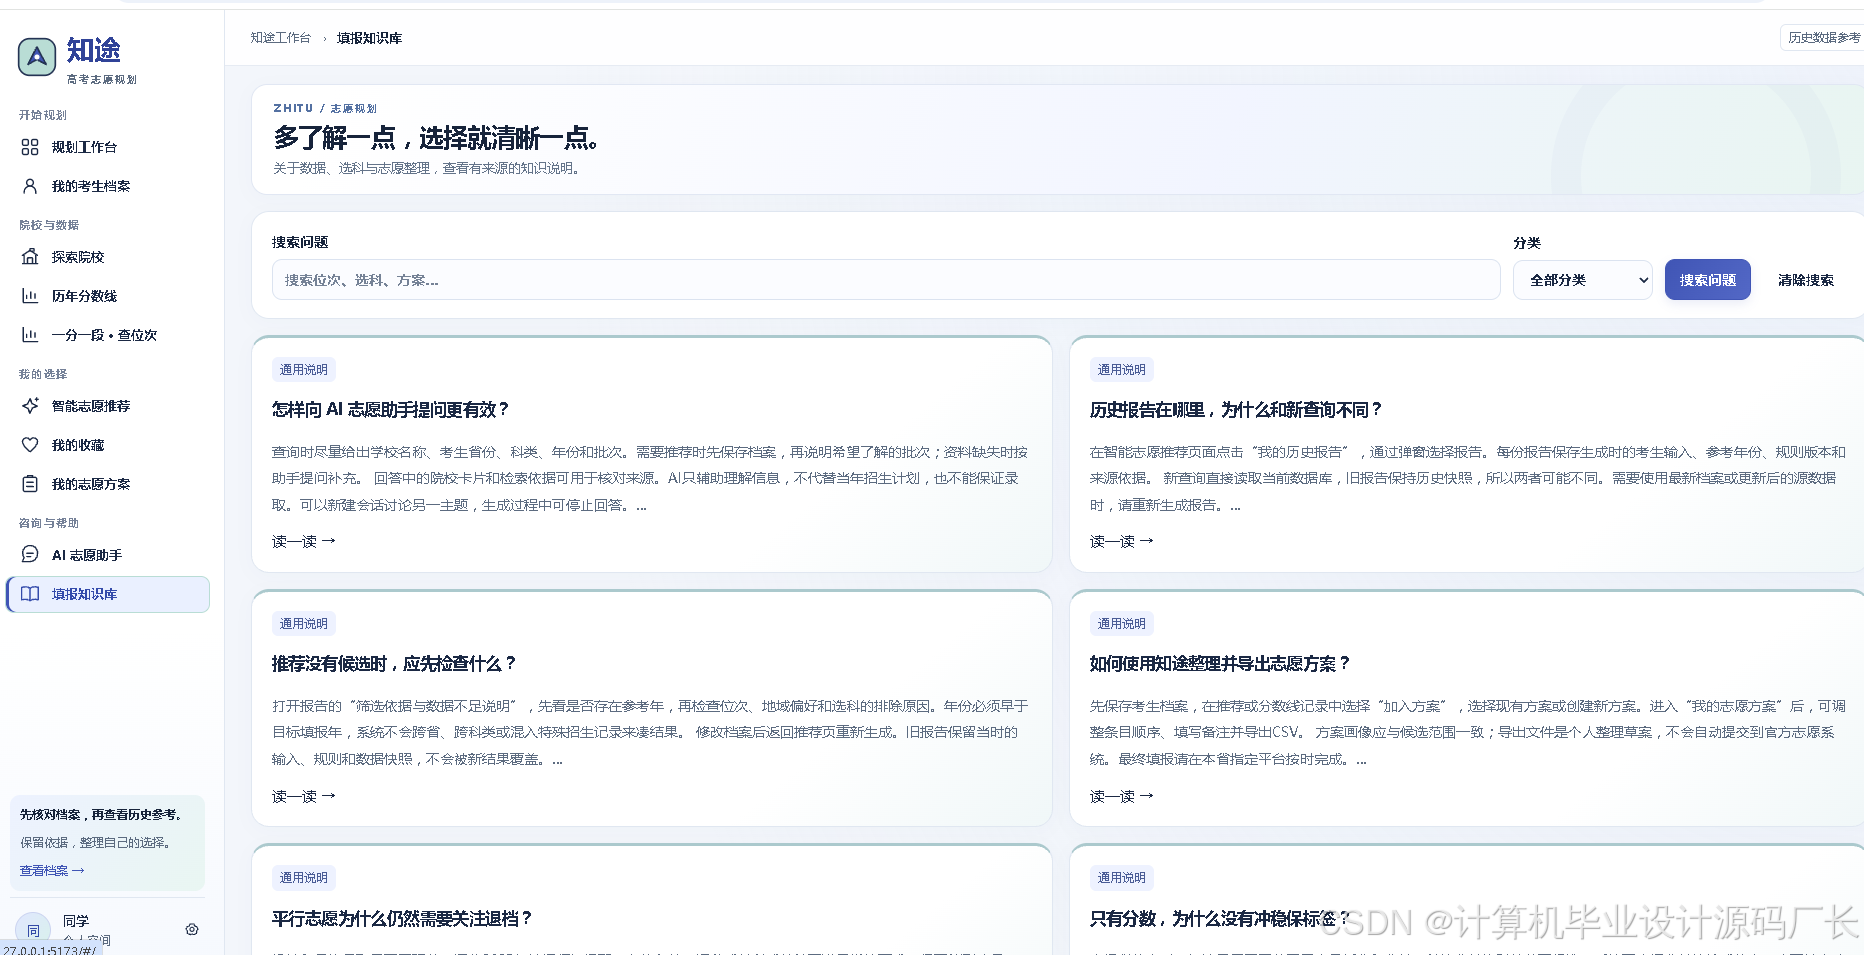
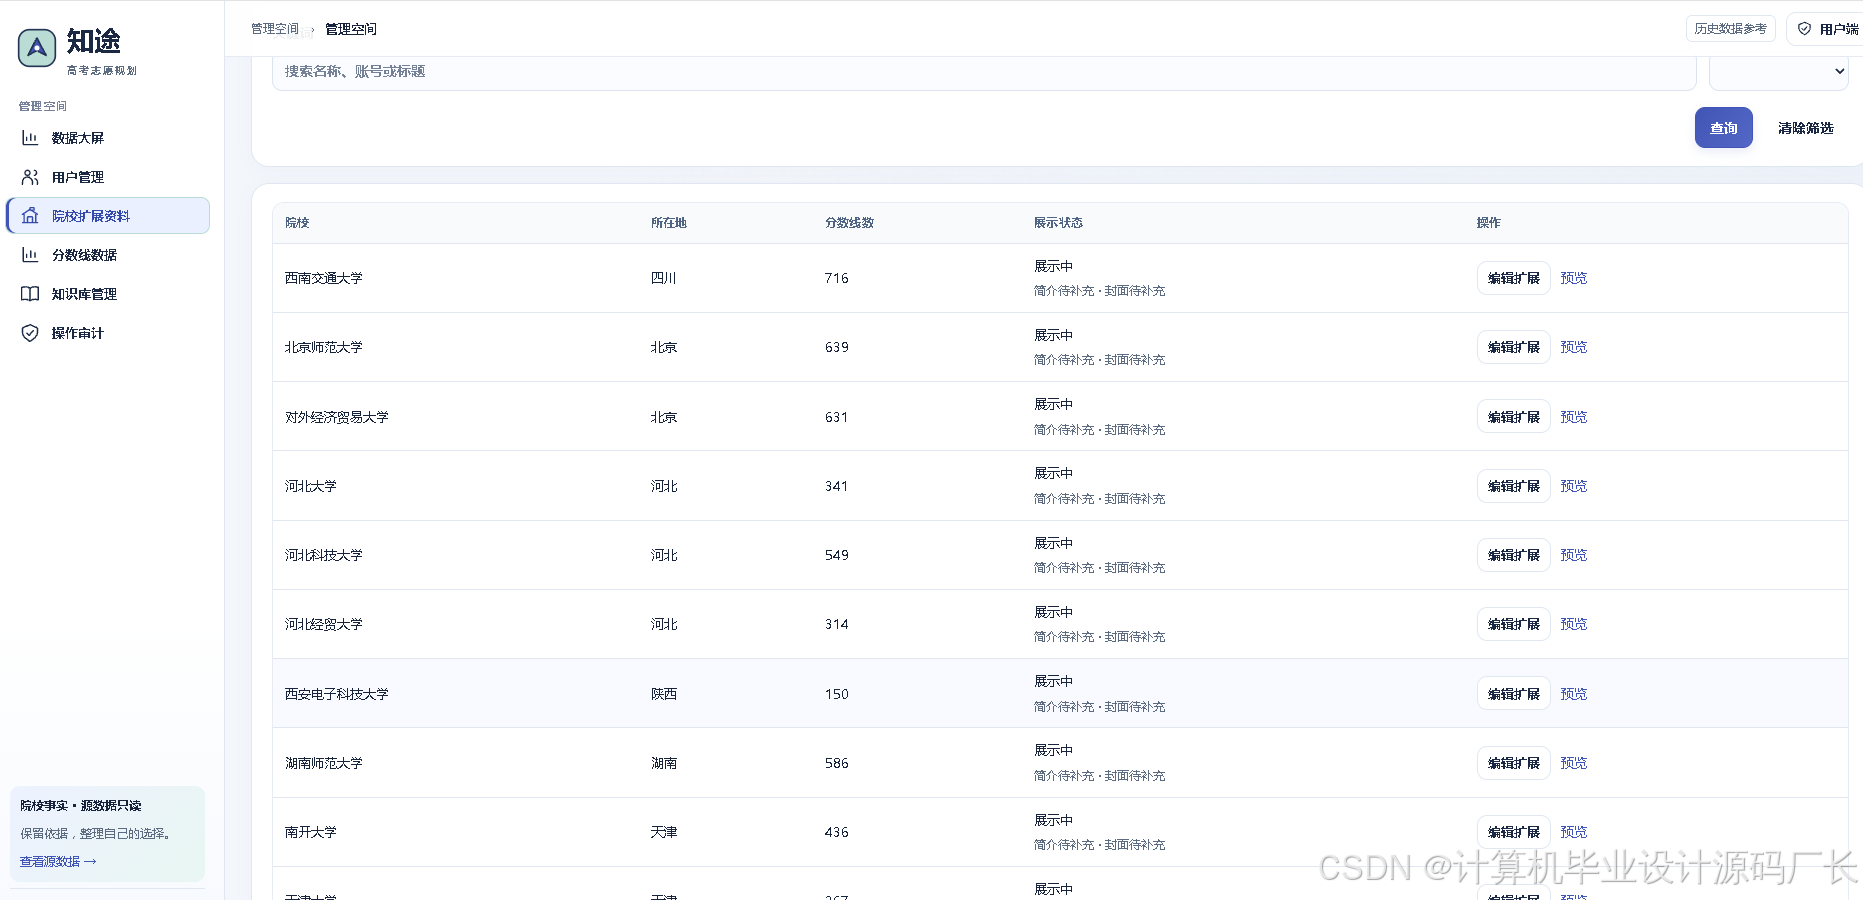
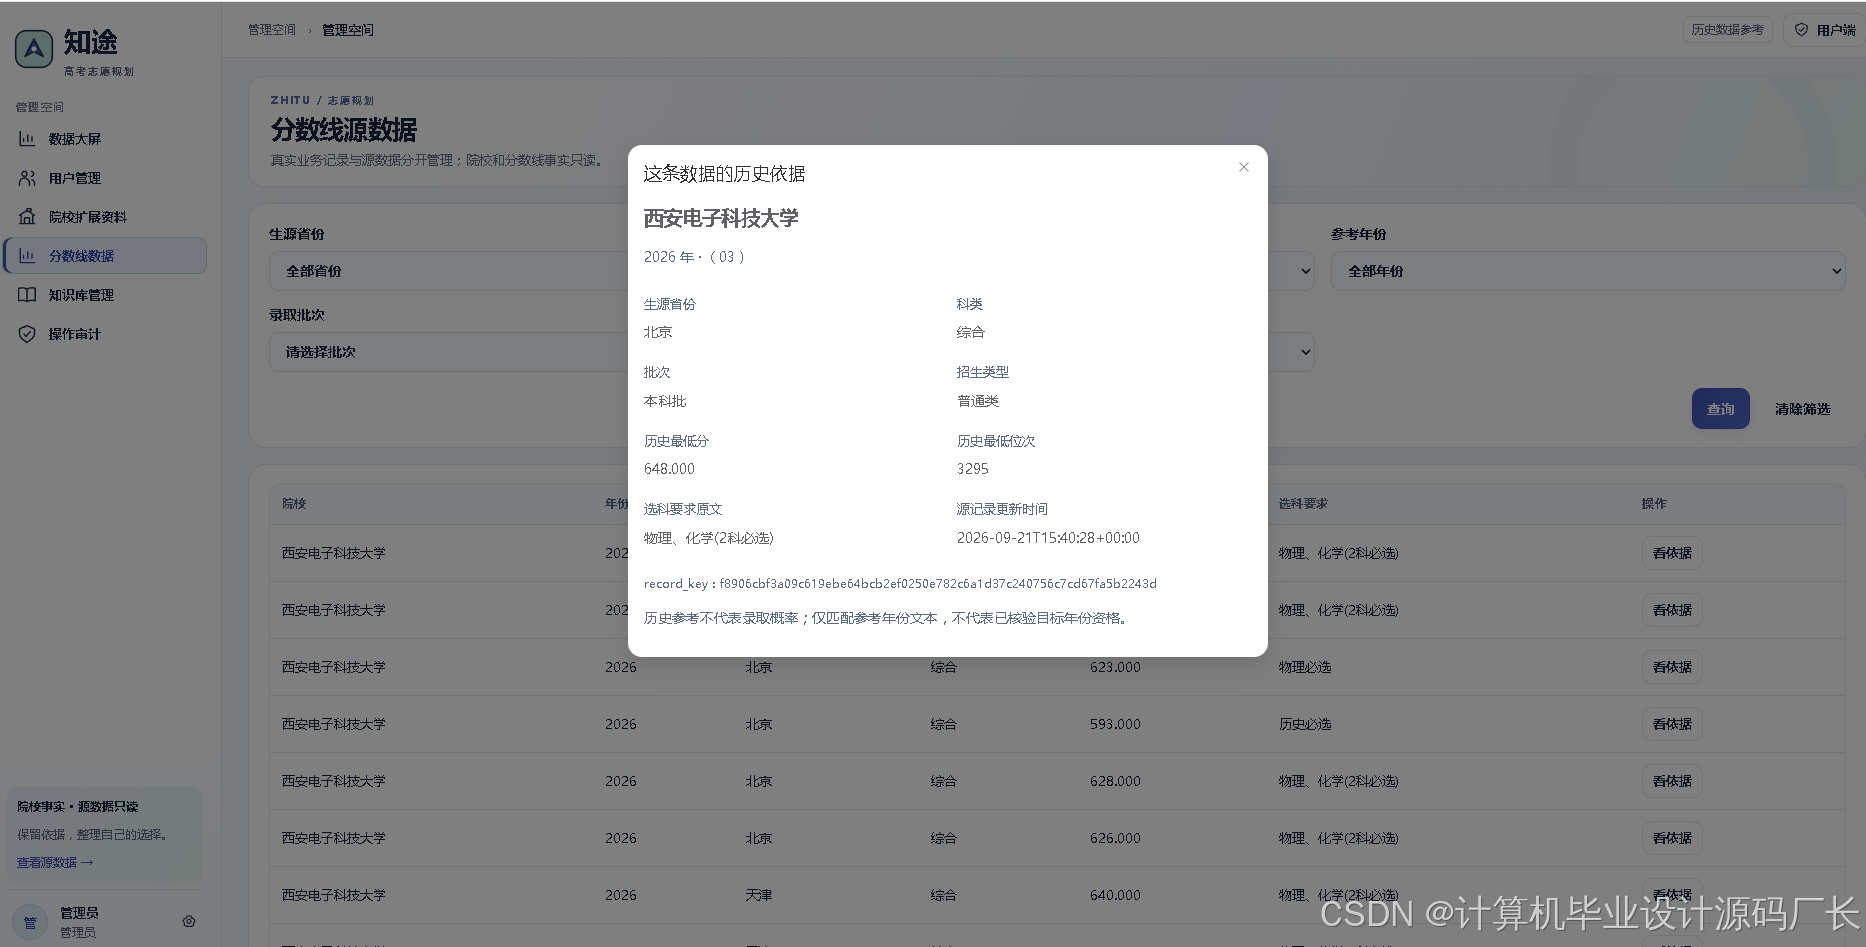
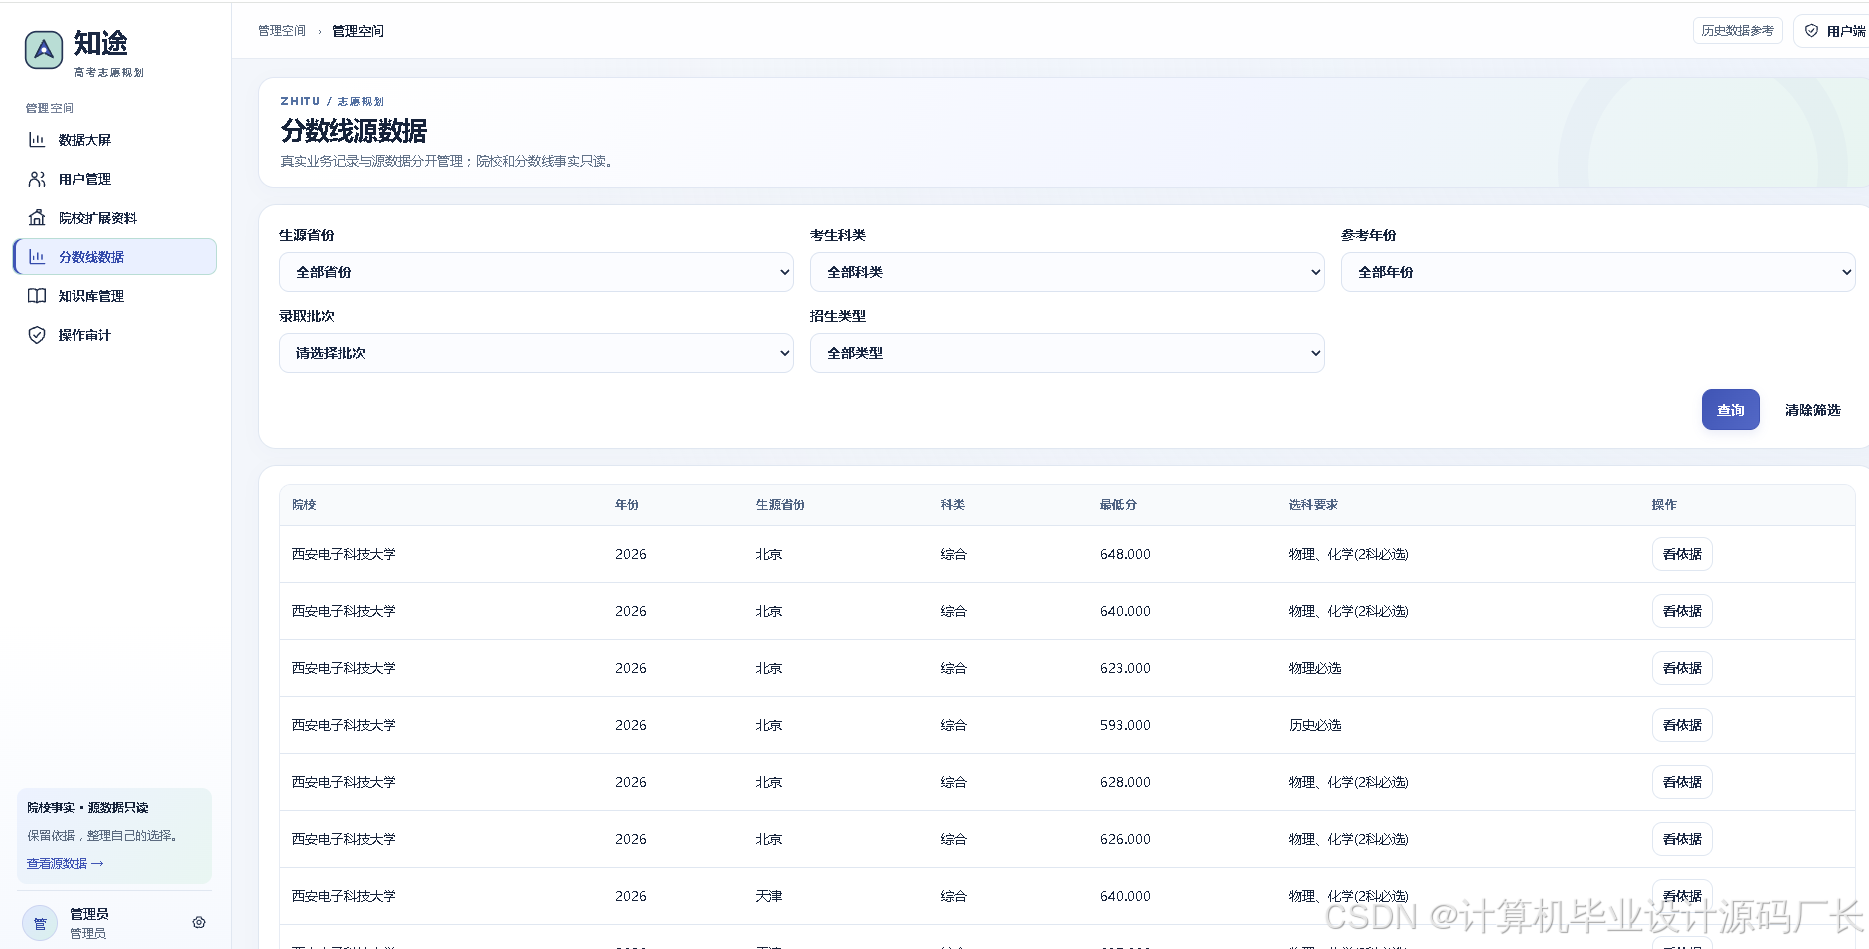
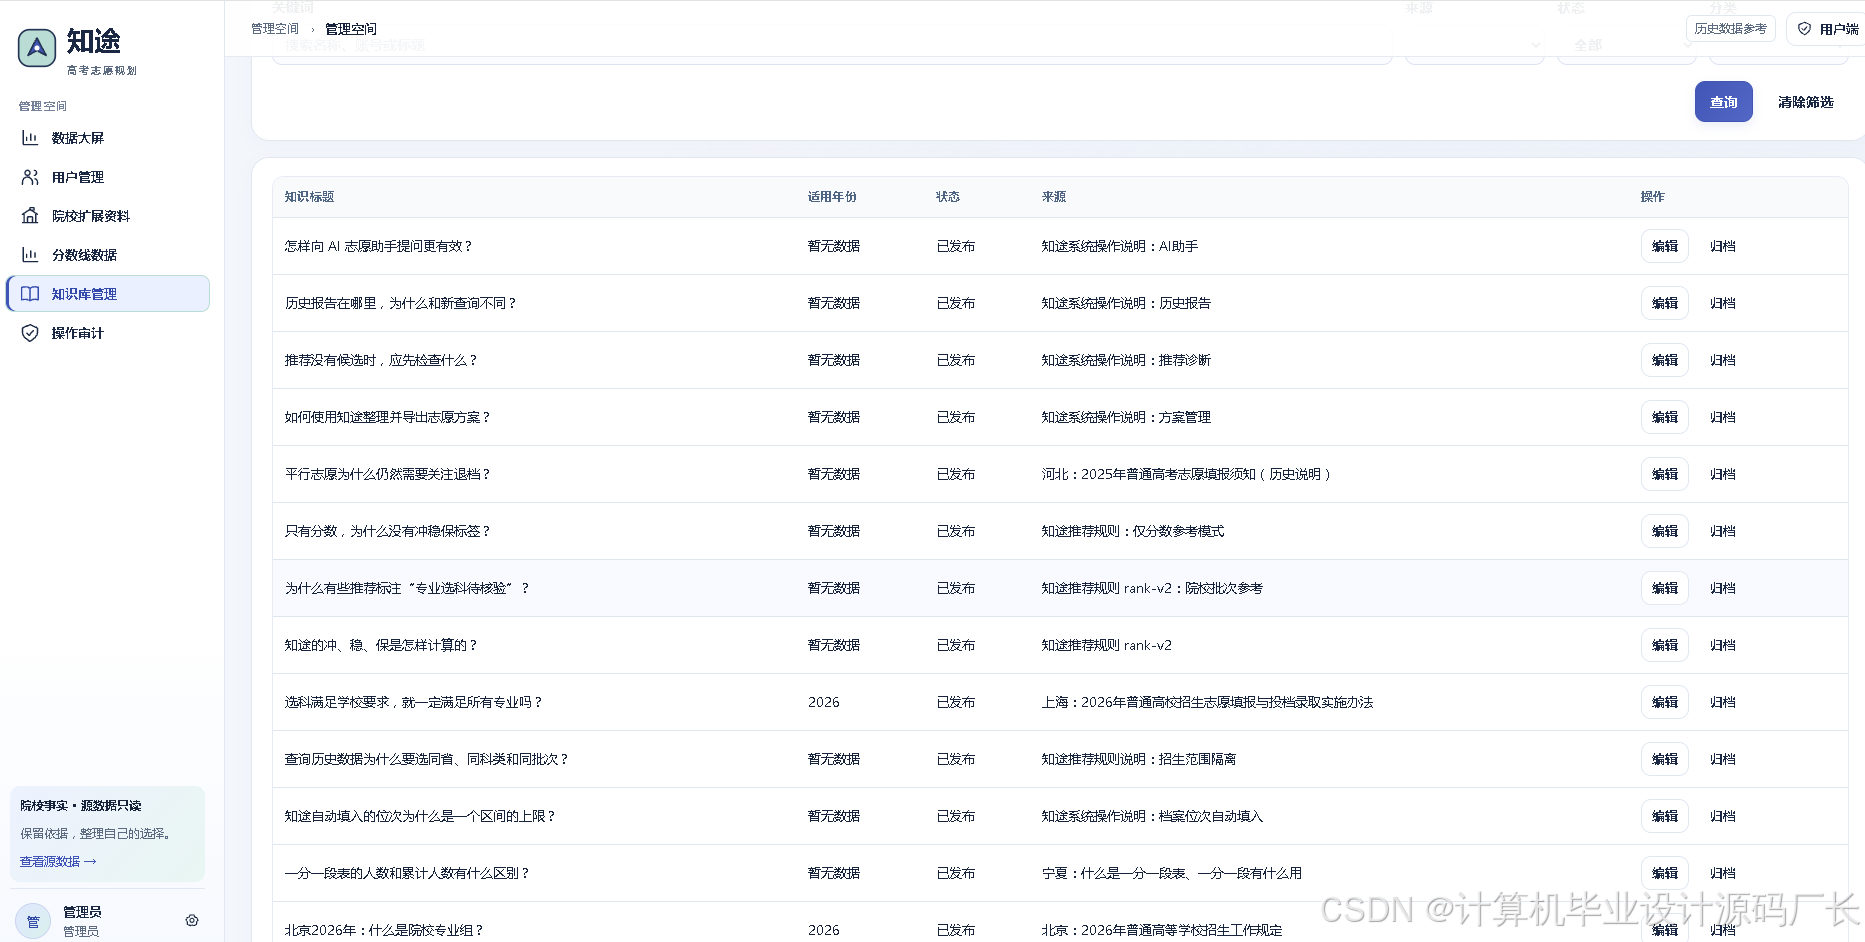
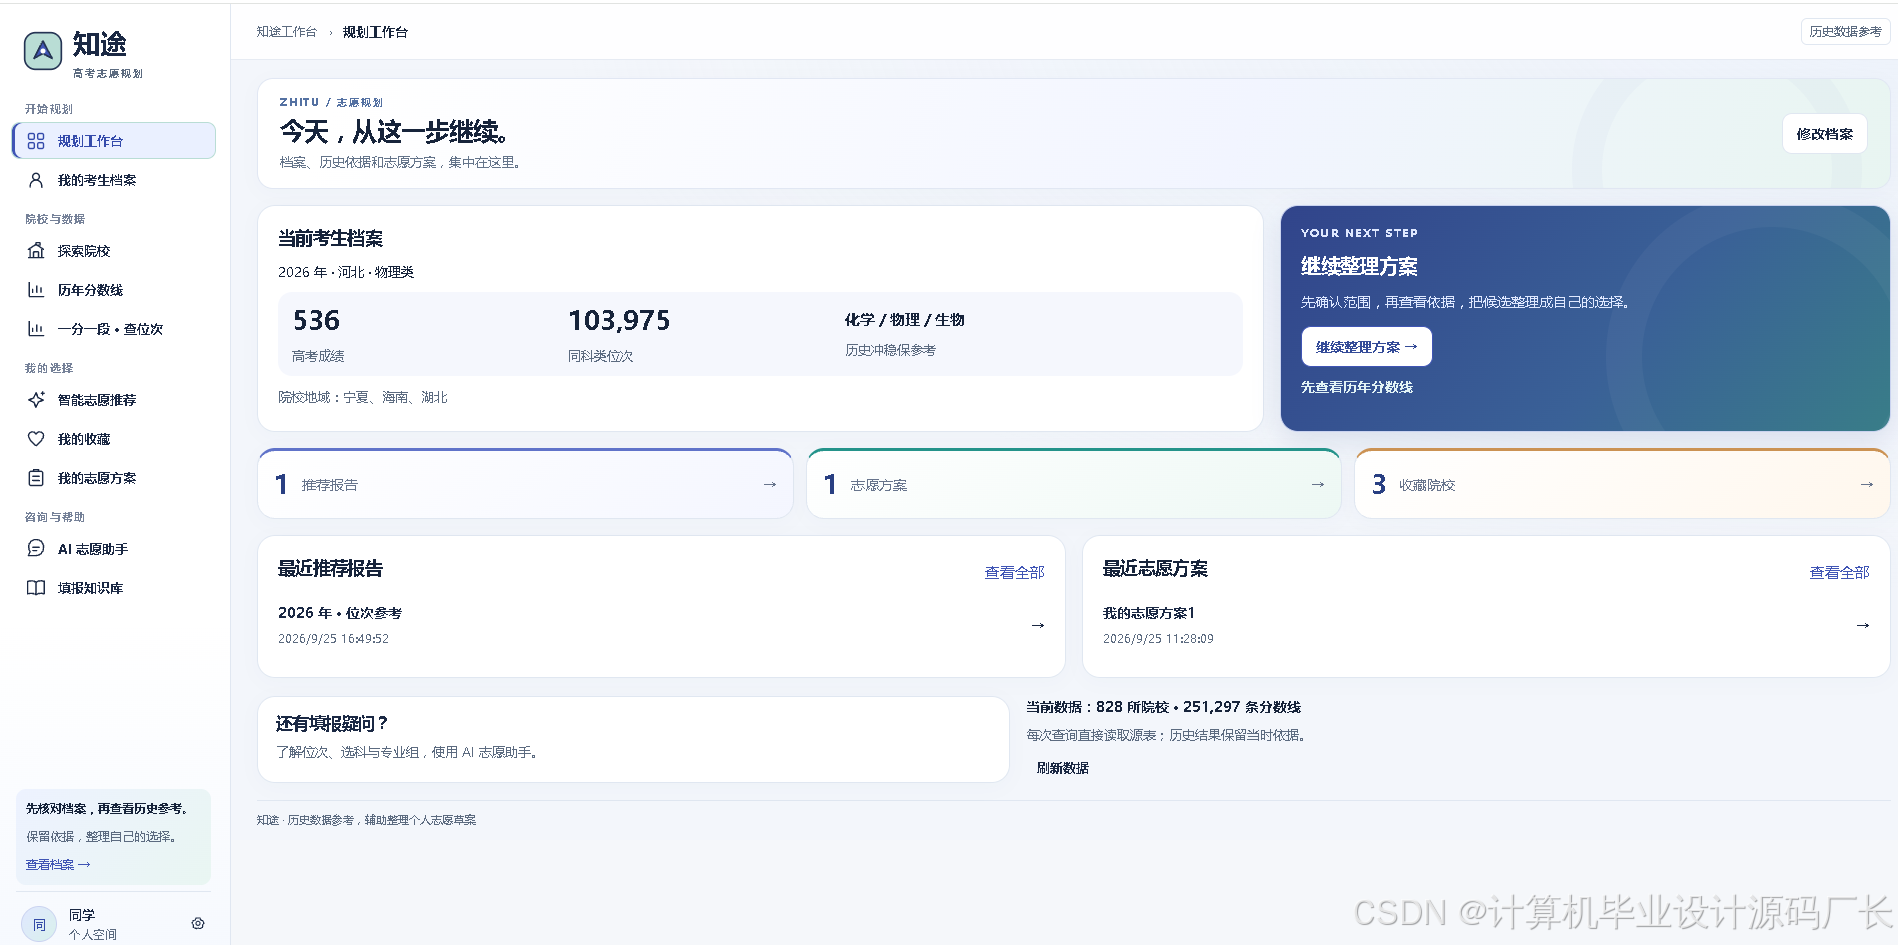
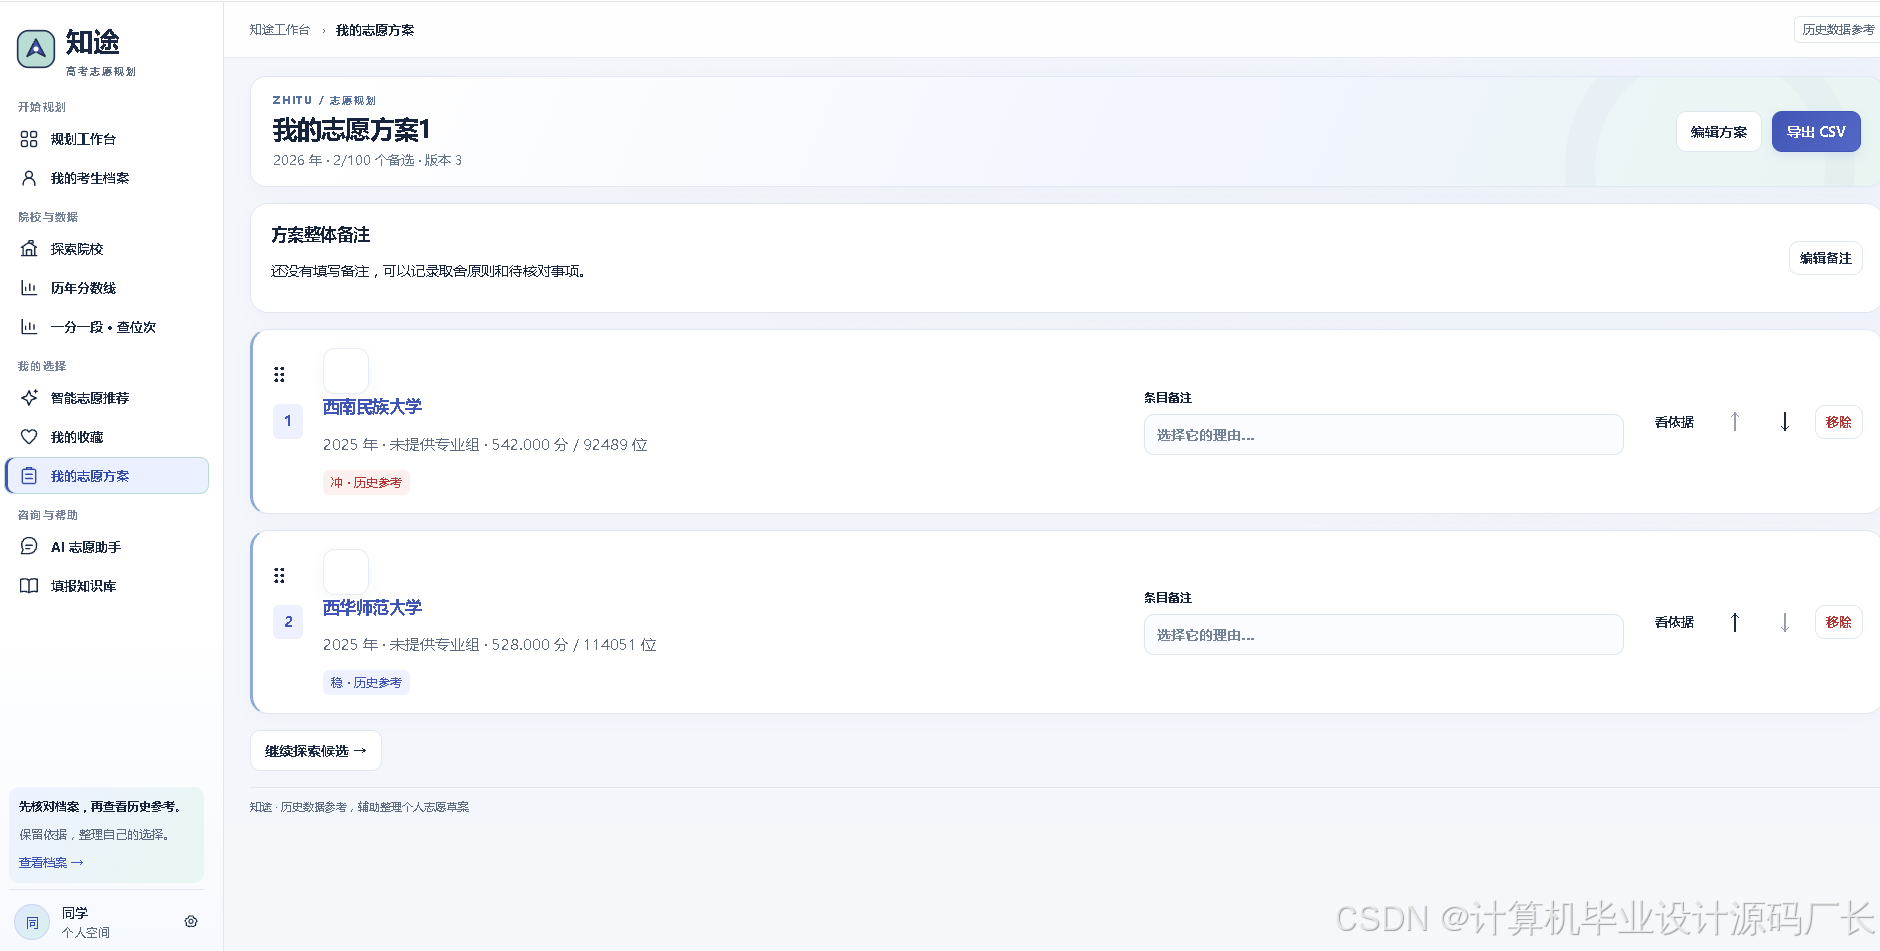
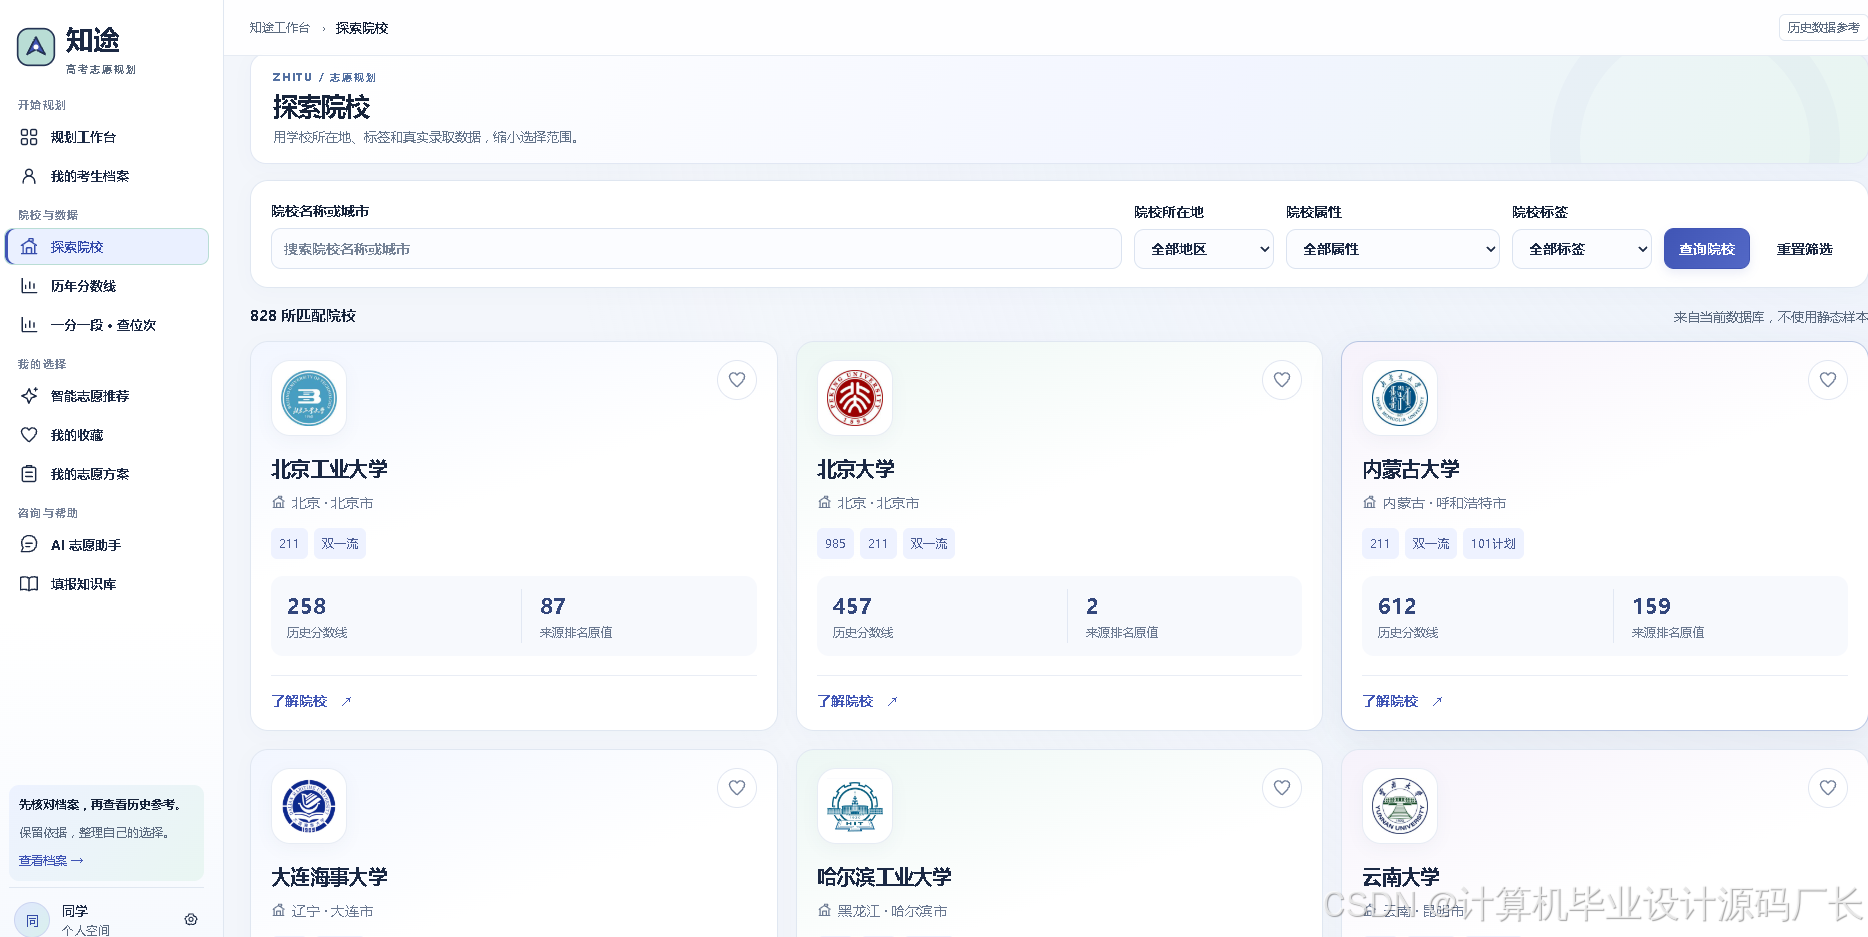
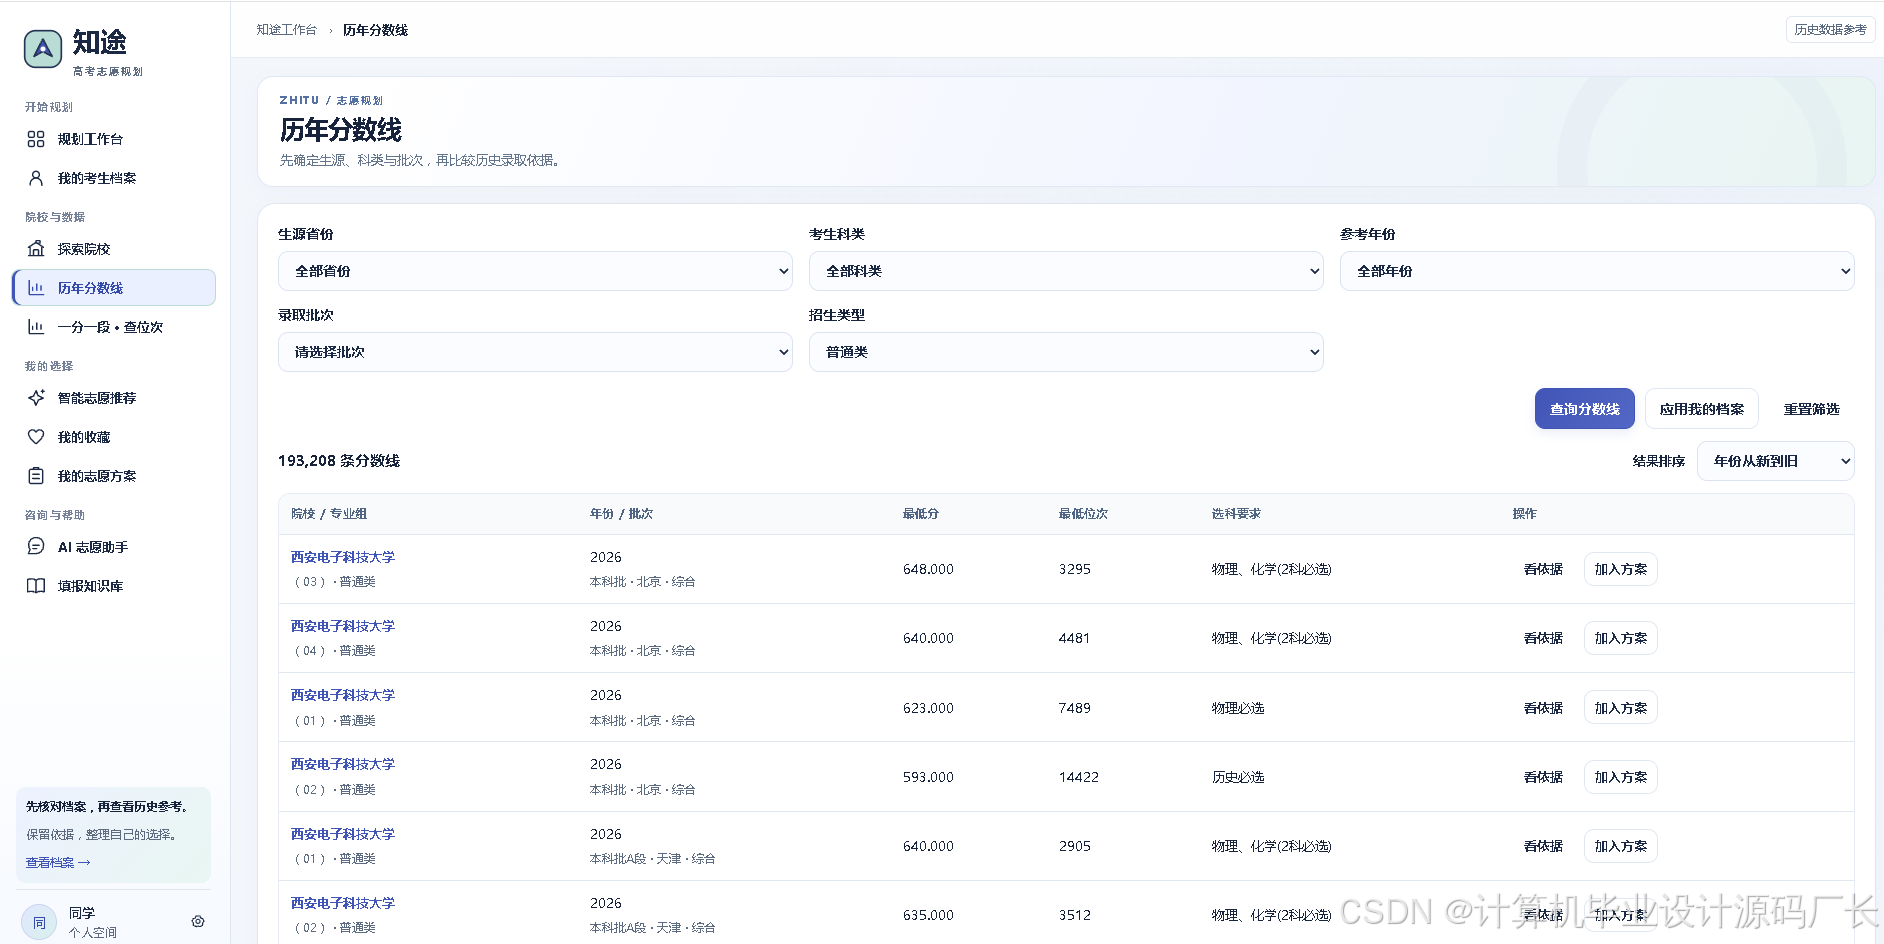
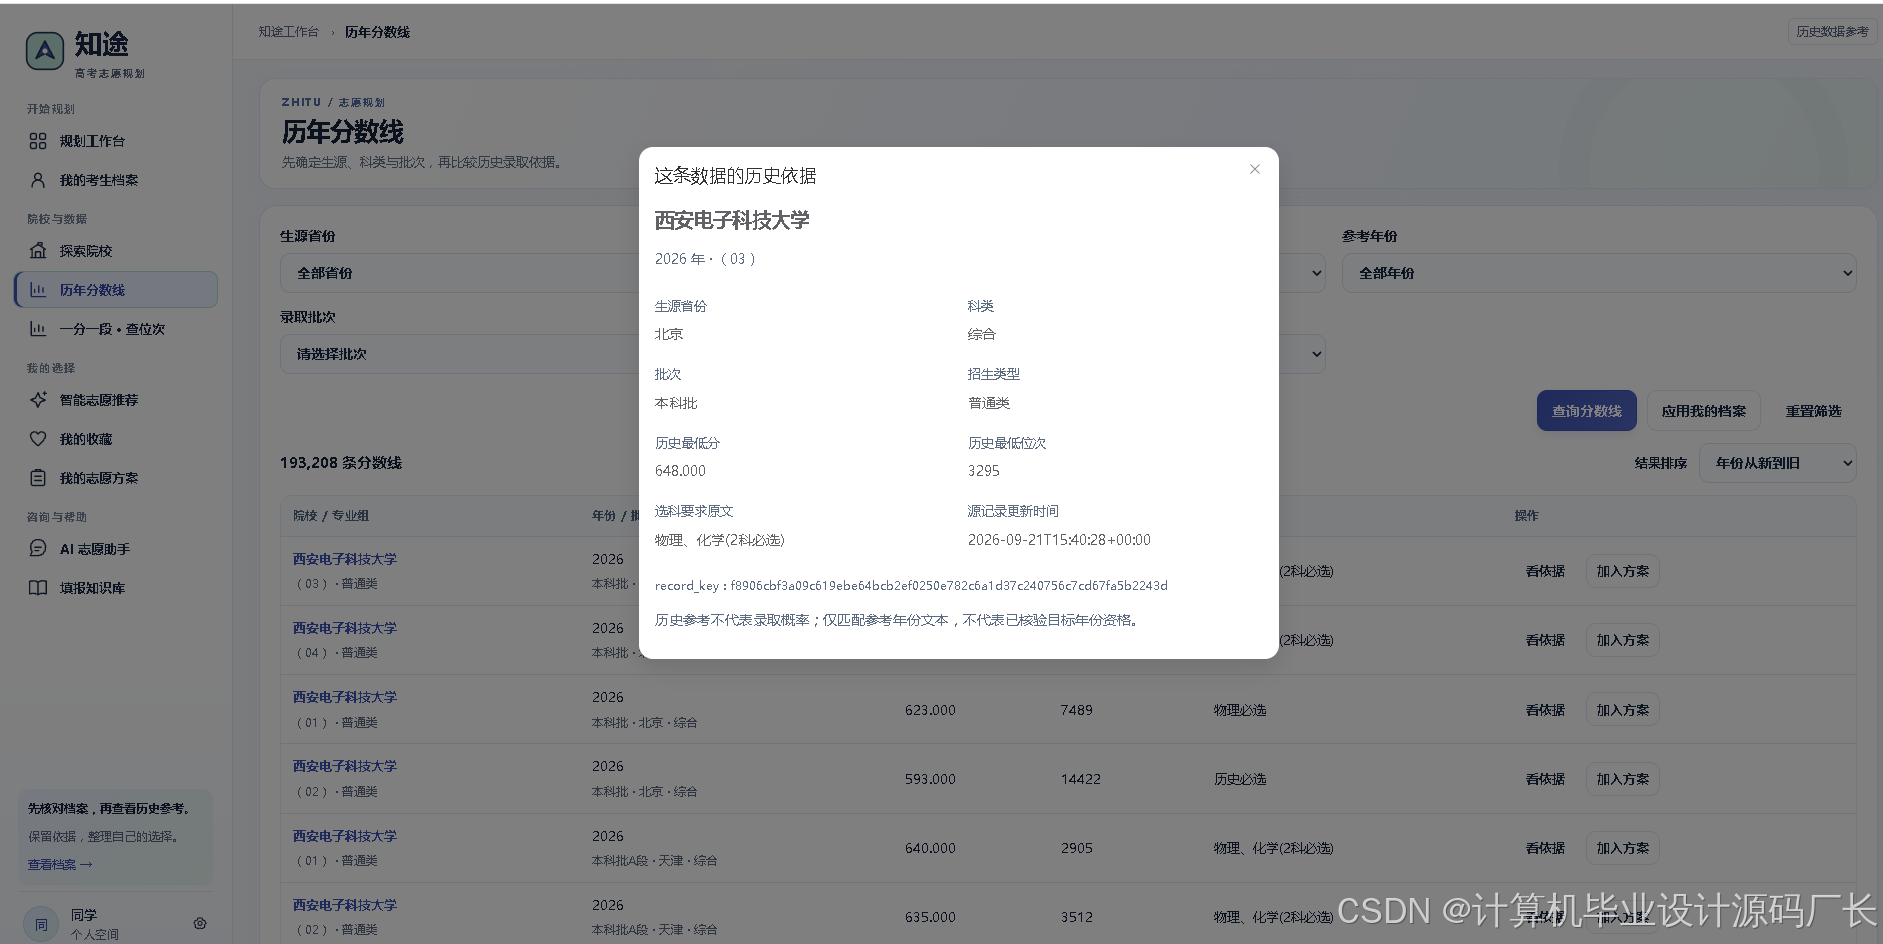
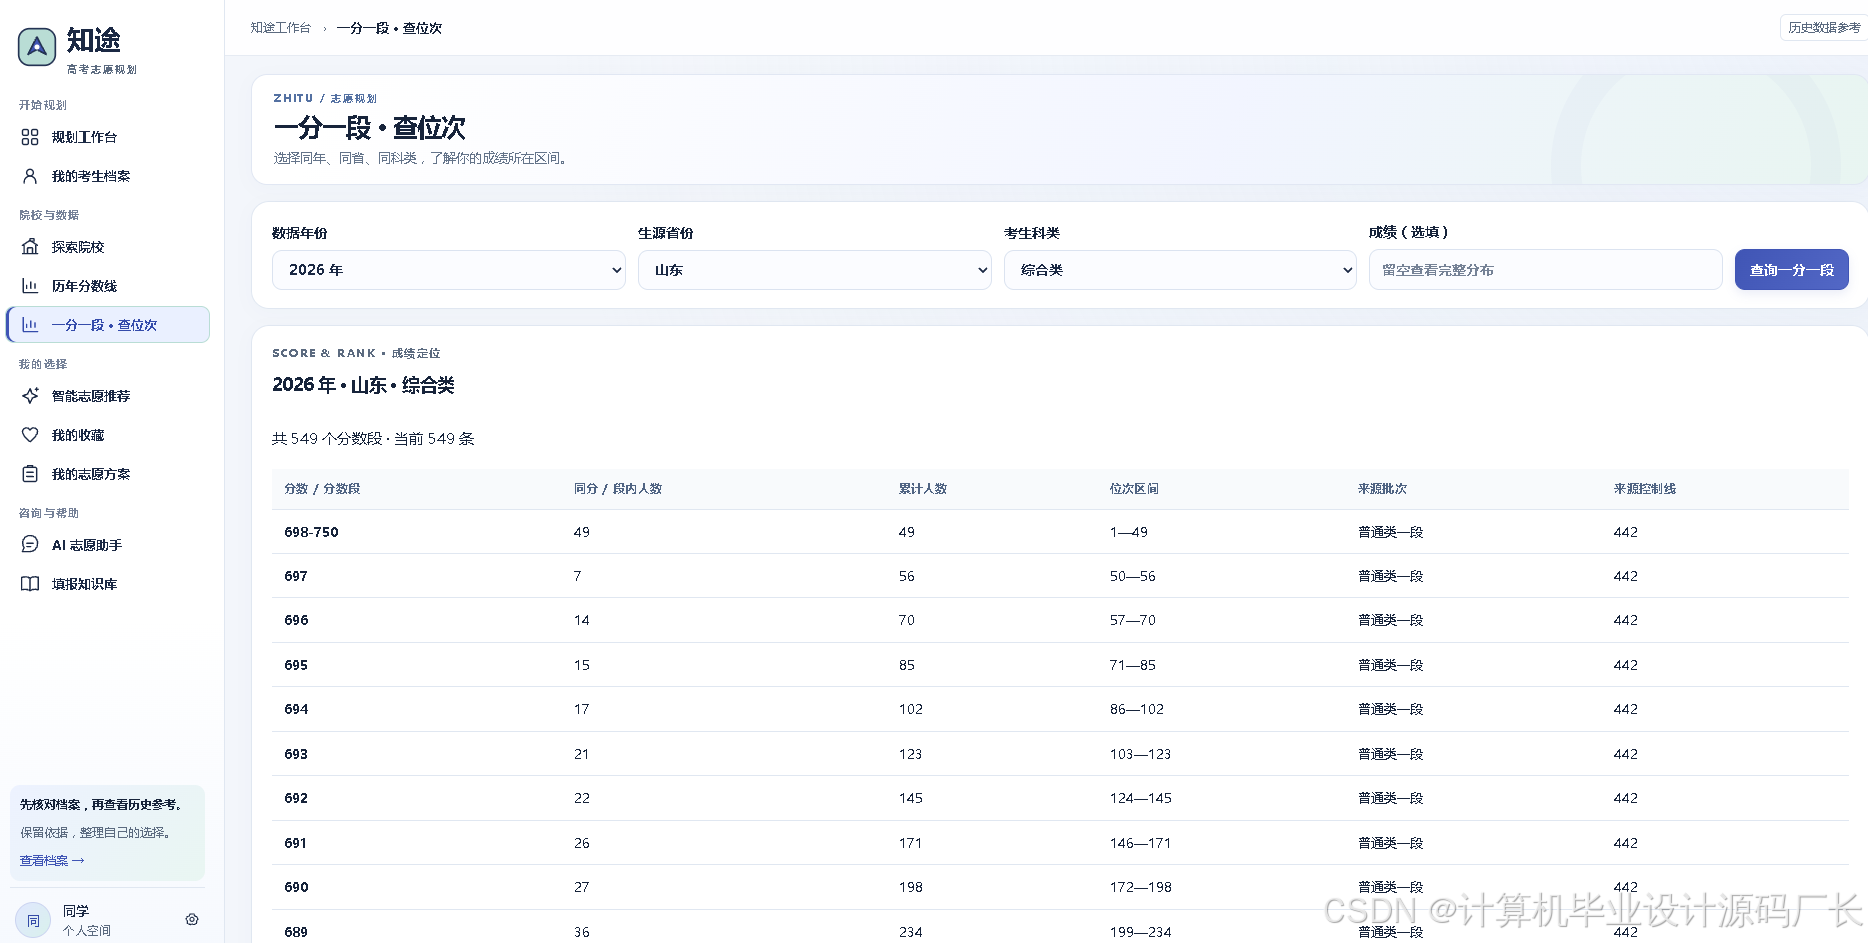
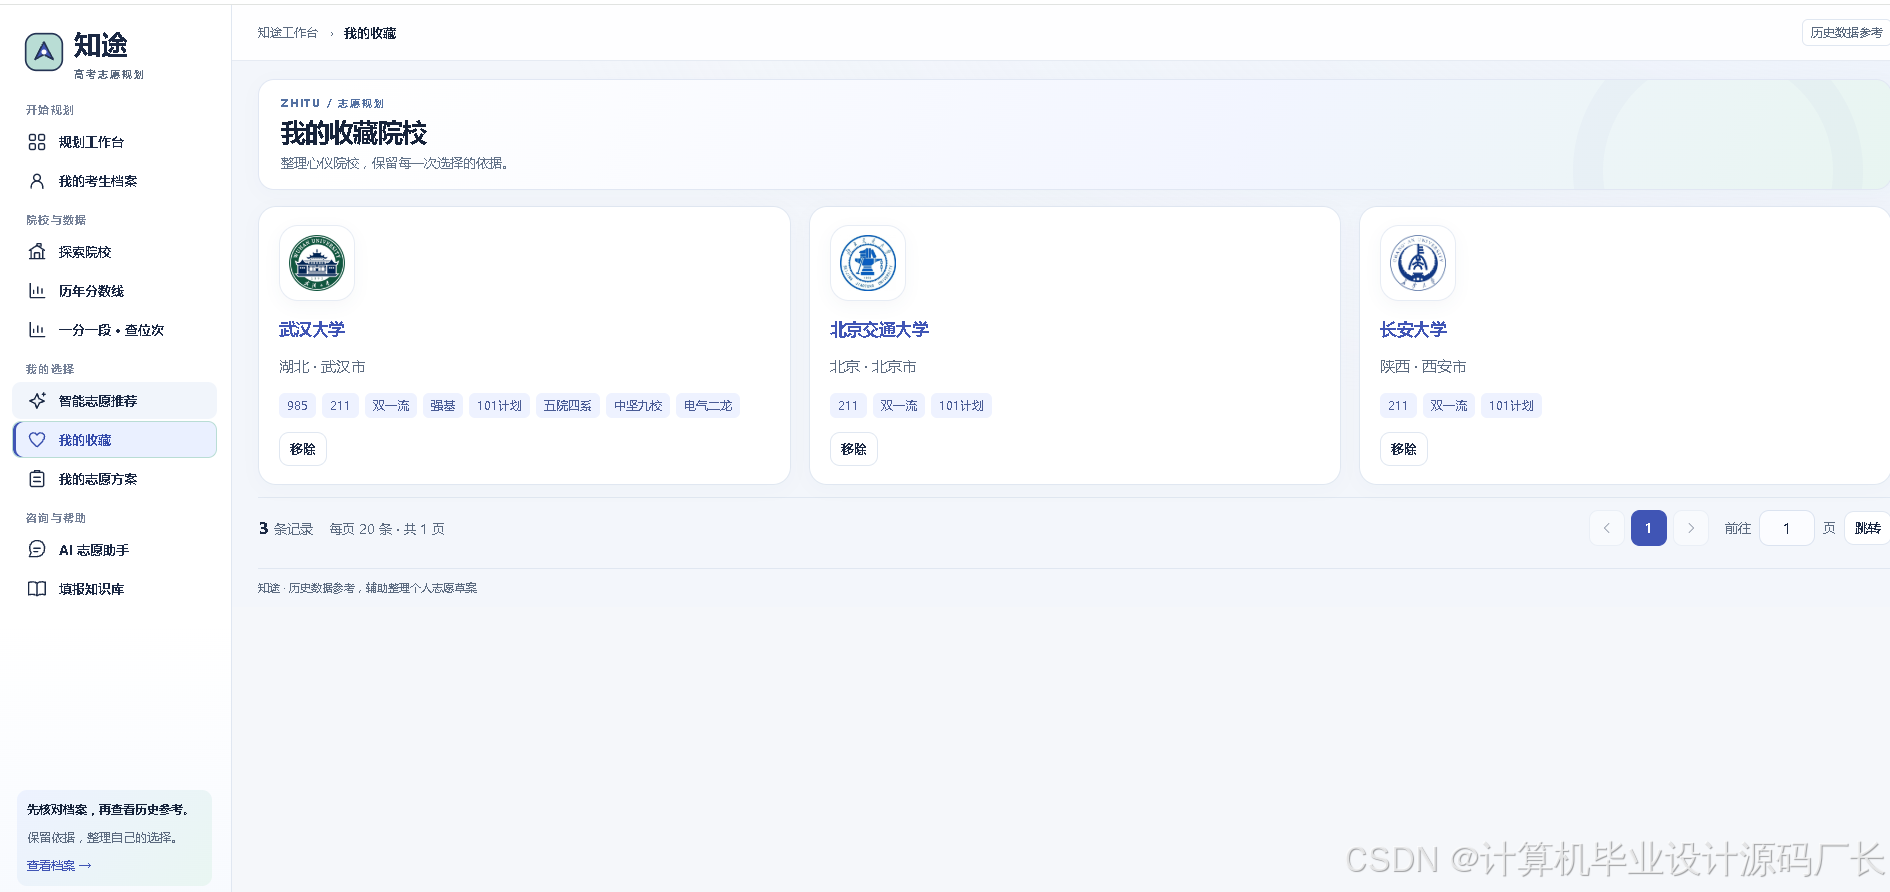
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!

为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,本人主页置顶文章(点我)开头有 CSDN 平台官方提供的学长联系方式的名片。🍅
点赞、收藏、关注,不迷路


评论前必须登录!
注册