 网硕互联帮助中心
一个”不会说话”的 AI 模型,凭什么让 14 万开发者挤进内测?它跟公路交通信息化又有什么关系?这篇文章不吹不黑,用交通人听得懂的话讲清楚:它是什么、能干啥、干不了啥,以及——在高速公路的”边缘”上,它到底能帮我们做什么决策。
一、先别急着上车:Jev 到底是个什么?
如果只用一句话介绍 Jev,那就是:
它是一个”只做判断、不写作文”的 AI 模型。
它由旧金山创业公司 TypeSafe AI 于 2026 年 9 月 15 日发布,创始人是前 OpenAI 研究员、RLHF 关键贡献者 Diogo Almeida。团队拿了 DCVC 领投的 4000 万美元种子轮,估值约 2 亿美元。
它和 GPT 这类大模型最本质的区别,一句话就能说清:
大模型(LLM)是”写”的——你问一句,它生成一段文字; Jev 是”判”的——你给一堆选项或一个打分标准,它挑一个、打个分、回个”是/否”,并附上概率。
官方把它叫作 System One(系统一)模型,借用了诺奖得主卡尼曼《思考,快与慢》里的概念:系统一是快而直觉的,系统二是慢而深思的。Jev 想干的,就是”系统一”的活儿——又快又省地做出简单判断。
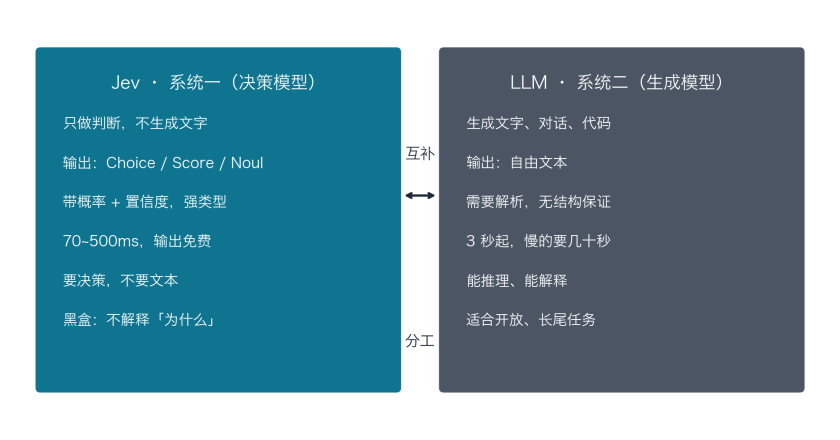 图1 Jev 与 LLM 的定位对比
三个”原语”,就这么多
Jev 的 API 极简,只有三种输出,业内叫它”决策三原语”:
表1 Jev 决策三原语
|
原语 |
中文 |
干什么 |
返回 |
|
Choice |
选择 |
从最多 255 个预设选项里挑一个 |
选中的那个 + 概率 |
|
Score |
打分 |
在自定义刻度上打分(如 1~10 风险等级) |
分数 + 概率分布 |
|
Noul |
是非 |
判断题(是/否),返回 0~1 的概率 |
概率值 |
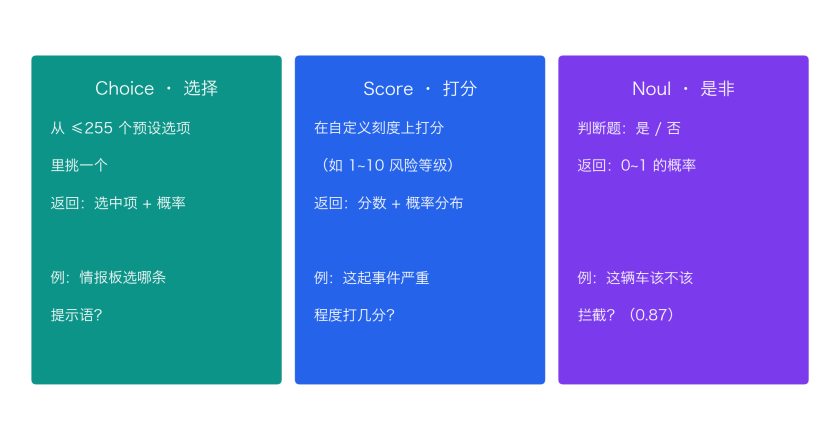 图2 Jev 决策三原语(Choice / Score / Noul)
Jev 决策三原语
关键点在于:它每次回答都附带完整的概率分布和置信度,而且是强类型结果——你代码里 response.choice 直接拿,不用再写正则去解析一大段文字。
为什么”爆火”?就两个字:快、省
- 快:端到端 70~500 毫秒,而大模型通常 3 秒起、慢的要几十秒。
- 省:输入每百万 token 0.042 美元,输出免费。官方宣称在特定工作流里比前沿大模型快约 193.6 倍、便宜约 444.6 倍(第三方实测没这么夸张,后面会拆穿)。
当下 Agent(智能体)大爆发,很多 Agent 内部其实是靠”一堆小 LLM 调用”撑起来的——判断该走哪条分支、这段内容相关不相关、这个结果合不合格。这些判断用大模型是”杀鸡用牛刀”,又慢又贵。Jev 的口号就一句话:要决策,不要文本(Decisions, not strings)。
二、它能干什么?
一句话概括:凡是”在明确选项里做判断、且要频繁调用”的活,都是 Jev 的主场。
举几个已经跑起来、有实测或开源佐证的例子:
- Agent 路由与分类:把”用户这句话该交给哪个工具/哪条流程”的判断,从大模型换成 Jev。
- 上下文压缩:给历史调用逐条打”相关分”,把接近 100 万 token 的上下文在 1 秒内精简到 8.6 万——不做摘要,只做”留/不留”的判断。
- 数据清洗:用自然语言对数据库行做实时概率过滤、排序(有人一晚处理 9081 条产品匹配数据)。
- 仓储机器人故障分级:为 1 万台 AMR 做”升级人工 / 交哪个团队 / 紧急度”三个判断,约 24.57 美元 / 百万次。
- 游戏与边缘:超级马里奥、《毁灭战士》守卫,靠几十毫秒级的操作决断。
- 边缘服务编排:arXiv 有论文用 Jev 替代 LLM 做低延迟服务编排,中位延迟降 15.9%~26.5%,费用降 69%~70.6%。
你会发现一个共同点:这些判断的”答案范围”全都是事先定义好的。这是理解 Jev 的钥匙——它的能力边界,恰恰由”你给它的选项”决定。
三、它做不到什么?(这一节最值钱)
不吹的部分来了。作为交通行业的信息化从业者,下面这些”做不到”比”能做到”更该记住。
1. 结构性的”不能”
- 不会生成文字:不能聊天、不能写报告、不能写代码,更不能”解释它为什么这么判断”——比大模型更黑盒。
- 只能吃文字:不支持图片、音频、视频。这一点对交通行业至关重要:它不能直接”看”监控视频。
- 答案锁死在选项里:你预设的选项就是它的全部宇宙,跳不出去。
2. 能力短板(第三方实测,非官方口径)
独立评测(jev-decision-bench,49 个任务、8225 条样本)显示:
- 需要外部知识时,会”自信地出错”:同一道历史选择题,不给背景时它用 0.90 的信心答错,喂入背景段落后以 0.97 的信心答对。也就是说,它不知道的,也能答得很笃定。
- 计数、算术、日期这类任务明显偏弱。
- 超大选项集表现下降(77 类时 0.81,基线 0.87)。
3. “概率校准”的坑
“概率诚实”是 Jev 的核心卖点(它的训练目标 RLCD,就是奖励”说 90% 就真有 90% 对”),但实测有不少坑:
- 选项顺序会影响概率:换个顺序,输出就变。
- 同一问题与其否定形式,概率不自洽(平均偏差 0.32)。
- 批量统计准确 ≠ 单次必对:它说”90% 把握”,是统计意义上的,不保证这一次就对。
4. “无幻觉”是文字游戏
官方说 Jev”无幻觉”,因为输出被 schema 锁死、结构上不可能吐出选项清单以外的东西。但多位评论者指出:“无幻觉”只保证答案落在合法选项内,不保证选对。它照样可能选错,或者给一个错误的置信度。
5. 工程现实
- 未开源、架构不公开,官方 API 只有云端,且未向中国大陆开放。
- 官方”快 193 倍”是自测口径,第三方测下来速度优势约 2~3.6 倍。
- 单次判断单价极低,商业模式要靠海量调用量支撑,能否长久有待观察。
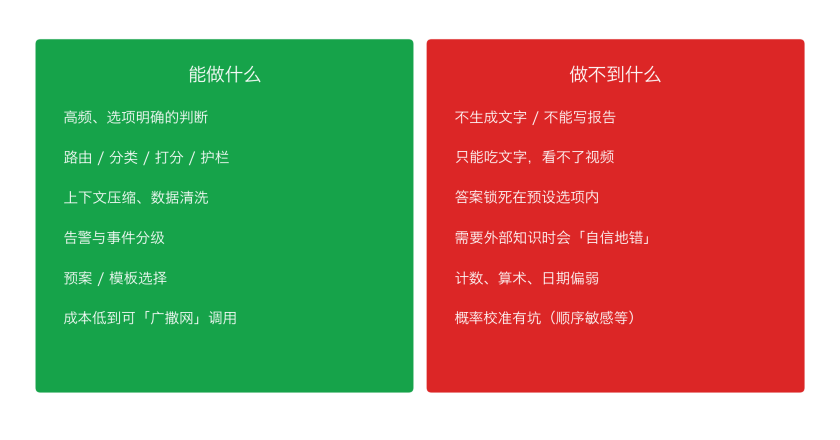 图3 Jev 能做什么与做不到什么
一句话总结它的边界:Jev 用”只做窄判断、输出带概率的结构化答案”,换来了快和省;代价是没了解释性、开放文本生成,以及”需要外部知识”时的可靠性。
四、重点来了:Jev 在公路交通能用在哪儿?
先抛一个可能反直觉、但对交通人很关键的观点:
公路交通的绝大多数”决策”,本来就发生在”预设选项”里。
想一想我们的日常业务:
- 一个”车辆抛锚”事件,该归到哪一类、发几级预警、推哪条应急预案?
- 情报板 / VMS 上,此刻该滚动显示哪条提示语?
- 收费站这道口,是放行、转人工、还是拦截?
- 门架上成千上万路摄像头的告警,哪些要升级、哪些能自动复位?
- 治超点,这辆车的多源数据拼起来,该不该拦?
这些全是 Choice / Score / Noul,全是预设选项内的判断。 这恰好不是大模型擅长的(写一大段文字没用,还慢还贵),却正是 Jev 的主场。
关键前提:它只能吃”文字”,不能”看”视频
所以正确的分工是——感知交给 CV 模型,决策交给 Jev:

图4 Jev 能做什么与做不到什么
几个能落地、且风险可控的场景
按”离安全关键越远越好上手”排序:
|
场景 |
Jev 干什么 |
原语 |
为什么适合 |
|
① 设备告警分级 |
把海量摄像头/门架/传感器告警分级:自动复位 / 派单 / 紧急升级 |
Choice + Score |
高频、选项明确,直接对应 AMR 故障分级 |
|
② 情报板内容选择 |
根据实时事件,从模板库里选最合适的一条提示语 |
Choice |
模板库天然是”预设选项” |
|
③ 应急预案/处置建议 |
事件信息进来,推荐预案库里的处置方案并打分 |
Choice + Score |
预案库是标准化的 |
|
④ 治超/黑名单异常车辆研判 |
多源数据拼成一句话,判断”拦/放”及置信度 |
Noul |
二值决策 + 概率门控 |
|
⑤ 车路协同边缘预警 |
路口/匝道冲突风险分级,触发预警 |
Score + Noul |
边缘低延迟 |
|
⑥ 事件检测后处置分级 |
抛锚/事故/拥堵 → 分级 → 联动信号、情报板 |
Choice + Score |
事件类型分类 |
为什么强调”边缘快速决策”?
因为高速公路有个残酷现实:隧道、山区、长下坡,常常弱网甚至断网。而交通决策是秒级甚至亚秒级的——一辆抛锚车后方 200 米有车以 110 km/h 逼近,你没时间等云端绕一圈。
实测数据(这点很关键):
|
部署方式 |
单次决策延迟 |
|
本地 Laya(RISC-V K3 芯片,60 TOPS) |
< 110ms |
|
本地 Laya(A100) |
30~85ms |
|
自托管 ModernBERT(2 核 CPU) |
p50 169ms |
|
官方云端 API(网络往返主导) |
约 390ms,p95 甚至 813ms |
结论很清楚:决策模型本身很快,但”云端 API”的延迟被网络主导。对公路交通的边缘场景,走本地部署才有意义——这也解释了为什么”官方 API 未向大陆开放、且未开源”这件事,对我们是硬约束。
好在国内已经在跟进:APUS AI Lab 基于公开文档做了跨平台开源复现(fast-browser-use,本地 Qwen3.5-9B 零云端调用、数据不出本机);社区还有 Laya、JevLoop 等项目,甚至已经在 RISC-V 芯片上跑通纯本地离线决策。
给交通信息化同仁的落地建议(不踩坑版)
五、总结
Jev 的火爆,本质是给了一个”高频、便宜、可编程、带概率的结构化判断”的新零件。它不是来取代大模型的,而是把 Agent 和业务系统里那些”本就不该用大模型做的小判断”接了过去。
对公路交通而言,真正值得兴奋的不是”又一个 AI 爆款”,而是它恰好戳中我们行业的特点:大量决策本来就是预设选项内的快速判断,而这类判断又最该发生在离现场最近的”边缘”上。
一句话收尾:
让 CV 去”看路”,让 Jev 去”拍板”,让规则和人工去”兜底”——这可能是决策模型给公路交通最有现实感的一条落地路径。
参考资料(文中数据来源)
- 不会说话的Jev,为什么爆火? — 搜狐
- 刷屏爆火的”不说话”AI Jev 真的是 AI 新范式吗? — 36氪
- Jev 为什么突然火了?它想把 Agent 里的大量 LLM 调用干掉 — 腾讯云
- 深度解读:关于 Jev 的几大疑问 — 雷锋网
- 号称快200倍的Jev模型,拿不下LLM的大结果 — 虎嗅
- 为什么Jev必须诞生在OpenAI之外:System One模型与RLHF的隐藏代价 — 至顶网
- Jev 模型量化拆解:AI 决策压到百毫秒后,时间戳反而成了瓶颈 — TickDB
- jev-decision-bench(独立评测) — GitHub
- jev-capability-atlas(能力图谱) — GitHub


评论前必须登录!
注册