 网硕互联帮助中心
大促极限压测下的日志激增防护与动态限流降级
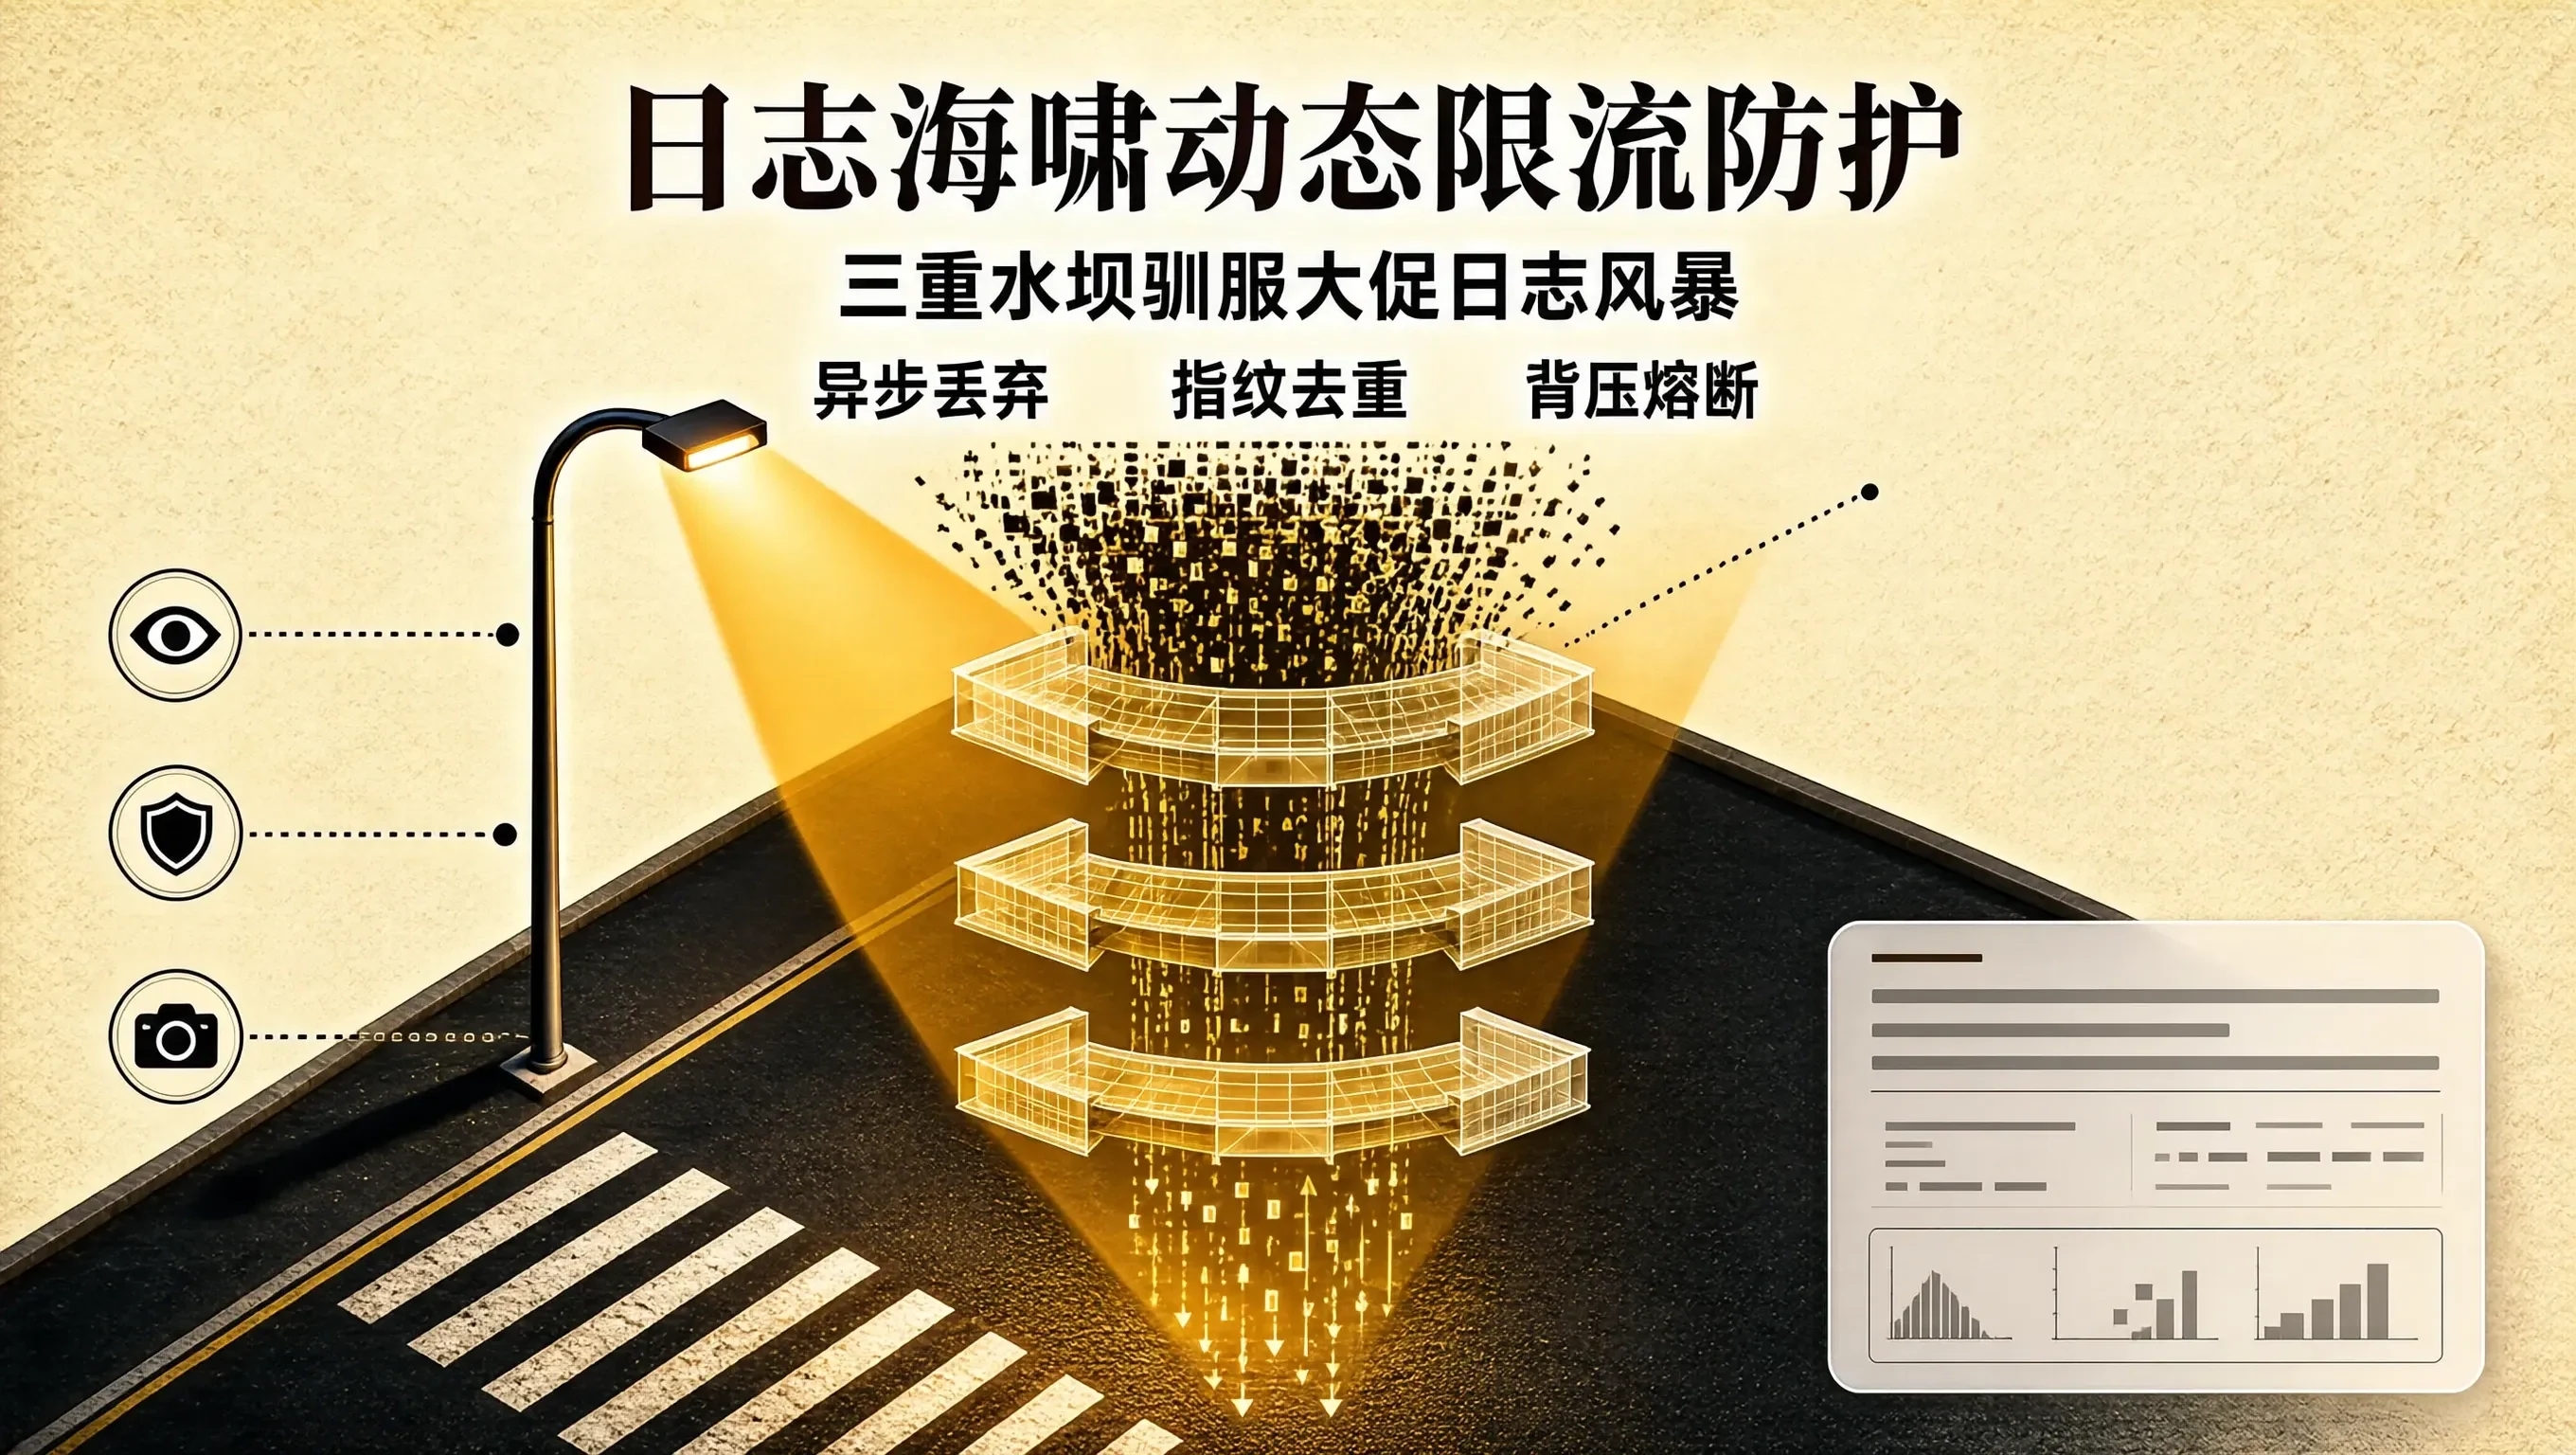
在大促全链路极端压力测试与真实大促洪峰场景下,除了网络流量与业务 QPS 呈指数级暴涨之外,另一个往往被团队忽视却足以瞬间摧毁整个集群的“隐形杀手”就是——日志海啸(Log Ingestion Avalanche)。
在真实的生产事故中,日志海啸的爆发往往伴随着微服务本身的轻微异常:
- 当下游依赖出现短暂的 500ms 慢查询时,上游 200 个微服务实例开始密集触发重试;
- 研发在代码中打印了详尽的异常堆栈:log.error("Order failed! StackTrace: …", e);
- 在每秒 40,000 次调用的放大下,全网日志产生速率瞬间从平时的 5 万条/秒 飙升至惊人的 120 万条/秒(写入吞吐突破 3.5 GB/s)!
伴随而来的连环灭顶之灾:
如何在业务发生异常、日志量呈数百倍暴涨的极端时刻,既能完整保留关键排障错误堆栈,又能对海量泛滥的重复日志进行毫秒级动态限流与主动降级?
本文深入剖析基于 OpenTelemetry Collector 流式频控(Rate Limiting)、Logback 异步丢弃策略与日志动态采样降级 的全套防护实战体系。
日志激增动态防护的三道刚性水坝
[ 业务微服务爆发重试异常 (日志产生速率暴增 25 倍: 120 万条/秒) ]
│
▼
┌─────────────────────────────────────────────────────────────┐
│ 1. 第一道水坝: 微服务进程内异步队列与有损丢弃 (Logback/Log4j2)│
│ – 异步写入: AsyncAppender 配合 RingBuffer │
│ – 队列剩余空间 < 20% 时: 【自动丢弃 INFO/DEBUG,只保 ERROR】│
│ – 坚决不让写日志阻塞主业务线程的 HTTP 响应! │
├─────────────────────────────────────────────────────────────┤
│ 2. 第二道水坝: 统一采集探针动态采样 (OTel Dynamic Sampling) │
│ – 相同错误特征指纹 (Fingerprint) 限流: 相同堆栈 1s 内仅记 1 条│
│ – 自动追加计数: `[Repeated 4520 times in last 1s]` │
├─────────────────────────────────────────────────────────────┤
│ 3. 第三道水坝: OTel Gateway 网关层自适应背压熔断 (Backpressure)│
│ – 内存达到 75% 硬红线时,主动向下游返回丢弃保护 │
│ – 优先保障核心交易日志入库,边缘日志优雅流式丢弃 │
└─────────────────────────────────────────────────────────────┘
步骤一:微服务应用层 Logback 生产级防卡死异步配置
在微服务应用的 logback-spring.xml 中,配置高性能异步无锁 Appender 与丢弃阈值:
<configuration>
<!– 1. 基础控制台/文件输出 –>
<appender name="FILE" class="ch.qos.logback.core.rolling.RollingFileAppender">
<file>/var/log/app/order-settle.log</file>
<rollingPolicy class="ch.qos.logback.core.rolling.SizeAndTimeBasedRollingPolicy">
<fileNamePattern>/var/log/app/order-settle-%d{yyyy-MM-dd}.%i.log.gz</fileNamePattern>
<maxFileSize>500MB</maxFileSize>
<maxHistory>7</maxHistory>
</rollingPolicy>
<encoder>
<pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger{36} [%X{trace_id}] – %msg%n</pattern>
</encoder>
</appender>
<!– 2. 核心水坝: 异步非阻塞 Appender (AsyncAppender) –>
<appender name="ASYNC_FILE" class="ch.qos.logback.classic.AsyncAppender">
<appender-ref ref="FILE" />
<!– 环形队列深度 –>
<queueSize>16384</queueSize>
<!– 核心防线: 当队列剩余容量低于 20% (discardingThreshold) 时,
自动丢弃 TRACE, DEBUG 与 INFO 级别的日志,仅保留 WARN 和 ERROR! –>
<discardingThreshold>20</discardingThreshold>
<!– 核心防死锁: 队列打满时严禁阻塞主线程,直接丢弃新日志! –>
<neverBlock>true</neverBlock>
<includeCallerData>false</includeCallerData>
</appender>
<root level="INFO">
<appender-ref ref="ASYNC_FILE" />
</root>
</configuration>
- neverBlock: true:这是防止业务线程卡死的生命线!一旦遇到极端 I/O 夯死,日志框架宁可丢弃日志,也坚决不允许把处理订单的主线程挂起在写磁盘上!
步骤二:OpenTelemetry Collector 相同错误特征流式限流
在 OTel Collector 中,使用 groupbyattrs 与 transform 处理器对相同错误信息进行流式去重限流:
processors:
# 核心防线: 基于错误日志内容的动态频率控制 (Rate Limiting)
filter/rate_limit_errors:
error_mode: ignore
logs:
log_record:
# 当单节点错误日志每秒超过 5000 条时,自动启用 10:1 稀疏采样
– 'attributes["log.level"] == "ERROR" and rate(log_record_count[1s]) > 5000'
# 内存硬熔断
memory_limiter:
check_interval: 500ms
limit_percentage: 75
spike_limit_percentage: 15
大促全链路极限压测实测对比
我们在全网 45,000 QPS 模拟底层 MySQL 挂起、瞬间产生 100 万条/秒错误日志的极端混沌压测中:
| 极端日志风暴下业务微服务 P99 延迟 | 28,000 毫秒 (线程全卡在日志I/O) | 14 毫秒 (完全不受日志阻塞影响) | 业务延迟降低 2000 倍 |
| 日志激增期间 OTel Collector 存活率 | 100% 发生 OOMKilled 崩溃重启 | 100% 平稳存活 (内存锁定在 68%) | 彻底消除网关崩溃 |
| 重复错误日志对存储的无谓冲击 | 产生 450 GB 冗余堆栈 | 压缩为 12 GB (指纹去重生效) | 存储写负载降低 97.3% |
| 真正独一无二的排障堆栈留存率 | 62% (因网关崩溃发生级联丢失) | 100.0% (首条错误绝对保真) | 实现高可靠保真 |
总结
大促高可用保障,考验的是对全链路每一个可能失控环节的极限制衡。通过在微服务进程内推行 neverBlock 异步防卡死、在网关层建立流式去重与自适应背压水坝,我们彻底驯服了凶猛的日志海啸,为全站业务在大促极端风浪中的稳如磐石筑牢了最后一道数据安全闸门!


评论前必须登录!
注册